
Aufwärmübung: System mit zwei LLM-Aufrufen
Beispiel-Berechnungsgraph. In der traditionellen automatischen Differenzierung berechnen wir Gradienten, die mit der Kettenregel eine Richtung liefern, die die Variable im Hinblick auf einen nachgelagerten Verlust verbessern würde. Für ein einfaches Analogon betrachten wir das einfache System:
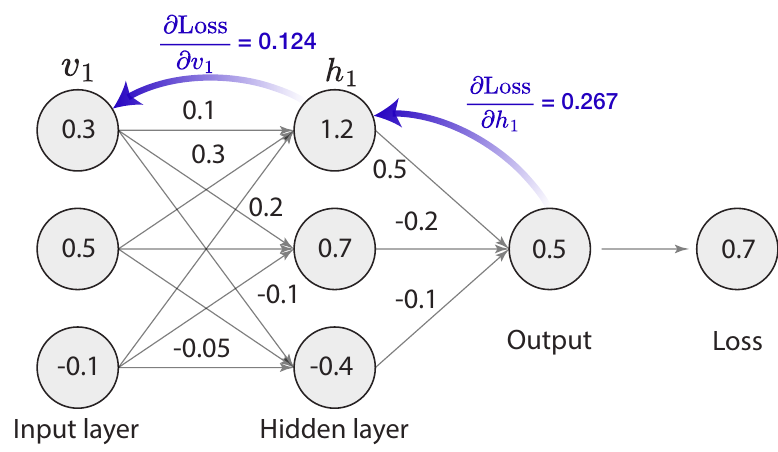
a Neuronales Netz und Backpropagation unter Verwendung numerischer Gradienten
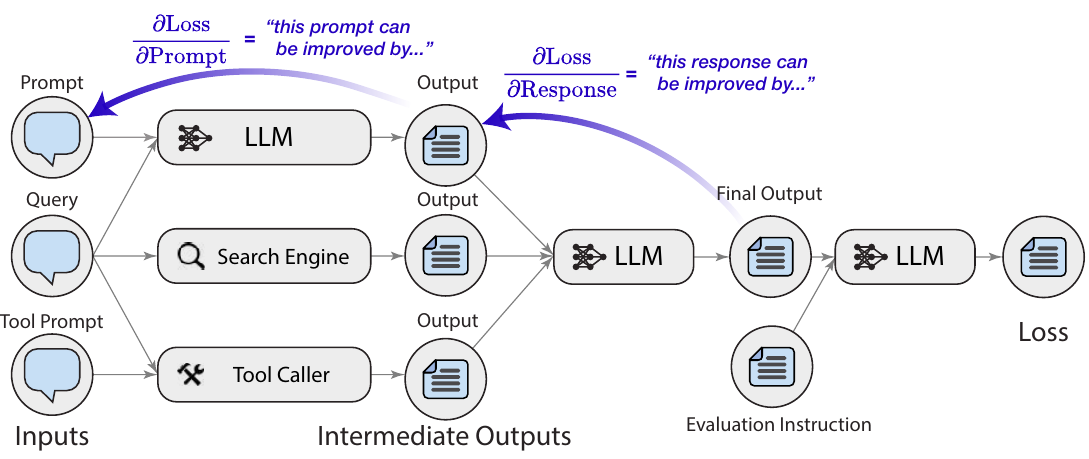
b Blackbox-KI-Systeme und Backpropagation unter Verwendung natürlicher Sprach-„Gradienten“
C 1 Analogie in Abstraktionen
| Mathematik | PyTorch | TextGrad | |
| Eingabe | x | Tensor(Bild) | tg.Variable(Artikel) |
| Modell | y = fθ(x) | ResNet50( ) | tg.BlackboxLLM("Du bist ein Zusammenfasser.") |
| Verlust | L(y, y) = ∑ y; log( y; ) | CrossEntropyLoss( ) | tg.TextLoss("Bewerte die Zusammenfassung.") |
| Optimierer | GD(θ; θ) = θ - θL/θ0 | SGD(List(model.parameters( ))) | tg.TGD(List(model.parameters( ))) |
2 Automatische Differenzierung
PyTorch und TextGrad teilen dieselbe Syntax für Backpropagation und Optimierung.
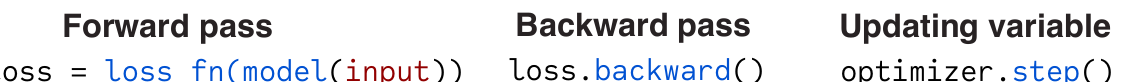
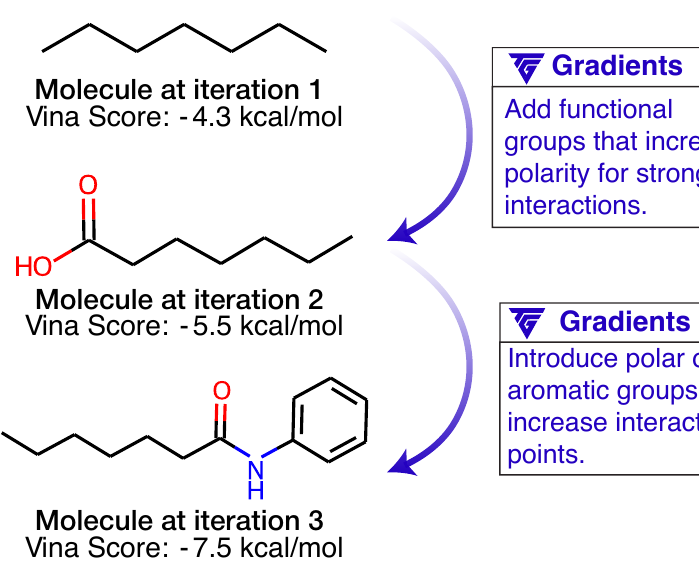
d TextGrad zur Moleküloptimierung
e TextGrad zur Codeoptimierung
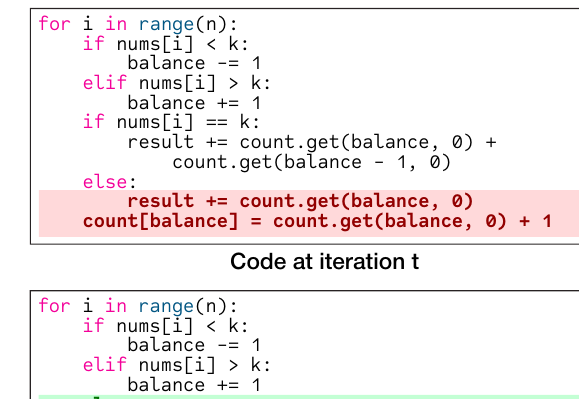
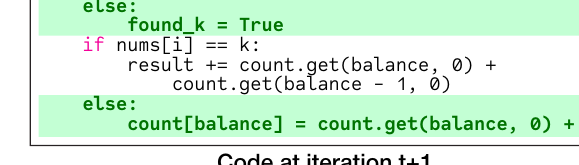
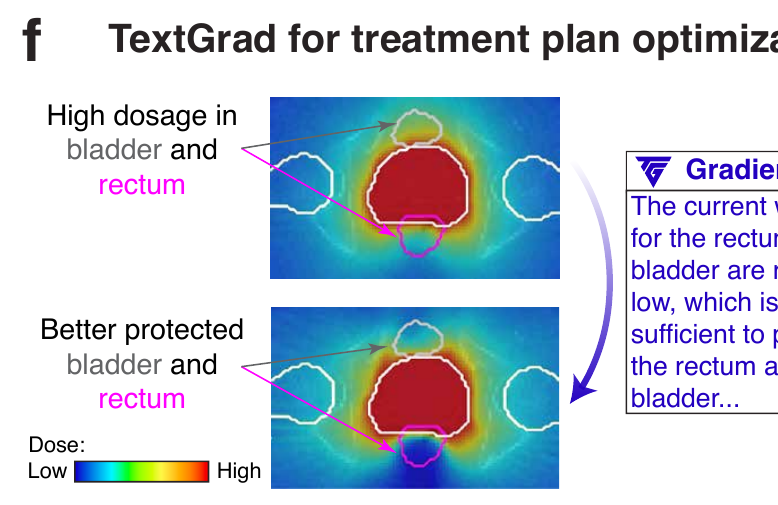
f TextGrad zur Optimierung von Behandlungsplänen
g TextGrad zur Prompt-Optimierung
Sie werden eine Reasoning-Frage beantworten. Denken Sie Schritt für Schritt. Die letzte Zeile Ihrer Antwort sollte das folgende Format haben: ‚Answer: ‘SVAULE‘, wobei VALUEl ein numerischer Wert ist.
Prompt bei der Initialisierung (Genauigkeit = 77,8 %)
Sie werden eine Reasoning-Frage beantworten. Listen Sie jedes Element und seine Menge in einem klaren und konsistenten Format auf, z. B. ‚- Element: Menge‘. Summieren Sie die Werte direkt aus der Liste und geben Sie eine prägnante Summation an. Stellen Sie sicher, dass die endgültige Antwort klar im Format ‚Answer: ‘SVAULE‘ angegeben wird, wobei VALUEl ein numerischer Wert ist. Überprüfen Sie die Relevanz jedes Elements für den Kontext der Anfrage und behandeln Sie mögliche Fehler oder Unklarheiten in der Eingabe. Überprüfen Sie die endgültige Zählung doppelt, um Genauigkeit zu gewährleisten.„
Prompt nach der Optimierung (Genauigkeit = 91,9 %)
Abbildung 1: Automatische „Differenzierung“ über Text (a, b). Die Backpropagation von Gradienten ist die treibende Kraft des Deep Learning. Für zusammengesetzte Systeme aus Blackbox-KI-Systemen haben wir keine Gradienten, aber wir können eine analoge Backpropagation für textbasiertes Feedback konstruieren, die die Grundlage von TEXTGRAD bildet. Abstraktionen in TEXTGRAD (c). Wir verwenden dieselben Abstraktionen und dieselbe Syntax wie PyTorch, damit unser Framework verallgemeinerbar und leicht erlernbar ist. Anwendungen von TEXTGRAD (d,e,f,g). In Abschnitt 3.4 optimieren wir molekulare Strukturen für Eigenschaften wie Arzneimittelähnlichkeit und Proteinbindungsaffinität (d). In Abschnitt 3.1 optimieren wir Lösungen für Programmierprobleme (e). In Abschnitt 3.5 optimieren wir Strahlentherapie-Behandlungspläne, um die Patientenergebnisse zu verbessern (f). In Abschnitt 3.3 optimieren wir Prompts, um das Reasoning von Sprachmodellen zu verbessern (g). Dabei bezeichnen wir den freien Parameter, der optimiert werden soll, nämlich den Prompt, mit Grün, und wir verwenden zur Bezeichnung der Verkettung zweier Strings und verwenden , um als Prompt an ein Sprachmodell zu geben, um die Antwort zu sammeln. Wir verwenden die Kettennotation:
als eine weitere Möglichkeit, dieses System zu bezeichnen, wobei wir einen LLM-Aufruf machen, um eine Prediction für eine Question unter Verwendung eines Prompt zu erzeugen, und einen weiteren LLM-Aufruf, um diese Prediction zu bewerten.
Beispiel für die Gradientenberechnung. In diesem Beispielsystem instanziieren wir, um den Prompt im Hinblick auf die Evaluation zu verbessern, ein Analogon des Backpropagation-[19]-Algorithmus durch Folgendes:
Gradientenberechnung für den einfachen Graphen: Prompt Prediction Evaluation
wobei wir für den Gradientenoperator verwenden, wenn die Vorwärtsfunktion ein LLM-Aufruf ist. Insbesondere gibt diese Funktion natürlichsprachliches Feedback wie ‚This prediction can be improved by...‘ zurück, wobei das Feedback beschreibt, wie die Variable zu ändern ist, um das nachgelagerte Ziel zu verbessern, analog zu Gradienten in der Optimierung. Wir sammeln zuerst Feedback für die Variable Prediction unter Verwendung der Evaluation. Dann sammeln wir, gegeben dieses Feedback und den Aufruf (Prompt Prediction), das Feedback zum Prompt.
„Beachten Sie, dass wir die Notation überladen, um sowohl Fälle zu bezeichnen, in denen die Ausgabevariable keine Nachfolger hat (z. B. ), als auch Fälle, in denen sie Nachfolger und somit Gradienten hat (z. B. ).
Im Folgenden findet sich eine flexible Möglichkeit, zu instanziieren, um Feedback für ein einfaches System wie zu sammeln:
Beispielimplementierung für den Gradientenoperator
wobei das Gradientenobjekt eine Kombination aus dem Kontext, in dem die Variable erscheint, und dem von einem erhaltenen Feedback ist, definiert analog zu Pryzant et al. [25]. Beachten Sie, dass dieser Operator nicht z. B. von der Anwendungsdomäne abhängt. Einmal implementiert, sind die Gradientenoperatoren für LLM-Aufrufe im gesamten Framework für alle Anwendungen festgelegt.
aDie genauen Prompts, die wir verwenden, unterscheiden sich, um Allgemeinheit und Flexibilität zu gewährleisten; wir verwenden diese Beispiele nur zur Veranschaulichung.
Beispieloptimierer. Beim standardmäßigen Gradientenabstieg wird der aktuelle Wert der Variable mit den Gradienten durch Subtraktion kombiniert, z. B.:
In Fortführung der Analogie zur gradientenbasierten Optimierung verwenden wir Textual Gradient Descent (TGD):
Aktualisierung der Variable Prompt im einfachen Graphen über TGD.
um die Parameter zu aktualisieren, in diesem Fall den Prompt. Insbesondere strebt der Optimierer, gegeben die aktuelle Variable und die Gradienten (Feedback), die wir für diese Variable gesammelt haben, danach, diese Variable zu aktualisieren.
Eine konkrete Möglichkeit, TGD zu instanziieren, ist die folgende:
Beispielimplementierung einer TGD-Iteration
wobei die Variable ist, die wir verbessern möchten, und das Feedback ist, das wir für die Variable während des Rückwärtsdurchlaufs erhalten habena. Ähnlich wie der Gradientenoperator hängt diese Funktion ebenfalls nicht von der Anwendungsdomäne ab, und die TGD-Implementierung ist in allen Verwendungen des Frameworks dieselbe.
aDie genauen Prompts, die wir verwenden, unterscheiden sich, um Allgemeinheit und Flexibilität zu gewährleisten; wir verwenden diese Beispiele nur zur Veranschaulichung.