
A.1 Variablen
Variablen sind die Knoten im Berechnungsgraphen. Im Folgenden sind die wichtigsten Attribute von Variablen aufgeführt:
1. Value sind die unstrukturierten Daten, die die Variable enthält. In diesem Manuskript sind alle Werte Textdaten.
2. Role description ist eine informative Zeichenkette, die die Rolle der Variable im Berechnungsgraphen beschreibt. Wir verwenden diese Rollen, damit der Nutzer Wissen in den Graphen einbringen und das Optimierungsverhalten steuern kann. Weitere Informationen werden unten beschrieben.
3. Gradients sind das natürlichsprachliche Feedback, das die LLMs während des Rückwärtsdurchlaufs liefern. Sie beschreiben die Änderungen, die an der Variable vorgenommen werden sollen, damit der nachgelagerte Verlust verbessert werden kann. Ein Beispiel für eine Rückwärtsoperation, die Gradienten befüllt, finden Sie in Abschnitt A.3.
4. Predecessors sind die Menge der Variablen, die zur Erzeugung einer gegebenen Variable verwendet werden. Wenn wir beispielsweise einem LLM eine Anweisung geben und eine Antwort erhalten, wäre die Anweisung der Vorgänger der Antwort. Während des Rückwärtsdurchlaufs werden die Gradienten des Nachfolgers an seine Vorgänger weitergegeben, um Hinweise zu liefern, wie das nachgelagerte Ziel verbessert werden kann.
5. Requires grad gibt an, ob die Gradienten während des Rückwärtsdurchlaufs befüllt werden oder nicht, analog zu PyTorch. Wenn der Nutzer beispielsweise keine Gradienten für eine Frage berechnen möchte, schreibt er einfach Variable(value=question, requires_grad=False, ...), um dies anzugeben.
Role Description: In TEXTGRAD hat jede Variable eine Role description. Konkret handelt es sich um eine Zeichenkette, die die Rolle der Variable im Berechnungsgraphen beschreibt, etwa System-Prompt an das Sprachmodell oder Vorhersage durch das Sprachmodell. Sie wird zwar manchmal automatisch befüllt, doch im Allgemeinen sind Role descriptions eine der wichtigsten Möglichkeiten, Nutzerwissen in den Optimierungsprozess einzubringen.
Empirisch stellen wir fest, dass Role descriptions den Optimierungsprozess erheblich lenken können. Wenn beispielsweise die Rolle einer Vorhersage als die endgültige numerische Antwort an das Sprachmodell festgelegt wird, lenkt dies den Textual Gradient Descent-Optimierer, der ein Sprachmodell auffordert, den Wert der Variable anhand des Feedbacks zu aktualisieren, dahingehend, die Variable so zu aktualisieren, dass sie nur einen numerischen Wert enthält. Im Vergleich dazu lenkt eine Role description wie die Begründung für die Lösung und die endgültige Vorhersage den Optimierer dahingehend, die Begründung zusammen mit der endgültigen Vorhersage zu erzeugen.
Hier ist ein Beispiel für die Verwendung:
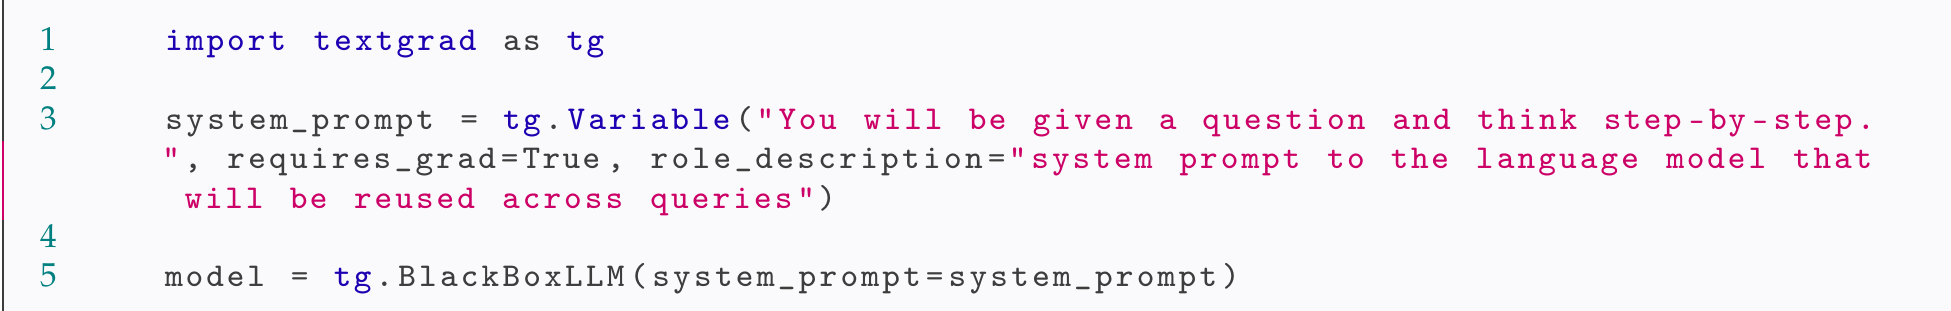
Code Snippet 3: Ein Beispiel für die Verwendung einer Role description.