Zum Hauptinhalt springen
TextGrad: Automatic "Differentiation" via TextMert Yuksekgonul et al.

F.4 Initialisierung

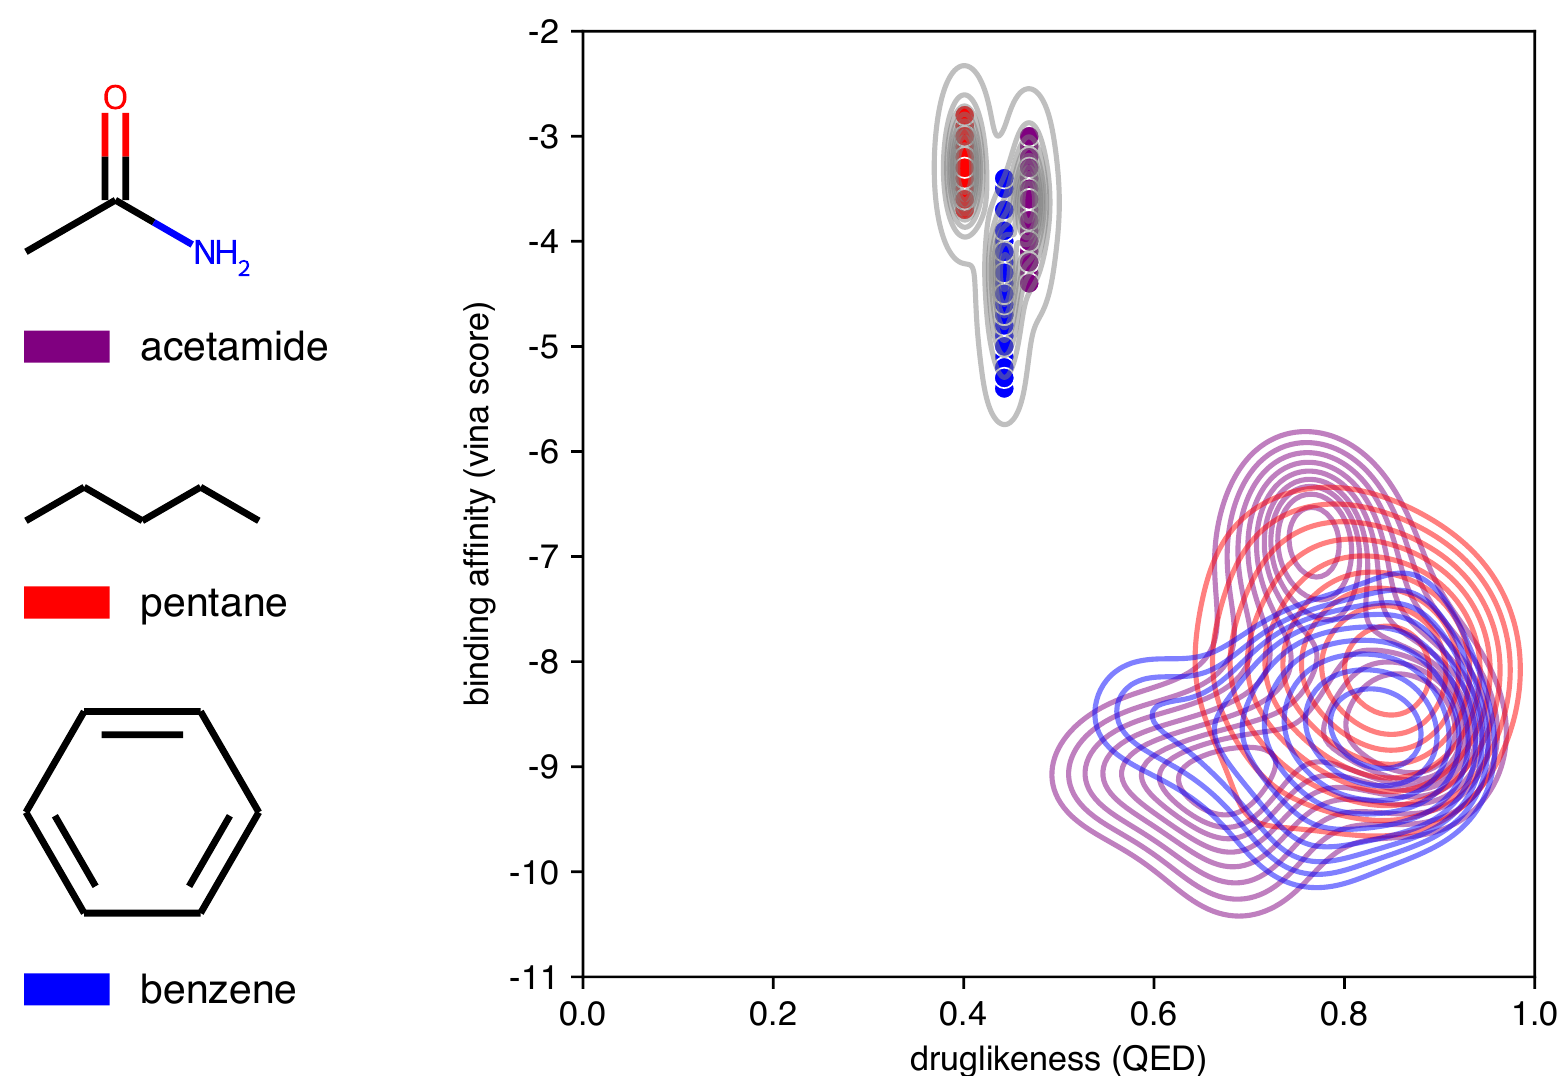
Ergänzende Abbildung 1: Molekülinitialisierung. Wir initialisieren TEXTGRAD mit Fragmentmolekülen aus drei verschiedenen funktionellen Gruppen und optimieren jedes Ausgangsmolekül über 10 Iterationen für alle 58 Zielstrukturen in der DOCKSTRING-Benchmark-Suite. Für jedes Fragment und jedes Protein führen wir eine Nachselektion der generierten Moleküle anhand des in Gleichung 25 beschriebenen Summen-Scores durch und visualisieren die resultierende Verteilung. Wir beobachten, dass die Verteilungen der QED- und Vina-Scores der Ausgangsfragmente zwar stark variieren, die Verteilung der optimierten Moleküle jedoch stark überlappt.

In der Praxis wird die molekulare Optimierung typischerweise durch groß angelegtes Prä-Optimierungs-Screening beschleunigt, bei dem Bibliotheken von Millionen oder sogar Milliarden existierender chemischer Strukturen durch Docking, Druglikeness und andere Metriken bewertet und gerankt werden. Nur die vielversprechendsten Strukturen, "Leads" genannt, werden von medizinischen Chemikern weiter verfeinert [104]. Obwohl TEXTGRAD jedes Ausgangsmolekül optimieren kann, wählen wir in dieser Arbeit, um seine Leistung genauer zu charakterisieren und zu vermeiden, dass seine Designs in Richtung existierender Medikamente verzerrt werden, stattdessen unsere drei Ausgangsmoleküle aus einfachen Fragmenten häufiger funktioneller Gruppen aus, die in Abbildung 1 gezeigt werden. Diese Fragmente sind sehr divers und gehören zu unterschiedlichen funktionellen Gruppen. Obwohl diese Ausgangsfragmente unterschiedliche Druglikeness- und Bindungsaffinitätseigenschaften aufweisen, ist der Einfluss des Startfragments auf die Leistung von TEXTGRAD minimal, und TEXTGRAD ist in der Lage, aus allen drei Fragmenten Moleküle mit hoher Druglikeness und Bindungsaffinität zu generieren.