
E.6 Implizite Ziele
Eine weitere zentrale Sorge bei der Anwendung von LLMs in der Wissenschaft ist ihre Neigung zu Halluzinationen, wobei Modelle faktisch falsche oder unlogische Antworten generieren, während sie versuchen, Nutzeranfragen zu erfüllen [105]. In unserem Setting könnten sich diese Halluzinationen darin manifestieren, dass TEXTGRAD ungültige, toxische oder anderweitig unerwünschte Moleküle vorschlägt, um seine Zielfunktion zu optimieren. Wir kontrollieren schwere Halluzinationen, indem wir Moleküle mittels RDKit-Sanitisierung vorverarbeiten und so zumindest sicherstellen, dass TEXTGRAD chemisch gültige Moleküle generiert. Dieser einfache Vorverarbeitungsschritt spezifiziert jedoch nicht vollständig das wünschenswerte chemische Verhalten. Eine direkte Strategie wäre, alle möglichen Metriken für die Wünschbarkeit von Arzneimittelmolekülen jenseits von Druglikeness und Bindungsaffinität erschöpfend in die Zielfunktion zu kodieren und sie um Synthetisierbarkeit, Toxizität und andere Kriterien zu erweitern. Leider ist dieser Ansatz realistischerweise nicht machbar, da nicht alle Kriterien für Wünschbarkeit ausgereifte computergestützte Metriken haben. Eine zentrale Frage ist daher, ob TEXTGRAD während seines Optimierungsprozesses sogenannte implizite Ziele befolgt, die unlogisches oder unerwünschtes Verhalten einschränken.
Um das Ausmaß oder die Existenz unerwünschter Moleküle zu bewerten, können wir die Schädlichkeit der generierten Moleküle charakterisieren und uns dabei auf Mutagenese und klinische Toxizität konzentrieren. Mutagenität bezeichnet die Fähigkeit eines Medikaments, genetische Veränderungen hervorzurufen, die zu DNA-Schäden und schädlichen langfristigen Auswirkungen führen können. Klinische Toxizität bezeichnet ein breites Spektrum ungünstiger kurz- oder langfristiger Nebenwirkungen. Wichtig ist, dass weder Druglikeness
noch Bindungsaffinität stark mit diesen Kriterien korreliert sind und diese Wünschbarkeitsmetriken daher nicht direkt optimiert oder anderweitig explizit in TEXTGRADs Zielen kodiert sind.
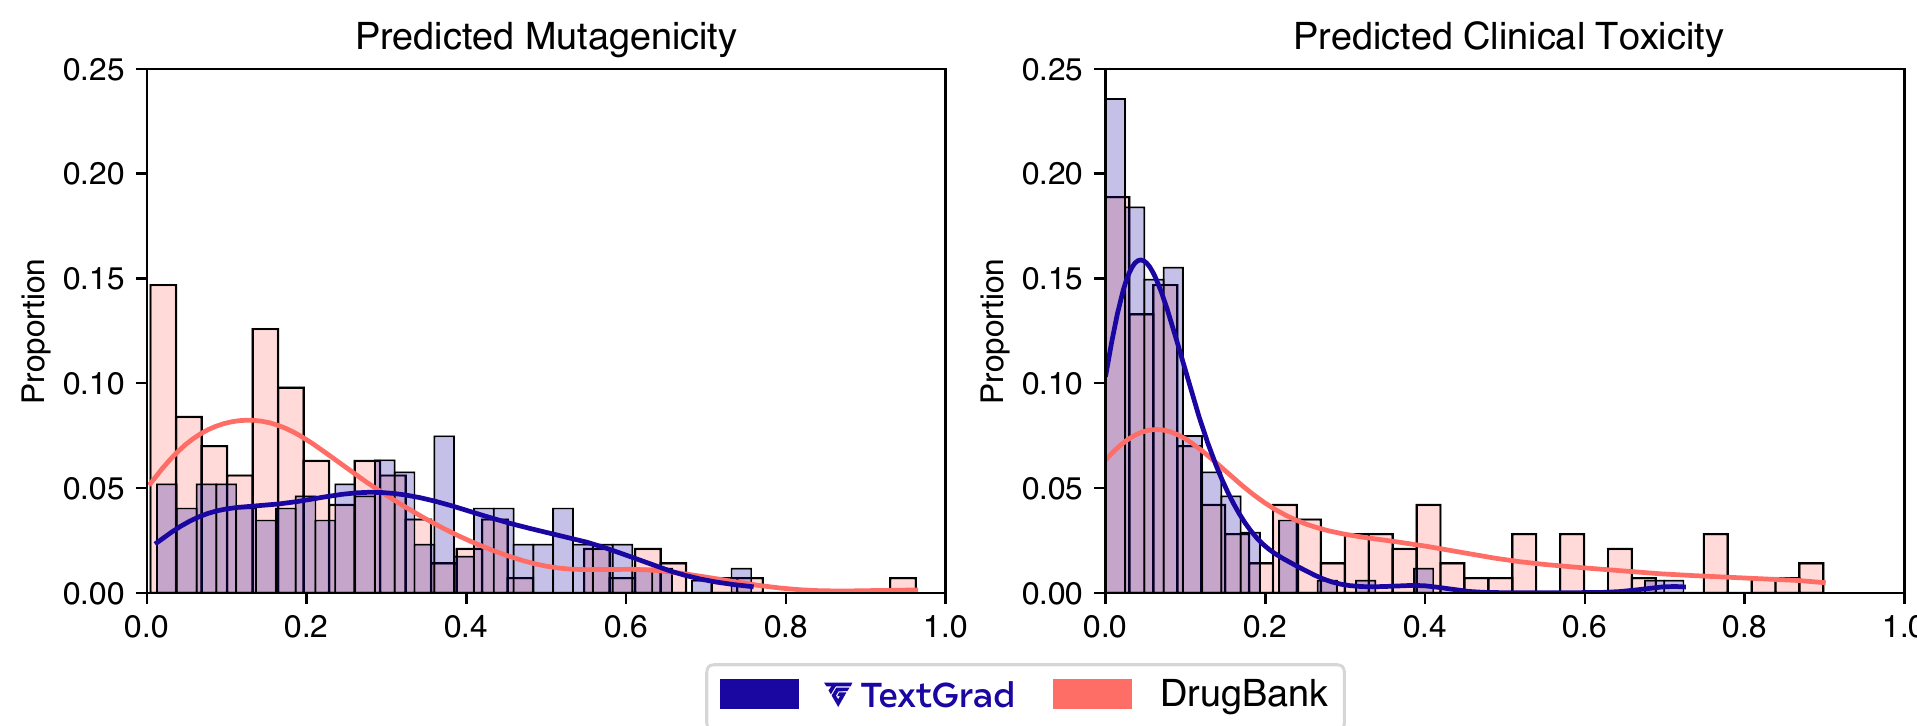
Um die Neigung zu Mutagenese und klinischer Toxizität zu bewerten, verwenden wir das ADMET-AI-Modell, das diese Scores aus den chemischen Strukturen von Molekülen vorhersagt [108]. ADMET-AI verwendet ein Deep-Learning-Modell, das auf mehreren relevanten Datensätzen trainiert wurde. Insbesondere für Mutagenität ist ADMET-AI auf 7.255 Medikamenten aus dem Ames-Datensatz trainiert, einem bakteriellen Rückmutationsassay zum schnellen Screening großer Zahlen von Verbindungen auf induzierbare genetische Schäden und Frameshift-Mutationen. Ein vorhergesagtes Label von 1,0 zeigt eine hohe Wahrscheinlichkeit an, dass das Medikament Mutagenese induziert, während ein Label von 0,0 eine geringe Wahrscheinlichkeit anzeigt. Für klinische Toxizität ist ADMET-AI auf dem ClinTox-Datensatz trainiert, einem Datensatz mit 1.484 Medikamenten, bestehend aus Molekülen, die aus Toxizitätsgründen in klinischen Studien versagt haben, sowie Medikamenten, die mit erfolgreichen Studien assoziiert sind. Ebenso zeigt ein vorhergesagtes Label von 1,0 eine hohe Wahrscheinlichkeit klinischer Toxizität an, während ein Label von 0,0 eine geringe Wahrscheinlichkeit anzeigt.
Auch hier beschränken wir unsere Analyse auf die leistungsstärksten generierten Moleküle mit drugable Targets, gemessen am Gesamtscore, und wählen das beste Molekül für jedes Protein-Target und für jedes Ausgangsfragment aus, insgesamt 87 generierte Moleküle. Anschließend vergleichen wir ihre vorhergesagte Mutagenese und klinische Toxizität mit den 118 klinisch zugelassenen Molekülen aus DrugBank. Wir beobachten, dass für sowohl Mutagenität als auch klinische Toxizität die von TEXTGRAD generierten Moleküle vorhergesagte Verteilungen aufweisen, die eine geringe Wahrscheinlichkeit schädlicher Effekte anzeigen und eng mit den Verteilungen der klinisch zugelassenen Moleküle übereinstimmen. Zusammengenommen legen diese Ergebnisse nahe, dass TEXTGRAD implizit vermeidet, schädliche Moleküle vorzuschlagen, obwohl diese Kriterien nicht direkt in seiner Loss-Funktion kodiert sind.