
F.5 Chemische Neuartigkeit
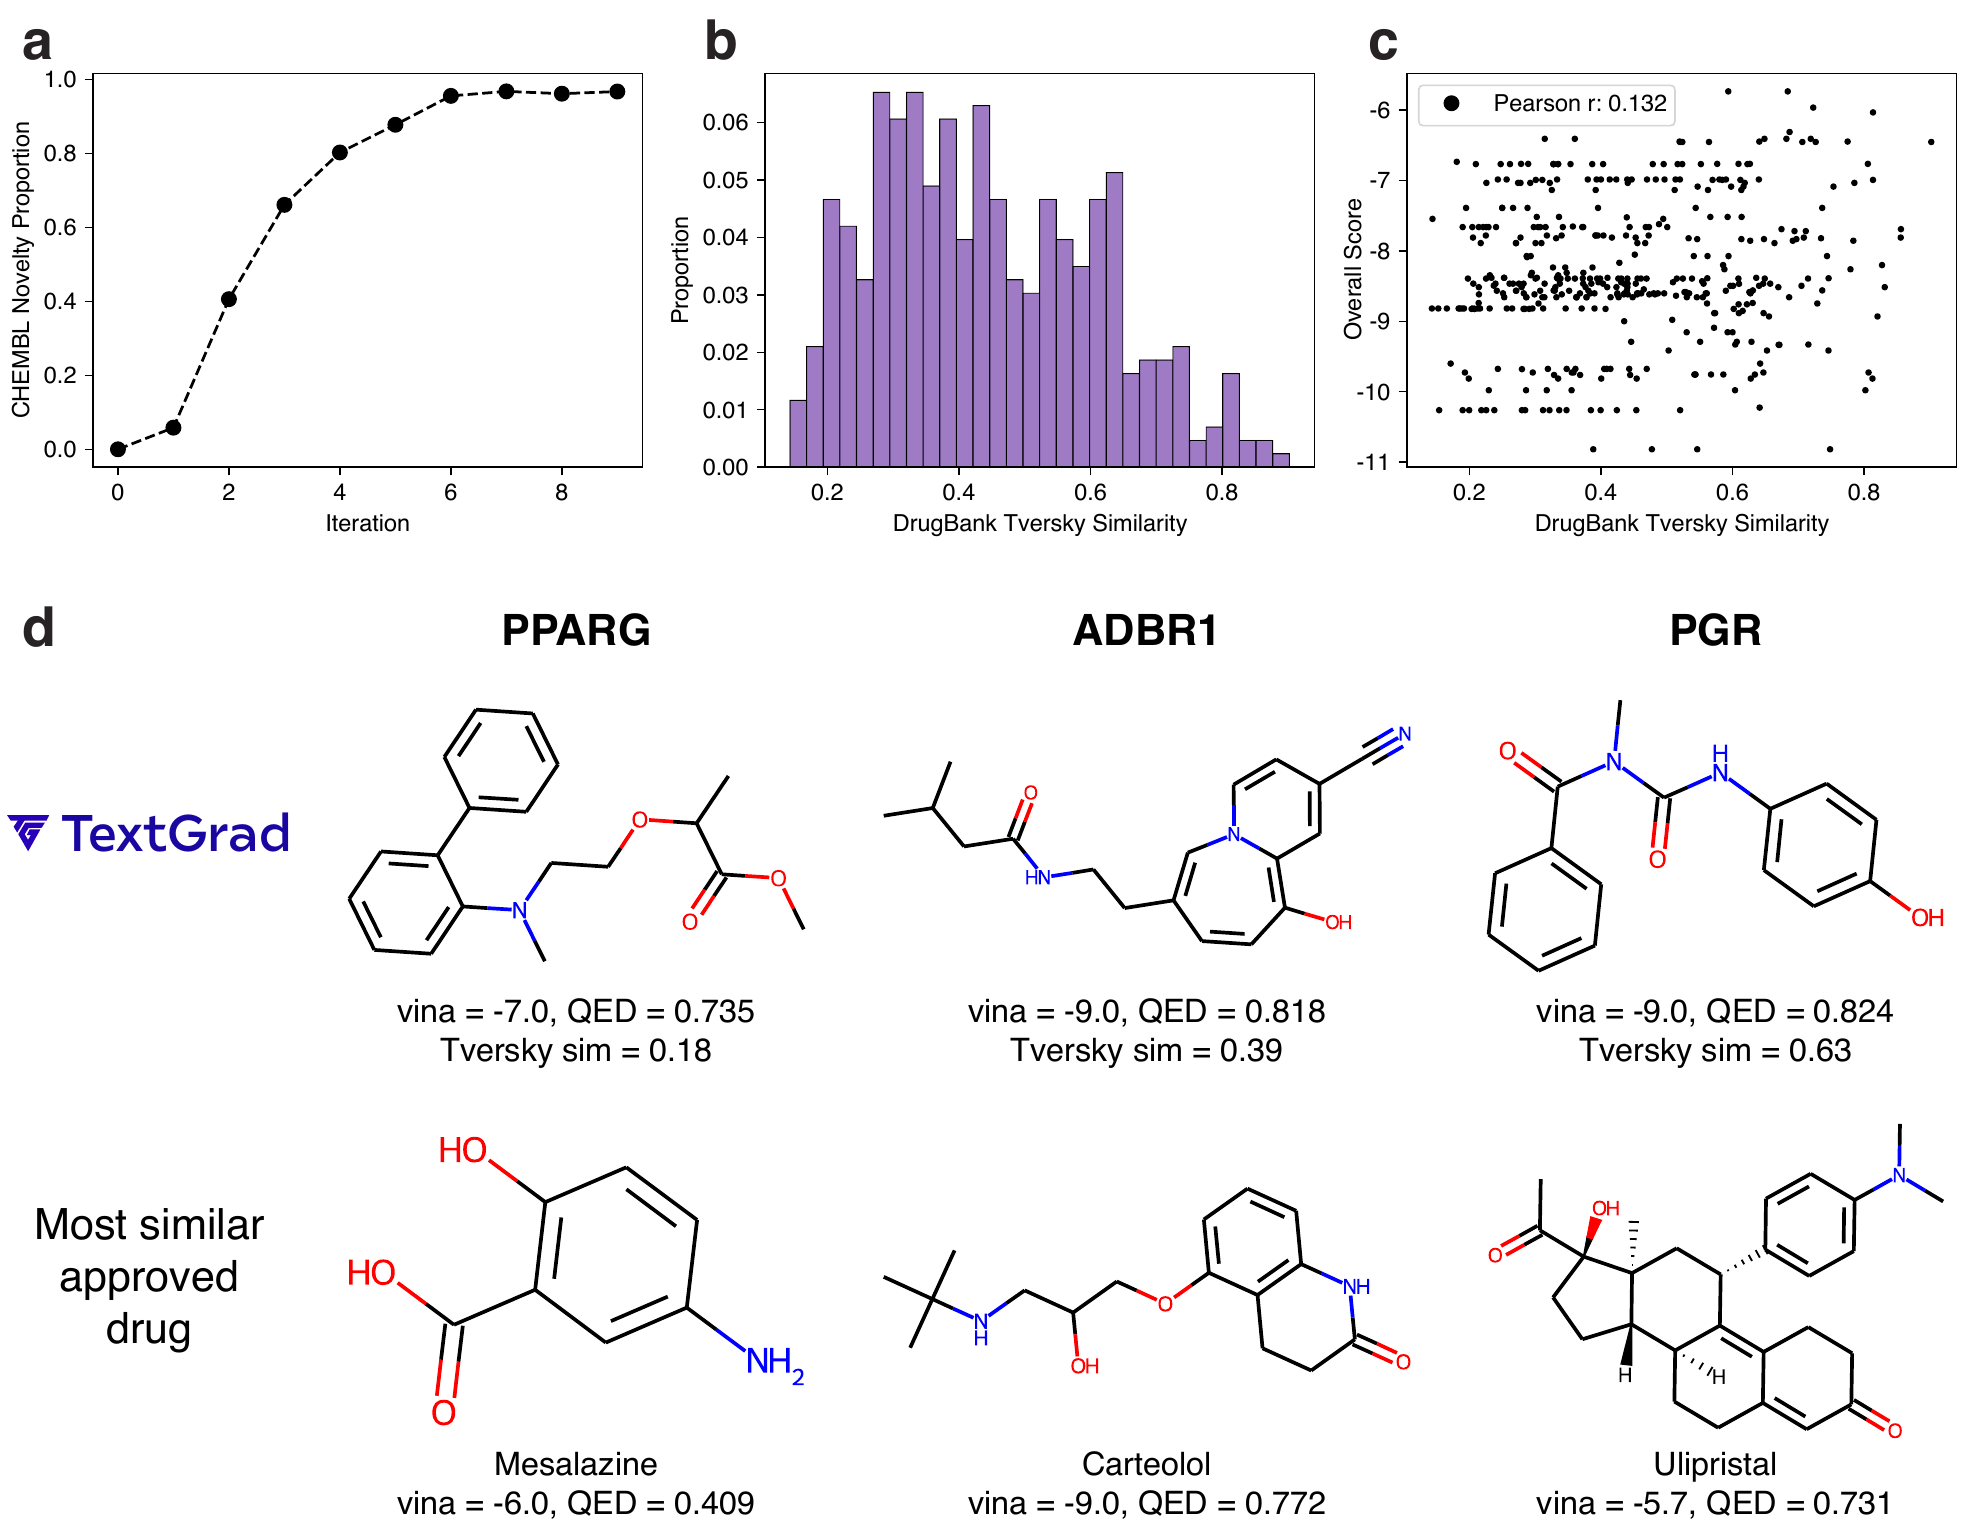
Eine der Hauptsorgen bei der Verwendung von LLM-Modellen in der wissenschaftlichen Entdeckung ist ihre Fähigkeit, ihre Trainingsdaten einfach auswendig zu lernen und wiederzugeben, anstatt logisches Schlussfolgern durchzuführen [105]. Da neuere Modelle wie gpt-4o auf massiven, undurchsichtigen Datensätzen trainiert werden, besteht eine zentrale Sorge darin, dass die von TEXTGRAD generierten Moleküle einfach Duplikate klinisch zugelassener Moleküle für ihre jeweiligen Targets sein könnten. Um das Ausmaß oder die Existenz dieses "Memorierungs"-Effekts zu quantifizieren und zu testen, vergleichen wir die von TEXTGRAD generierten Moleküle mit zugelassenen Medikamenten für ihre jeweiligen Protein-Targets sowie mit unverwandten, aber existierenden druglike chemischen Verbindungen.
Wir vergleichen zunächst die von TEXTGRAD generierten Moleküle für ein bestimmtes Protein-Target mit allen klinisch zugelassenen kleinen Molekülen, die in DrugBank für dasselbe Target zu finden sind (siehe F.3 für Filterkriterien), unter Verwendung des Tversky-Ähnlichkeitswerts auf RDKit-Daylight-Chemiefingerabdrücken. Der Tversky-Ähnlichkeitswert ist nicht symmetrisch und vergleicht Substrukturen zwischen einer Variante und einem Referenzmolekül [106]. In unserer Anwendung wird dies bevorzugt, da es generierten (Varianten-)Molekülen einen hohen Wert zuweist, die die meisten oder alle Substrukturen des DrugBank-(Referenz-)Moleküls enthalten, selbst wenn im generierten Molekül andere überflüssige Substrukturen vorhanden sind, die die symmetrische Überlappung zwischen den beiden Molekülen verringern. Ein Tversky-Wert von 1,0 zeigt an, dass das TEXTGRAD-Molekül eine vollständige Teilmenge des DrugBank-Moleküls ist, während 0,0 keineÜberlappung anzeigt.
Um die relevantesten chemischen Strukturen zu analysieren, beschränkten wir unsere Analyse auf eine Menge leistungsstarker TEXTGRAD-Moleküle statt auf alle Moleküle aus allen Iterationen. Insbesondere wählten wir unter Verwendung des in Gleichung 25 beschriebenen Gesamtscores das beste Molekül für jedes Protein-Target und für jedes Ausgangsfragment aus, insgesamt 87 generierte Moleküle (29 drugable Targets Ausgangsfragmente) und 118 klinisch zugelassene Medikamente über 29 Targets. Für jedes Target berechnen wir alle paarweisen Tversky-Werte zwischen den 3 TEXTGRAD-Molekülen und den für dieses Target zugelassenen DrugBank-Molekülen, wobei wir das DrugBank-Molekül als Referenz und das TEXTGRAD-Molekül als Variante setzen.
Wir beobachteten, dass die Verteilung der Tversky-Ähnlichkeitswerte recht breit war, mit einem Median von 0,42, aber einem Bereich von 0,14 bis 0,90 (Abbildung 2 (b)). Wir beobachten jedoch, dass die Tversky-Ähnlichkeit zwischen TEXTGRAD- und DrugBank-Molekülen tatsächlich leicht antikorreliert mit der Molekülleistung, gemessen am Gesamtscore, ist, was darauf hindeutet, dass TEXTGRADs Optimierungsverfahren bestenfalls schwach durch Vorwissen über zugelassene Medikamente beeinflusst wird. Tatsächlich weisen die generierten Moleküle für eine Vielzahl generierter Moleküle entlang eines Gradienten von Ähnlichkeitswerten QED- und Vina-Scores auf, die mit ihren DrugBank-Gegenstücken übereinstimmen oder diese sogar übertreffen (Abbildung 2 (d)).
Über die Ähnlichkeit zu bekannten Medikamenten hinaus interessiert uns auch zu beobachten, ob TEXTGRAD neuartige Moleküle generiert oder bisher unbekannte Eigenschaften in existierenden Verbindungen entdeckt, beispielsweise eine starke Bindungsaffinität zu einem Protein-Target in einer Verbindung, die nicht mit dem Protein assoziiert wurde. Um diese Frage zu beantworten, führen wir eine Tanimoto-Ähnlichkeitssuche über ganz ChEMBL durch, eine manuell kuratierte Datenbank mit 2,4 Millionen bioaktiven Molekülen mit druglike Eigenschaften [107]. Anders als der Tversky-Score misst die Tanimoto-Metrik die symmetrische Überlappung zwischen zwei chemischen Strukturen, wobei 1,0 eine exakte Übereinstimmung und 0,0 keine Überlappung anzeigt. Wir klassifizieren eine TEXTGRAD-Verbindung genau dann als "neuartig", wenn kein Molekül in ChEMBL mit einem Tanimoto-Ähnlichkeitswert über 0,80 existiert.
Während die Ausgangsfragmente bekannte Moleküle sind, beobachten wir, dass mit zunehmender Anzahl von Iterationen TEXTGRAD Moleküle generiert, die zunehmend weniger wahrscheinlich zuvor bekannte Verbindungen sind. Bis zur 6. Iteration sind 95 % aller von TEXTGRAD über alle 58 Targets und 3 Ausgangsfragmente generierten Moleküle nach den oben genannten Kriterien neuartig (Abbildung 2 (a)). Durch die Beobachtung der Trajektorien generierter Moleküle und die Analyse der textuellen Gradienten stellen wir die Hypothese auf, dass das durch die Vina- und QED-Scores bereitgestellte Feedback TEXTGRAD dazu ermutigt, den chemischen Raum jenseits bekannter Moleküle zu erkunden, indem es schrittweise Kombinationen funktioneller Gruppen hinzufügt und entfernt. Da diese chemischen Aktualisierungen eine kombinatorische Anzahl einzigartiger Strukturen bilden können, ist es plausibel, dass TEXTGRAD in einer relativ kleinen Anzahl von Iterationen zuvor unerkundete Regionen des chemischen Raums erreicht.