
3.4 Moleküloptimierung
TEXTGRAD unterstützt eine Vielzahl von Optimierungsproblemen, einschließlich Multi-Objective-Optimierungsaufgaben, wie sie häufig in wissenschaftlichen und ingenieurtechnischen Anwendungen vorkommen. In der Wirkstoffforschung beispielsweise versuchen Forschende, Moleküle zu entdecken oder zu entwerfen, die eine Vielzahl von Zielen in Bezug auf Synthetisierbarkeit, Wirksamkeit und Sicherheit maximieren [53, 54]. Um die Anwendungen von TEXTGRAD auf die Multi-Objective-Optimierung zu demonstrieren, wenden wir TEXTGRAD auf die Optimierung von Arzneimittelmolekülen an und zeigen, wie unser Framework mit computergestützten Werkzeugen interagieren und chemische Strukturen optimieren kann, um gleichzeitig ihre Bindungsaffinität und Druglikeness zu verbessern.
Aufgabe: Eine kritische Überlegung für potenzielle Arzneimittelmoleküle ist ihre Bindungsaffinität, die die Stärke der Wechselwirkungen zwischen dem Molekül und seinem Proteinziel angibt. Wirkstoffdesigner suchen nach Molekülen mit hohen Bindungsaffinitäten zu relevanten Wirkstoffzielen, da diese niedrigere und weniger häufige Dosen erfordern, um Wirksamkeit zu erzielen. Diese Affinität kann durch die freie Energie quantifiziert werden, die das Verhältnis der Wahrscheinlichkeiten zwischen gebundenen und ungebundenen Ligand-Rezeptor-Paaren beschreibt. kann mithilfe von „Docking“-Simulationen der Protein-Ligand-Bindung geschätzt werden [55, 56]. In unseren Experimenten verwenden wir den Vina-Score aus dem Autodock-Vina-Tool, einem weit verbreiteten physikbasierten Docking-Simulator [57]. Je negativer der Vina-Score, desto größer ist die Wahrscheinlichkeit, dass das Arzneimittel an sein beabsichtigtes Ziel bindet.
Potenzielle Arzneimittelmoleküle werden auch anhand ihrer Druglikeness bewertet, die abschätzt, wie sich das Molekül in vivo in Bezug auf Löslichkeit, Permeabilität, metabolische Stabilität und Transporter-Effekte verhalten wird. Moleküle mit hoher Druglikeness werden mit größerer Wahrscheinlichkeit vom Körper aufgenommen und erreichen ihre Ziele [58]. Eine beliebte Metrik für „Druglikeness“ ist der Quantitative Estimate of Druglikeness (QED)-Score, eine gewichtete zusammengesetzte Metrik wichtiger chemischer Eigenschaften wie Molekulargewicht, Lipophilie, polare Oberfläche und andere. Der QED-Score reicht von 0 bis 1, wobei 1 eine hohe Druglikeness anzeigt [59].
Obwohl es noch viele weitere Überlegungen für erfolgreiche Moleküle gibt, beschränken wir in unseren Experimenten unsere Ziele auf die Minimierung des Vina-Scores und die Maximierung des QED, da diese beiden Metriken relativ ausgereift sind. Die konkurrierenden Zielkonflikte zwischen diesen beiden Metriken machen die Optimierungsaufgabe realistisch und anspruchsvoll. Insbesondere bevorzugen Docking-Scores tendenziell größere Moleküle mit vielen funktionellen Gruppen, die die Wechselwirkungen mit einer Bindungsstelle maximieren [55, 56, 60]. Im Gegensatz dazu begünstigt die Arzneimittelähnlichkeit leichtere, einfachere Moleküle mit besseren Absorptionseigenschaften [58, 59]. Daher ist die gleichzeitige Optimierung beider Ziele nicht trivial.
Methoden: Wir wenden TEXTGRAD auf die Optimierung von Arzneimittelmolekülen an, indem wir Moleküle als SMILES-Strings kodieren und eine multikriterielle Verlustfunktion aus den Vina- und QED-Scores konstruieren. Genauer gesagt führen wir eine Instanzoptimierung über SMILES-Strings durch, wobei die von TEXTGRAD in Bezug auf die multikriterielle Verlustfunktion erzeugten Gradienten verwendet werden, um den Text, der das Molekül repräsentiert, zu aktualisieren.
Wir verwenden gpt-4o als unser LLM mit dem in Anhang F.2 aufgeführten Prompt-Text. Bei jeder Iteration wird das aktuelle Molekül bewertet, indem seine Bindungsaffinität zum Zielprotein mithilfe des Vina-Scores von Autodock Vina geschätzt wird und der QED-Score von RDKit für die Arzneimittelähnlichkeit verwendet wird (Anhang F.1). Jedes Molekül wird als ein kleines chemisches Fragment aus einer funktionellen Gruppe initialisiert. Wir wenden TEXTGRAD auf alle 58 Zielproteine im DOCKSTRING-Molekülbewertungsbenchmark [61] an. Diese 58 Zielproteine bestehen aus klinisch relevanten Proteinen, die aus einer Vielzahl struktureller Klassen entnommen wurden, von denen 29 klinisch zugelassene Arzneimittel haben. Für jedes Zielprotein optimieren wir ein Ausgangsfragment mit TEXTGRAD über 10 Iterationen für 3 einzigartige Ausgangsfragmente. Um unsere Leistung zu bewerten, vergleichen wir die Eigenschaften der von TEXTGRAD erzeugten Moleküle mit klinisch zugelassenen Arzneimitteln für das jeweilige Protein (Anhang F.3).
Ergebnisse: Für alle 58 Ziele erzeugt TEXTGRAD konsistent Moleküle mit verbesserter Bindungsaffinität und Druglikeness, unabhängig vom initialen Startfragment (Anhang F.4). Für die 29 Proteinziele mit
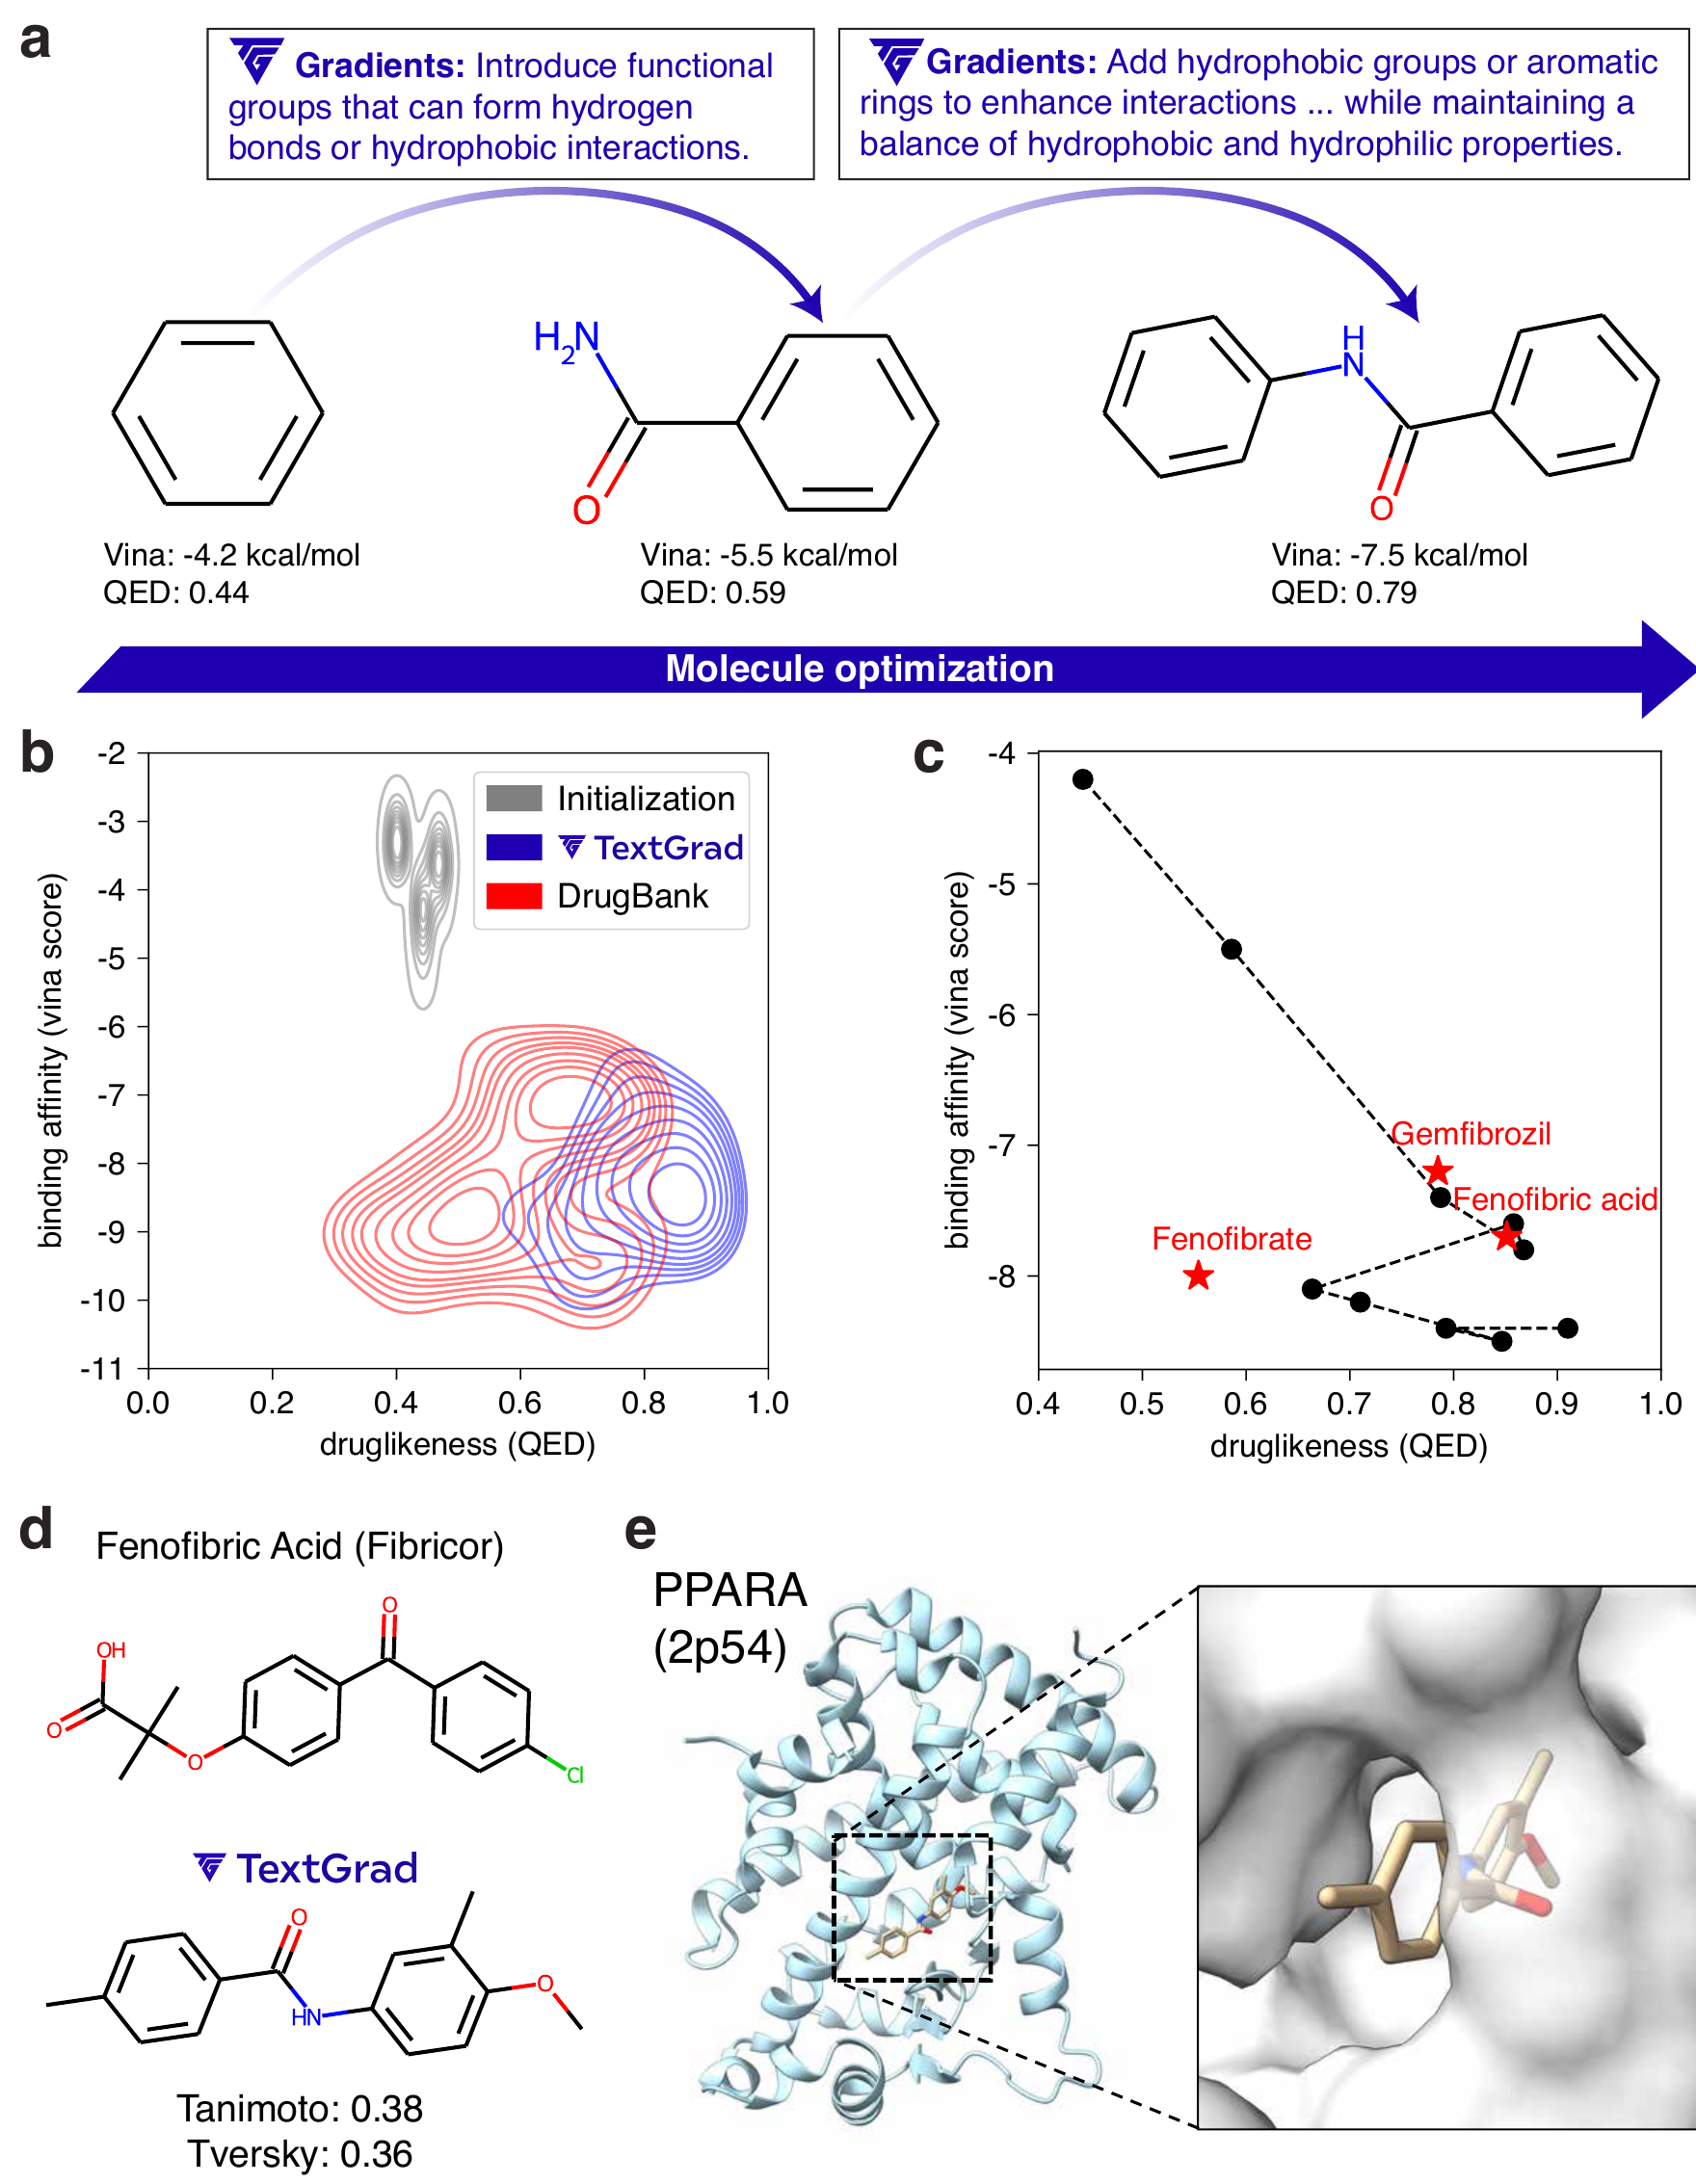
klinisch zugelassenen Arzneimitteln beobachten wir, dass TEXTGRAD Moleküle mit hochkompetitiver Affinität und Druglikeness erzeugt, verglichen mit klinischen Molekülen, die mit derselben Verlustfunktion bewertet wurden (Abbildung 2 (b)). Die resultierenden Moleküle weisen im Vergleich zu ihren klinisch zugelassenen Gegenstücken und existierenden Verbindungen einzigartige Strukturen auf (Anhang F.5), während sie ähnliche In-silico-Sicherheitsprofile beibehalten (Anhang F.6). Obwohl es alternative maschinelle Lernmethoden zur de-novo-Molekülgenerierung gibt, bietet TEXTGRAD zwei entscheidende Vorteile gegenüber seinen Gegenstücken: Erstens erzielt TEXTGRAD durch die Kombination traditioneller Chemoinformatik-Werkzeuge mit den allgemeinen Wissens- und Reasoning-Fähigkeiten von LLMs kompetitive Ergebnisse selbst ohne vorherigen Trainingsdatensatz. Zweitens erzeugt TEXTGRADs Framework natürlicher Sprachgradienten erklärbare Entscheidungen, wodurch Forschende genau verstehen können, wie und warum die Struktur eines Moleküls konstruiert wurde. Zusammen genommen eröffnen diese beiden Eigenschaften eine vielversprechende Zukunft für die Rolle von KI-Agenten in der wissenschaftlichen Entdeckung.