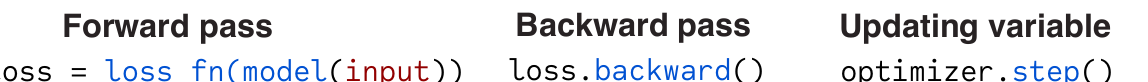TextGrad: Automatic "Differentiation" via Text Mert Yuksekgonul et al.
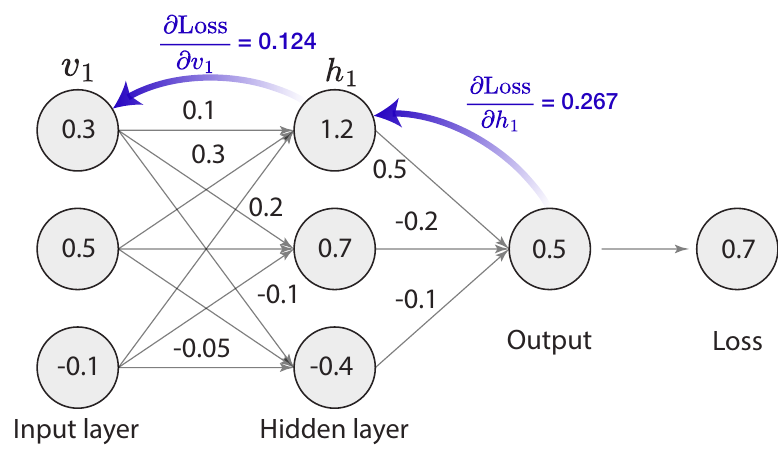
示例计算图。在传统自动微分中,我们计算梯度,它提供了根据下游损失改进变量的方向,并遵循链式法则。作为一个简单的类比,让我们看一个简单系统:
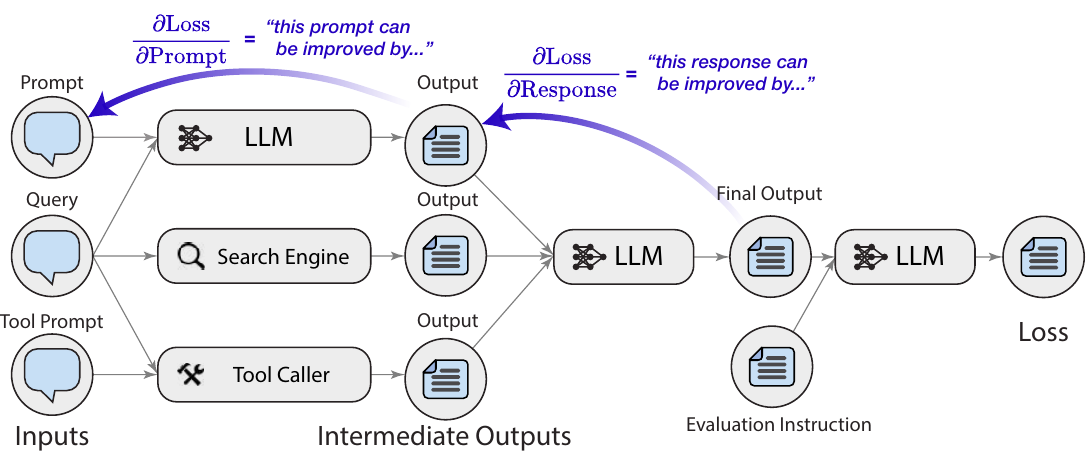
查看原页 P r e d i c t i o n = L L M ( P r o m p t + Q u e s t i o n ) , E v a l u a t i o n = L L M ( E v a l u a t i o n + P r e d i c t i o n ) , ( 1 ) \begin{array}{r}\mathrm{Prediction} = \mathrm{LLM}(\mathrm{Prompt} + \mathrm{Question}),\\ \mathrm{Evaluation} = \mathrm{LLM}(\mathrm{Evaluation} + \mathrm{Prediction}), \end{array} \quad (1) Prediction = LLM ( Prompt + Question ) , Evaluation = LLM ( Evaluation + Prediction ) , ( 1 ) 查看原页 查看原页 b 黑盒AI系统和使用自然语言“梯度”的反向传播
查看原页 查看原页 PyTorch和TextGrad共享相同的反向传播和优化语法。
查看原页 查看原页 查看原页 查看原页 查看原页 查看原页 你将回答一个推理问题。逐步思考。你回答的最后一行应采用以下格式:‘Answer: ’SVAULE‘,其中VALUEl是一个数值。
查看原页 你将回答一个推理问题。以清晰一致的格式列出每个项目及其数量,例如‘- Item: Quantity’。直接从列表中求和这些值,并提供简洁的求和结果。确保最终答案以以下格式清楚标明:‘Answer: ’SVAULE‘,其中VALUEl是一个数值。验证每个项目与查询上下文的相关性,并处理输入中的潜在错误或歧义。仔细检查最终计数以确保准确性。”
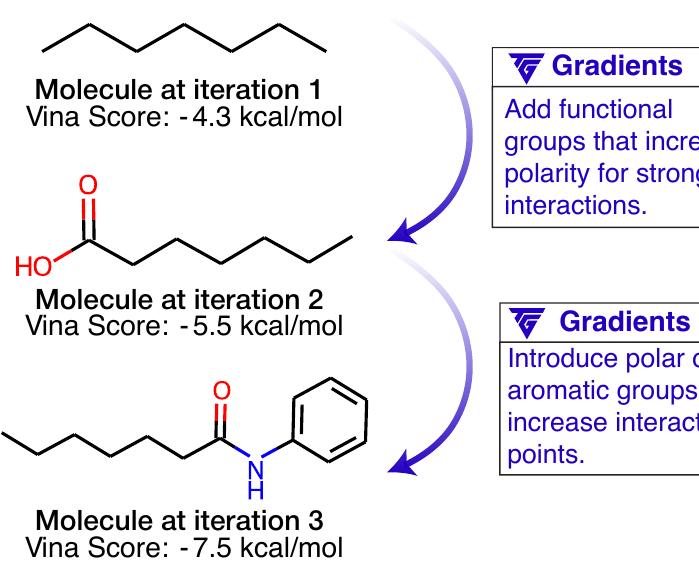
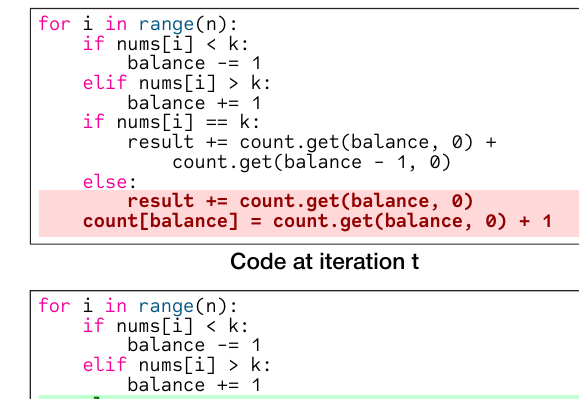
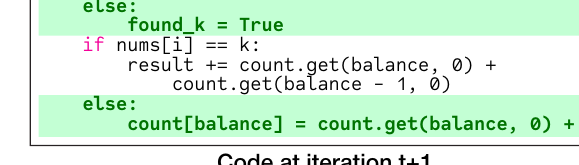
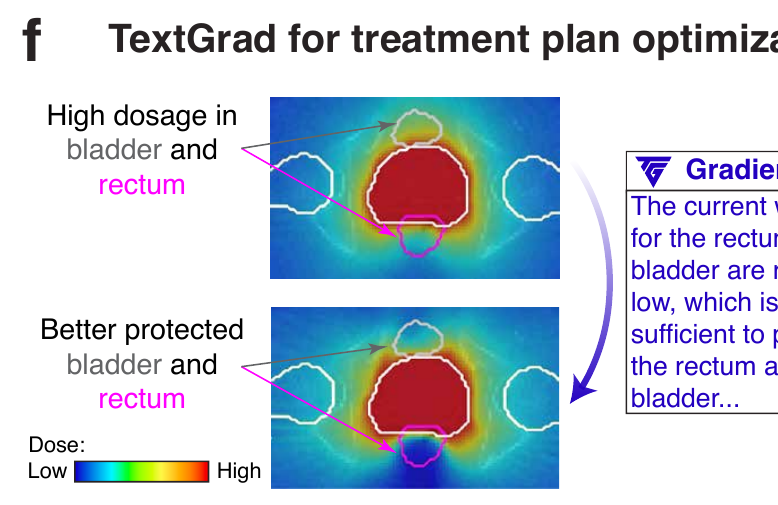
查看原页 图1:通过文本进行自动“微分”(a, b)。梯度的反向传播是深度学习的驱动力。对于黑盒AI系统的复合系统,我们没有梯度,但我们可以为基于文本的反馈构建类似的反向传播,这构成了TEXTGRAD的基础。TEXTGRAD中的抽象(c)。我们与PyTorch共享相同的抽象和语法,使我们的框架具有泛化性且易于学习。TEXTGRAD的应用(d,e,f,g)。在第3.4节中,我们优化分子结构以获得类药性和蛋白质结合亲和力等性质(d)。在第3.1节中,我们优化编码问题的解决方案(e)。在第3.5节中,我们优化放射治疗计划以改善患者结果(f)。在第3.3节中,我们优化提示以改进语言模型的推理(g)。 其中我们用绿色表示待优化的自由参数,即提示,并用 + + + 表示两个字符串的拼接,用 L L M ( x ) \mathrm{LLM}(x) LLM ( x ) 表示将 x x x 作为提示提供给语言模型以收集响应。我们将使用链式记号:
查看原页 P r o m p t + Q u e s t i o n → L L M E v a l u a t i o n I n s t r u c t i o n + P r e d i c t i o n → L L M E v a l u a t i o n , ( 3 ) \mathrm{Prompt} + \mathrm{Question} \xrightarrow{\mathrm{LLM}} \mathrm{Evaluation} \mathrm{Instruction} + \mathrm{Prediction} \xrightarrow{\mathrm{LLM}} \mathrm{Evaluation}, \quad (3) Prompt + Question LLM Evaluation Instruction + Prediction LLM Evaluation , ( 3 ) 查看原页 作为表示该系统的另一种方式,其中我们进行一次LLM调用以使用Prompt为Question生成Prediction,另一次LLM调用评估该Prediction。
查看原页 示例梯度计算。在这个示例系统中,为了根据评估改进Prompt,我们通过以下方式实例化反向传播[19]算法的类比:
查看原页 简单图的梯度计算:Prompt → L L M \xrightarrow{\mathrm{LLM}} LLM Prediction → L L M \xrightarrow{\mathrm{LLM}} LLM Evaluation
查看原页 ∂ E v a l u a t i o n ∂ P r o m p t = ∂ E v a l u a t i o n ∂ P r e d i c t i o n ⋅ ∂ P r e d i c t i o n ∂ P r o m p t = ∇ L L M ( P r e d i c t i o n , E v a l u a t i o n ) , ( 4 ) \frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prompt}} = \frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prediction}}\cdot \frac{\partial\mathrm{Prediction}}{\partial\mathrm{Prompt}} = \nabla_{\mathrm{LLM}}(\mathrm{Prediction},\mathrm{Evaluation}), \quad (4) ∂ Prompt ∂ Evaluation = ∂ Prediction ∂ Evaluation ⋅ ∂ Prompt ∂ Prediction = ∇ LLM ( Prediction , Evaluation ) , ( 4 ) 查看原页 其中当前向函数是LLM调用时,我们使用 ∇ L L M \nabla_{\mathrm{LLM}} ∇ LLM 表示梯度算子。特别地,该函数返回自然语言反馈,例如“该预测可以通过……改进”,其中反馈描述了如何修改变量以改进下游目标,类似于优化中的梯度。我们首先使用评估收集对Prediction变量的反馈。然后,给定该反馈以及(Prompt → L L M \xrightarrow{\mathrm{LLM}} LLM Prediction)调用,我们收集关于Prompt的反馈。
查看原页 “请注意,我们对记号进行了重载,使其既表示输出变量没有后继节点的情况(例如 ∇ L L M ( P r e d i c t i o n , E v a l u a t i o n ) \nabla_{\mathrm{LLM}}(\mathrm{Prediction},\mathrm{Evaluation}) ∇ LLM ( Prediction , Evaluation ) ),也表示其有后继节点、因而有梯度的情况(例如 ∇ L L M ( P r o m p t , P r e d i c t i o n , ∂ L o s s ∂ P r e d i c t i o n ) \nabla_{\mathrm{LLM}}(\mathrm{Prompt},\mathrm{Prediction},\frac{\partial\mathrm{Loss}}{\partial\mathrm{Prediction}}) ∇ LLM ( Prompt , Prediction , ∂ Prediction ∂ Loss ) )。
查看原页 下面是一种灵活实例化 ∇ L L M \nabla_{\mathrm{LLM}} ∇ LLM 的方式,用于为诸如 x → L L M y → L L M L x \xrightarrow{\mathrm{LLM}} y \xrightarrow{\mathrm{LLM}} \mathcal{L} x LLM y LLM L 这样的简单系统收集反馈:
查看原页 \[\begin{array}{r l} & {\frac{\partial\mathcal{L}}{\partial x} = \nabla_{\mathrm{LLM}}(x,y,\frac{\partial\mathcal{L}}{\partial y})\triangleq \mathrm{"H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad +\qquad}\\ & {\qquad \mathrm{LLM}(\mathrm{H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad \mathrm{Below~a r e~t h e~c r i t i c i s m s~o n~\{y\} :}}\\ & {\qquad \left\{\frac{\partial\mathcal{L}}{\partial y}\right\}}\\ & {\qquad \mathrm{Explain~h o w~t o~i m p r o v e~\{x\} .),} \end{array} \quad (6)\] 查看原页 其中梯度对象是该变量出现时所处上下文与从 L L M a \mathrm{LLM}^a LLM a 获得的反馈的组合,其定义方式类似于 Pryzant 等人 [25] 的定义。请注意,该算子不依赖于例如应用领域。一旦实现,用于 LLM 调用的梯度算子在所有应用的整个框架中都是固定的。
查看原页 a我们实际使用的提示词有所不同,以确保通用性和灵活性;此处使用这些示例仅用于说明。
查看原页 示例优化器。在标准梯度下降中,变量的当前值通过减法与梯度结合,例如:
查看原页 θ n e w = G r a d i e n t D e s c e n t . s t e p ( θ , ∂ L ∂ θ ) = θ − ∂ L ∂ θ . ( 7 ) \theta_{\mathrm{new}} = \mathrm{GradientDescent.step}(\theta ,\frac{\partial\mathcal{L}}{\partial\theta}) = \theta -\frac{\partial\mathcal{L}}{\partial\theta}. \quad (7) θ new = GradientDescent.step ( θ , ∂ θ ∂ L ) = θ − ∂ θ ∂ L . ( 7 ) 查看原页 延续基于梯度的优化类比,我们使用文本梯度下降(TGD):
查看原页 通过 TGD 更新简单图中的 Prompt 变量。
查看原页 P r o m p t n e w = T G D . s t e p ( P r o m p t , ∂ E v a l u a t i o n ∂ P r o m p t ) . ( 8 ) \mathrm{Prompt}_{\mathrm{new}} = \mathrm{TGD.step}(\mathrm{Prompt},\frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prompt}}). \quad (8) Prompt new = TGD.step ( Prompt , ∂ Prompt ∂ Evaluation ) . ( 8 ) 查看原页 为了更新参数,在本例中即Prompt。具体而言,给定当前变量以及我们为该变量收集的梯度(反馈),优化器寻求更新该变量。
查看原页 x n e w = T G D . s t e p ( x , ∂ L ∂ x ) ≜ L L M ( B e l o w a r e t h e c r i t i c i s m s o n { x } ; { ∂ L ∂ x } I n c o r p o r a t e t h e c r i t i c i s m s , a n d p r o d u c e a n e w v a r i a b l e . ) . ( 9 ) \begin{array}{r l} & {x_{\mathrm{new}} = \mathrm{TGD.step}(x,\frac{\partial\mathcal{L}}{\partial x})\triangleq \mathrm{LLM}(\mathrm{Below~are~the~criticisms~on~}\{x\} ;}\\ & {\qquad \left\{\frac{\partial\mathcal{L}}{\partial x}\right\}}\\ & {\qquad \mathrm{Incorporate~the~criticisms,~and~produce~a~new~variable.~).}} \end{array} \quad (9) x new = TGD.step ( x , ∂ x ∂ L ) ≜ LLM ( Below are the criticisms on { x } ; { ∂ x ∂ L } Incorporate the criticisms , and produce a new variable. ) . ( 9 ) 查看原页 其中 x x x 是我们想要改进的变量, ∂ L ∂ x \frac{\partial\mathcal{L}}{\partial x} ∂ x ∂ L 是我们在反向传播过程中为该变量获得的反馈。 与梯度算子类似,该函数也不依赖于应用领域,并且TGD的实现在该框架的所有使用中都是相同的。
查看原页 a 我们使用的确切提示词有所不同,以确保通用性和灵活性;我们使用这些示例仅用于说明。
查看原页 新用户注册即送 $1 免费额度,把你自己的 PDF 也做成同款电子书