
F.5 化学新颖性
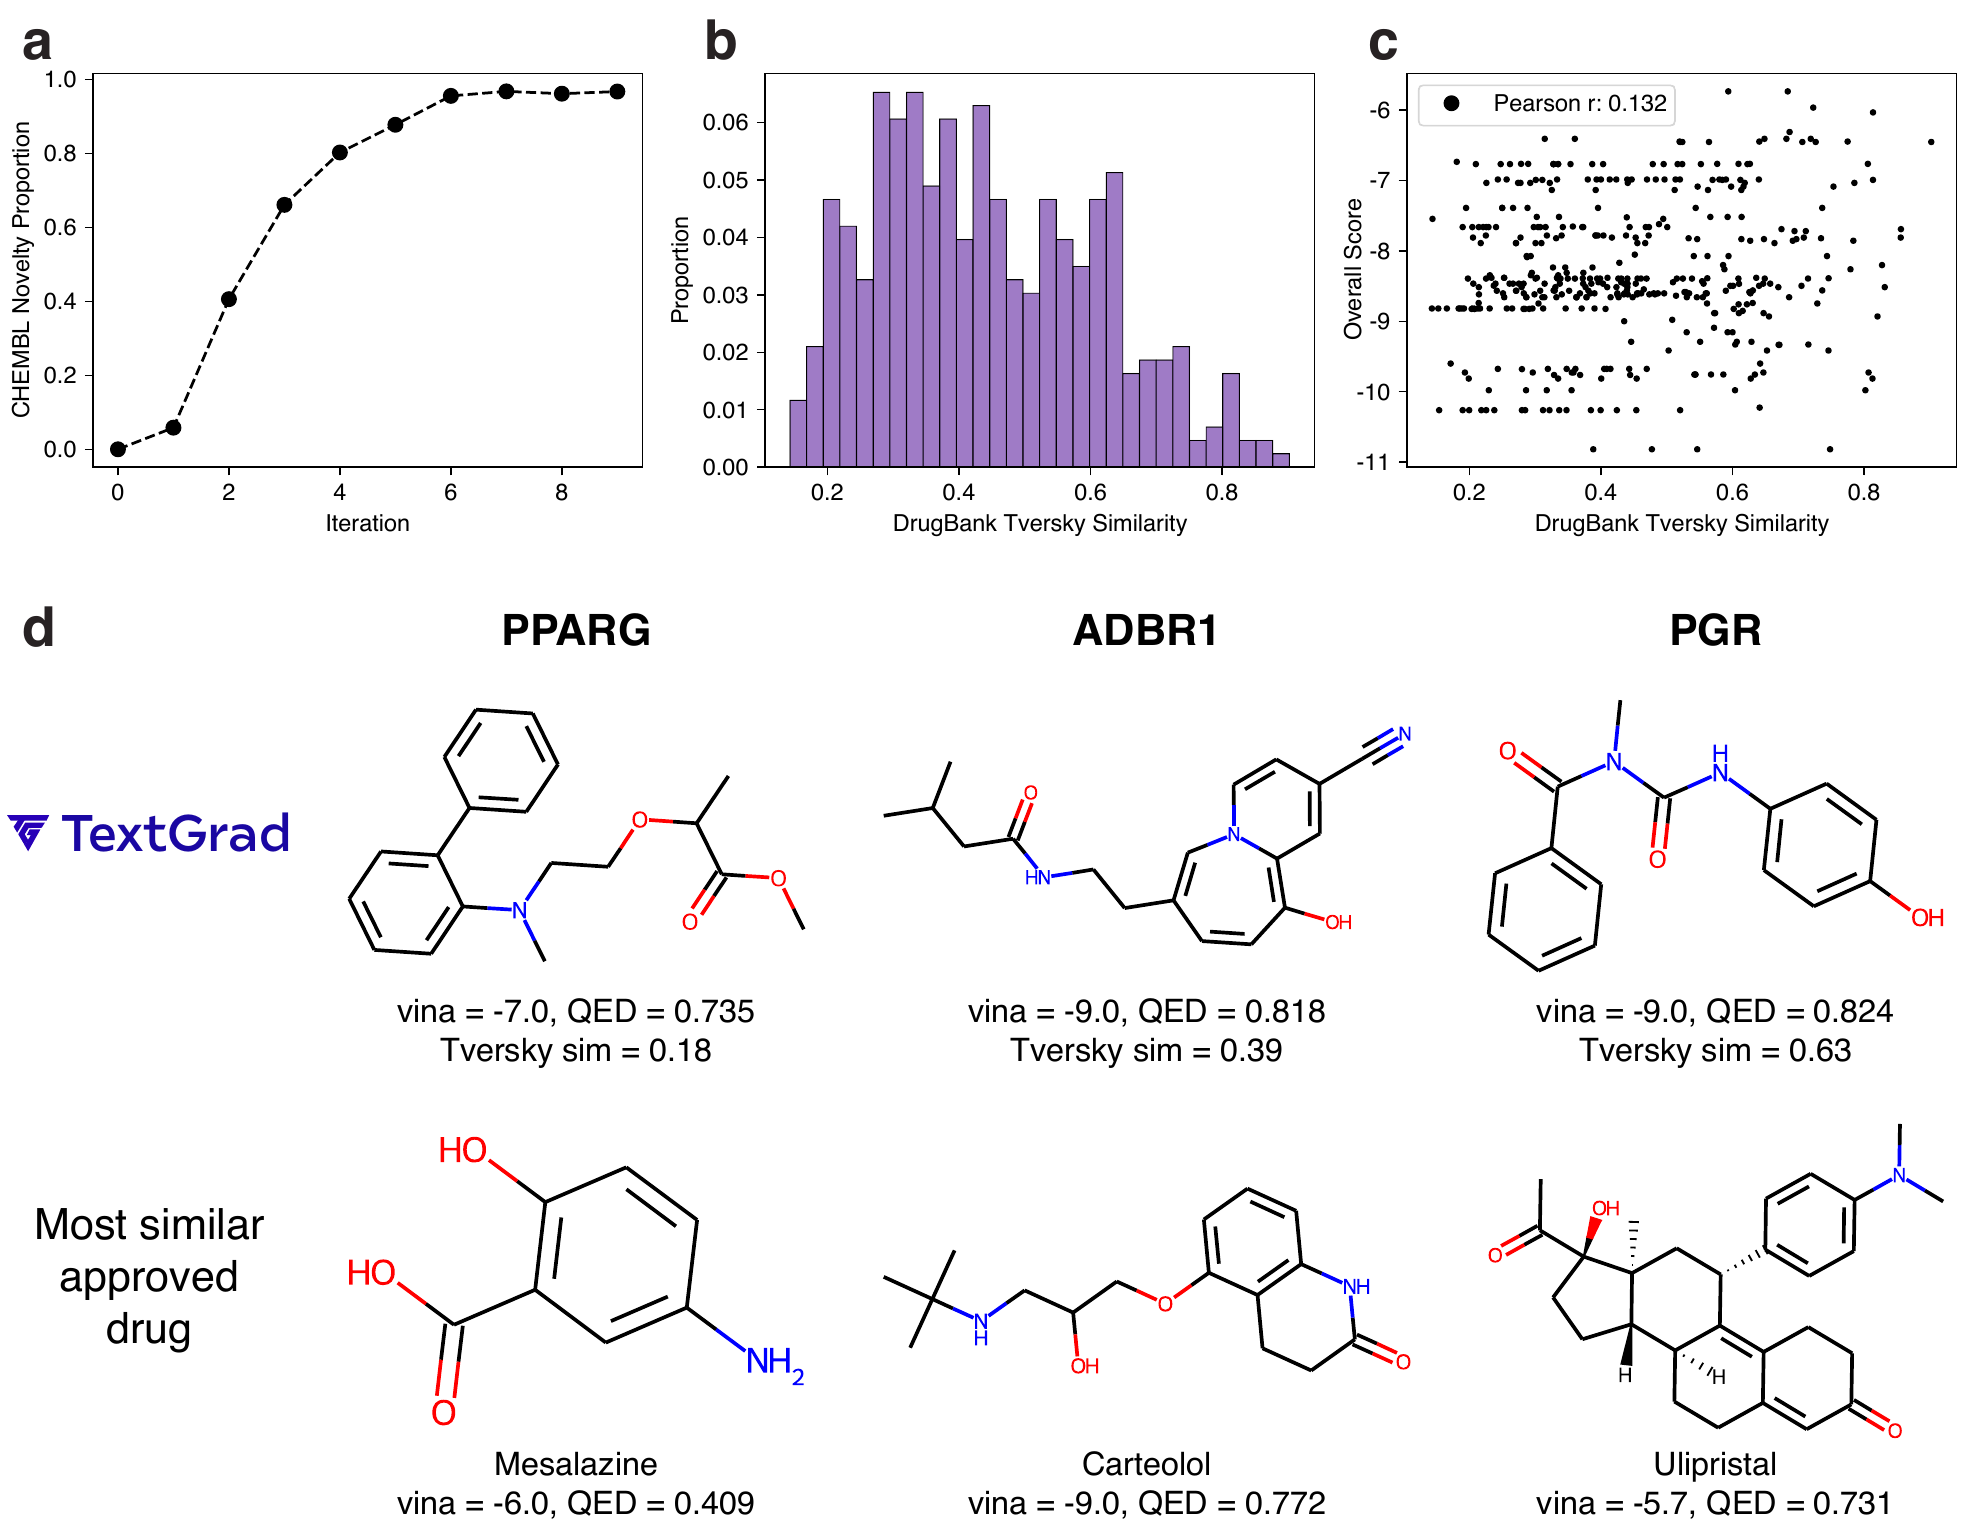
在科学发现中使用 LLM 模型的主要担忧之一是其仅仅记忆和复述训练集而非进行逻辑推理的能力 [105]。由于像 gpt-4o 这样的近期模型是在海量、不透明的数据集上训练的,一个关键担忧是 TEXTGRAD 生成的分子可能只是针对其各自靶标的临床批准分子的重复。为了量化和测试这种“记忆”效应的程度或存在性,我们将 TEXTGRAD 生成的分子与其各自蛋白靶标的批准药物,以及无关但现有的类药化合物进行比较。
我们首先使用 RDKit daylight 化学指纹上的 Tversky 相似度分数,将针对特定蛋白靶标的 TEXTGRAD 生成分子与 DrugBank 中针对同一靶标找到的所有临床批准小分子进行比较(筛选标准见 F.3)。Tversky 相似度分数不是对称的,它比较变体分子和参考分子之间的子结构 [106]。在我们的应用中,这更可取,因为它为生成(变体)分子赋予高分,这些分子包含 DrugBank(参考)分子中的大部分或全部子结构,即使生成分子中存在其他多余子结构从而降低了两者之间的对称重叠。Tversky 分数为 1.0 表示 TEXTGRAD 分子是 DrugBank 分子的完全子集,而 0.0 表示没有重叠。
为了分析最相关的化学结构,我们将分析限制在一组高性能的 TEXTGRAD 分子上,而不是所有迭代中的所有分子。特别地,使用公式 25 中描述的总体分数,我们为每个蛋白靶标和每个初始片段选择了最佳分子,总共得到 87 个生成分子(29 个可成药靶标 个初始片段)和跨 29 个靶标的 118 种临床批准药物。对于每个靶标,我们计算 3 个 TEXTGRAD 分子与该靶标批准的 DrugBank 分子之间的所有成对 Tversky 分数,将 DrugBank 分子设为参考,TEXTGRAD 分子设为变体。
我们观察到,Tversky相似度得分的分布相当宽泛,中位数为0.42,但范围从0.14到0.90(图2(b))。然而,我们观察到TEXTGRAD与DrugBank分子之间的Tversky相似度实际上与以总体得分衡量的分子性能略呈负相关,这表明TEXTGRAD的优化过程至多仅微弱地受到已批准药物先验知识的影响。事实上,对于沿相似度得分梯度生成的各种分子,所生成的分子表现出与DrugBank对应物相当甚至超过后者的QED和Vina得分(图2(d))。
除了与已知药物的相似性之外,我们还有兴趣观察TEXTGRAD是在生成新分子,还是在现有化合物中发现此前未知的性质,例如某种化合物与某个蛋白质靶点具有强结合亲和力,而该化合物此前并未与该蛋白质相关联。为了回答这个问题,我们在整个ChEMBL中执行Tanimoto相似性搜索,ChEMBL是一个经过人工整理的数据库,包含240万个具有类药性质的生物活性分子[107]。与Tversky得分不同,Tanimoto度量衡量两个化学结构之间的对称重叠,其中1.0表示完全匹配,0.0表示无重叠。当且仅当ChEMBL中不存在任何Tanimoto相似度得分超过0.80的分子时,我们将TEXTGRAD化合物分类为“新颖”。
虽然起始片段是已知分子,但我们观察到,随着迭代次数增加,TEXTGRAD生成的分子逐渐不太可能是此前已知的化合物。到第6次迭代时,在所有58个靶点和3个起始片段上,TEXTGRAD生成的所有分子中有95%按照上述标准是新颖的(图2(a))。通过观察生成分子的轨迹并分析文本梯度,我们假设Vina和QED得分提供的反馈鼓励TEXTGRAD通过逐步添加和移除官能团组合来探索已知分子之外的化学空间。由于这些化学更新可以形成组合数量的独特结构,因此TEXTGRAD在相对较少的迭代次数内到达此前未探索的化学空间区域是合理的。