
3.4 分子优化
TEXTGRAD 支持多种优化问题,包括科学和工程应用中常见的多目标优化任务。例如,在药物发现中,研究人员寻求发现或设计在可合成性、有效性和安全性方面最大化各种目标的分子 [53, 54]。为了展示 TEXTGRAD 在多目标优化中的应用,我们将 TEXTGRAD 应用于药物分子优化,并展示我们的框架如何与计算工具对接,并优化化学结构以同时提高其结合亲和力和成药性。
任务:潜在药物分子的一个关键考虑因素是其结合亲和力,它表示分子与其蛋白质靶标之间相互作用的强度。药物设计者寻求对相关药物靶标具有高结合亲和力的分子,因为它们需要更低且更少的剂量即可实现疗效。这种亲和力可以通过自由能 来量化,它描述了结合与未结合配体-受体对之间的概率比。 可以使用蛋白质-配体结合的“对接”模拟来估计 [55, 56]。在我们的实验中,我们采用 Autodock Vina 工具中的 Vina 分数,这是一个广泛使用的基于物理的对接模拟器 [57]。Vina 分数越负,药物与其预期靶标结合的概率就越大。
潜在药物分子还通过其成药性进行评估,成药性估计分子在体内关于溶解度、渗透性、代谢稳定性和转运体效应的行为。具有高成药性的分子更可能被身体吸收并到达其靶标 [58]。“成药性”的一个流行指标是药物相似性定量估计(QED)分数,它是分子量、亲脂性、极性表面积等重要化学特征的加权复合指标。QED 分数范围为 0 到 1,其中 1 表示高成药性 [59]。
尽管成功分子还有许多其他考虑因素,但在我们的实验中,由于这两个指标相对成熟,我们将目标限制为最小化 Vina 分数和最大化 QED。这两个指标之间相互竞争的权衡使优化任务既现实又具有挑战性。具体而言,对接分数往往偏好具有许多官能团、能最大化与结合位点相互作用的大型分子 [55, 56, 60]。相反,成药性鼓励具有更好吸收性质的更轻、更简单的分子 [58, 59]。因此,同时优化这两个目标并非易事。
方法:我们通过将分子编码为 SMILES 字符串,并从 Vina 和 QED 分数构建多目标损失,将 TEXTGRAD 应用于药物分子优化。也就是说,我们对 SMILES 字符串进行实例优化,其中 TEXTGRAD 针对多目标损失生成的梯度用于更新表示分子的文本。
我们使用 gpt-4o 作为我们的 LLM,提示文本见附录 F.2。在每次迭代中,通过使用 Autodock Vina 的 Vina 分数估计当前分子与靶标蛋白的结合亲和力,并使用 RDKit 的 QED 分数评估成药性,从而对当前分子进行评估(附录 F.1)。每个分子初始化为来自官能团的小化学片段。我们将 TEXTGRAD 应用于 DOCKSTRING 分子评估基准中的所有 58 个靶标 [61]。这 58 个靶标由从多种结构类别中采样的临床相关蛋白质组成,其中 29 个已有临床批准药物。对于每个靶标,我们使用 TEXTGRAD 对起始片段优化 10 次迭代,针对 3 个唯一初始片段。为了评估我们的性能,我们将 TEXTGRAD 生成的分子特征与相应蛋白质的临床批准药物进行比较(附录 F.3)。
结果:对于所有58个靶标,TEXTGRAD均能一致地生成具有改善的结合亲和力和类药性的分子,而与初始起始片段无关(附录F.4)。对于29个已有临床批准药物的蛋白质靶标,我们观察到,与使用相同损失函数评估的临床分子相比,
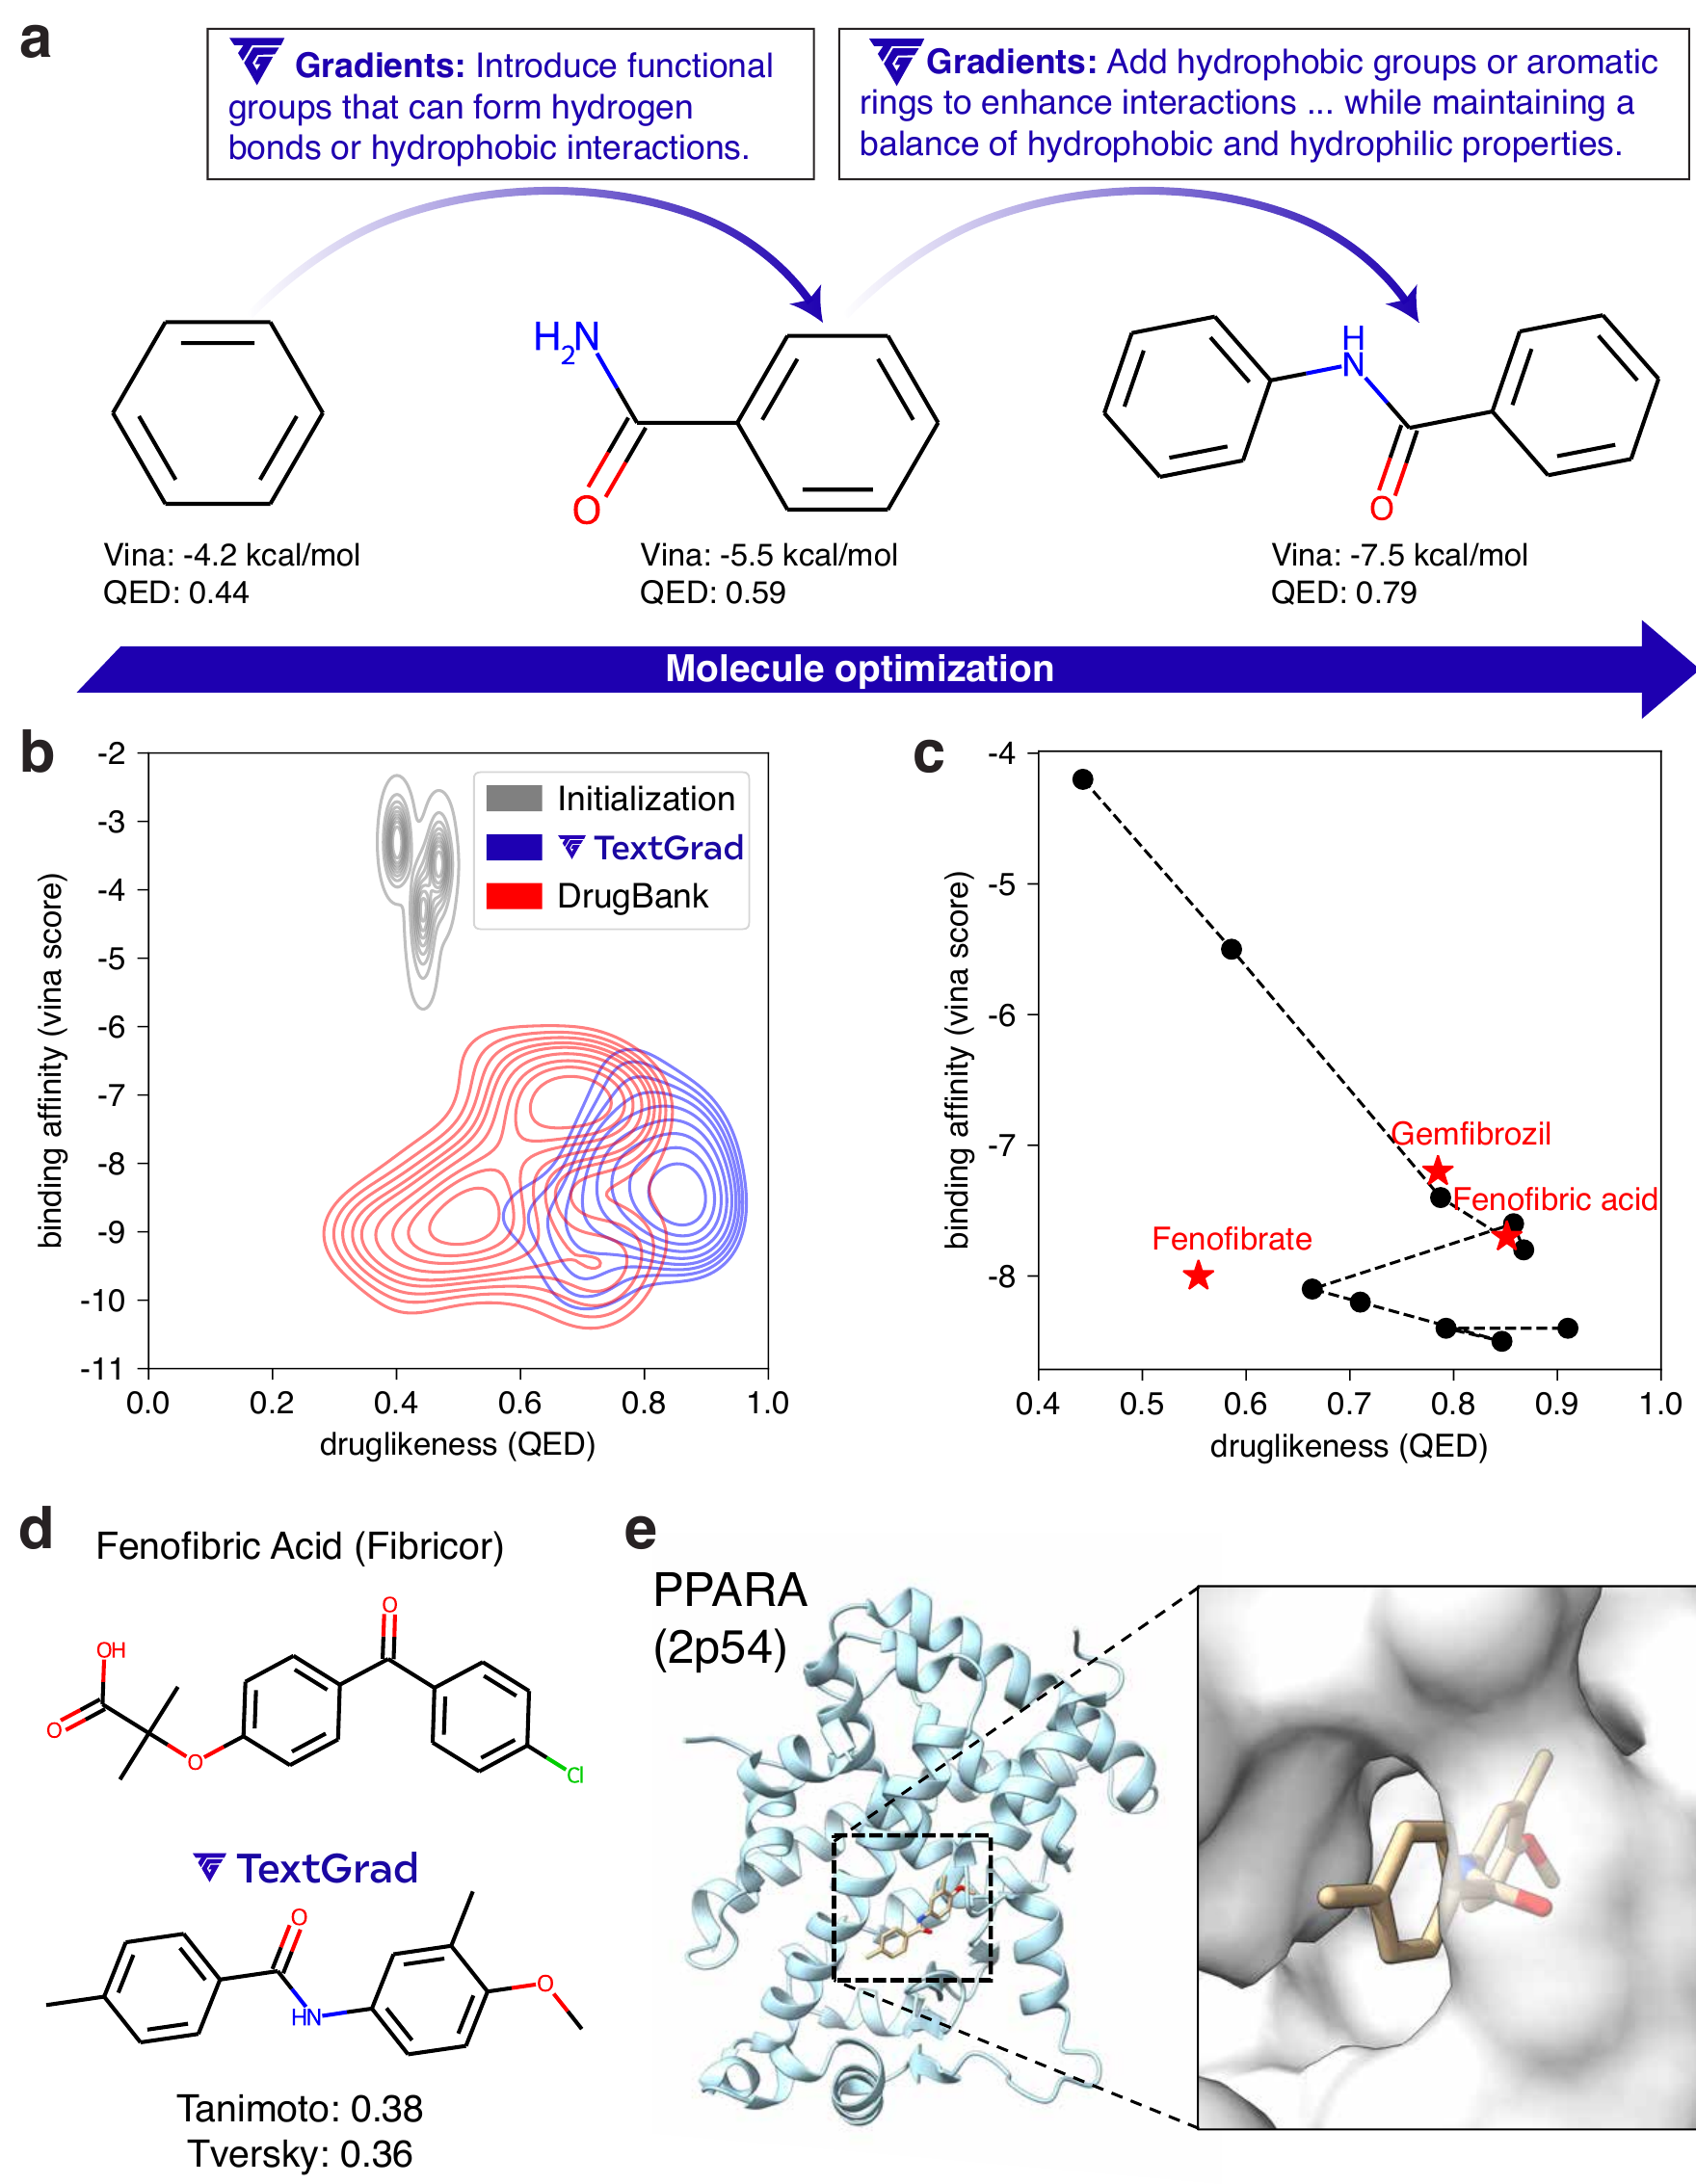
TEXTGRAD生成的分子具有极具竞争力的亲和力和类药性(图2(b))。所得分子与临床批准的对应物及现有化合物相比表现出独特的结构(附录F.5),同时保持相似的计算机安全特征(附录F.6)。尽管存在其他用于从头分子生成的机器学习方法,但TEXTGRAD相较同类方法具有两个关键优势:首先,通过将传统化学信息学工具与LLM的通用知识和推理能力相结合,TEXTGRAD即使在没有先验训练集的情况下也能产生有竞争力的结果。其次,TEXTGRAD的自然语言梯度框架产生可解释的决策,使研究人员能够精确理解分子结构是如何以及为何被构建的。这两项特性共同为AI智能体在科学发现中的作用展现了充满希望的未来。