
A.1 变量
变量是计算图中的节点。以下是变量最重要的属性:
1. 值(Value)是变量包含的非结构化数据。在本手稿中,所有值均为文本数据。
2. 角色描述(Role description)是一个信息性字符串,描述变量在计算图中的角色。我们使用这些角色让用户将知识注入图中并引导优化行为。更多信息见下文。
3. 梯度(Gradients)是LLM在反向传播过程中提供的自然语言反馈。这些描述了应对变量做出的更改,以便改善下游损失。关于填充梯度的反向操作示例,请阅读A.3节。
4. 前驱(Predecessors)是用于生成给定变量的一组变量。例如,如果我们向LLM给出指令并获得响应,则指令将是响应的前驱。在反向传播过程中,后继变量上的梯度被传递给其前驱,以提供关于如何改善下游目标的指导。
5. 需要梯度(Requires grad)指示在反向传播过程中是否将填充梯度,类似于PyTorch。例如,如果用户不希望为某个问题计算梯度,只需写Variable(value=question, requires_grad=False, ...)来表示这一点。
角色描述:在TEXTGRAD中,每个变量都有一个角色描述。具体来说,这是一个描述变量在计算图中角色的字符串,例如对语言模型的系统提示或语言模型的预测。虽然有时会自动填充,但角色描述通常是用户将知识注入优化过程的主要方式之一。
经验上,我们发现角色描述能够显著引导优化过程。例如,将预测的角色设定为语言模型的最终数值答案,会引导文本梯度下降优化器——该优化器提示语言模型利用反馈来更新变量的值——将变量更新为仅为一个数值。相比之下,诸如“解决方案的推理过程和最终预测”这样的角色描述,则会引导优化器在生成最终预测的同时生成推理过程。
以下是一个使用示例:
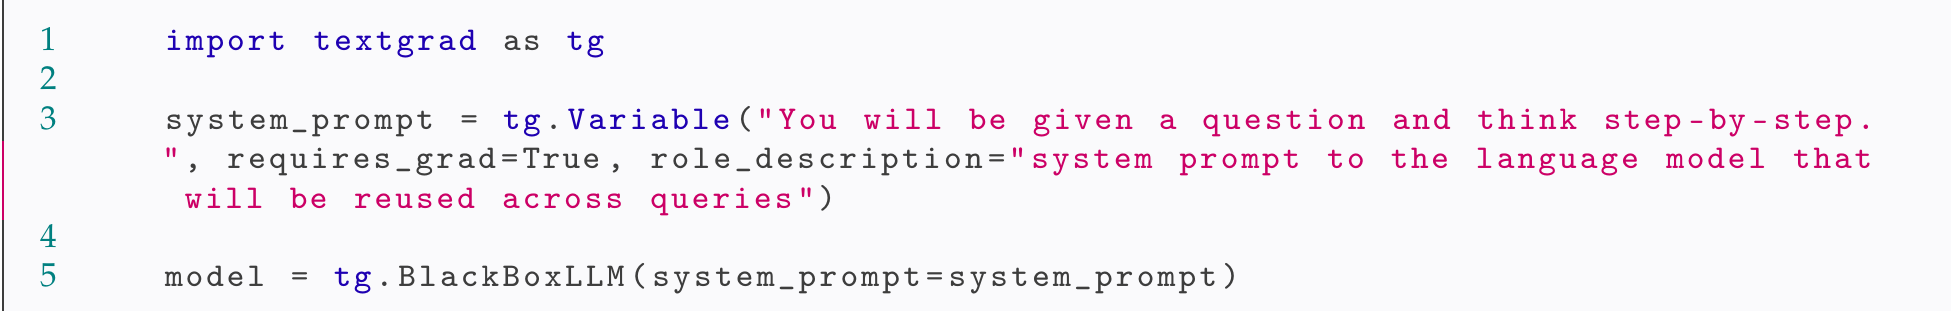
代码片段3:角色描述的使用示例。