
E.6 隐式目标
在科学中应用LLM的另一个关键担忧是其产生幻觉的倾向,即模型在试图满足用户请求时生成事实不正确或不合逻辑的回应[105]。在我们的设定中,这种幻觉可能表现为TEXTGRAD为优化其目标函数而提出无效、有毒或其他不可取的分子。我们通过使用RDKit净化预处理分子来控制严重幻觉,至少确保TEXTGRAD生成化学上有效的分子。然而,这一简单的预处理步骤并未完全规定理想的化学行为。一种直接策略是将药物分子中除类药性和结合亲和力之外的所有可能的可取性指标详尽地编码到目标函数中,并将其扩展到包括可合成性、毒性及其他标准。不幸的是,这种方法在现实中并不可行,因为并非所有可取性标准都有成熟的计算指标。因此,一个关键问题是TEXTGRAD在其优化过程中是否遵循所谓的隐式目标,从而抑制不合逻辑或不可取的行为。
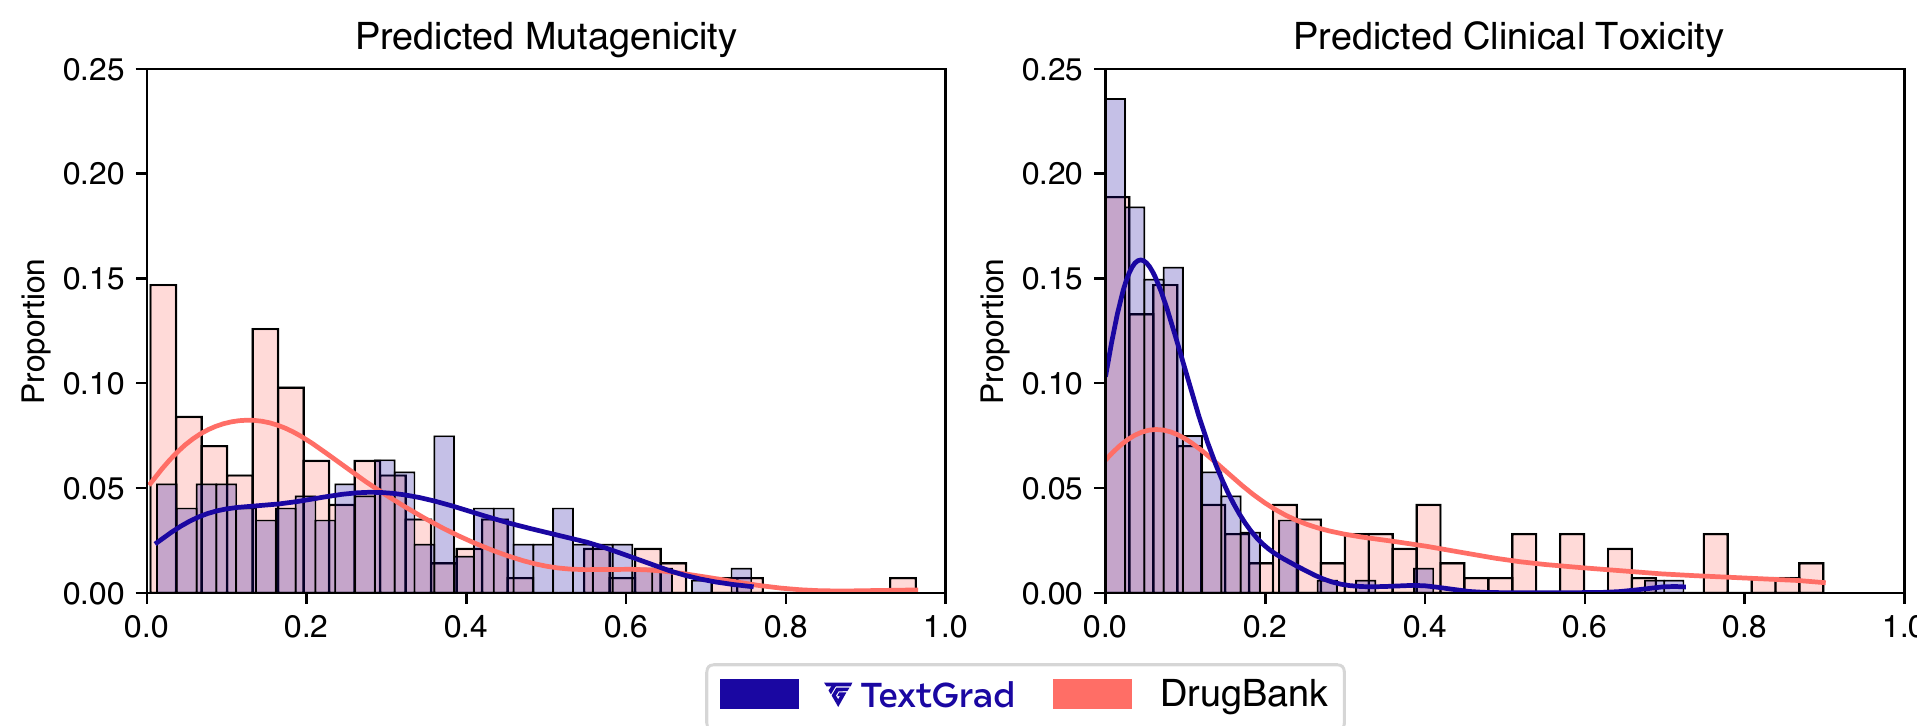
为了评估不良分子的程度或是否存在,我们可以表征所生成分子的危害性,重点关注致突变性和临床毒性。致突变性是指药物诱导遗传改变的能力,这可能导致DNA损伤和有害的长期影响。临床毒性是指广泛的不良短期或长期副作用。重要的是,药物相似性
和结合亲和力均与这些标准没有强相关性,因此这些可取性指标并未在TEXTGRAD的目标中被直接优化或以其他方式显式编码。
为了评估致突变性和临床毒性的倾向,我们采用ADMET-AI模型,该模型从分子的化学结构预测这些分数[108]。ADMET-AI采用在多个相关数据集上训练的深度学习模型。特别地,对于致突变性,ADMET-AI在来自Ames数据集的7,255种药物上训练,Ames数据集是一种细菌回复突变试验,用于快速筛选大量化合物是否可诱导遗传损伤和移码突变。预测标签为1.0表示药物诱导致突变性的可能性高,而标签为0.0表示可能性低。对于临床毒性,ADMET-AI在ClinTox数据集上训练,该数据集包含1,484种药物,由因毒性原因未能通过临床试验的分子以及与成功试验相关的药物组成。类似地,预测标签为1.0表示临床毒性的可能性高,而标签为0.0表示可能性低。
再次,我们将分析限制在总体分数衡量的具有可成药靶点的表现最佳的生成分子上,并为每个蛋白质靶点和每个初始片段选择最佳分子,总共87个生成分子。然后,我们将它们预测的致突变性和临床毒性与来自DrugBank的118个临床批准分子进行比较。我们观察到,对于致突变性和临床毒性,TEXTGRAD生成的分子具有表明有害效应可能性低的预测分布,并且与临床批准分子的分布密切匹配。总之,这些结果表明,TEXTGRAD隐式地避免提出有害分子,即使这些标准并未直接编码在其损失函数中。