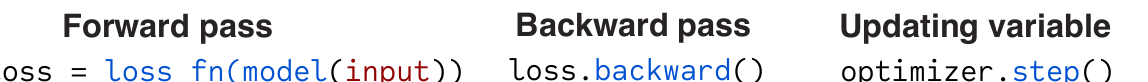TextGrad: Automatic "Differentiation" via Text Mert Yuksekgonul et al.
ウォームアップ:2つのLLM呼び出しからなるシステム 原文ページを表示 計算グラフの例。従来の自動微分では、連鎖律を用いて下流の損失に関して変数を改善する方向を提供する勾配を計算する。単純な類推として、次の単純なシステムを見てみよう:
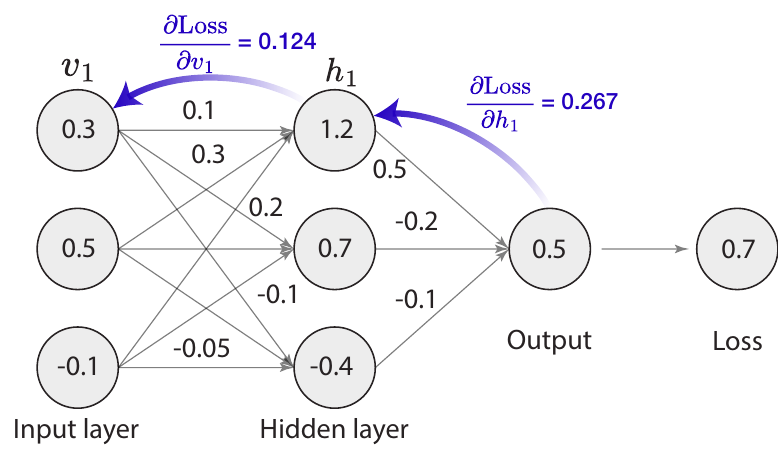
原文ページを表示 P r e d i c t i o n = L L M ( P r o m p t + Q u e s t i o n ) , E v a l u a t i o n = L L M ( E v a l u a t i o n + P r e d i c t i o n ) , ( 1 ) \begin{array}{r}\mathrm{Prediction} = \mathrm{LLM}(\mathrm{Prompt} + \mathrm{Question}),\\ \mathrm{Evaluation} = \mathrm{LLM}(\mathrm{Evaluation} + \mathrm{Prediction}), \end{array} \quad (1) Prediction = LLM ( Prompt + Question ) , Evaluation = LLM ( Evaluation + Prediction ) , ( 1 ) 原文ページを表示 a 数値勾配を用いたニューラルネットワークと誤差逆伝播法
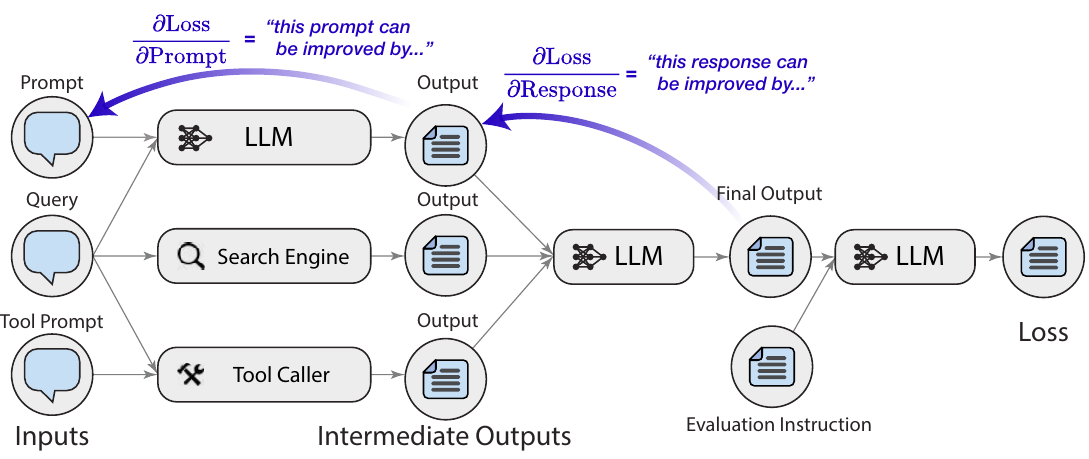
原文ページを表示 原文ページを表示 b ブラックボックスAIシステムと自然言語の「勾配」を用いた誤差逆伝播法
原文ページを表示 原文ページを表示 PyTorchとTextGradは、逆伝播と最適化のための同一の構文を共有している。
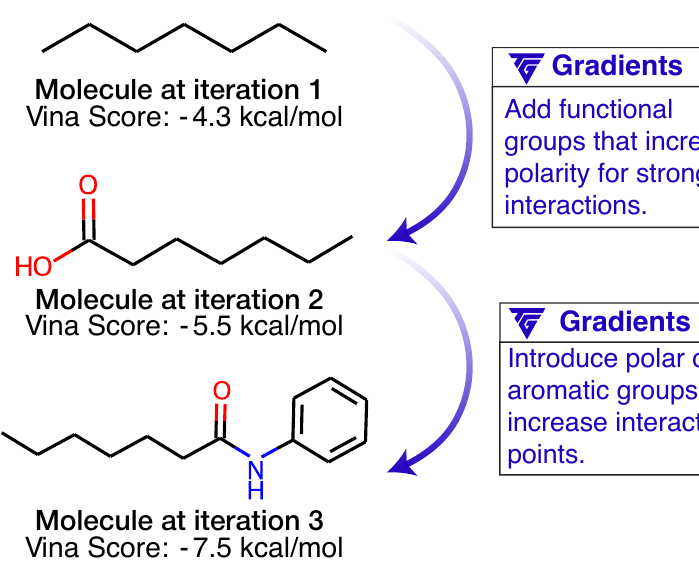
原文ページを表示 原文ページを表示 d 分子最適化のためのTextGrad
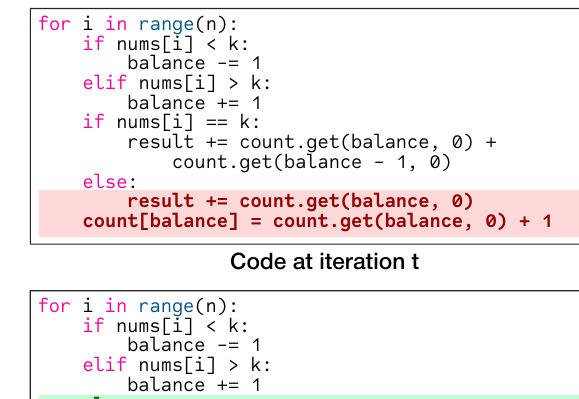
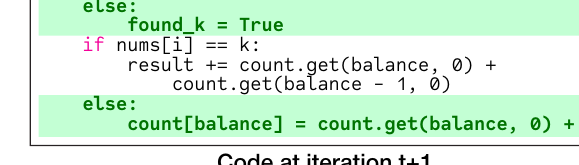
原文ページを表示 原文ページを表示 e コード最適化のためのTextGrad
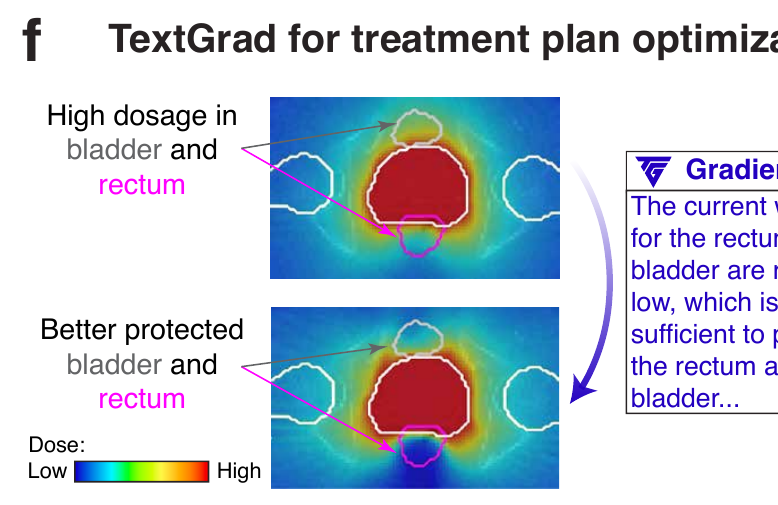
原文ページを表示 原文ページを表示 原文ページを表示 原文ページを表示 f 治療計画最適化のためのTextGrad
原文ページを表示 g プロンプト最適化のためのTextGrad
原文ページを表示 あなたは推論問題に答えます。ステップごとに考えてください。回答の最終行は次の形式でなければなりません:「Answer: $VALUE」。ここでVALUEは数値です。
原文ページを表示 初期化時のプロンプト(精度 = 77.8%)
原文ページを表示 あなたは推論問題に答えます。各項目とその数量を「- 項目:数量」のような明確で一貫した形式で列挙してください。リストから直接値を合計し、簡潔な総和を示してください。最終的な答えが「Answer: $VALUE」の形式で明確に示されるようにしてください。ここでVALUEは数値です。各項目がクエリの文脈に関連していることを確認し、入力における潜在的な誤りや曖昧さに対処してください。最終的な計数を再確認して正確性を確保してください。」
原文ページを表示 最適化後のプロンプト(精度 = 91.9%)
原文ページを表示 図1:テキストによる自動「微分」(a、b)。勾配の逆伝播は深層学習の原動力である。ブラックボックスAIシステムの複合システムには勾配が存在しないが、テキストベースのフィードバックに対して類似の逆伝播を構築することができ、これがTEXTGRADの基盤を成す。TEXTGRADにおける抽象化(c)。我々のフレームワークを汎用化し、習得しやすくするために、PyTorchと同じ抽象化と構文を共有している。TEXTGRADの応用(d、e、f、g)。セクション3.4では、薬剤性やタンパク質結合親和性などの特性のために分子構造を最適化する(d)。セクション3.1では、コーディング問題の解答を最適化する(e)。セクション3.5では、患者の転帰を改善するために放射線治療計画を最適化する(f)。セクション3.3では、言語モデルの推論を改善するためにプロンプトを最適化する(g)。 ここで、最適化する自由パラメータであるプロンプトを緑で示し、 + + + を用いて2つの文字列の連結を表し、 L L M ( x ) \mathrm{LLM}(x) LLM ( x ) を用いて x x x をプロンプトとして言語モデルに与え応答を収集することを表す。我々は連鎖記法:
原文ページを表示 P r o m p t + Q u e s t i o n → L L M E v a l u a t i o n I n s t r u c t i o n + P r e d i c t i o n → L L M E v a l u a t i o n , ( 3 ) \mathrm{Prompt} + \mathrm{Question} \xrightarrow{\mathrm{LLM}} \mathrm{Evaluation} \mathrm{Instruction} + \mathrm{Prediction} \xrightarrow{\mathrm{LLM}} \mathrm{Evaluation}, \quad (3) Prompt + Question LLM Evaluation Instruction + Prediction LLM Evaluation , ( 3 ) 原文ページを表示 をこのシステムを表す別の方法として用いる。ここでは、プロンプトを用いて質問に対する予測を生成するために1回のLLM呼び出しを行い、この予測を評価するために別のLLM呼び出しを行う。
原文ページを表示 勾配計算の例。この例のシステムにおいて、評価に関してプロンプトを改善するために、以下のようにして逆伝播[19]アルゴリズムの類似物をインスタンス化する:
原文ページを表示 単純なグラフに対する勾配計算:プロンプト → L L M \xrightarrow{\mathrm{LLM}} LLM 予測 → L L M \xrightarrow{\mathrm{LLM}} LLM 評価
原文ページを表示 ∂ E v a l u a t i o n ∂ P r o m p t = ∂ E v a l u a t i o n ∂ P r e d i c t i o n ⋅ ∂ P r e d i c t i o n ∂ P r o m p t = ∇ L L M ( P r e d i c t i o n , E v a l u a t i o n ) , ( 4 ) \frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prompt}} = \frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prediction}}\cdot \frac{\partial\mathrm{Prediction}}{\partial\mathrm{Prompt}} = \nabla_{\mathrm{LLM}}(\mathrm{Prediction},\mathrm{Evaluation}), \quad (4) ∂ Prompt ∂ Evaluation = ∂ Prediction ∂ Evaluation ⋅ ∂ Prompt ∂ Prediction = ∇ LLM ( Prediction , Evaluation ) , ( 4 ) 原文ページを表示 ここで、順伝播関数がLLM呼び出しである場合の勾配演算子として ∇ L L M \nabla_{\mathrm{LLM}} ∇ LLM を用いる。特に、この関数は「この予測は…によって改善できる」のような自然言語のフィードバックを返す。このフィードバックは、下流の目的関数を改善するために変数をどのように修正すべきかを記述しており、最適化における勾配に類似している。我々はまず、評価を用いて予測変数へのフィードバックを収集する。次に、このフィードバックと(プロンプト → L L M \xrightarrow{\mathrm{LLM}} LLM 予測)呼び出しが与えられたもとで、プロンプトに関するフィードバックを収集する。
原文ページを表示 注意として、我々はこの記法を、出力変数が後続を持たない場合(例: ∇ L L M ( P r e d i c t i o n , E v a l u a t i o n ) \nabla_{\mathrm{LLM}}(\mathrm{Prediction},\mathrm{Evaluation}) ∇ LLM ( Prediction , Evaluation ) )と、後続を持ち、したがって勾配を持つ場合(例: ∇ L L M ( P r o m p t , P r e d i c t i o n , ∂ L o s s ∂ P r e d i c t i o n ) \nabla_{\mathrm{LLM}}(\mathrm{Prompt},\mathrm{Prediction},\frac{\partial\mathrm{Loss}}{\partial\mathrm{Prediction}}) ∇ LLM ( Prompt , Prediction , ∂ Prediction ∂ Loss ) )の両方を表すために多重定義している。
原文ページを表示 以下は、 x → L L M y → L L M L x \xrightarrow{\mathrm{LLM}} y \xrightarrow{\mathrm{LLM}} \mathcal{L} x LLM y LLM L のような単純なシステムに対してフィードバックを収集するために ∇ L L M \nabla_{\mathrm{LLM}} ∇ LLM をインスタンス化する柔軟な方法である:
原文ページを表示 \[\begin{array}{r l} & {\frac{\partial\mathcal{L}}{\partial x} = \nabla_{\mathrm{LLM}}(x,y,\frac{\partial\mathcal{L}}{\partial y})\triangleq \mathrm{"H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad +\qquad}\\ & {\qquad \mathrm{LLM}(\mathrm{H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad \mathrm{Below~a r e~t h e~c r i t i c i s m s~o n~\{y\} :}}\\ & {\qquad \left\{\frac{\partial\mathcal{L}}{\partial y}\right\}}\\ & {\qquad \mathrm{Explain~h o w~t o~i m p r o v e~\{x\} .),} \end{array} \quad (6) 原文ページを表示 ここで、勾配オブジェクトは、変数が現れる文脈と L L M a \mathrm{LLM}^a LLM a から得られたフィードバックの組み合わせであり、Pryzant et al. [25] と同様に定義される。この演算子は、例えば応用領域に依存しないことに注意されたい。一度実装されれば、LLM呼び出しに対する勾配演算子は、すべての応用に対してフレームワーク全体を通して固定される。
原文ページを表示 a 我々が使用する正確なプロンプトは、汎用性と柔軟性を確保するために異なるものである;これらの例は説明のためだけに用いている。
原文ページを表示 最適化器の例。標準的な勾配降下法では、変数の現在の値は減算を通じて勾配と組み合わされる。例えば:
原文ページを表示 θ n e w = G r a d i e n t D e s c e n t . s t e p ( θ , ∂ L ∂ θ ) = θ − ∂ L ∂ θ . ( 7 ) \theta_{\mathrm{new}} = \mathrm{GradientDescent.step}(\theta ,\frac{\partial\mathcal{L}}{\partial\theta}) = \theta -\frac{\partial\mathcal{L}}{\partial\theta}. \quad (7) θ new = GradientDescent.step ( θ , ∂ θ ∂ L ) = θ − ∂ θ ∂ L . ( 7 ) 原文ページを表示 勾配に基づく最適化の類推を続けて、我々はテキスト勾配降下法(TGD)を用いる:
原文ページを表示 TGDによる単純なグラフにおけるPrompt変数の更新。
原文ページを表示 P r o m p t n e w = T G D . s t e p ( P r o m p t , ∂ E v a l u a t i o n ∂ P r o m p t ) . ( 8 ) \mathrm{Prompt}_{\mathrm{new}} = \mathrm{TGD.step}(\mathrm{Prompt},\frac{\partial\mathrm{Evaluation}}{\partial\mathrm{Prompt}}). \quad (8) Prompt new = TGD.step ( Prompt , ∂ Prompt ∂ Evaluation ) . ( 8 ) 原文ページを表示 これによりパラメータ、この場合はPromptを更新する。特に、現在の変数とその変数に対して収集した勾配(フィードバック)が与えられると、最適化器はこの変数の更新を試みる。
原文ページを表示 TGDをインスタンス化する具体的な方法は以下の通りである:
原文ページを表示 x n e w = T G D . s t e p ( x , ∂ L ∂ x ) ≜ L L M ( B e l o w a r e t h e c r i t i c i s m s o n { x } ; { ∂ L ∂ x } I n c o r p o r a t e t h e c r i t i c i s m s , a n d p r o d u c e a n e w v a r i a b l e . ) . ( 9 ) \begin{array}{r l} & {x_{\mathrm{new}} = \mathrm{TGD.step}(x,\frac{\partial\mathcal{L}}{\partial x})\triangleq \mathrm{LLM}(\mathrm{Below~are~the~criticisms~on~}\{x\} ;}\\ & {\qquad \left\{\frac{\partial\mathcal{L}}{\partial x}\right\}}\\ & {\qquad \mathrm{Incorporate~the~criticisms,~and~produce~a~new~variable.~).}} \end{array} \quad (9) x new = TGD.step ( x , ∂ x ∂ L ) ≜ LLM ( Below are the criticisms on { x } ; { ∂ x ∂ L } Incorporate the criticisms , and produce a new variable. ) . ( 9 ) 原文ページを表示 ここで、 x x x は改善したい変数であり、 ∂ L ∂ x \frac{\partial\mathcal{L}}{\partial x} ∂ x ∂ L は逆伝播中にその変数に対して得られたフィードバックである。勾配演算子と同様に、この関数も応用領域に依存せず、TGDの実装はフレームワークのすべての使用において同一である。
原文ページを表示 a 我々が使用する正確なプロンプトは、汎用性と柔軟性を確保するために異なるものである;これらの例は説明のためだけに用いている。
原文ページを表示 新規登録で $1 の無料クレジット付与。手元の PDF も同じように電子書籍化できます