
E.6 暗黙の目的関数
科学においてLLMを適用する際のもう一つの重要な懸念は、幻覚を生じやすい傾向である。これは、モデルがユーザーの要求を満たそうとする際に、事実に反する、または非論理的な応答を生成する現象である[105]。我々の設定では、この幻覚は、TEXTGRADがその目的関数を最適化するために、無効な、有毒な、あるいはその他の望ましくない分子を提案する形で現れうる。我々は、RDKitのサニタイゼーションを用いて分子を前処理することで深刻な幻覚を制御し、最低限としてTEXTGRADが化学的に有効な分子を生成することを保証する。しかし、この単純な前処理のステップは、望ましい化学的挙動を完全に規定するものではない。直接的な戦略としては、ドラッグライク性と結合親和性を超えた、薬剤分子の望ましさに関するあらゆる可能な指標を網羅的に目的関数に符号化し、合成可能性や毒性などの他の基準を含めるよう拡張することが考えられる。残念ながら、望ましさに関するすべての基準が成熟した計算指標を持つわけではないため、このアプローチは現実的に実行可能ではない。したがって、重要な問題は、TEXTGRADがその最適化プロセスにおいて、非論理的または望ましくない挙動を抑制するいわゆる暗黙の目的関数に従うかどうかである。
望ましくない分子の程度または存在を評価するため、我々は生成された分子の有害性を特徴づけることができ、変異原性と臨床毒性に焦点を当てる。変異原性とは、薬剤が遺伝的変化を誘発する能力を指し、これはDNA損傷や有害な長期的影響につながる可能性がある。臨床毒性とは、広範な短期的または長期的な副作用を指す。重要なことに、ドラッグライク性も
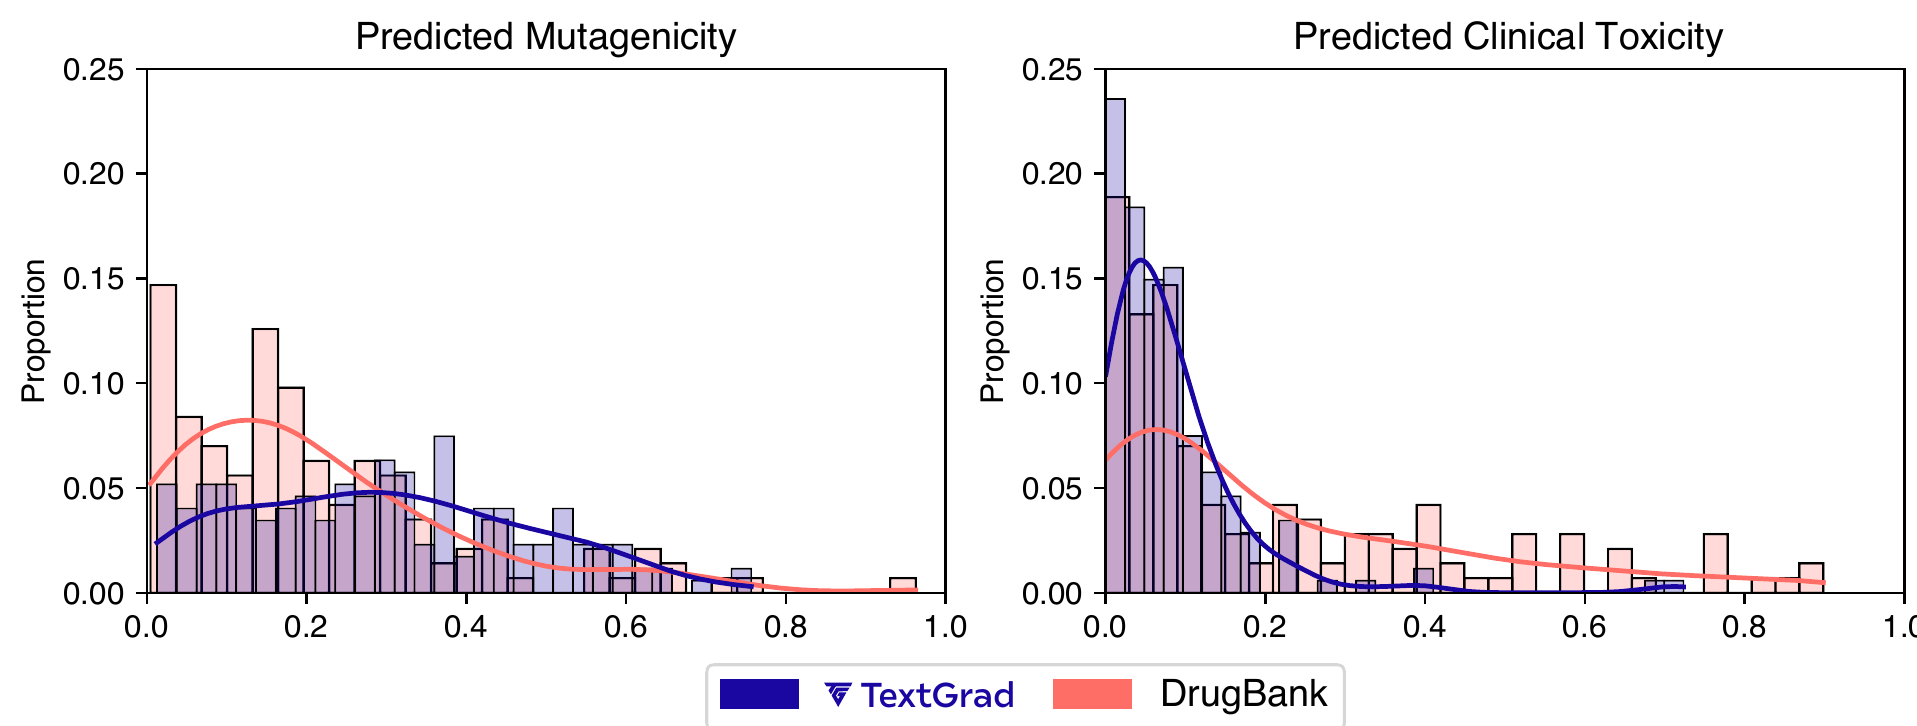
結合親和性もこれらの基準と強く相関しておらず、したがってこれらの望ましさの指標はTEXTGRADの目的関数において直接最適化されたり、明示的に符号化されたりしていない。
変異原性と臨床毒性の傾向を評価するため、我々は分子の化学構造からこれらのスコアを予測するADMET-AIモデルを採用する[108]。ADMET-AIは、複数の関連データセットで訓練された深層学習モデルを採用している。特に変異原性については、ADMET-AIはAmesデータセットの7,255の薬剤で訓練されている。Amesデータセットは、遺伝的損傷やフレームシフト変異を誘発しうるかについて大量の化合物を迅速にスクリーニングするための細菌復帰突然変異試験である。予測ラベル1.0は薬剤が変異原性を誘発する高い可能性を示し、ラベル0.0は低い可能性を示す。臨床毒性については、ADMET-AIはClinToxデータセットで訓練されている。これは、毒性上の理由で臨床試験に失敗した分子と、成功した試験に関連する薬剤からなる1,484の薬剤のデータセットである。同様に、予測ラベル1.0は臨床毒性の高い可能性を示し、ラベル0.0は低い可能性を示す。
ここでもまた、我々は分析を、総合スコアで測定された、drugableな標的に対する最も性能の高い生成分子に限定し、各タンパク質標的および各初期フラグメントについて最良の分子を選択し、合計87の生成分子を得る。次に、我々はそれらの予測された変異原性と臨床毒性を、DrugBankの118の臨床承認分子と比較する。我々は、変異原性と臨床毒性の両方について、TEXTGRADによって生成された分子が有害な影響の低い可能性を示す予測分布を持ち、臨床承認分子の分布と密接に一致することを観察する。これらの結果を合わせると、これらの基準がその損失関数に直接符号化されていないにもかかわらず、TEXTGRADが暗黙的に有害な分子の提案を回避していることが示唆される。