
F.5 化学的新規性
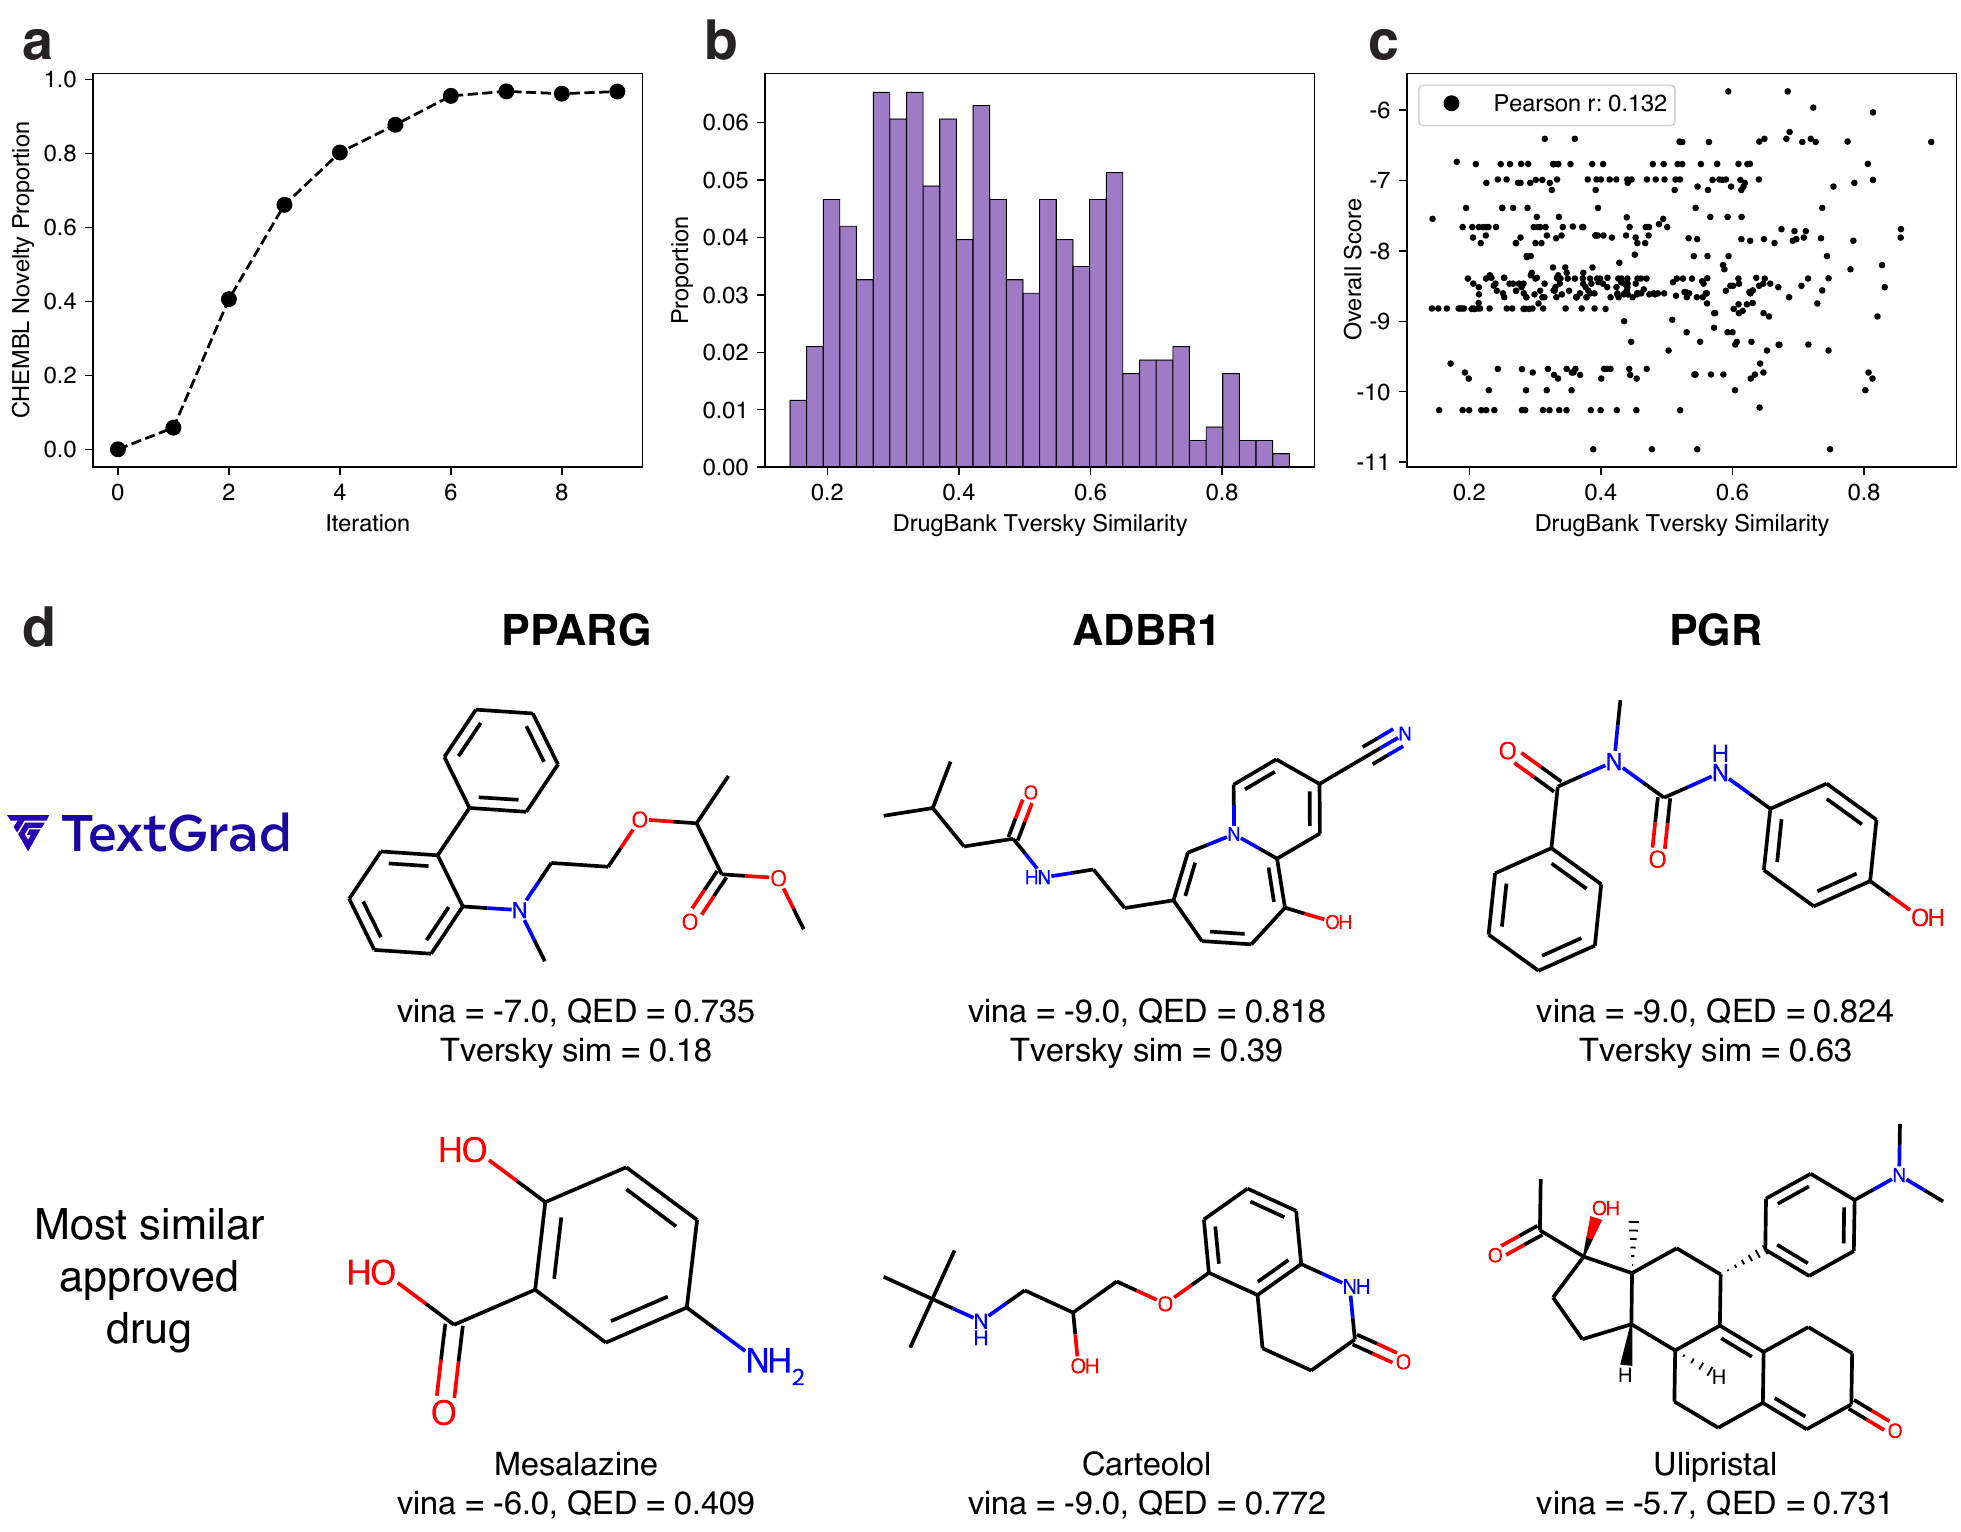
科学的発見においてLLMモデルを使用する際の主要な懸念の一つは、論理的推論を行うのではなく、単に訓練セットを丸暗記して regurgitate(反復吐出)する能力である[105]。gpt-4oのような最近のモデルは大規模で不透明なデータセットで訓練されているため、TEXTGRADが生成する分子が、それぞれの標的に対して臨床承認された分子の単なる複製である可能性があることが重要な懸念である。この「丸暗記」効果の程度または存在を定量化および検証するために、TEXTGRADが生成する分子を、それぞれのタンパク質標的に対して承認された薬物、ならびに無関係だが既存の薬物類似化学化合物と比較する。
まず、特定のタンパク質標的に対してTEXTGRADが生成した分子を、同じ標的に対してDrugbankで見つかったすべての臨床承認済み小分子(フィルタリング基準についてはF.3を参照)と、RDKit daylight化学フィンガープリント上のTversky類似度スコアを用いて比較する。Tversky類似度スコアは対称ではなく、バリアント分子と参照分子の間の部分構造を比較する[106]。我々の適用では、これは好ましい。なぜなら、生成された(バリアント)分子がDrugbank(参照)分子の部分構造の大部分またはすべてを含む場合に高いスコアを割り当てるからであり、たとえ生成分子に他の余分な部分構造が存在して2分子間の対称的な重なりを減少させたとしても同様である。Tverskyスコア1.0は、TEXTGRAD分子がDrugbank分子の完全な部分集合であることを示し、0.0は重なりがないことを示す。
最も関連性の高い化学構造を分析するために、我々はすべての反復からのすべての分子ではなく、高性能なTEXTGRAD分子のセットに分析を限定した。特に、式25に記載された総合スコアを用いて、各タンパク質標的および各初期フラグメントについて最良の分子を選択し、合計87個の生成分子(29個の創薬可能標的 個の初期フラグメント)と、29個の標的にわたる118個の臨床承認薬を得た。各標的について、3つのTEXTGRAD分子とその標的に対して承認されたDrugbank分子との間のすべてのペアワイズTverskyスコアを計算し、Drugbank分子を参照、TEXTGRAD分子をバリアントとして設定した。
Tversky類似度スコアの分布はかなり広く、中央値は0.42であるが、0.14から0.90の範囲にあった(図2 (b))。しかし、TEXTGRADとDrugBank分子間のTversky類似度は、総合スコアで測定された分子性能と実際にはわずかに逆相関していることが観察され、TEXTGRADの最適化手順が承認薬に関する事前知識の影響をせいぜい弱くしか受けていないことを示唆している。実際、類似度スコアの勾配に沿った多様な生成分子について、生成分子はDrugBankの対応物に匹敵する、あるいはそれを上回るQEDおよびVinaスコアを示している(図2 (d))。
既知の薬剤との類似性に加えて、我々はTEXTGRADが新規の分子を生成しているのか、あるいは既存の化合物においてこれまで知られていなかった特性(例えば、そのタンパク質と関連付けられたことのない化合物におけるタンパク質標的への強い結合親和性など)を発見しているのかを観察することにも関心がある。この問いに答えるため、我々はChEMBL全体にわたってTanimoto類似度検索を実行する。ChEMBLは、ドラッグライクな特性を持つ240万の生物活性分子からなる手作業でキュレーションされたデータベースである[107]。Tverskyスコアとは異なり、Tanimoto指標は2つの化学構造間の対称的な重なりを測定し、1.0は完全一致を、0.0は重なりがないことを示す。我々は、Tanimoto類似度スコアが0.80を超える分子がChEMBL内に1つも存在しない場合に限り、TEXTGRADの化合物を「新規」と分類する。
出発フラグメントは既知の分子であるが、我々は反復回数が増えるにつれて、TEXTGRADが生成する分子が既知の化合物である可能性が次第に低くなっていくことを観察する。第6反復までに、58の標的すべてと3つの出発フラグメントにわたってTEXTGRADが生成したすべての分子の95%が、上記の基準を用いて新規である(図2(a))。生成された分子の軌跡を観察し、テキスト勾配を分析することにより、我々は、VinaスコアとQEDスコアによって提供されるフィードバックが、TEXTGRADに官能基の組み合わせを徐々に追加・除去させることで既知の分子を超えた化学空間を探索するよう促していると仮説を立てる。これらの化学的更新は組み合わせ的に多数のユニークな構造を形成しうるため、TEXTGRADが比較的少ない反復回数でこれまで未探索の化学空間領域に到達するのは妥当である。