
TextGrad: Automatic "Differentiation" via TextMert Yuksekgonul et al.
F.4 初期化
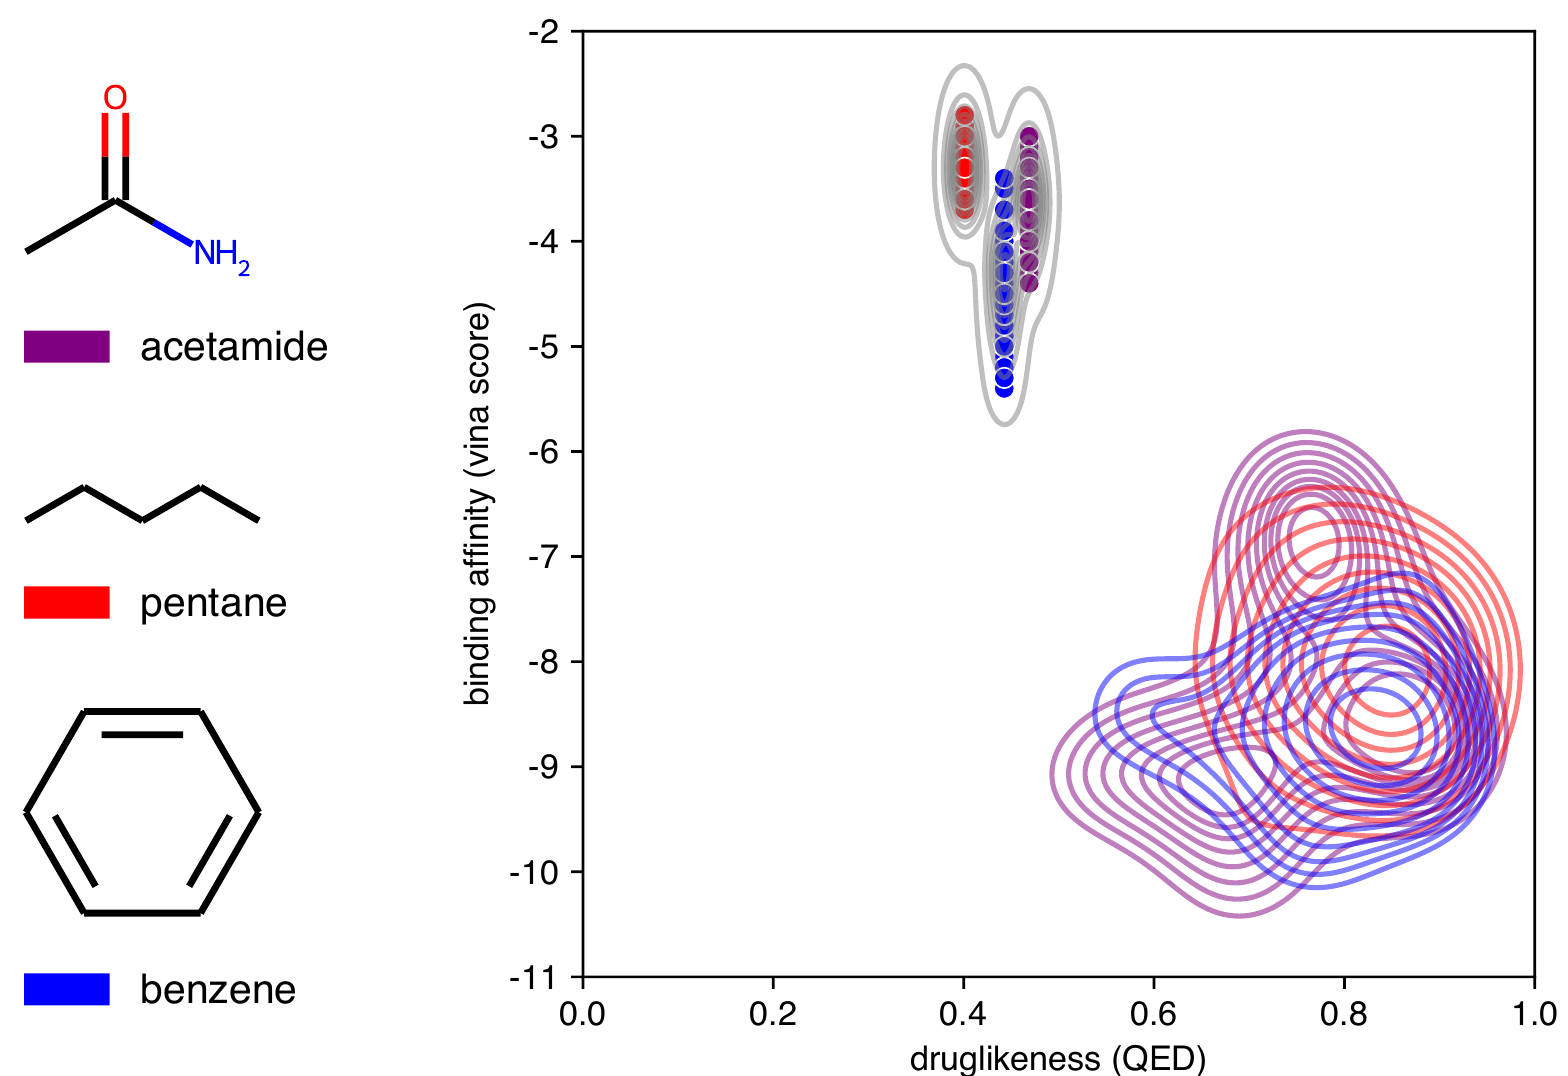
実践では、分子最適化は通常、大規模な事前最適化スクリーニングによって加速される。そこでは、数百万、あるいは数十億もの既存の化学構造のライブラリが、ドッキング、薬物類似性、その他の指標によってスコアリングされ、ランク付けされる。最も有望な構造のみが「リード」と呼ばれ、メディシナルケミストによってさらに改良される[104]。TEXTGRADは任意の初期分子を最適化することが可能であるが、本研究では、その性能をより正確に特徴づけ、その設計が既存薬に偏ることを避けるために、代わりに図1に示す一般的な官能基の単純なフラグメントから3つの初期分子を選択する。これらのフラグメントは非常に多様であり、異なる官能基に属している。これらの初期フラグメントは薬物類似性および結合親和性の特性が異なるものの、開始フラグメントがTEXTGRADの性能に与える影響は最小限であり、TEXTGRADは3つのフラグメントすべてから高い薬物類似性と結合親和性を持つ分子を生成することができる。