
A.1 変数
変数は計算グラフのノードである。以下に変数の最も重要な属性を示す:
1. 値とは、変数が含む非構造化データである。本稿全体を通して、すべての値はテキストデータである。
2. 役割記述とは、計算グラフにおける変数の役割を説明する情報的な文字列である。これらの役割を用いて、ユーザーがグラフに知識を注入し、最適化の挙動を導くことを可能にする。より詳細な情報は以下に記載する。
3. 勾配とは、逆伝播の際にLLMによって提供される自然言語のフィードバックである。これらは、下流の損失を改善できるように変数に対して行うべき変更を記述する。勾配を生成する逆伝播操作の例については、セクションA.3を参照されたい。
4. 先行変数とは、ある変数を生成するために使用される変数の集合である。例えば、LLMに指示を与えて応答を得る場合、その指示は応答の先行変数となる。逆伝播の過程では、後続変数の勾配がその先行変数へと伝えられ、下流の目的をどのように改善すべきかに関する指針が与えられる。
5. requires_gradは、逆伝播の過程で勾配が格納されるかどうかを示すものであり、PyTorchに類似している。例えば、ユーザーがある質問について勾配を計算したくない場合には、単にVariable(value=question, requires_grad=False, ...)と記述してそれを示せばよい。
役割記述:TEXTGRADでは、各変数は役割記述を持つ。特に、これは計算グラフにおける変数の役割を記述する文字列であり、例えば言語モデルへのシステムプロンプトや言語モデルによる予測などである。しばしば自動的に設定されることもあるが、一般に役割記述はユーザーの知識を最適化プロセスに注入する主要な方法の一つである。
経験的に、役割記述は最適化プロセスを大きく方向づけ得ることが分かっている。例えば、予測の役割を言語モデルへの最終的な数値回答と設定すると、フィードバックを用いて変数の値を更新するよう言語モデルに促すTextual Gradient Descentオプティマイザに対し、変数が数値のみとなるように更新するよう導く。これに対し、解答の推論と最終予測といった役割記述では、オプティマイザは最終予測とともに推論を生成するよう導かれる。
以下に使用例を示します:
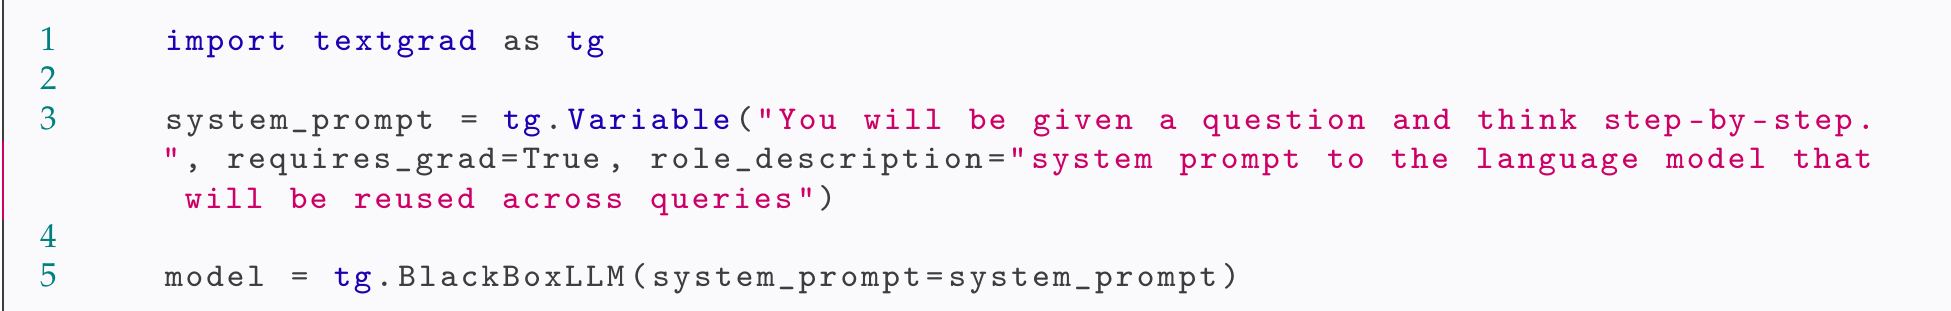
コードスニペット3:ロール記述の使用例。