
3.4 分子最適化
TEXTGRADは、科学および工学分野で一般的に見られる多目的最適化タスクを含む、多様な最適化問題をサポートする。例えば、創薬では、研究者は合成可能性、有効性、安全性に関して様々な目的を最大化する分子を発見または設計しようとする[53, 54]。TEXTGRADの多目的最適化への応用を示すために、我々はTEXTGRADを薬物分子最適化に適用し、我々のフレームワークが計算ツールと連携し、結合親和性とドラッグライクネスを同時に改善する方向へ化学構造を最適化できることを示す。
タスク:潜在的薬物分子にとって重要な考慮事項はその結合親和性であり、これは分子とそのタンパク質標的との間の相互作用の強さを表す。薬物設計者は関連する薬物標的に対して高い結合親和性を持つ分子を求める。なぜならそれらは有効性を達成するためにより低くより頻度の少ない投与量を必要とするからである。この親和性は自由エネルギーによって定量化でき、これは結合状態と非結合状態のリガンド-受容体対の間の確率の比を表す。はタンパク質-リガンド結合の「ドッキング」シミュレーションを用いて推定できる[55, 56]。我々の実験では、広く用いられている物理ベースのドッキングシミュレータであるAutodock VinaツールからのVinaスコアを採用する[57]。Vinaスコアがより負であるほど、薬物がその意図された標的に結合する確率がより大きい。
潜在的薬物分子はまた、そのドラッグライクネスによって評価される。これは溶解性、透過性、代謝安定性およびトランスポーター効果に関して、分子がin vivoでどのように振る舞うかを推定する。高いドラッグライクネスを持つ分子は体内に吸収され標的に到達する可能性がより高い[58]。「ドラッグライクネス」の一般的な指標の一つは定量的ドラッグライクネス推定(QED)スコアであり、分子量、脂溶性、極性表面積などの重要な化学的特性の加重複合指標である。QEDスコアは0から1の範囲であり、1は高いドラッグライクネスを示す[59]。
成功する分子にはさらに多くの考慮事項があるが、我々の実験では、これら2つの指標の相対的な成熟度のため、目的をVinaスコアの最小化とQEDの最大化に限定する。これら2つの指標間の競合するトレードオフが最適化タスクを現実的かつ困難なものにする。特に、ドッキングスコアは結合部位との相互作用を最大化する多くの官能基を持つより大きな分子を好む傾向がある[55, 56, 60]。対照的に、ドラッグライクネスはより良い吸収特性を持つより軽くより単純な分子を促す[58, 59]。したがって、両方の目的を同時に最適化することは自明ではない。
手法:我々は分子をSMILES文字列としてエンコードし、VinaおよびQEDスコアから多目的損失を構築することにより、TEXTGRADを薬物分子最適化に適用する。すなわち、SMILES文字列に対してインスタンス最適化を実行し、多目的損失に関するTEXTGRADによって生成された勾配が分子を表すテキストを更新するために用いられる。
我々は付録F.2にあるプロンプトテキストとともにgpt-4oをLLMとして用いる。各イテレーションで、現在の分子は、Autodock VinaからのVinaスコアを用いて標的タンパク質への結合親和性を推定し、RDKitからのドラッグライクネスにQEDスコアを用いることによって評価される(付録F.1)。各分子は官能基からの小さな化学フラグメントとして初期化される。我々はDOCKSTRING分子評価ベンチマーク[61]の全58標的にTEXTGRADを適用する。これら58標的は様々な構造クラスからサンプリングされた臨床的に関連するタンパク質から成り、そのうち29は臨床承認薬を持つ。各標的について、我々は3つの独自の初期フラグメントに対して、TEXTGRADを用いて開始フラグメントを10イテレーション最適化する。性能を評価するために、我々はTEXTGRADによって生成された分子の特性を、それぞれのタンパク質に対する臨床承認薬と比較する(付録F.3)。
結果:58個の標的すべてにおいて、TEXTGRADは初期の出発フラグメントに関係なく、結合親和性と薬物類似性を改善した分子を一貫して生成する(付録F.4)。臨床的に承認された薬剤を持つ29のタンパク質標的について、我々は、
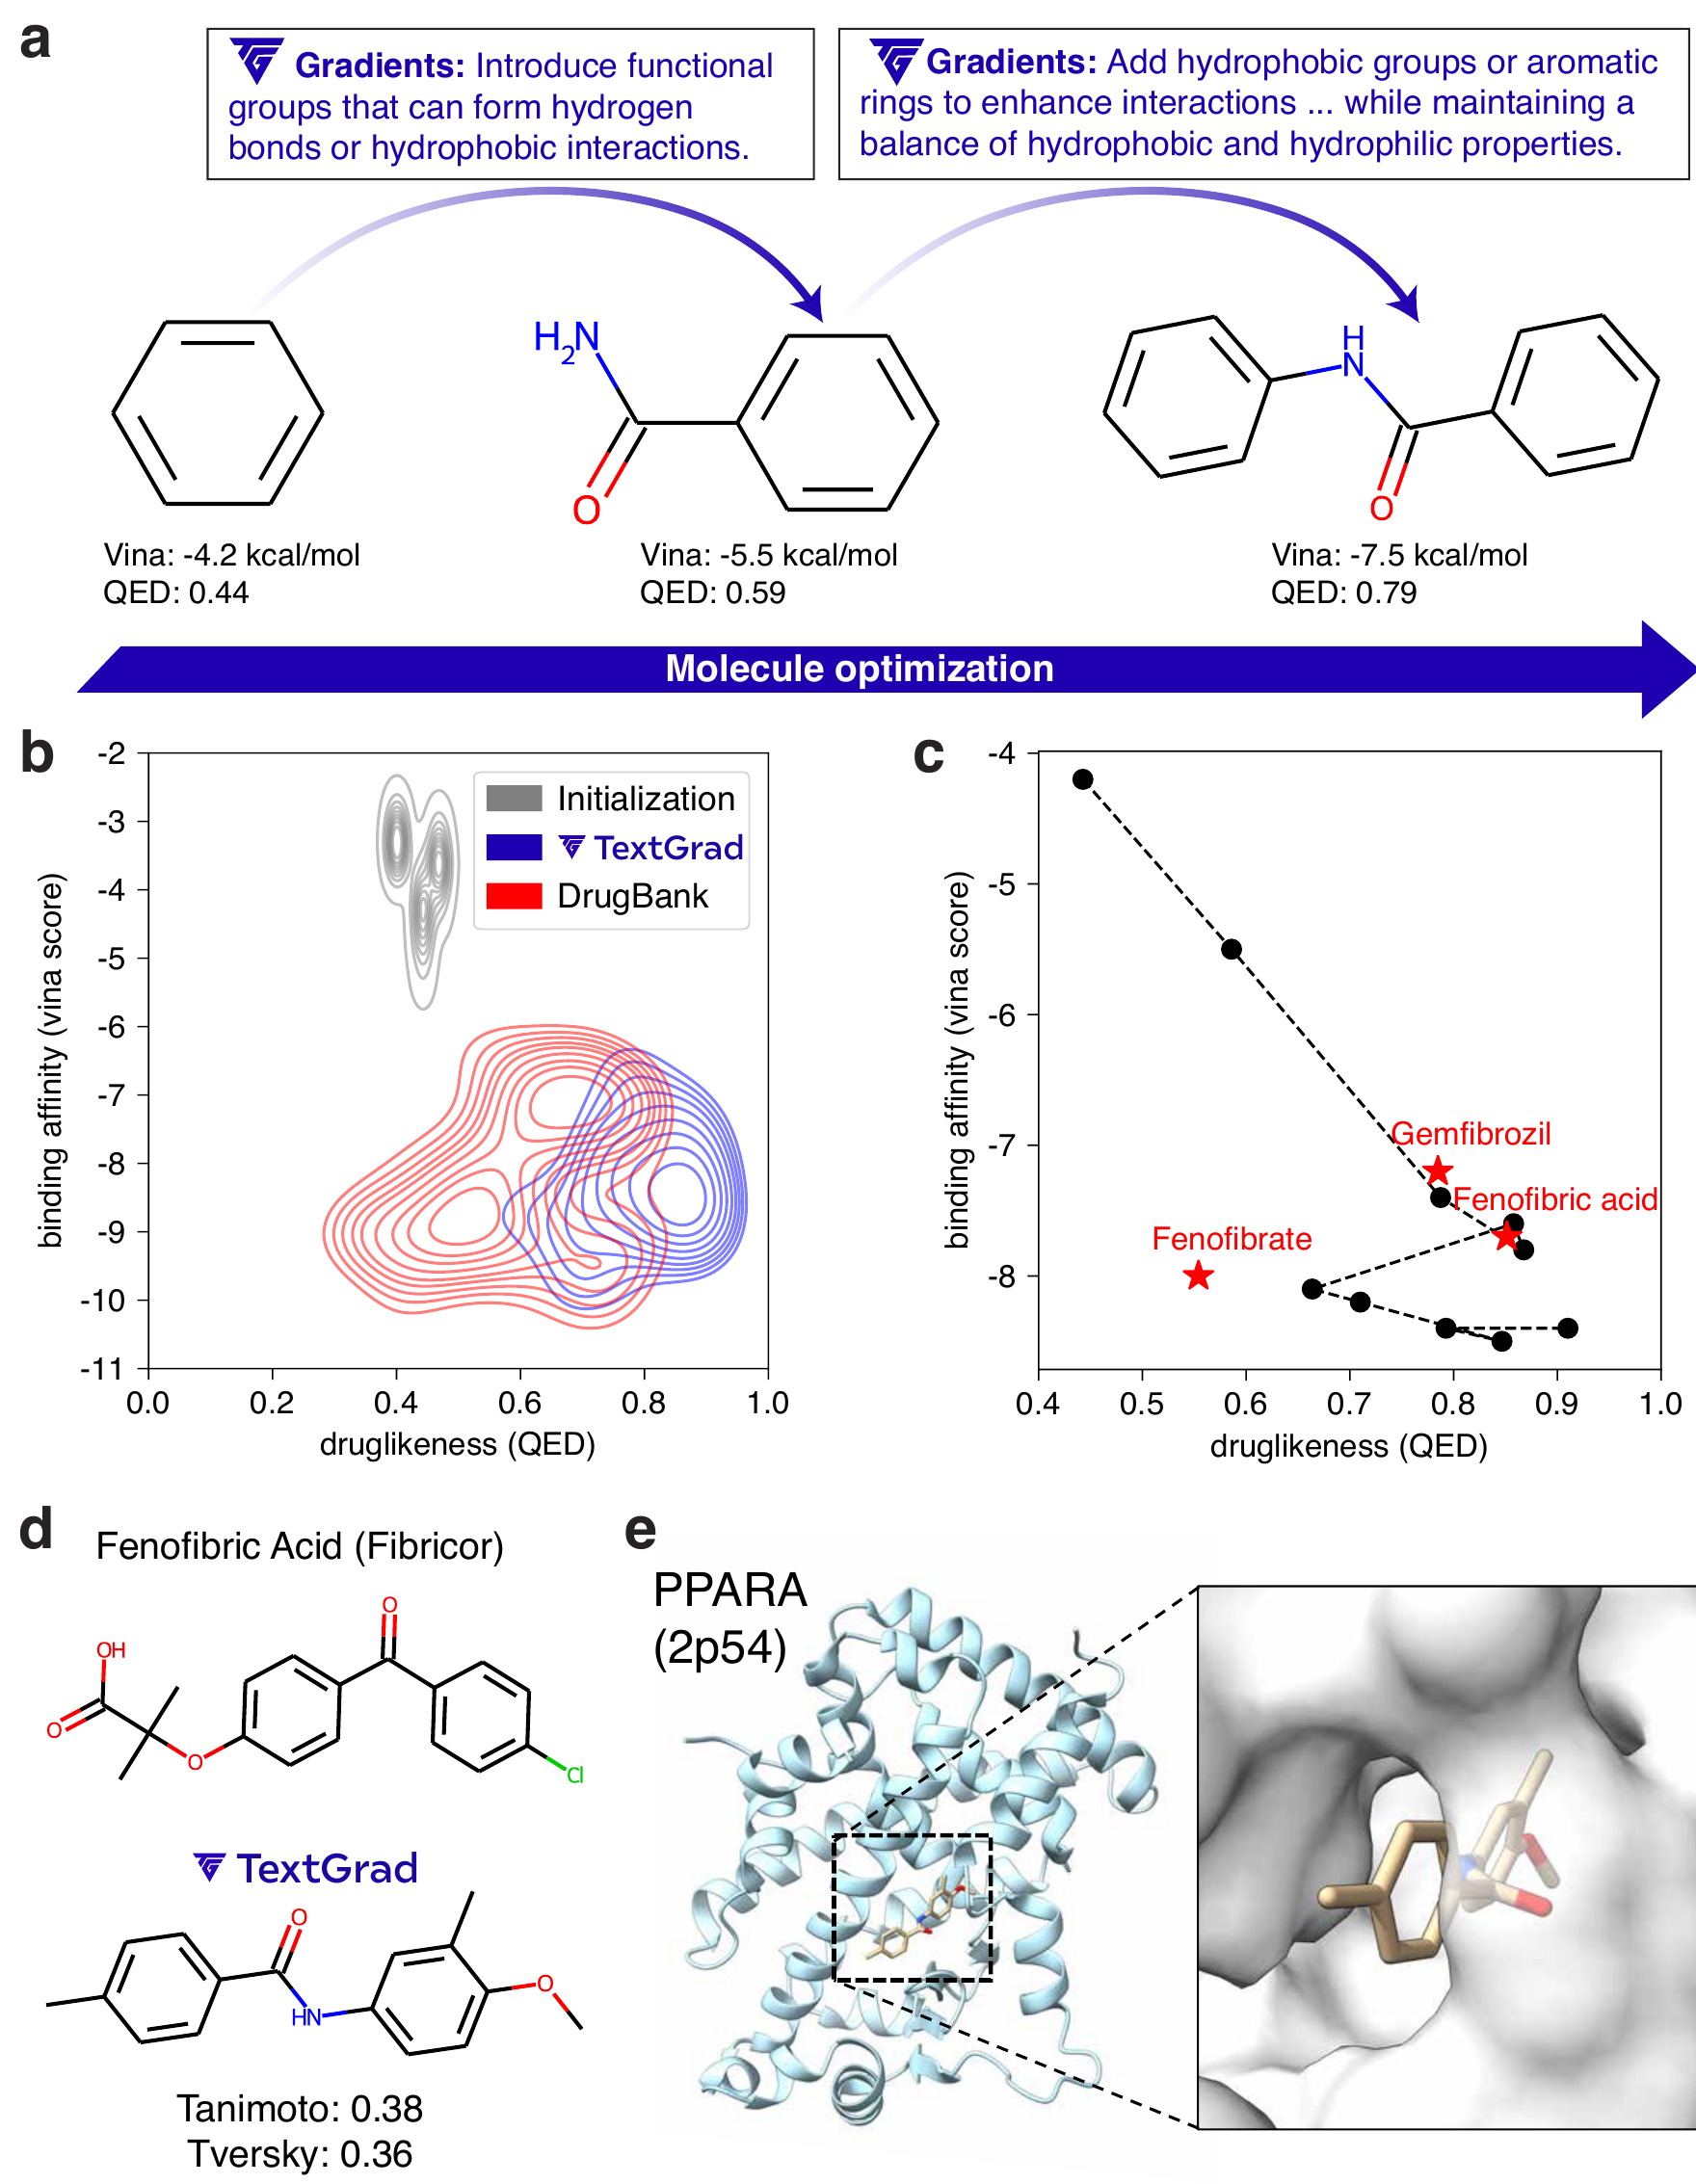
同じ損失関数を用いて評価された臨床分子と比較した場合に、TEXTGRADが高度に競争力のある親和性と薬物類似性を持つ分子を生成することを観察する(図2(b))。得られた分子は、臨床的に承認された対応分子や既存の化合物と比較して独自の構造を示す一方で(付録F.5)、同様のin silico安全性プロファイルを維持している(付録F.6)。de novo分子生成のための代替の機械学習手法は存在するが、TEXTGRADはその counterparts に対して2つの主要な利点を提供する。第一に、従来のケモインフォマティクスツールをLLMの一般知識と推論能力と組み合わせることで、TEXTGRADは事前の訓練セットなしでも競争力のある結果を生み出す。第二に、TEXTGRADの自然言語勾配というフレームワークは説明可能な決定を生み出し、研究者が分子の構造がどのように、そしてなぜ構築されたのかを正確に理解することを可能にする。これら2つの特性は相まって、科学的発見におけるAIエージェントの役割に有望な未来を呼び起こす。