
Calentamiento: sistema con dos llamadas a LLM
Gráfico de computación de ejemplo. En la diferenciación automática tradicional, calculamos gradientes que proporcionan una dirección que mejoraría la variable con respecto a una pérdida posterior con la regla de la cadena. Para un análogo simple, veamos el sistema simple:
a Red neuronal y retropropagación usando gradientes numéricos
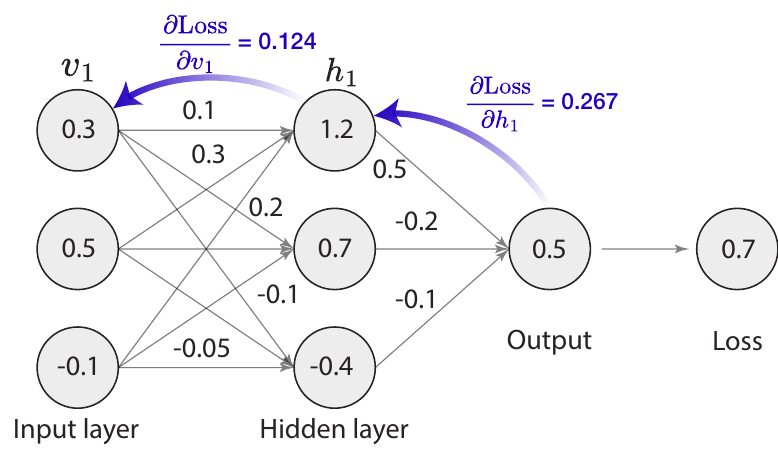
b Sistemas de IA de caja negra y retropropagación usando "gradientes" en lenguaje natural
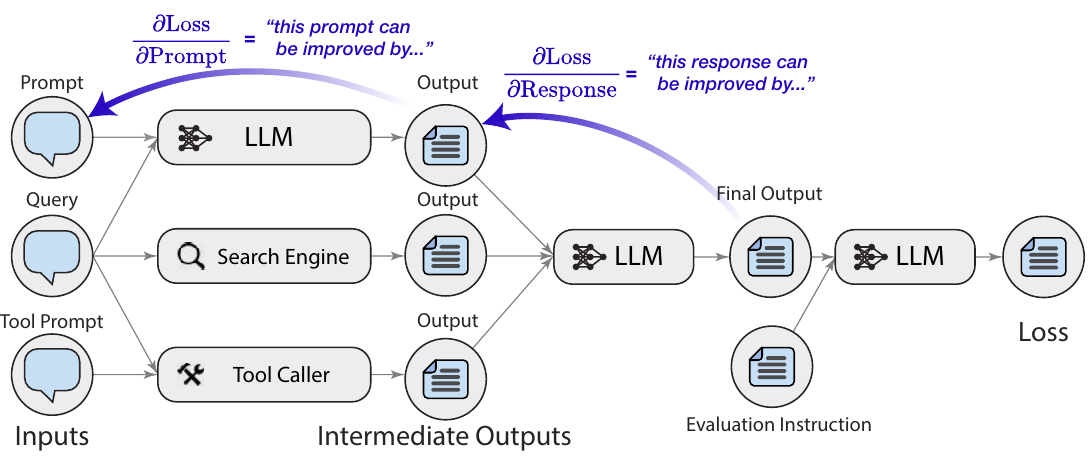
C 1 Analogía en abstracciones
| Matemáticas | PyTorch | TextGrad | |
| Entrada | x | Tensor(imagen) | tg.Variable(artículo) |
| Modelo | y = fθ(x) | ResNet50( ) | tg.BlackboxLLM("Eres un resumidor.") |
| Pérdida | L(y, y) = ∑ y; log( y; ) | CrossEntropyLoss( ) | tg.TextLoss("Evalúa el resumen.") |
| Optimizador | GD(θ; θ) = θ - θL/θ0 | SGD(List(model.parameters( ))) | tg.TGD(List(model.parameters( ))) |
2 Diferenciación automática
PyTorch y TextGrad comparten la misma sintaxis para retropropagación y optimización.
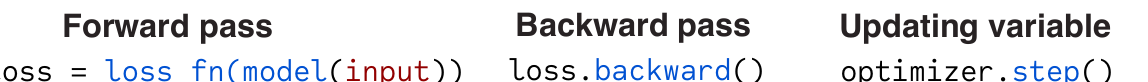
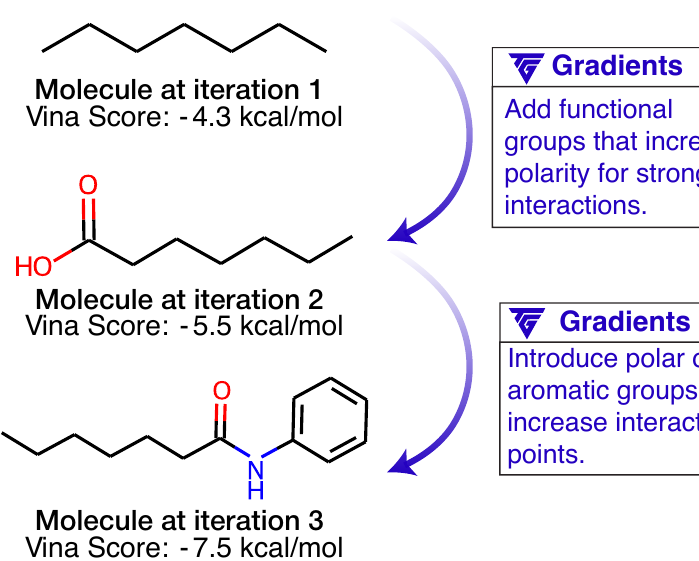
d TextGrad para optimización de moléculas
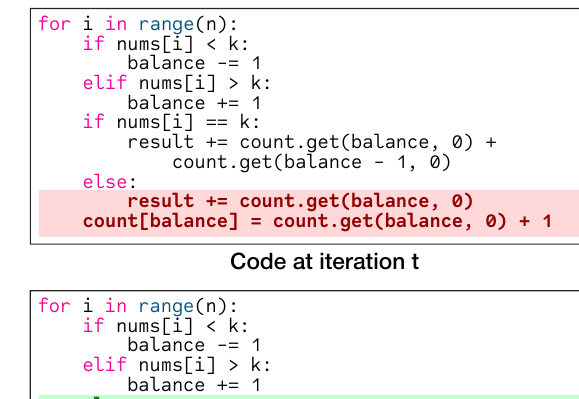
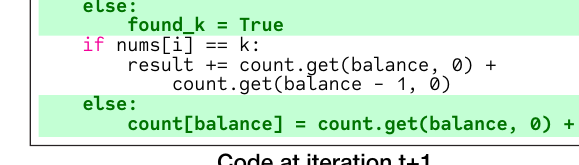
e TextGrad para optimización de código
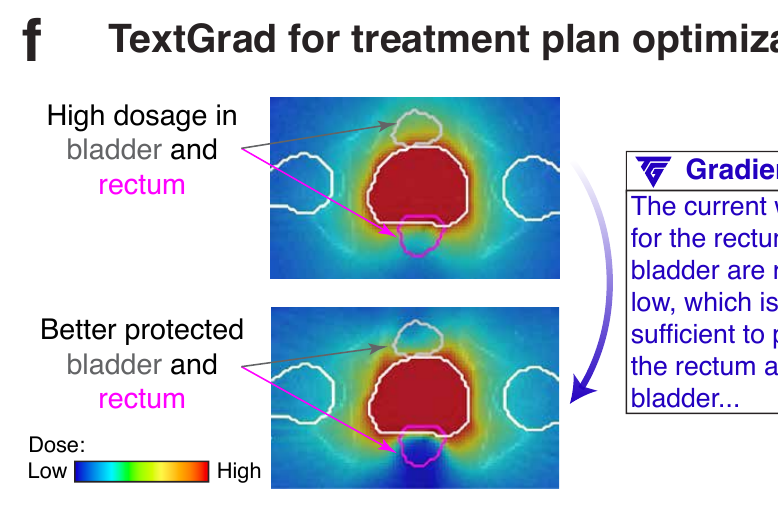
f TextGrad para optimización de planes de tratamiento
g TextGrad para optimización de prompts
Responderás una pregunta de razonamiento. Piensa paso a paso. La última línea de tu respuesta debe tener el siguiente formato: 'Answer: 'SVAULE' donde VALUEl es un valor numérico.
Prompt en la inicialización (Precisión = 77.8%)
Responderás una pregunta de razonamiento. Enumera cada elemento y su cantidad en un formato claro y consistente, como - Elemento: Cantidad'. Suma los valores directamente de la lista y proporciona una suma concisa. Asegúrate de que la respuesta final se indique claramente en el formato: 'Answer: 'SVAULE' donde VALUEl es un valor numérico. Verifica la relevancia de cada elemento para el contexto de la consulta y maneja posibles errores o ambigüedades en la entrada. Revisa el conteo final para asegurar la precisión."
Prompt después de la optimización (Precisión = 91.9%)
Figura 1: "Diferenciación" automática mediante texto (a, b). La retropropagación de gradientes es la fuerza motriz del aprendizaje profundo. No disponemos de gradientes para sistemas compuestos de sistemas de IA de caja negra, pero podemos construir una retropropagación análoga para la retroalimentación basada en texto, lo que constituye la base de TEXTGRAD. Abstracciones en TEXTGRAD (c). Compartimos las mismas abstracciones y sintaxis que PyTorch para que nuestro marco sea generalizable y fácil de aprender. Aplicaciones de TEXTGRAD (d, e, f, g). En la Sección 3.4, optimizamos estructuras moleculares para propiedades como la similitud con fármacos y la afinidad de unión a proteínas (d). En la Sección 3.1, optimizamos soluciones a problemas de programación (e). En la Sección 3.5, optimizamos planes de tratamiento de radioterapia para mejorar los resultados de los pacientes (f). En la Sección 3.3, optimizamos prompts para mejorar el razonamiento de los modelos de lenguaje (g). donde denotamos el parámetro libre a optimizar, el prompt, con verde, y usamos para denotar la concatenación de dos cadenas, y usamos para dar como prompt a un modelo de lenguaje para recopilar la respuesta. Usaremos la notación de cadena:
como otra forma de denotar este sistema, donde hacemos una llamada al LLM para generar una Predicción para una Pregunta usando un Prompt, y otra llamada al LLM para evaluar esta Predicción.
Ejemplo de cálculo de gradientes. En este sistema de ejemplo, para mejorar el Prompt con respecto a la evaluación, instanciamos un análogo del algoritmo de retropropagación [19] mediante lo siguiente:
Cálculo de gradientes para el grafo simple: Prompt Prediction Evaluation
donde usamos para el operador de gradiente cuando la función directa es una llamada a un LLM. En particular, esta función devuelve retroalimentación en lenguaje natural tal como «Esta predicción puede mejorarse mediante...», donde la retroalimentación describe cómo modificar la variable para mejorar el objetivo posterior, de forma análoga a los gradientes en optimización. Primero recopilamos retroalimentación para la variable Prediction usando la evaluación. Luego, dada esta retroalimentación y la llamada (Prompt Prediction), recopilamos la retroalimentación sobre el Prompt.
«Nótese que sobrecargamos la notación para denotar tanto los casos en que la variable de salida no tiene sucesores (p. ej., ) como cuando tiene sucesores y, por lo tanto, gradientes (p. ej., ).
A continuación se presenta una forma flexible de instanciar para recopilar retroalimentación para un sistema simple como :
Ejemplo de implementación para el operador de gradiente
donde el objeto gradiente es una combinación del contexto en el que aparece la variable y la retroalimentación obtenida de un , definido de forma análoga a Pryzant et al. [25]. Nótese que este operador no depende, por ejemplo, del dominio de aplicación. Una vez implementado, el operador de gradiente para las llamadas a LLM queda fijo a lo largo de todo el marco para todas las aplicaciones.
aLos prompts exactos que usamos son distintos para garantizar generalidad y flexibilidad; usamos estos ejemplos solo con fines expositivos.
Optimizador de ejemplo. En el descenso de gradiente estándar, el valor actual de la variable se combina con los gradientes mediante sustracción, p. ej.:
Continuando con la analogía de la optimización basada en gradientes, usamos el Descenso de Gradiente Textual (TGD):
Actualización de la variable Prompt en el grafo simple mediante TGD.
para actualizar los parámetros, en este caso, el Prompt. En particular, dados la variable actual y los gradientes (retroalimentación) que recopilamos para esta variable, el optimizador busca actualizar esta variable.
Una forma concreta de instanciar TGD es la siguiente:
Ejemplo de implementación de una iteración de TGD
donde es la variable que nos gustaría mejorar, y es la retroalimentación que obtuvimos para la variable durante el paso hacia atrás. De forma similar al operador de gradiente, esta función tampoco depende del dominio de aplicación, y la implementación de TGD es la misma en todos los usos del marco.
aLos prompts exactos que usamos son distintos para garantizar generalidad y flexibilidad; usamos estos ejemplos solo con fines expositivos.