
F.5 Novedad química
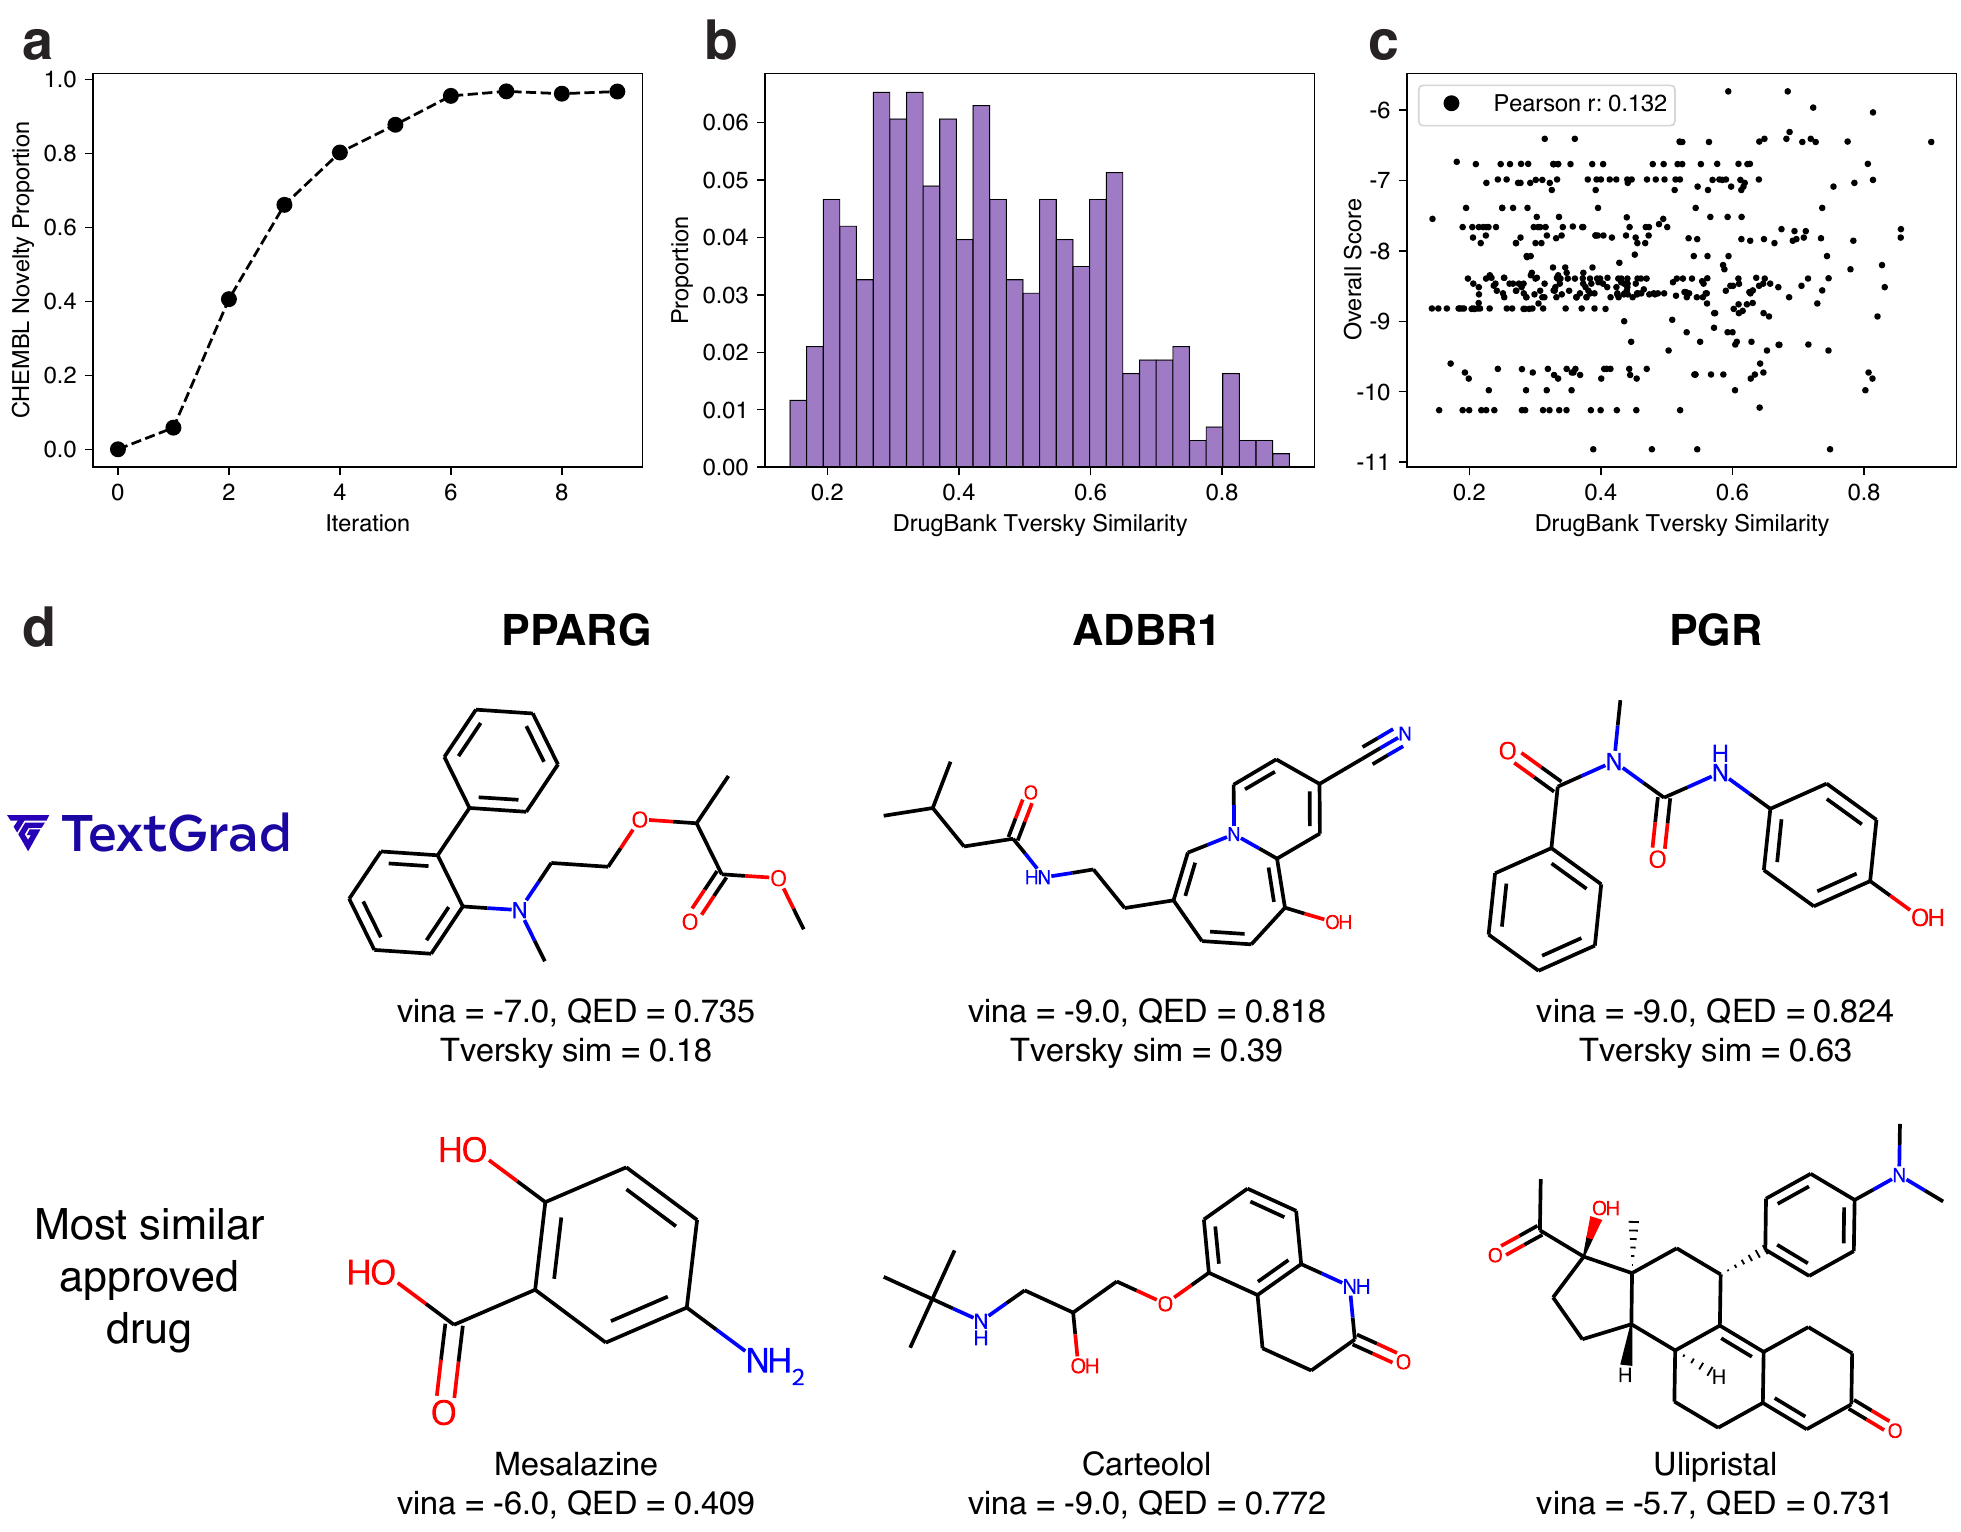
Una de las principales preocupaciones al utilizar modelos LLM en el descubrimiento científico es su capacidad para simplemente memorizar y regurgitar sus conjuntos de entrenamiento en lugar de realizar razonamiento lógico [105]. Dado que modelos recientes como gpt-4o se entrenan con conjuntos de datos masivos y opacos, una preocupación clave es que las moléculas que genera TEXTGRAD puedan ser simplemente duplicados de moléculas aprobadas clínicamente para sus respectivos objetivos. Para cuantificar y comprobar el alcance o la existencia de este efecto de "memorización", comparamos las moléculas que genera TEXTGRAD con fármacos aprobados para sus respectivos objetivos proteicos, así como con compuestos químicos farmacocinéticamente similares pero no relacionados y existentes.
Primero comparamos las moléculas generadas por TEXTGRAD para un objetivo proteico particular con todas las moléculas pequeñas clínicamente aprobadas que se encuentran en Drugbank para el mismo objetivo (véase F.3 para los criterios de filtrado) utilizando la puntuación de similitud de Tversky sobre las huellas químicas daylight de RDKit. La puntuación de similitud de Tversky no es simétrica y compara subestructuras entre una molécula variante y una molécula de referencia [106]. En nuestra aplicación, esto es preferible, ya que asigna una puntuación alta a las moléculas generadas (variantes) que contienen la mayoría o todas las subestructuras de la molécula de Drugbank (referencia), incluso si existen otras subestructuras extrañas en la molécula generada que reducen el solapamiento simétrico entre ambas moléculas. Una puntuación de Tversky de 1.0 indica que la molécula de TEXTGRAD es un subconjunto completo de la molécula de Drugbank, mientras que 0.0 indica ausencia de solapamiento.
Con el fin de analizar las estructuras químicas más relevantes, restringimos nuestro análisis a un conjunto de moléculas de TEXTGRAD de alto rendimiento, en lugar de a todas las moléculas de todas las iteraciones. En particular, utilizando la puntuación global descrita en la Ecuación 25, seleccionamos la mejor molécula para cada objetivo proteico y para cada fragmento inicial, para un total de 87 moléculas generadas (29 objetivos druggables \(\times\) 3 fragmentos iniciales) y 118 fármacos clínicamente aprobados en 29 objetivos. Para cada objetivo, calculamos todas las puntuaciones de Tversky por pares entre las 3 moléculas de TEXTGRAD y las moléculas de Drugbank aprobadas para ese objetivo, estableciendo la molécula de Drugbank como referencia y la molécula de TEXTGRAD como variante.
Observamos que la distribución de las puntuaciones de similitud de Tversky era bastante amplia, con una mediana de 0.42 pero con un rango de 0.14 a 0.90 (Figura 2 (b)). Sin embargo, observamos que la similitud de Tversky entre las moléculas de TEXTGRAD y de DrugBank está en realidad ligeramente anticorrelacionada con el rendimiento de las moléculas según lo medido por la puntuación global, lo que sugiere que el procedimiento de optimización de TEXTGRAD está, como mucho, débilmente influenciado por el conocimiento previo de fármacos aprobados. De hecho, para una variedad de moléculas generadas a lo largo de un gradiente de puntuaciones de similitud, las moléculas generadas exhiben puntuaciones QED y Vina que igualan o incluso superan a las de sus homólogas de DrugBank (Figura 2 (d)).
Más allá de la similitud con fármacos conocidos, también nos interesa observar si TEXTGRAD está generando moléculas novedosas, o descubriendo propiedades previamente desconocidas en compuestos existentes, por ejemplo una fuerte afinidad de unión a un objetivo proteico en un compuesto que no ha sido asociado con la proteína. Para responder a esta pregunta, realizamos una búsqueda de similitud de Tanimoto en todo ChEMBL, una base de datos curada manualmente de 2.4 millones de moléculas bioactivas con propiedades similares a fármacos [107]. A diferencia de la puntuación de Tversky, la métrica de Tanimoto mide el solapamiento simétrico entre dos estructuras químicas, donde 1.0 indica una coincidencia exacta y 0.0 ausencia de solapamiento. Clasificamos un compuesto de TEXTGRAD como "novedoso" si y solo si no existe ninguna molécula en ChEMBL con una puntuación de similitud de Tanimoto superior a 0.80.
Aunque los fragmentos iniciales son moléculas conocidas, observamos que a medida que aumenta el número de iteraciones, TEXTGRAD genera moléculas que son progresivamente menos propensas a ser compuestos previamente conocidos. Para la sexta iteración, el 95% de todas las moléculas generadas por TEXTGRAD a través de los 58 objetivos y 3 fragmentos iniciales son novedosas según los criterios anteriores (Figura 2 (a)). Al observar las trayectorias de las moléculas generadas y analizar los gradientes textuales, planteamos la hipótesis de que la retroalimentación proporcionada por las puntuaciones de Vina y QED alienta a TEXTGRAD a explorar el espacio químico más allá de las moléculas conocidas mediante la adición y eliminación progresiva de combinaciones de grupos funcionales. Dado que estas actualizaciones químicas pueden formar un número combinatorio de estructuras únicas, es razonable que TEXTGRAD alcance regiones del espacio químico previamente inexploradas en un número relativamente pequeño de iteraciones.