Ir al contenido principal

De libros escaneados a ebooks cómodos de leer.

Convierte PDF a EPUB o Markdown. También puedes traducir documentos PDF y EPUB.

Suelta aquí un PDF o EPUB

Convierte o traduce tu documento.

Un archivo a la vez

Un libro en papel, listo para cualquier pantalla.

Selecciona, busca y ajusta el tamaño del texto escaneado, conservando ilustraciones y fórmulas. Olvídate de ampliar y desplazar la página para leer cómodamente en tu móvil o lector.

Página escaneada / Inglés
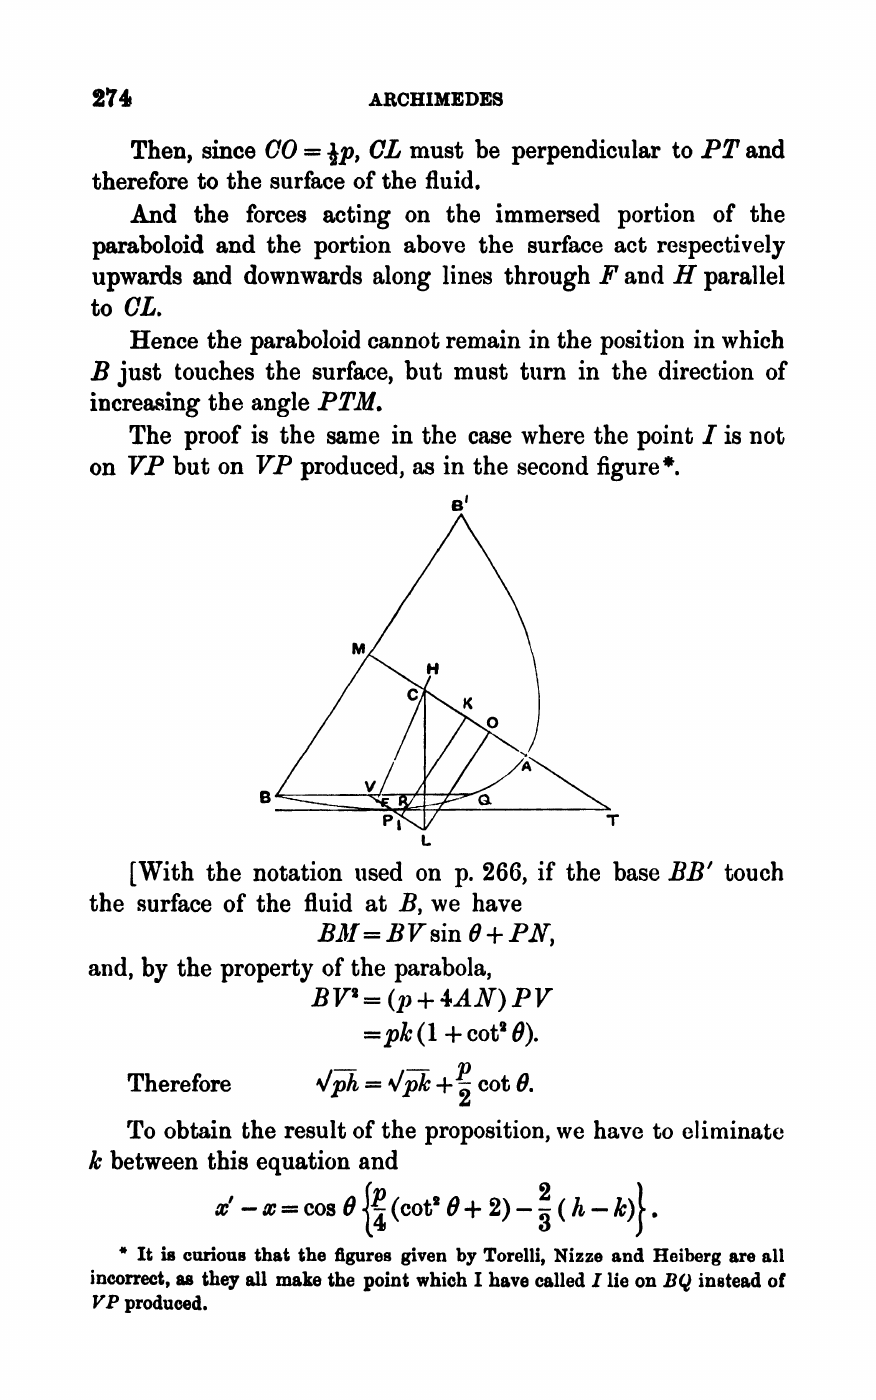
On floating bodies / p. 274
Texto recompuesto / español de España

Las obras de Arquímedes

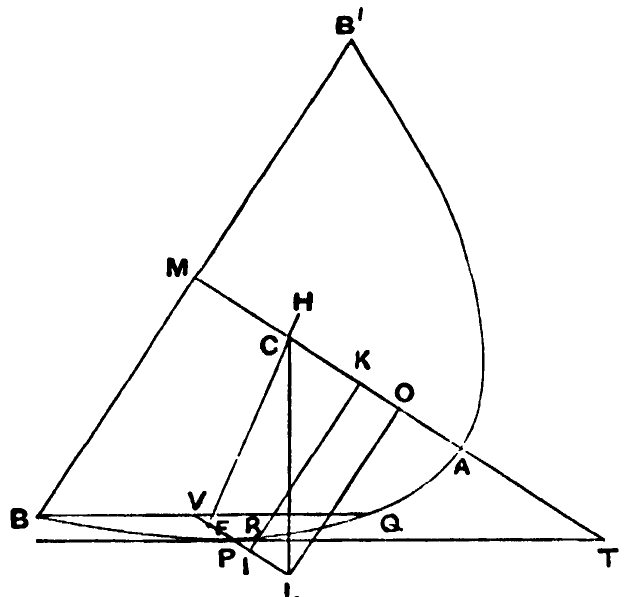
Entonces, puesto que CO = ½p, CL debe ser perpendicular a PT y, por tanto, a la superficie del fluido.

Y las fuerzas que actúan sobre la parte sumergida del paraboloide y sobre la parte situada por encima de la superficie actúan, respectivamente, hacia arriba y hacia abajo, a lo largo de rectas que pasan por F y H y son paralelas a CL.

Por tanto, el paraboloide no puede permanecer en la posición en que B apenas toca la superficie, sino que debe girar en el sentido de aumentar el ángulo PTM.

La demostración es la misma cuando el punto I no está en VP, sino en su prolongación, como en la segunda figura*.

Diagrama geométrico del original

[Con la notación de la p. 266, si la base BB′ toca la superficie del fluido en B, tenemos

BM=BVsinθ+PN

y, por la propiedad de la parábola,

BV2=(p+4AN)PV=pk(1+cot2θ)

Por tanto

ph=pk+p2cotθ

Para obtener el resultado de la proposición, debemos eliminar k entre esta ecuación y

x′−x=cosθ{p4(cot2θ+2)−23(h−k)}.

* Es curioso que las figuras de Torelli, Nizze y Heiberg sean todas incorrectas, pues sitúan el punto que he llamado I en BQ en vez de en la prolongación de VP.

274
  • Reconocimiento de texto
  • Ilustraciones y fórmulas
  • Texto ajustable
  • Páginas adaptables

¿Qué quieres hacer?

Conversión PDF

Convierte páginas escaneadas en texto editable o en un EPUB para tu lector electrónico.

EPUB
EPUB se adapta a tu lector, con solo la traducción o una edición bilingüe.
Markdown
Markdown permite editar, citar y organizar el texto.
Qué PDFs merece más la pena convertir
Libros escaneados, artículos, manuales, apuntes, maquetaciones a doble columna y archivos cargados de fórmulas, tablas o notas son los casos donde este flujo más se nota.
Por qué esto es más que OCR básico
Reconocer las palabras es solo el primer paso. Un resultado realmente útil también tiene que conservar fórmulas, tablas, maquetación y orden de lectura para poder buscar, corregir y seguir trabajando.

Traducción de documentos

Traduce PDF y EPUB, con salida EPUB bilingüe

Elige el idioma de destino e indica tus preferencias de términos y nombres. Los PDF pueden generar PDF, EPUB o Markdown; los EPUB, versiones traducidas o bilingües.

Tener en cuenta el contexto
La traducción consulta el texto cercano para mantener el sentido entre pasajes.
Indicar términos y nombres
Especifica antes de empezar cómo traducir términos técnicos, nombres y expresiones.
Leer en ambos idiomas
El EPUB bilingüe coloca la traducción después del pasaje original para facilitar la comprobación de detalles importantes.
Conservar la estructura del libro
Se conservan en lo posible capítulos, navegación, imágenes y estructura de lectura, y se comprueban los errores estructurales.

Leer

Termina el proceso. Sigue leyendo.

Después de convertir o traducir tu libro, ábrelo en PDF Craft en el ordenador o el móvil y sigue leyendo.

Conoce las apps de lectura
Biblioteca de ejemplo

Analizar

Haz preguntas mientras lees y comprueba la fuente

Abre el PDF o EPUB convertido o traducido en PDF Craft para escritorio. Usa Wiki Graph para encontrar pasajes relevantes o pide a la IA que extraiga las ideas principales. Selecciona un resultado o una cita de la respuesta para ir al pasaje correspondiente.

Descubrir Wiki Graph
DeepSeek-OCR: Contexts Optical Compression

¿Qué pretende comprobar este artículo?

Preguntas a la IA

Los autores quieren comprobar si es posible representar textos largos con menos tokens visuales.

Después se preguntan cuántos tokens visuales hacen falta como mínimo para decodificar un documento de 1000 palabras.

Texto original

1. Introduction

Current Large Language Models (LLMs) face significant computational challenges when processing long textual content due to quadratic scaling with sequence length. We explore a potential solution: leveraging visual modality as an efficient compression medium for textual information. A single image containing document text can represent rich information using substantially fewer tokens than the equivalent digital text, suggesting that optical compression through vision tokens could achieve much higher compression ratios.

This insight motivates us to reexamine vision-language models (VLMs) from an LLM-centric perspective, focusing on how vision encoders can enhance LLMs’ efficiency in processing textual information rather than basic VQA [12, 24, 32, 41, 16] what humans excel at. OCR tasks, as an intermediate modality bridging vision and language, provide an ideal testbed for this vision-text compression paradigm, as they establish a natural compression-decompression mapping between visual and textual representations while offering quantitative evaluation metrics.

Accordingly, we present DeepSeek-OCR, a VLM designed as a preliminary proof-of-concept for efficient vision-text compression. Our work makes three primary contributions:

First, we provide comprehensive quantitative analysis of vision-text token compression ratios. Our method achieves 96%+ OCR decoding precision at 9-10× text compression, ∼90% at 10-12× compression, and ∼60% at 20× compression on Fox [21] benchmarks featuring diverse document layouts (with actual accuracy being even higher when accounting for formatting differences between output and ground truth), as shown in Figure 1(a). The results demonstrate that compact language models can effectively learn to decode compressed visual representations, suggesting that larger LLMs could readily acquire similar capabilities through appropriate pretraining design.

Second, we introduce DeepEncoder, a novel architecture that maintains low activation memory and minimal vision tokens even with high-resolution inputs. It serially connects window attention and global attention encoder components through a 16× convolutional compressor. This design ensures that the window attention component processes a large number of vision tokens, while the compressor reduces vision tokens before they enter the dense global attention component, achieving effective memory and token compression.

Third, we develop DeepSeek-OCR based on DeepEncoder and DeepSeek3B-MoE [19, 20]. As shown in Figure 1(b), it achieves state-of-the-art performance within end-to-end models on OmniDocBench while using the fewest vision tokens. Additionally, we equip the model with capabilities for parsing charts, chemical formulas, simple geometric figures, and natural images to enhance its practical utility further. In production, DeepSeek-OCR can generate 33 million pages of data per day for LLMs or VLMs using 20 nodes (each with 8 A100-40G GPUs).

In summary, this work presents a preliminary exploration of using visual modality as an efficient compression medium for textual information processing in LLMs. Through DeepSeek-OCR, we demonstrate that vision-text compression can achieve significant token reduction (7-20×) for different historical context stages, offering a promising direction for addressing long-context challenges in large language models. Our quantitative analysis provides empirical guidelines for VLM token allocation optimization, while the proposed DeepEncoder architecture showcases practical feasibility with real-world deployment capabilities. Although focused on OCR as a proof-of-concept, this paradigm opens new possibilities for rethinking how vision and language modalities can be synergistically combined to enhance computational efficiency in large-scale text processing and agent systems.

Ejemplo de lecturaDeepSeek-OCR: Contexts Optical Compression (Wei, Sun & Li) CC BY 4.0

Haz sitio a los libros que quieres leer.

Soluciones

Código abierto

Desarrollado abiertamente

Las bibliotecas de conversión de PDF, traducción de EPUB y Wiki Graph son de código abierto. Puedes examinarlas, usarlas por separado o contribuir.

Explorar el código abierto

Antes de empezar

¿EPUB o Markdown?

Si quieres aumentar el tamaño del texto y leer cómodamente en el móvil o en un lector de libros electrónicos, elige EPUB. Si prefieres editar el texto, tomar notas de investigación o armar una base de conocimientos, elige Markdown. El formato EPUB redistribuye el texto según la pantalla, mientras que Markdown facilita la edición posterior; elige según el uso que vayas a darle al documento.

¿Qué debo revisar?

Abre primero el archivo resultante en tu lector o editor habitual y comprueba si el índice, los párrafos y las imágenes se leen bien. En artículos académicos conviene revisar el salto entre dos columnas, las fórmulas, las tablas y las notas al pie; si tienes dudas sobre algún pasaje, compararlo con el PDF original te ayudará a encontrar la referencia.

¿Qué afecta a la calidad del OCR?

Las páginas escaneadas con nitidez y bien alineadas se reconocen mejor. En libros antiguos, conviene revisar con más atención la letra pequeña, las sombras del lomo y las tablas densas tras la conversión. Si necesitas conservar las notas al pie de página, puedes optar por el modo refinado, que incluye extracción de notas al pie y refinamiento de páginas, y guardar el PDF original para consultarlo mientras lees.

¿Cuánto cuesta y cuánto tarda?

El coste se calcula según el número de páginas del documento y el modo de procesamiento elegido; puedes consultar las tarifas vigentes en la página de recarga. Tras enviar el archivo, puedes seguir el progreso en la lista de tareas y descargar el resultado al terminar. El tamaño del documento, la complejidad de la maquetación y la carga del servicio influyen en el tiempo de procesamiento.

¿Cómo es la salida bilingüe?

En el EPUB bilingüe, la traducción sigue a cada bloque del texto original. No es un PDF a dos columnas. Elige solo la traducción si prefieres una edición en un único idioma.

Empieza con un documento.

Convierte PDF a EPUB o Markdown. También puedes traducir documentos PDF y EPUB.

Convierte o traduce tu documento