Ir al contenido principal
TextGrad: Automatic "Differentiation" via TextMert Yuksekgonul et al.

F.4 Inicialización

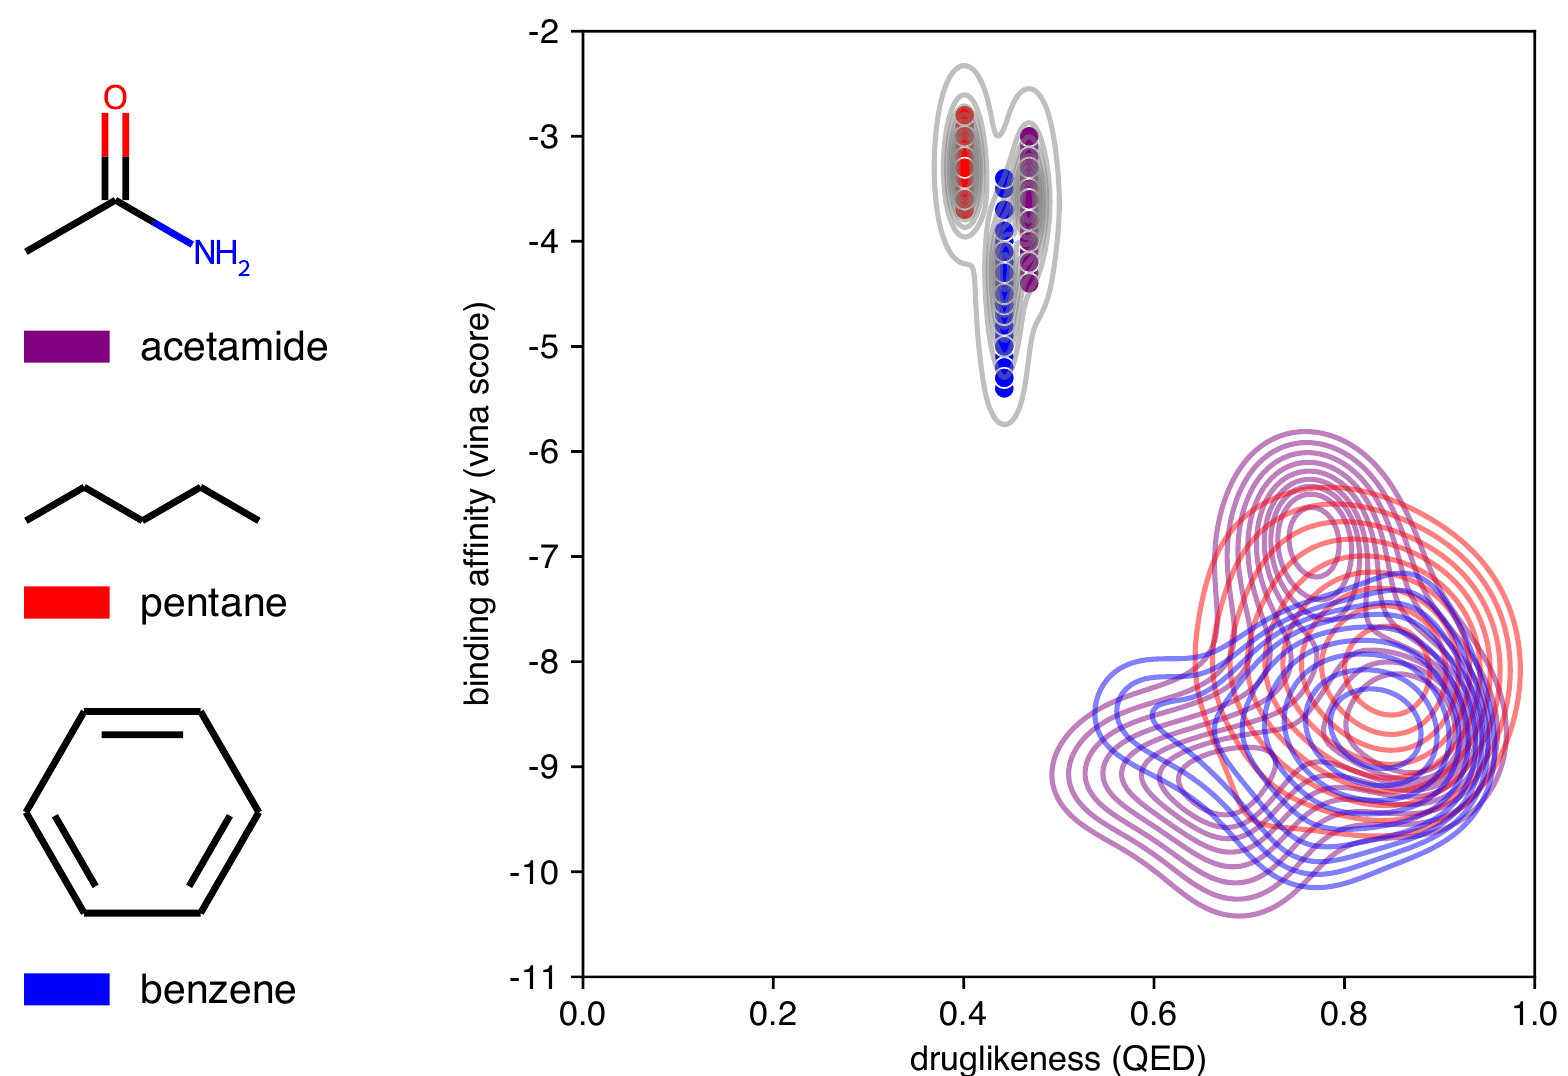
Figura complementaria 1: Inicialización de moléculas. Inicializamos TEXTGRAD con moléculas fragmento de tres grupos funcionales diversos y optimizamos cada molécula inicial durante 10 iteraciones para los 58 objetivos del conjunto de referencia DOCKSTRING. Para cada fragmento y cada proteína, realizamos una posselección sobre las moléculas generadas utilizando la puntuación resumen descrita en la ecuación 25 y visualizamos la distribución resultante. Observamos que, si bien las distribuciones iniciales de las puntuaciones QED y Vina de los fragmentos de partida varían enormemente, la distribución de las moléculas optimizadas presenta un alto grado de solapamiento.

En la práctica, la optimización molecular suele acelerarse mediante un cribado de preoptimización a gran escala, en el que bibliotecas de millones o incluso miles de millones de estructuras químicas existentes se puntúan y clasifican por acoplamiento, farmacocinesia y otras métricas. Solo las estructuras más prometedoras, denominadas "líderes", son refinadas posteriormente por químicos medicinales [104]. Aunque TEXTGRAD es capaz de optimizar cualquier molécula inicial, en este trabajo, para caracterizar con mayor precisión su rendimiento y evitar sesgar sus diseños hacia fármacos existentes, seleccionamos nuestras tres moléculas iniciales a partir de fragmentos simples de grupos funcionales comunes, mostrados en la Figura 1. Estos fragmentos son muy diversos y pertenecen a diferentes grupos funcionales. Aunque estos fragmentos iniciales tienen características de farmacocinesia y afinidad de unión diferentes, el impacto del fragmento de partida en el rendimiento de TEXTGRAD es mínimo, y TEXTGRAD es capaz de generar moléculas con alta farmacocinesia y afinidad de unión a partir de los tres fragmentos.