
E.6 Objetivos implícitos
Otra preocupación clave en la aplicación de LLM en la ciencia es su propensión a las alucinaciones, donde los modelos generan respuestas fácticamente incorrectas o ilógicas mientras intentan satisfacer las solicitudes del usuario [105]. En nuestro contexto, estas alucinaciones podrían manifestarse mediante TEXTGRAD proponiendo moléculas inválidas, tóxicas o indeseables de otro modo para optimizar su función objetivo. Controlamos las alucinaciones graves preprocesando las moléculas mediante la sanitización de RDKit, asegurando como mínimo que TEXTGRAD genere moléculas químicamente válidas. Sin embargo, este simple paso de preprocesamiento no especifica completamente el comportamiento químico deseable. Una estrategia directa sería codificar exhaustivamente todas las métricas posibles de deseabilidad en moléculas farmacológicas más allá de la farmacocinesia y la afinidad de unión en la función objetivo, y extenderla para incluir la sintetizabilidad, la toxicidad, entre otros criterios. Desafortunadamente, este enfoque no es realista ni factible, ya que no todos los criterios de deseabilidad tienen métricas computacionales maduras. Por lo tanto, una pregunta clave es si TEXTGRAD obedece los llamados objetivos implícitos durante su proceso de optimización que limitan el comportamiento ilógico o indeseable.
Para evaluar la extensión o existencia de moléculas indeseables, podemos caracterizar la nocividad de las moléculas generadas, centrándonos en la mutagenicidad y la toxicidad clínica. La mutagenicidad se refiere a la capacidad de un fármaco de inducir alteraciones genéticas, lo que puede provocar daño en el ADN y efectos nocivos a largo plazo. La toxicidad clínica se refiere a una amplia gama de efectos secundarios adversos a corto o largo plazo. Es importante destacar que ni la farmacocinesia
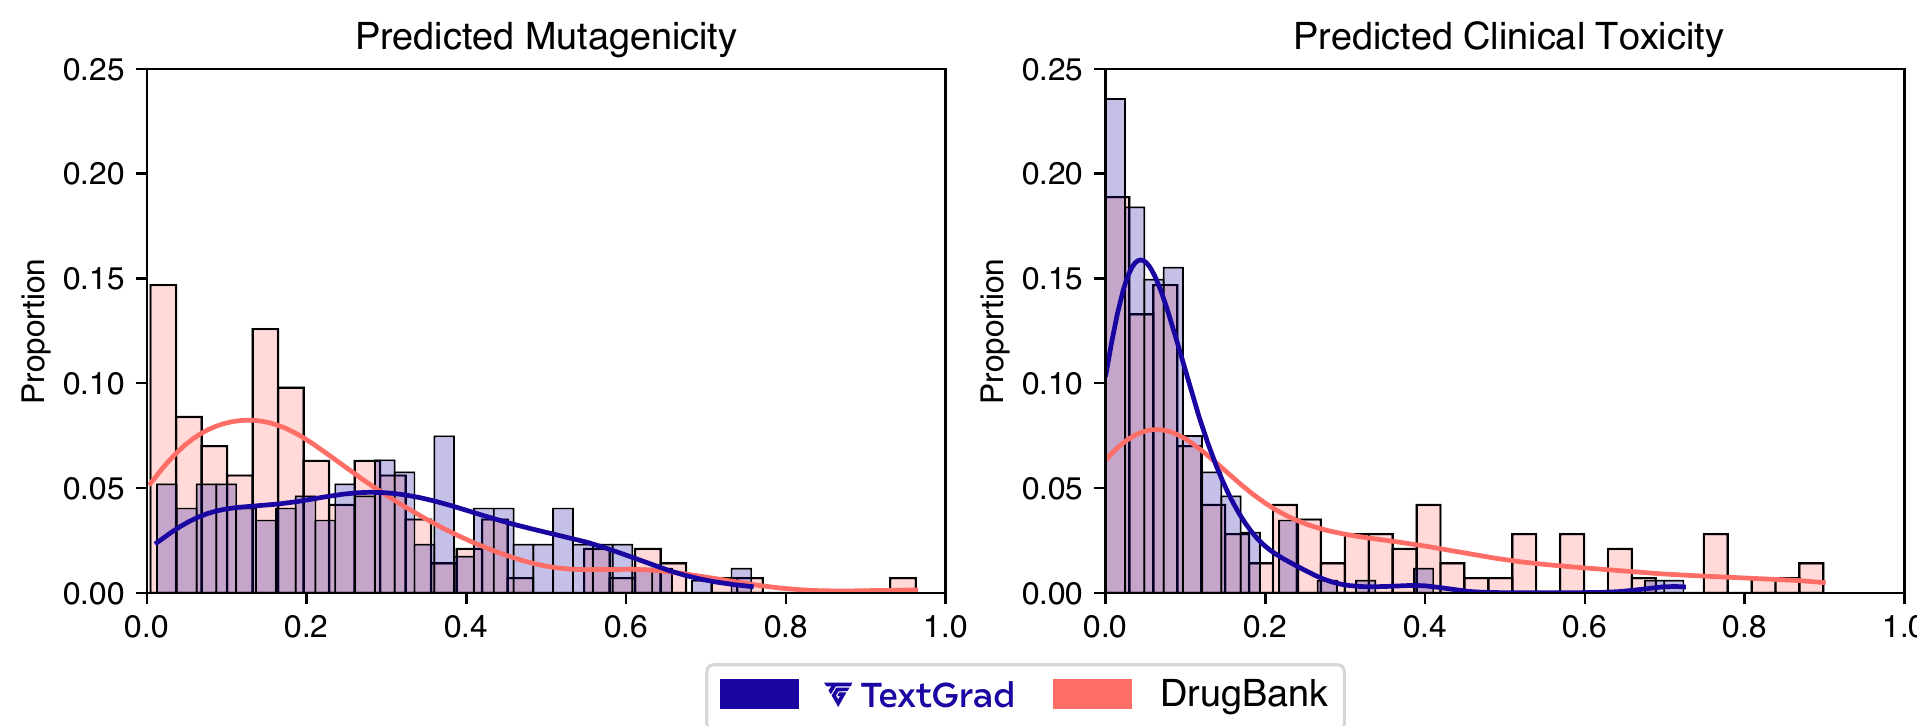
ni la afinidad de unión están fuertemente correlacionadas con estos criterios, y por lo tanto estas métricas de deseabilidad no se optimizan directamente ni se codifican explícitamente de otro modo en los objetivos de TEXTGRAD.
Para evaluar la propensión a la mutagenicidad y la toxicidad clínica, empleamos el modelo ADMET-AI, que predice estas puntuaciones a partir de las estructuras químicas de las moléculas [108]. ADMET-AI emplea un modelo de aprendizaje profundo entrenado en múltiples conjuntos de datos relevantes. En particular, para la mutagenicidad, ADMET-AI se entrena con 7.255 fármacos del conjunto de datos Ames, un ensayo de mutación reversa bacteriana para el cribado rápido de grandes cantidades de compuestos que pueden inducir daño genético y mutaciones de cambio de marco. Una etiqueta predicha de 1.0 indica una alta probabilidad de que el fármaco induzca mutagenicidad, mientras que una etiqueta de 0.0 indica una baja probabilidad. Para la toxicidad clínica, ADMET-AI se entrena con el conjunto de datos ClinTox, un conjunto de datos de 1.484 fármacos que consiste en moléculas que han fracasado en ensayos clínicos por razones de toxicidad y también fármacos asociados con ensayos exitosos. De manera similar, una etiqueta predicha de 1.0 indica una alta probabilidad de toxicidad clínica, mientras que una etiqueta de 0.0 indica una baja probabilidad.
Una vez más, restringimos nuestro análisis a las moléculas generadas con mejor rendimiento con objetivos farmacológicos según la puntuación general, y seleccionamos la mejor molécula para cada objetivo proteico y para cada fragmento inicial, para un total de 87 moléculas generadas. Luego comparamos su mutagenicidad y toxicidad clínica predichas con las 118 moléculas clínicamente aprobadas de DrugBank. Observamos que tanto para la Mutagenicidad como para la Toxicidad Clínica, las moléculas generadas por TEXTGRAD tienen distribuciones predichas que indican una baja probabilidad de efectos nocivos, y coinciden estrechamente con las distribuciones de las moléculas clínicamente aprobadas. En conjunto, estos resultados sugieren que TEXTGRAD evita implícitamente proponer moléculas nocivas, aunque estos criterios no estén codificados directamente en su función de pérdida.