
3.4 Optimización de moléculas
TEXTGRAD admite una variedad de problemas de optimización, incluidos los problemas de optimización multiobjetivo que se encuentran comúnmente en aplicaciones científicas y de ingeniería. Por ejemplo, en el descubrimiento de fármacos, los investigadores buscan descubrir o diseñar moléculas que maximicen una variedad de objetivos con respecto a la sintetizabilidad, la eficacia y la seguridad [53, 54]. Para demostrar las aplicaciones de TEXTGRAD a la optimización multiobjetivo, aplicamos TEXTGRAD a la optimización de moléculas de fármacos y mostramos cómo nuestro framework puede interactuar con herramientas computacionales y optimizar estructuras químicas hacia la mejora simultánea de su afinidad de unión y su farmacabilidad.
Tarea: Una consideración crítica para las posibles moléculas de fármacos es su afinidad de unión, que representa la fuerza de las interacciones entre la molécula y su diana proteica. Los diseñadores de fármacos buscan moléculas con altas afinidades de unión a dianas farmacológicas relevantes, ya que requieren dosis más bajas y menos frecuentes para lograr eficacia. Esta afinidad se puede cuantificar mediante la energía libre , que describe la relación de probabilidades entre pares ligando-receptor unidos y no unidos. se puede estimar usando simulaciones de "docking" de unión proteína-ligando [55, 56]. En nuestros experimentos, empleamos la puntuación Vina de la herramienta Autodock Vina, un simulador de docking basado en física ampliamente usado [57]. Cuanto más negativo es la puntuación Vina, mayor es la probabilidad de que el fármaco se una a su diana prevista.
Las posibles moléculas de fármacos también se evalúan por su farmacabilidad, que estima cómo se comportará la molécula in vivo, con respecto a la solubilidad, la permeabilidad, la estabilidad metabólica y los efectos de transporte. Las moléculas con alta farmacabilidad tienen más probabilidades de ser absorbidas por el cuerpo y alcanzar sus dianas [58]. Una métrica popular para la "farmacabilidad" es la Estimación Cuantitativa de la Farmacabilidad (QED), una métrica compuesta ponderada de características químicas importantes como el peso molecular, la lipofilicidad, el área de superficie polar, entre otras. La puntuación QED varía de 0 a 1, donde 1 indica alta farmacabilidad [59].
Aunque hay muchas más consideraciones para moléculas exitosas, en nuestros experimentos restringimos nuestros objetivos a minimizar la puntuación Vina y maximizar el QED, debido a la relativa madurez de estas dos métricas. Las compensaciones competitivas entre estas dos métricas hacen que la tarea de optimización sea realista y desafiante. En particular, las puntuaciones de docking tienden a preferir moléculas más grandes con muchos grupos funcionales que maximizan las interacciones con un sitio de unión [55, 56, 60]. En contraste, la farmacabilidad favorece moléculas más ligeras y simples que tienen mejores propiedades de absorción [58, 59]. Por lo tanto, optimizar simultáneamente ambos objetivos no es trivial.
Métodos: Aplicamos TEXTGRAD a la optimización de moléculas de fármacos codificando moléculas como cadenas SMILES y construyendo una pérdida multiobjetivo a partir de las puntuaciones Vina y QED. Es decir, realizamos optimización de instancias sobre cadenas SMILES, donde los gradientes generados por TEXTGRAD con respecto a la pérdida multiobjetivo se usan para actualizar el texto que representa la molécula.
Usamos gpt-4o como nuestro LLM con el texto del prompt que se encuentra en el Apéndice F.2. En cada iteración, la molécula actual se evalúa estimando su afinidad de unión a la proteína diana usando la puntuación Vina de Autodock Vina y usando la puntuación QED para la farmacabilidad de RDKit (Apéndice F.1). Cada molécula se inicializa como un pequeño fragmento químico de un grupo funcional. Aplicamos TEXTGRAD a las 58 dianas en el benchmark de evaluación de moléculas DOCKSTRING [61]. Estas 58 dianas consisten en proteínas clínicamente relevantes muestreadas de una variedad de clases estructurales, 29 de las cuales tienen fármacos clínicamente aprobados. Para cada diana, optimizamos un fragmento inicial usando TEXTGRAD durante 10 iteraciones, para 3 fragmentos iniciales únicos. Para evaluar nuestro rendimiento, comparamos las características de las moléculas generadas por TEXTGRAD con fármacos clínicamente aprobados para la proteína respectiva (Apéndice F.3).
Resultados: Para los 58 objetivos, TEXTGRAD genera de manera consistente moléculas con una afinidad de unión y una farmacocompatibilidad mejoradas, independientemente del fragmento inicial de partida (Apéndice F.4). Para los 29 objetivos proteicos con
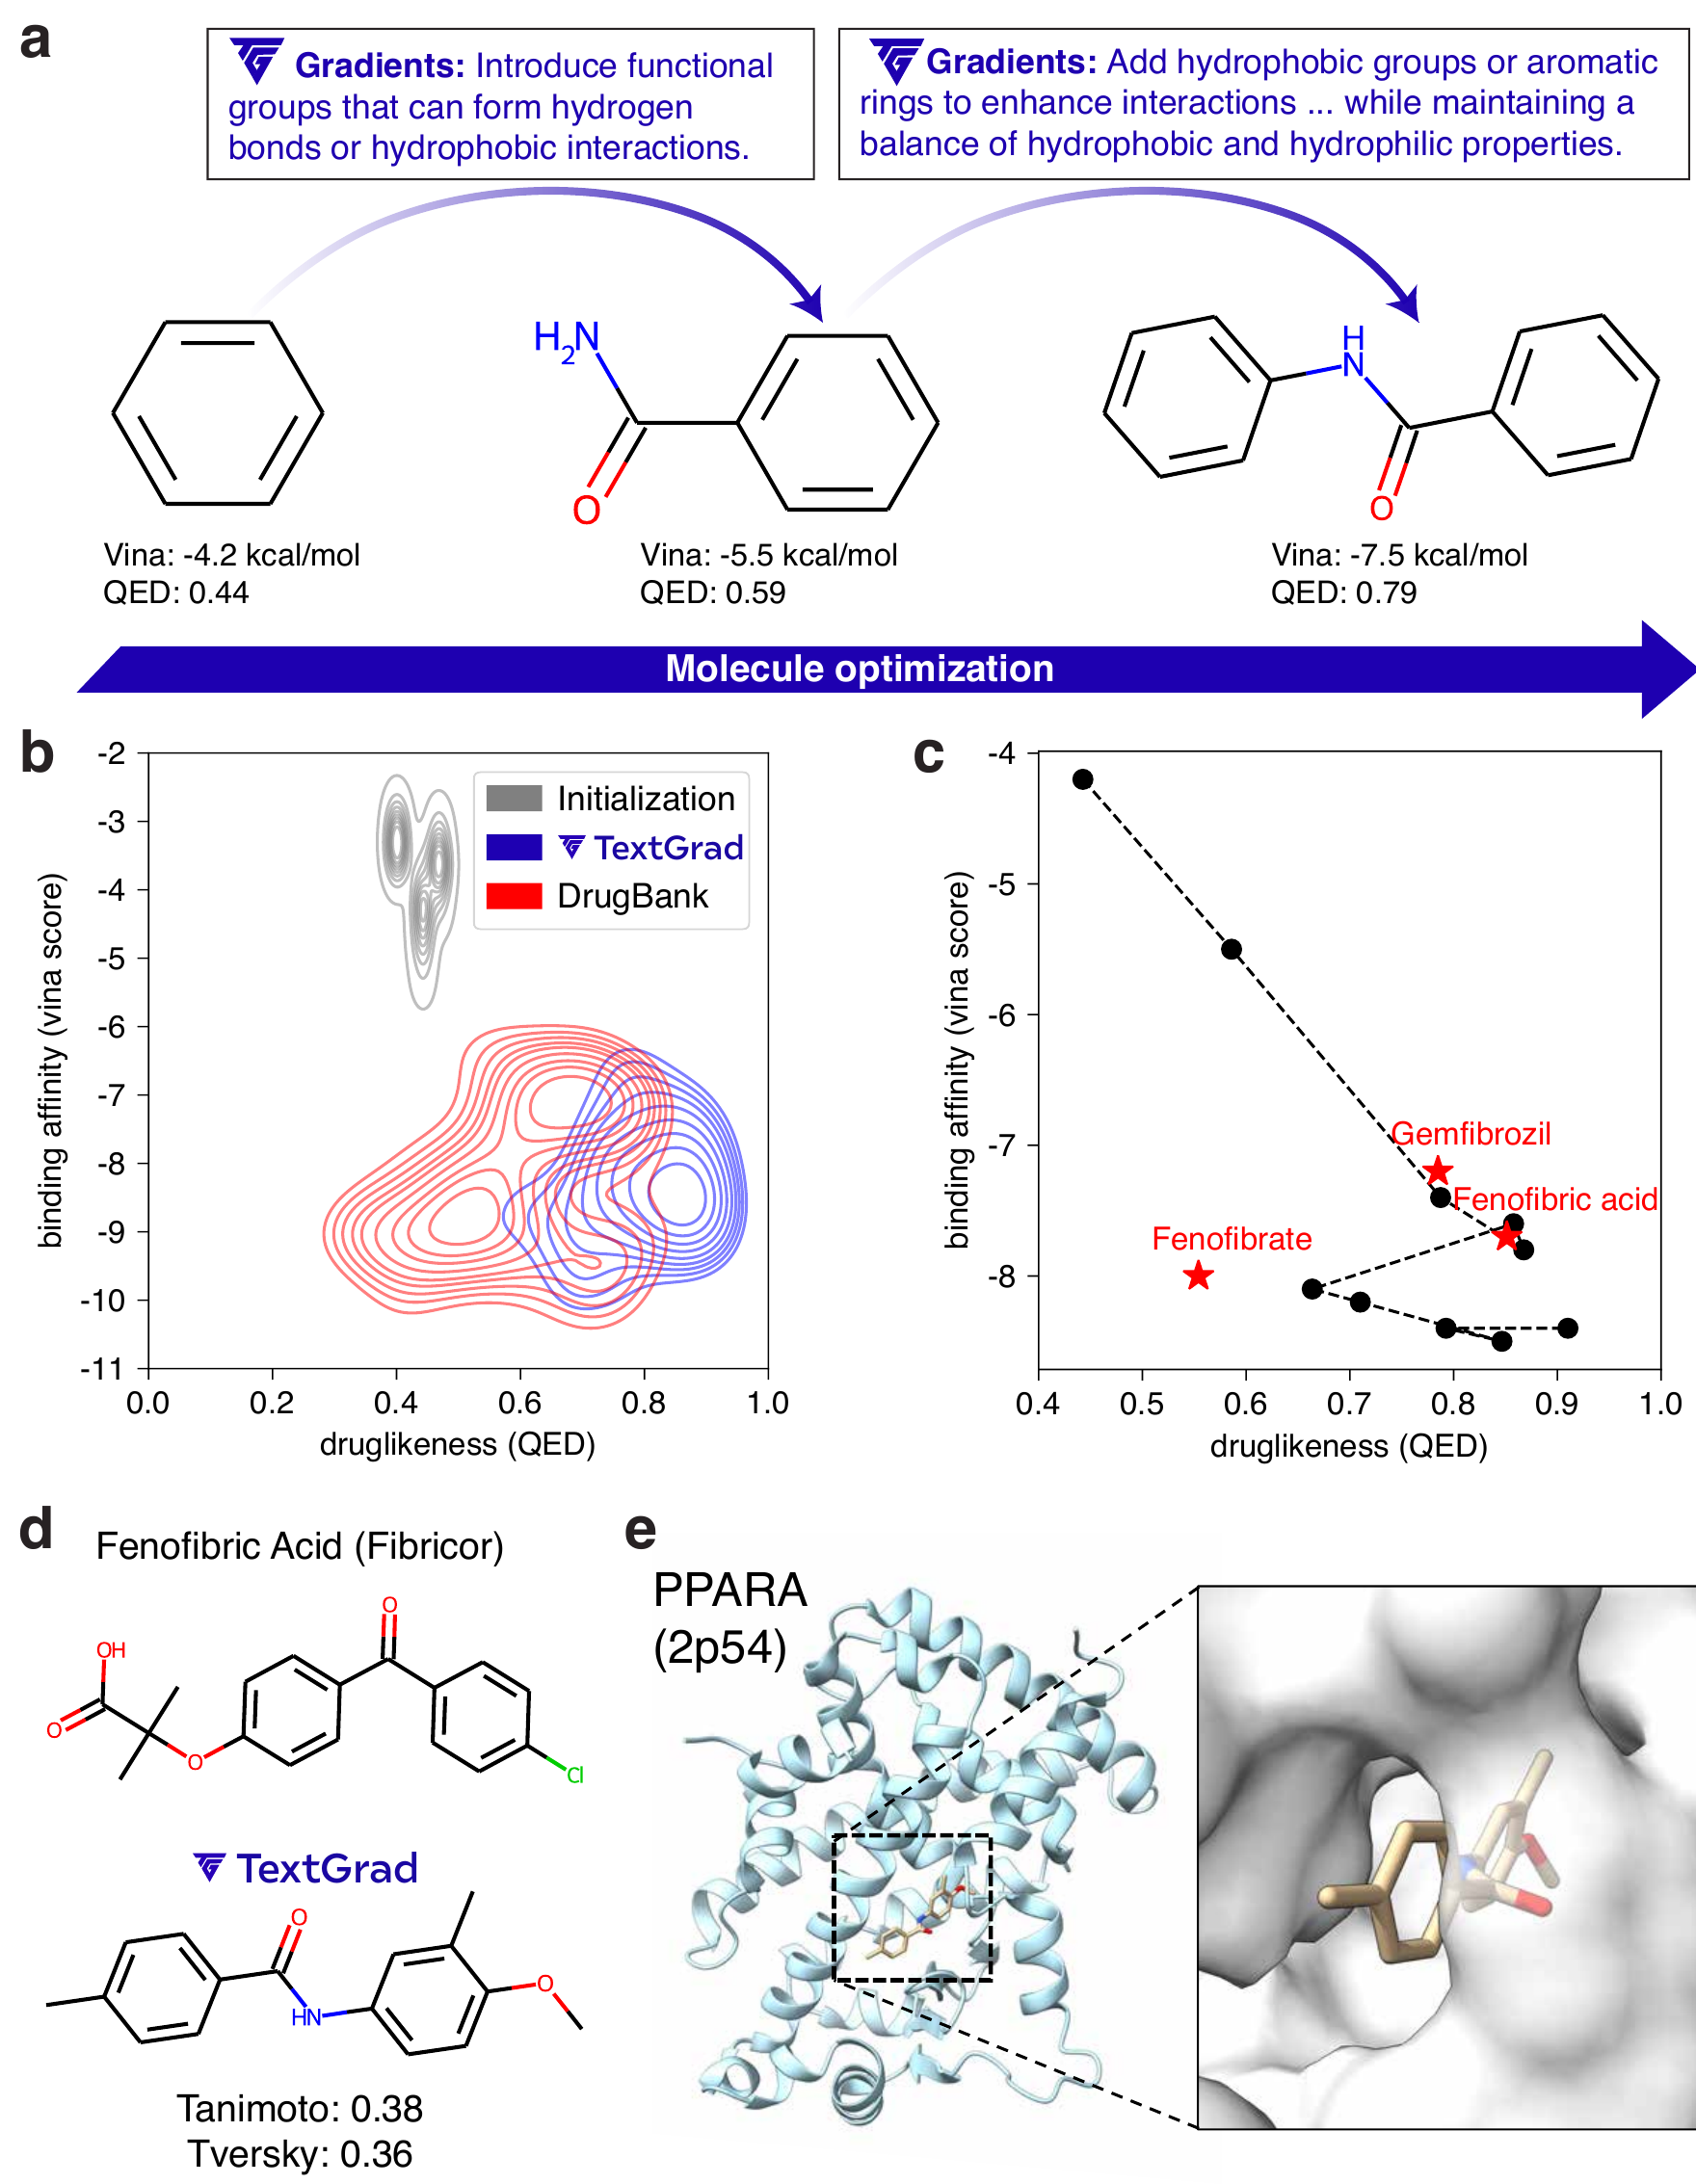
fármacos clínicamente aprobados, observamos que TEXTGRAD genera moléculas con una afinidad y una farmacocompatibilidad altamente competitivas en comparación con las moléculas clínicas evaluadas utilizando la misma función de pérdida (Figura 2 (b)). Las moléculas resultantes exhiben estructuras únicas en comparación con sus contrapartes clínicamente aprobadas y los compuestos existentes (Apéndice F.5), mientras mantienen perfiles de seguridad in silico similares (Apéndice F.6). Si bien existen métodos alternativos de aprendizaje automático para la generación de moléculas de novo, TEXTGRAD ofrece dos ventajas clave sobre sus contrapartes: en primer lugar, al combinar herramientas tradicionales de quimioinformática con las capacidades de conocimiento general y razonamiento de los LLM, TEXTGRAD produce resultados competitivos incluso sin un conjunto de entrenamiento previo. En segundo lugar, el marco de gradientes en lenguaje natural de TEXTGRAD produce decisiones explicables, lo que permite a los investigadores comprender con precisión cómo y por qué se construyó la estructura de una molécula. Juntas, estas dos características auguran un futuro prometedor para el papel de los agentes de IA en el descubrimiento científico.