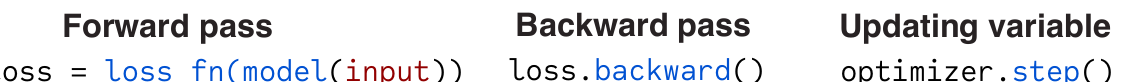당신은 추론 질문에 답할 것입니다. 단계별로 생각하세요. 응답의 마지막 줄은 다음 형식이어야 합니다: 'Answer: 'SVAULE' 여기서 VALUE는 수치 값입니다.
초기화 시 프롬프트 (정확도 = 77.8%)
당신은 추론 질문에 답할 것입니다. 각 항목과 그 수량을 명확하고 일관된 형식으로 나열하세요, 예: - 항목: 수량'. 목록에서 직접 값을 합산하고 간결한 합계를 제공하세요. 최종 답변이 다음 형식으로 명확하게 표시되도록 하세요: 'Answer: 'SVAULE' 여기서 VALUE는 수치 값입니다. 각 항목이 질의의 맥락과 관련이 있는지 확인하고 입력의 잠재적 오류나 모호성을 처리하세요. 최종 개수를 다시 확인하여 정확성을 보장하세요."
최적화 후 프롬프트 (정확도 = 91.9%)
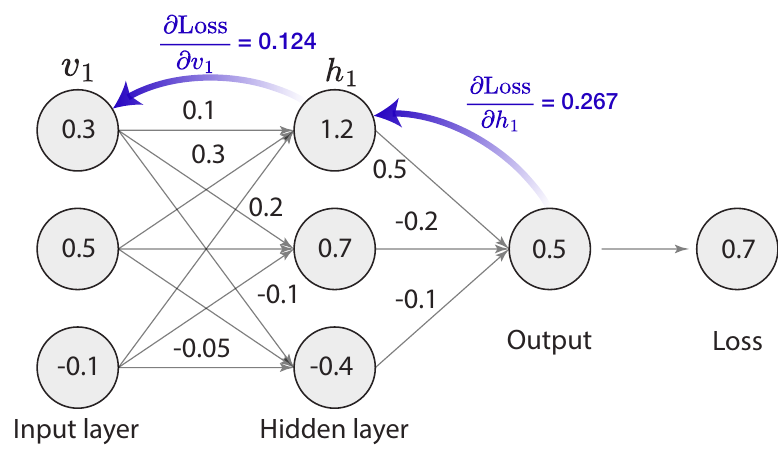
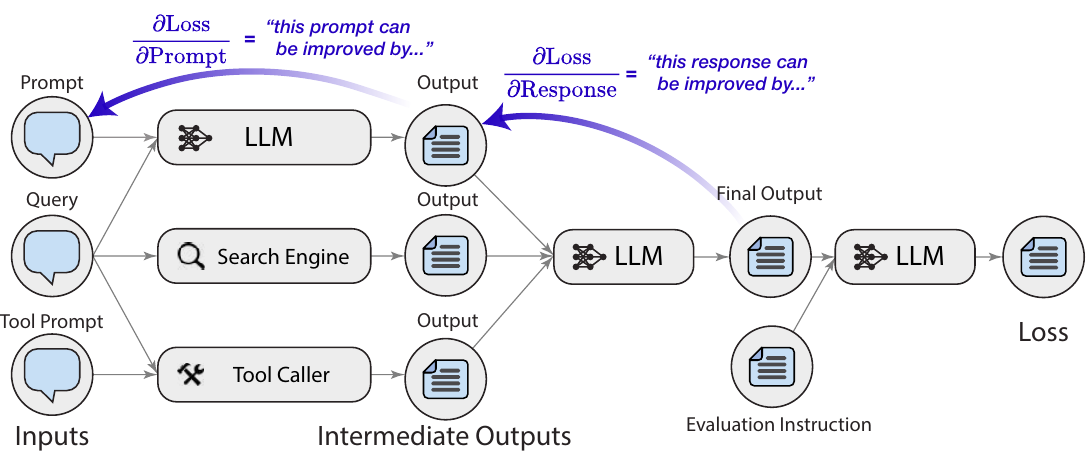
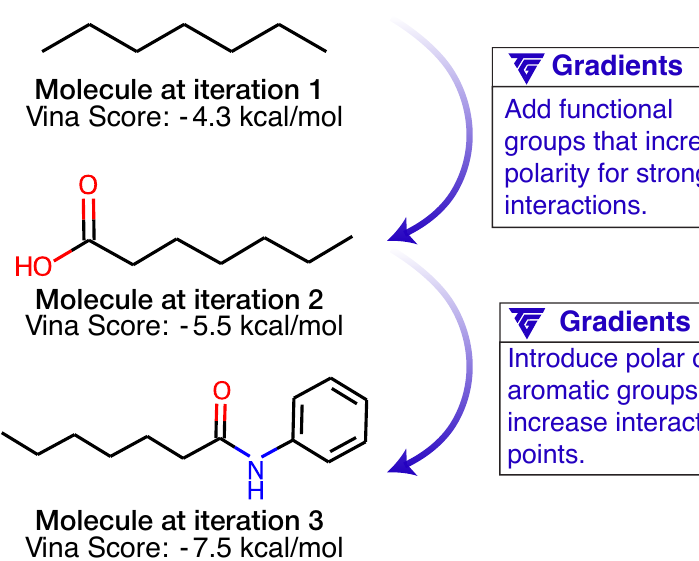
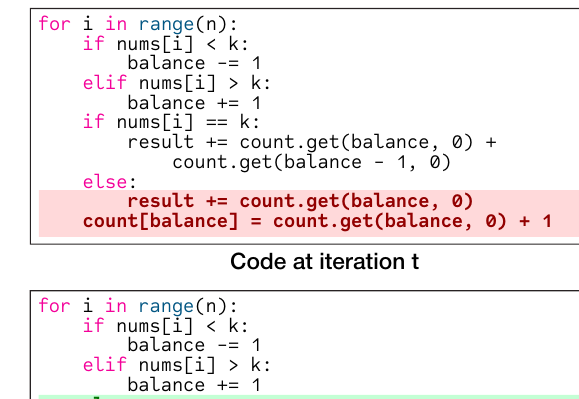
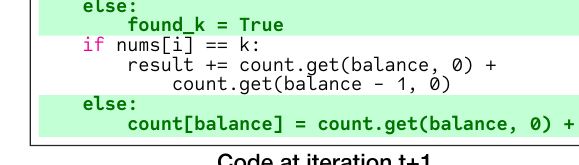
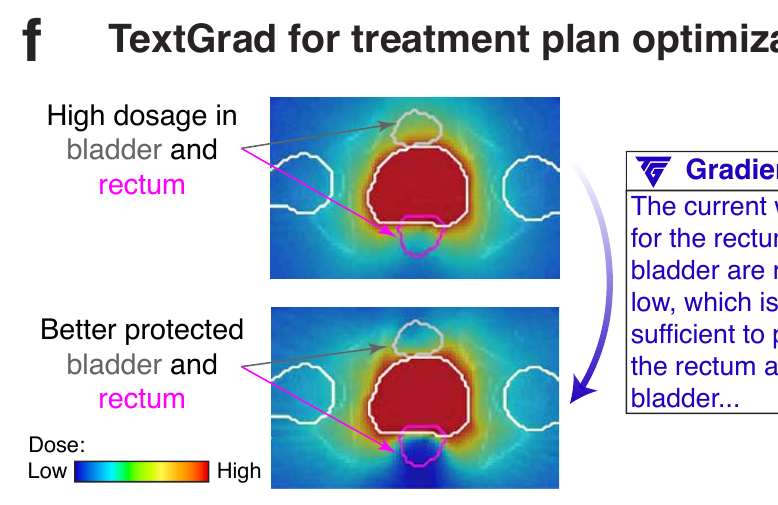
그림 1: 텍스트를 통한 자동 "미분"(a, b). 기울기의 역전파는 딥러닝의 원동력이다. 우리는 블랙박스 AI 시스템의 복합 시스템에 대해서는 기울기를 가지고 있지 않지만, 텍스트 기반 피드백에 대해 유사한 역전파를 구성할 수 있으며, 이것이 TEXTGRAD의 기반을 이룬다. TEXTGRAD의 추상화(c). 우리는 PyTorch와 동일한 추상화와 구문을 공유하여 우리 프레임워크를 일반화 가능하고 배우기 쉽게 만들었다. TEXTGRAD의 응용(d, e, f, g). 3.4절에서 우리는 약물 유사성과 단백질 결합 친화력 같은 속성에 대해 분자 구조를 최적화한다(d). 3.1절에서 우리는 코딩 문제에 대한 해답을 최적화한다(e). 3.5절에서 우리는 환자 결과를 개선하기 위해 방사선 치료 계획을 최적화한다(f). 3.3절에서 우리는 언어 모델의 추론을 개선하기 위해 프롬프트를 최적화한다(g). 여기서 우리는 최적화할 자유 매개변수인 프롬프트를 초록색으로 표시하고, 두 문자열의 연결을 나타내기 위해 +를 사용하며, LLM(x)를 사용하여 x를 언어 모델에 프롬프트로 제공하여 응답을 수집한다. 우리는 다음과 같은 연쇄 표기법을 사용할 것이다:
여기서 우리는 순방향 함수가 LLM 호출일 때 기울기 연산자에 ∇LLM을 사용한다. 특히, 이 함수는 '이 예측은 다음과 같이 개선될 수 있습니다...'와 같은 자연어 피드백을 반환하며, 여기서 피드백은 최적화에서의 기울기와 유사하게, 하류 목표를 개선하기 위해 변수를 어떻게 수정할지 설명한다. 우리는 먼저 평가를 사용하여 Prediction 변수에 대한 피드백을 수집한다. 그다음, 이 피드백과 (Prompt LLM Prediction) 호출이 주어지면, 우리는 Prompt에 대한 피드백을 수집한다.
“여기서 우리는 출력 변수에 후속자가 없는 경우(예: ∇LLM(Prediction,Evaluation))와 후속자가 있어 그래디언트를 가지는 경우(예: ∇LLM(Prompt,Prediction,∂Prediction∂Loss)) 모두를 표기하기 위해 표기를 중복 정의한다는 점에 유의하라.
다음은 xLLMyLLML와 같은 단순한 시스템에 대해 피드백을 수집하기 위해 ∇LLM을 인스턴스화하는 유연한 방법이다:
그래디언트 연산자에 대한 예시 구현
\[\begin{array}{r l} & {\frac{\partial\mathcal{L}}{\partial x} = \nabla_{\mathrm{LLM}}(x,y,\frac{\partial\mathcal{L}}{\partial y})\triangleq \mathrm{"H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad +\qquad}\\ & {\qquad \mathrm{LLM}(\mathrm{H e r e~i s~a~c o n v e r s a t i o n~w i t h~a n~L L M:~}\{x|y\} .}\\ & {\qquad \mathrm{Below~a r e~t h e~c r i t i c i s m s~o n~\{y\} :}}\\ & {\qquad \left\{\frac{\partial\mathcal{L}}{\partial y}\right\}}\\ & {\qquad \mathrm{Explain~h o w~t o~i m p r o v e~\{x\} .),} \end{array} \quad (6)
여기서 그래디언트 객체는 변수가 등장하는 맥락과 LLMa으로부터 얻은 피드백의 조합이며, Pryzant 등 [25]과 유사하게 정의된다. 이 연산자는 예를 들어 응용 도메인에 의존하지 않는다는 점에 유의하라. 일단 구현되면, LLM 호출에 대한 그래디언트 연산자는 모든 응용에서 프레임워크 전반에 걸쳐 고정된다.
a우리가 사용하는 정확한 프롬프트는 일반성과 유연성을 보장하기 위해 다르다; 우리는 이 예시들을 설명 목적으로만 사용한다.
예시 옵티마이저. 표준 그래디언트 하강법에서는 변수의 현재 값이 그래디언트와 뺄셈을 통해 결합된다. 예를 들어:
θnew=GradientDescent.step(θ,∂θ∂L)=θ−∂θ∂L.(7)
그래디언트 기반 최적화 유추를 계속하여, 우리는 텍스트 그래디언트 하강법(Textual Gradient Descent, TGD)을 사용한다: