
F.5 화학적 참신성
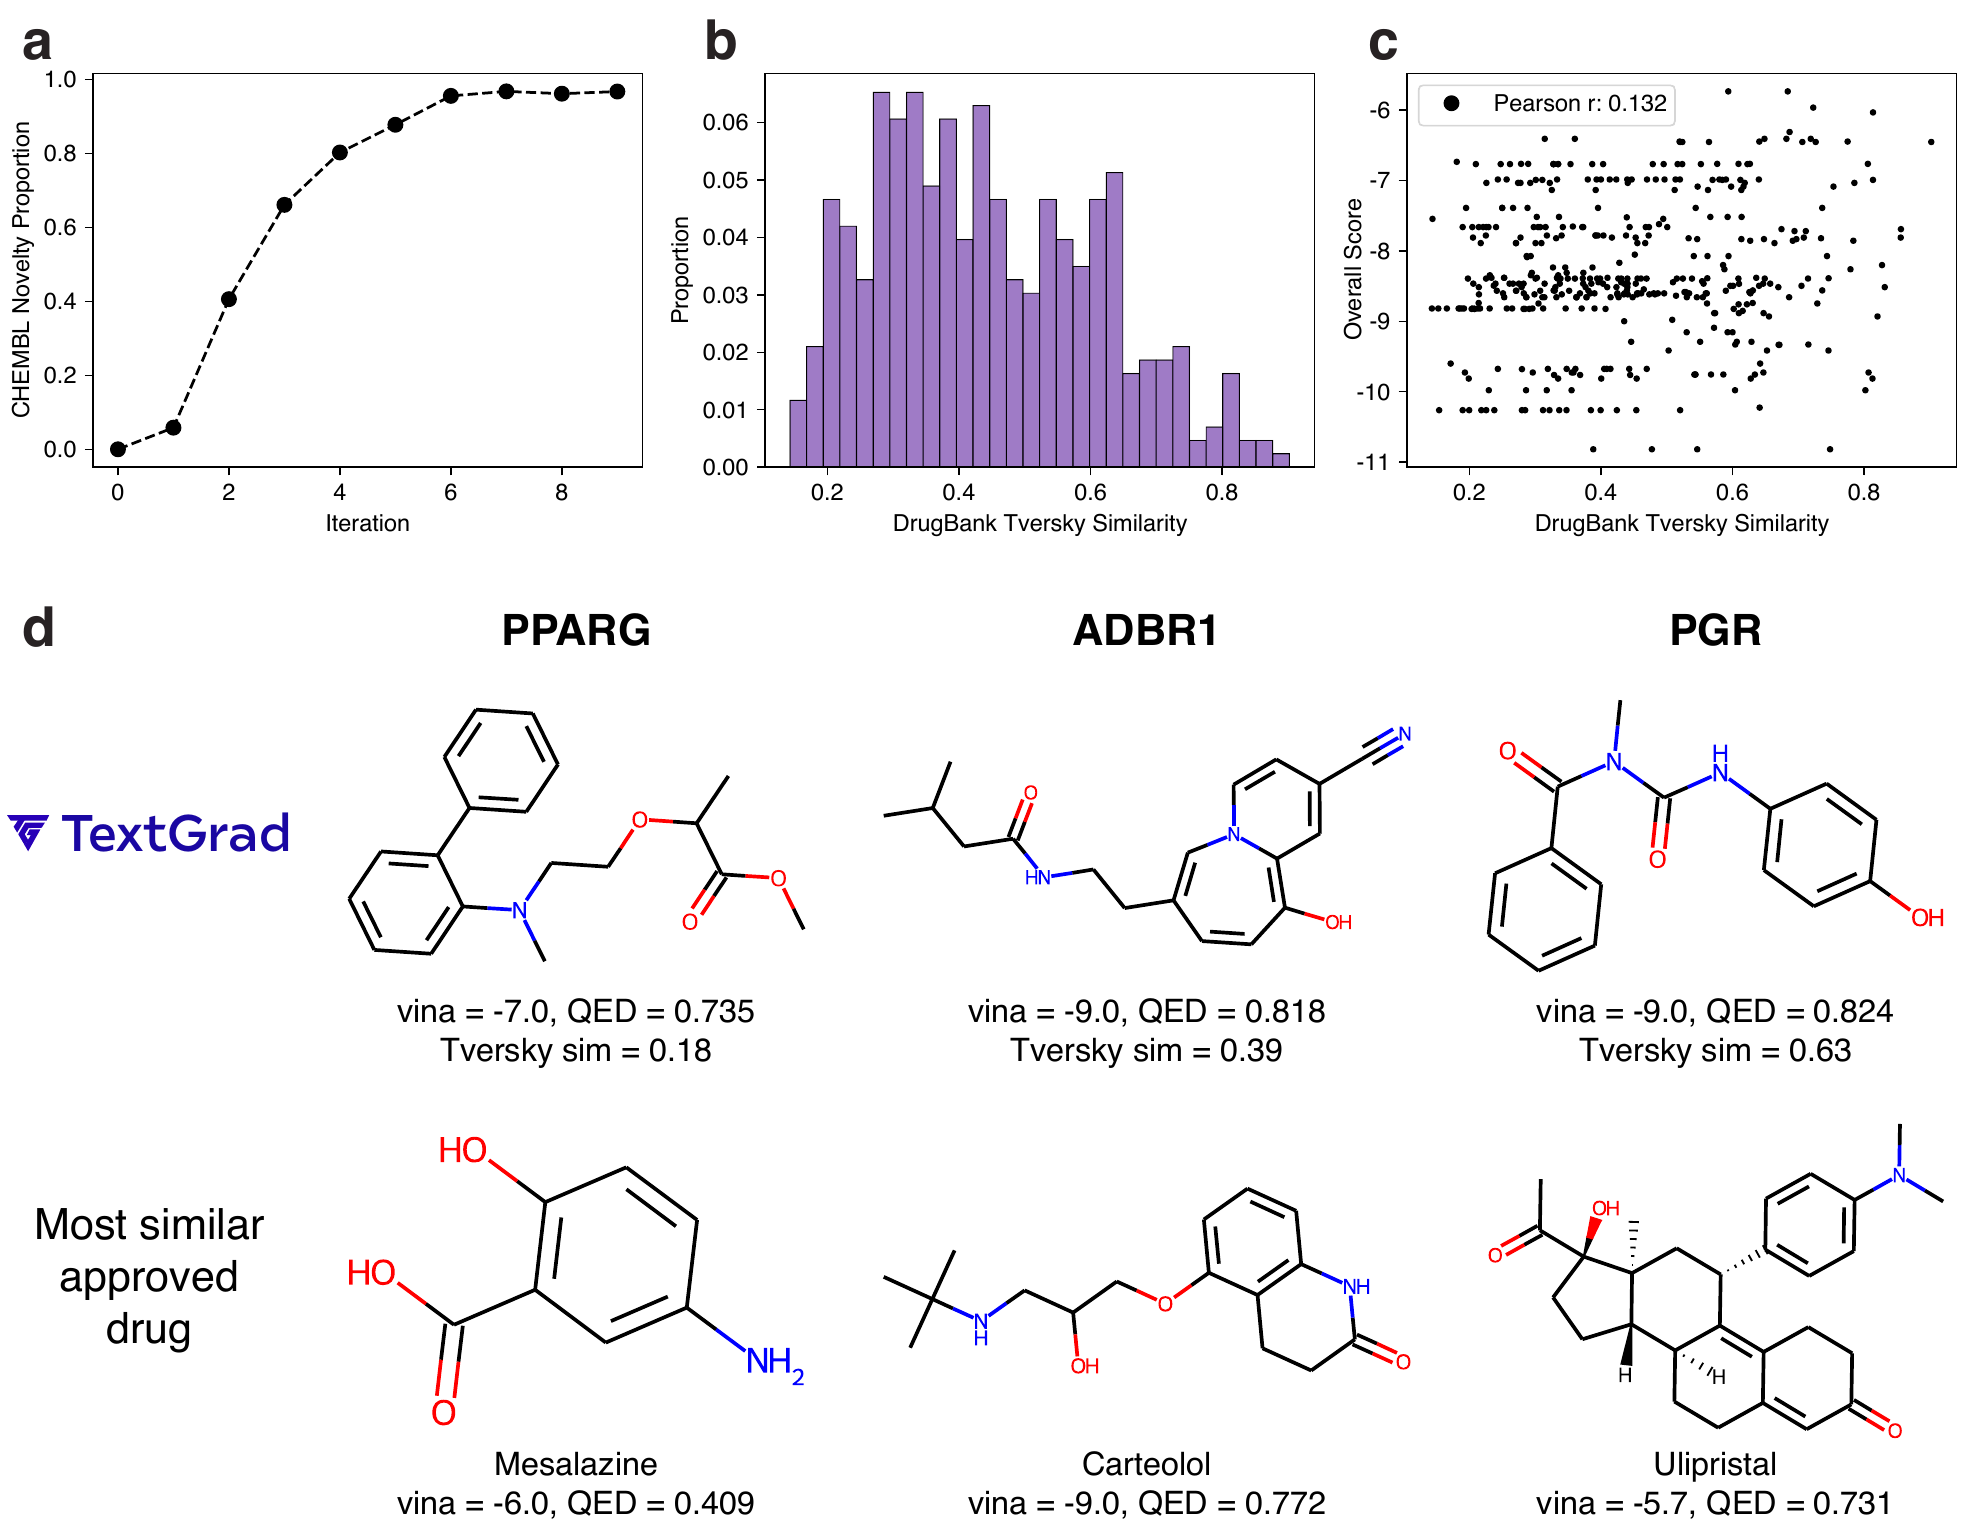
과학적 발견에 LLM 모델을 사용할 때의 주요 우려 중 하나는 논리적 추론을 수행하는 대신 단순히 훈련 세트를 암기하고 되풀이하는 능력이다 [105]. gpt-4o와 같은 최근 모델들은 방대하고 불투명한 데이터셋으로 훈련되기 때문에, 핵심적인 우려는 TEXTGRAD가 생성하는 분자가 해당 표적에 대해 임상 승인된 분자의 단순 중복일 수 있다는 것이다. 이 "암기" 효과의 정도나 존재 여부를 정량화하고 테스트하기 위해, 우리는 TEXTGRAD가 생성한 분자를 해당 단백질 표적에 대해 승인된 약물뿐만 아니라 관련 없지만 기존의 약물유사 화학 화합물과 비교한다.
우리는 먼저 특정 단백질 표적에 대해 TEXTGRAD가 생성한 분자를, 동일한 표적에 대해 Drugbank에서 발견된 모든 임상 승인 소분자와(필터링 기준은 F.3 참조) RDKit daylight 화학 지문에 대한 Tversky 유사도 점수를 사용하여 비교한다. Tversky 유사도 점수는 대칭적이지 않으며, 변이체와 참조 분자 사이의 부분 구조를 비교한다 [106]. 우리의 응용에서는, 생성된(변이체) 분자가 Drugbank(참조) 분자의 부분 구조 대부분 또는 전부를 포함하는 경우 높은 점수를 부여하는 것이 선호되는데, 이는 생성된 분자에 두 분자 사이의 대칭적 중첩을 감소시키는 다른 여분의 부분 구조가 존재하더라도 그러하다. Tversky 점수 1.0은 TEXTGRAD 분자가 Drugbank 분자의 완전한 부분집합임을 나타내고, 0.0은 중첩이 없음을 나타낸다.
가장 관련성 높은 화학 구조를 분석하기 위해, 우리는 모든 반복의 모든 분자가 아닌, 성능이 높은 TEXTGRAD 분자 집합으로 분석을 제한했다. 특히, 방정식 25에 설명된 종합 점수를 사용하여, 우리는 각 단백질 표적과 각 초기 단편에 대해 최고의 분자를 선택하여, 총 87개의 생성된 분자(29개의 약물화 가능 표적 개의 초기 단편)와 29개 표적에 걸친 118개의 임상 승인 약물을 얻었다. 각 표적에 대해, 우리는 3개의 TEXTGRAD 분자와 해당 표적에 대해 승인된 Drugbank 분자 사이의 모든 쌍별 Tversky 점수를 계산하며, Drugbank 분자를 참조로, TEXTGRAD 분자를 변이체로 설정한다.
우리는 Tversky 유사도 점수의 분포가 상당히 넓으며, 중앙값이 0.42이지만 0.14에서 0.90까지 분포한다는 것을 관찰했다(그림 2 (b)). 그러나 TEXTGRAD와 DrugBank 분자 간의 Tversky 유사도는 전체 점수로 측정한 분자 성능과 실제로 약한 음의 상관관계를 보이며, 이는 TEXTGRAD의 최적화 절차가 승인된 약물에 대한 사전 지식의 영향을 기껏해야 약하게 받는다는 것을 시사한다. 실제로 유사도 점수의 변화 구배를 따라 생성된 다양한 분자들에 대해, 생성된 분자들은 DrugBank의 대응물과 일치하거나 심지어 능가하는 QED 및 Vina 점수를 보인다(그림 2 (d)).
알려진 약물과의 유사성 외에도, 우리는 TEXTGRAD가 새로운 분자를 생성하는지, 또는 기존 화합물에서 이전에 알려지지 않은 특성, 예를 들어 해당 단백질과 연관되지 않았던 화합물에서 단백질 표적에 대한 강한 결합 친화력을 발견하는지 관찰하는 데에도 관심이 있다. 이 질문에 답하기 위해, 우리는 약물 유사 특성을 가진 240만 개의 생물활성 분자로 수동 큐레이션된 데이터베이스인 ChEMBL 전체에 걸쳐 Tanimoto 유사도 검색을 수행한다[107]. Tversky 점수와 달리, Tanimoto 척도는 두 화학 구조 간의 대칭적 중첩을 측정하며, 1.0은 정확한 일치를, 0.0은 중첩 없음을 나타낸다. 우리는 ChEMBL에 Tanimoto 유사도 점수가 0.80을 초과하는 분자가 존재하지 않는 경우에만 TEXTGRAD 화합물을 "새로운(novel)" 것으로 분류한다.
시작 단편들은 알려진 분자이지만, 우리는 반복 횟수가 증가함에 따라 TEXTGRAD가 이전에 알려진 화합물일 가능성이 점진적으로 낮아지는 분자들을 생성한다는 것을 관찰한다. 6번째 반복까지, 58개의 모든 표적과 3개의 시작 단편에 걸쳐 TEXTGRAD에 의해 생성된 모든 분자의 95%가 위의 기준을 사용할 때 새로운 분자이다(그림 2 (a)). 생성된 분자들의 궤적을 관찰하고 텍스트 그래디언트를 분석함으로써, 우리는 Vina 및 QED 점수가 제공하는 피드백이 TEXTGRAD가 기능기 조합을 점진적으로 추가하고 제거함으로써 알려진 분자를 넘어 화학 공간을 탐색하도록 장려한다고 가설을 세운다. 이러한 화학적 업데이트가 조합적으로 수많은 고유 구조를 형성할 수 있으므로, TEXTGRAD가 비교적 적은 반복 횟수 내에 이전에 탐험되지 않은 화학 공간 영역에 도달하는 것은 합리적이다.