
3.4 분자 최적화
TEXTGRAD는 과학 및 공학 응용 분야에서 흔히 발견되는 다목적 최적화 작업을 포함한 다양한 최적화 문제를 지원한다. 예를 들어, 신약 개발에서 연구자들은 합성 가능성, 효능 및 안전성과 관련하여 다양한 목표를 최대화하는 분자를 발견하거나 설계하려고 한다[53, 54]. 다목적 최적화에 대한 TEXTGRAD의 응용을 시연하기 위해, 우리는 TEXTGRAD를 약물 분자 최적화에 적용하고, 우리의 프레임워크가 계산 도구와 인터페이스하고 화학 구조를 최적화하여 결합 친화도와 약물 유사성을 동시에 개선하는 방법을 보여준다.
작업: 잠재적 약물 분자에 대한 중요한 고려 사항은 분자와 단백질 표적 간의 상호 작용 강도를 나타내는 결합 친화도이다. 약물 설계자들은 관련 약물 표적에 대해 높은 결합 친화도를 가진 분자를 추구하는데, 이는 효능을 달성하기 위해 더 낮고 덜 빈번한 용량이 필요하기 때문이다. 이 친화도는 결합 및 비결합 리간드-수용체 쌍 간의 확률 비율을 설명하는 자유 에너지 로 정량화될 수 있다. 는 단백질-리간드 결합의 "도킹" 시뮬레이션을 사용하여 추정될 수 있다[55, 56]. 우리의 실험에서, 우리는 널리 사용되는 물리 기반 도킹 시뮬레이터인 Autodock Vina 도구의 Vina 점수를 사용한다[57]. Vina 점수가 더 음수일수록 약물이 의도된 표적에 결합할 확률이 더 크다.
잠재적 약물 분자는 또한 용해도, 투과성, 대사 안정성 및 수송체 효과와 관련하여 분자가 생체 내에서 어떻게 행동할지를 추정하는 약물 유사성으로 평가된다. 높은 약물 유사성을 가진 분자는 신체에 흡수되어 표적에 도달할 가능성이 더 높다[58]. "약물 유사성"에 대한 인기 있는 메트릭 중 하나는 분자량, 친유성, 극성 표면적 등과 같은 중요한 화학적 특성의 가중 복합 메트릭인 약물 유사성 정량 추정(QED) 점수이다. QED 점수는 0에서 1까지이며, 여기서 1은 높은 약물 유사성을 나타낸다[59].
성공적인 분자에 대한 고려 사항은 더 많지만, 우리의 실험에서는 이 두 메트릭의 상대적 성숙도 때문에 목표를 Vina 점수 최소화와 QED 최대화로 제한한다. 이 두 메트릭 간의 경쟁적인 트레이드오프는 최적화 작업을 현실적이고 도전적으로 만든다. 특히, 도킹 점수는 결합 부위와의 상호 작용을 최대화하는 많은 작용기를 가진 더 큰 분자를 선호하는 경향이 있다[55, 56, 60]. 대조적으로, 약물 유사성은 더 나은 흡수 특성을 가진 더 가볍고 단순한 분자를 장려한다[58, 59]. 따라서 두 목표를 동시에 최적화하는 것은 쉽지 않다.
방법: 우리는 분자를 SMILES 문자열로 인코딩하고 Vina 및 QED 점수로부터 다목적 손실을 구성하여 TEXTGRAD를 약물 분자 최적화에 적용한다. 즉, 우리는 SMILES 문자열에 대해 인스턴스 최적화를 수행하며, 여기서 다목적 손실에 대해 TEXTGRAD에 의해 생성된 기울기는 분자를 나타내는 텍스트를 업데이트하는 데 사용된다.
우리는 부록 F.2에서 찾을 수 있는 프롬프트 텍스트와 함께 gpt-4o를 LLM으로 사용한다. 각 반복에서 현재 분자는 Autodock Vina의 Vina 점수를 사용하여 표적 단백질에 대한 결합 친화도를 추정하고 RDKit의 약물 유사성에 대한 QED 점수를 사용하여 평가된다(부록 F.1). 각 분자는 작용기로부터의 작은 화학적 단편으로 초기화된다. 우리는 DOCKSTRING 분자 평가 벤치마크[61]의 모든 58개 표적에 TEXTGRAD를 적용한다. 이 58개 표적은 다양한 구조적 클래스에서 샘플링된 임상적으로 관련된 단백질로 구성되며, 그 중 29개는 임상적으로 승인된 약물을 가지고 있다. 각 표적에 대해, 우리는 3개의 고유한 초기 단편에 대해 10회 반복 동안 TEXTGRAD를 사용하여 시작 단편을 최적화한다. 우리의 성능을 평가하기 위해, 우리는 TEXTGRAD에 의해 생성된 분자의 특성을 해당 단백질에 대해 임상적으로 승인된 약물과 비교한다(부록 F.3).
결과: 58개의 모든 표적에 대해, TEXTGRAD는 초기 시작 단편과 무관하게 개선된 결합 친화도와 약물성을 지닌 분자를 일관되게 생성한다(부록 F.4). 임상적으로 승인된 약물이 있는 29개의 단백질 표적에 대해, 우리는 TEXTGRAD가 동일한 손실 함수를 사용하여 평가된 임상 분자와 비교할 때 매우 경쟁력 있는 친화도와 약물성을 지닌 분자를 생성함을 관찰한다(그림 2 (b)). 생성된 분자는 임상적으로 승인된 대응물 및 기존 화합물과 비교하여 독특한 구조를 나타내면서도(부록 F.5), 유사한 인 실리코 안전성 프로파일을 유지한다(부록 F.6). 새로운 분자 생성을 위한 대안적인 기계 학습 방법들이 존재하지만, TEXTGRAD는 경쟁 방법들에 비해 두 가지 핵심 이점을 제공한다. 첫째, 전통적인 화학정보학 도구를
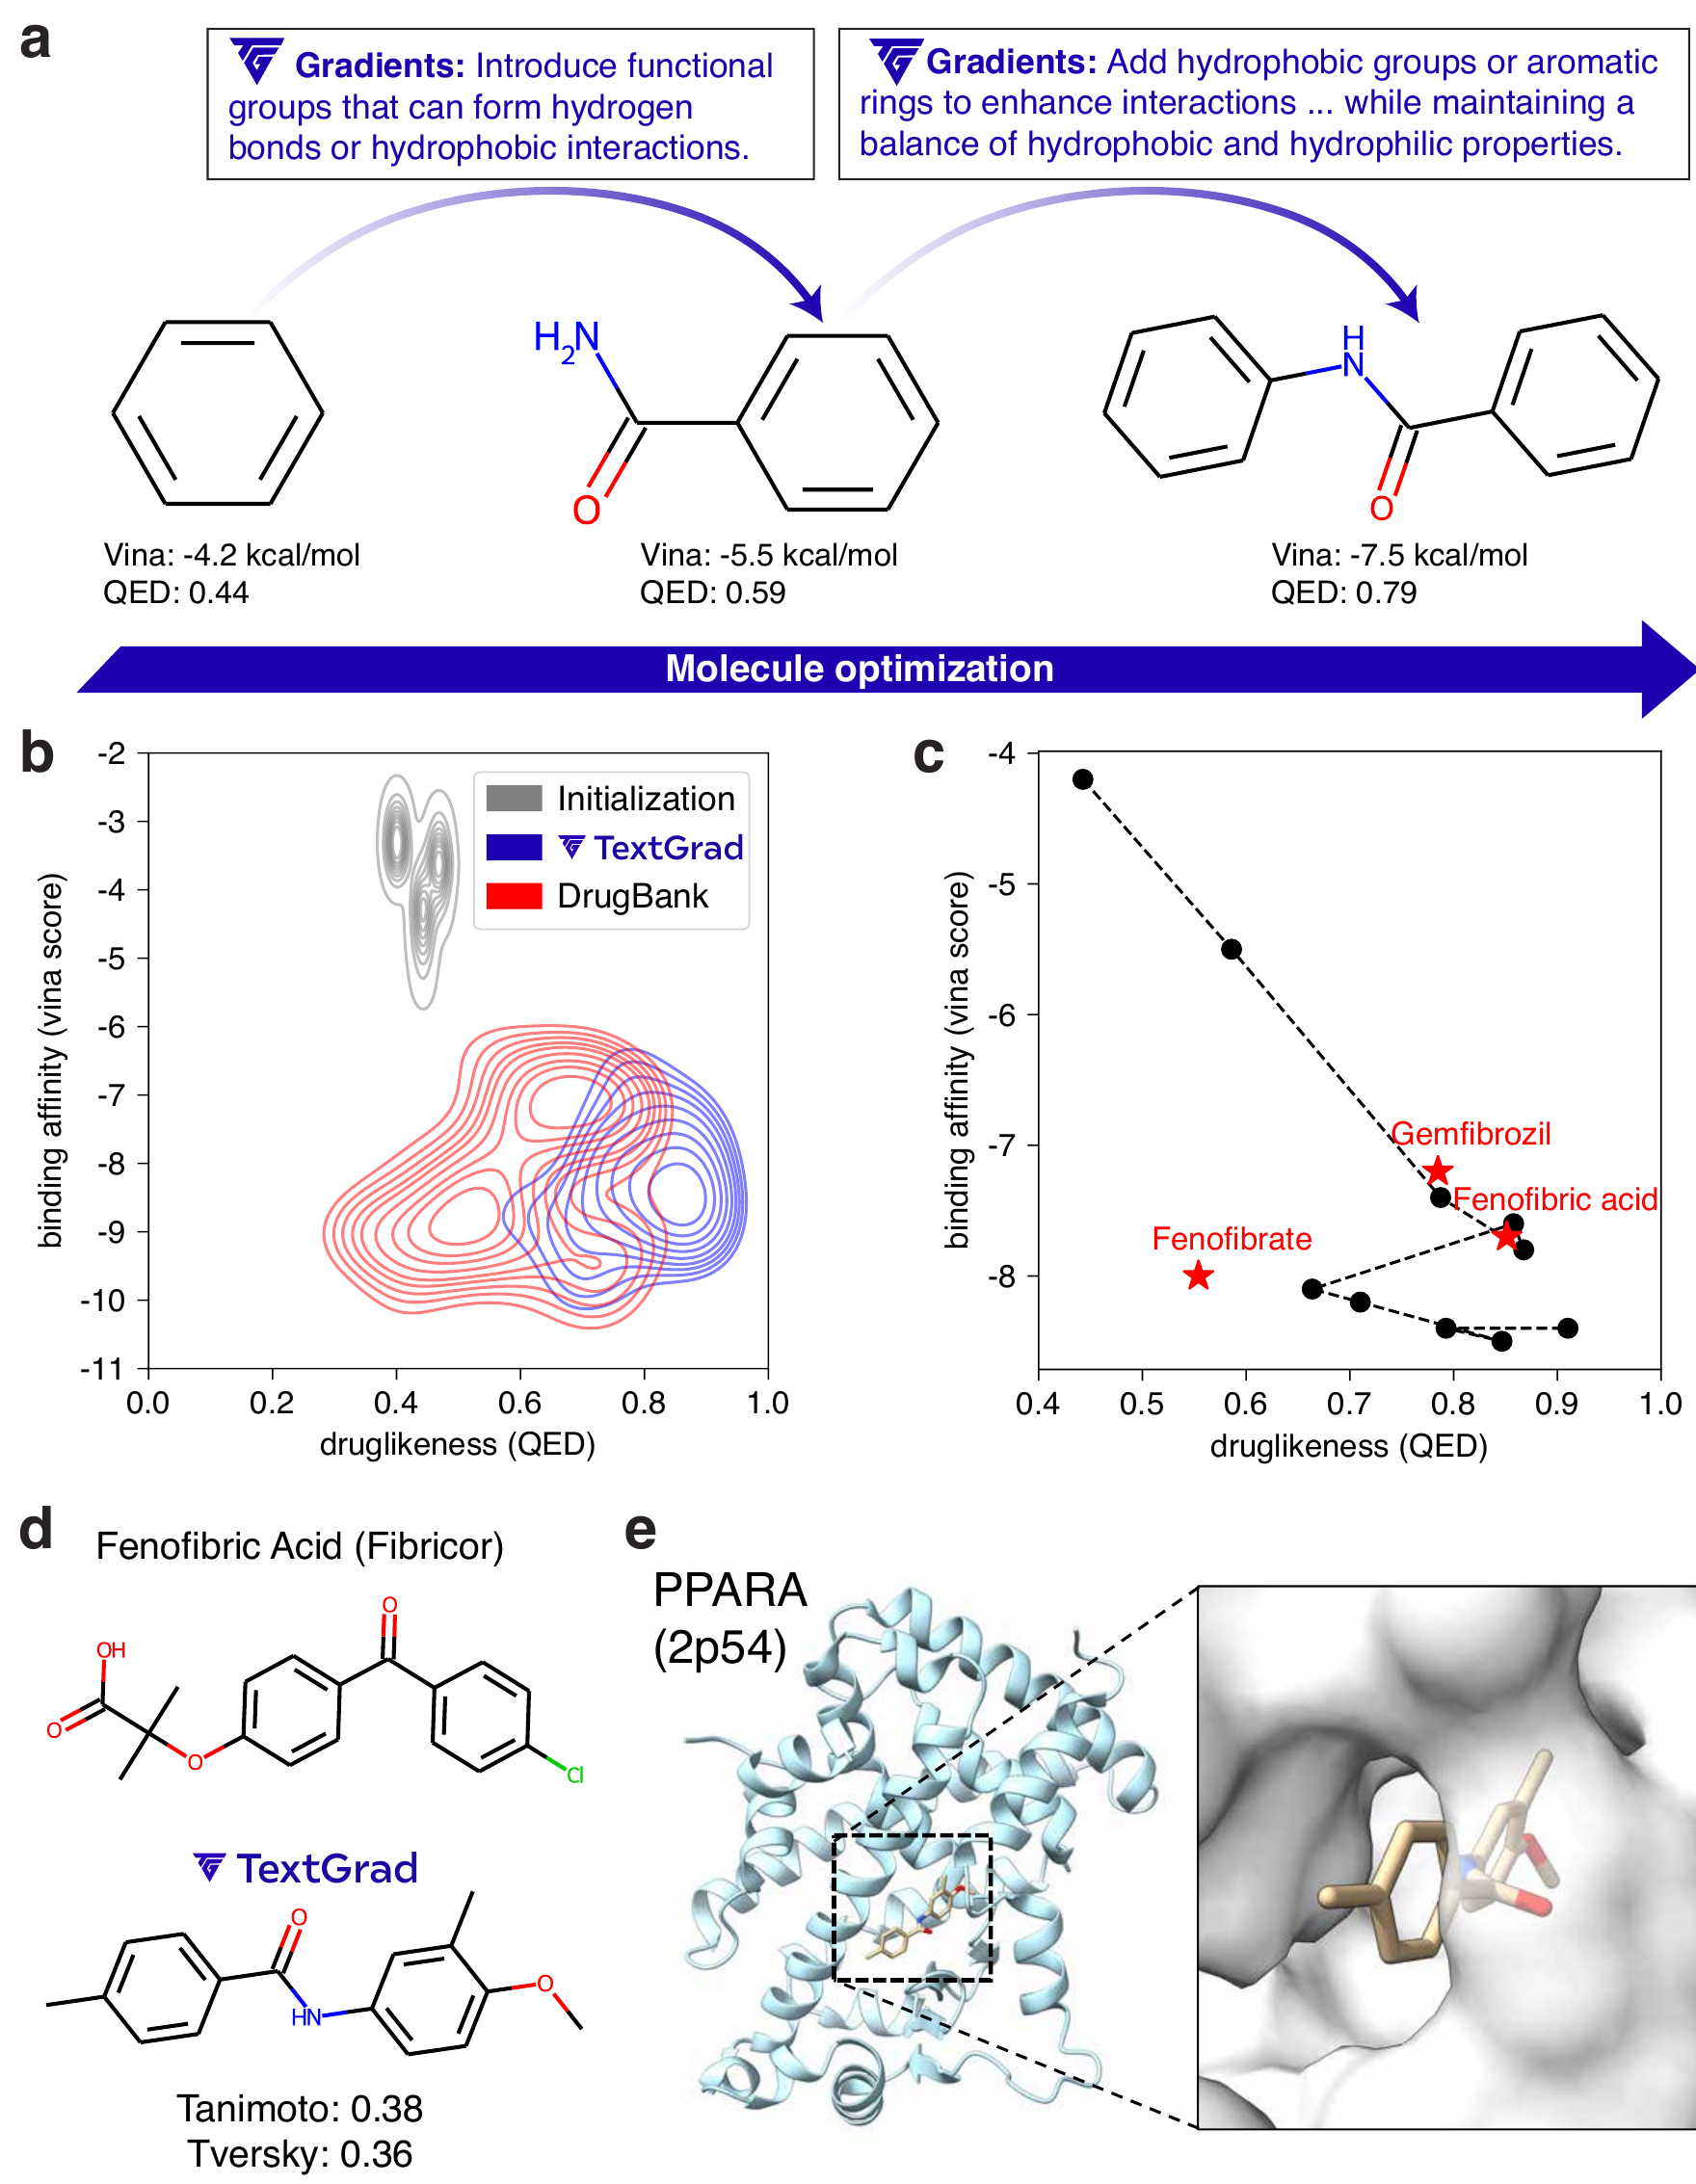
LLM의 일반 지식 및 추론 능력과 결합함으로써, TEXTGRAD는 사전 훈련 세트 없이도 경쟁력 있는 결과를 산출한다. 둘째, TEXTGRAD의 자연어 그래디언트 프레임워크는 설명 가능한 결정을 생성하여, 연구자들이 분자의 구조가 어떻게 그리고 왜 구성되었는지를 정확히 이해할 수 있게 한다. 이 두 가지 특성은 함께 과학적 발견에서 AI 에이전트의 역할에 대한 유망한 미래를 불러일으킨다.