
E.6 암묵적 목표
과학에서 LLM을 적용할 때의 또 다른 핵심 우려는 환각(hallucination) 경향으로, 모델이 사용자 요청을 충족시키려고 시도하면서 사실적으로 부정확하거나 비논리적인 응답을 생성하는 것이다[105]. 우리의 설정에서 이러한 환각은 TEXTGRAD가 목적 함수를 최적화하기 위해 유효하지 않거나, 독성이 있거나, 그 밖에 바람직하지 않은 분자를 제안하는 방식으로 나타날 수 있다. 우리는 RDKit 정제(sanitization)를 사용하여 분자를 전처리함으로써 심각한 환각을 통제하며, 최소한 TEXTGRAD가 화학적으로 유효한 분자를 생성하도록 보장한다. 그러나 이 단순한 전처리 단계는 바람직한 화학적 거동을 완전히 규정하지는 못한다. 직접적인 전략은 약물 유사성과 결합 친화력 외에도 약물 분자의 바람직함에 대한 가능한 모든 지표를 목적 함수에 철저히 인코딩하고, 합성 가능성, 독성 등 다른 기준을 포함하도록 확장하는 것일 것이다. 불행히도, 바람직함에 대한 모든 기준이 성숙한 계산 지표를 갖고 있는 것은 아니기 때문에 이 접근 방식은 현실적으로 실현 가능하지 않다. 따라서 핵심 질문은 TEXTGRAD가 최적화 과정에서 비논리적이거나 바람직하지 않은 행동을 억제하는 소위 암묵적 목표(implicit objectives)를 따르는지 여부이다.
undesirable molecules의 존재 여부나 정도를 평가하기 위해, 우리는 생성된 분자들의 유해성을 특성화할 수 있으며, 여기서 돌연변이원성과 임상적 독성에 초점을 맞춘다. 돌연변이원성은 약물이 유전적 변이를 유도하는 능력을 의미하며, 이는 DNA 손상과 유해한 장기적 영향을 초래할 수 있다. 임상적 독성은 광범위한 단기 또는 장기 부작용을 의미한다. 중요한 점은, 약물다움(druglikeness)도 결합 친화도도
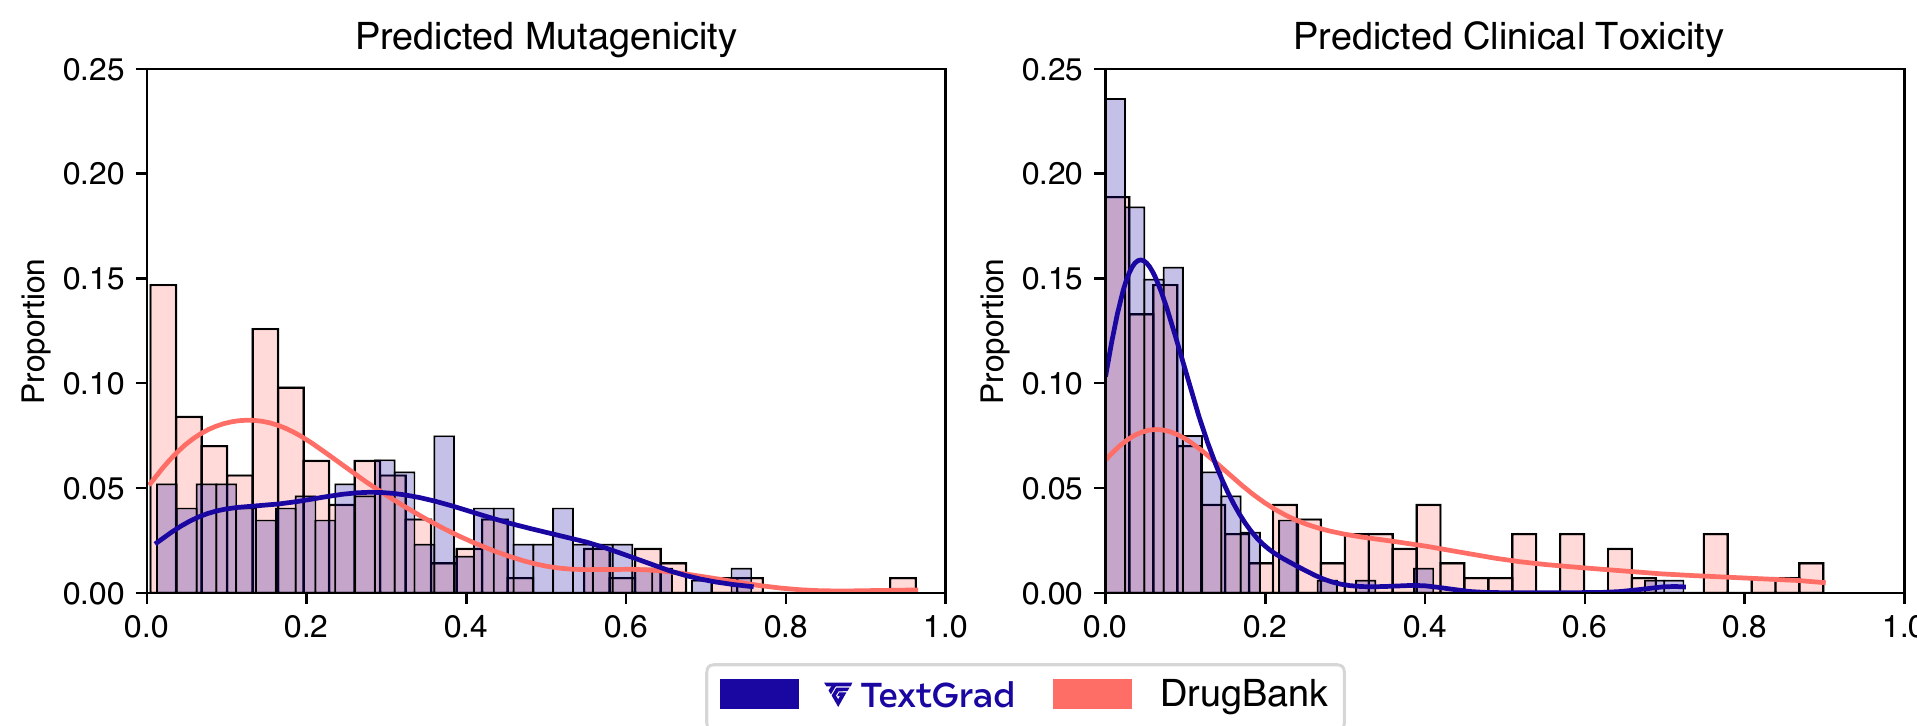
이러한 기준과 강하게 상관되지 않으며, 따라서 이러한 바람직성 지표들은 TEXTGRAD의 목표에 직접적으로 최적화되거나 명시적으로 인코딩되지 않는다.
돌연변이원성과 임상적 독성에 대한 성향을 평가하기 위해, 우리는 분자의 화학 구조로부터 이러한 점수들을 예측하는 ADMET-AI 모델을 사용한다 [108]. ADMET-AI는 여러 관련 데이터셋으로 훈련된 딥러닝 모델을 채택한다. 특히, 돌연변이원성에 대해서 ADMET-AI는 대량의 화합물을 신속하게 스크리닝하여 유전적 손상과 프레임시프트 돌연변이를 유도할 수 있는지 확인하기 위한 세균 역돌연변이 분석법인 Ames 데이터셋의 7,255개 약물로 훈련된다. 예측 레이블 1.0은 약물이 돌연변이원성을 유도할 가능성이 높음을 나타내며, 0.0은 가능성이 낮음을 나타낸다. 임상적 독성에 대해서 ADMET-AI는 ClinTox 데이터셋으로 훈련되는데, 이는 독성 이유로 임상시험에 실패한 분자들과 성공적인 임상시험과 연관된 약물들로 구성된 1,484개 약물의 데이터셋이다. 마찬가지로, 예측 레이블 1.0은 임상적 독성의 가능성이 높음을 나타내며, 0.0은 가능성이 낮음을 나타낸다.
다시 한번, 우리는 분석을 전체 점수로 측정된, 약물화 가능한 표적을 가진 최고 성능의 생성 분자들로 제한하고, 각 단백질 표적과 각 초기 단편에 대해 최고의 분자를 선택하여 총 87개의 생성 분자를 얻는다. 그런 다음 우리는 이들의 예측된 돌연변이원성과 임상적 독성을 DrugBank의 118개 임상 승인 분자들과 비교한다. 우리는 돌연변이원성과 임상적 독성 모두에 대해, TEXTGRAD에 의해 생성된 분자들이 유해한 영향의 가능성이 낮음을 나타내는 예측 분포를 가지며, 임상 승인 분자들의 분포와 밀접하게 일치함을 관찰한다. 종합하면, 이러한 결과들은 이러한 기준들이 손실 함수에 직접적으로 인코딩되지 않았음에도 불구하고 TEXTGRAD가 암묵적으로 유해한 분자들을 제안하는 것을 회피함을 시사한다.