
A.1 변수
변수는 계산 그래프의 노드입니다. 다음은 변수의 가장 중요한 속성입니다:
1. 값(Value)은 변수가 포함하는 비정형 데이터입니다. 본 원고 전체에서 모든 값은 텍스트 데이터입니다.
2. 역할 설명(Role description)은 계산 그래프에서 변수의 역할을 설명하는 유용한 문자열입니다. 우리는 이러한 역할을 사용하여 사용자가 그래프에 지식을 주입하고 최적화 동작을 안내할 수 있도록 합니다. 자세한 내용은 아래에 설명되어 있습니다.
3. 그래디언트(Gradients)는 역방향 패스 동안 LLM이 제공하는 자연어 피드백입니다. 이는 다운스트림 손실을 개선할 수 있도록 변수에 가할 변경 사항을 설명합니다. 그래디언트를 채우는 역방향 연산의 예시는 섹션 A.3을 참조하십시오.
4. 선행자(predecessor)는 주어진 변수를 생성하는 데 사용되는 변수들의 집합이다. 예를 들어, LLM에 지시를 내리고 응답을 받는 경우, 그 지시는 응답의 선행자가 된다. 역방향 패스(backward pass) 동안, 후속자(successor)에 대한 그래디언트가 선행자들에게 전달되어, 하위 목표(downstream objective)를 어떻게 개선할지에 관한 지침을 제공한다.
5. requires_grad는 역방향 패스 동안 그래디언트가 채워질지 여부를 나타내며, PyTorch와 유사하다. 예를 들어, 사용자가 어떤 질문에 대해 그래디언트를 계산하기를 원하지 않는다면, 단순히 Variable(value=question, requires_grad=False, ...)라고 작성하여 이를 나타내면 된다.
역할 설명(Role Description): TEXTGRAD에서 각 변수는 역할 설명을 가진다. 특히 이는 언어 모델에 대한 시스템 프롬프트나 언어 모델에 의한 예측과 같이, 계산 그래프에서 변수의 역할을 기술하는 문자열이다. 때로는 자동으로 채워지기도 하지만, 일반적으로 역할 설명은 사용자의 지식을 최적화 과정에 주입하는 주요 방법 중 하나이다.
경험적으로, 우리는 역할 설명이 최적화 과정을 상당히 조종할 수 있음을 발견한다. 예를 들어, 예측의 역할을 언어 모델에 대한 최종 수치 답변으로 설정하면, 피드백을 사용하여 변수의 값을 업데이트하도록 언어 모델에 프롬프트를 제공하는 Textual Gradient Descent 최적화기가 변수를 오직 수치 값만 되도록 업데이트하게끔 유도한다. 이에 비해, 해답에 대한 추론과 최종 예측이라는 역할 설명은 최적화기가 최종 예측과 함께 추론을 산출하도록 유도한다.
다음은 사용 예시입니다:
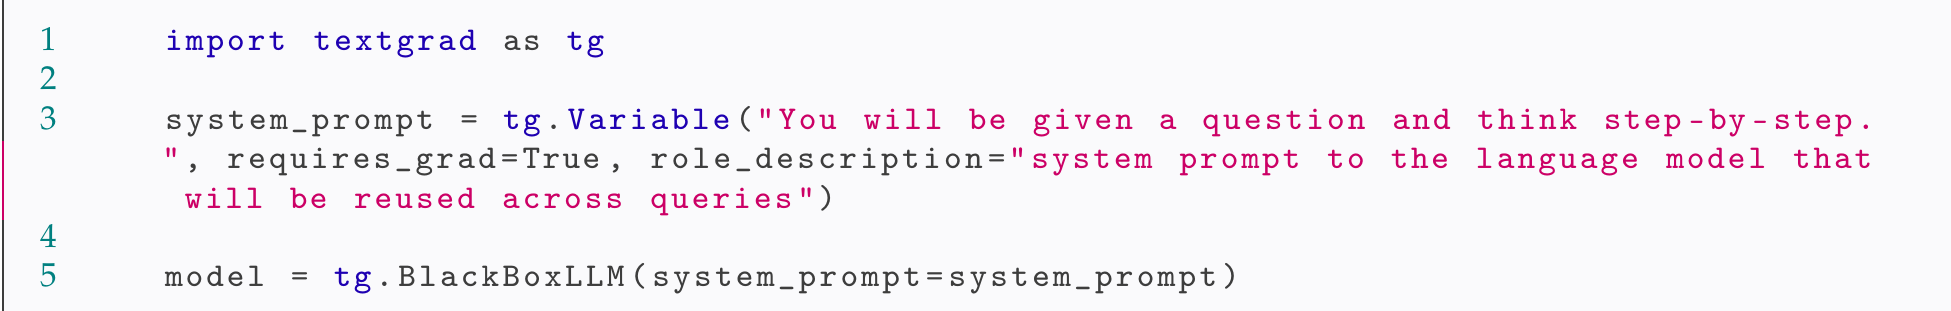
코드 스니펫 3: 역할 설명의 사용 예시.