
TextGrad: Automatic "Differentiation" via TextMert Yuksekgonul et al.
F.4 초기화
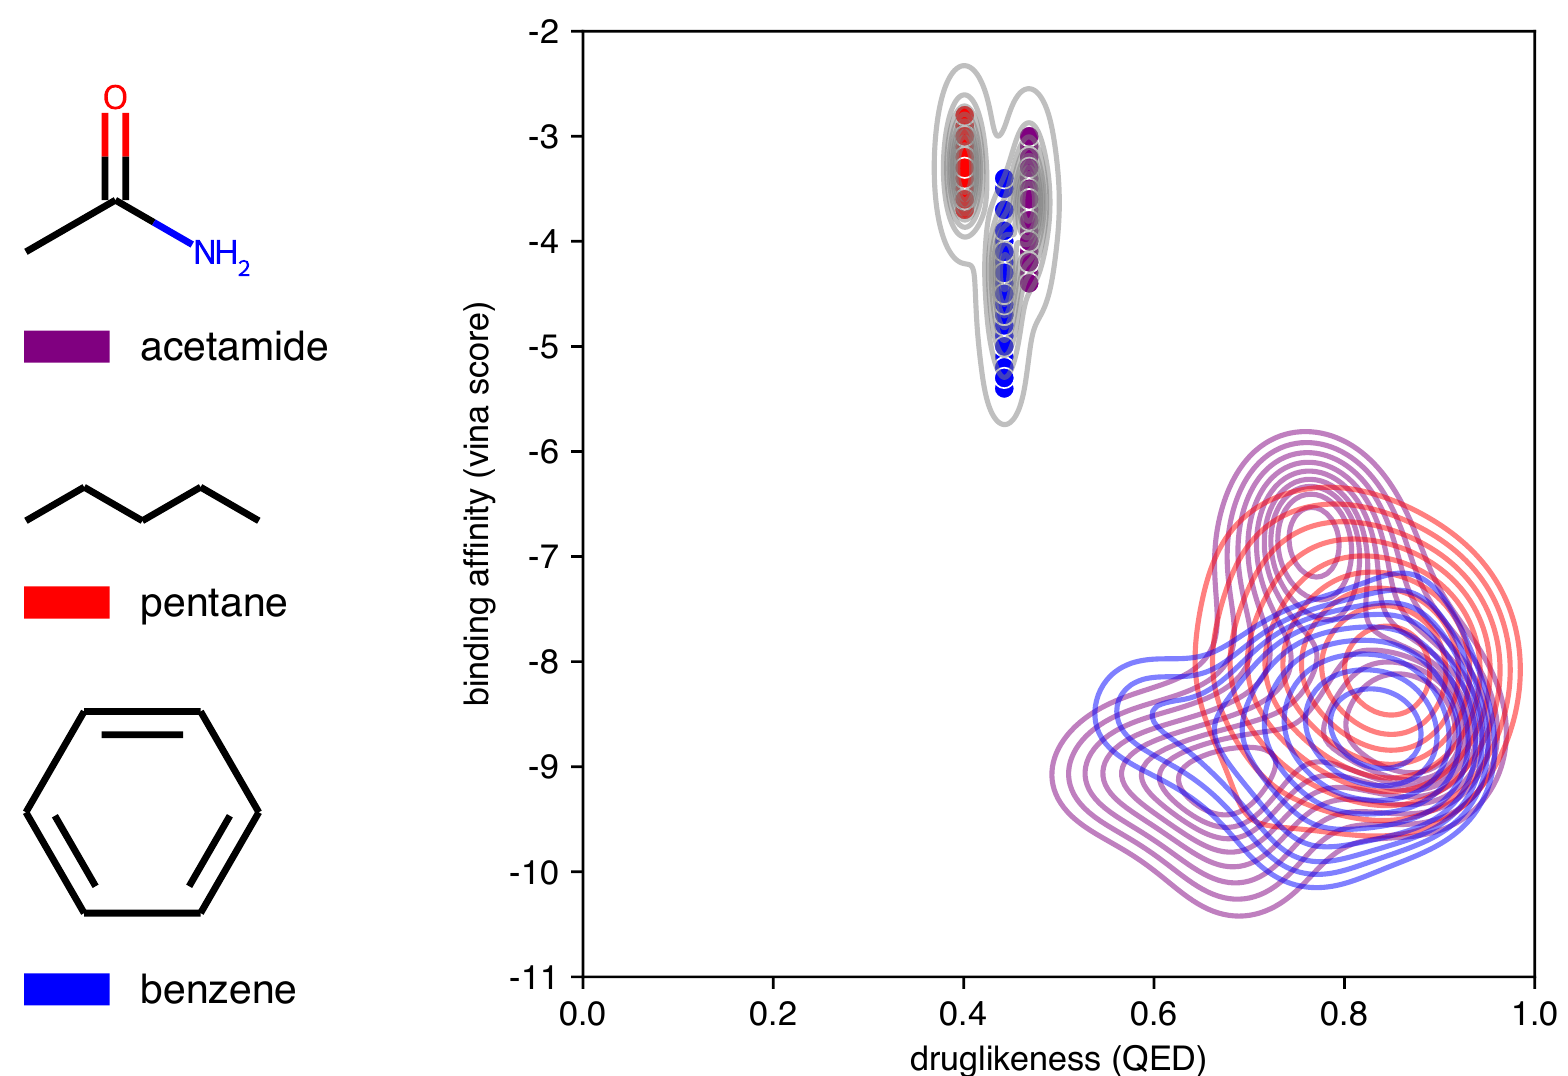
실제로 분자 최적화는 일반적으로 대규모 사전 최적화 스크리닝에 의해 가속화되며, 여기서 수백만 또는 수십억 개의 기존 화학 구조 라이브러리가 도킹, 약물유사성 및 기타 지표에 의해 점수가 매겨지고 순위가 매겨진다. "리드(leads)"라고 불리는 가장 유망한 구조만이 의약 화학자들에 의해 추가로 개선된다 [104]. TEXTGRAD는 어떤 초기 분자든 최적화할 수 있지만, 본 연구에서는 그 성능을 보다 정확하게 특성화하고 설계가 기존 약물 쪽으로 편향되는 것을 피하기 위해, 대신 그림 1에 표시된 일반적인 작용기의 단순한 단편들로부터 세 개의 초기 분자를 선택한다. 이 단편들은 매우 다양하며 서로 다른 작용기에 속한다. 이러한 초기 단편들은 서로 다른 약물유사성 및 결합 친화도 특성을 가지지만, 시작 단편이 TEXTGRAD의 성능에 미치는 영향은 미미하며, TEXTGRAD는 세 단편 모두로부터 높은 약물유사성과 결합 친화도를 가진 분자를 생성할 수 있다.