
Échauffement : système avec deux appels de LLM
Exemple de graphe de calcul. Dans la différentiation automatique traditionnelle, nous calculons des gradients qui fournissent une direction qui améliorerait la variable par rapport à une perte en aval avec la règle de la chaîne. Pour un analogue simple, examinons le système simple :
a Réseau de neurones et rétropropagation utilisant des gradients numériques
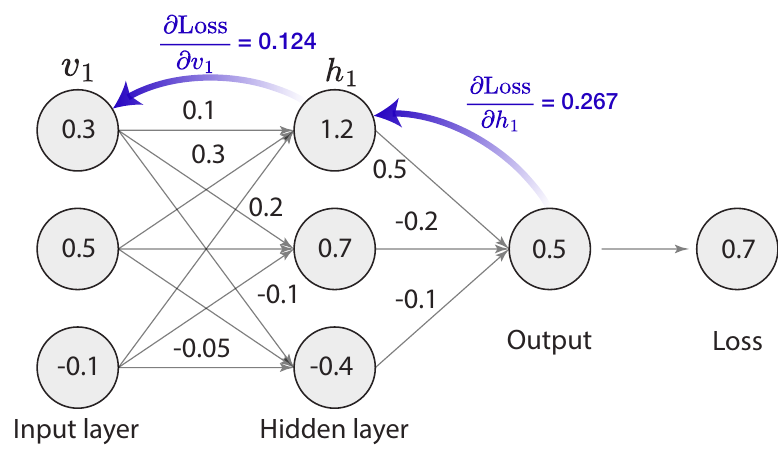
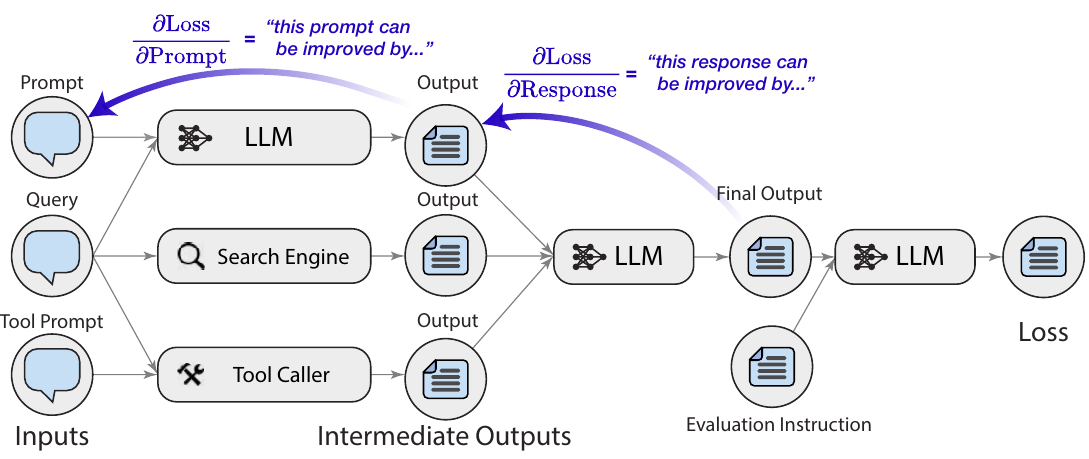
b Systèmes d'IA en boîte noire et rétropropagation utilisant des « gradients » en langage naturel
C 1 Analogie dans les abstractions
| Math | PyTorch | TextGrad | |
| Entrée | x | Tensor(image) | tg.Variable(article) |
| Modèle | y = fθ(x) | ResNet50( ) | tg.BlackboxLLM("You are a summarizer.") |
| Perte | L(y, y) = ∑ y ; log( y ; ) | CrossEntropyLoss( ) | tg.TextLoss("Rate the summary.") |
| Optimiseur | GD(θ ; θ) = θ - θL/θ0 | SGD(List(model.parameters( ))) | tg.TGD(List(model.parameters( ))) |
2 Différenciation automatique
PyTorch et TextGrad partagent la même syntaxe pour la rétropropagation et l'optimisation.
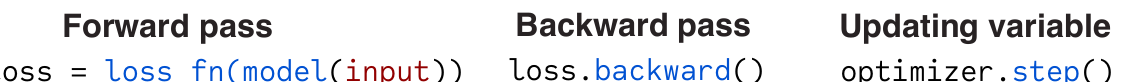
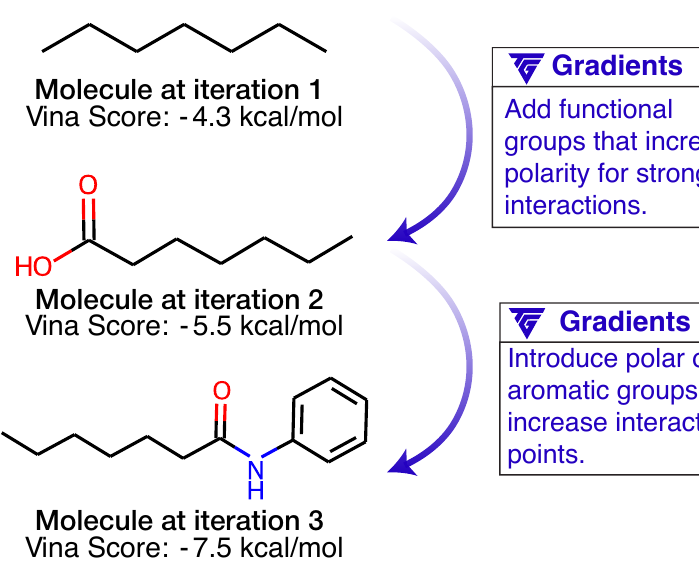
d TextGrad pour l'optimisation de molécules
e TextGrad pour l'optimisation du code
Texte à traduire : TextGrad pour l'optimisation des plans de traitement
g TextGrad pour l'optimisation des invites
Vous allez répondre à une question de raisonnement. Réfléchissez étape par étape. La dernière ligne de votre réponse doit être au format suivant : 'Answer: 'SVAULE' où VALUEl est une valeur numérique.
Invite à l'initialisation (Précision = 77,8 %)
Vous allez répondre à une question de raisonnement. Énumérez chaque élément et sa quantité dans un format clair et cohérent, tel que - Élément : Quantité'. Additionnez les valeurs directement à partir de la liste et fournissez une sommation concise. Assurez-vous que la réponse finale est clairement indiquée au format : 'Answer: 'SVAULE' où VALUEl est une valeur numérique. Vérifiez la pertinence de chaque élément par rapport au contexte de la requête et gérez les erreurs ou ambiguïtés potentielles dans l'entrée. Vérifiez à nouveau le décompte final pour garantir l'exactitude."
Invite après optimisation (Précision = 91,9 %)
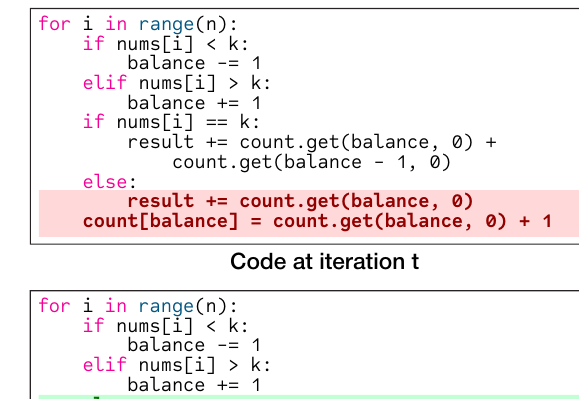
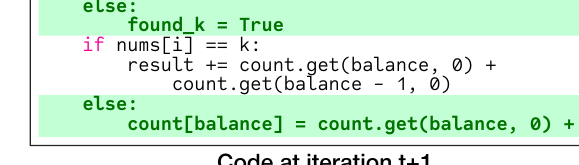
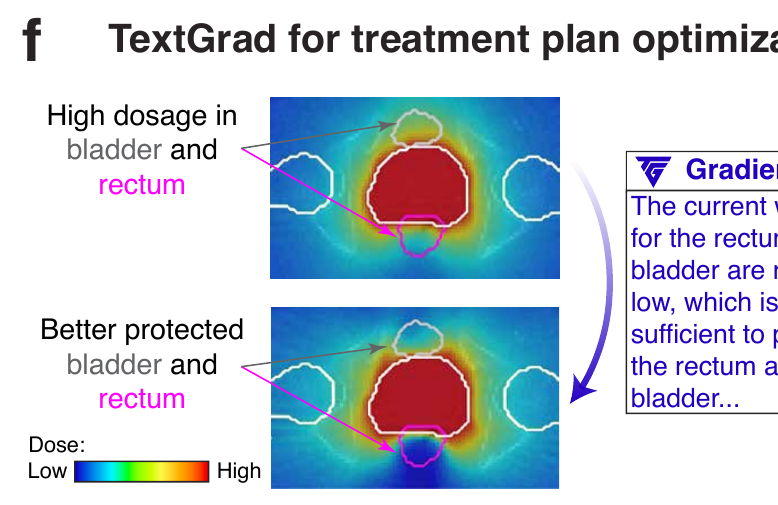
Figure 1 : « Différenciation » automatique via le texte (a, b). La rétropropagation des gradients est la force motrice de l'apprentissage profond. Nous n'avons pas de gradients pour des systèmes composés de systèmes d'IA boîte noire, mais nous pouvons construire une rétropropagation analogue pour le retour d'information textuel, formant la base de TEXTGRAD. Abstractions dans TEXTGRAD (c). Nous partageons les mêmes abstractions et la même syntaxe que PyTorch afin que notre cadre soit généralisable et facile à apprendre. Applications de TEXTGRAD (d,e,f,g). Dans la section 3.4, nous optimisons des structures moléculaires pour des propriétés telles que la ressemblance aux médicaments et l'affinité de liaison aux protéines (d). Dans la section 3.1, nous optimisons des solutions à des problèmes de programmation (e). Dans la section 3.5, nous optimisons des plans de traitement de radiothérapie afin d'améliorer les résultats pour les patients (f). Dans la section 3.3, nous optimisons des invites pour améliorer le raisonnement des modèles de langage (g). où nous désignons le paramètre libre à optimiser, l'invite, en vert, et nous utilisons pour désigner la concaténation de deux chaînes, et utilisons pour donner comme invite à un modèle de langage afin de recueillir la réponse. Nous utiliserons la notation en chaîne :
comme une autre façon de désigner ce système, où nous effectuons un appel au LLM pour générer une Prediction pour une Question à l'aide d'un Prompt, et un autre appel au LLM pour évaluer cette Prediction.
Exemple de calcul de gradient. Dans ce système exemple, pour améliorer le Prompt par rapport à l'évaluation, nous instancions un analogue de l'algorithme de rétropropagation [19] au moyen de ce qui suit :
Calcul du gradient pour le graphe simple : Prompt Prediction Evaluation
où nous utilisons pour l'opérateur de gradient lorsque la fonction directe est un appel au LLM. En particulier, cette fonction renvoie un retour d'information en langage naturel tel que « Cette prédiction peut être améliorée en... », où le retour d'information décrit comment modifier la variable afin d'améliorer l'objectif en aval, de manière analogue aux gradients en optimisation. Nous recueillons d'abord le retour d'information pour la variable Prediction à l'aide de l'évaluation. Ensuite, à partir de ce retour d'information et de l'appel (Prompt Prediction), nous recueillons le retour d'information sur le Prompt.
« Notez que nous surchargeons la notation pour désigner à la fois les cas où la variable de sortie n'a pas de successeurs (par exemple, ) et ceux où elle a des successeurs, et donc des gradients (par exemple, ).
Voici une manière flexible d'instancier pour recueillir le retour d'information pour un système simple comme :
Exemple d'implémentation pour l'opérateur de gradient
où l'objet gradient est une combinaison du contexte dans lequel la variable apparaît et du retour d'information obtenu auprès d'un , défini de manière analogue à Pryzant et al. [25]. Notez que cet opérateur ne dépend pas, par exemple, du domaine d'application. Une fois implémenté, l'opérateur de gradient pour les appels au LLM est fixe dans tout le cadre pour toutes les applications.
aLes invites exactes que nous utilisons sont différentes afin de garantir la généralité et la flexibilité ; nous n'utilisons ces exemples qu'à des fins d'exposition.
Exemple d'optimiseur. Dans la descente de gradient standard, la valeur actuelle de la variable est combinée aux gradients par soustraction, par exemple :
Poursuivant l'analogie de l'optimisation fondée sur les gradients, nous utilisons la Descente de Gradient Textuelle (TGD) :
Mise à jour de la variable Prompt dans le graphe simple via TGD.
pour mettre à jour les paramètres, dans ce cas, le Prompt. En particulier, étant donné la variable actuelle et les gradients (retour d'information) que nous avons recueillis pour cette variable, l'optimiseur cherche à mettre à jour cette variable.
Une manière concrète d'instancier TGD est la suivante :
Exemple d'implémentation d'une itération TGD
où est la variable que nous souhaitons améliorer, et est le retour d'information que nous avons obtenu pour la variable durant la passe arrièrea. Semblable à l'opérateur de gradient, cette fonction ne dépend pas non plus du domaine d'application, et l'implémentation de TGD est la même dans toutes les utilisations du cadre.
aLes invites exactes que nous utilisons sont différentes afin de garantir la généralité et la flexibilité ; nous n'utilisons ces exemples qu'à des fins d'exposition.