
F.5 Nouveauté chimique
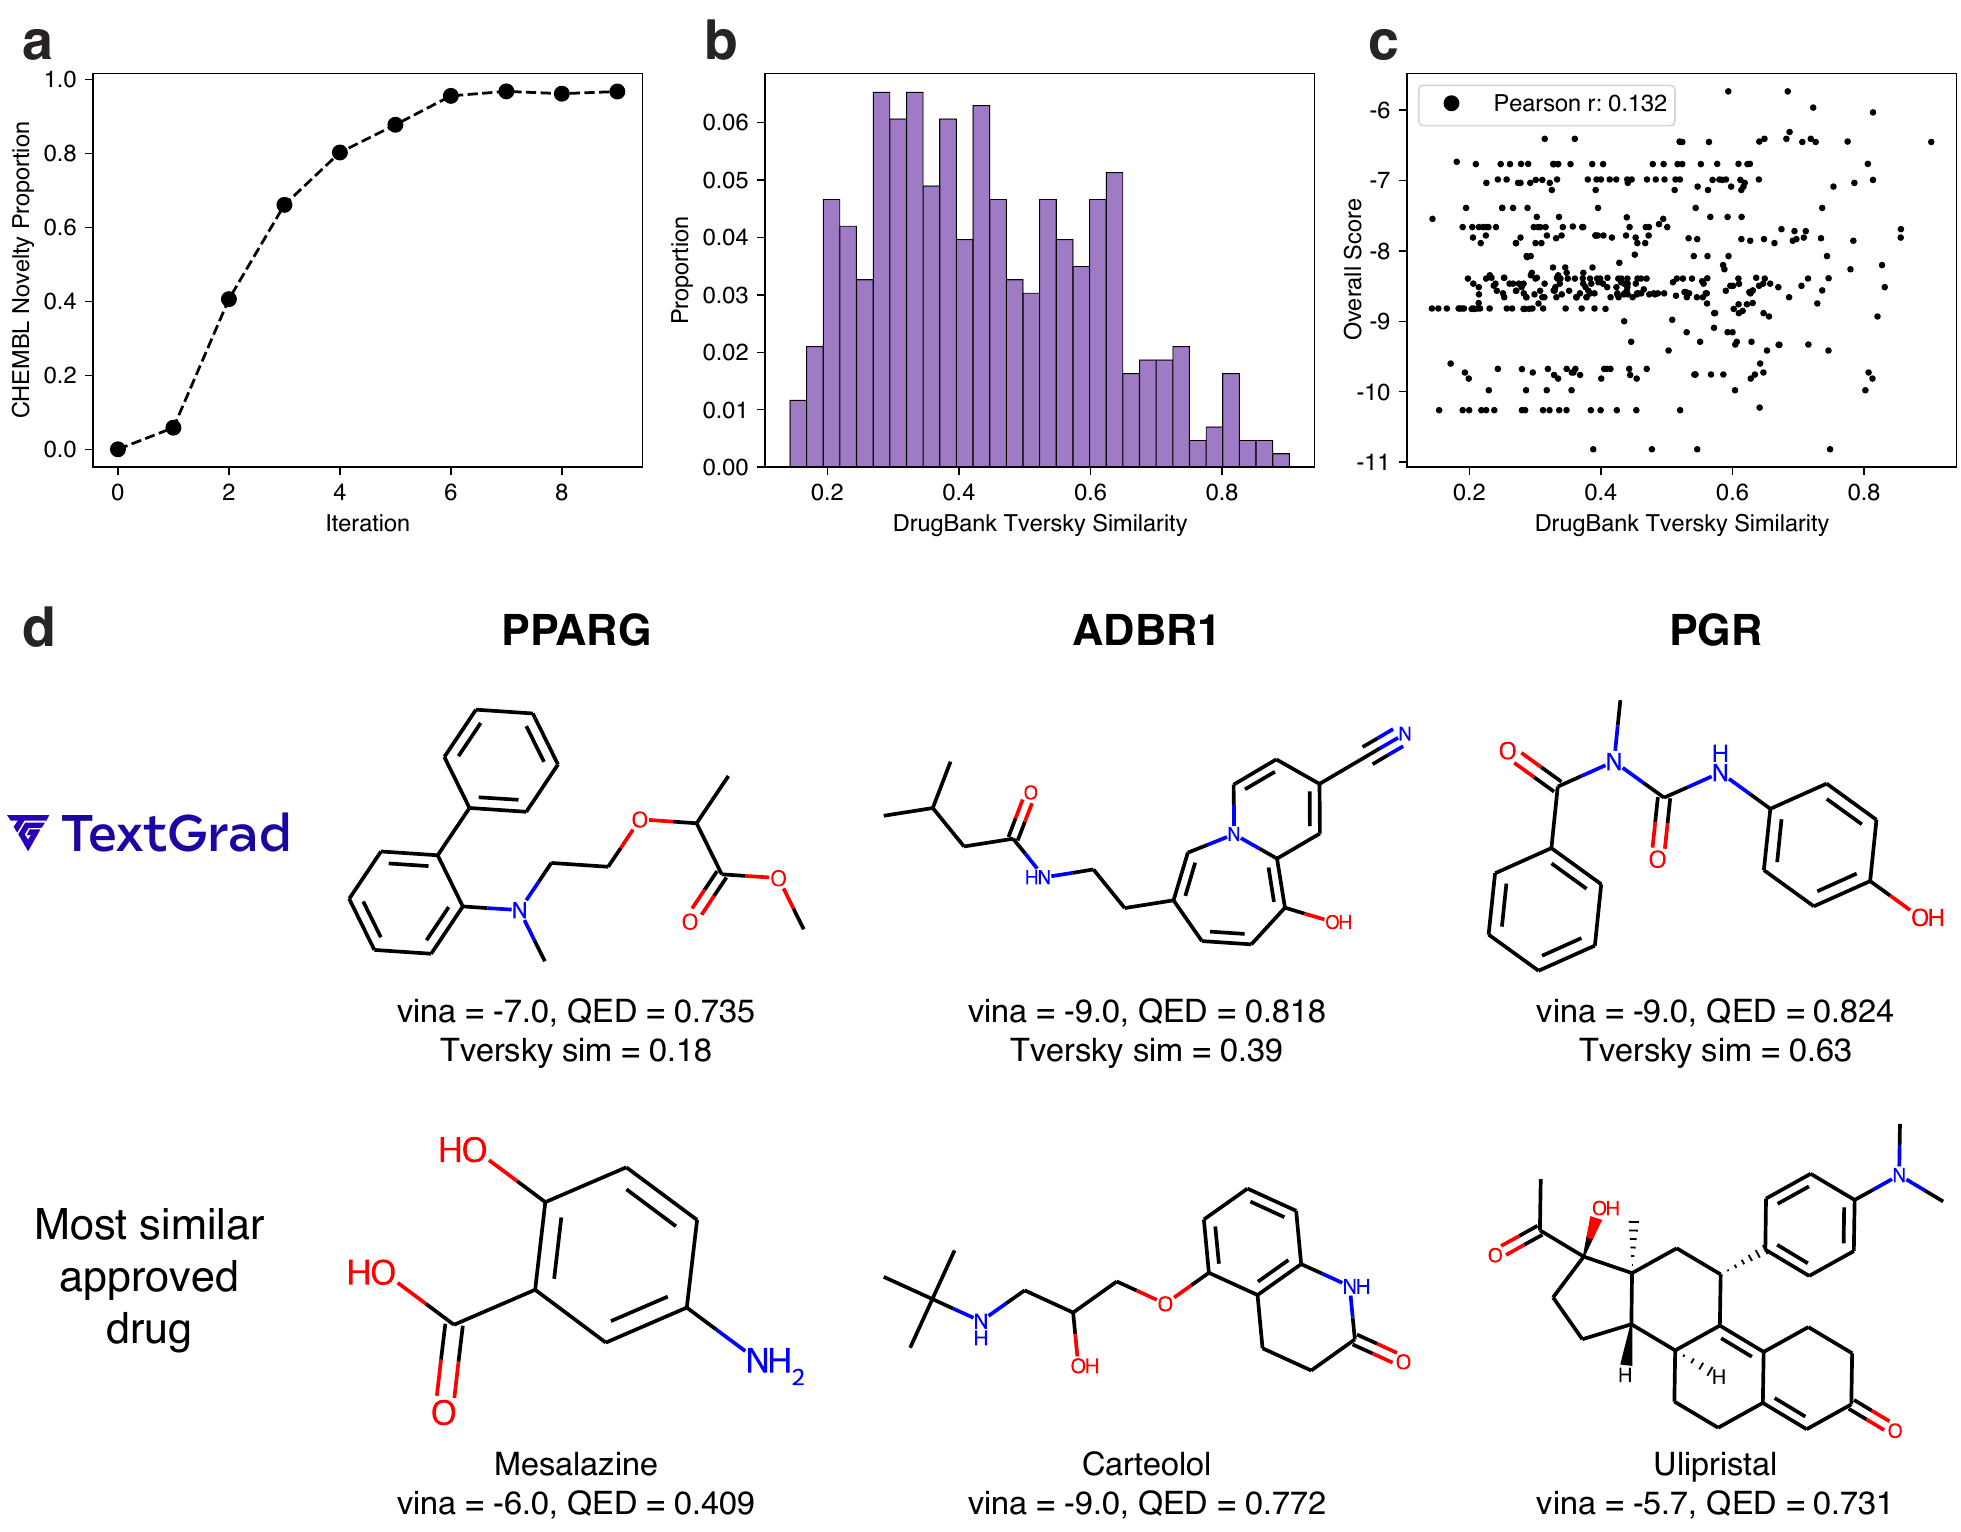
L'une des principales préoccupations liées à l'utilisation des modèles LLM dans la découverte scientifique est leur capacité à simplement mémoriser et régurgiter leurs ensembles d'entraînement au lieu d'effectuer un raisonnement logique [105]. Étant donné que les modèles récents comme gpt- 4o sont entraînés sur des ensembles de données massifs et opaques, une préoccupation majeure est que les molécules générées par TEXTGRAD puissent simplement être des doublons de molécules approuvées cliniquement pour leurs cibles respectives. Pour quantifier et tester l'ampleur ou l'existence de cet effet de « mémorisation », nous comparons les molécules que TEXTGRAD génère avec les médicaments approuvés pour leurs cibles protéiques respectives, ainsi qu'avec des composés chimiques existants sans rapport mais ressemblant à des médicaments.
Nous comparons d'abord les molécules générées par TEXTGRAD pour une cible protéique particulière avec toutes les petites molécules approuvées cliniquement trouvées dans Drugbank pour la même cible (voir F.3 pour les critères de filtrage) en utilisant le score de similarité de Tversky sur les empreintes chimiques daylight de RDKit. Le score de similarité de Tversky n'est pas symétrique et compare les sous-structures entre une molécule variante et une molécule de référence [106]. Dans notre application, cela est préférable car il attribue un score élevé aux molécules générées (variantes) qui contiennent la plupart ou la totalité des sous-structures de la molécule Drugbank (référence), même s'il existe d'autres sous-structures superflues dans la molécule générée qui réduisent le chevauchement symétrique entre les deux molécules. Un score de Tversky de 1,0 indique que la molécule TEXTGRAD est un sous-ensemble complet de la molécule Drugbank, tandis que 0,0 indique aucun chevauchement.
Afin d'analyser les structures chimiques les plus pertinentes, nous avons restreint notre analyse à un ensemble de molécules TEXTGRAD les plus performantes, plutôt qu'à l'ensemble des molécules de toutes les itérations. En particulier, en utilisant le score global décrit dans l'équation 25, nous avons sélectionné la meilleure molécule pour chaque cible protéique et pour chaque fragment initial, soit un total de 87 molécules générées (29 cibles druggables fragments initiaux) et 118 médicaments approuvés cliniquement sur 29 cibles. Pour chaque cible, nous calculons tous les scores de Tversky par paires entre les 3 molécules TEXTGRAD et les molécules Drugbank approuvées pour cette cible, en fixant la molécule Drugbank comme référence et la molécule TEXTGRAD comme variante.
Nous avons observé que la distribution des scores de similarité de Tversky était assez étendue, avec une médiane de 0,42 mais allant de 0,14 à 0,90 (Figure 2 (b)). Cependant, nous observons que la similarité de Tversky entre les molécules TEXTGRAD et DrugBank est en réalité légèrement anticorrélée avec la performance des molécules telle que mesurée par le score global, ce qui suggère que la procédure d'optimisation de TEXTGRAD est au mieux faiblement influencée par la connaissance préalable des médicaments approuvés. En fait, pour une variété de molécules générées le long d'un gradient de scores de similarité, les molécules générées présentent des scores QED et Vina qui égalent ou même dépassent leurs homologues DrugBank (Figure 2 (d)).
Au-delà de la similarité avec des médicaments connus, nous cherchons également à observer si TEXTGRAD génère des molécules nouvelles, ou découvre des propriétés auparavant inconnues dans des composés existants, par exemple une forte affinité de liaison à une cible protéique dans un composé qui n'a pas été associé à la protéine. Pour répondre à cette question, nous effectuons une recherche de similarité de Tanimoto sur l'ensemble de ChEMBL, une base de données curée manuellement de 2,4 millions de molécules bioactives dotées de propriétés médicamenteuses [107]. Contrairement au score de Tversky, la métrique de Tanimoto mesure le chevauchement symétrique entre deux structures chimiques, où 1,0 indique une correspondance exacte et 0,0 aucune superposition. Nous classons un composé TEXTGRAD comme « nouveau » si et seulement s'il n'existe aucune molécule dans ChEMBL avec un score de similarité de Tanimoto supérieur à 0,80.
Bien que les fragments de départ soient des molécules connues, nous observons qu'à mesure que le nombre d'itérations augmente, TEXTGRAD génère des molécules qui sont progressivement moins susceptibles d'être des composés connus auparavant. Dès la 6e itération, 95 % de toutes les molécules générées par TEXTGRAD sur l'ensemble des 58 cibles et 3 fragments de départ sont nouvelles selon les critères ci-dessus (Figure 2 (a)). En observant les trajectoires des molécules générées et en analysant les gradients textuels, nous émettons l'hypothèse que le retour d'information fourni par les scores Vina et QED encourage TEXTGRAD à explorer l'espace chimique au-delà des molécules connues en ajoutant et en retirant progressivement des combinaisons de groupes fonctionnels. Étant donné que ces mises à jour chimiques peuvent former un nombre combinatoire de structures uniques, il est raisonnable que TEXTGRAD atteigne des régions auparavant inexplorées de l'espace chimique en un nombre relativement faible d'itérations.