
3.4 Optimisation de molécules
TEXTGRAD prend en charge une variété de problèmes d'optimisation, y compris les tâches d'optimisation multi-objectifs couramment rencontrées dans les applications scientifiques et d'ingénierie. Par exemple, dans la découverte de médicaments, les chercheurs cherchent à découvrir ou concevoir des molécules qui maximisent une variété d'objectifs en ce qui concerne la synthétisabilité, l'efficacité et la sécurité [53, 54]. Pour démontrer les applications de TEXTGRAD à l'optimisation multi-objectifs, nous appliquons TEXTGRAD à l'optimisation de molécules médicamenteuses, et montrons comment notre framework peut s'interfacer avec des outils computationnels et optimiser les structures chimiques vers l'amélioration simultanée de leur affinité de liaison et de leur druglikeness.
Tâche : Une considération critique pour les molécules médicamenteuses potentielles est leur affinité de liaison, qui représente la force des interactions entre la molécule et sa cible protéique. Les concepteurs de médicaments recherchent des molécules ayant une forte affinité de liaison aux cibles médicamenteuses pertinentes, car elles nécessitent des doses plus faibles et moins fréquentes pour atteindre l'efficacité. Cette affinité peut être quantifiée par l'énergie libre , qui décrit le rapport de probabilités entre les paires ligand- récepteur liées et non liées. peut être estimé à l'aide de simulations d'« amarrage » (docking) de la liaison protéine- ligand [55, 56]. Dans nos expériences, nous employons le score Vina de l'outil Autodock Vina, un simulateur d'amarrage basé sur la physique largement utilisé [57]. Plus le score Vina est négatif, plus la probabilité que le médicament se lie à sa cible visée est grande.
Les molécules médicamenteuses potentielles sont également évaluées par leur druglikeness, qui estime comment la molécule se comportera in vivo, en ce qui concerne la solubilité, la perméabilité, la stabilité métabolique et les effets de transporteur. Les molécules ayant une druglikeness élevée sont plus susceptibles d'être absorbées par le corps et d'atteindre leurs cibles [58]. Une métrique populaire pour la « druglikeness » est le score Quantitative Estimate of Druglikeness (QED), une métrique composite pondérée de caractéristiques chimiques importantes telles que le poids moléculaire, la lipophilie, la surface polaire, entre autres. Le score QED varie de 0 à 1, où 1 indique une druglikeness élevée [59].
Bien qu'il existe de nombreuses autres considérations pour des molécules réussies, dans nos expériences, nous limitons nos objectifs à minimiser le score Vina et à maximiser le QED, en raison de la relative maturité de ces deux métriques. Les compromis concurrents entre ces deux métriques rendent la tâche d'optimisation réaliste et difficile. En particulier, les scores d'amarrage ont tendance à préférer les molécules plus grandes avec de nombreux groupes fonctionnels qui maximisent les interactions avec un site de liaison [55, 56, 60]. En revanche, la druglikeness favorise des molécules plus légères et plus simples qui ont de meilleures propriétés d'absorption [58, 59]. Ainsi, optimiser simultanément les deux objectifs n'est pas trivial.
Méthodes : Nous appliquons TEXTGRAD à l'optimisation de molécules médicamenteuses en encodant les molécules sous forme de chaînes SMILES et en construisant une perte multi-objectifs à partir des scores Vina et QED. À savoir, nous effectuons une optimisation d'instance sur les chaînes SMILES, où les gradients générés par TEXTGRAD par rapport à la perte multi-objectifs sont utilisés pour mettre à jour le texte représentant la molécule.
Nous utilisons gpt-4o comme LLM avec le texte d'invite figurant à l'annexe F.2. À chaque itération, la molécule courante est évaluée en estimant son affinité de liaison à la protéine cible à l'aide du score Vina d'Autodock Vina et en utilisant le score QED de ressemblance médicamenteuse de RDKit (annexe F.1). Chaque molécule est initialisée sous la forme d'un petit fragment chimique issu d'un groupe fonctionnel. Nous appliquons TEXTGRAD aux 58 cibles du benchmark d'évaluation de molécules DOCKSTRING [61]. Ces 58 cibles consistent en des protéines pertinentes sur le plan clinique, échantillonnées dans diverses classes structurelles, dont 29 disposent de médicaments approuvés sur le plan clinique. Pour chaque cible, nous optimisons un fragment de départ à l'aide de TEXTGRAD pendant 10 itérations, pour 3 fragments initiaux uniques. Pour évaluer nos performances, nous comparons les caractéristiques des molécules générées par TEXTGRAD à celles des médicaments approuvés sur le plan clinique pour la protéine respective (annexe F.3).
Résultats : Pour les 58 cibles, TEXTGRAD génère systématiquement des molécules avec une meilleure affinité de liaison et une meilleure ressemblance médicamenteuse, quel que soit le fragment de départ initial (annexe F.4). Pour les 29 cibles protéiques disposant de
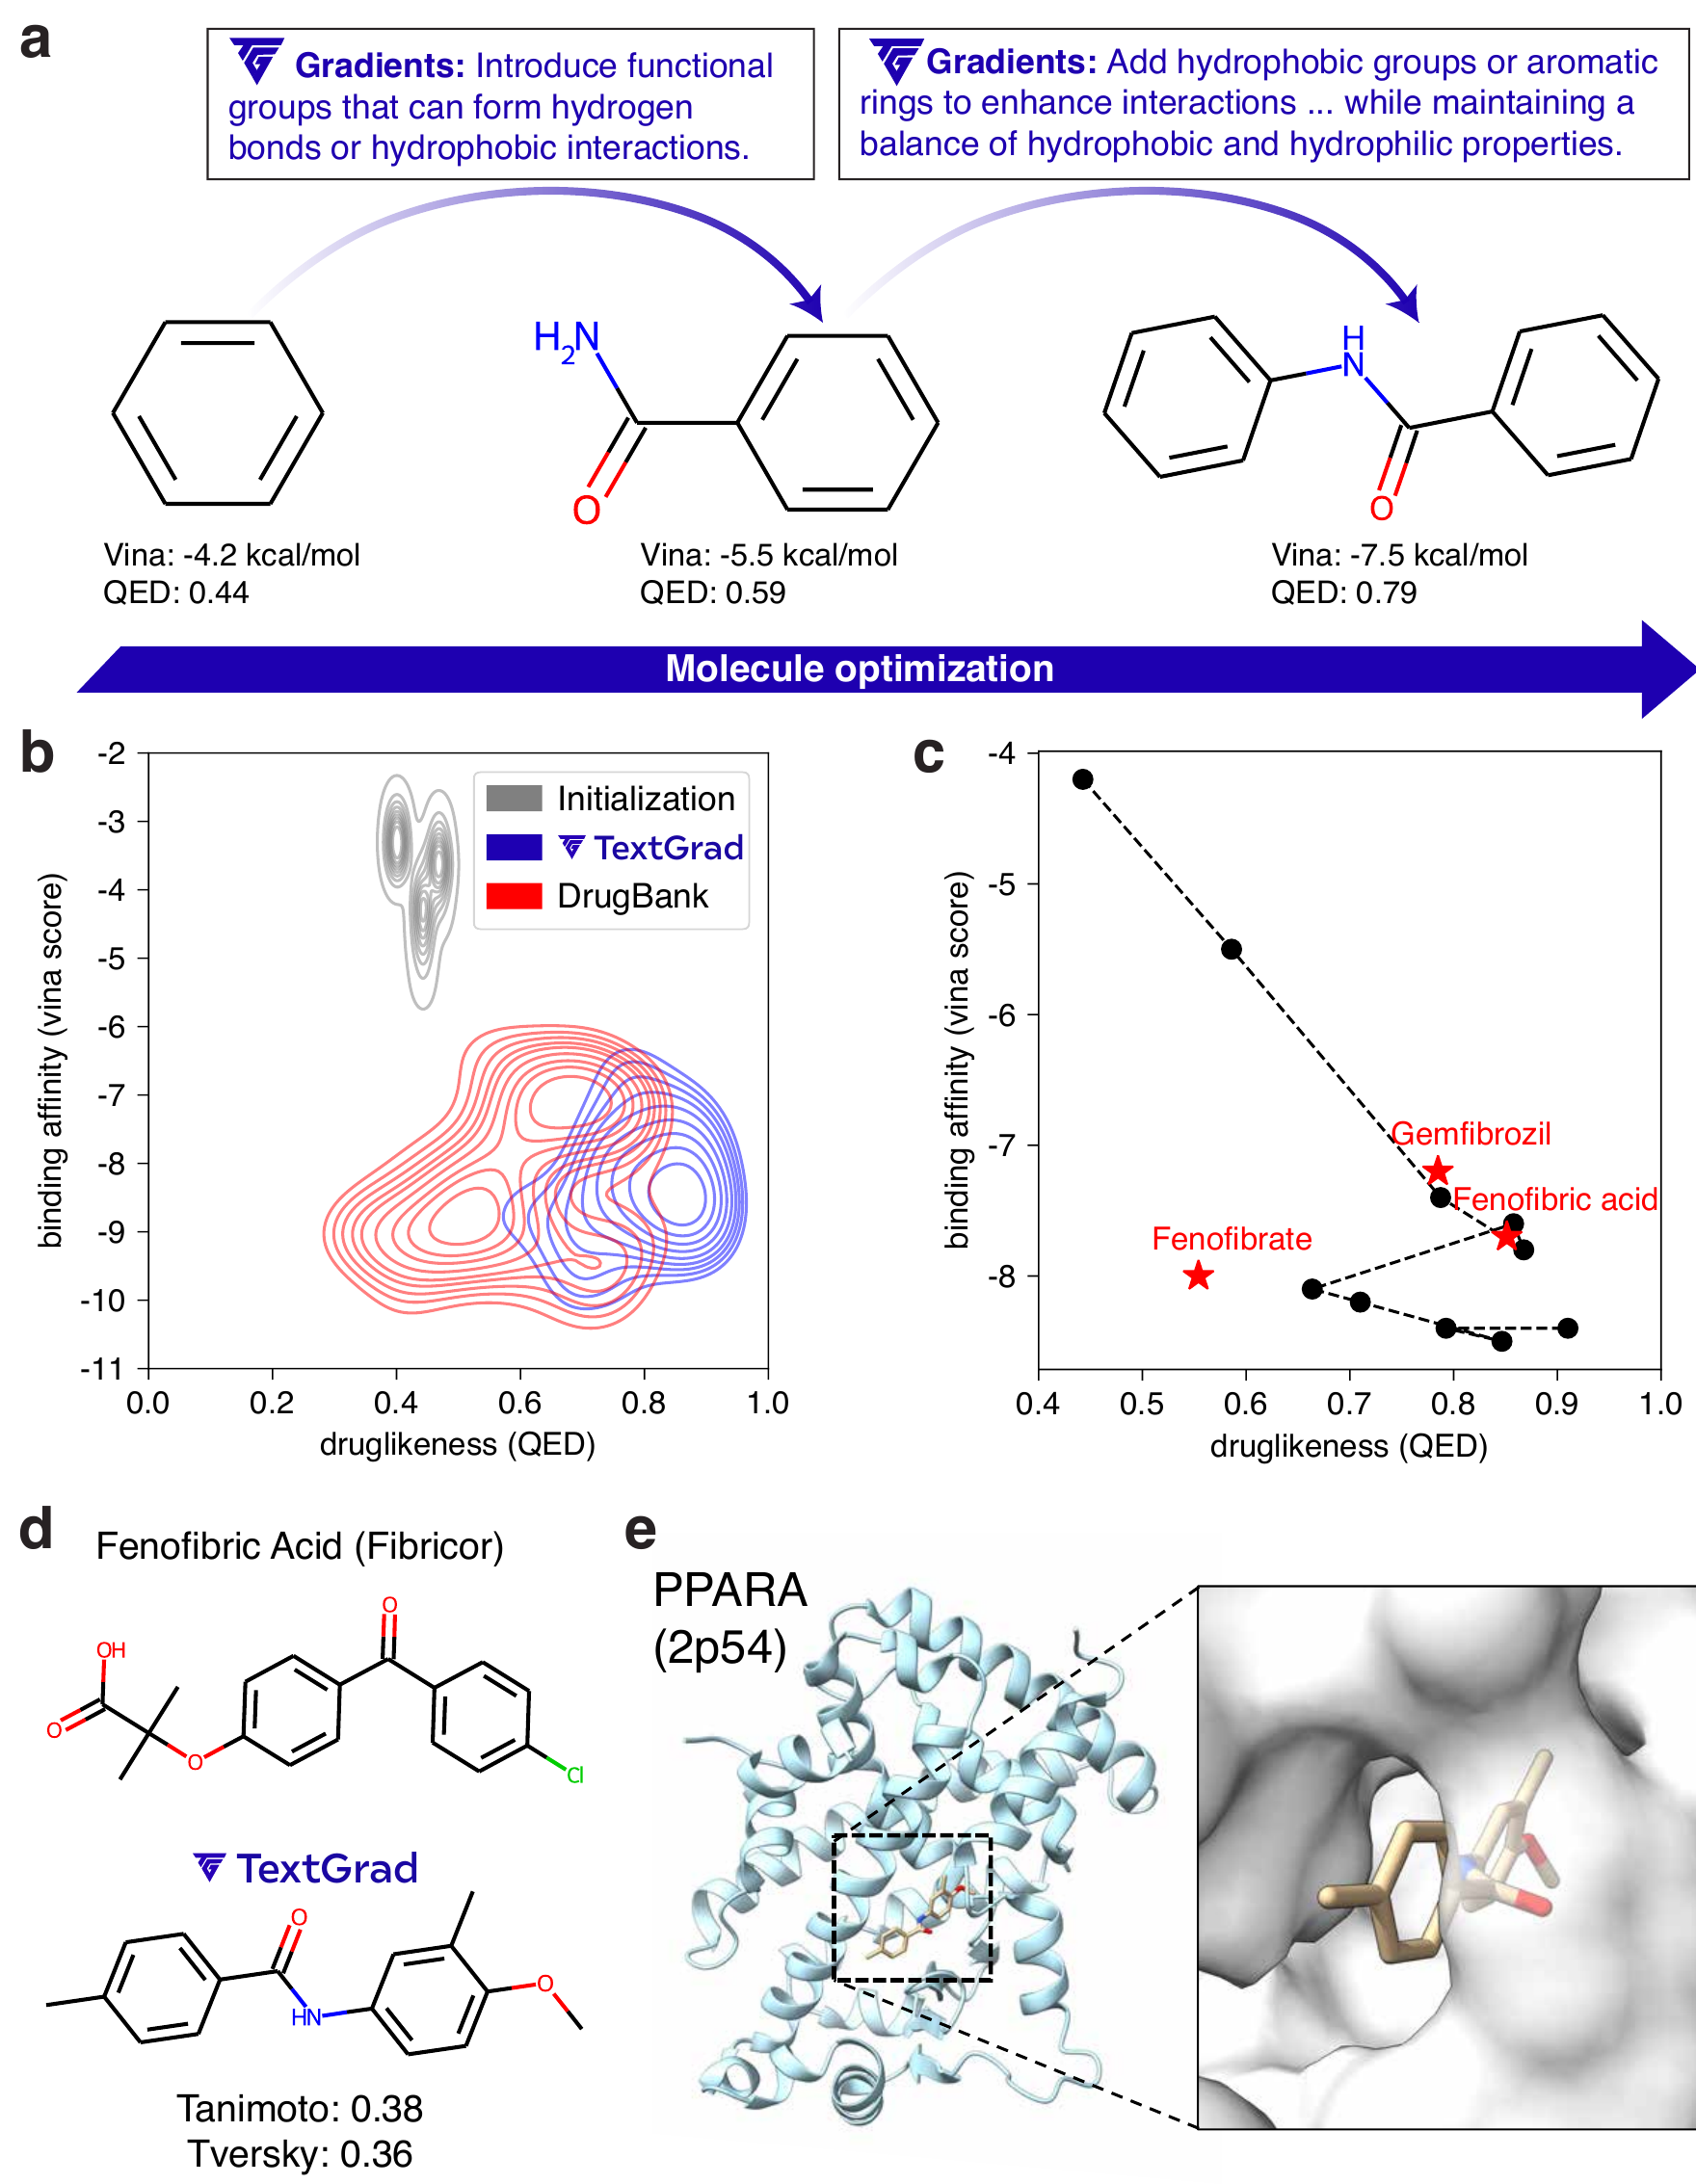
médicaments approuvés sur le plan clinique, nous observons que TEXTGRAD génère des molécules dont l'affinité et la ressemblance médicamenteuse sont très compétitives par rapport aux molécules cliniques évaluées à l'aide de la même fonction de perte (Figure 2 (b)). Les molécules résultantes présentent des structures uniques par rapport à leurs homologues approuvés sur le plan clinique et aux composés existants (annexe F.5), tout en conservant des profils de sécurité in silico similaires (annexe F.6). Bien qu'il existe des méthodes d'apprentissage automatique alternatives pour la génération de molécules de novo, TEXTGRAD offre deux avantages clés par rapport à ses homologues : premièrement, en combinant des outils de chémoinformatique traditionnels avec les capacités de connaissance générale et de raisonnement des LLM, TEXTGRAD produit des résultats compétitifs même sans ensemble d'entraînement préalable. Deuxièmement, le cadre de gradients en langage naturel de TEXTGRAD produit des décisions explicables, permettant aux chercheurs de comprendre précisément comment et pourquoi la structure d'une molécule a été construite. Ensemble, ces deux caractéristiques augurent un avenir prometteur pour le rôle des agents d'IA dans la découverte scientifique.