Aller au contenu principal
TextGrad: Automatic "Differentiation" via TextMert Yuksekgonul et al.

F.4 Initialisation

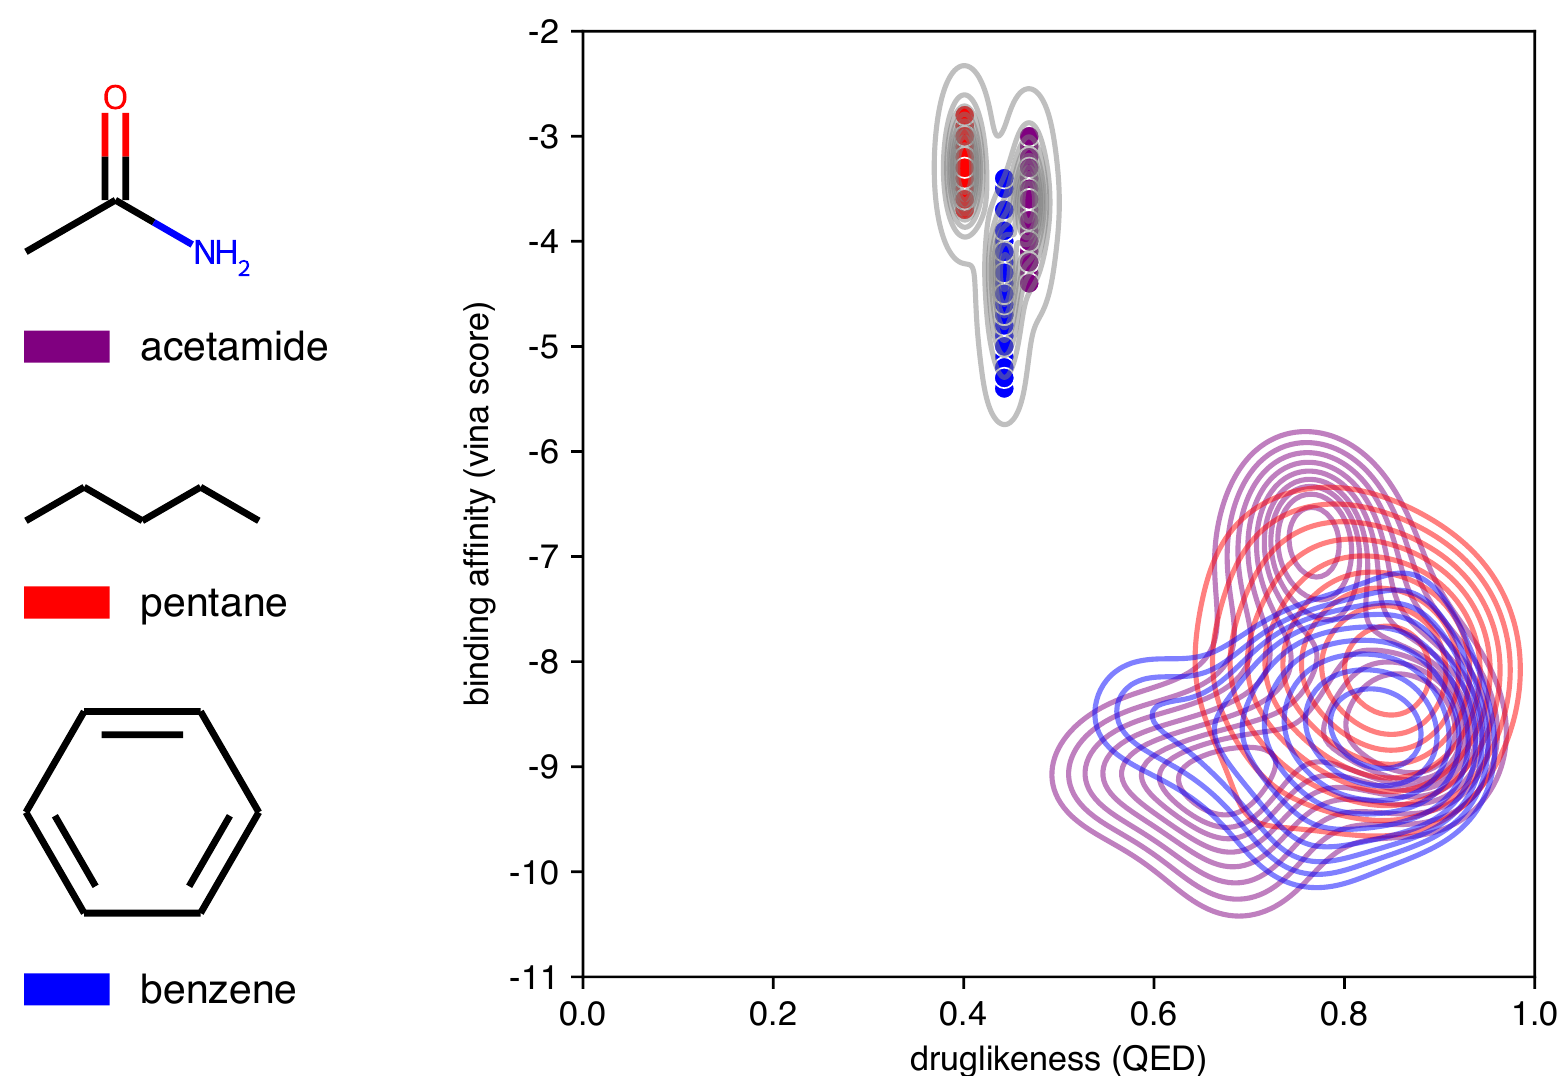
Figure supplémentaire 1 : Initialisation des molécules. Nous initialisons TEXTGRAD avec des molécules fragments issues de trois groupes fonctionnels divers et optimisons chaque molécule initiale pendant 10 itérations pour les 58 cibles de la suite de référence DOCKSTRING. Pour chaque fragment et chaque protéine, nous effectuons une post-sélection sur les molécules générées à l'aide du score récapitulatif décrit dans l'équation 25 et visualisons la distribution résultante. Nous observons que, bien que les distributions initiales des scores QED et Vina des fragments de départ varient considérablement, la distribution des molécules optimisées se recoupe fortement.

En pratique, l'optimisation moléculaire est généralement accélérée par un criblage de pré-optimisation à grande échelle, où des bibliothèques de millions, voire de milliards, de structures chimiques existantes sont évaluées et classées par docking, ressemblance aux médicaments et autres métriques. Seules les structures les plus prometteuses, appelées « têtes de série », sont ensuite affinées par les chimistes médicinaux [104]. Bien que TEXTGRAD soit capable d'optimiser n'importe quelle molécule initiale, dans ce travail, afin de caractériser plus précisément ses performances et d'éviter de biaiser ses conceptions vers des médicaments existants, nous sélectionnons plutôt nos trois molécules initiales à partir de fragments simples de groupes fonctionnels courants, illustrés à la Figure 1. Ces fragments sont très diversifiés et appartiennent à différents groupes fonctionnels. Bien que ces fragments initiaux présentent des caractéristiques de ressemblance aux médicaments et d'affinité de liaison différentes, l'impact du fragment de départ sur les performances de TEXTGRAD est minimal, et TEXTGRAD est capable de générer des molécules présentant une forte ressemblance aux médicaments et une forte affinité de liaison à partir des trois fragments.