
A.1 Variables
Les variables sont les nœuds du graphe de calcul. Ci-dessous figurent les attributs les plus importants des Variables :
1. La valeur correspond aux données non structurées que contient la variable. Dans l’ensemble de ce manuscrit, toutes les valeurs sont des données textuelles.
2. La description du rôle est une chaîne informative qui décrit le rôle de la variable dans le graphe de calcul. Nous utilisons ces rôles pour permettre à l’utilisateur d’injecter des connaissances dans le graphe et de guider le comportement d’optimisation. De plus amples informations sont décrites ci-dessous.
3. Les gradients correspondent au retour d’information en langage naturel fourni par les LLM lors de la passe arrière. Ils décrivent les modifications à apporter à la variable afin que la perte en aval puisse être améliorée. Pour un exemple d’opération arrière qui renseigne les gradients, veuillez lire la section A.3.
4. Les prédécesseurs constituent l’ensemble des variables utilisées pour générer une variable donnée. Par exemple, si nous donnons une instruction à un LLM et obtenons une réponse, l’instruction serait le prédécesseur de la réponse. Lors de la passe arrière, les gradients sur le successeur sont transmis à ses prédécesseurs, afin de fournir des indications sur la manière d’améliorer l’objectif en aval.
5. Requires grad indique si les gradients seront peuplés ou non pendant la passe arrière, de manière analogue à PyTorch. Par exemple, si l'utilisateur ne souhaite pas calculer de gradients pour une question, il suffit d'écrire Variable(value=question, requires_grad=False, ...) pour l'indiquer.
Description du rôle : Dans TEXTGRAD, chaque variable possède une description de rôle. En particulier, il s'agit d'une chaîne de caractères qui décrit le rôle de la variable dans le graphe de calcul, comme par exemple le prompt système adressé au modèle de langage ou la prédiction effectuée par le modèle de langage. Bien qu'elle soit parfois renseignée automatiquement, les descriptions de rôle constituent en général l'un des principaux moyens d'injecter la connaissance de l'utilisateur dans le processus d'optimisation.
Empiriquement, nous constatons que les descriptions de rôle peuvent orienter de manière significative le processus d'optimisation. Par exemple, définir le rôle d'une prédiction comme étant la réponse numérique finale du modèle de langage guide l'optimiseur Textual Gradient Descent, qui invite un modèle de langage à mettre à jour la valeur de la variable à l'aide du retour d'information, afin qu'il mette à jour la variable de sorte qu'elle ne soit qu'une valeur numérique. En comparaison, une description de rôle telle que le raisonnement pour la solution et la prédiction finale guide l'optimiseur pour produire le raisonnement accompagné de la prédiction finale.
Voici un exemple d'utilisation :
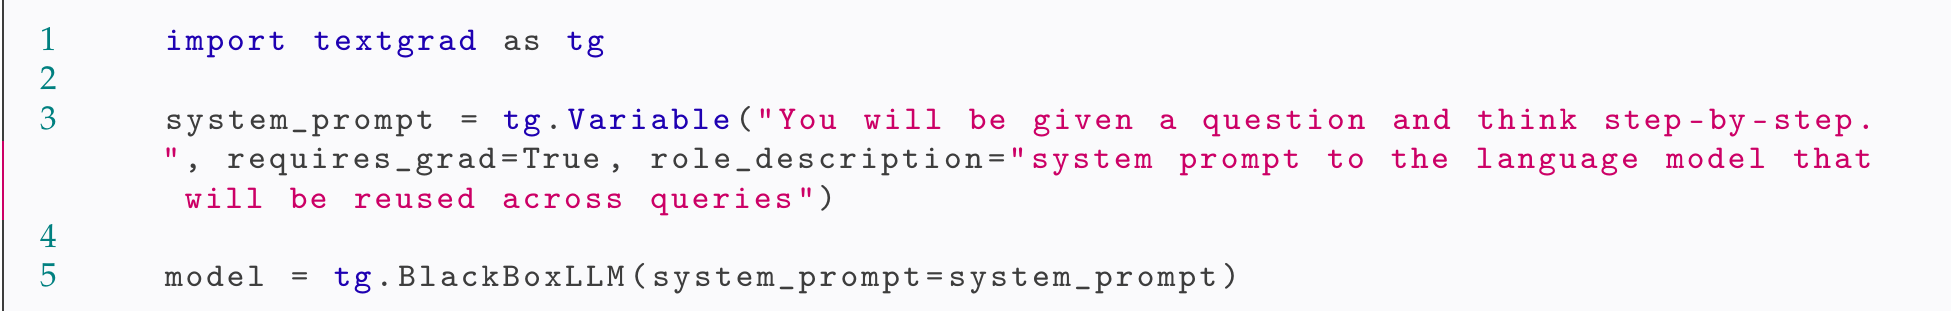
Extrait de code 3 : Un exemple d'utilisation d'une description de rôle.