
E.6 Objectifs implicites
Une autre préoccupation majeure dans l'application des LLM en science est leur propension aux hallucinations, où les modèles génèrent des réponses factuellement incorrectes ou illogiques tout en tentant de satisfaire les demandes des utilisateurs [105]. Dans notre contexte, ces hallucinations pourraient se manifester par TEXTGRAD proposant des molécules invalides, toxiques ou autrement indésirables afin d'optimiser sa fonction objectif. Nous contrôlons les hallucinations sévères en prétraitant les molécules à l'aide de la sanitisation RDKit, garantissant au minimum que TEXTGRAD génère des molécules chimiquement valides. Cependant, cette simple étape de prétraitement ne spécifie pas complètement le comportement chimique souhaitable. Une stratégie directe consisterait à encoder exhaustivement toutes les métriques possibles de désirabilité des molécules médicamenteuses au-delà de la druglikeness et de l'affinité de liaison dans la fonction objectif, et à l'étendre pour inclure la synthétisabilité, la toxicité, entre autres critères. Malheureusement, cette approche n'est pas réalistement faisable car tous les critères de désirabilité ne disposent pas de métriques computationnelles matures. Ainsi, une question clé est de savoir si TEXTGRAD obéit à des objectifs dits implicites durant son processus d'optimisation, qui limitent les comportements illogiques ou indésirables.
Pour évaluer l'ampleur ou l'existence de molécules indésirables, nous pouvons caractériser la nocivité des molécules générées, en nous concentrant sur la mutagénicité et la toxicité clinique. La mutagénicité désigne la capacité d'un médicament à induire des altérations génétiques, qui peuvent entraîner des dommages à l'ADN et des effets néfastes à long terme. La toxicité clinique désigne un large éventail d'effets secondaires indésirables à court ou à long terme. Il est important de noter que ni la druglikeness
ni l'affinité de liaison ne sont fortement corrélées à ces critères, et donc ces métriques de désirabilité ne sont pas directement optimisées ni autrement explicitement encodées dans les objectifs de TEXTGRAD.
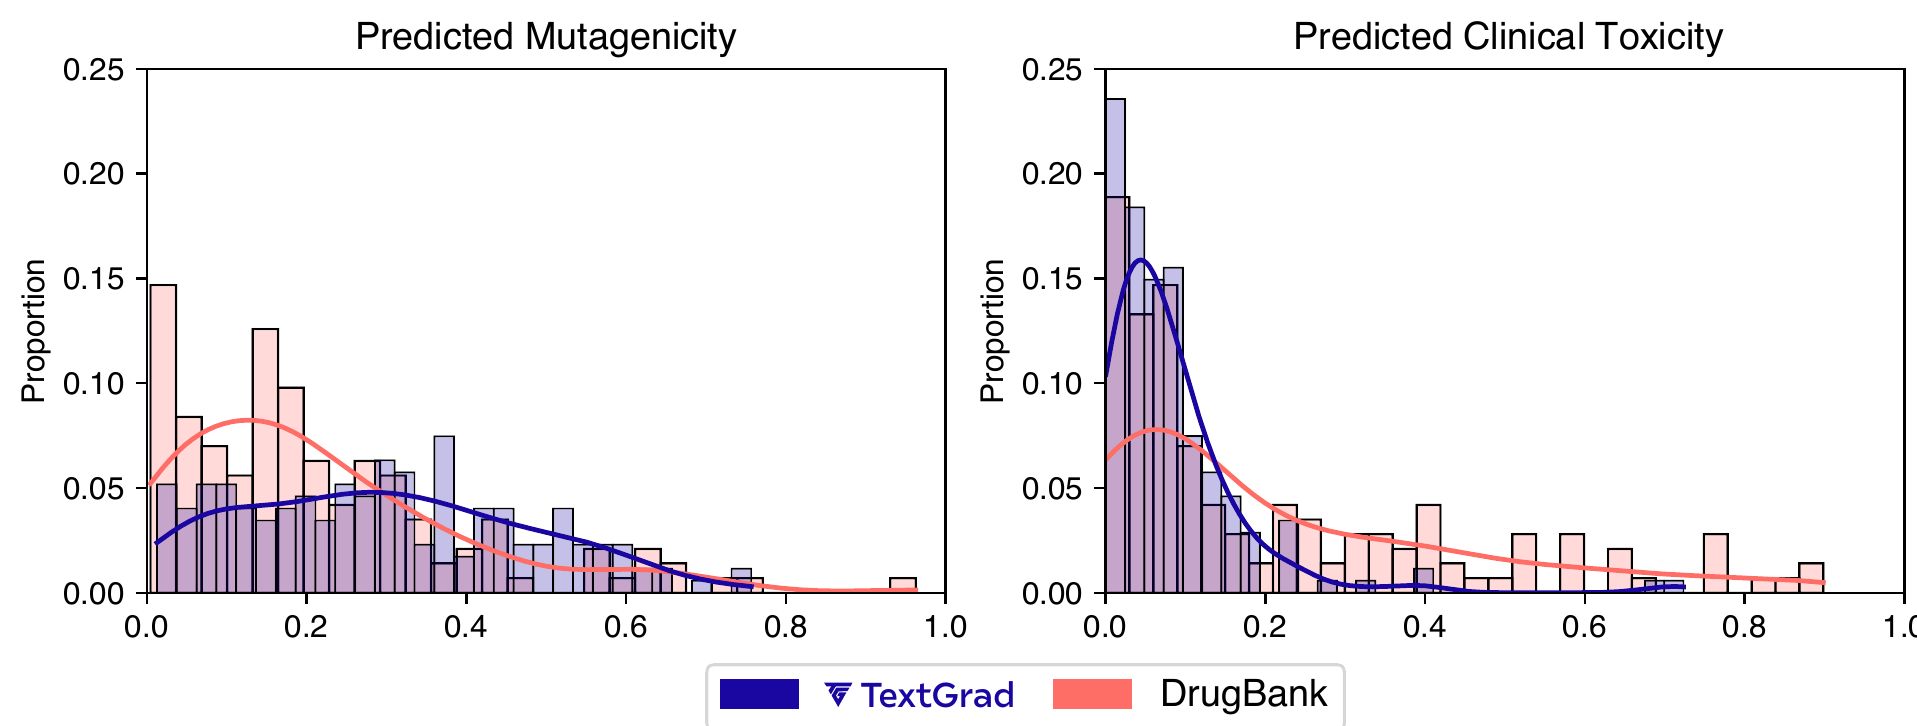
Pour évaluer la propension à la mutagénicité et à la toxicité clinique, nous employons le modèle ADMET-AI, qui prédit ces scores à partir des structures chimiques des molécules [108]. ADMET-AI emploie un modèle d'apprentissage profond entraîné sur de multiples jeux de données pertinents. En particulier, pour la mutagénicité, ADMET-AI est entraîné sur 7 255 médicaments du jeu de données Ames, un test de mutation inverse bactérienne permettant de cribler rapidement un grand nombre de composés afin de détecter les dommages génétiques induits et les mutations de décalage de cadre. Une étiquette prédite de 1,0 indique une forte probabilité que le médicament induise une mutagénicité, tandis qu'une étiquette de 0,0 indique une faible probabilité. Pour la toxicité clinique, ADMET-AI est entraîné sur le jeu de données ClinTox, un jeu de données de 1 484 médicaments comprenant des molécules qui ont échoué aux essais cliniques pour des raisons de toxicité ainsi que des médicaments associés à des essais réussis. De même, une étiquette prédite de 1,0 indique une forte probabilité de toxicité clinique, tandis qu'une étiquette de 0,0 indique une faible probabilité.
Une fois encore, nous restreignons notre analyse aux molécules générées les plus performantes avec des cibles druggables telles que mesurées par le score global, et sélectionnons la meilleure molécule pour chaque cible protéique et pour chaque fragment initial, soit un total de 87 molécules générées. Nous comparons ensuite leurs prédictions de mutagénicité et de toxicité clinique aux 118 molécules approuvées cliniquement issues de DrugBank. Nous observons que, tant pour la mutagénicité que pour la toxicité clinique, les molécules générées par TEXTGRAD présentent des distributions prédites qui indiquent une faible probabilité d'effets nocifs, et correspondent étroitement aux distributions des molécules approuvées cliniquement. Ensemble, ces résultats suggèrent que TEXTGRAD évite implicitement de proposer des molécules nocives, bien que ces critères ne soient pas directement encodés dans sa fonction de perte.