
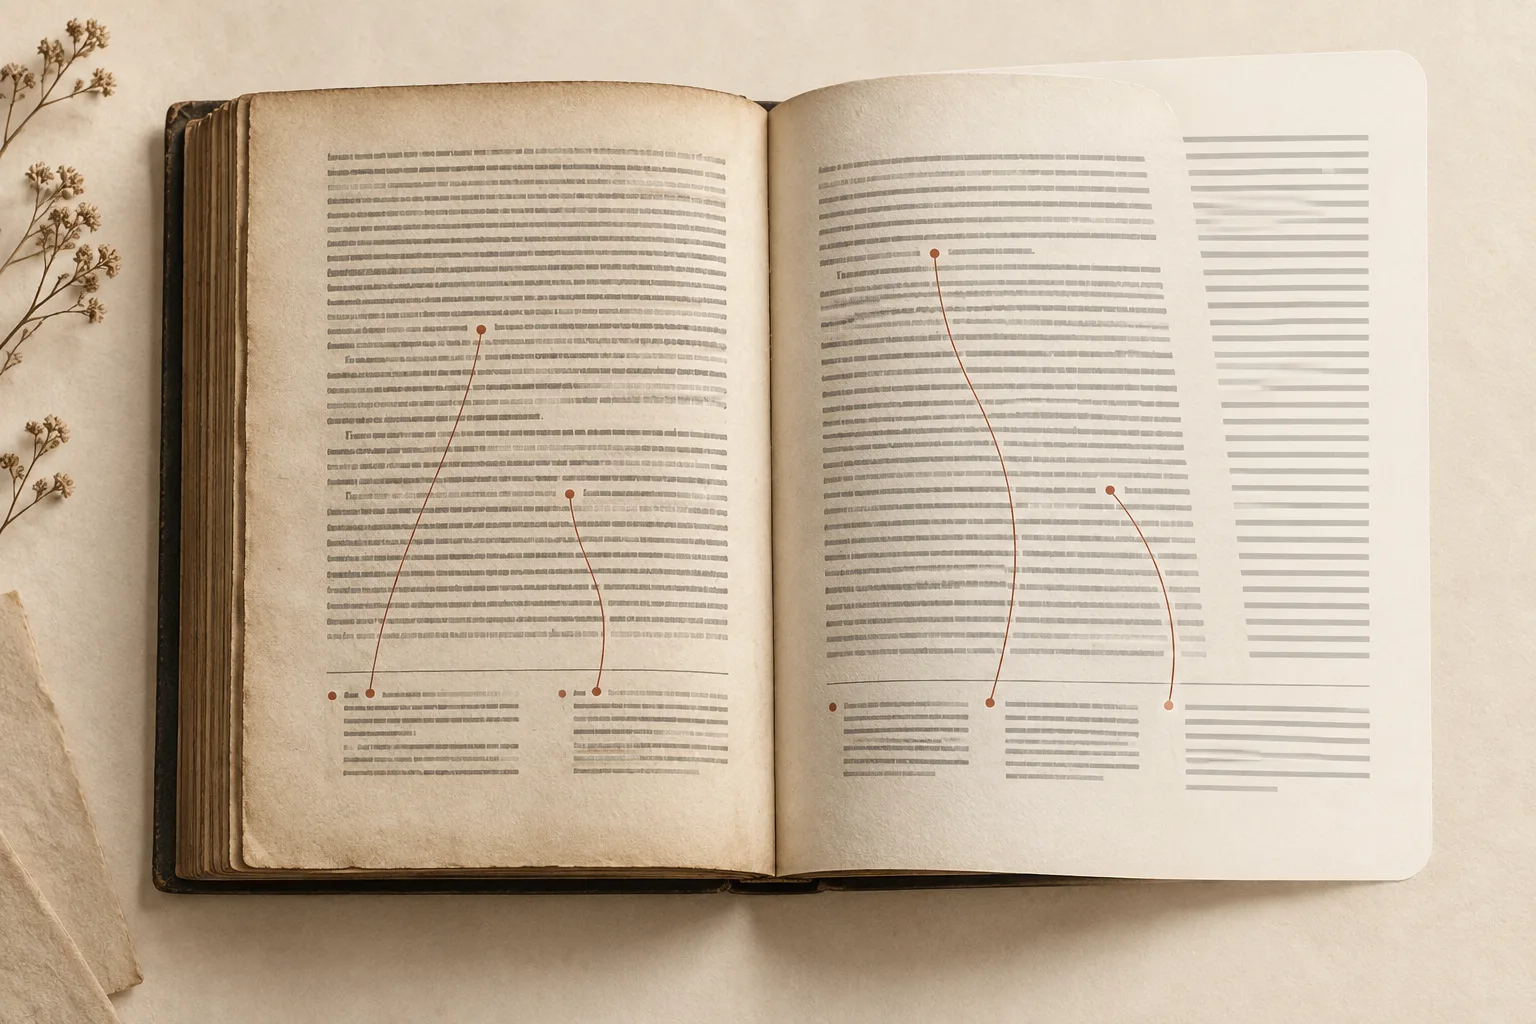
PDF Craftは、スキャンした書籍のPDFを、実際に読めて検索でき、整理もできるMarkdownやEPUBに変換するために作りました。ただし、文字を認識するだけでは仕事は終わりません。本文中の数字や丸囲み記号、アスタリスクが、元のページ下部にある正しい注記へつながっている必要があります。ここが崩れると、文章はリフローされても、読むうえで欠かせない関係が失われてしまいます。
古い書籍や学術資料、個人の蔵書を扱うときには、この点が重要になります。役に立つ変換とは、参照関係を保ったまま、検索できて小さい画面でも読みやすい本にすることです。出力ファイルの具体的な確認方法については、スキャンPDFからEPUBへの変換ガイドと数式・脚注のチェックリストをご覧ください。
OCRがわかるのは文字であり、その役割ではない
OCRはページ上の単語を識別できても、その単語が本の中でどんな役割を果たしているかまではわかりません。ページ下部の小さい文字が脚注なのか、余白まで届いた本文なのかは区別できません。上付きの丸囲み数字が参照記号なのか、ただの箇条書きの番号なのかも同じです。ひとつの注記が2つのブロックに分かれたり、次のページへ続いたりすることもあります。
判断をひとつ間違えるだけで、EPUBの挙動はおかしくなります。行き先のない参照記号、つながってしまった2つの注記、文中に紛れ込んだページ番号、前のページの末尾と次ページの柱(running header)がつながった文章などです。脚注は以前から、PDF Craftがもっとも苦手とする問題のひとつでした。
最初の試み:LLMに全ページを読ませる
1年ほど前、素直な答えは、各ページを大規模言語モデルに渡すことでした。小さい文字が本文を説明していると認識したり、星印やローマ数字を参照記号として解釈したり、文がページをまたいで続いているかを判断したりすることは、しばしば可能でした。
ページ単位では有望でしたが、長い本を通して処理すると厳しいものがありました。数百ページあれば、数百回の呼び出しと待ち時間、そして再試行の可能性が生じます。ページをまたぐ判断には前後の文脈も必要で、入力はさらに膨らみます。ほとんどのページはすでに正しく処理されているのに、高価なモデルは「変更は不要」と答えるためだけに多くの時間を費やしていました。長い処理が進んでいるのか止まっているのか、利用者にもわかりにくいという問題もありました。
まずルールに基づく処理の流れを整える
後のバージョンでは、主要な処理を再びOCRと固定ルールで行うようにしました。この経路は、本文と注記を分け、自然な段落をつなぎ、注記を個々の引用に分割し、本文の参照記号と注記を対応付けます。速く、繰り返し実行でき、安定しており、ほとんどのページをうまく処理できます。
しかし本のレイアウトはさまざまです。注記はページ下部にあるとは限らず、段の間に置かれることもあります。参照記号は数字のことも記号のこともあります。柱やページ番号、飾りが認識結果に混ざることもあります。文の意味を理解しないと決められない判断もあり、ルールだけでは難しいケースが残ります。一方、全ページをLLMに読ませるのは遅く、コストもかかります。
変更点:JEVには作り直させるのではなく、点検させる
既存の処理経路を置き換える必要はありませんでした。必要なのは、詳しく見る価値のあるページを拾い上げる、手早い品質チェックです。そこにJEVを置き、問いをひとつに絞りました。このページの解析結果は、そのまま通してよいか。 JEVは文章を書き換えたり、すべての引用を説明したりはしません。返ってくるのは確率で、そのページをそのまま進めるか、LLMによる修正に回すかを決めるのに使います。
確認の単位はページ全体です。アルゴリズムが注記を完全に見落としていれば、既知の引用だけをたどるチェックでは調べる対象がありません。ページ単位の判定なら、参照の欠落、対応先の取り違え、ページをまたぐ不自然なつながり、本文に混ざったページ番号などを拾えます。多少多めのページを確認に回すほうが、誤ったページを黙って通すよりましだと考えています。誤検知のコストはモデルによる追加チェック1回分ですが、見逃した誤りは最終的なEPUBに残ってしまいます。しきい値については、さらに幅広い調整が必要です。
flowchart TB
  accTitle: ページ確認から制約付き修正まで
  accDescr: まずOCRとルールがページを処理します。JEVはそのまま通せるかを判定します。要注意ページはLLMへ送られ、その後プログラムによる整合性チェックを受けます。通過したページは章の組み立てへ進み、修正に失敗した場合は再試行します。
  A[OCRとルール] --> B{JEV:ページは信頼できるか?}
  B -- はい --> F[章を組み立てて出力]
  B -- いいえ --> C[LLMが現在のページだけを修正]
  C --> D{整合性チェック}
  D -- 通過 --> F
  D -- 再試行 --> C
LLMには厳しい範囲内でページを修正させる
要注意と判定されたページについて、LLMは連続する3ページ(前・現在・次)のテキスト構造を受け取ります。変更してよいのは中央のページだけです。前後のページは、ページ境界をまたぐ文の文脈を提供します。この段階ではページ画像は送りません。OCRがすでにテキスト、位置、レイアウトを提供しており、ここでの作業はもう一度OCRをかけることではなく、意味の修正だからです。
モデルは本文、脚注、ページ番号のラベルを付け直し、段落の連続性を正し、参照記号と注記を対応付け直すことができます。ただし、元の文章を自由に書き換えたり、ページ構造を変えたりはできません。その後、プログラムによるチェックで、注記番号が順序どおりであること、参照と注記が対応していること、ページ境界をまたぐリンクが一貫していること、参照記号の位置が指定テキスト内で一意に特定できることを確認します。チェックに失敗した場合は具体的なエラーが返り、モデルは完全な結果を再提出できます。再試行が少ないのは望ましいことですが、それを理由にチェックを緩めるべきではありません。
既存の26ページの技術系サンプルでわかったこと
26ページで注記の多いテスト用PDFでは、JEVが6ページをLLMに回しました。6ページとも最初の提出で整合性チェックを通過し、すでに正しかった22組の本文参照と注記の対応もそのまま保たれました。
実際の修正はささやかでしたが、重要でした。印刷されたページ番号が本文と誤認されていたこと、ある数字が段落間に誤った橋渡しを作っていたこと、導入文がその後に続く字下げされた引用と結合されていたことです。LLMは意味と字下げを手がかりに、これらを分離しました。
これは1つのサンプルでの観察であり、文書全体の精度やコストを示す主張ではありません。ここから得た教訓は、よい修正段階とは、正しく処理できた部分を保ち、根拠のある問題を直したら止まるべきだということでした。
高価な判断は必要なところにだけ使う
ルールに基づく処理が本の大部分を担います。JEVは要注意ページをすばやく選び出します。LLMは意味の判断が必要な少数のケースを扱います。プログラムによる制約が最終的な構造を守ります。修正されたページは、同じ章の組み立てとMarkdownまたはEPUBのレンダリング経路に戻ります。
言語、レイアウト、より長い本での検証はまだ必要です。とくにJEVの見逃し率と、LLMによる確認に回すしきい値は詰める必要があります。それでも、1年前より方向性ははっきりしました。余白に隠れたわずかな誤りを見つけるために、LLMに全ページを読ませる必要はないのです。
スキャンした本を変換する場合は、まず注記を含む短いサンプルをPDF Craftのワークスペースで試してください。本全体の変換に進む前に、本文の参照記号、注記の全文、ページ境界をまたぐ段落を確認しましょう。
サンプルを手がかりに、自分の出力確認を設計する
ここで紹介したサンプルは、ある1回の技術的な実行についての証拠であり、任意の本に対する成功率ではありません。注記の多い本を変換したときに、どこを見ればよいかを示してくれます。参照記号がいくつかあるページ、記号による参照を含むページ、注記や本文の段落が次ページへ続く箇所を選んでください。
選んだ箇所ごとに、元のページ画像と出力を比べます。本文の参照記号を見つけ、その行き先をたどり、注記の全文がその箇所に対応しているかを確かめます。本文に戻り、次の文が自然につながっているかも確認します。リンクが機能していても、間違った注記を指していることはあります。
次のような異常に注意してください。
- 行き先のない参照、または対応する本文の参照記号がない注記。
- 別々の注記が1つに結合されている、または続きの注記が誤って分割されている。
- ページ番号、柱、飾り記号が文中に挿入されている。
- 注記が誤った段や隣のページに結び付いている。
- 引用や節の区切りがあるのに、段落がページ境界をまたいで結合されている。
印刷ページ、PDFビューア上のページ、参照記号、短いフレーズを記録しておきます。EPUBのページ送りはフォントサイズで変わるため、電子書籍のページ番号だけでは後から問題箇所を特定できません。
ページ単位の確認の限界を知っておく
ここで説明した確認と修正の段階は内部処理であり、利用者が操作できるJEVの機能でも、変換後のすべてのページが専門家によって確認済みだという保証でもありません。ページが構造上の制約を満たしていても、認識の誤りや曖昧な表現が残っていることはあります。逆に、要注意ページを修正に回したからといって、隣接する関係がすべて正しいと証明されるわけでもありません。
気軽に読むことが目的なら、難しい構造と重要な箇所を狙って確認しましょう。引用、研究上の主張、出版を目的とする場合は、その用途に必要な、より丁寧な確認を行ってください。EPUBが読みやすくても、元のPDFは手元に残しておきましょう。
OCRと翻訳のワークフローでは、認識、構造、意味にそれぞれ異なる確認が必要な理由を説明しています。翻訳も行う論文については、arXivのPDFから作業する方法をご覧ください。現在の処理料金は料金に掲載しています。今回のサンプルは、普遍的な速度やコスト削減を裏付けるものではありません。