
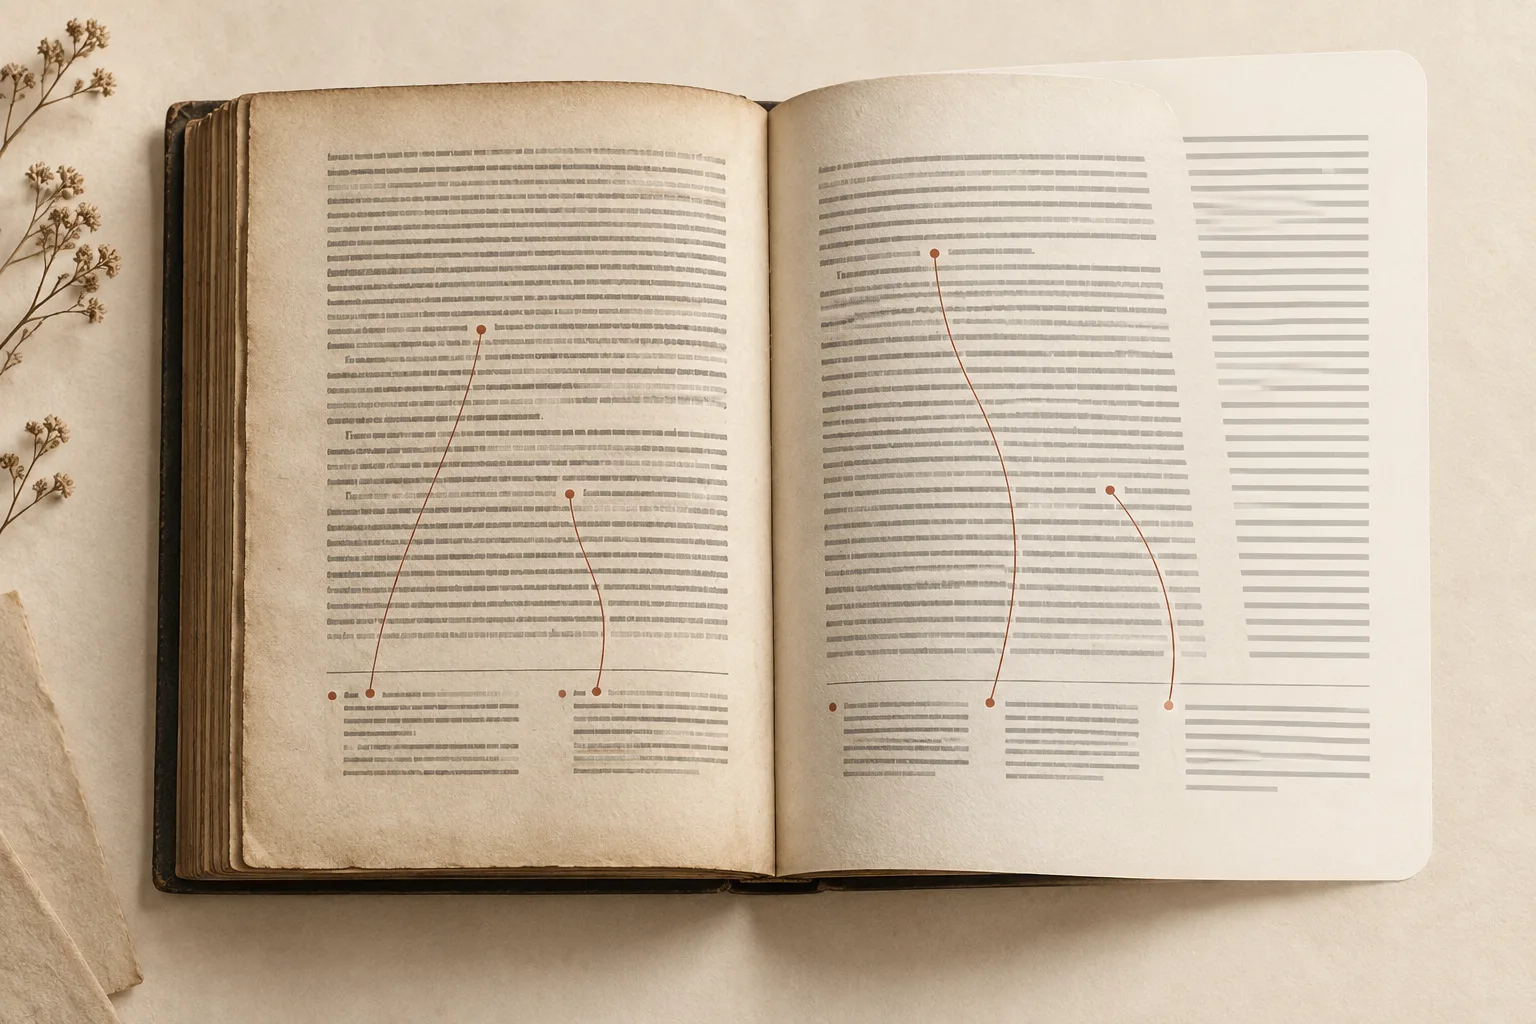
Creé PDF Craft para convertir en Markdown o EPUB libros escaneados en PDF que la gente pueda leer, buscar y organizar de verdad. Reconocer las palabras es solo una parte del trabajo. Un número, un símbolo rodeado por un círculo o un asterisco en el cuerpo del texto debe seguir llevando a la nota correcta al pie de la página original. De lo contrario, el texto se reajusta, pero se pierde una relación esencial para la lectura.
Esto importa cuando trabajas con libros antiguos, fuentes académicas o una colección personal. Una conversión útil debe hacer que el libro se pueda buscar y resulte cómodo en una pantalla pequeña, sin romper sus referencias. Para revisar de forma práctica un archivo de salida, consulta la guía para convertir PDF escaneados a EPUB y la lista de comprobación de fórmulas y notas al pie.
El OCR encuentra caracteres, no sus funciones
El OCR puede identificar las palabras de una página sin saber qué papel desempeñan en el libro. Un texto pequeño al pie puede ser una nota al pie o simplemente texto del cuerpo que llegó al margen. Un número volado y rodeado por un círculo puede ser una llamada a nota o el número corriente de una lista. Una nota puede quedar dividida en dos bloques o continuar en la página siguiente.
Una sola decisión equivocada puede producir un comportamiento extraño en el EPUB: una llamada sin destino, dos notas pegadas, un número de página insertado en una frase o el final de una página unido al encabezado de la siguiente. Las notas al pie han sido desde hace tiempo uno de los problemas más difíciles de PDF Craft.
Primer intento: que un LLM leyera todas las páginas
Hace aproximadamente un año, la solución más directa era entregar cada página a un modelo de lenguaje grande. A menudo sabía reconocer que un texto pequeño explicaba el cuerpo del texto, interpretar asteriscos o números romanos como llamadas y decidir si una frase continuaba tras un salto de página.
Prometía página a página, pero resultaba penoso en un libro largo. Cientos de páginas significaban cientos de llamadas, esperas y posibles reintentos. Las decisiones que afectaban a varias páginas necesitaban el contexto de las vecinas, lo que aumentaba aún más la entrada. La mayoría de las páginas ya estaban bien: el modelo caro pasaba buena parte del tiempo leyendo una página solo para decir que no había nada que cambiar. Además, a quien lo usaba le costaba saber si una ejecución larga avanzaba o se había quedado atascada.
Construir primero un proceso determinista completo
Las versiones posteriores devolvieron el trabajo principal al OCR y a reglas deterministas. Ese proceso separa el cuerpo del texto de las notas, une los párrafos naturales, divide las notas en citas individuales y empareja cada llamada del cuerpo con su nota. Es rápido, repetible y estable, y resuelve bien la mayoría de las páginas.
Pero la maquetación de los libros varía. Las notas pueden estar al pie de página o entre columnas; las llamadas pueden ser dígitos o símbolos; los encabezados, los números de página y los adornos pueden colarse en el texto reconocido. Algunas decisiones exigen entender qué significa una frase. Las reglas por sí solas dejan unos cuantos casos difíciles, mientras que un LLM en cada página resulta demasiado lento y costoso.
El cambio: pedir a JEV que inspeccione, no que rehaga
No hacía falta sustituir el proceso existente. Hacía falta una comprobación de calidad rápida que señalara las páginas que merecían una mirada más atenta. Ahí coloqué a JEV y le planteé una pregunta concreta: ¿el análisis de esta página puede pasar sin cambios? No reescribe el texto ni explica cada cita. Devuelve una probabilidad que sirve para decidir si la página sigue adelante o se envía a un LLM para repararla.
La unidad de revisión es la página entera. Si el algoritmo pasa por alto una nota, una comprobación que solo visita las citas conocidas no tiene nada que inspeccionar. Un juicio a nivel de página todavía puede señalar referencias que faltan, atribuciones equivocadas, vínculos poco habituales entre páginas o números de página mezclados con la prosa. Prefiero enviar unas cuantas páginas de más a revisión que dejar pasar una mala en silencio: una falsa alarma cuesta otra comprobación del modelo; un error no detectado puede llegar al EPUB final. El umbral aún necesita una calibración más amplia.
flowchart TB
  accTitle: De la revisión de la página a la reparación acotada
  accDescr: El OCR y las reglas procesan primero una página. JEV decide si puede pasar sin cambios. Las páginas sospechosas van a un LLM y después a una comprobación programática de integridad. Las páginas que pasan continúan al ensamblado de capítulos; las reparaciones fallidas se reintentan.
  A[OCR y reglas] --> B{JEV: ¿la página es fiable?}
  B -- Sí --> F[Ensamblar capítulos y generar la salida]
  B -- No --> C[El LLM repara solo la página actual]
  C --> D{Comprobación de integridad}
  D -- Pasa --> F
  D -- Reintentar --> C
Dejar que el LLM repare una página con límites estrictos
Para una página señalada, el LLM recibe la estructura de texto de tres páginas consecutivas: la anterior, la actual y la siguiente. Solo puede modificar la del medio. Las vecinas le dan contexto para las frases que cruzan los límites de página. En esta fase no envío imágenes de las páginas: el OCR ya proporciona texto, posiciones y maquetación, y la tarea es una corrección semántica, no otra pasada de OCR.
El modelo puede reetiquetar texto del cuerpo, notas al pie y números de página, corregir la continuidad de los párrafos y volver a emparejar las llamadas con las notas. No puede reescribir la fuente a su antojo ni cambiar la estructura de la página. Después, las comprobaciones programáticas exigen índices de notas ordenados, llamadas y notas que coincidan, vínculos coherentes entre límites de página y posiciones de las llamadas que se puedan localizar sin ambigüedad en el texto indicado. Si una comprobación falla, se devuelven errores concretos para que el modelo pueda enviar un resultado completo de nuevo. Menos reintentos son útiles, pero no son motivo para debilitar esas comprobaciones.
Qué mostró la muestra de ingeniería existente de 26 páginas
En un PDF de prueba de 26 páginas con muchas notas, JEV seleccionó 6 páginas para el LLM. Las seis primeras entregas pasaron las comprobaciones de integridad, y las 22 relaciones entre llamadas del cuerpo y notas que ya eran correctas se mantuvieron intactas.
Las correcciones reales fueron modestas pero importantes: se habían confundido números de página impresos con texto del cuerpo; un número se había convertido en un falso puente entre párrafos; y una frase introductoria se había fusionado con la cita sangrada que venía después. El LLM usó el significado y la sangría para separarlas.
Esta es la observación de una sola muestra, no una afirmación sobre la precisión o el coste en todo un documento. La lección para mí fue que una buena fase de reparación debe conservar lo que ya está bien y detenerse tras corregir los problemas confirmados por las pruebas.
Reservar el análisis del LLM para los casos que lo necesitan
El procesamiento determinista se ocupa de la mayor parte del libro. JEV selecciona rápidamente las páginas sospechosas. El LLM se encarga de los pocos casos que requieren un juicio semántico. Las restricciones programáticas protegen la estructura final. Las páginas reparadas vuelven al mismo ensamblado de capítulos y al mismo proceso de generación de Markdown o EPUB.
Todavía tengo que probar más idiomas, maquetaciones y libros más largos, sobre todo la tasa de errores no detectados por JEV y el umbral para la revisión con LLM. Pero la dirección está más clara que hace un año: no hace falta que un LLM lea todas las páginas para encontrar unos pocos errores escondidos en los márgenes.
Si vas a convertir un libro escaneado, empieza con una muestra corta que contenga notas en el espacio de trabajo de PDF Craft. Revisa las llamadas del cuerpo, el texto completo de las notas y los párrafos que cruzan saltos de página antes de lanzarte con el libro entero.
Usa la muestra para diseñar tu propia comprobación de la salida
La muestra anterior es una prueba de una sola ejecución de ingeniería, no una tasa de éxito para libros cualesquiera. Sugiere qué conviene inspeccionar cuando un libro convertido contiene muchas notas. Elige una página con varias llamadas, otra con referencias simbólicas y un punto en el que la nota o el párrafo del cuerpo continúe en la página siguiente.
Para cada punto seleccionado, compara la imagen de la página original con la salida. Localiza la llamada en el cuerpo, sigue su destino y confirma que la nota completa pertenece a ese pasaje. Vuelve al cuerpo y comprueba que la frase siguiente continúa con naturalidad. Un vínculo que funciona puede llevar igualmente a la nota equivocada.
Señala estas anomalías concretas:
- Una llamada sin destino, o texto de una nota sin la llamada correspondiente en el cuerpo.
- Dos notas distintas unidas en una, o una sola nota continuada dividida de forma incorrecta.
- Un número de página, un encabezado o un adorno insertado en una frase.
- Una nota asociada a la columna equivocada o a la página vecina.
- Un párrafo unido a través de un salto de página pese a una cita o un límite de sección.
Anota la página impresa, la página del visor de PDF, la llamada y una frase corta. La paginación del EPUB cambia con el tamaño de letra, así que el número de página del libro electrónico por sí solo no basta para localizar el problema más adelante.
Entender los límites de la revisión a nivel de página
Las fases de revisión y reparación descritas aquí son procesamiento interno, no un control de JEV a disposición de quien lo usa ni la promesa de que cada página convertida se haya revisado profesionalmente. Una página puede cumplir las restricciones estructurales y aun así contener un error de reconocimiento o una frase ambigua. A la inversa, enviar una página sospechosa a reparar no garantiza que todas las relaciones con las páginas vecinas sean correctas.
Para una lectura informal, céntrate en las estructuras difíciles y los pasajes importantes. Para una cita, una afirmación de investigación o una publicación, aplica la revisión más detallada que exija ese uso. Conserva el PDF original aunque el EPUB sea cómodo de leer.
El flujo de trabajo de OCR y traducción explica por qué el reconocimiento, la estructura y el significado requieren comprobaciones distintas. Si el artículo también se va a traducir, consulta cómo trabajar con un PDF de arXiv. Las tarifas de procesamiento actuales están en Precios; la muestra no demuestra un ahorro universal de tiempo ni de coste.