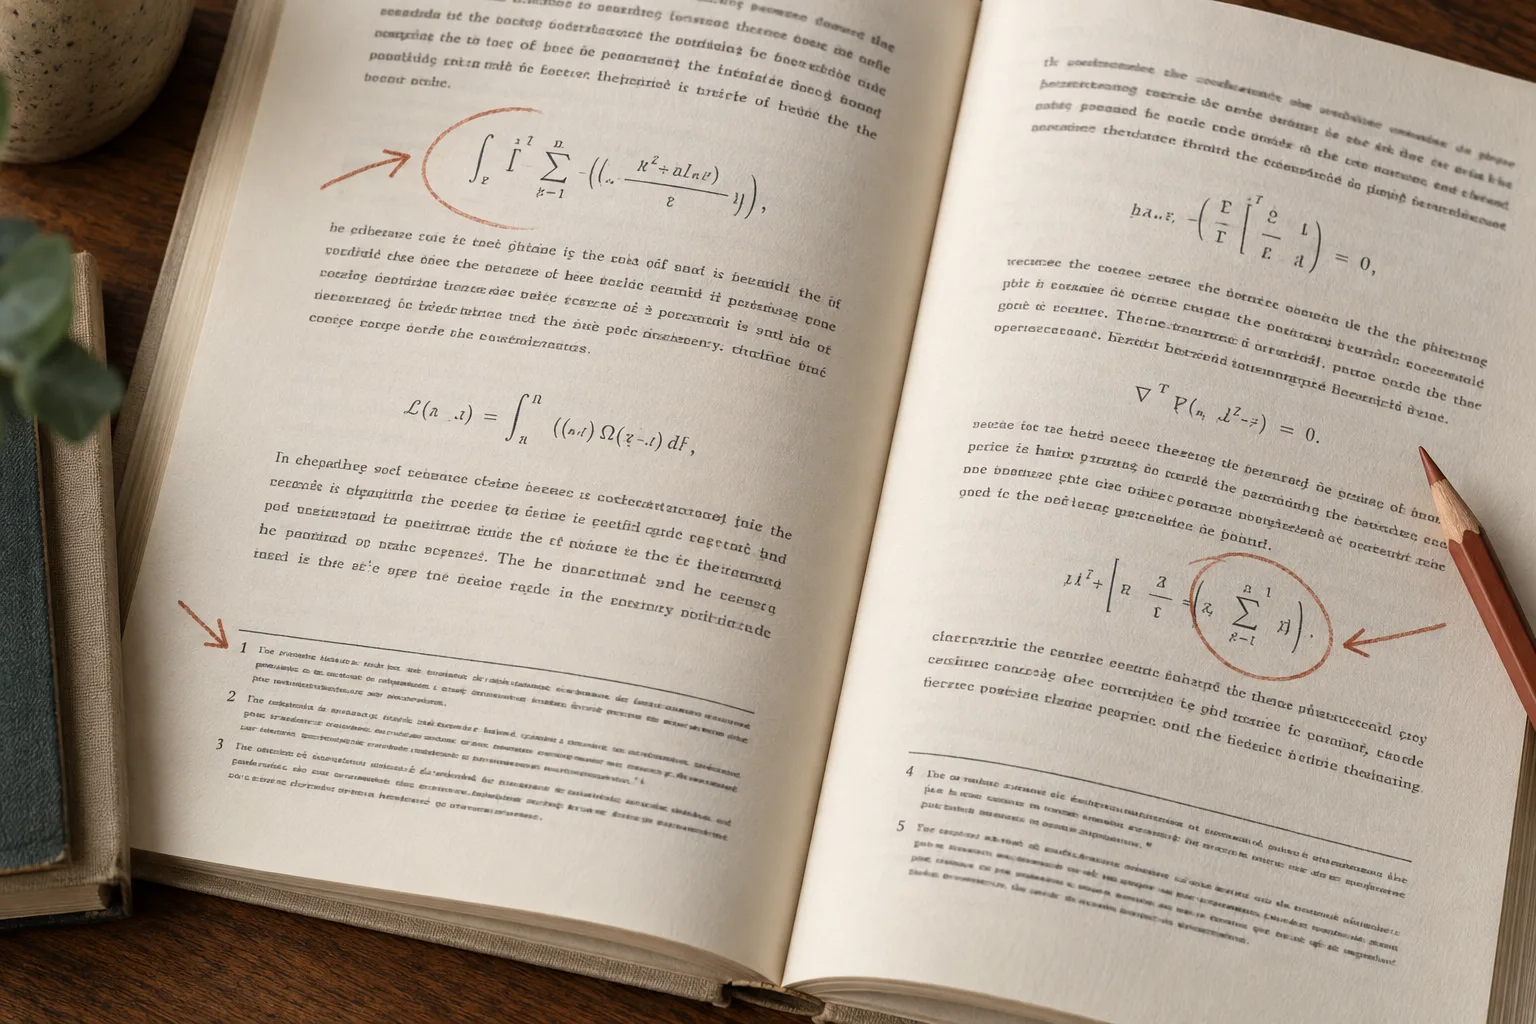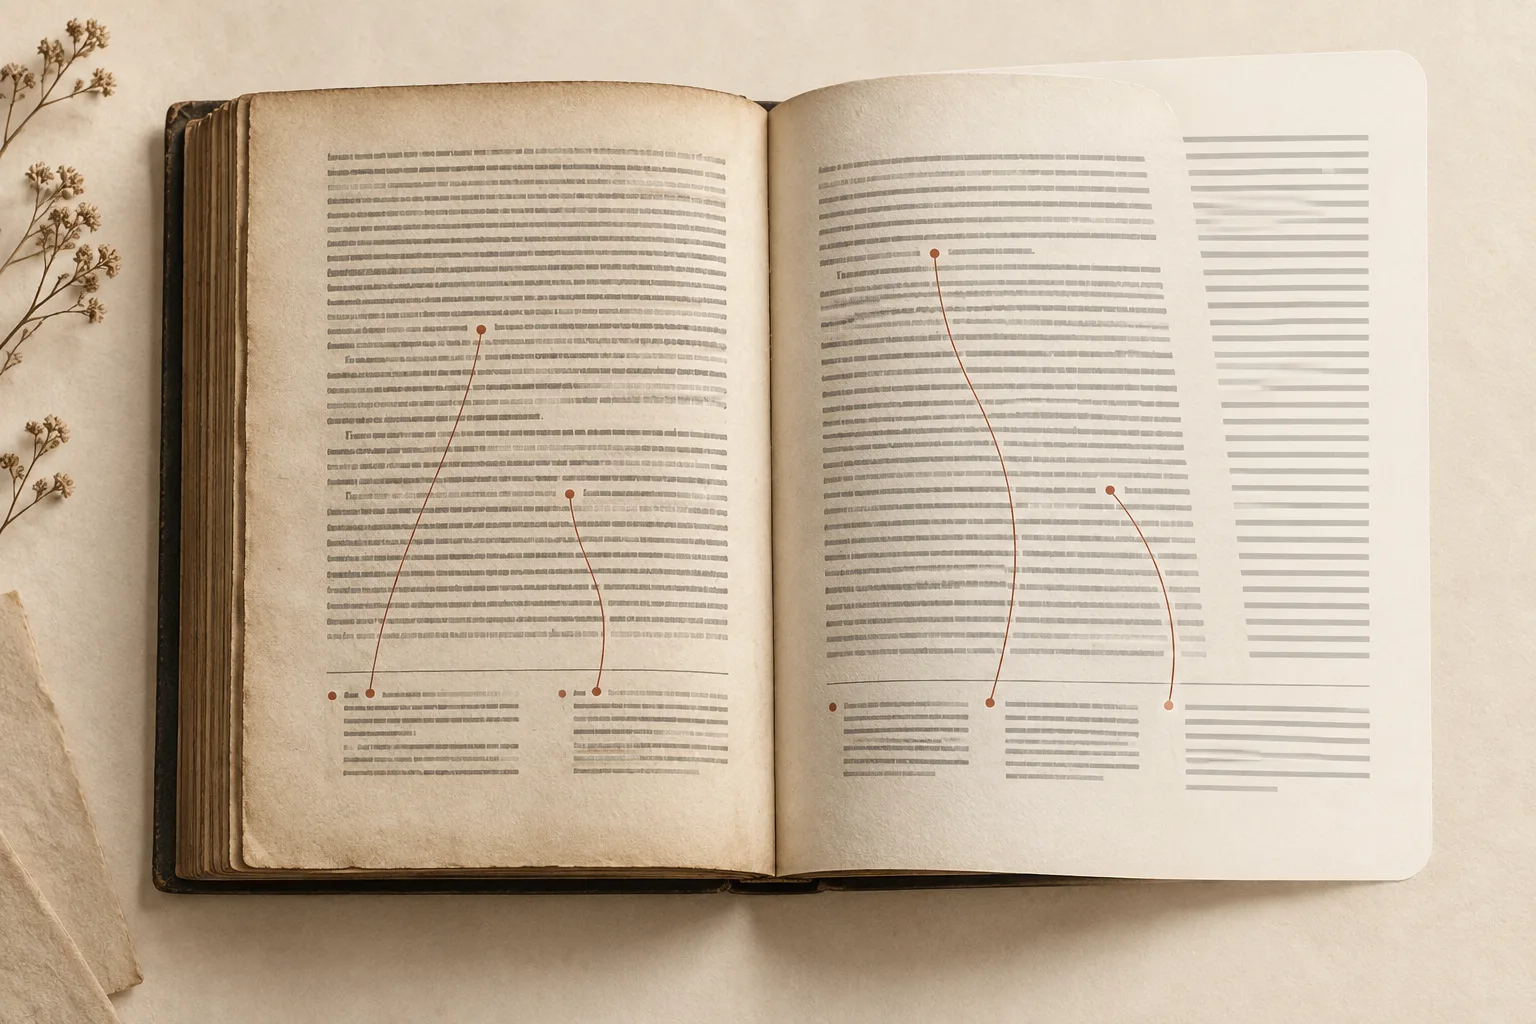
Ich habe PDF Craft entwickelt, um gescannte Buch-PDFs in Markdown oder EPUB umzuwandeln, die sich tatsächlich lesen, durchsuchen und ordnen lassen. Die Wörter zu erkennen ist nur ein Teil dieser Aufgabe. Eine Zahl, ein eingekreistes Symbol oder ein Sternchen im Text muss weiterhin zur richtigen Anmerkung am Fuß der Originalseite führen. Sonst wird der Text zwar neu umbrochen, aber eine wesentliche Beziehung beim Lesen geht verloren.
Das ist wichtig bei älteren Büchern, wissenschaftlichen Quellen oder einer eigenen Sammlung. Eine brauchbare Konvertierung sollte das Buch durchsuchbar und auf einem kleineren Bildschirm angenehm lesbar machen und dabei die Verweise intakt lassen. Eine praktische Prüfung der Ausgabedatei finden Sie im Leitfaden zum Umwandeln gescannter PDFs in EPUB und in der Checkliste für Formeln und Fußnoten.
OCR erkennt Zeichen, nicht ihre Rolle
OCR kann Wörter auf einer Seite identifizieren, ohne zu wissen, welche Funktion diese Wörter im Buch haben. Kleingedrucktes am unteren Rand kann eine Fußnote sein oder einfach Fließtext, der bis an den Rand reicht. Eine hochgestellte eingekreiste Zahl kann ein Verweiszeichen sein oder eine gewöhnliche Listennummer. Eine Anmerkung kann in zwei Blöcke aufgeteilt sein oder sich auf der nächsten Seite fortsetzen.
Eine falsche Entscheidung kann im EPUB seltsame Folgen haben: ein Verweiszeichen ohne Ziel, zwei zusammengeklebte Anmerkungen, eine Seitenzahl mitten im Satz oder das Ende einer Seite, das an die Kopfzeile der nächsten Seite anschließt. Fußnoten gehören seit Langem zu den schwierigsten Problemen von PDF Craft.
Erster Versuch: ein LLM liest jede Seite
Vor etwa einem Jahr lag die naheliegende Lösung darin, jede Seite einem großen Sprachmodell zu übergeben. Es erkannte oft, dass Kleingedrucktes den Haupttext erläuterte, deutete Sternchen oder römische Ziffern als Verweiszeichen und beurteilte, ob ein Satz über einen Seitenumbruch hinweg weiterlief.
Seite für Seite war das vielversprechend, über ein ganzes Buch hinweg jedoch mühsam. Hunderte Seiten bedeuteten Hunderte Aufrufe, Wartezeiten und mögliche Wiederholungen. Entscheidungen über Seitengrenzen hinweg brauchten den Kontext der Nachbarseiten, was die Eingabe weiter vergrößerte. Die meisten Seiten waren ohnehin schon korrekt: Das teure Modell verbrachte viel Zeit damit, eine Seite zu lesen und dann festzustellen, dass nichts geändert werden musste. Für Nutzer war außerdem schwer zu erkennen, ob ein langer Lauf vorankam oder hängen blieb.
Zuerst einen vollständigen deterministischen Weg aufbauen
Spätere Versionen verlagerten die Hauptarbeit zurück auf OCR und feste Regeln. Dieser Weg trennt Fließtext und Anmerkungen, fügt natürliche Absätze zusammen, zerlegt Anmerkungen in einzelne Belege und ordnet jedem Verweis im Text seine Anmerkung zu. Er ist schnell, wiederholbar und stabil und bewältigt die meisten Seiten gut.
Doch Buchlayouts sind unterschiedlich. Anmerkungen können am Seitenfuß oder zwischen Spalten stehen; Verweiszeichen können Ziffern oder Symbole sein; Kopfzeilen, Seitenzahlen und Zierelemente können in den erkannten Text geraten. Manche Entscheidungen erfordern zu verstehen, was ein Satz bedeutet. Regeln allein lassen einige schwierige Fälle offen, während ein LLM auf jeder Seite zu langsam und zu teuer ist.
Die Änderung: JEV prüft, statt neu zu bearbeiten
Die bestehende Verarbeitung musste nicht ersetzt werden. Sie brauchte eine schnelle Qualitätskontrolle, die Seiten markiert, die einen genaueren Blick verdienen. Dort habe ich JEV eingesetzt und ihm eine eng umrissene Frage gestellt: Kann die Analyse dieser Seite unverändert übernommen werden? Es schreibt keinen Text um und erklärt nicht jeden Beleg. Es liefert eine Wahrscheinlichkeit, anhand derer entschieden wird, ob die Seite weiterläuft oder zur Korrektur an ein LLM geht.
Die Einheit der Prüfung ist die ganze Seite. Wenn der Algorithmus eine Anmerkung vollständig übersieht, kann eine Kontrolle, die nur bereits erkannte Anmerkungen prüft, diesen Fehler nicht entdecken. Eine Bewertung auf Seitenebene kann trotzdem fehlende Verweise, falsche Zuordnungen, ungewöhnliche seitenübergreifende Verbindungen oder in den Text geratene Seitenzahlen erkennen. Lieber schicke ich ein paar Seiten zu viel zur Prüfung, als eine fehlerhafte stillschweigend durchzulassen: Ein Fehlalarm kostet eine weitere Modellprüfung; ein übersehener Fehler kann bis in das fertige EPUB gelangen. Der Schwellenwert muss noch breiter kalibriert werden.
flowchart TB
  accTitle: Von der Seitenprüfung zur begrenzten Korrektur
  accDescr: OCR und Regeln bearbeiten zuerst eine Seite. JEV entscheidet, ob sie unverändert übernommen werden kann. Verdächtige Seiten gehen an ein LLM, danach folgt eine programmatische Integritätsprüfung. Seiten, die die Prüfung bestanden haben, werden zu Kapiteln zusammengefügt; fehlgeschlagene Korrekturen werden wiederholt.
  A[OCR und Regeln] --> B{JEV: Seite vertrauenswürdig?}
  B -- Ja --> F[Kapitel montieren und ausgeben]
  B -- Nein --> C[LLM korrigiert nur die aktuelle Seite]
  C --> D{Integritätsprüfung}
  D -- Bestanden --> F
  D -- Wiederholen --> C
Das LLM korrigiert eine Seite innerhalb enger Grenzen
Für eine markierte Seite erhält das LLM die Textstruktur von drei aufeinanderfolgenden Seiten: vorherige, aktuelle und nächste. Ändern darf es nur die mittlere Seite. Die Nachbarseiten liefern den Kontext für Sätze, die über Seitengrenzen hinweg laufen. Seitenbilder schicke ich in dieser Phase nicht mit: OCR liefert bereits Text, Positionen und Layout, und die Aufgabe ist eine inhaltliche Korrektur, kein weiterer OCR-Durchlauf.
Das Modell darf Fließtext, Fußnoten und Seitenzahlen neu kennzeichnen, den Absatzfluss berichtigen und Verweiszeichen neu den Anmerkungen zuordnen. Es darf die Quelle nicht frei umschreiben oder die Seitenstruktur verändern. Anschließend verlangen programmatische Prüfungen geordnete Anmerkungsindizes, übereinstimmende Verweise und Anmerkungen, stimmige Verbindungen über Seitengrenzen hinweg sowie Verweispositionen, die sich im angegebenen Text eindeutig finden lassen. Scheitert eine Prüfung, erhält das Modell konkrete Fehler und kann ein vollständiges Ergebnis erneut einreichen. Weniger Wiederholungen sind nützlich, aber kein Grund, diese Prüfungen abzuschwächen.
Was der vorhandene 26-seitige Testlauf aus dem Ingenieurwesen zeigte
In einem Test-PDF mit 26 Seiten und vielen Anmerkungen wählte JEV 6 Seiten für das LLM aus. Alle sechs ersten Einreichungen bestanden die Integritätsprüfungen, und die 22 Zuordnungen zwischen Verweisen im Text und Anmerkungen, die bereits korrekt waren, blieben erhalten.
Die tatsächlichen Korrekturen waren überschaubar, aber wichtig: Gedruckte Seitenzahlen waren für Fließtext gehalten worden; eine Zahl war zu einer falschen Brücke zwischen Absätzen geworden; und ein Einleitungssatz war mit dem eingerückten Zitat darunter zusammengeführt worden. Das LLM nutzte Bedeutung und Einrückung, um beides zu trennen.
Dies ist eine Beobachtung an einem einzelnen Beispiel, keine Aussage über die Genauigkeit oder die Kosten des gesamten Dokuments. Die Lehre für mich war, dass eine gute Korrekturstufe korrekte Arbeit bewahren und aufhören sollte, sobald die durch Belege gestützten Probleme behoben sind.
Teure Urteile dort einsetzen, wo sie gebraucht werden
Die deterministische Verarbeitung bewältigt den größten Teil des Buchs. JEV wählt schnell verdächtige Seiten aus. Das LLM kümmert sich um die wenigen Fälle, die inhaltliches Urteilen erfordern. Programmatische Vorgaben sichern die endgültige Struktur. Korrigierte Seiten kehren in dieselbe Kapitelmontage und denselben Weg zur Markdown- oder EPUB-Ausgabe zurück.
Ich muss noch weitere Sprachen, Layouts und längere Bücher testen, insbesondere die Rate übersehener Fehler bei JEV und den Schwellenwert für die LLM-Prüfung. Doch die Richtung ist klarer als vor einem Jahr: Es ist nicht nötig, ein LLM jede Seite lesen zu lassen, um ein paar Fehler aufzuspüren, die sich am Rand verstecken.
Wenn Sie ein gescanntes Buch konvertieren, beginnen Sie im PDF-Craft-Arbeitsbereich mit einem kurzen Auszug, der Anmerkungen enthält. Prüfen Sie Verweiszeichen im Text, den vollständigen Anmerkungstext und Absätze über Seitenumbrüche hinweg, bevor Sie das ganze Buch konvertieren.
Nutzen Sie das Beispiel, um Ihre eigene Ausgabeprüfung zu planen
Dieses Praxismuster dokumentiert einen konkreten Durchlauf und bietet Anhaltspunkte für die Auswahl passender Prüfseiten. Beim Konvertieren anmerkungsreicher Bücher lohnt es sich, eine Seite mit mehreren Fußnotenzeichen, eine mit Sonderzeichen-Verweisen und eine Stelle herauszusuchen, an der Fußnote oder Fließtext auf der Folgeseite weiterlaufen. So sehen Sie direkt, wie diese Elemente in der fertigen Ausgabe ineinandergreifen.
Vergleichen Sie an jeder ausgewählten Stelle das Bild der Originalseite mit der Ausgabe. Suchen Sie das Verweiszeichen im Text, folgen Sie seinem Ziel und prüfen Sie, ob die vollständige Anmerkung zu dieser Passage gehört. Kehren Sie zum Text zurück und kontrollieren Sie, ob der nächste Satz natürlich anschließt. Ein funktionierender Link kann trotzdem zur falschen Anmerkung führen.
Achten Sie auf diese konkreten Auffälligkeiten:
- Ein Verweis ohne Ziel oder ein Anmerkungstext ohne zugehöriges Verweiszeichen im Text.
- Zwei getrennte Anmerkungen, die zu einer zusammengefügt wurden, oder eine einzelne fortlaufende Anmerkung, die falsch aufgeteilt wurde.
- Eine Seitenzahl, eine Kopfzeile oder ein Zierzeichen mitten in einem Satz.
- Eine Anmerkung, die an die falsche Spalte oder die benachbarte Seite gehängt wurde.
- Ein Absatz, der über einen Seitenumbruch hinweg zusammengefügt wurde, obwohl ein Zitat oder eine Abschnittsgrenze dazwischenliegt.
Notieren Sie die gedruckte Seite, die Seite im PDF-Betrachter, das Verweiszeichen und einen kurzen Satzausschnitt. Die Seitenzählung im EPUB ändert sich mit der Schriftgröße; eine Seitenzahl im E-Book allein reicht daher nicht, um das Problem später wiederzufinden.
Die Grenzen der Prüfung auf Seitenebene kennen
Die seitenweise Überprüfung dient vor allem dazu, strukturelle Unstimmigkeiten zwischen Anmerkungen und Fließtext aufzudecken. Achten Sie beim Durchsehen des Ergebnisses auch auf schwer lesbare Wörter sowie auf die Seitenübergänge: Schließt der Haupttext nahtlos an, sind alle Fußnoten vollständig und stehen die Verweise an der richtigen Stelle?
Für die alltägliche Lektüre konzentrieren Sie sich auf schwierige Strukturen und wichtige Passagen. Bei einem Zitat, einer wissenschaftlichen Aussage oder einer Veröffentlichung ist die genauere Prüfung nötig, die der jeweilige Zweck verlangt. Halten Sie das Quell-PDF verfügbar, auch wenn sich das EPUB bequem lesen lässt.
Unter OCR- und Übersetzungsworkflow erfahren Sie, worauf es bei Texterkennung, Dokumentstruktur und Semantik jeweils ankommt. Wenn das Paper zusätzlich übersetzt werden soll, bietet arXiv-PDFs übersetzen praktische Orientierung. Die aktuellen Bearbeitungspreise finden Sie unter Preise.