
antiSMASH 8.0 扫描微生物基因组里的生物合成基因簇,可识别类型从 81 种增至 101 种,酶学分析也更细。2025 年工具论文,免费阅读。
antiSMASH 8.0: extended gene cluster detection capabilities and analyses of chemistry, enzymology, and regulation
antiSMASH 8.0:扩展的基因簇检测能力以及对化学、酶学和调控的分析
Blin, K.; Shaw, S.; Vader, L.; Szenei, J.; Reitz, Z.L.; Augustijn, H.E.; ...; Weber, T.
引用
Blin, K., Shaw, S., Vader, L., Szenei, J., Reitz, Z. L., Augustijn, H. E., ... Weber, T. (2025). antiSMASH 8.0:扩展的基因簇检测能力以及对化学、酶学和调控的分析。Nucleic Acids Research, 53(W1), W32-W38. doi:10.1093/nar/gkaf334
版本:出版商版本 许可:Creative Commons CC BY 4.0 许可 下载自:https://hdl.handle.net/1887/4285886
注:引用本出版物时,请使用最终发表版本(如适用)。
antiSMASH 8.0:扩展的基因簇检测能力以及对化学、酶学和调控的分析
Kai Blin , Simon Shaw , Lisa Vader , Judit Szenei , Zachary L. Reitz , Hannah E. Augustijn , José D.D. Cédiel-Becerra , Valérie de Crécy-Lagard , Robert A. Koetsier , Sam E. Williams , Pablo Cruz-Morales , Sopida Wongwas , Alejandro E. Segurado Luchsinger , Friederike Biermann , Aleksandra Korenskaia , Mitja M. Zdouc , David Meijer , Barbara R. Terlouw , Justin J.J. van der Hooft , Nadine Ziemert , Eric J.N. Helfrich , Joleen Masschelein , Christophe Corre , Marc G. Chevrette , Gilles P. van Wezel , Marnix H. Medema , Tilmann Weber
\(^{*}\) 通讯作者。电子邮件:kblin@biosustain.dtu.dk 通信也可发送至 Marnix H. Medema。电子邮件:marnix.medema@wur.nl 通信也可发送至 Tilmann Weber。电子邮件:tiwe@biosustain.dtu.dk
摘要
微生物通过其次生代谢或特殊代谢合成小型生物活性化合物。这些化合物在微生物相互作用和土壤健康中发挥着重要作用,同时对药物或农用化学品的开发也至关重要。在过去几十年中,基因组测序的进步使得能够直接从微生物基因组中鉴定大量生物合成基因簇。自2011年问世以来,antiSMASH(https://antismash.secondarymetabolites.org/)已成为检测和表征细菌和真菌中这些基因簇的领先工具。本文介绍antiSMASH第8版,该版本将可检测的簇类型数量从81种增加到101种,并改进了对萜类化合物和修饰酶的分析支持,同时改进了对聚酮合酶和非核糖体肽合成酶等模块化酶的分析。这些修改使antiSMASH与该领域的发展保持同步,并扩展了其用于天然产物基因组挖掘的整体预测能力。
图形摘要
引言
微生物产生的小型生物活性分子是药物[1]和农用化学品[2]的重要来源,并在微生物相互作用和土壤健康中发挥重要作用。在过去20-25年中,可用基因组数据的丰富性使得传统工作流程得以增强——即分离微生物菌株、提取化合物,然后通过寻找微生物基因组中编码这些分子生物合成的生物合成基因簇(BGCs)来筛选所需活性[3]。用于在基因组中搜索这些产生次生/特殊代谢物的BGCs的软件工具已经存在了十多年[4-7]。
自2011年首次发布以来,antiSMASH [8-14]已成为该领域的领先工具。围绕antiSMASH,一个包含或依赖antiSMASH预测的广泛相关工具生态系统已经发展起来。示例包括基于抗性的挖掘工具ARTS [15]、质谱引导的Seq2PKS [16]、基因组工程工具StreptoCAD [17]、BGC网络和聚类工具BiG-SCAPE [18],以及配对组学分析工具NPLinker [19]。反过来,antiSMASH也可以整合来自其他工具的BGC预测[13]。最初为DeepBGC [20]构建,其他基于机器学习的工具如GECCO [21]也以所需格式提供其结果。antiSMASH的BGC预测还被用于许多基因组和BGC相关数据库,例如联合基因组研究所的次生代谢物协作实验室[22]、用于基因组注释和分析的MicroScope平台[23]、人工 curated BGCs的MIBiG数据库[24]、BGC家族数据库BiG-FAM [25]、化学多样性宏基因组数据库BGC Atlas [26]以及antiSMASH数据库[27]。此外,antiSMASH还是一些用于基因组数据大规模分析的系统化工作流程的一部分,例如BGCFlow [28]或欧洲食品安全局(EFSA)的MicroOrganisms Pipelines Service [29]。
在此,我们介绍antiSMASH第8版。此版本将可检测的生物合成途径类型数量从81种增加到101种,增加了萜类BGCs的分析模块,并提供了对修饰酶的深入分析。
此外,KnownClusterBlast和ClusterCompare数据集已更新以反映MIBiG第4版的数据,我们增加了对环状基因组中跨越复制起点的BGCs的适当支持,转录因子结合位点预测也扩展了来自CollecTF数据库[30]的数据集。在含有非核糖体肽合成酶(NRPSs)或I型聚酮合成酶(PKSs)的BGCs中,检测和分析了更多的生物合成结构域。
新功能和更新
BGC检测更新
antiSMASH使用人工 curated 规则来定义基因组区域中需要存在哪些生物合成功能才能定义为BGC。为了识别这些生物合成功能,antiSMASH利用了谱隐马尔可夫模型(pHMMs),并在较小程度上使用Python代码文件中指定的动态谱。pHMMs来源于公共数据集,如PFAM [31]、TIGRFAMS [32]、SMART [33]、BAGEL [34]、Yadav等人[35],或专门为antiSMASH使用而创建。antiSMASH 7包含81条此类BGC规则[14],此版本中该数量已增加到101条,同时一些现有规则得到了完善。由于生物合成酶的大量重叠,很难区分线性唑类肽和硫醚连接的环化硫肽。在当前antiSMASH数据库[27]中,约16%的硫肽和约29%的线性唑类肽BGC判定存在重叠,目前尚不清楚其余注释中有多少是正确的。为了解决这种不确定性并避免潜在混淆,两种类型BGCs的检测规则被合并为新的"含唑类RiPPs规则"。萜烯、霉菌孢素、NRPS非依赖性铁载体、反式-AT PKSs、NRPSs、NRPS样簇和脂肪酸的检测规则也已更新。此外,还添加了以下新规则:古菌核糖体合成和翻译后修饰肽(RiPPs)、atropeptides、硝基丙酸、含氧化偶氮化合物、多炔、脱氮嘌呤、多卤代吡咯、羟基托酚酮、氢氰酸、darobactins、异腈、细菌和真菌环二肽、三肽、高度还原型II型PKSs以及真菌NRPS样赖氨酸生物合成。
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
::
:
:
:
:
:
:
:
:
:
:
::
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
请提供需要翻译的源文本。
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
:
::antiSMASH 对 NRPS/PKS BGC 中编码的蛋白质结构域提供了详细分析。为了更全面地概述所存在的结构域,我们添加了铁载体相关 - 羟化酶和界面结构域的配置文件(详细讨论见 [37]),以及一个更通用的 -
为覆盖某些核心基因的连续区段与其他核心基因相距过远的情况,在规则定义中添加了一个新的“EXTENDS”条件,以确保所有核心基因都被正确标记。trans- AT PKS 规则利用这一点来确保所有包含模块的基因都能被正确检测到,即使单个反式作用酰基转移酶(AT)结构域相距很远。
萜类分析
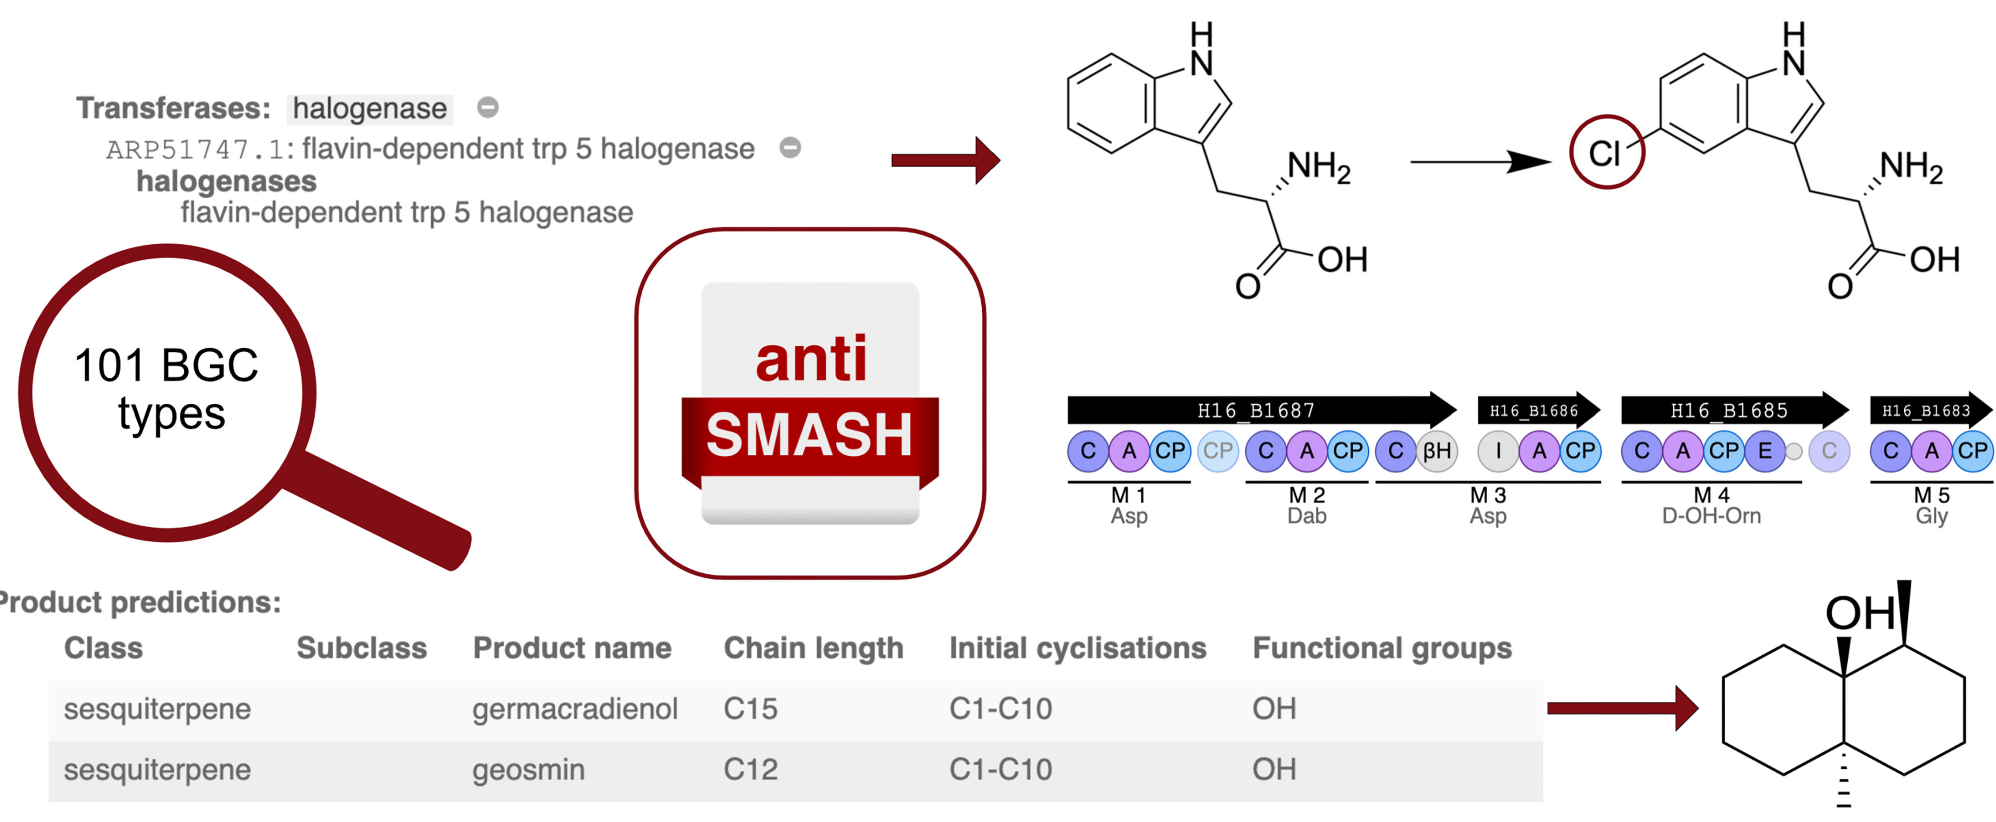
尽管 antiSMASH 自版本 1 [8] 起就一直在检测萜类基因簇,但一直缺少对萜类合酶/环化酶更详细的分析。antiSMASH 版本 4 [11] 添加了一个初步分析模块,但由于系统发育放置算法性能的限制以及可维护性方面的挑战,该模块在 antiSMASH 5 [12] 中再次被移除。在版本 8 中,我们看到了基于精心 curated 的 pHMM 的萜类分析的回归(见图 1A)。对于每个包含萜类 BGC 的区域,都会显示潜在产物类型的列表。每个预测都包括萜类类别(例如二萜、倍半萜等)和预测产物的链长度。对于研究更透彻的萜类合酶亚家族,预测还可以包含萜类亚类(例如吲哚二萜)、初始环化(例如 C1- C15)和产物名称。
基因功能分析
在去年 MIBiG 注释期间,社区大力推动更好地注释 MIBiG 条目中的修饰酶(描述见 [24]),在此期间我们注意到 antiSMASH 需要一个更用户友好的界面来访问修饰酶反应。利用在这些注释马拉松期间注释的 MITE 数据库(https://mite.bioinformatics. nl/)[36] 中的修饰酶集合,以及我们现有的 smCOG 注释,我们现在在一个专门的“修饰”选项卡中呈现修饰酶信息(见图 1B)。这也让我们有机会报告许多黄素依赖性卤化酶的底物特异性,这些信息也在本次发布中添加。使用自定义 pHMM 和保守基序特征,预测的详细程度从“卤化吡咯”到例如色氨酸卤化酶的区域选择性不等,具体取决于数据可用性。
在修饰选项卡中,修饰酶按酶委员会类别组织,即氧化还原酶、转移酶、水解酶、裂解酶、异构酶和连接酶。仅显示该区域中有命中的类别。点击加号图标可展开该类别,显示具有相关命中的基因以及尽可能详细的修饰功能预测的简短摘要。点击感兴趣基因的加号图标可展开 antiSMASH 提供的关于该修饰酶的所有信息。如果某个修饰酶与 MITE 数据库中的任何条目显示至少 的氨基酸序列同一性,则提供指向该 MITE 条目的交叉链接。
NRPS 和 PKS 改进
CoA- 连接酶(CAL)结构域通常参与脂肽 BGC 中脂肪酸衍生起始单元的加载,但此前在 antiSMASH 模块检测中未被视作起始模块。与上述 - 羟化酶和界面结构域一起,它们现在可以作为模块的一部分被检测到。
根据 [38] 中收集的信息,现在检查 NRPS 缩合(C)和差向异构化(E)结构域的活性位点是否存在催化残基,并在这些残基缺失时标记为无活性。为补充 antiSMASH 中已执行的 NRPS 腺苷酸化(A)结构域底物特异性预测,我们现在还提供指向外部 PARAS 底物特异性预测器的链接 [39],为研究人员提供更多分析选项。
其他更改
版本 8 中还包含许多其他较小的更改。显示最相似已知簇的概览页面视图已被简化,以解决一些用户困惑的来源。我们不再直接以“具有至少 序列相似性的基因百分比”显示簇相似性,而是以三个置信水平显示相似性:簇相似性大于或等于 为“高”,簇相似性在 和 之间为“中”,簇相似性在 和 之间为“低”。簇相似性 不再被认为足够相似,不再显示在概览中。Known ClusterBlast、ClusterCompare 和 CompaRiPPson 已更新至 MIBiG 4.0 发布版 [24] 提供的数据。ClusterBlast SVG 生成已移至 JavaScript 中,以减小文件大小并改善本地打开 antiSMASH 结果时的用户体验。历史上,antiSMASH 一直难以处理跨越环状基因组原点的 BGC。最好的情况下,这些 BGC 被分成两部分;最坏的情况下,原点两侧的一个或两个部分可能被完全遗漏。在 antiSMASH 8.0 中,我们彻底改造了环状基因组的坐标处理,使其能够被正确检测和报告。
历史上,antiSMASH 依赖 GlimmerHMM [40] 进行真菌基因调用,因为它能够在无需手动选择正确基因模型的情况下运行。不幸的是,随着越来越多真菌基因组变得可用,很明显这种基因模型选择对于高质量基因调用至关重要。由于我们无法轻易为上传的未知分类群基因组选择正确的基因模型,我们决定从 antiSMASH 中移除真菌基因调用功能。我们建议用户运行专用的基因调用工具如 AUGUSTUS [41],然后向 antiSMASH 提供基因注释。由于现代系统中的软件不兼容性,我们还弃用了对 MEME 工具套件的支持,特别是 MEME [42] 和 FIMO [43]。antiSMASH 独立版本的用户仍然可以自行提供这些二进制文件,但它们不再是我们提供的容器或 Web 服务的一部分。这实际上禁用了 CASSIS [44] 真菌 BGC 边界检测,并可能影响羊毛硫肽、sactipeptide、套索肽和含唑 RiPP 前体的 RODEO [45] 评分。
A
详细的萜类预测
| 用于理解原文的只读背景(非待翻译源文本):详细的萜类预测待翻译文本:产物预测: | |||||
| 类别 | 亚类 | 产物名称 | 链长 | 初始环化 | 官能团 |
| 倍半萜 | germacradienol | C15 | C1-C10 | OH | |
| 倍半萜 | geosmin | C12 | C1-C10 | OH |
具有萜类结构域的基因:
scO6073:T1TS + T1TS
结构域 1(0 - 326):1 型萜类合酶 亚型:土臭素合酶,N 端结构域 反应:FPP → 吉马烯二醇
结构域 2(326 - 695):1 型萜类合酶
亚型:土臭素合酶,C 端结构域 反应:吉马烯二醇 → 土臭素
B
修饰功能
氧化还原酶:加氧酶
oxyA:环化
oxyB:环化
oxyC:环化
oxyD:细胞色素 P450
转移酶:氨基转移酶 糖基转移酶 卤化酶 甲基转移酶
bgtFA:糖基化
bgtFB:糖基化
bgtFC:糖基化
bhaA:黄素依赖性酪氨酸样 hpg 卤化酶 卤化酶 黄素依赖性酪氨酸样 hpg 卤化酶
MITF
MITEO000028 卤化(同一性:100.00%) smcogs SMCOG1119:卤化酶
bmt:甲基化
dvaB:DegT/DnrJ/ErYC1/StrS 氨基转移酶
pgaT:氨基转移酶
水解酶:水解酶
bhp:α/β水解酶折叠蛋白
裂解酶:水合酶
dpgC:烯酰辅酶A水合酶
dpgD:烯酰辅酶A水合酶
连接酶:连接酶合成酶
结论与未来展望
结论与未来展望像antiSMASH这样的基因组挖掘技术是天然产物发现拼图中的重要一块。在过去的14年里,antiSMASH不断更新和改进,确保其始终处于天然产物基因组挖掘工具的前沿。从核心开发团队之外的众多贡献中可以看出,antiSMASH项目的开源与开放科学模式仍然卓有成效。它是一个重要的工具,许多其他更专业的工具、工作流程和数据库都依赖它。它目前是若干正在开发中的其他基因组挖掘工具的技术平台。在未来的更新中,我们将继续致力于新算法和分析模块的工作,以破译所检测簇的完整生物合成途径。我们将以本版本中修饰酶预测改进为基础,覆盖更多酶家族。同样,我们在调控因子和调控因子结合位点检测方面的工作也将继续。一如既往,我们还将整合生态系统中的新工具,或与之集成。
致谢
致谢作者贡献:Kai Blin(概念构思[主导],数据管理[主导],资金获取[同等],方法学[主导],项目管理[主导],软件[同等],监督[同等],撰写—原始草稿[主导],撰写—审阅与编辑[主导]),Simon Shaw(数据管理[同等],方法学[同等],软件[主导],可视化[主导]),Lisa Vader(数据管理[支持],软件[支持],可视化[支持]),Judit Szenei(数据管理[支持],软件[支持],可视化[支持]),Zachary L. Reitz(数据管理[支持],软件[支持]),Hannah E. Augustin(数据管理[支持],软件[支持]),José D.D. Cediel-Becerra(数据管理[支持],软件[支持]),Valérie de Crécy-Lagard(数据管理[支持]),Robert A. Koetsier(数据管理[支持],软件[支持]),Sam E. Williams(数据管理[支持]),Pablo Cruz-Morales(数据管理[支持]),Sopida Wongwas(数据管理[支持]),Alejandro E. Segurado Luchsinger(数据管理[支持]),Friederike Biermann(数据管理[支持]),Aleksandra Korenskaia(数据管理[支持]),Mitja M. Zdouc(数据管理[支持],撰写—原始草稿[支持]),David Meijer(数据管理[支持]),Barbara R. Terlouw(数据管理[支持]),Justin J.J. van der Hooft(资金获取[同等],撰写—原始草稿[支持]),Nadine Ziemert(资金获取[同等],监督[同等]),Eric J.N. Helfrich(资金获取[同等],监督[同等],撰写—原始草稿[支持]),Joleen Masschelein(数据管理[支持],资金获取[同等],监督[同等]),Christophe Corre(资金获取[同等],监督[同等]),Marc G. Chevrette(资金获取[同等],监督[同等]),Gilles P. van Wezel(资金获取[同等],监督[同等]),Marnix H. Medema(概念构思[支持],资金获取[同等],监督[同等],撰写—原始草稿[支持]),以及Tilmann Weber(概念构思[支持],资金获取[同等],监督[同等],验证[支持],撰写—原始草稿[支持])
利益冲突
J.J.vdH. 是意大利米兰 NAICONS Srl 科学顾问委员会的成员,并为美国印第安纳州印第安纳波利斯的 Corteva Agriscience 提供咨询。M.H.M. 是 Hexagon Bio 科学顾问委员会的成员。所有其他作者声明无利益冲突。
资助
资助来源:诺和诺德基金会 [NNF20CC0035580 授予 T.W.、K.B. 和 P.C.-M.,NNF22OC0079021 授予 S.E.W.];微生物次级代谢产物中心(CeMiSt),丹麦国家研究基金会 [DNRF137 授予 T.W.];欧盟“地平线欧洲”计划 MAGic-MOLFUN [MSC 101072485 授予 T.W.、K.B.、M.H.M.、N.Z.、A.K. 和 J.J.vdH.];欧盟“地平线2020”计划 MARBLES [101000392 授予 M.M.Z.、J.J.vdH.、M.H.M. 和 G.P.vW.];NWO [KICH1.LWV04.21.013 授予 M.M.Z.、J.J.vdH. 和 M.H.M.];欧盟 ERC Community [101055020 授予 G.P.vW.];NWO-XL [OCENW.XL21.XL21.088 授予 R.A.K.];美国国立卫生研究院 [RM1GM145426 授予 VdC.-L.];德国感染研究中心(DZIF)[TTU09.716 授予 N.Z.];欧盟“地平线2020”计划 DECIPHER [948770 授予 D.M. 和 M.H.M.];泰国皇家政府 [博士学位资助授予 S.W.];德国研究基金会 Emmy Noether 项目 [504947087 授予 E.J.N.H.],黑森州科学和艺术部 [LOEWE 转化生物多样性基因组学中心授予 E.J.N.H.];FWO [1008520N 和 G061821N 授予 J.M.]。本文开放获取出版费用的资助由欧盟“地平线欧洲”计划 MAGic-MOLFUN 提供。
数据可用性
antiSMASH 8.0 的细菌版本和真菌版本可分别从 https://antismash.secondarymetabolites.org 和 https://fungismash.secondarymetabolites.org 免费访问。
antiSMASH 文档可在 https://docs.antismash.secondarymetabolites.org/ 获取。
antiSMASH 源代码依据 GNU Affero 通用公共许可证(AGPL)3.0 版授权。antiSMASH 也可通过 Docker 获取。有关如何下载和安装 antiSMASH 的详细信息,请参阅文档网站。
参考文献
1. Newman DJ, Cragg GM. 天然产物作为新药来源:1981年1月至2019年9月近四十年间。BMC Genomics 2020;83:1138-43. https://doi.org/10.1021/acs.jnatprod.9b01285 2. Sparks TC, Bryant RJ. 天然产物对作物保护化合物发现与创新的影响。Pest Manag Sci 2022;78:399-408. https://doi.org/10.1002/ps.6653 3. Ziemert N, Alanjary M, Weber T. 微生物基因组挖掘的演化——综述。Nat Prod Rep 2016;33:988-1005. https://doi.org/10.1039/C6NP00025H 4. Weber T. 用于分析抗生素生物合成途径的计算机工具。Int J Med Microbiol 2014;304:230-5. https://doi.org/10.1016/j.ijmm.2014.02.001 5. Medema MH, Fischbach MA. 天然产物发现的的计算方法。Nat Chem Biol 2015;11:639-48. https://doi.org/10.1038/nchembio.1884 6. Weber T, Kim HU. 次级代谢物生物信息学门户:促进次级代谢物生产合成生物学的计算工具。Synth Syst Biotechnol 2016;1:69-79. https://doi.org/10.1016/j.synbio.2015.12.0027. Blin K, Kim HU, Medema MH 等. antiSMASH及其他用于挖掘次级代谢物生物合成基因簇的计算方法的最新进展。Brief Bioinform 2019;20:1103-13. https://doi.org/10.1093/bib/bbx1468. Medema MH, Blin K, Cimermancic P 等. antiSMASH:细菌和真菌基因组序列中次级代谢物生物合成基因簇的快速鉴定、注释和分析。Nucleic Acids Res 2011;39:W339-46. https://doi.org/10.1093/nar/gkr4669. Blin K, Medema MH, Kazempour D 等. antiSMASH 2.0——用于次级代谢物产生菌基因组挖掘的多功能平台。Nucleic Acids Res 2013;41:W204-12. https://doi.org/10.1093/nar/gkt44910. Weber T, Blin K, Duddela S 等. antiSMASH 3.0——生物合成基因簇基因组挖掘的综合资源。Nucleic Acids Res 2015;43:W237-43. https://doi.org/10.1093/nar/gkv43711. Blin K, Wolf T, Chevrette MG 等. antiSMASH 4.0——化学预测和基因簇边界识别的改进。Nucleic Acids Res 2017;45:W36-41. https://doi.org/10.1093/nar/gkx31912. Blin K, Shaw S, Steinke K 等. antiSMASH 5.0:次级代谢物基因组挖掘流程的更新。Nucleic Acids Res 2019;47:W81-7. https://doi.org/10.1093/nar/gkz31013. Blin K, Shaw S, Kloosterman AM 等. antiSMASH 6.0:改进簇检测和比较能力。Nucleic Acids Res 2021;49:W29-35. https://doi.org/10.1093/nar/gkab33514. Blin K, Shaw S, Augustijn HE 等. antiSMASH 7.0:检测、调控、化学结构和可视化方面的新改进预测。Nucleic Acids Res 2023;51:W46-50. https://doi.org/10.1093/nar/gkad34415. Mungan MD, Alanjary M, Blin K 等. ARTS 2.0:抗生素耐药靶标搜寻器用于比较基因组挖掘的功能更新和扩展。Nucleic Acids Res 2020;48:W546-52. https://doi.org/10.1093/nar/gkaa37416. Yan D, Zhou M, Adduri A 等. 通过计算质谱和基因组挖掘结合Seq2PKS发现I型顺式-AT聚酮化合物。Nat Commun 2024;15:5356. https://doi.org/10.1038/s41467-024-49587-117. Levasor L, Whitford CM, Petersen SD 等. StreptoCAD:一个自动化链霉菌基因组工程工作流程的开源软件工具箱。bioRxiv, https://doi.org/10.1101/2024.12.19.629370, 2024年12月20日,预印本:未经同行评审。18. Navarro-Munoz JC, Selem-Mojica N, Mullowney MW 等. 探索大规模生物合成多样性的计算框架。Nat Chem Biol 2020;16:60-8. https://doi.org/10.1038/s41589-019-0400-919. Eldjarn GH, Ramsay A, Hooft JJJvd 等. 在NPLinker框架中使用互补评分函数对微生物代谢组学和基因组学关联进行排序。PLOS Comput Biol 2021;17:e1008920. https://doi.org/10.1371/journal.pcbi.100892020. Hannigan GD, Prihoda D, Palicka A 等. 一种用于生物合成基因簇预测的深度学习基因组挖掘策略。Nucleic Acids Res 2019;47:e110. https://doi.org/10.1093/nar/gkz65421. Carroll LM, Larralde M, Fleck JS 等. 使用GECCO准确从头鉴定生物合成基因簇。bioRxiv, https://doi.org/10.1101/2021.05.03.442509, 2021年5月4日,预印本:未经同行评审。22. Udwary DW, Doering DT, Foster B 等. 次级代谢协作平台:次级代谢物生物合成基因簇的数据库和网络讨论门户。Nucleic Acids Res 2025;53:D717-23. https://doi.org/10.1093/nar/gkae106023. Vallenet D, Calteau A, Dubois M 等. MicroScope:通过基因组学、泛基因组学和代谢[研究]对微生物基因功能进行注释和探索的集成平台比较分析。《核酸研究》2020;48:D579-89. https://doi.org/10.1093/nar/gkz92624. Zdouc MM, Blin K, Louwen NLL等。MIBiG 4.0:通过全球合作推进生物合成基因簇的整理。《核酸研究》2025;53:D678-90. https://doi.org/10.1093/nar/gkae111525. Kautsar SA, Blin K, Shaw S等。BiG-FAM:生物合成基因簇家族数据库。《核酸研究》2021;49:D490-7. https://doi.org/10.1093/nar/gkaa81226. Bagci C, Nuhamunada M, Goyat H等。BGC Atlas:用于探索细菌基因组中编码的全球化学多样性的网络资源。《核酸研究》2025;53:D618-24. https://doi.org/10.1093/nar/gkae95327. Blin K, Shaw S, Medema MH等。antiSMASH数据库第4版:更多基因组和BGC、新的基于序列的搜索及更多功能。《核酸研究》2024;52:D586-9. https://doi.org/10.1093/nar/gkad98428. Nuhamunada M, Mohite OS, Phaneuf PV等。BGCFlow:用于分析大型基因组数据集中生物合成基因簇的系统性泛基因组工作流程。《核酸研究》2024;52:5478-95. https://doi.org/10.1093/nar/gkae31429. Yolanda GC。微生物流程服务(MOPS):流程文档。技术报告。30. Kilu S, White ER, Sagitova DM等。CollecTF:经实验验证的细菌转录因子结合位点数据库。《核酸研究》2014;42:D156-6030. https://doi.org/10.1093/nar/gkt112331. Mistry J, Chugarunsky S, Williams L等。Pfam:2021年蛋白质家族数据库。《核酸研究》2021;49:D412-9. https://doi.org/10.1093/nar/gkaa91332. Haft DH, Selengut JD, Richter RA等。2013年的TIGRFAMs和基因组特性。《核酸研究》2013;41:D387-953. https://doi.org/10.1093/nar/gks123433. Letunic I, Khedkar S, Bork P。SMART:2020年的最新更新、新进展和现状。《核酸研究》2021;49:D458-60. https://doi.org/10.1093/nar/gkaa93734. van Heel AJ, de Jong A, Song C等。BAGEL4:一个用户友好的网络服务器,用于深入挖掘RiPP和细菌素。《核酸研究》2018;46:W278-81. https://doi.org/10.1093/nar/gky38335. Yadav G, Gokhale RS, Mohanty D。走向聚酮合酶代谢产物的预测:一项计算机分析。《PLOS计算生物学》2009;5:e1000351. https://doi.org/10.1371/journal.pcbi.100035136. Zdouc MM, Meijer D, Biermann F等。关于捕获天然产物生物合成的修饰酶/突变酶数据标准的最低信息要求。ChemRxiv,https://doi.org/10.26434/chemrxiv-2024-78mtl,2024年4月9日,预印本:未经同行评审。37. Reitz ZL, Hardy CD, Suk J等。铁载体-羟化酶的基因组分析揭示了发散的立体控制并扩展了缩合结构域家族。《美国国家科学院院刊》2019;116:19805-14. https://doi.org/10.1073/pnas.190316111628. Bloudoff K, Schmeng TM。非核糖体肽合成酶缩合结构域超家族的结构和功能方面:发现、剖析和多样性。《生物化学与生物物理学报:蛋白质与蛋白质组学》2017;1865:1587-604. https://doi.org/10.1016/j.bbapap.2017.05.01039. Terlouw BR, Huang C, Meijer D等。PARAS:非核糖体肽合成酶底物特异性的高精度机器学习。bioRxiv,https://doi.org/10.1101/2025.01.08.631717,2025年1月10日,预印本:未经同行评审。40. Majoros WH, Pertea M, Salzberg SL。TigrScan和GlimmerHMM:两种开源从头真核基因查找器。《生物信息学》2004;20:2878-9. https://doi.org/10.1093/bioinformatics/bth31541. Stanke M, Morgenstern B。AUGUSTUS:一个允许用户定义约束的真核生物基因预测网络服务器。《核酸研究》2005;33:W465-7. https://doi.org/10.1093/nar/gk14858 42. Bailey TL, Elkan C。通过期望最大化拟合混合模型以发现生物聚合物中的基序。《国际智能系统与分子生物学会议论文集》1994;2:28-36. 43. Grant CE, Bailey TL, Noble WS。FIMO:扫描给定基序的出现位置。《生物信息学》2011;27:1017-8. https://doi.org/10.1093/bioinformatics/btr064 44. Wolf T, Shelest V, Nath N等。CASSIS和SMIPS:真核基因组中次级代谢基因簇的基于启动子的预测。《生物信息学》2016;32:1138-43. https://doi.org/10.1093/bioinformatics/btv713 45. Walker MC, Eslami SM, Hetrick KJ等。针对前体肽靶向挖掘超过十万个基因组扩展了羊毛硫肽天然产物家族。《BMC基因组学》2020;21:387. https://doi.org/10.1186/s12864-020-06785-7