
让注意力本身变稀疏且可端到端训练,64k 上下文下省掉大部分算力而精度不掉。2025 年 ACL 最佳论文,免费阅读。
Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
原生稀疏注意力:硬件对齐且可原生训练的稀疏注意力
Jingyang Yuan , Huazuo Gao , Damai Dai , Junyu Luo , Liang Zhao , Zhengyan Zhang , Zhenda Xie , Y. X. Wei , Lean Wang , Zhiping Xiao , Yuqing Wang , Chong Ruan , Ming Zhang , Wenfeng Liang , Wangding Zeng
DeepSeek-AI 北京大学计算机学院多媒体信息处理重点实验室,PKU-Anker LLM Lab 华盛顿大学 {yuanjy, mzhang_cs}@pku.edu.cn, {zengwangding, wenfeng.liang}@deepseek.com
摘要
长上下文建模对于下一代语言模型至关重要,然而标准注意力机制的高计算成本带来了显著的计算挑战。稀疏注意力为提高效率同时保持模型能力提供了一个有前景的方向。我们提出 NSA,一种可原生训练的稀疏注意力机制,它将算法创新与硬件对齐的优化相结合,以实现高效的长上下文建模。NSA 采用动态分层稀疏策略,将粗粒度 token 压缩与细粒度 token 选择相结合,以同时保持全局上下文感知和局部精度。我们的方法通过两项关键创新推进了稀疏注意力设计:(1) 我们通过算术强度均衡的算法设计,并结合面向现代硬件的实现优化,实现了显著加速。(2) 我们实现了端到端训练,在不牺牲模型性能的情况下减少预训练计算量。如图[1]所示,实验表明,使用 NSA 预训练的模型在通用基准、长上下文任务和基于指令的推理上保持或超过了全注意力模型。同时,在 64k 长度序列上,NSA 在解码、前向传播和反向传播中相较全注意力实现了显著加速,验证了其在整个模型生命周期中的效率。
1. 引言
研究界日益认识到长上下文建模是下一代大型语言模型的一项关键能力,这由从深度推理(DeepSeek-AI, 2025; Zelikman et al., 2022)、仓库级代码生成(Zhang et al., 2023a; Zhang et al.)到多轮自主智能体系统(Park et al., 2023)等多种现实应用所驱动。近期突破,包括 OpenAI 的 o 系列模型、DeepSeek-R1(DeepSeek-AI, 2025)和 Gemini 1.5 Pro(Google et al., 2024),使模型能够处理整个代码库、冗长文档,在数千个 token 上保持连贯的多轮对话,并跨长距离依赖执行复杂推理。然而,随着序列长度增加,普通注意力(Vaswani et al., 2017)机制的高复杂度(Zaheer et al., 2020)成为关键
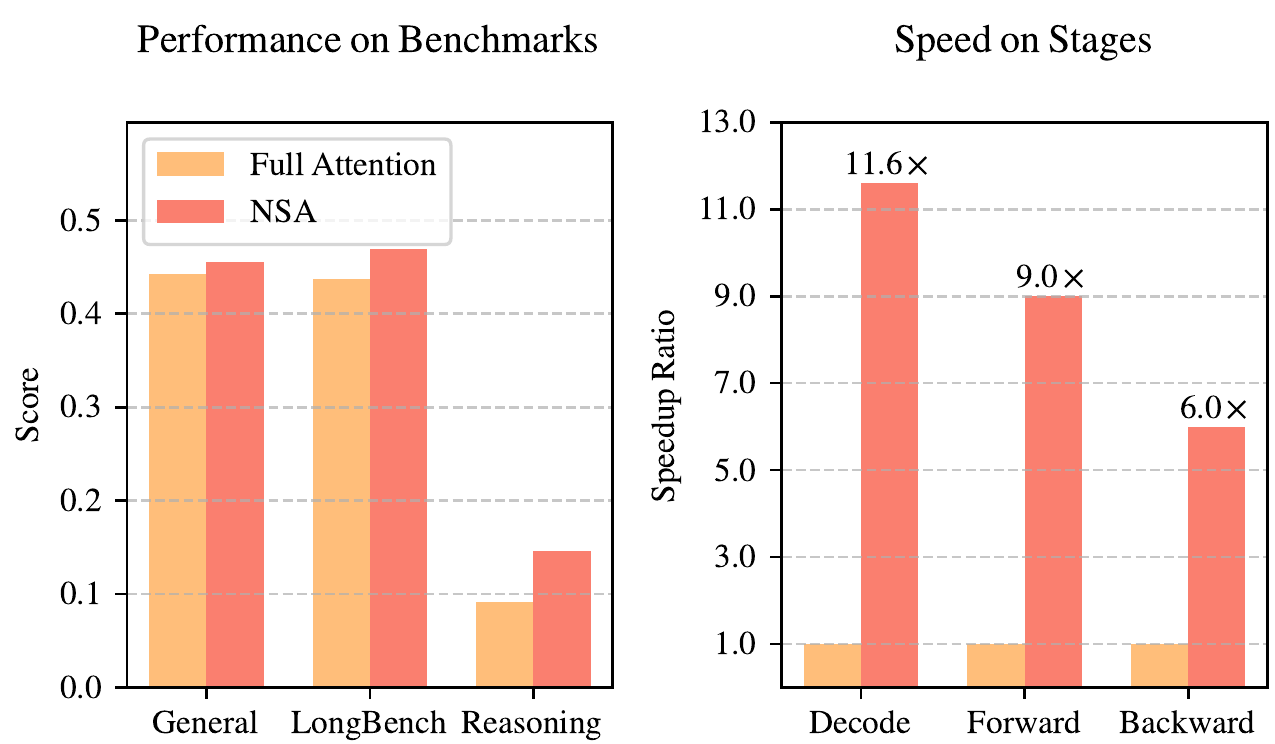
图 1 | 全注意力模型与我们的 NSA 在性能和效率上的比较。左:尽管是稀疏的,NSA 在通用基准、长上下文任务和推理评估的平均表现上超过了全注意力基线。右:对于 64k 长度序列处理,NSA 在所有阶段——解码、前向传播和反向传播——相较全注意力实现了显著的计算加速。 理论估计表明,在解码 64k 长度上下文时,采用 softmax 架构的注意力计算占总延迟的 ,这凸显了对更高效注意力机制的迫切需求。
实现高效长上下文建模的一种自然方法是利用 softmax 注意力的内在稀疏性(Ge et al., 2023; Jiang et al., 2023),其中选择性计算关键的查询-键对可以在保持性能的同时显著降低计算开销。近期进展通过多种策略展示了这一潜力:KV 缓存驱逐方法(Li et al., 2024; Zhang et al., 2023b; Zhou et al., 2024)、块级 KV 缓存选择方法(Gao et al., 2024; Tang et al., 2024; Xiao et al., 2024a),以及基于采样、聚类或哈希的选择方法(Chen et al., 2024b; Desai et al., 2024; Liu et al., 2024)。尽管这些策略很有前景,现有稀疏注意力方法在实际部署中往往表现不足。许多方法未能实现与其理论收益相当的加速;此外,大多数方法缺乏有效的训练时支持,无法充分利用注意力的稀疏模式。
为解决这些局限,部署有效的稀疏注意力必须应对两个关键挑战:(1) 硬件对齐的推理加速:将理论计算减少转化为实际速度提升,需要在预填充和解码阶段进行硬件友好的算法设计,以缓解内存访问和硬件调度瓶颈;(2) 训练感知的算法设计:使用可训练算子实现端到端计算,以在保持模型性能的同时降低训练成本。这些要求对于实际应用实现快速长上下文推理或训练至关重要。综合考虑这两个方面,现有方法仍存在明显差距。
为实现更有效且高效的稀疏注意力,我们提出 NSA,一种集成分层 token 建模的可原生训练稀疏注意力架构。如图 2 所示,NSA 通过将键和值组织为时间块,并通过三条注意力路径处理它们来减少每个查询的计算量:压缩的粗粒度 token、选择性保留的细粒度 token,以及用于局部上下文信息的滑动窗口。然后
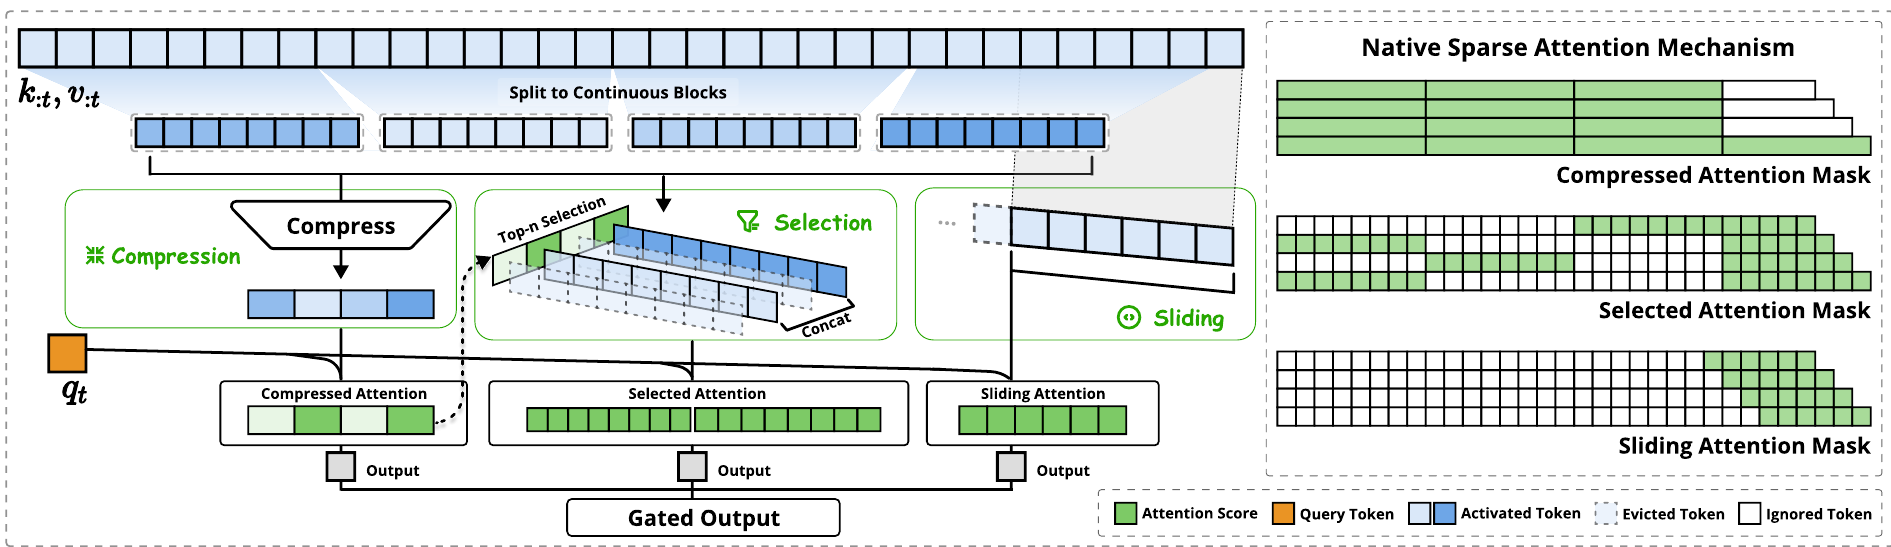
我们实现专用内核以最大化其实际效率。NSA 引入了与上述关键要求相对应的两项核心创新:(1) 硬件对齐系统:针对 Tensor Core 利用率和内存访问优化块级稀疏注意力,确保算术强度均衡。(2) 训练感知设计:通过高效算法和反向算子实现稳定的端到端训练。这一优化使 NSA 能够同时支持高效部署和端到端训练。
我们通过对真实语言语料库的全面实验评估 NSA。在具有 260B token 的 27B 参数 transformer 骨干上进行预训练,我们评估 NSA 在通用语言评估、长上下文评估和思维链推理评估中的性能。我们进一步比较了在 A100 GPU 上使用优化 Triton(Tillet et al., 2019)实现的内核速度。实验结果表明,NSA 实现了与全注意力基线相当或更优的性能,同时超过了现有稀疏注意力方法。此外,NSA 在解码、前向和反向阶段相较全注意力实现了显著加速,且加速比随序列变长而增加。这些结果验证了我们的分层稀疏注意力设计有效平衡了模型能力和计算效率。
2. 重新思考稀疏注意力方法
现代稀疏注意力方法在降低 transformer 模型的理论计算复杂度方面取得了重大进展。然而,大多数方法主要在推理期间应用稀疏性,同时保留预训练的全注意力骨干,这可能引入架构偏差,限制其充分利用稀疏注意力优势的能力。在介绍我们的原生稀疏架构之前,我们通过两个关键视角系统分析这些局限性。
2.1. 高效推理的幻象
尽管在注意力计算中实现了稀疏性,许多方法未能实现推理延迟的相应降低,主要由于两个挑战:
阶段受限的稀疏性。诸如 H2O(Zhang et al., 2023b)之类的方法在自回归解码期间应用稀疏性,但在预填充期间需要计算密集型预处理(例如注意力图计算、索引构建)。相反,MInference(Jiang et al., 2024)等方法仅关注预填充稀疏性。这些方法无法在所有推理阶段实现加速,因为至少一个阶段的计算成本仍与全注意力相当。阶段专门化降低了这些方法在以预填充为主的工作负载(如书籍摘要和代码补全)或以解码为主的工作负载(如长思维链(Wei et al., 2022)推理)中的加速能力。
与先进注意力架构的不兼容性。一些稀疏注意力方法无法适应现代高效解码架构,如多查询注意力(MQA)(Shazeer, 2019)和分组查询注意力(GQA)(Ainslie et al., 2023),这些架构通过跨多个查询头共享 KV 显著降低了解码期间的内存访问瓶颈。例如,在 Quest(Tang et al., 2024)之类的方法中,每个注意力头独立选择其 KV 缓存子集。尽管它在多头注意力(MHA)模型中表现出计算稀疏性和内存访问稀疏性的一致性,但在基于 GQA 之类架构的模型中呈现出不同情况,其中 KV 缓存的内存访问量对应于同一 GQA 组内所有查询头选择的并集。这种架构特性意味着,虽然这些方法可以减少计算操作,但所需的 KV 缓存内存访问量仍然相对较高。这一限制迫使做出关键选择:虽然一些稀疏注意力方法减少了计算,但其分散的内存访问模式与先进架构的高效内存访问设计相冲突。
这些局限的出现是因为许多现有稀疏注意力方法关注 KV 缓存减少或理论计算减少,但在先进框架或后端中难以实现显著延迟降低。这促使我们开发结合先进架构和硬件高效实现的算法,以充分利用稀疏性提高模型效率。
2.2. 可训练稀疏性的迷思
我们追求原生可训练稀疏注意力的动机,源于对仅推理方法进行分析时得到的两点关键认识:(1) 性能退化:事后施加稀疏性会迫使模型偏离其预训练的优化轨迹。正如 Chen 等人(2024b)所展示的,前 的注意力只能覆盖总注意力分数的 ,使得预训练模型中的检索头等结构在推理过程中容易被剪枝。(2) 训练效率需求:高效处理长序列训练对于现代 LLM 开发至关重要。这既包括在更长文档上进行预训练以增强模型能力,也包括后续的适配阶段,如长上下文微调和强化学习。然而,现有的稀疏注意力方法主要面向推理,训练中的计算挑战在很大程度上仍未得到解决。这一局限阻碍了通过高效训练开发能力更强的长上下文模型。此外,将现有稀疏注意力适配用于训练的尝试也暴露出一些挑战:
不可训练组件。ClusterKV(Liu 等人,2024)中的离散操作(包括 k-means 聚类)和 MagicPIG(Chen 等人,2024b)中的离散操作(包括基于 SimHash 的选择)会在计算图中造成不连续。这些不可训练组件阻止了梯度通过 token 选择过程流动,限制了模型学习最优稀疏模式的能力。
低效的反向传播。一些理论上可训练的稀疏注意力方法在实际训练中存在效率低下的问题。HashAttention(Desai 等人,2024)等方法采用的 token 粒度选择策略导致在注意力计算期间需要从 KV 缓存中加载大量单独的 token。这种非连续内存访问阻碍了 FlashAttention 等快速注意力技术的有效适配,因为这些技术依赖连续内存访问和分块计算来实现高吞吐量。结果,实现被迫退回到低硬件利用率,显著降低了训练效率。
2.3. 原生稀疏性势在必行
推理效率和训练可行性方面的这些局限,促使我们对稀疏注意力机制进行根本性重新设计。我们提出 NSA,一个原生稀疏注意力框架,同时解决计算效率和训练需求。在以下各节中,我们详细介绍 NSA 的算法设计和算子实现。
3. 方法
我们的技术方法涵盖算法设计与内核优化。在以下小节中,我们首先介绍方法的背景。然后给出NSA的整体框架,随后介绍其关键算法组件。最后,我们详述为实现实际效率最大化而进行的硬件优化内核设计。
3.1. 背景
注意力机制被广泛应用于语言建模中,其中每个查询token 针对所有前序键 计算相关性分数,以生成值的加权和 。形式化地,对于长度为 的输入序列,注意力操作定义为:
其中Attn表示注意力函数:
这里, 表示 与 之间的注意力权重, 是键的特征维度。随着序列长度增加,注意力计算在整体计算成本中日益占据主导地位,给长上下文处理带来了重大挑战。
算术强度是计算操作与内存访问之比。它从根本上决定了硬件上的算法优化方式。每个GPU都有一个由其峰值计算能力和内存带宽决定的临界算术强度,计算为这两个硬件上限的比值。对于计算任务,算术强度高于该临界阈值时变为计算受限(受GPU FLOPS限制),低于该阈值时变为内存受限(受内存带宽限制)。
具体对于因果自注意力机制,在训练和分析阶段,批量矩阵乘法和注意力计算表现出高算术强度,使得这些阶段在现代加速器上为计算受限。相比之下,自回归解码则受内存带宽约束,因为它在每次前向传递中生成一个token,同时需要加载整个键值缓存,导致算术强度较低。这导致了不同的优化目标——在训练和预填充期间降低计算成本,而在解码期间降低内存访问。
3.2. 整体框架
为了利用具有自然稀疏模式的注意力的潜力,我们提出对于每个查询 ,将公式(1)中的原始键值对 替换为一组更紧凑、信息更密集的表示键值对 。具体而言,我们将优化后的注意力输出形式化定义如下:
其中 基于当前查询 和上下文记忆 动态构建。我们可以设计各种映射策略来得到不同类别的 ,并将它们组合如下:
如图2所示,NSA有三种映射策略 ,分别表示对键和值的压缩、选择和滑动窗口。 是相应策略 的门控分数,由输入特征通过MLP和sigmoid激活得到。令 表示重映射后的键/值总数:
我们通过确保 来维持高稀疏率。
3.3. 算法设计
在本小节中,我们介绍重映射策略 和 的设计:token压缩、token选择和滑动窗口。
3.3.1. Token压缩
通过将连续的键或值块聚合为块级表示,我们获得能够捕获整个块信息的压缩键和值。形式化地,压缩键表示定义为:
其中 是块长度, 是相邻块之间的滑动步长, 是带有块内位置编码的可学习MLP,用于将块中的键映射为单个压缩键。 是由压缩键组成的张量。通常,我们采用 来缓解信息碎片化。压缩值表示 也有类似的公式。压缩表示捕获了更粗粒度的高层语义信息,并降低了注意力的计算负担。
3.3.2. Token选择
仅使用压缩键和值可能会丢失重要的细粒度信息,这促使我们有选择地保留单个键和值。下面我们描述高效token选择机制,该机制以低计算开销识别并保留最相关的token。
分块选择。我们的选择策略在空间连续的块中处理键和值序列,这源于两个关键因素:硬件效率考虑和注意力分数的固有分布模式。分块选择对于在现代GPU上实现高效计算至关重要。这是因为现代GPU架构对于连续块访问的吞吐量显著高于基于随机索引的读取。此外,分块计算能够最优地利用Tensor Core。这一架构特性已将分块内存访问和计算确立为高性能注意力实现的基本原则,正如FlashAttention基于块的设计所示。分块选择遵循注意力分数的固有分布模式。先前工作(Jiang et al., 2024)表明,注意力分数通常表现出空间连续性,这表明相邻键往往具有相似的重要性水平。我们在第6.2节的可视化也展示了这种空间连续模式。
为实现分块选择,我们首先将键、值序列划分为选择块。为了识别用于注意力计算的最重要块,我们需要为每个块分配重要性分数。下面我们介绍计算这些块级重要性分数的方法。
重要性分数计算。计算块重要性分数可能引入显著开销。幸运的是,压缩token的注意力计算产生了中间注意力分数,我们可以利用它们来推导选择块的重要性分数,公式如下:
其中 是 与压缩键 之间的注意力分数。令 表示选择块大小。当压缩块和选择块采用相同的分块方案,即 时,我们可以直接得到选择块的重要性分数 ,即 。对于分块方案不同的情况,我们根据选择块的空间关系推导其重要性分数。给定 、 且 ,我们有:
其中 表示用于访问向量元素的索引运算符。对于采用 GQA 或 MQA 且键值缓存在查询头之间共享的模型,必须确保这些头之间进行一致的块选择,以最小化解码期间的 KV 缓存加载。组内各头之间共享的重要性分数形式化定义为:
其中上标中的 表示头索引, 是每组中查询头的数量。这种聚合确保了同一组内各头之间一致的块选择。
Top-n 块选择。在获得选择块重要性分数之后,我们保留按块重要性分数排名位于前 n 个稀疏块内的 token,公式化为:
其中 rank 表示按降序排列的排名位置,rank 对应最高分数, 是所选块的索引集合,Cat 表示拼接操作。 是由压缩键组成的张量。类似的公式也适用于细粒度的值 。然后,选定的键和值与 一起参与如公式 (5) 所定义的注意力计算。
3.3.3. 滑动窗口
在注意力机制中,局部模式通常适应得更快,并可能主导学习过程,从而可能阻碍模型有效地从压缩和选择标记中学习。为解决这一问题,我们引入了一个专门的滑动窗口分支来显式处理局部上下文,使其他分支(压缩和选择)能够专注于学习各自的特征,而不会被局部模式捷径化。具体而言,我们在窗口 中维护最近的标记 ,并将不同信息源(压缩标记、选择标记、滑动窗口)的注意力计算隔离到独立的分支中。这些分支的输出随后通过一个学习到的门控机制进行聚合。为了以极小的计算开销进一步防止跨注意力分支的捷径学习,我们为三个分支提供独立的键和值。这种架构设计通过防止局部模式识别与长程模式识别之间的梯度干扰来实现稳定学习,同时引入的开销极小。
在获得全部三类键和值 之后,我们按照公式(5)计算最终的注意力输出。结合上述压缩、选择和滑动窗口机制,这构成了 NSA 的完整算法框架。
3.4. 内核设计
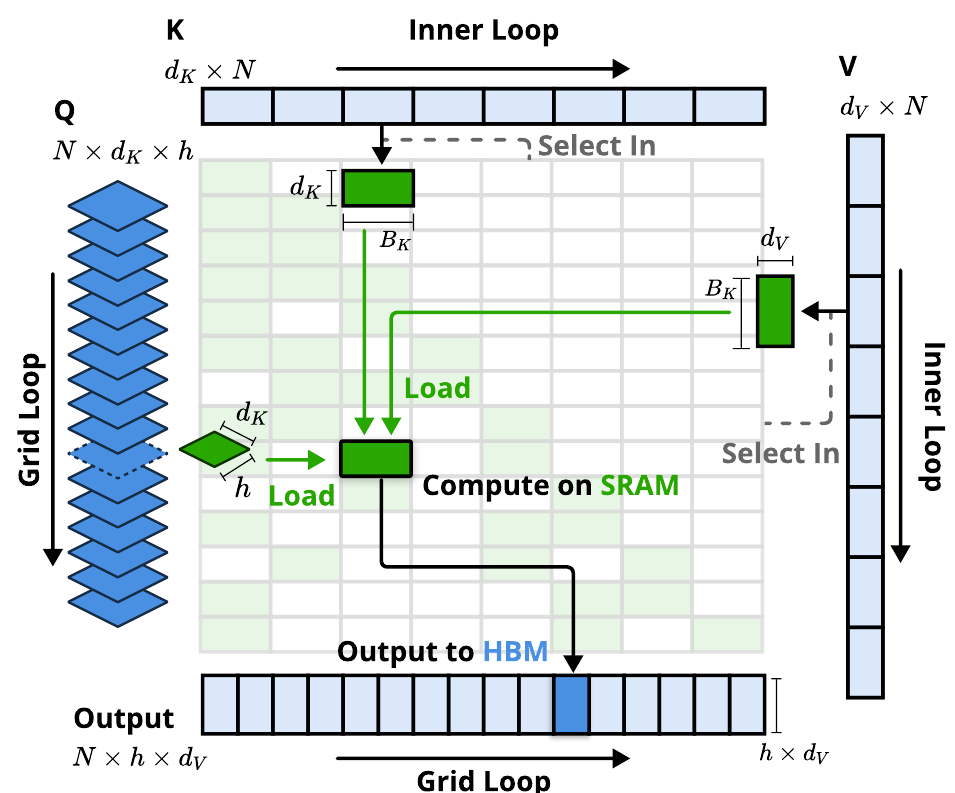
为了在训练和性能分析期间实现 FlashAttention 级别的加速,我们在 Triton 之上实现了硬件对齐的稀疏注意力内核。鉴于 MHA 内存密集且在解码时效率低下,我们遵循当前最先进 LLM 的做法,聚焦于具有共享 KV 缓存的架构,如 GQA 和 MQA。虽然压缩和滑动窗口注意力计算与现有的 FlashAttention-2 内核天然兼容,但我们针对稀疏选择注意力引入了专门的内核设计。如果按照 FlashAttention 的策略将时间上连续的查询块加载到 SRAM 中,会导致低效的内存访问,因为一个块内的查询可能需要不相交的 KV 块。为解决这一问题,我们的关键优化在于一种不同的查询分组策略:对于查询序列上的每个位置,我们将一个 GQA 组内的所有查询头(它们共享相同的稀疏 KV 块)加载到 SRAM 中。图 3 展示了我们的前向传播实现。所提出的内核架构具有以下关键特征:
1. 以组为中心的数据加载。对于每个内层循环,加载位置 处组内所有头的查询 及其共享的稀疏键/值块索引 。
2. 共享 KV 获取。在内层循环中,将索引为 的连续键/值块依次加载到 SRAM 中,即 、,以最小化内存加载,其中 是满足 的内核块大小。
3. 网格上的外层循环。由于内层循环长度(与所选块数量 成正比)对于不同查询块几乎相同,我们将查询/输出循环放入 Triton 的网格调度器中,以简化和优化内核。
该设计通过以下方式实现了接近最优的算术强度:(1)通过组内共享消除冗余的 KV 传输;(2)在 GPU 流式多处理器之间平衡计算负载。
4. 实验
我们从三个角度评估 NSA:(1)通用基准性能,(2)长上下文基准性能,(3)思维链推理性能,并与 Full Attention 基线和最先进的稀疏注意力方法进行比较。我们将稀疏计算范式的效率分析推迟到第 5 节,在那里提供关于训练和推理速度的详细讨论。
4.1. 预训练设置
遵循最先进 LLM 的常见做法,我们的实验采用结合分组查询注意力(GQA)和专家混合(MoE)的骨干架构,总参数为 27B,激活参数为 3B。模型由 30 层组成,隐藏维度为 2560。对于 GQA,我们将组数设为 4,注意力头总数为 64。对于每个头,查询、键和值的隐藏维度分别配置为 和 。对于 MoE,我们采用 DeepSeekMoE(Dai et al., 2024; DeepSeek-AI, 2024)结构,包含 72 个路由专家和 2 个共享专家,并将 top-k 专家设为 6。为确保训练稳定性,第一层的 MoE 被替换为 SwiGLU 形式的 MLP。
| 模型 | MMLU Acc. 5-shot | MMLU-PRO Acc. 5-shot | CMMLU Acc. 5-shot | BBH Acc. 3-shot | GSM8K Acc. 8-shot | MATH Acc. 4-shot | DROP F1 1-shot | MBPP Pass@1 3-shot | HumanEval Pass@1 0-shot | 平均 |
| Full Attn | 0.567 | 0.279 | 0.576 | 0.497 | 0.486 | 0.263 | 0.503 | 0.482 | 0.335 | 0.443 |
| NSA | 0.565 | 0.286 | 0.587 | 0.521 | 0.520 | 0.264 | 0.545 | 0.466 | 0.348 | 0.456 |
表 1 | Full Attention 基线与 NSA 在通用基准上的预训练性能比较,涵盖知识(MMLU、MMLU-PRO、CMMLU)、推理(BBH、GSM8K、MATH、DROP)和编码(MBPP、HumanEval)任务。尽管稀疏度很高,NSA 在大多数基准上仍取得了更优的平均性能。
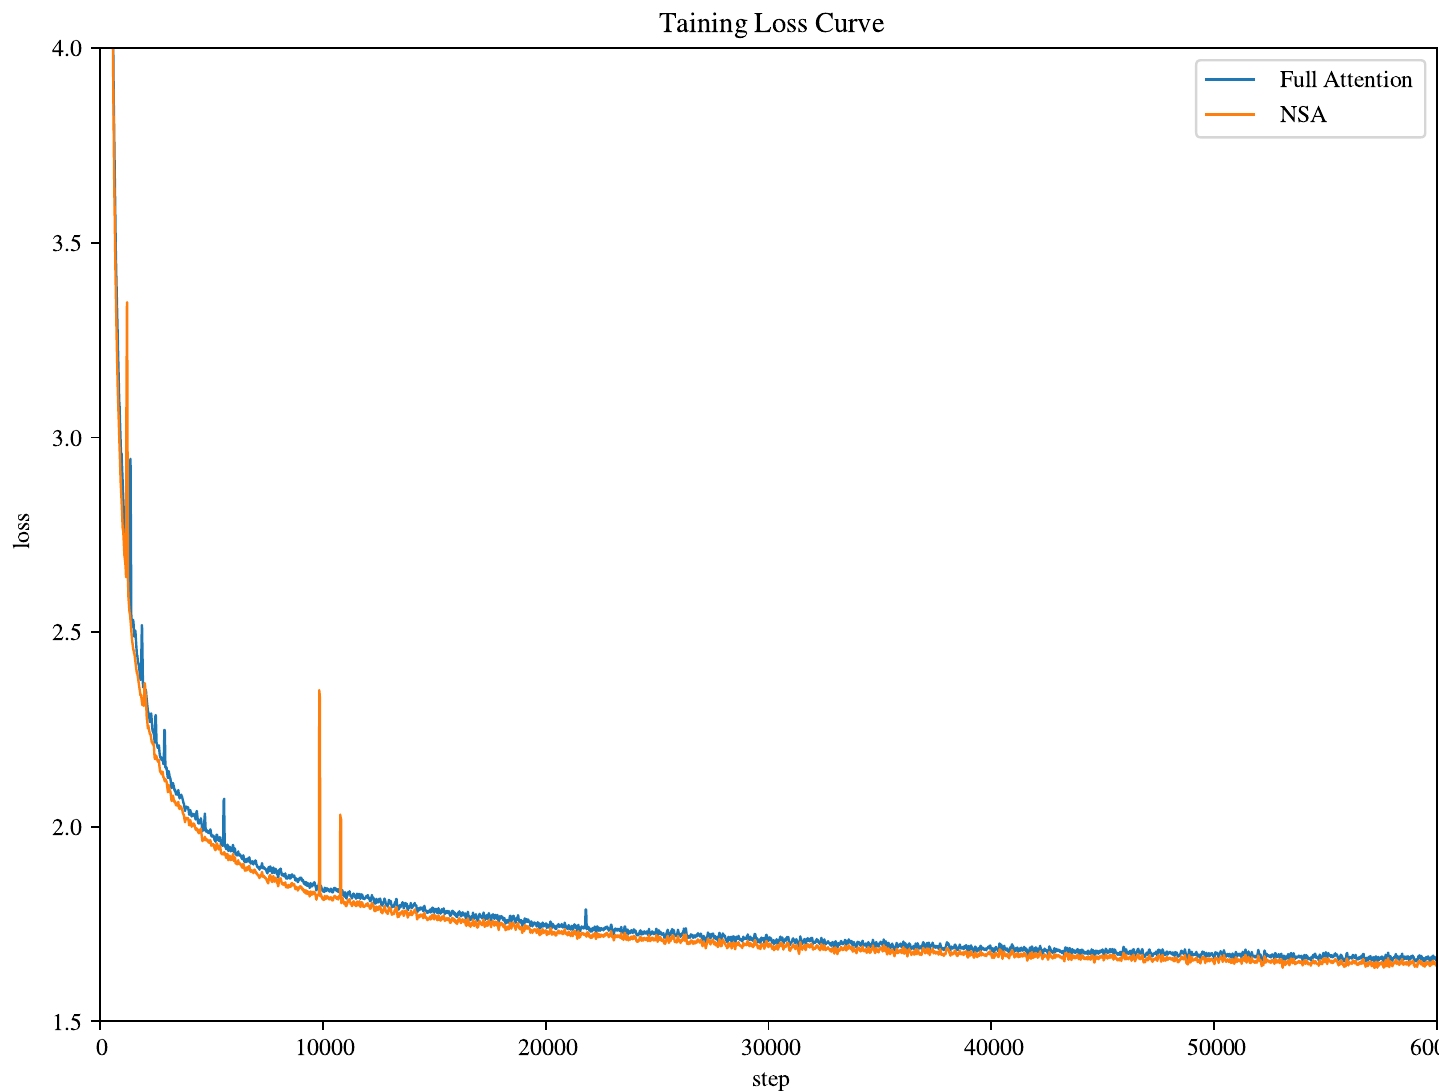
所提出的架构在计算成本和模型性能之间实现了有效的权衡。对于 NSA,我们设置压缩块大小 、滑动步长 、选择块大小 、选择块数量 (包括固定激活 1 个初始块和 2 个局部块),以及滑动窗口大小 。Full Attention 和稀疏注意力模型均在 270B 个 8k 长度文本的 token 上进行预训练,随后使用 YaRN(Peng et al., 2024)在 32k 长度文本上进行持续训练和监督微调,以实现长上下文适应。两个模型均训练至完全收敛以确保公平比较。如图 4 所示,我们的 NSA 与 Full Attention 基线的预训练损失曲线呈现出稳定平滑的下降,NSA 始终优于 Full Attention 模型。
4.2. 基线方法
除了与 Full Attention 比较外,我们还评估了几种最先进的推理阶段稀疏注意力方法:H2O(Zhang et al., 2023b)、infLLM(Xiao et al., 2024a)、Quest(Tang et al., 2024)和 Exact-Top,后者首先计算完整的注意力分数,为每个查询选择 top- 分数对应的键,然后在这些位置上计算注意力。这些
| 模型 SQA | MQA | Synthetic | CodeLCC | 平均 | |||||||
| MFQA-en | MFQA-zh | Qasper | HPQ | 2Wiki | GovRpt | Dur | PassR-en | PassR-zh | |||
| H2O | 0.428 | 0.429 | 0.308 | 0.112 | 0.101 | 0.231 | 0.208 | 0.704 | 0.421 | 0.092 | 0.303 |
| InfLLM | 0.474 | 0.517 | 0.356 | 0.306 | 0.250 | 0.277 | 0.257 | 0.766 | 0.486 | 0.143 | 0.383 |
| Quest | 0.495 | 0.561 | 0.365 | 0.295 | 0.245 | 0.293 | 0.257 | 0.792 | 0.478 | 0.135 | 0.392 |
| Exact-Top | 0.502 | 0.605 | 0.397 | 0.321 | 0.288 | 0.316 | 0.291 | 0.810 | 0.548 | 0.156 | 0.423 |
| Full Attn | 0.512 | 0.623 | 0.409 | 0.350 | 0.305 | 0.324 | 0.294 | 0.830 | 0.560 | 0.163 | 0.437 |
| NSA | 0.503 | 0.624 | 0.432 | 0.437 | 0.356 | 0.307 | 0.341 | 0.905 | 0.550 | 0.232 | 0.469 |
表 2 | 我们的 NSA 与基线在 LongBench 上的性能比较,包括单文档问答、多文档问答、合成和代码任务类别的子集。NSA 优于包括 Full Attention 在内的大多数基线。方法涵盖多种稀疏注意力范式,包括 KV 缓存驱逐、查询感知选择和精确 top- 稀疏选择。
对于通用评估,由于大多数样本的长度在稀疏注意力基线的局部上下文窗口之内,这些方法实际上等效于 Full Attention。因此,我们在此设置下仅展示 NSA 与 Full Attention 基线的比较结果。在长上下文评估中,我们对所有基线方法进行比较,并将所有稀疏注意力方法的稀疏度设为相同以确保公平比较。对于需要长文本监督微调的思维链推理评估,我们将比较限制在 Full Attention,因为稀疏注意力基线不支持训练。
4.3. 性能比较
通用评估。我们在涵盖知识、推理和编码能力的综合基准套件上评估了预训练的 NSA 和 Full Attention 基线,包括 MMLU(Hendrycks et al., 2020)、MMLU-PRO(Wang et al., 2024)、CMMLU(Li et al., 2023)、BBH(Suzgun et al., 2022)、GSM8K(Cobbe et al., 2021)、MATH(Hendrycks et al., 2020)、DROP(Dua et al., 2019)、MBPP(Austin et al., 2021)和 HumanEval(Chen et al., 2021)。结果如表 1 所示。尽管具有稀疏性,NSA 仍取得了更优的整体性能,在 9 个指标中的 7 个上优于包括 Full Attention 在内的所有基线。这表明,尽管 NSA 在较短序列上可能无法充分利用其效率优势,但它表现出强大的性能。值得注意的是,NSA 在推理相关基准上表现出显著提升(DROP:,GSM8K:),这表明我们的预训练有助于模型发展出专门的注意力机制。这种稀疏注意力预训练机制迫使模型关注最重要的信息,可能通过滤除来自无关注意力路径的噪声来提升性能。在多样化评估中的一致表现也验证了 NSA 作为通用架构的鲁棒性。
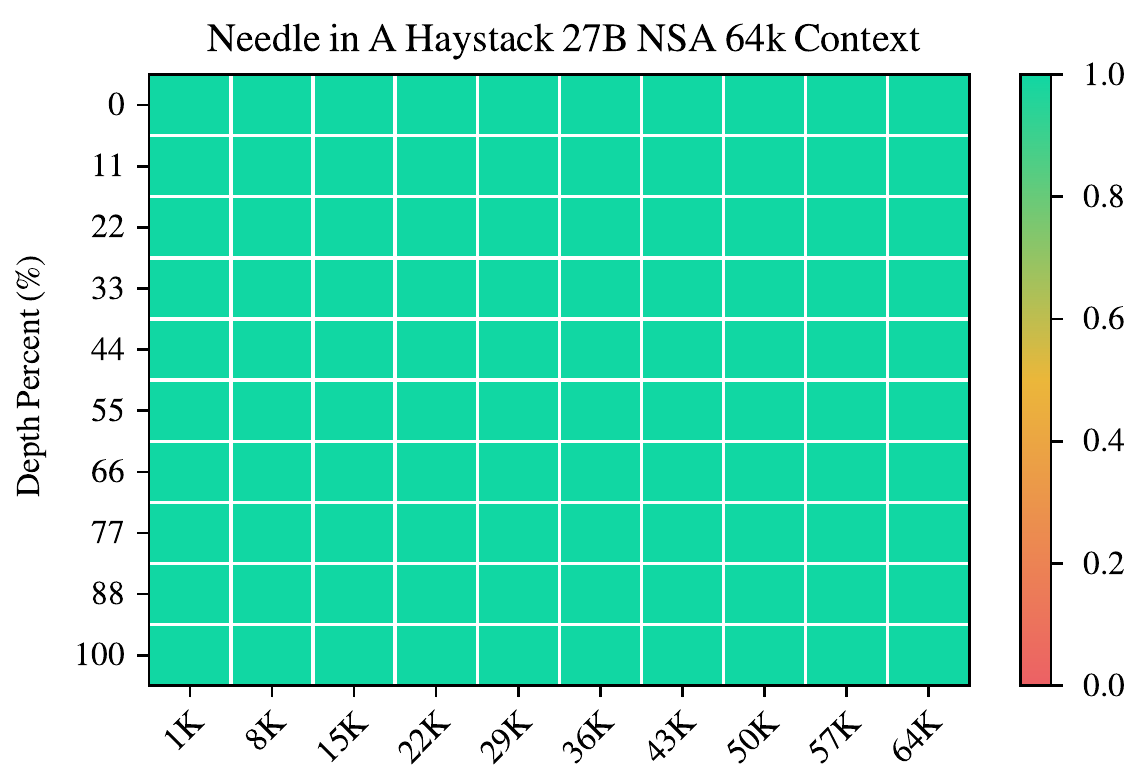
长上下文评估。如图5所示,NSA在64k上下文的“大海捞针”(Kamradt, 2023)测试中于所有位置均实现了完美的检索准确率。这一性能源于我们的层次化稀疏注意力设计,该设计结合了用于高效全局上下文扫描的压缩令牌,以及用于精确局部信息检索的选择令牌。粗粒度的压缩以较低的计算成本识别出相关的上下文块,而对所选令牌的令牌级注意力则确保了对关键细粒度信息的保留。这一设计使NSA能够同时保持全局感知与局部精度。
我们还在LongBench(Bai et al., 2023)上评估了NSA,并将其与最先进的稀疏注意力
方法以及Full Attention基线进行了对比。为确保稀疏性一致,我们将所有稀疏注意力基线中每个查询激活的令牌数设为2560个令牌,这对应于NSA在处理32k序列长度时平均激活的令牌数。参照Stream-LLM(Xiao et al., 2023),该令牌预算包含前128个令牌和512个局部令牌。由于某些子集在所有模型上得分均较低,可能无法提供有意义的比较,我们将这些子集从LongBench中排除。如表2所示,NSA取得了最高的平均分0.469,优于所有基线(比Full Attention高+0.032,比Exact-Top高+0.046)。这一提升源于两项关键创新:(1)我们的原生稀疏注意力设计,使得稀疏模式能够在预训练过程中进行端到端优化,促进了稀疏注意力模块与其他模型组件之间的同步适配;(2)层次化稀疏注意力机制在局部与全局信息处理之间实现了平衡。
值得注意的是,NSA在需要对长上下文进行复杂推理的任务上表现出卓越的性能,在多跳问答任务(HPQ和2Wiki)上相较Full Attention分别取得+0.087和+0.051的提升,在代码理解任务上超越基线(LCC:+0.069),在段落检索任务上优于其他方法(PassR-en:+0.075)。这些结果验证了NSA处理多样化长上下文挑战的能力,其原生预训练的稀疏注意力在学习任务最优模式方面提供了额外优势。
思维链推理评估。为评估NSA与先进下游训练范式的兼容性,我们研究了其通过后训练获得思维链数学推理能力的效果。鉴于强化学习在较小规模模型上效果有限,我们采用从DeepSeek-R1进行知识蒸馏的方法,使用100亿令牌的32k长度数学推理轨迹进行监督微调(SFT)。由此得到两个可比较的模型:Full Attention-R(Full Attention基线)和NSA-R(我们的稀疏变体)。我们在具有挑战性的美国数学邀请赛(AIME 24)基准上评估了这两个模型。我们采用0.7的采样温度和0.95的top-值,为每个问题生成16个回答并取平均分。为验证推理深度的影响,我们在两种生成上下文限制下进行实验:8k和16k令牌,以衡量更长的推理链是否能提升准确率。模型预测的示例对比见附录A。
| 生成Token限制 | 8192 | 16384 |
| Full Attention-R | 0.046 | 0.092 |
| NSA-R | 0.121 | 0.146 |
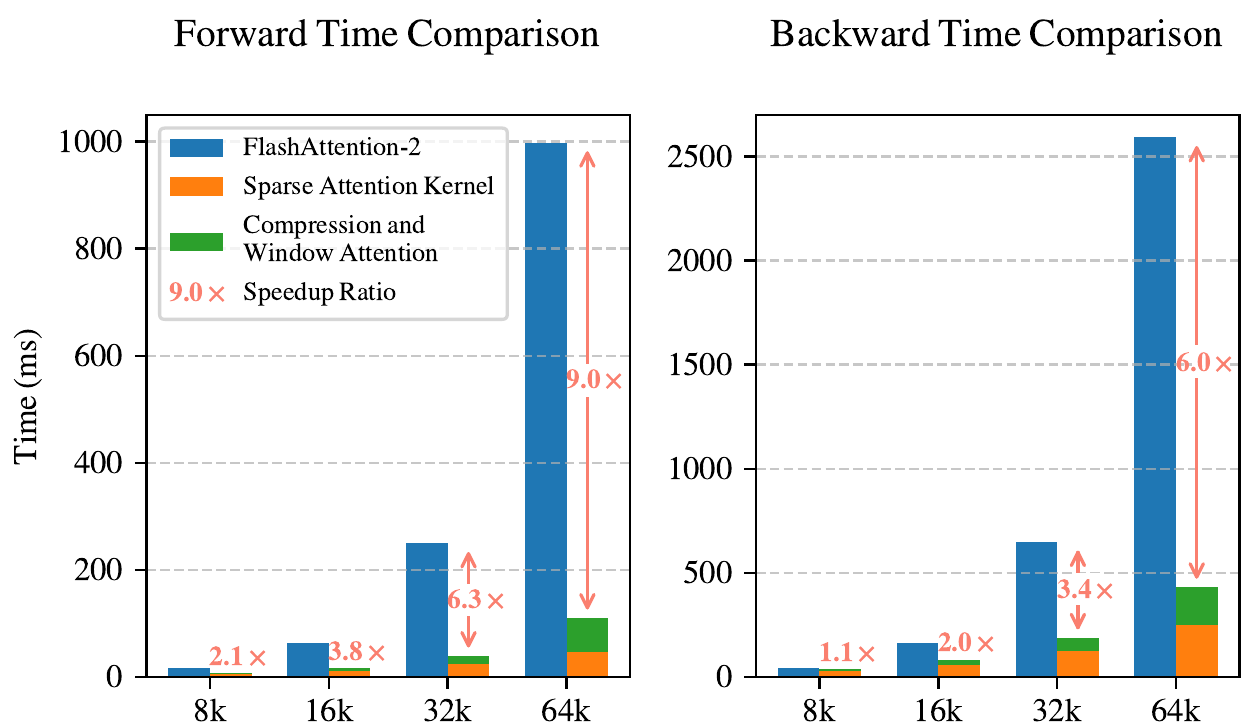
图6 | 基于Triton的NSA内核与基于Triton的FlashAttention-2内核的比较。我们的实现在所有上下文长度下都显著降低了延迟,并且随着输入长度的增加,改进效果愈发明显。
如表3所示,在8k上下文设置下,NSA-R的准确率显著高于Full Attention-R(+0.075),这一优势在16k上下文下依然保持(+0.054)。这些结果验证了原生稀疏注意力的两个关键优势:(1) 预训练的稀疏注意力模式能够高效捕捉对于复杂数学推导至关重要的长程逻辑依赖关系;(2) 我们的架构采用硬件对齐设计,保持了足够的上下文密度,以支持不断增长的推理深度而不会出现灾难性遗忘。在不同上下文长度下的一致优异表现,证实了稀疏注意力在原生集成到训练流程中时对于高级推理任务的可行性。
5. 效率分析
我们在8-GPU A100系统上评估NSA相对于Full Attention的计算效率。在效率分析中,我们还配置模型使用GQA组数、每组头数、查询/键维度、值维度。遵循第4节中的相同设置,我们设定NSA压缩块大小、滑动步长、选中块大小、选中块数量、滑动窗口大小。
5.1. 训练速度
我们将基于Triton实现的NSA注意力和Full Attention与基于Triton的FlashAttention-2进行比较,以确保在相同后端下进行公平的速度对比。如图6所示,我们的NSA随着上下文长度的增加实现了逐步更大的加速,在64k上下文长度下前向加速比最高达,反向加速比最高达。值得注意的是,速度优势随着序列变长而更加明显。这一加速源于我们
| 上下文长度 | 8192 | 16384 | 32768 | 65536 |
| 全注意力 | 8192 | 16384 | 32768 | 65536 |
| NSA | 2048 | 2560 | 3584 | 5632 |
| 预期加速比 | 4× | 6.4× | 9.1× | 11.6× |
采用硬件对齐的算法设计,以最大化稀疏注意力架构的效率:(1) 分块内存访问模式通过合并加载最大化Tensor Core利用率;(2) 内核中精细的循环调度消除了冗余的KV传输。
5.2. 解码速度
注意力解码速度主要取决于内存访问瓶颈,而这与KV缓存的加载量密切相关。在每个解码步骤中,我们的NSA最多只需加载个压缩token、个选中token和个邻近token,其中为缓存序列长度。如表4所示,随着解码长度的增加,我们的方法展现出显著的延迟降低,在64k上下文长度下实现了最高的加速。这一内存访问效率优势同样随着序列变长而放大。
6. 讨论
在本节中,我们回顾NSA的开发过程,并讨论在探索不同稀疏注意力策略过程中获得的关键见解。虽然我们的方法展现了令人鼓舞的结果,但理解替代策略所遇到的挑战并分析注意力模式,可为未来研究方向提供有价值的参考。我们首先审视促使我们做出设计选择的替代token选择策略所面临的挑战,随后展示有助于理解注意力分布模式的可视化结果。
6.1. 替代Token选择策略的挑战
在设计NSA之前,我们探索了将现有稀疏注意力方法适配到训练阶段的方案。然而,这些尝试遇到了各种挑战,促使我们设计一种不同的稀疏注意力架构:
基于键聚类的策略。我们考察了ClusterKV(Liu et al., 2024)等基于聚类的策略。这些方法将来自同一聚类的键和值存储在连续的内存区域中。虽然在训练和推理中理论上是可行的,但它们面临三个重大挑战:(1) 动态聚类机制引入的不可忽视的计算开销;(2) 簇间不均衡加剧的算子优化困难,尤其在混合专家(MoE)系统中,专家并行(EP)组执行时间的偏斜导致持续的负载不均衡;(3) 强制周期性重新聚类和分块顺序训练协议所带来的实现约束。这些因素共同造成实质性瓶颈,显著限制了其在实际部署中的有效性。
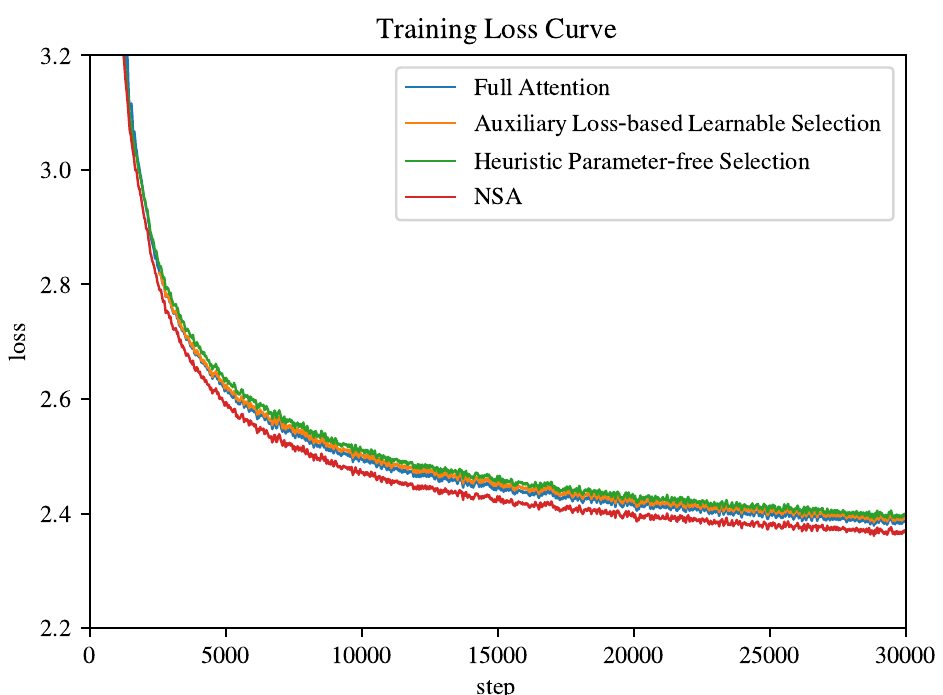
其他分块选择策略。我们还考虑了不同于NSA的分块键、值选择策略,如Quest(Tang et al. [2024])和InfLLM(Xiao et al. [2024a])。这些方法依赖于为每个KV块计算重要性分数,并基于其与的相似度选择前个块。然而,现有方法面临两个关键问题:(1) 由于选择操作不可微,基于神经网络的重要性分数计算依赖于辅助损失,这增加了算子开销且往往降低模型性能;(2) 启发式无参数重要性分数计算策略的召回率较低,导致性能次优。我们在架构相似的3B参数模型上评估了这两种方法,并将其损失曲线与NSA和Full Attention进行比较。对于基于辅助损失的选择方法,我们为每个token引入额外的查询,为每个块引入代表性键来估计块重要性分数。我们通过对每个键块内的注意力分数进行平均池化来计算块级监督信号,并使用KL散度来监督块重要性预测。我们保持单个查询粒度而非块平均查询,以适应高效解码。这种基于辅助损失的重要性估计与SeerAttention(Gao et al. [2024])在概念上相似。对于启发式无参数选择方法,遵循Quest的策略,我们利用查询与键块逐坐标最小-最大值之间的乘积实现直接选择,不引入额外参数。我们还探索了一种冷启动训练方法,即在前1000步应用Full Attention,然后过渡到启发式分块选择。如图7所示,两种方法均表现出较差的损失。
6.2. 可视化
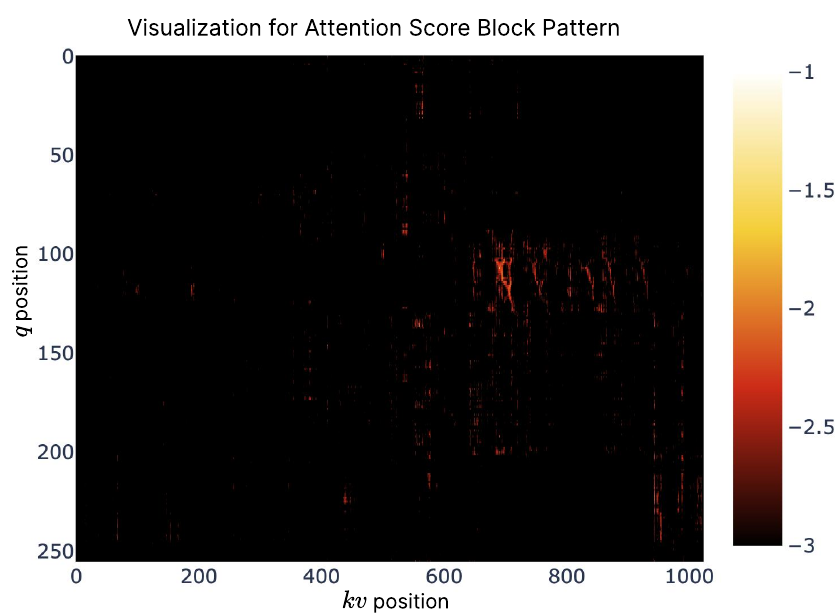
为了探索Transformer注意力分布中的潜在模式并为我们的设计寻求灵感,我们在图8中可视化了预训练的27B Full Attention模型的注意力图。可视化揭示了有趣的模式:注意力分数倾向于呈现分块聚类特征,邻近的键往往表现出相似的注意力分数。这一观察启发了我们对NSA的设计,表明基于空间连续性选择键块可能是一种有前景的方法。分块聚类现象表明,序列中相邻的token可能与查询token共享某些语义关系,尽管这些关系的确切性质有待进一步研究。这一观察促使我们探索一种作用于连续token块而非单个token的稀疏注意力机制,旨在提高计算效率并保留高注意力模式。
7. 相关工作
我们回顾了通过稀疏注意力提高注意力计算效率的现有方法。这些方法根据其核心策略可大致分为三类:(1) 固定稀疏模式,(2) 动态token剪枝,(3) 查询感知选择。我们介绍每个类别中的若干代表性工作。
7.1. 固定稀疏模式
滑动窗口是一种常用的方法,允许查询仅在固定窗口内计算注意力。StreamingLLM(Xiao et al., 2023)将注意力汇与局部窗口相结合来处理连续文本流。MoA(Fu et al., 2024a)和DuoAttention(Xiao et al., 2024b)也采用类似的局部和汇信息进行长序列建模。Longformer(Beltagy et al., 2020)将局部窗口注意力与全局token交错来处理长序列。与它们相比,我们的NSA不依赖于预定义的稀疏模式,而是自动学习模式,释放了利用完整上下文的潜力。
7.2. 动态Token剪枝
一些方法旨在通过动态KV缓存剪枝来降低推理过程中的内存和计算成本。H2O(Zhang et al., 2023b)、BUZZ(Zhao et al., 2024)和SepLLM(Chen et al., 2024a)实现了自适应方法来减少解码过程中的KV缓存内存使用。这些方法动态驱逐被认为对未来预测不太重要的token。FastGen(Ge et al., 2023)和HeadKV(Fu et al., 2024b)通过为各个注意力头分配不同策略来优化计算。SnapKV(Li et al., 2024)引入了一种token剪枝策略,通过仅选择性保留最关键的特征来减少KV缓存,从而实现高效的内存使用。与这些聚焦于推理的方法不同,我们的NSA在训练阶段原生地融入了稀疏性。
7.3. 查询感知选择
其他工作则聚焦于依赖查询的 token 选择方法,以在保持注意力质量的同时减少注意力计算。Quest(Tang 等,2024)采用分块选择策略,其中每个块的重要性通过查询与键块逐坐标最小-最大值之间的乘积来估计。InfLLM(Xiao 等,2024a)通过维护注意力汇、局部上下文和可检索块,将固定模式与检索相结合。该方法从每个块中选择具有代表性的键来估计块的重要性。HashAttention(Desai 等,2024)将关键 token 识别形式化为推荐问题,通过所学函数将查询和键映射到汉明空间。ClusterKV(Liu 等,2024)通过首先对键进行聚类,然后基于查询-聚类相似度为注意力计算选择最相关的聚类来实现稀疏性。MInference(Jiang 等,2024)和 TokenSelect(Wu 等,2024)基于 token 级重要性评分选择 KV 对进行计算。SeerAttention(Gao 等,2024)将查询和键分离为空间块,并执行分块选择以实现高效计算。与这些方法相比,我们的 NSA 在整个模型生命周期(包括训练、预填充和解码)中实现了硬件对齐的稀疏注意力计算。
8. 结论
我们提出了 NSA,一种用于高效长上下文建模的硬件对齐稀疏注意力架构。通过在可训练架构中将分层 token 压缩与分块 token 选择相结合,我们的架构在保持全注意力性能的同时实现了训练和推理加速。NSA 推动了最先进水平的发展,其证明了通用基准性能与全注意力基线相匹配、在长上下文评估中超越了建模能力,并增强了推理能力,同时伴随着计算延迟的可测量降低并实现了显著加速。
参考文献
J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón, and S. Sanghai. Gqa: Training generalized multi-query transformer models from multi-head checkpoints. arXiv preprint arXiv:2305.13245, 2023. J. Austin, A. Odena, M. Nye, M. Bosma, H. Michalewski, D. Dohan, E. Jiang, C. Cai, M. Terry, Q. Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021. Y. Bai, X. Lv, J. Zhang, H. Lyu, J. Tang, Z. Huang, Z. Du, X. Liu, A. Zeng, L. Hou, et al. Longbench: A bilingual, multitask benchmark for long context understanding. arXiv preprint arXiv:2308.14508, 2023. I. Beltagy, M. E. Peters, and A. Cohan. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150, 2020. G. Chen, H. Shi, J. Li, Y. Gao, X. Ren, Y. Chen, X. Jiang, Z. Li, W. Liu, and C. Huang. Sepllm: Accelerate large language models by compressing one segment into one separator. arXiv preprint arXiv:2412.12094, 2024a. M. Chen, J. Tworek, H. Jun, Q. Yuan, H. P. D. O. Pinto, J. Kaplan, H. Edwards, Y. Burda, N. Joseph, G. Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. Z. Chen, R. Sadhukhan, Z. Ye, Y. Zhou, J. Zhang, N. Nolte, Y. Tian, M. Douze, L. Bottou, Z. Jia, et al. Magicpig: Lsh sampling for efficient llm generation. arXiv preprint arXiv:2410.16179, 2024b. K. Cobbe, V. Kosaraju, M. Bavarian, M. Chen, H. Jun, L. Kaiser, M. Plappert, J. Tworek, J. Hilton, R. Nakano, et al. Training verifiers to solve math word problems, 2021. URL https://arxiv.org/abs/2110.14168, 2021. D. Dai, C. Deng, C. Zhao, R. Xu, H. Gao, D. Chen, J. Li, W. Zeng, X. Yu, Y. Wu, et al. Deepseekmoe: Towards ultimate expert specialization in mixture-of-experts language models. arXiv preprint arXiv:2401.06066, 2024. DeepSeek- AI. Deepseek- v2: A strong, economical, and efficient mixture- of- experts language model. 2024. URL https://arxiv.org/abs/2405.04434 DeepSeek- AI. Deepseek- r1: Incentivizing reasoning capability in llms via reinforcement learning, 2025. URL https://arxiv.org/abs/2501.12948
A. Desai, S. Yang, A. Cuadron, A. Klimovic, M. Zaharia, J. E. Gonzalez, and I. Stoica. Hashattention: Semantic sparsity for faster inference. arXiv preprint arXiv:2412.14468, 2024.
D. Dua, Y. Wang, P. Dasigi, G. Stanovsky, S. Singh, and M. Gardner. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. arXiv preprint arXiv:1903.00161, 2019.
T. Fu, H. Huang, X. Ning, G. Zhang, B. Chen, T. Wu, H. Wang, Z. Huang, S. Li, S. Yan, et al. Moa: Mixture of sparse attention for automatic large language model compression. arXiv preprint arXiv:2406.14909, 2024a.
Y. Fu, Z. Cai, A. Asi, W. Xiong, Y. Dong, and W. Xiao. Not all heads matter: A head-level kv cache compression method with integrated retrieval and reasoning. arXiv preprint arXiv:2410.19258, 2024b.
Y. Gao, Z. Zeng, D. Du, S. Cao, H. K.-H. So, T. Cao, F. Yang, and M. Yang. Seerattention: Learning intrinsic sparse attention in your llms. arXiv preprint arXiv:2410.13276, 2024.
S. Ge, Y. Zhang, L. Liu, M. Zhang, J. Han, and J. Gao. Model tells you what to discard: Adaptive kv cache compression for llms. arXiv preprint arXiv:2310.01801, 2023.
G. T. Google, P. Georgiev, V. I. Lei, R. Burnell, L. Bai, A. Gulati, G. Tanzer, D. Vincent, Z. Pan, S. Wang, et al. Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context. arXiv preprint arXiv:2403.05530, 2024.
D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
H. Jiang, Q. Wu, C.-Y. Lin, Y. Yang, and L. Qiu. Llmlingua: Compressing prompts for accelerated inference of large language models. arXiv preprint arXiv:2310.05736, 2023.
H. Jiang, Y. Li, C. Zhang, Q. Wu, X. Luo, S. Ahn, Z. Han, A. H. Abdi, D. Li, C.-Y. Lin, et al. Minference 1.0: Accelerating pre-filling for long-context llms via dynamic sparse attention. arXiv preprint arXiv:2407.02490, 2024.
G. Kamradt. LLMTest NeedleInAHaystack. GitHub repository, 2023. URL https://github.com/gkamradt/LLMTest_NeedleInAHaystack Accessed: [Insert Access Date Here].
.
.
H. Li, Y. Zhang, F. Koto, Y. Yang, H. Zhao, Y. Gong, N. Duan, and T. Baldwin. Cmmlu: Measuring massive multitask language understanding in chinese. arXiv preprint arXiv:2306.09212, 2023.
Y. Li, Y. Huang, B. Yang, B. Venkitesh, A. Locatelli, H. Ye, T. Cai, P. Lewis, and D. Chen. Snapkv: Llm knows what you are looking for before generation. arXiv preprint arXiv:2404.14469, 2024.
.
G. Liu, C. Li, J. Zhao, C. Zhang, and M. Guo. Clusterkv: Manipulating llm kv cache in semantic space for recallable compression. arXiv preprint arXiv:2412.03213, 2024.
J. S. Park, J. C. O'Brien, C. J. Cai, M. R. Morris, P. Liang, and M. S. Bernstein. Generative agents: Interactive simulacra of human behavior. In S. Follmer, J. Han, J. Steimle, and N. H. Riche, editors, Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, UIST 2023, San Francisco, CA, USA, 29 October 2023–1 November 2023, pages 2:1–2:22. ACM, 2023.
.
.
B. Peng, J. Quesnelle, H. Fan, and E. Shippole. Yarn: Efficient context window extension of large language models. In ICLR. OpenReview.net, 2024.
N. Shazeer. Fast transformer decoding: One write-head is all you need. CoRR, abs/1911.02150, 2019.
M. Suzgun, N. Scales, N. Schärli, S. Gehrmann, Y. Tay, H. W. Chung, A. Chowdhery, Q. V. Le, E. H. Chi, D. Zhou, et al. Challenging big-bench tasks and whether chain-of-thought can solve them. arXiv preprint arXiv:2210.09261, 2022.
J. Tang, Y. Zhao, K. Zhu, G. Xiao, B. Kasikci, and S. Han. Quest: Query-aware sparsity for efficient long-context llm inference. arXiv preprint arXiv:2406.10774, 2024.
P. Tillet, H.-T. Kung, and D. Cox. Triton: an intermediate language and compiler for tiled neural network computations. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, L. u. Kaiser, and I. Polosukhin. Attention is all you need. Advances in Neural Information Processing Systems, 2017.
Y. Wang, X. Ma, G. Zhang, Y. Ni, A. Chandra, S. Guo, W. Ren, A. Arulraj, X. He, Z. Jiang, et al. Mmlu-pro: A more robust and challenging multi-task language understanding benchmark. arXiv preprint arXiv:2406.01574, 2024.
J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. Chi, Q. V. Le, D. Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824-24837, 2022.
W. Wu, Z. Pan, C. Wang, L. Chen, Y. Bai, K. Fu, Z. Wang, and H. Xiong. Tokenselect: Efficient long-context inference and length extrapolation for llms via dynamic token-level kv cache selection. arXiv preprint arXiv:2411.02886, 2024.
C. Xiao, P. Zhang, X. Han, G. Xiao, Y. Lin, Z. Zhang, Z. Liu, and M. Sun. Infllm: Training-free long-context extrapolation for llms with an efficient context memory. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024a.
G. Xiao, Y. Tian, B. Chen, S. Han, and M. Lewis. Efficient streaming language models with attention sinks. arXiv preprint arXiv:2309.17453, 2023.
G. Xiao, J. Tang, J. Zuo, J. Guo, S. Yang, H. Tang, Y. Fu, and S. Han. Duoattention: Efficient long-context llm inference with retrieval and streaming heads. arXiv preprint arXiv:2410.10819, 2024b.
M. Zaheer, G. Guruganesh, K. A. Dubey, J. Ainslie, C. Alberti, S. Ontanon, P. Pham, A. Ravula, Q. Wang, L. Yang, et al. Big bird: Transformers for longer sequences. Advances in neural information processing systems, 33:17283-17297, 2020.
E. Zelikman,Y. Wu,J. Mu 和 N. D. Goodman。Star:用推理引导推理的自举方法。载于 S. Koyejo、S. Mohamed、A. Agarwal、D. Belgrave、K. Cho 和 A. Oh 编,《神经信息处理系统进展 35:2022 年神经信息处理系统年度会议,NeurIPS 2022,美国路易斯安那州新奥尔良,2022 年 11 月 28 日 - 12 月 9 日》,2022 年。
F. Zhang,B. Chen,Y. Zhang,J. Keung,J. Liu,D. Zan,Y. Mao,J. Lou 和 W. Chen。Repocoder:通过迭代检索与生成的仓库级代码补全。载于 H. Bouamor、J. Pino 和 K. Bali 编,《2023 年自然语言处理实证方法会议论文集,EMNLP 2023,新加坡,2023 年 12 月 6-10 日》,第 2471-2484 页。计算语言学协会,2023a。K. Zhang,J. Li,G. Li,X. Shi 和 Z. Jin。Codeagent:利用工具集成智能体系统增强面向真实世界仓库级编码挑战的代码生成。载于 L. Ku、A. Martins 和 V. Srikumar 编,《第 62 届计算语言学协会年会论文集(第 1 卷:长论文),ACL 2024,泰国曼谷,2024 年 8 月 11-16 日》,第 13643-13658 页。Z. Zhang,Y. Sheng,T. Zhou,T. Chen,L. Zheng,R. Cai,Z. Song,Y. Tian,C. Ré,C. Barrett 等。H2o:用于大型语言模型高效生成式推理的重击者预言机。载于《神经信息处理系统进展》,36:34661-34710,2023b。J. Zhao,Z. Fang,S. Li,S. Yang 和 S. He。Buzz:具有分段重击者的蜂巢结构稀疏 KV 缓存,用于高效 LLM 推理。arXiv 预印本 arXiv:2410.23079,2024。Z. Zhou,C. Li,X. Chen,S. Wang,Y. Chao,Z. Li,H. Wang,R. An,Q. Shi,Z. Tan 等。Llm × mapreduce:使用大型语言模型简化长序列处理。arXiv 预印本 arXiv:2410.09342,2024。
A. AIME 结果示例
提示:
"| 用户 | 设 \(x, y\) 和 \(z\) 为正实数,满足以下方程组:
则 \(\left|\log_{2}(x^{4}y^{3}z^{2})\right|\) 的值为 \(\frac{m}{n}\),其中 \(m\) 和 \(n\) 是互质的正整数。求 \(m + n\)。请逐步推理,并将最终答案放在 \(\square\) 中。| 助手 | "
我们的结果:
\(\langle \mathrm{think}\rangle \ldots \langle /\mathrm{think}\rangle\)(2275 个 token)
给定方程组:
我们将这些对数方程转换为指数形式:
用 \(x, y\) 和 \(z\) 表示每个变量:
将这些表达式相互代入,我们得到:- 由 \(x = \sqrt{2} \cdot yz\) 和 \(y = 2^{1 / 3} \cdot xz\),我们得到 \(x = \sqrt{2} \cdot (2^{1 / 3} \cdot xz) \cdot z\),从而得到 \(z = 2^{-5 / 12}\)。- 将 \(z\) 代入 \(y\) 的方程,我们得到 \(y = 2^{-3 / 8}\)。- 将 \(z\) 和 \(y\) 代入 \(x\) 的方程,我们得到 \(x = 2^{-7 / 24}\)。
接下来,我们计算 \(x^{4}y^{3}z^{2}\):
将它们相乘:
取以 2 为底的对数:
绝对值为:
因此,\(m = 25\) 且 \(n = 8\),得到 \(m + n = 33\)。
33
基线结果:
(think)...(/think)(9392 个 token)
给定对数方程组:
我们将这些方程转换为指数形式:
将它们相互代入,我们得到:
通过逐步求解这些方程,我们得到:
然而,在验证第三个方程时,我们意识到该系统可能没有解。因此,我们使用矩阵求逆来求解该系统:
令 \(A = \log_2(x)\),\(B = \log_2(y)\),\(C = \log_2(z)\)。方程组变为:
我们使用克莱姆法则和矩阵求逆来求解该系统。矩阵的行列式为 -2,解为:
因此,我们有:
我们需要求 :
转换为公分母(48):
将这些相加:
分数 已是最简形式,所以 且 。因此, 。
Prompt:
“| User | 满足 的实数 和 满足 。 的值是多少?请逐步推理,并将最终答案放在 中。 | Assistant | ”
我们的结果:
(15147 个 token)
给定方程:
1. 2.
我们首先对两个方程应用对数幂法则。
对于第一个方程:
令 。那么, 。将其代入方程,我们得到:
对于第二个方程:
使用幂法则,我们得到:
由于 ,这简化为:
我们现在有两个表达式:
1. 2.
将 和 代入乘积 ,我们得到:
因此, 的值为 。
基线结果:
(16223 个 token)
给定问题:实数 和 满足 ,并且满足方程 和 ,我们需要求 的值。
首先,我们使用换底公式将对数方程转换为指数形式。
1.
使用换底公式,。由于 ,我们有 。因此,
2.
再次使用换底公式,。
接下来,我们用彼此表示 和 :
然后我们计算乘积 :
然而,在重新评估并使用另一种方法,即令 和 后,我们发现:
最后,我们发现乘积 简化为: