
一个开放平台:智能体能写代码、跑命令、上网,在 15 个基准上评测。2025 年 ICLR 论文,全文免费在线阅读。
OpenHands: An Open Platform for AI Software Developers as Generalist Agents
OpenHands:面向AI软件开发者的通用智能体开放平台
王星耀 ,李博轩 ,宋雨凡 ,徐方舟 ,唐祥如 ,诸葛明晨 ,潘嘉怡 ,宋月琪 ,李博文,Jaskirat Singh ,Hoang H. Tran ,李富强,马韧,郑明章,Bill Qian ,邵彦钧 ,Niklas Muennighoff ,张一哲,惠彬原 ,林俊旸 ,Robert Brennan ,彭浩 ,季恒 ,Graham Neubig 伊利诺伊大学厄巴纳-香槟分校 卡内基梅隆大学 耶鲁大学 加州大学伯克利分校 Contextual AI 阿卜杜拉国王科技大学 澳大利亚国立大学 胡志明市理工大学 阿里巴巴 All Hands AI xingyao6@illinois.edu, gneubig@cs.cmu.edu
摘要
软件是人类所拥有的最强大的工具之一;它使熟练的程序员能够以复杂而深刻的方式与世界互动。与此同时,得益于大语言模型(LLM)的进步,能够与其周围环境交互并对其产生改变的AI智能体也在快速发展。在本文中,我们介绍OpenHands(前称OpenDevin),这是一个用于开发强大而灵活的AI智能体的平台,这些智能体以与人类开发者相似的方式与世界交互:通过编写代码、与命令行交互以及浏览网页。我们描述了该平台如何支持新智能体的实现、与沙箱环境进行安全交互以执行代码、多个智能体之间的协调,以及评估基准的集成。基于我们当前集成的基准,我们对智能体在15项具有挑战性的任务上进行了评估,包括软件工程(例如SWE-BENCH)和网页浏览(例如WEBARENA)等。OpenHands以宽松的MIT许可证发布,是一个横跨学术界和工业界的社区项目,拥有来自188多名贡献者的超过2.1K项贡献。
代码 https://github.com/All-Hands-AI/OpenHands Slack http://bit.ly/OpenHands-Slack
1 引言
在大语言模型(LLM;OpenAI 2024b;Team et al. 2023;Jiang et al. 2024;Chang et al. 2024)的驱动下,面向用户的AI系统(如ChatGPT)在执行复杂任务方面的能力日益增强,例如准确回答用户查询、解决数学问题以及生成代码。特别是,AI智能体——即能够感知外部环境并对其采取行动的系统——近年来受到越来越多的研究关注。它们正朝着执行复杂任务的方向发展,例如开发软件(Jimenez et al., 2024)、浏览现实世界的网站(Zhou et al., 2023a)、做家务(Ahn et al., 2022),甚至开展科学研究(Boiko et al., 2023;Tang et al., 2024a)。
X
随着AI智能体具备解决复杂问题的能力,其开发和评估也变得具有挑战性。近期有大量工作致力于创建促进智能体开发的开源框架(Hong et al., 2023;Chen et al., 2024;Wu et al., 2023)。这些智能体框架通常包括:1)智能体与世界交互的接口(如基于JSON的函数调用或代码执行),2)智能体运行的环境,以及3)用于人-智能体或智能体-智能体通信的交互机制。这些框架以多种方式简化和便利了开发过程(表1,§C)。
在设计AI智能体时,我们也可以考虑人类如何与世界交互。人类目前与世界交互的最强大方式是通过软件——软件
驱动着我们生活的方方面面,从满足基本需求的物流到科学、技术乃至AI本身的进步。鉴于软件的力量,以及围绕其高效开发、使用和部署的现有工具,它为AI智能体以复杂方式与世界交互提供了理想的接口。然而,构建能够有效开发软件的智能体也伴随着其独特的挑战。我们如何使智能体能够在复杂软件系统中有效地创建和修改代码?我们如何为它们提供工具,以便即时收集信息以调试问题或收集任务所需信息?我们如何确保开发是安全的,并避免对用户系统产生负面影响?
在本文中,我们介绍OpenHands(前称OpenDevin),这是一个社区驱动的平台,旨在开发通过软件与世界交互的通用和专用AI智能体。1它具有以下特点:
(1)一种交互机制,允许用户界面、智能体和环境通过一种强大而灵活的事件流架构进行交互(§2.1)。(2)一个运行时环境,由带有bash shell、网页浏览器和IPython服务器的Docker沙箱操作系统组成,智能体可以与之交互(§2.2)。(3)一个接口,允许智能体以类似于真实软件工程师的方式与环境交互(§2.3)。我们为智能体提供了以下能力:a)创建和编辑复杂软件,b)在沙箱中执行任意代码,以及c)浏览网站以收集信息。(4)多智能体委派,允许多个专用智能体协同工作(§2.4)。(5)评估框架,便于在广泛任务上评估智能体(§4)。
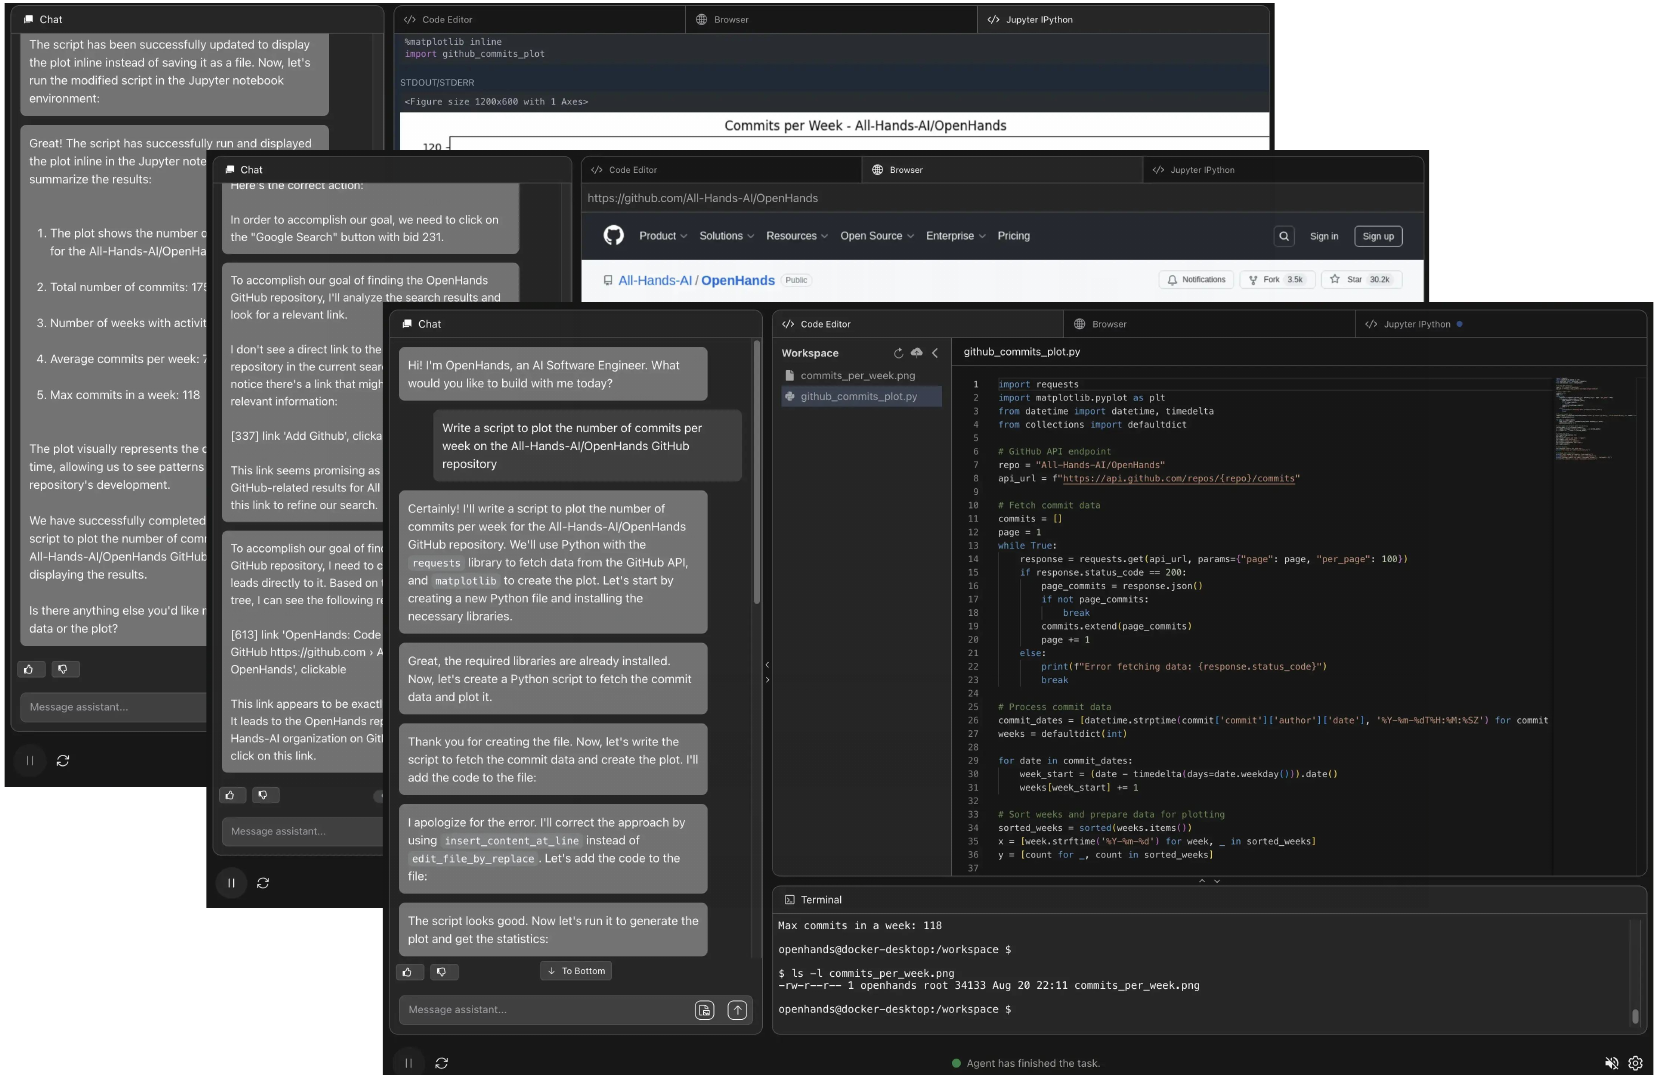
重要的是,OpenHands不仅仅是一个概念框架,它还包括智能体、环境和评估的全面且可立即使用的实现。截至本文撰写时,OpenHands包含一个智能体中心,其中有超过10个已实现的智能体(§3),包括一个基于CodeAct架构(Wang et al., 2024a)实现的强大通用智能体,并增加了网页浏览(ServiceNow)和代码编辑专家(Yang et al., 2024)的组件。与用户的交互通过基于聊天的用户界面实现,该界面可视化智能体的当前动作并允许
实时反馈(图1,§D)。此外,评估框架目前支持15个基准,我们使用这些基准来评估我们的智能体(§4)。
OpenHands以允许商业使用的宽松MIT许可证发布,有望支持学术界和工业界的多样化研究和现实应用。OpenHands已获得显著关注,拥有32K GitHub星标和来自188多名贡献者的超过2.1K项贡献。我们将OpenHands设想为未来研究创新和由广泛从业者社区驱动的多样化应用的催化剂。
2 OpenHands架构
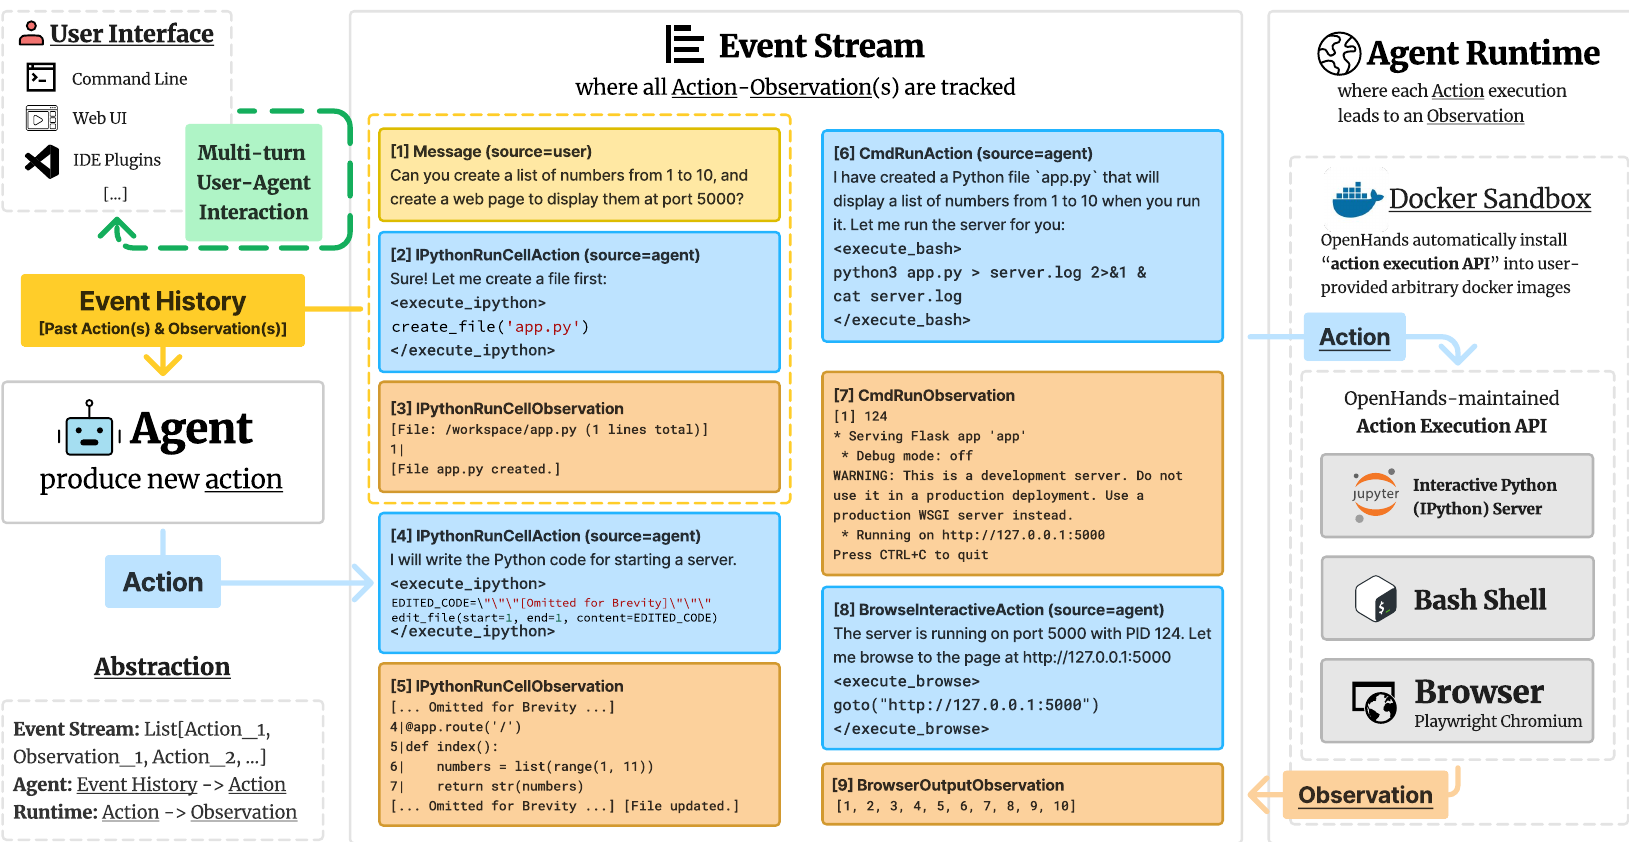
接下来我们详细描述OpenHands的使用。具体而言,我们讨论1)如何定义和实现一个智能体(§2.1),2)每个动作执行如何产生一个观察(§2.2),3)如何可靠地管理和扩展智能体常用的技能(§2.3),以及4)如何将多个智能体组合在一起以解决任务(§2.4)。图2提供了概览。
2.1 智能体定义与实现
智能体可以感知环境的状态(例如,先前的动作和观察),并在解决用户指定任务时产生一个动作以供执行。
状态与事件流。在OpenHands中,状态是一个数据结构,封装了智能体执行的所有相关信息。该状态的一个关键组件是事件流,它是过去动作和观察(包括智能体自身的动作和用户交互,例如指令、反馈)按时间顺序的集合。除事件流外,状态还包含用于智能体运行的辅助信息,例如LLM调用的累计成本、用于跟踪多智能体委派的元数据(§2.4),以及其他与执行相关的参数。
动作。受CodeAct(Wang等,2024a)的启发,OpenHands通过一组核心的通用动作将智能体与环境连接起来。动作IPythonRunCellAction和CmdRunAction使智能体能够在沙箱环境(例如,一个安全隔离的Linux操作系统)内执行任意的Python代码和bash命令。BrowserInteractiveAction借助BrowserGym(Drouin等,2024)引入的用于浏览的领域特定语言,实现与网页浏览器的交互。选择这些动作是为了提供一组全面而又灵活的原语,覆盖人类软件工程师和分析师执行的大多数任务。基于编程语言(PL)的动作空间强大且灵活,足以借助不同形式的工具(例如Python函数、REST API等)执行任何任务,同时又可靠且易于维护(Wang等,2024a)。
这一设计也与现有的、需要一组预定义工具的工具调用智能体相兼容(Chase,2022)。也就是说,用户可以轻松地使用原语动作所支持的PL来定义工具(例如,为计算器编写一个Python函数),并通过JSON风格的函数调用体验使这些工具可供智能体使用(Qin等,2023)。此外,该框架强大的基于PL的原语进一步使智能体能够在完成任务所需的API不可用时自行创建工具(例如,通过生成Python函数,Yuan等,2023)。关于这些基于PL的核心动作如何组合成多样化的工具,请参阅§2.3。
观测。观测描述智能体所观察到的环境变化(例如,先前动作的执行结果、来自人类用户的文本消息等)。
图3:在OpenHands中实现一个智能体的最小示例。
class MinimalAgent: def reset(self) -> None: self.system_message "You are a helpful assistant ..." def step(self, state: State): messages: list[dict[str, str]] = [ {'role': 'system', 'content': self.system_message] ] for prev_action, obs in state.history: action_message get_action_message(prev_action) messages.append(action_message) obs_message get_observation_message(obs) messages.append(obs_message) # use lim to generate response (e.g., thought, action) response self.lim.do_completion(messages) # parse and execute action in the runtime action self.parse_response(response) if self.is_finish_command(action): return AgentFinishAction() elif self.is_bash_command(action): return CmdRunAction(command=action.command) elif self.is_python_code(action): return IPythonRunCallAction(code=action.code) elif self.is_browser_action(action): return BrowseInteractiveAction(code=action.code) else: return MessageAction(content=action.message)
实现一个新的智能体。智能体抽象被设计得简单而强大,使用户能够轻松地为各种任务创建和定制智能体。智能体抽象的核心在于step函数,它以当前状态作为输入,并根据智能体的逻辑生成合适的动作。智能体抽象的简化示例代码如图3所示。通过提供这一抽象,OpenHands使用户能够专注于定义期望的智能体行为和逻辑,而无需担心动作如何执行的低层细节(§2.2)。
2.2 智能体运行时:动作执行如何产生观察结果
智能体运行时提供了一个通用环境,为智能体配备了可与人类软件开发者相媲美的动作空间,使 OpenHands 智能体能够处理广泛的软件开发与基于 Web 的任务,包括复杂的软件开发工作流、数据分析项目、Web 浏览任务等。它允许智能体访问 bash 终端以运行代码和命令行工具,利用 Jupyter notebook 即时编写和执行代码,并与 Web 浏览器交互以完成基于 Web 的任务(例如信息检索)。
Docker 沙箱。对于每个任务会话,OpenHands 会启动一个安全隔离的 Docker 容器沙箱,事件流中的所有动作都在其中执行。OpenHands 通过运行在沙箱内部的 REST API 服务器(即 OpenHands 动作执行 API)连接到沙箱,执行来自事件流的任意动作(例如 bash 命令、Python 代码),并将执行结果作为观察结果返回。包含用户希望智能体处理的文件的可配置工作区目录会被挂载到该安全沙箱中,供 OpenHands 智能体访问。
OpenHands 动作执行 API。OpenHands 维护一个运行在 Docker 沙箱内部的 API 服务器,用于监听来自事件流的动作执行请求。该 API 服务器维护以下组件:
(1)一个与操作系统环境(由 Docker 镜像指定)相连的 bash shell,用于执行命令。(2)一个 Jupyter IPython 服务器,用于处理交互式 Python(IPython)代码执行请求,并将执行结果返回给事件流。(3)一个基于 Playwright 的 Chromium 浏览器。该提供程序提供了一组由 BrowserGym(ServiceNow;Drouin et al., 2024)定义的动作原语,例如导航、点击、输入和滚动。完整的动作集详见 §J。在执行这些动作后,浏览器运行时会提供关于浏览器当前状态的丰富观察结果,包括 HTML、DOM、可访问性树(Mozilla)、截图、已打开的标签页等。
任意 Docker 镜像支持。OpenHands 通过支持基于任意 Docker 镜像的运行时,允许智能体在具有不同软件环境的任意操作系统上运行。OpenHands 实现了一种构建机制,该机制接收用户提供的任意 Docker 镜像,并将 OpenHands 动作执行 API 安装到该镜像中,以支持智能体交互。我们在 §F 中提供了 OpenHands 智能体运行时的详细描述。
2.3 智能体技能:可扩展的智能体-计算机接口
SWE-Agent(Yang et al., 2024)强调了精心设计的智能体-计算机接口(Agent-Computer Interface,ACI,即为特定任务定制的工具)在成功解决复杂任务中的重要性。然而,创建、维护和分发大量工具可能是一项艰巨的工程挑战,尤其是当我们希望将这些工具提供给不同的智能体实现使用时(§3)。为解决这些问题,我们构建了 AgentSkills 库,这是一个旨在增强智能体能力的工具箱,提供难以通过基础 bash 命令或 Python 代码直接获得的实用工具。
易于创建和扩展工具。AgentSkills 被设计为一个 Python 包,由不同的实用函数(即工具)组成,这些函数会被自动导入 Jupyter IPython 环境(§2.2)。将 Python 函数定义为工具的简便性降低了社区成员向该库贡献新工具的门槛。Python 包的通用性也使得不同的智能体实现能够通过我们的核心动作之一 IPythonRunCellAction(§2.1)轻松利用这些工具。
纳入标准与理念。在 AgentSkills 库中,我们并不打算封装每一个可能的 Python 包并重新教智能体如何使用它们(例如,LLM 已经知道可以使用 pandas 库读取 CSV 文件,因此我们不需要重新创建一个工具来教智能体读取相同的文件格式)。我们仅在以下情况下添加新技能:(1)LLM 难以直接编写代码实现(例如,编辑代码并替换特定行),和/或(2)涉及调用外部模型(例如,调用语音转文本模型,或用于代码编辑的模型(Sanger))。
当前支持的技能。AgentSkills 库包含改编自 SWE-Agent(Yang et al., 2024)和 Aider(Gauthier)的文件编辑工具,例如 edit_file,它允许从指定行开始修改现有文件;以及用于查看文件不同部分的滚动函数 scroll_up 和 scroll_down。它还包含支持读取多模态文档的工具,例如 parse_image 和 parse_pdf,分别用于使用视觉-语言模型(例如 GPT-4V)从图像中提取信息以及从 PDF 中读取文本。支持的技能完整列表可在 §I 中找到。
2.4 智能体委派:协作式多智能体交互
OpenHands 也允许多个智能体之间的交互。为此,我们使用一种特殊的动作类型 AgentDelegateAction,它使一个智能体能够将特定子任务委派给另一个智能体。例如,对 Web 浏览支持有限的通用 CodeActAgent 可以使用 AgentDelegateAction 将 Web 浏览任务委派给专门的 BrowsingAgent,以执行更复杂的浏览活动(例如,浏览网页、点击按钮、提交表单等)。
3 AGENTHUB:社区贡献智能体的中心
基于我们的智能体抽象(§2.1),OpenHands 支持广泛的社区贡献智能体实现,供最终用户选择,并作为不同智能体任务的基线。
CodeAct Agent。CodeActAgent 是基于 CodeAct 框架(Wang et al., 2024a)的默认通用智能体。在每一步中,智能体可以(1)用自然语言与人类交流,以请求澄清、确认等,或(2)通过执行代码(即 CodeAct)来执行任务,包括执行 bash 命令、Python 代码或浏览器特定的编程语言(§2.2)。这种通用的动作空间使智能体(v1.5 及以上版本)能够执行各种任务,包括编辑文件、浏览网页、运行程序等。
表 1:不同 AI 智能体框架的比较(§C)。SWE 指“软件工程”。标准化工具库:框架是否包含可供不同智能体实现复用的工具(§2.3);内置沙箱与代码执行:是否支持对智能体生成的任意代码进行沙箱化执行;内置 Web 浏览器:是否为智能体提供功能完整的 Web 浏览器访问能力;人机协作:是否支持多轮人机协作(例如,人类可以在任务执行期间中断智能体,和/或提供额外反馈和指令);AgentHub:是否托管各种智能体的实现(§3);评估框架:是否提供在具有挑战性的基准上对已实现智能体进行系统评估的能力(§4);Agent QC(质量控制):框架是否集成测试(§E)以确保整体框架软件质量。
| 理解源文本的只读背景(非待翻译源文本): | 表1:不同AI代理框架的比较(§C)。SWE指“软件工程”。标准化工具库:框架是否包含可供不同代理实现复用的工具(§2.3);内置沙盒与代码执行:是否支持对代理生成的任意代码进行沙盒执行;内置网络浏览器:是否为代理提供功能完整的网络浏览器访问;人机协作:是否支持多轮人机协作(例如,huma | 待翻译文本: | 框架 | 领域 | 图形用户界面 | 标准化工具库 | 内置沙盒与代码执行 | 内置网络浏览器 | 多代理协作 | 人机协作 |
| AgentHub | 评估框架 | Agent QC | AutoGPT Gravitas(2023) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| ✓ | ✓ | ✓ | LangChain(Chase,2022) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| ✓ | ✓ | ✓ | MetaGPT(Hong等,2023) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| ✓ | ✓ | ✓ | AutoGen(Wu等,2023) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| ✓ | ✓ | ✓ | AutoAgents(Chen等,2024) | 通用 | ✓ | ✓ | ✓ | ✓✓✓✓ | ✓ | ✓ |
| Agents(Zhou 等,2023b) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Xagents(Team,2023) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenAgents(Xie 等,2023) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| GPT5Warm(Zhuge 等,2024) | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| AutoCodeRover(Zhang 等,2024b) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| SWE-Agent(Yang 等,2024) | SWE | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| OpenHands | 通用 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
\* 无原生支持。可使用第三方商业选项。
Browsing Agent。我们实现了一个名为 Browsing Agent 的通用 Web 智能体,作为 Web 智能体任务的一个简单而有效的基线。该智能体与 WebArena(Zhou et al., 2023a)中的智能体类似,但具有改进的观察和动作,且仅使用零样本提示。完整提示见 。
GPT5Warm Agent。GPT5Warm(Zhuge et al., 2024)率先使用可优化图来构建智能体系统,通过模块化统一语言智能体框架。每个节点代表一个不同的操作,而边定义协作与通信路径。这种设计允许对节点和边进行自动优化,推动多智能体系统创建的进步。
微智能体(Micro Agent(s))。此外,OpenHands 支持创建微智能体,即专门针对特定任务的智能体。微智能体复用了现有通用智能体(例如 CodeAct Agent)的大部分实现。它旨在降低智能体开发的门槛,社区成员可以分享在其特定用例中效果良好的专门提示。
4 评估
为了系统地跟踪构建通用数字智能体的进展,如表 2 所列,我们将 15 个成熟基准集成到 OpenHands 中。这些基准涵盖软件工程、Web 浏览和杂项辅助。在本节中,我们将 OpenHands 与开源、可复现的基线进行比较,这些基线并未专门根据基准内容进行手动提示工程。请注意,为简洁起见,在本节剩余部分中我们使用“OH”作为 OpenHands 的简写。
| 类别 | 基准测试 | 所需能力 |
| 软件 | SWE-Bench(Jimenez 等,2024) | 修复 Github 问题 |
| HumanEvalFix(Muennighoff 等,2024) | 修复缺陷 | |
| BIRD(Li 等,2023b) | 文本到 SQL | |
| BioCoder(Tang 等,2024c) | 生物信息学编码 | |
| 网页 | ML-Bench(Tang 等,2024b) | 机器学习编码 |
| Gorilla APIBench(Patil 等,2023) | 软件 API 调用 | |
| ToolQA(Zhuang 等,2024) | 工具使用 | |
| 杂项辅助 | WebArena(Zhou 等,2023a) | 目标规划与逼真浏览 |
| MiniWoB++(Liu 等,2018) | 合成网页上的短轨迹 | |
| GAI(Mialon 等,2023) | 工具使用、浏览、多模态 | |
| GPQA(Rein 等,2023) | 研究生水平的 Google 无法检索问答 | |
| AgentBench(Liu 等,2023) | 操作系统交互(bash) | |
| MINT(Wang 等,2024b) | 多轮数学与代码问题 | |
| Entity Deduction Arena(Zhang 等,2024a) | 状态跟踪与策略规划 | |
| ProofWriter(Tajford 等,2021) | 演绎逻辑推理 |
4.1 结果概览
在 OpenHands 中,我们的目标是开发能够通过软件接口与世界交互的通用数字智能体(如 §2.1 中描述的代码动作所示)。我们认识到,软件智能体不仅应擅长代码编辑,还应擅长 Web 浏览和各种辅助任务,例如回答有关代码仓库的问题或进行在线研究。
| Agent | 模型 | 软件('$4.2)</td><td rowspan="2">Web('$4.3) | 其他('$4.4) | ||
| SWE-Bench Lite | WebArena | ||||
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 18.0 | - | - | |
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-0125-preview | 19.0 | - | - | |
| Aider (Gauthier) | gpt-4o &amp; claude-3-opus | 26.3 | - | - | |
| Moatless Tools (Orwall) | claude-3.5-sonnet | 26.7 | - | - | |
| Agentless (Xia et al., 2024) | gpt-4o | 27.3 | - | - | |
| 网页浏览智能体 | |||||
| Lemur (Xu et al., 2023) | Lemur-chat-70b | - | 5.3 | - | - |
| Patel et al. (2024) | 使用合成数据训练的72B模型 | - | 9.4 | - | - |
| AutoWebGLM (Lai et al., 2024) | 使用人工/智能体标注训练的7B模型 | - | 18.2 | - | - |
| Auto Eval &amp; Refine (Pan et al., 2024) | GPT-4 + Reflexion,配合GPT-4V | - | 20.2 | - | - |
| WebArena Agent (Zhou et al., 2023a) | gpt-4-turbo | - | 14.4 | - | - |
| 其他辅助智能体 | |||||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | - | - | - | 13.2 |
| 少样本提示 + 思维链(Rein et al., 2023) | Llama-2-70b-chat | - | - | 28.1 | - |
| gpt-4 | gpt-3.5-turbo-16k | - | - | 29.6 | - |
| gpt-4 | gpt-4 | - | - | 38.8 | - |
| OpenHands 智能体 | |||||
| CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 6.3 | 8.3 | - | - |
| gpt-4o-2024-05-13 | gpt-4o-2024-05-13 | 22.0 | 14.5 | *53.1 | - |
| claude-3-5-sonnet | claude-3-5-sonnet | 26.0 | 15.3 | 52.0 | - |
| GPTSwarm v1.0 | gpt-4o-2024-05-13 | - | - | - | 32.1 |
\* 数字报告自 CodeActAgent v1.5。
表 3 展示了一组精选的评估结果。虽然 OpenHands 智能体可能并非在每个类别中都达到最佳性能,但它们的设计以通用性为核心。值得注意的是,同一个 CodeAct 智能体在未对其系统提示进行任何修改的情况下,在三大任务类别中展现出有竞争力的性能:软件开发、Web 交互和杂项任务。与通常针对特定任务类别设计和优化的基线智能体相比,这一点尤为重要。
4.2 软件工程
接下来,我们在表4中专门报告软件工程基准的结果。
SWE-Bench(Jimenez et al., 2024)旨在评估智能体解决真实世界GitHub问题的能力,例如缺陷报告或功能请求。智能体与代码仓库交互,并尝试通过文件编辑和代码执行来修复所提供的问题。智能体修改后的代码仓库会针对一个测试套件进行测试,该测试套件包含从人类开发者针对同一问题的修复中新添加的测试。每个测试实例都附带一段“提示文本”,其中包含关于如何解决问题的自然语言建议。在本文中,我们报告的所有结果均不使用提示文本。一个规范子集SWE-bench Lite被创建,以便于进行可访问且高效的测试。出于节省成本的考虑,我们默认使用该子集进行测试。2结果。如表4所示,我们最新版本的CodeActAgent v1.8在使用claude-3.5-sonnet时,取得了的竞争性解决率,与其他开源SWE专用模型相比具有竞争力。
4.2.1 HUMANEVALFIX
HumanEvalFix(Muennighoff et al., 2024)要求智能体在所提供的测试用例帮助下修复给定函数中的缺陷。这些缺陷被设计为确保一个或多个测试用例失败。我们专注于该基准的Python子集,并允许多个模型通过多轮自我调试、结合测试执行反馈来解决缺陷。我们遵循Muennighoff et al. (2024)的设置,使用pass@k(Chen et al., 2021)。结果。在表4中,OpenHands CodeActAgent成功修复了Python拆分中的缺陷。这显著优于所有非智能体方法,几乎是StarCoder2-15B(Lozhkov et al., 2024; Li et al., 2023c)性能的两倍。尽管SWE-Agent达到了,但Yang et al. (2024)向模型提供了成功样本轨迹的完整演示,用于修复测试数据集中的一个缺陷(“1-shot”),而我们对OpenHands的评估是0-shot。由于HumanEvalFix由人类创建且所有缺陷均经过仔细验证,
| Agent | Model | Success Rate (%) | $ Avg. Cost |
| SWE-Agent (Yang et al., 2024) | SWE-Bench Lite (Jimenez et al., 2024), 300 instances, w/o Hint | ||
| AutoCodeRover (Zhang et al., 2024b) | gpt-4-1106-preview | 18.0 | 1.67 |
| Aider (Gauthier) | gpt-4-0125-preview | 19.0 | - |
| gpt-4-0& claude-3-opus | 26.3 | - | |
| OH CodeActAgent v1.8 | gpt-4-0-mini-2024-07-18 | 7.0 | 0.01 |
| gpt-4-0-2024-05-13 | 22.0 | 1.72 | |
| claude-3-5-sonnet@20240620 | 26.0 | 1.10 | |
| HumanEvalFix (Muennighoff et al., 2024), 164 instances | |||
| Prompting, 0-shot | BLOOMZ-176B | 16.6 | - |
| OctoCoder-15B | 30.4 | - | |
| DeepSeekCoder-33B-Instruct | 47.5 | - | |
| StarCoder2-15B | 48.6 | - | |
| SWE-agent, 1-shot (Yang et al., 2024) | gpt-4-turbo | 87.7 | - |
| gpt-3.5-turbo-16k-0613 | 20.1 | 0.11 | |
| OH CodeActAgent v1.5, Generalist, 0-shot. | gpt-4-0-2024-05-13 | 79.3 | 0.14 |
| BIRD (Li et al., 2023b), 300 instances | |||
| Prompting, 0-shot | CodeLlama-7B-Instruct | 18.3 | - |
| CodeQwen-7B-Chat | 31.3 | - | |
| OH CodeActAgent v1.5 | gpt-4-1106-preview | 42.7 | 0.19 |
| gpt-4-0-2024-05-13 | 47.3 | 0.11 | |
| ML-Bench (Tang et al., 2024b),68 个实例 | |||
| 提示 + BM25,0-shot | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 22.1 | - | |
| gpt-4-0-2024-05-13 | 26.2 | - | |
| SWE-Agent (Yang et al., 2024) | gpt-4-1106-preview | 42.6 | 1.91 |
| Aider (Gauthier) | gpt-4-0-2024-05-13 | 64.4 | - |
| gpt-4-0-2024-05-13 | 76.5 | 0.25 | |
| gpt-4-1106-preview | 58.8 | 1.22 | |
| gpt-3.5-turbo-16k-0613 | 13.2 | 0.12 | |
| BioCoder (Python) (Tang et al., 2024b),157 个实例 | |||
| 提示,0-shot | gpt-3.5-turbo | 11.0 | - |
| gpt-4-1106-preview | 12.7 | - | |
| OH CodeActAgent v1.5 | gpt-4-0-2024-05-13 | 27.5 | 0.13 |
| gpt-4-0-2024-05-13 | 8.7 | - | |
| gpt-4-0-2014 | 21.2 | - | |
| gpt-3.5-turbo-0301 | 29.7 | - | |
| llama-7b | 75.0 | - | |
| gpt-3.5-turbo-0125 | 21.6 | 0.002 | |
| gpt-4-0-2024-05-13 | 36.4 | 0.04 | |
| ToolQA (Zhuang et al., 2024),800 个实例 | |||
| 提示,0-shot | ChatGPT + CoT | 5.1 | - |
| ChatGPT | 5.6 | - | |
| Chameleon | 10.6 | - | |
| ReAct,0-shot(Yao 等,2023;OpenAI,2024a) | gpt-3.5-turbo | 36.8 | - |
| gpt-3 | 43.1 | - | |
| gpt-3.5-turbo-0125 | 2.3 | 0.03 | |
| gpt-4-0-2024-05-13 | 47.2 | 0.91 |
在该基准上达到是完全可行的,我们希望在OpenHands的未来迭代中实现这一目标。
ML-Bench(Tang et al., 2024b)评估智能体在18个GitHub仓库中解决机器学习任务的能力。该基准包含跨越169个多样化ML问题的9,641个任务,要求智能体根据用户指令生成bash脚本或Python代码。在沙盒环境中,智能体可以迭代执行命令并接收反馈,使其能够理解仓库上下文并逐步满足用户需求。遵循原论文的设置,我们在ML-Bench的四分之一子集上进行智能体评估。
Gorilla APIBench(Patil et al., 2023)评估智能体使用API的能力。它包含TorchHub、TensorHub和HuggingFace上的任务。在评估过程中,模型会收到与API使用相关的问题,例如“识别一个能够将录音中的口语转换为文本的API”。正确性根据模型的API调用是否处于正确领域来评估。
ToolQA(Zhuang et al., 2024)评估智能体使用外部工具的能力。该基准包含涉及航班状态、咖啡价格、Yelp数据和Airbnb数据等各种主题的任务,需要使用文本工具、数据库工具、数学工具、图工具、代码工具和系统工具等多种工具。它具有两个难度级别:简单和困难。简单问题更侧重于单一工具的使用,而困难问题则强调推理。我们采用简单子集进行评估。
BioCoder(Tang et al., 2024c)是一个仓库级代码生成基准,用于评估智能体在生物信息学相关任务上的表现,特别是检索并准确利用上下文的能力。原始提示包含代码的相关上下文;然而,在本研究中,我们移除了这些内容,以展示OpenHands在多轮交互中执行上下文检索、
| Agent | 模型 | 成功率(%) | $ 平均成本 |
| Lemur(Xu 等,2023) | WebArena(Zhou 等,2023a),812 个实例 | ||
| Patel 等(2024) | Lemur-chat-70b | 5.3 | - |
| AutoWebGLM(Lai 等,2024) | 使用自我改进合成数据训练的 72B 模型 | 9.4 | - |
| Auto Eval & Refine(Pan 等,2024) | 使用人类/智能体混合标注训练的 7B 模型 | 18.2 | - |
| GPT-4 + Reflexion,配合 GPT-4V 奖励模型 | 20.2 | - | |
| WebArena Agent(Zhou 等,2023a) | gpt-3.5-turbo | 6.2 | - |
| gpt-4-turbo | 14.4 | - | |
| OH BrowsingAgent v1.0 | gpt-4o-mini-2024-07-18 | 8.5 | 0.01 |
| gpt-4o-2024-05-13 | 14.8 | 0.15 | |
| claude-3-5-sonnet-20240620 | 15.5 | 0.10 | |
| OH CodeActAgent v1.8 | gpt-4o-mini-2024-07-18 | 8.3 | - |
| 通过委托给 BrowsingAgent v1.0 | gpt-4o-2024-05-13 | 14.5 | - |
| claude-3-5-sonnet-20240620 | 15.3 | - | |
| MiniWoB++(Liu 等,2018),125 个环境 | |||
| Workflow Guided Exploration(Liu 等,2018) | 通过环境探索训练的专家模型 | 34.6 | - |
| CC-NET(Humphreys 等,2022) | 通过强化学习和人工标注行为克隆训练的专家模型 | 91.1 | - |
| OH BrowsingAgent v1.0 | gpt-3.5-turbo-0125 | 27.2 | 0.01 |
| gpt-4o-2024-05-13 | 40.8 | 0.05 | |
| OH CodeActAgent v1.8 | gpt-4o-2024-05-13 | 39.8 | - |
自我调试和推理的能力。BioCoder由157个Python函数和50个Java函数组成,每个函数都针对生物信息学中的特定领域,例如蛋白质组学、基因组学和其他专业领域。该基准面向真实世界代码,通过在相关代码已被掩码的现有仓库中生成代码来进行评估。
BIRD(Li et al., 2023b)是一个面向文本到SQL任务(即将自然语言翻译为可执行SQL)的基准,旨在面向真实且大规模的数据库环境。我们从开发集中选择300个样本集成到OpenHands中,并评估执行准确率。此外,我们扩展了设置,允许智能体进行多轮交互以得出最终SQL查询,使其能够通过观察SQL执行结果来修正历史结果。
4.3 网页浏览
我们在表5中报告网页浏览基准的评估结果。
WebArena(Zhou et al., 2023a)是一个自对抗、基于执行的网页智能体基准,允许智能体在完成给定任务时自由选择采取哪条路径。WebArena包含812条人工策划的任务指令,涵盖购物、论坛、开发者平台和内容管理系统等多个领域。结果。从表5中可以看出,我们的BrowsingAgent在使用领域通用提示技术的LLM智能体中取得了有竞争力的性能。
MiniWoB++(Liu et al., 2018)是一个交互式网页基准,内置奖励函数。这些任务在125个不同的极简网页界面上以合成方式初始化。与WebArena不同,这些任务更简单,没有页面变化,需要更少的步骤,并提供低层次的逐步任务指引。请注意,它包含一部分需要视觉能力才能成功解决的环境,许多现有工作选择只关注任务的一个子集(Kim et al., 2024; Li et al., 2023d; Shaw et al., 2023)。尽管如此,我们报告完整集合上的性能,并且只纳入在完整集合上评估的基线。
4.4 杂项辅助
杂项辅助基准的结果报告在表6中。
GAIA(Mialon et al., 2023)评估智能体的通用任务解决技能,涵盖不同的真实世界场景。它要求智能体具备多种能力,包括推理、多模态理解、网页浏览和编码。GAIA由466个策划任务组成,分为三个级别。由于将各种工具与智能体集成的复杂性,搭建GAIA传统上具有挑战性,但OpenHands的基础设施(例如,运行时§2.2、工具§2.3)显著简化了集成。
GPQA(Rein et al., 2023)评估智能体在解决具有挑战性的研究生水平问题时的协调工具使用能力。工具使用(例如Python)和网页搜索通常有助于智能体回答这些问题,因为它们提供了LLM通常无法做到的精确计算,并且能够访问LLM参数化知识库之外的信息。
| Agent | 模型 | 成功率 (%) | $ 平均成本 |
| GAIA (Mialon et al., 2023),L1 验证集,53 个实例 | |||
| AutoGPT (Gravitas, 2023) | gpt-4-turbo | 13.2 | - |
| OH GPTSwarm v1.0 | gpt-4-0125-preview | 30.2 | 0.110 |
| gpt-4-2024-05-13 | 32.1 | 0.050 | |
| GPQA (Rein et al., 2023),diamond 集,198 个实例(其他子集请参阅 §G,表 7) | |||
| 人类 (Rein et al., 2023) | 专家人类 | 81.3 | - |
| 非专家人类 | 21.9 | - | |
| 少样本提示 + 思维链 (Rein et al., 2023) | gpt-3.5-turbo-16k | 29.6 | - |
| gpt-4 | 38.8 | - | |
| OH CodeActAgent v1.8 | claude-3-5-sonnet-20240620 | 52.0 | 0.065 |
| AgentBench (Liu et al., 2023),OS (bash) 子集,144 个实例 | |||
| AgentBench 基线 Agent (Liu et al., 2023) | gpt-4 | 42.4 | - |
| gpt-3.5-turbo | 32.6 | - | |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 57.6 | 0.085 |
| gpt-3.5-turbo-0125 | 11.8 | 0.006 | |
| MINT (Wang et al., 2024b):数学子集,225 个实例 | |||
| MINT 基线 Agent | gpt-4-0613 | 65.8 | - |
| gpt-4-2024-05-13 | 77.3 | 0.070 | |
| OH CodeActAgent v1.5 | gpt-3.5-turbo-16k-0613 | 33.8 | 0.048 |
| MINT (Wang et al., 2024b):代码子集,136 个实例 | |||
| MINT 基线 Agent | 用于理解来源的只读背景(非待翻译源文本): | GPQA(Rein等,2023)评估智能体在解决高难度研究生水平问题时的协同工具使用能力。工具使用(如python)和网络搜索通常有助于智能体回答这些问题,因为它们能提供大语言模型(LLM)往往无法做到的精确计算,并能获取LLM参数化知识库之外的信息。 | AgentBench(Liu等,2023)评估智能体在多轮……中的推理和决策能力。 |
| 待翻译文本: | gpt-4-0613 | 59.6 | |
| - | gpt-4-2024-05-13 | 50.0 | 0.087 |
| OH CodeActAgent v1.5 | |||
| gpt-3.5-turbo-16k-0613 | 5.2 | 0.030 | ProofWriter(Tafjord等,2021),600个实例 |
| 少样本提示 + 思维链(Pan等,2023) | gpt-4 | 68.1 | - |
| Logic-LM(Pan等,2023) | gpt-4 + 符号求解器 | 79.6 | - |
| OH CodeActAgent v1.5 | |||
| gpt-4-2024-05-13 | 78.8 | - | 实体推演竞技场(Zhang等,2024a),200个实例 |
| 零样本提示(Zhang等,2024a) | gpt-4-0314 | 40.0 | |
| - | gpt-3.5-turbo-0613 | 27.0 | - |
| OH CodeActAgent v1.5 | gpt-4-2024-05-13 | 38.0 |
AgentBench(Liu et al., 2023)评估智能体在多轮、开放式生成设置中的推理和决策能力。我们选择了具有144个任务的、基于代码的操作系统(OS)子集。OpenHands中的智能体以多轮方式使用bash命令直接与特定任务的OS交互,结合交互与推理来自动完成任务。
MINT(Wang et al., 2024b)是一个基准,旨在评估智能体通过多轮交互、使用工具以及由GPT-4模拟的自然语言反馈来解决具有挑战性任务的能力。我们使用Yuan et al. (2024)中使用的编码和数学子集。我们遵循原论文,允许智能体最多进行五轮交互,并有两次提出解决方案的机会。
ProofWriter(Tafjord et al., 2021)是一个合成数据集,用于评估LLM的演绎推理能力。与Logic-LM(Pan et al., 2023)相同,我们关注最具挑战性的子集,其中包含600个需要5跳推理的实例。为了尽量减少语义解析中潜在错误的影响,我们使用Logic-LM提供的逻辑形式。
实体推演竞技场(EDA)(Zhang et al., 2024a)评估智能体通过策略性提问推断未知实体的能力,类似于“20个问题”游戏。该基准测试智能体在多轮对话中的状态跟踪、策略规划和归纳推理能力。我们评估两个数据集“Things”和“Celebrities”,每个包含100个实例,并报告这两个数据集的平均成功率。
5 结论
我们介绍了OpenHands,一个社区驱动的平台,能够支持开发通过软件界面与世界交互的智能体。通过提供强大的交互机制、安全的沙盒环境、必要的智能体技能、多智能体协作能力以及全面的评估框架,OpenHands加速了智能体AI系统的研究创新和真实世界应用。尽管在开发安全可靠的智能体方面仍存在挑战(\$A),但我们对充满活力的社区感到兴奋,并期待OpenHands的持续演进。
参考文献
Michael Ahn, Anthony Brohan, Noah Brown, Yevgen Chebotar, Omar Cortes, Byron David, Chelsea Finn, Chuyuan Fu, Keerthana Gopalakrishnan, Karol Hausman, 等. Do as i can, not as i say: Grounding language in robotic affordances. arXiv preprint arXiv:2204.01691, 2022. 1
Daniil A Boiko, Robert MacKnight, Ben Kline, 和 Gabe Gomes. Autonomous chemical research with large language models. Nature, 624(7992):570- 578, 2023. 1
Yupeng Chang, Xu Wang, Jindong Wang, Yuan Wu, Linyi Yang, Kaijie Zhu, Hao Chen, Xiaoyuan Yi, Cunxiang Wang, Yidong Wang, 等. A survey on evaluation of large language models. ACM Transactions on Intelligent Systems and Technology, 15(3):1- 45, 2024. 1
Harrison Chase. LangChain, October 2022. URL https://github.com/langchain- ai/langchain. 4, 6, 18
Guangyao Chen, Siwei Dong, Yu Shu, Ge Zhang, Jaward Sesay, Borje F. Karlsson, Jie Fu, 和 Yemin Shi. Autoagents: A framework for automatic agent generation, 2024. 1, 6, 18
Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, 等. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021. 7
Cognition.ai. Introducing devin, the first ai software engineer. URL https://www.cognition.ai/blog/introducing- devin. 2
CrewAI. CrewAI, October 2024. URL https://github.com/crewAIInc/crewAI. 18
Jiaxi Cui, Zongjian Li, Yang Yan, Bohua Chen, and Li Yuan. Chatlaw: 集成了外部知识库的开源法律大型语言模型, 2023. 18
Alexandre Drouin, Maxime Gasse, Massimo Caccia, Issam H. Laradji, Manuel Del Verme, Tom Marty, Léo Boisvert, Megh Thakkar, Quentin Cappart, David Vazquez, Nicolas Chapados, and Alexandre Lacoste. Workarena: 网络智能体在解决常见知识工作任务方面的能力如何?, 2024. 3, 4
Paul Gauthier. aider 如何在 swe bench lite 上取得 26.3% 的 sota i aider。https://aider.chat/2024/05/22/ swe- bench- lite.html。访问日期:2024- 06- 05。5, 7, 8
Significant Gravitas. Auto- gpt: 一项自主 gpt- 4 实验, 2023。URL https://github.com/Significant- Gravitas/Auto- GPT, 2023。6, 7, 10, 18
Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Jinlin Wang, Ceyao Zhang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, et al. Metagpt: 面向多智能体协作框架的元编程。In The Twelfth International Conference on Learning Representations, 2023。1, 6, 18
Dong Huang, Qingwen Bu, Jie M. Zhang, Michael Luck, and Heming Cui. Agentcoder: 基于多智能体并带有迭代测试与优化的代码生成, 2024。19
Peter C Humphreys, David Raposo, Tobias Pohlen, Gregory Thornton, Rachita Chhaparia, Alistair Muldal, Josh Abramson, Petko Georgiev, Adam Santoro, and Timothy Lillicrap. 一种用于学习控制计算机的数据驱动方法。In International Conference on Machine Learning, pp. 9466- 9482. PMLR, 2022。9
IPython. Jupyter 与 IPython 的未来 — IPython。URL https://ipython.org。4
Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts。arXiv preprint arXiv:2401.04088, 2024。1
Carlos E Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik R Narasimhan. SWE- bench: 语言模型能够解决现实世界中的 Github 问题吗?In The Twelfth International Conference on Learning Representations, 2024。URL https://openreview.net/forum?id=VTF8yNQM66。1, 6, 7, 8, 17, 19
Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy: 将声明式语言模型调用编译为自我改进的流水线。2024。18
Geunwoo Kim, Pierre Baldi, and Stephen McAleer. 语言模型能够解决计算机任务。Advances in Neural Information Processing Systems, 36, 2024。9
Hanyu Lai, Xiao Liu, Iat Long Iong, Shuntian Yao, Yuxuan Chen, Pengbo Shen, Hao Yu, Hanchen Zhang, Xiaohan Zhang, Yuxiao Dong, et al. Autowebglm: 引导并强化基于大型语言模型的网页导航智能体。arXiv preprint arXiv:2404.03648, 2024。7, 9
Hareton K. N. Leung and Lee J. White. 集成层面的集成测试与软件回归研究。In Proceedings of the Conference on Software Maintenance, ICSM 1990, San Diego, CA, USA, 26- 29 November, 1990, pp. 290- 301. IEEE, 1990。doi: 10.1109/ICSM.1990.131377。URL https://doi.org/10.1109/ICSM.1990.131377。19
Guohao Li, Hasan Abed Al Kader Hammoud, Hani Itani, Dmitrii Khizbullin, and Bernard Ghanem. Camel: 面向大规模语言模型社会“心智”探索的交流型智能体。arXiv preprint arXiv:2303.17760, 2023a。18
Jinyang Li, Binyuan Hui, GE QU, Jiaxi Yang, Binhua Li, Bowen Li, Bailin Wang, Bowen Qin, Ruiying Geng, Nan Huo, Xuanhe Zhou, Chenhao Ma, Guoliang Li, Kevin Chang, Fei Huang, Reynold Cheng, and Yongbin Li. LLM 已经能够充当数据库接口吗?一个面向大规模数据库 grounded text- to- SQLs 的 Blg 基准。In Thirty- seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023b。6, 8, 9, 17
Raymond Li, Loubna Ben Allal, Yangtian Zi, Niklas Muennighoff, Denis Kocetkov, Chenghao Mou, Marc Marone, Christopher Akiki, Jia Li, Jenny Chim, Qian Liu, Evgenii Zheltonozhskii, Terry Yue Zhuo, Thomas Wang, Olivier Dehaene, Mishig Davaadorj, Joel Lamy- Poirier, Joao Monteiro, Oleh Shliazhko, Nicolas Gontier, Nicholas Meade, Armel Zebaze, Ming- Ho Yee, Logesh Kumar Umapathi, Jian Zhu, Benjamin Lipkin, Muhtasham Oblokulov, Zhiruo Wang, Rudra Murthy, Jason Stillerman, Siva Sankalp Patel, Dmitry Abulkhanov, Marco Zocca, Manan Dey, Zhihan Zhang, Nour Fahmy, Urvashi Bhattacharyya, Wenhao Yu, Swayam Singh, Sasha Luccioni, Paulo Villegas, Maxim Kunakov, Fedor Zhdanov, Manuel Romero, Tony Lee, Nadav Timor, Jennifer Ding, Claire Schlesinger, Hailey Schoelkopf, Jan Ebert, Tri Dao, Mayank Mishra, Alex Gu, Jennifer Robinson, Carolyn Jane Anderson, Brendan Dolan- Gavitt, Danish Contractor, Siva Reddy, Daniel Fried, Dzmitry Bahdanau, Yacine Jernite, Carlos Munoz Ferrandis, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, and Harm de Vries. Starcoder: 愿源码与你同在!, 2023c。URL https://arxiv.org/abs/2305.06161。7
Tao Li, Gang Li, Zhiwei Deng, Bryan Wang, and Yang Li. 一种用于计算机控制的零样本语言智能体与结构化反思。arXiv preprint arXiv:2310.08740, 2023d。9
Evan Zheran Liu, Kelvin Guu, Panupong Pasupat, Tianlin Shi, and Percy Liang. 使用工作流引导探索在网页界面上进行强化学习。In International Conference on Learning Representations (ICLR), 2018。URL https://arxiv.org/abs/1802.08802。6, 9, 17
Xiao Liu, Hao Yu, Hanchen Zhang, Yifan Xu, Xuanyu Lei, Hanyu Lai, Yu Gu, Hangliang Ding, Kaiwen Men, Kejuan Yang, Shudan Zhang, Xiang Deng, Aohan Zeng, Zhengxiao Du, Chenhui Zhang, Sheng Shen, Tianjun Zhang, Yu Su, Huan Sun, Minlie Huang, Yuxiao Dong, and Jie Tang. Agentbench: 将 llms 作为智能体进行评估。arXiv preprint arXiv: 2308.03688, 2023。6, 10, 17
Anton Lozhkov, Raymond Li, Loubna Ben Allal, Federico Cassano, Joel Lamy- Poirier, Nouamane Tazi, Ao Tang, Dmytro Pykhtar, Jiawei Liu, Yuxiang Wei, Tianyang Liu, Max Tian, Denis Kocetkov, Arthur Zucker, Younes Belkada, Zijian Wang, Qian Liu, Dmitry Abulkhanov, Indraneil Paul, Zhuang Li, Wen- Ding Li, Megan Risdal, Jia Li, Jian Zhu, Terry Yue Zhuo, Evgenii Zheltonozhskii, Nii Osae Osae Dade, Wenhao Yu, Lucas Krauß, Naman Jain, Yixuan Su, Xuanli He, Manan Dey, Edoardo Abati, Yekun Chai, Niklas Muennighoff, Xiangru Tang, Muhtasham Oblokulov, Christopher Akiki, Marc Marone, Chenghao Mou, Mayank Mishra, Alex Gu, Binyuan Hui, Tri Dao, Armel Zebaze, Olivier Dehaene, Nicolas Patry, Canwen Xu, Julian McAuley, Han Hu, Torsten Scholak, Sebastien Paquet, Jennifer Robinson, Carolyn Jane Anderson, Nicolas Chapados, Mostofa Patwary, Nima Tajbakhsh, Yacine Jernite, Carlos Muñoz Ferrandis, Lingming Zhang, Sean Hughes, Thomas Wolf, Arjun Guha, Leandro von Werra, and Harm de Vries. Starcoder 2 与 the stack v2:下一代, 2024。URL https://arxiv.org/abs/2402.19173。7
Grégoire Mialon、Clémentine Fourrier、Craig Swift、Thomas Wolf、Yann LeCun 和 Thomas Scialom。GAIA:通用 AI 助手的基准。CoRR,abs/2311.12983,2023。doi:10.48550/ARXIV.2311.12983。URL https://doi.org/10.48550/arXiv.2311.12983。6、9、10、17
Mozilla。无障碍树 - MDN Web 文档术语表:Web 相关术语的定义 | MDN。URL https://developer.mozilla.org/en-US/docs/Glossary/Accessibility_tree。5
Niklas Muennighoff、Qian Liu、Armel Zebaze、Qinkai Zheng、Binyuan Hui、Terry Yue Zhuo、Swayam Singh、Xiangru Tang、Leandro von Werra 和 Shayne Longpre。Octopack:指令调优代码大语言模型,2024。6、7、8、17
Y Nakajima。Babyagi。URL https://github.com/yoheinakajima/babyagi,2023。18
OpenAI。Chatgpt:2024 年 5 月版本。https://www.openai.com/chatgpt,2024a。访问时间:2024-05-29。8、18
OpenAI。Hello gpt-4o。https://openai.com/index/hello-gpt-4o/,2024b。访问时间:2024-05-15。1
OpenAI. Hello gpt-4o. https://openai.com/index/hello-gpt-4o/,2024b。访问日期:2024-05-15。1OpenAI、Josh Achiam、Steven Adler、Sandhini Agarwal、Lama Ahmad、Ilge Akkaya、Florencia Leoni Aleman、Diogo Almeida、Janko Altenschmidt、Sam Altman、Shyamal Anadkat、Red Avila、Igor Babuschkin、Suchir Balaji、Valerie Balcom、Paul Baltescu、Haiming Bao、Mohammad Bavarian、Jeff Belgum、Irwan Bello、Jake Berdine、Gabriel Bernadett-Shapiro、Christopher Berner、Lenny Bogdonoff、Oleg Boiko、Madelaine Boyd、Anna-Luisa Brakman、Greg Brockman、Tim Brooks、Miles Brundage、Kevin Button、Trevor Cai、Rosie Campbell、Andrew Cann、Brittany Carey、Chelsea Carlson、Rory Carmichael、Brooke Chan、Che Chang、Fotis Chantzis、Derek Chen、Sully Chen、Ruby Chen、Jason Chen、Mark Chen、Ben Chess、Chester Cho、Casey Chu、Hyung Won Chung、Dave Cummings、Jeremiah Currier、Yunxing Dai、Cory Decareaux、Thomas Degry、Noah Deutsch、Damien Deville、Arka Dhar、David Dohan、Steve Dowling、Sheila Dunning、Adrien Ecoffet、Atty Eleti、Tyna Eloundou、David Farhi、Liam Fedus、Niko Felix、Simón Posada Fishman、Juston Forte、Isabella Fulford、Leo Gao、Elie Georges、Christian Gibson、Vik Goel、Tarun Gogineni、Gabriel Goh、Rapha Gontijo-Lopes、Jonathan Gordon、Morgan Grafstein、Scott Gray、Ryan Greene、Joshua Gross、Shixiang Shane Gu、Yufei Guo、Chris Hallacy、Jesse Han、Jeff Harris、Yuchen He、Mike Heaton、Johannes Heidecke、Chris Hesse、Alan Hickey、Wade Hickey、Peter Hoeschele、Brandon Houghton、Kenny Hsu、Shengli Hu、Xin Hu、Joost Huizinga、Shantanu Jain、Shawn Jain、Joanne Jang、Angela Jiang、Roger Jiang、Haozhun Jin、Denny Jin、Shino Jomoto、Billie Jonn、Heewoo Jun、Tomer Kaftan、Łukasz Kaiser、Ali Kamali、Ingmar Kanitscheider、Nitish Shirish Keskar、Tabarak Khan、Logan Kilpatrick、Jong Wook Kim、Christina Kim、Yongjik Kim、Jan Hendrik Kirchner、Jamie Kiros、Matt Knight、Daniel Kokotajlo、Łukasz Kondraciuk、Andrew Kondrich、Aris Konstantinidis、Kyle Kosic、Gretchen Krueger、Vishal Kuo、Michael Lampe、Iki Lan、Teddy Lee、Jan Leike、Jade Leung、Daniel Levy、Chak Ming Li、Rachel Lim、Molly Lin、Stephanie Lin、Mateusz Litwin、Theresa Lopez、Ryan Lowe、Patricia Lue、Anna Makanju、Kim Malfacini、Sam Manning、Todor Markov、Yaniv Markovski、Bianca Martin、Katie Mayer、Andrew Mayne、Bob McGrew、Scott Mayer McKinney、Christine McLeavey、Paul McMillan、Jake McNeil、David Medina、Aalok Mehta、Jacob Menick、Luke Metz、Andrey Mishchenko、Pamela Mishkin、Vinnie Monaco、Evan Morikawa、Daniel Mossing、Tong Mu、Mira Murati、Oleg Murk、David Mély、Ashvin Nair、Reiichiro Nakano、Rajeev Nayak、Arvind Neelakantan、Richard Ngo、Hyeonwoo Noh、Long Ouyang、Cullen O'Keefe、Jakub Pachocki、Alex Paino、Joe Palermo、Ashley Pantuliano、Giambattista Parascandolo、Joel Parish、Emy Parparita、Alex Passos、Mikhail Pavlov、Andrew Peng、Adam Perelman、Filipe de Avila Belbute Peres、Michael Petrov、Henrique Ponde de Oliveira Pinto、Michael、Pokorny、Michelle Pokrass、Vitchyr H. Pong、Tolly Powell、Alethea Power、Boris Power、Elizabeth Proehl、Raul Puri、Alec Radford、Jack Rae、Aditya Ramesh、Cameron Raymond、Francis Real、Kendra Rimbach、Carl Ross、Bob Rotsted、Henri Roussez、Nick Ryder、Mario Saltarelli、Ted Sanders、Shibani Santurkar、Girish Sastry、Heather Schmidt、David Schnurr、John Schulman、Daniel Selsam、Kyla Sheppard、Toki Sherbakov、Jessica Shieh、Sarah Shoker、Pranav Shyam、Szymon Sidor、Eric Sigler、Maddie Simens、Jordan Sitkin、Katarina Slama、Ian Sohl、Benjamin Sokolowsky、Yang Song、Natalie Staudacher、Felipe Petroski Such、Natalie Summers、Ilya Sutskever、Jie Tang、Nikolas Tezak、Madeleine B. Thompson、Phil Tillet、Amin Tootoonchian、Elizabeth Tseng、PrestonTuggle、Nick Turley、Jerry Tworek、Juan Felipe Cerón Uribe、Andrea Vallone、Arun Vijayvergiya、Chelsea Voss、Carroll Wainwright、Justin Jay Wang、Alvin Wang、Ben Wang、Jonathan Ward、Jason Wei、CJ Weinmann、Akila Welihinda、Peter Welinder、Jiayi Weng、Lilian Weng、Matt Wiethoff、Dave Willner、Clemens Winter、Samuel Wolrich、Hannah Wong、Lauren Workman、Sherwin Wu、Jeff Wu、Michael Wu、Kai Xiao、Tao Xu、Sarah Yoo、Kevin Yu、Qiming Yuan、Wojciech Zaremba、Rowan Zellers、Chong Zhang、Marvin Zhang、Shengjia Zhao、Tianhao Zheng、Juntang Zhuang、William Zhuk 和 Barret Zoph。Gpt-4 技术报告,2024。18
Jiayi Pan、Yichi Zhang、Nicholas Tomlin、Yifei Zhou、Sergey Levine 和 Alane Suhr。数字代理的自主评估与改进。arXiv 预印本 arXiv:2404.06474,2024。7,9,18
Liangming Pan、Alon Albalak、Xinyi Wang 和 William Yang Wang。Logic-Im:用符号求解器赋能大型语言模型以实现忠实的逻辑推理。arXiv 预印本 arXiv:2305.12295,2023。10
Joon Sung Park、Joseph C. O'Brien、Carrie J. Cai、Meredith Ringel Morris、Percy Liang 和 Michael S. Bernstein。生成式代理:人类行为的交互式模拟,2023。18
Ajay Patel、Markus Hofmarcher、Claudiu Leoveanu-Condrei、Marius-Constantin Dinu、Chris Callison-Burch 和 Sepp Hochreiter。大型语言模型可在网络代理任务中自我改进。arXiv 预印本 arXiv:2405.20309,2024。7,9
Shishir G. Patil、Tianjun Zhang、Xin Wang 和 Joseph E. Gonzalez。Gorilla:与海量 API 连接的大型语言模型。arXiv 预印本 arXiv:2305.15334,2023。6,8,17
Playwright。面向现代 Web 应用的快速可靠端到端测试 | Playwright。URL https://playwright.dev/。4
Chen Qian、Xin Cong、Wei Liu、Cheng Yang、Weize Chen、Yusheng Su、Yufan Dang、Jiahao Li、Juyuan Xu、Dahai Li、Zhiyuan Liu 和 Maosong Sun。用于软件开发的通信代理,2023。18,19
Yujia Qin、Shihao Liang、Yining Ye、Kunlun Zhu、Lan Yan、Yaxi Lu、Yankai Lin、Xin Cong、Xiangru Tang、Bill Qian、Sihan Zhao、Runchu Tian、Ruobing Xie、Jie Zhou、Mark Gerstein、Dahai Li、Zhiyuan Liu 和 Maosong Sun。Toolllm:帮助大型语言模型掌握 16000+ 真实世界 API。CoRR,abs/2307.16789,2023。doi: 10.48550/ARXIV.2307.16789。URL https://doi.org/10.48550/arXiv.2307.16789。4
David Rein、Betty Li Hou、Asa Cooper Stickland、Jackson Petty、Richard Yuanzhe Pang、Julien Dirani、Julian Michael 和 Samuel R Bowman。GPQA:一个研究生级别、Google 无法轻易搜索到答案的问答基准。arXiv 预印本 arXiv:2311.12022,2023。6,7,9,10,17,23
Aman Sanger。近乎即时的全文件编辑。https://www.cursor.com/blog/instant-apply。访问日期:2024-06-05。5
ServiceNow。BrowserGym:面向 Web 任务自动化的 Gym 环境。URL https://github.com/ServiceNow/BrowserGym。2,4,18
Peter Shaw、Mandar Joshi、James Cohan、Jonathan Berant、Panupong Pasupat、Hexiang Hu、Urvashi Khandelwal、Kenton Lee 和 Kristina N Toutanova。从像素到 UI 操作:学习通过图形用户界面遵循指令。Advances in Neural Information Processing Systems,36:34354-34370,2023。9
Noah Shinn、Federico Cassano、Ashwin Gopinath、Karthik Narasimhan 和 Shunyu Yao。Reflexion:具有语言强化学习的语言代理。Advances in Neural Information Processing Systems,36,2024。18
Øyvind Tafjord、Bhavana Dalvi 和 Peter Clark。《ProofWriter:在自然语言上生成蕴含、证明和溯因陈述》。载于 Chengqing Zong、Fei Xia、Wenjie Li 和 Roberto Navigli(编),《计算语言学协会研究发现:ACL-IJCNLP 2021》,第 3621-3634 页,在线,2021 年 8 月。计算语言学协会。doi: 10.18653/v1/2021.findings-acl.317。URL https://aclanthology.org/2021.findings-acl.317。6, 10, 17
Xiangru Tang、Qiao Jin、Kunlun Zhu、Tongxin Yuan、Yichi Zhang、Wangchunshu Zhou、Meng Qu、Yilun Zhao、Jian Tang、Zhuosheng Zhang 等。《优先保障而非自主:LLM 智能体用于科学研究的风险》。arXiv 预印本 arXiv:2402.04247,2024a。1
Xiangru Tang、Yuliang Liu、Zefan Cai、Yanjun Shao、Junjie Lu、Yichi Zhang、Zexuan Deng、Helan Hu、Kaikai An、Ruijun Huang、Shuzheng Si、Sheng Chen、Haozhe Zhao、Liang Chen、Yan Wang、Tianyu Liu、Zhiwei Jiang、Baobao Chang、Yin Fang、Yujia Qin、Wangchunshu Zhou、Yilun Zhao、Arman Cohan 和 Mark Gerstein。ML-Bench:评估大型语言模型和智能体在仓库级代码上的机器学习任务,2024b。URL https://arxiv.org/abs/2311.09835。6, 8, 17
唐祥如、Bill Qian、Rick Gao、陈家康、陈心云和Mark B Gerstein。BioCoder:一个用于大语言模型生物信息学代码生成的基准。Bioinformatics,40(Supplement_1):i266-i276,2024c年6月。ISSN 1367-4811。6,8,17
唐祥如、邹安妮、张卓胜、李子明、赵一伦、张星耀、Arman Cohan和Mark Gerstein。Medagents:大语言模型作为零样本医学推理的协作者,2024d。18
Gemini团队、Rohan Anil、Sebastian Borgeaud、吴永辉、Jean-Baptiste Alayrac、余家辉、Radu Soricut、Johan Schalkwyk、Andrew M Dai、Anja Hauth等。Gemini:一个能力极强的多模态模型家族。arXiv预印本arXiv:2312.11805,2023。1
XAgent团队。Xagent:一个用于复杂任务求解的自主智能体,2023。6,18
Hugo Touvron、Thibaut Lavril、Gautier Izacard、Xavier Martinet、Marie-Anne Lachaux、Timothée Lacroix、Baptiste Rozière、Naman Goyal、Eric Hambro、Faisal Azhar、Aurelien Rodriguez、Armand Joulin、Edouard Grave和Guillaume Lample。Llama:开放且高效的基础语言模型。arXiv预印本arXiv:2302.13971,2023。8
王星耀、陈阳逸、袁立凡、张亦哲、李韵竹、彭浩和Heng Ji。可执行代码动作能激发更好的LLM智能体。载于ICML,2024a。2,3,4,5,17
王星耀、王梓涵、刘嘉腾、陈阳逸、袁立凡、彭浩和Heng Ji。MINT:在与工具和语言反馈的多轮交互中评估LLM。载于ICLR,2024b。6,10,17
吴青云、Gagan Bansal、张洁玉、吴逸然、张少坤、Erkang Zhu、Beibin Li、蒋丽、张笑云和Chi Wang。Autogen:通过多智能体对话框架实现下一代LLM应用。arXiv预印本arXiv:2308.08155,2023。1,6,18
Chunqiu Steven Xia、邓胤林、Soren Dunn和张 Lingming。Agentless:揭开基于LLM的软件工程智能体的神秘面纱。arXiv预印本,2024。7
谢天宝、周帆、程周骏、石鹏、翁洛轩、刘一涛、Toh Jing Hua、赵俊宁、刘倩、车刘等。Openagents:一个面向真实环境中语言智能体的开放平台。arXiv预印本arXiv:2310.10634,2023。6
徐一恒、苏宏锦、陈星、米博宇、刘倩、石维佳、惠斌元、周帆、刘一涛、谢天宝等。Lemur:协调语言智能体的自然语言与代码。arXiv预印本arXiv:2310.06830,2023。7,9
John Yang、Carlos E. Jimenez、Alexander Wettig、Kilian Lieret、姚顺宇、Karthik Narasimhan和Ofir Press。Swe-agent:智能体-计算机接口实现自动化软件工程,2024。2,5,6,7,8,19
姚顺宇、Jeffrey Zhao、余典、杜楠、Izhak Shafran、Karthik R Narasimhan和曹原。React:在语言模型中协同推理与行动。载于第十一届国际学习表征会议,2023。URL https://openreview.net/forum?id=WE_vluYUL-X。8
叶一宁、丛鑫、田世卓、曹建楠、王浩、秦宇佳、陆雅茜、于禾阳、王华栋、林彦凯等。Proagent:从机器人流程自动化到智能体流程自动化。arXiv预印本arXiv:2311.10751,2023。18。
袁立凡、陈阳逸、王星耀、Yi R. Fung、彭浩和Heng Ji。CRAFT:通过从专用工具集中创建和检索来自定义LLM。CoRR,abs/2309.17428,2023。doi: 10.48550/ARXIV.2309.17428。URL https://doi.org/10.48550/arXiv.2309.17428。4
袁立凡、崔甘泉、王汉斌、丁宁、王星耀、邓嘉、单博吉、陈慧敏、谢若冰、林彦凯、刘正浩、周博文、彭浩、刘知远和孙茂松。用偏好树推进LLM推理通才,2024。10
张亦哲、Jiarui Lu和Navdeep Jaitly。通过20问游戏探究LLM的多轮规划能力。2024a。6,10,17
张云彤、阮海峰、范志宇和Abhik Roychoudhury。Autocoderover:自主程序改进,2024b。6,7,8,19
周书妍、Frank F Xu、朱浩、周栩辉、Robert Lo、Abishek Sridhar、程纤依、欧天悦、Yonatan Bisk、Daniel Fried等。Webarena:一个用于构建自主智能体的逼真Web环境。载于第十二届国际学习表征会议,2023a。1,6,7,9,17
周王春树、Yuchen Eleanor Jiang、李龙、吴嘉龙、王天南、邱石、张锦天、陈静、吴睿璞、王帅、朱世丁、陈吉宇、张 Wentao、唐祥如、张宁豫、陈华钧、崔鹏和Mrinmaya Sachan。Agents:一个面向自主语言智能体的开源框架,2023b。6,18
庄宇晨、于悦、王宽、孙浩天和张超。Toolqa:一个用于LLM借助外部工具问答的数据集。Advances in Neural Information Processing Systems,36,2024。6,8,17
Mingchen Zhuge、刘浩哲、Francesco Faccio、Dylan R Ashley、Robert Csordás、Anand Gopalakrishnan、Abdullah Hamdi、Hasan Abed Al Kader Hammoud、Vincent Herrmann、Kazuki Irie等。基于自然语言的心智社会中的思维风暴。arXiv预印本arXiv:2305.17066,2023。18
Mingchen Zhuge、王文逸、Louis Kirsch、Francesco Faccio、Dmitrii Khizbullin和Jurgen Schmidhuber。语言智能体作为可优化图。arXiv预印本arXiv:2402.16823,2024。6,17,18
Albert Örwall。Moatless工具。URL https://github.com/aorwall/moatless-tools。7
作者贡献
这项工作是一项跨多个机构的开源协作成果。我们采用基于积分的系统来确定贡献并授予作者身份,技术贡献以拉取请求(PR)为单位进行跟踪和衡量。王星耀领导了该项目,协调整体开发与论文写作工作。详细贡献如下:
- 智能体开发(§3):王星耀领导了CodeAct Wang等(2024a)和CodeActSWE智能体的实现。Frank F. Xu领导了网页浏览智能体的开发 Zhou等(2023a)。Mingchen Zhuge统筹了GPTSwarm智能体 Zhuge等(2024)的集成。Robert Brennan和李博轩领导了Micro Agent的开发。
- 架构开发(图2):Robert Brennan发起了架构设计。李博轩、Frank F. Xu、王星耀、宋雨凡和郑明章进一步细化和扩展了架构。李博轩实现了集成测试的初始版本(§E),维护了agentskills库(§2.3),管理配置,并解决了评估中的资源泄漏问题。Frank F. Xu开发了用于智能体执行和评估的网页浏览环境(§J),并将其与智能体和前端用户界面集成。王星耀编写了agentskills库和Docker沙箱的初始代码。宋雨凡实现了评估的成本跟踪,而郑明章开发了与镜像无关的Docker沙箱,以实现更稳定的SWE-Bench评估。
- 基准测试、集成和代码审查:李伯轩和宋宇凡领导了基准集成工作,包括协调、评估和代码审查。宋宇凡还帮助跟踪PR贡献。Graham Neubig、王星尧、郑明章、Robert Brennan、Hoang H. Tran、Frank F. Xu、唐向如、李富强和邵彦君在集成和代码审查方面提供了额外支持。具体基准贡献包括:
- SWE-Bench Jimenez et al. (2024):李伯文和王星尧- WebArena Zhou et al. (2023a) 和 MiniWob++ Liu et al. (2018):Frank F. Xu- GAIA Mialon et al. (2023):潘嘉怡(集成)和诸葛明晨(GPTSwarm评估)- API-Bench Patil et al. (2023) 和 ToolQA Zhuang et al. (2024):宋月琪- HumanEvalFix Muennighoff et al. (2024):Niklas Muennighoff和唐向如- ProofWriter Tafjord et al. (2021):马仁- MINT Wang et al. (2024b):Hoang H. Tran- AgentBench Liu et al. (2023):李富强- BIRD Li et al. (2023b):惠彬元- GPQA Rein et al. (2023):Jaskirat Singh- BioCoder Tang et al. (2024c):唐向如和Bill Qian- ML-Bench Tang et al. (2024b):唐向如和邵彦君- Entity-Deduction-Arena Zhang et al. (2024a):张一哲
- 指导:Graham Neubig指导了该项目,提供了指导、资源和大量论文修改。Heng Ji和Hao Peng提供了额外的项目建议,并协助论文写作。林俊旸提供了咨询支持并赞助了资源。
A 局限性与未来工作
我们对活跃社区在 OpenHands 中奠定的基础感到振奋,并期待其持续演进。我们确定了若干未来工作方向:
增强多模态支持。虽然我们当前的实现已通过预定义的智能体技能支持多种文件格式,但我们有兴趣通过标准 IPython 和浏览器集成,以有原则的方式实现多模态,例如通过浏览器使用视觉语言模型查看图像和视频,或用代码处理 XLSX 文件。
更强的智能体。当前的智能体在复杂任务上仍表现不佳,我们有兴趣通过训练和推理时技术构建更好的智能体。
智能体编辑改进。当前智能体在编辑长文件时表现欠佳,我们有兴趣探索不同方法以提升智能体的文件编辑性能。
网页浏览改进。由于 OpenHands 的可扩展特性,能够改进智能体的正交组件可以轻松集成。例如,得益于 OpenHands 的可扩展架构,Auto Eval & Refine Pan et al. (2024)——一种带有 Reflexion Shinn et al. (2024) 提示和任务完成奖励模型的错误重试策略——将作为可选组件附加到我们的浏览智能体上。
自动工作流生成。目前,OpenHands 的工作流仍需要大量手工工作量。我们相信,诸如 GPTSwarm Zhuge et al. (2024) 和 LangGraph Chase (2022) 等基于图的框架可以作为构建智能体的替代方案。特别是在 GPTSwarm 中,当使用图构建智能体时,更容易引入各种优化方法(例如强化学习、元提示)。OpenHands 认为这些方法为未来版本中自动工作流生成的有前景的解决方案奠定了基础。
B 伦理声明
如今大多数 AI 智能体仍属研究产物,缺乏在现实世界中可靠执行复杂、长时程任务的能力。然而,随着其性能持续提升并日益部署于现实世界,它们有潜力提升生产力,同时也对社会构成重大安全风险。OpenHands 通过以下方式帮助降低风险:
(1) 支持对这些智能体进行系统性评估,从而在广泛部署之前识别并解决风险。(2) 促进人机交互,而非允许智能体在没有监督的情况下自主运行。(3) 更重要的是,我们希望 OpenHands 让全球研究人员能够使用最佳的智能体套件,开展前沿安全研究,以构建安全且有帮助的智能体。
C 相关工作
ChatGPT OpenAI (2024a) 和 GPT4 OpenAI et al. (2024) 等大型语言模型(LLM)的突破显著增强了自主智能体在各领域的能力 Ye et al. (2023); Tang et al. (2024d); Park et al. (2023); Cui et al. (2023)。这些进展催生了大量通用智能体提案 Gravitas (2023); Nakajima (2023); Wu et al. (2023),旨在执行多样化的用户任务,并受到了开发者和更广泛受众的关注。Auto-GPT Gravitas (2023) 等著名工作利用 LLM 将用户目标分解为可执行步骤以完成任务。多智能体协作系统利用 LLM 实现角色扮演和任务求解等能力 Zhuge et al. (2023); Li et al. (2023a); Zhou et al. (2023b); Team (2023),其中 MetaGPT Hong et al. (2023) 强调标准化操作流程,AutoGen Wu et al. (2023) 为交互系统提供对话框架。AGENTS Zhou et al. (2023b) 和 AutoAgents Chen et al. (2024) 为可定制智能体架构提供了新范式,而 XAgent Team (2023) 和 GPTSwarm Zhuge et al. (2024) 分别引入了复杂管理系统和可优化图,以增强智能体运行。
智能体开发的激增催生了旨在简化智能体实现的专用框架。LangChain 和 LangGraph Chase (2022) 提供基础构建模块和基本运行时支持,而 CrewAI CrewAI (2024) 专注于编排多智能体通信。BrowserGym ServiceNow 专门面向网页浏览能力,DSPy Khattab et al. (2024) 强调端到端提示优化。AutoGen Wu et al. (2023) 通过实现 Python 和 bash 执行能力超越了基础框架,尽管其命令执行是无状态的;而 CrewAI 等框架提供沙箱化但有限的代码解释器功能。
软件开发是应用基于 LLM 的智能体的先行领域,在促进开发流程的框架方面已取得进展 Hong et al. (2023); Qian et al. (2023)。ChatDev Qian et al. (2023) 等创新以类似瀑布模型的方式自动化软件开发生命周期,AutoCodeRover Zhang et al. (2024b) 通过代码搜索和抽象语法树操作解决 GitHub 问题。AgentCoder Huang et al. (2024) 通过集成测试和反馈迭代改进代码生成,而 SWE-Agent Yang et al. (2024) 集成 LLM 以自动修复 GitHub 问题,简化软件工程。
D 图形用户界面
除了从命令行运行外,OpenHands 还提供丰富的图形用户界面,可视化智能体当前的操作(例如浏览网页、执行基础命令或 Python 代码等),并允许用户实时反馈。UI 截图见图 1。用户可在智能体工作期间的任何时刻中断它,以提供额外反馈、评论或指令。该用户界面直接连接事件流(§2.1)以控制和可视化智能体与运行时,使其与智能体和运行时无关。
E 质量控制:智能体集成测试
集成测试 Leung & White (1990) 长期以来被软件开发者用于确保软件质量。与具有简单输入-输出模式的大型语言模型不同,智能体通常是复杂的软件,开发过程中容易引入细微错误并损害最终任务性能。虽然运行完整套件评估(§4)是衡量性能下降的最终手段,但为每次代码更改运行它们可能过于缓慢且昂贵。4 。在 OpenHands 中,我们开创了一个端到端智能体测试框架,用于测试提示回归、动作和沙箱环境。它结合了软件工程中的集成测试与基础模型模拟以实现确定性行为,防止在智能体开发过程中意外引入缺陷。
定义集成测试。OpenHands 的集成测试框架通过自动化任务执行和结果验证来验证端到端功能。开发者定义任务和预期结果;例如,任务可能涉及纠正名为“bad.txt”文档中的拼写错误。通过 OpenHands 执行任务后,将输出与预定义的“黄金文件”进行比较以确保准确性。
模拟 LLM 以实现确定性行为。为应对大型语言模型(LLM)的非确定性及相关高成本挑战,该框架拦截所有 LLM 调用,并基于精确提示匹配提供预定义响应。此方法不仅确保测试结果的一致性,还通过最小化对真实 LLM 的依赖降低运营成本。
在破坏性变更时重新生成 LLM 响应。提示-响应对通过脚本管理,该脚本在引入新测试或修改现有提示时生成并存储这些对。对于常规测试,框架尝试通过轻微调整提示来复用现有 LLM 响应。影响任务处理的重大变更需要使用真实 LLM 重新生成这些对。
集成测试的优势。该框架具有若干优势,包括:1)提示回归测试:存储的提示-响应对便于变更跟踪,并为新团队成员理解 LLM 交互提供参考;2)多平台支持:测试自动安排在每次拉取请求和主分支提交时运行,跨多个平台、环境和智能体,包括 Linux 和 Mac,以及本地、SSH 和 exec 沙箱;3)全面错误检测:它捕获提示生成、消息传递和沙箱执行中的错误,从而保持高测试覆盖率。
F OpenHands Runtime 的工作原理
F.1 工作流
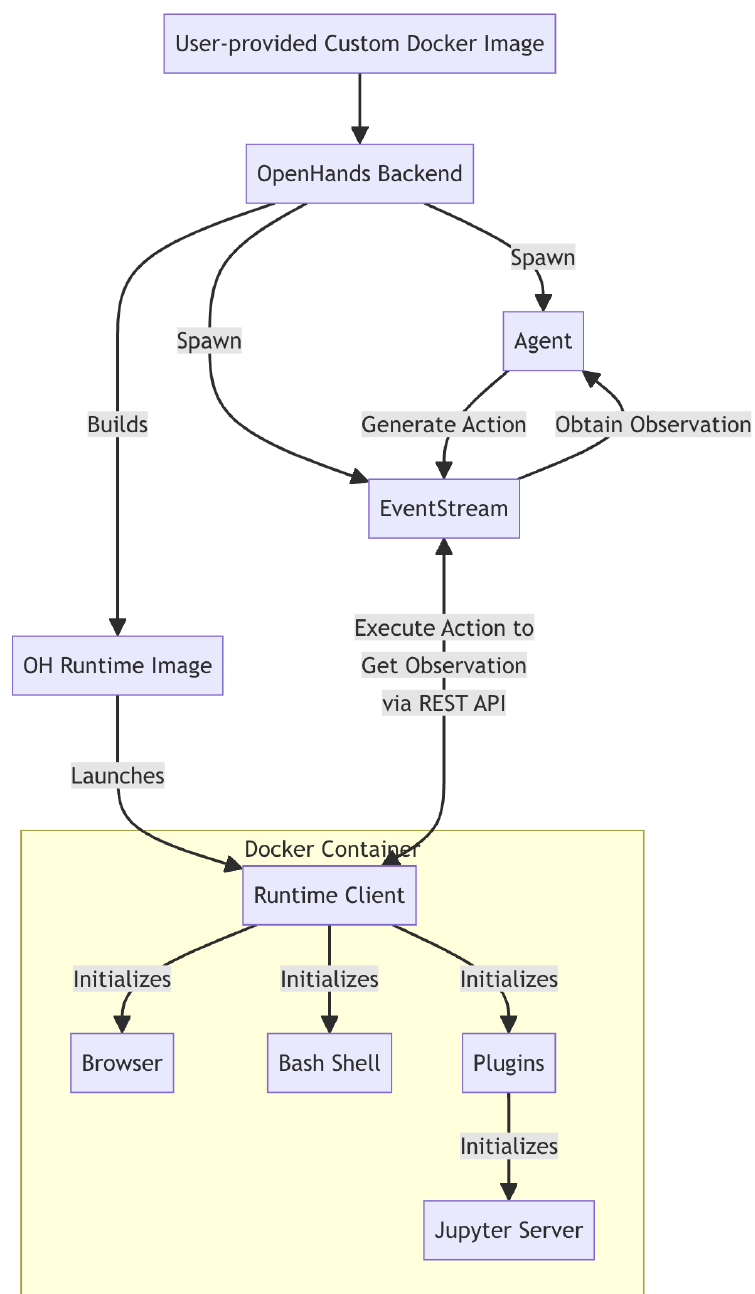
OpenHands Runtime 系统采用基于 Docker 容器实现的客户端-服务器架构。其工作原理概览见图 4。
(1) 用户输入:用户提供自定义基础 Docker 镜像。
(2) 镜像构建:OpenHands 基于用户提供的镜像构建新的 Docker 镜像(“OH runtime 镜像”)。该新镜像包含 OpenHands 特定代码,主要是“runtime 客户端”(即 §2.2 中描述的 runtime API 服务器)。
(3) 容器启动:当 OpenHands 启动时,它使用 OH runtime 镜像启动一个 Docker 容器。
(4) 通信:OpenHands 后端(runtime.py)通过 RESTful API 与 runtime 客户端通信,发送动作并接收观察结果
(5) 动作执行:runtime 客户端从后端接收动作,在沙箱环境中执行它们,并发送回观察结果
(6) 观察返回:客户端将执行结果作为观察结果发送回 OpenHands 后端事件流。
客户端的角色:- 它充当OpenHands后端与沙箱环境之间的中介- 它在容器内安全地执行各类操作(shell命令、文件操作、Python代码等)- 它管理沙箱环境的状态,包括当前工作目录和已加载的插件- 它格式化观测结果并将其返回给后端,确保处理结果时接口的一致性
F.2 OpenHands如何构建和维护运行时镜像
OpenHands在构建和管理运行时镜像方面的方法,确保了为生产环境和开发环境创建和维护Docker镜像时的高效性、一致性和灵活性。
F.2.1 镜像标记系统
OpenHands对其运行时镜像采用双重标记系统,以在可复现性与灵活性之间取得平衡:
(1) 基于哈希的标签:{target_image_repo}:{target_image_hash_tag}。示例:runtime:abc123def456
- 此标签基于Docker构建文件夹的MD5哈希值,该文件夹包含源代码(运行时客户端及相关依赖的源代码)和Dockerfile- 相同的哈希标签保证镜像使用完全相同的源代码和Dockerfile构建- 这确保了可复现性;相同的哈希始终意味着相同的镜像内容
(2) 通用标签:{target_image_repo}:{target_image_tag}。示例:runtime:oh_v0.9.3_ubuntu_tag_22.04
- 此标签遵循以下格式:runtime:oh_v{VERSION}{BASE_IMAGE_tag{IMAGE_TAG}}
- 它代表特定基础镜像与OpenHands版本组合的最新构建
- 每当从相同基础镜像构建新镜像时,即使源代码发生变化,此标签也会更新
基于哈希的标签确保了可复现性,而通用标签则为特定配置的最新版本提供了稳定的引用。这种双重标记方法使OpenHands能够高效地管理开发环境和生产环境。
F.2.2 构建流程
(1) 镜像命名约定:
- 基于哈希的标签:target_image_repo:target_image_hash_tag。示例:runtime:abc123def456
- 通用标签:target_image_repo:target_image_tag。示例:runtime:oh_v0.9.3_ubuntu_tag_22.04
(2) 构建过程:
a. 将基础镜像名称转换为 OH 运行时镜像名称 示例:ubuntu:22.04->runtime:oh_v0.9.3_ubuntu_tag_22.04
b. 生成构建上下文(Dockerfile 和 OpenHands 源代码)并计算其哈希值
c. 检查是否存在具有所计算哈希值的现有镜像
d. 如果未找到,则检查是否有最近的兼容镜像可用作基础
e. 如果不存在兼容镜像,则使用原始基础镜像从头构建
f. 为新镜像同时打上基于哈希的标签和通用标签
(3) 镜像复用与重建逻辑:系统按照以下步骤判断是构建新镜像还是使用用户提供(基础)镜像(例如 ubuntu:22.04)的现有镜像:
a. 如果存在具有相同哈希值的镜像(例如 runtime:abc123def456),则将按原样复用
b. 如果未找到确切的哈希值,系统将尝试使用最新的通用镜像(例如 runtime:oh_v0.9.3_ubuntu_tag_22.04)作为基础进行重建。这通过利用现有依赖项来节省时间
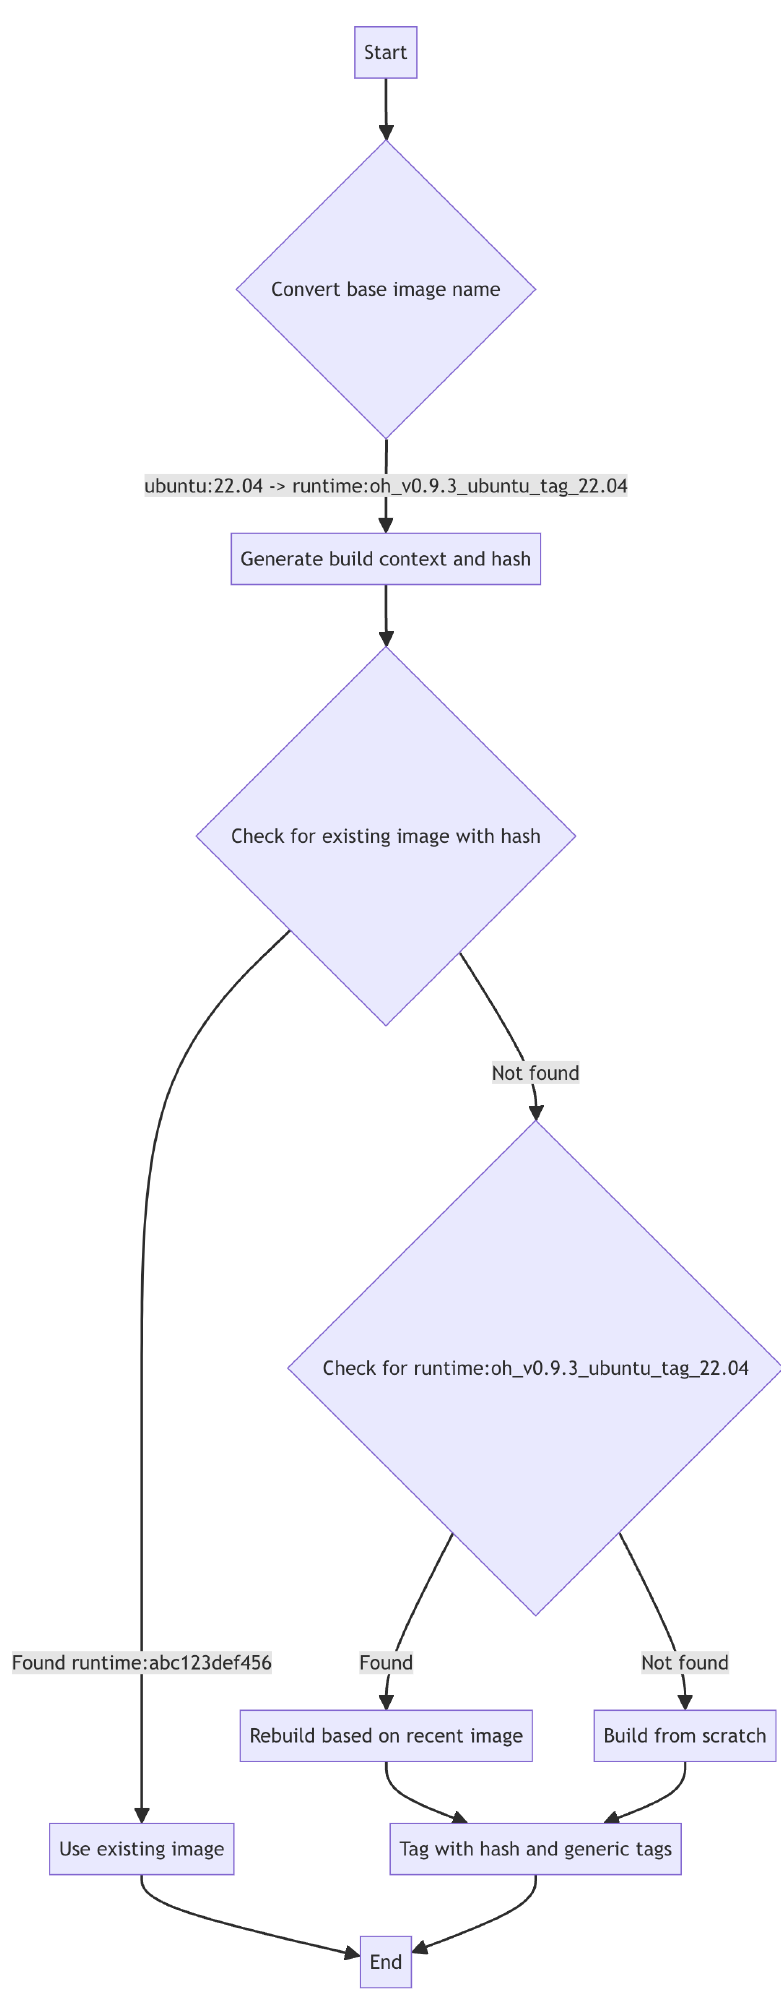
c. 如果既未找到带哈希标签的镜像,也未找到带通用标签的镜像,系统将完全从头构建镜像
缓存与效率。系统会尽可能尝试复用现有镜像以节省构建时间。如果找到确切匹配(按哈希值),则直接使用而无需重建。如果找到兼容镜像,则将其用作重建的基础,从而节省依赖安装的时间。
图 5 展示了说明构建过程的流程图
G GPQA 基准的补充结果
我们在表 7 中展示了更详细的结果,包括 GPQA 基准其他子集上的性能。
| 评估方法与模型 | 各子集准确率(%) | 平均成本(美元) | ||
| Diamond Set | Main Set | Extended Set | ||
| 专家人工验证者 | 81.2 | 72.5 | 65.4 | 不适用 |
| 非专家人工验证者 | 21.9 | 30.5 | 33.9 | 不适用 |
| 少样本CoT Llama-2-70B-chat | 28.1 | 29.1 | 30.4 | 不适用 |
| 少样本CoT GPT-3.5-turbo-16k | 29.6 | 28.0 | 28.2 | 不适用 |
| 少样本CoT GPT-4 | 38.8 | 39.7 | 38.7 | 不适用 |
| GPT-4结合搜索(弃权时回退至CoT) | 38.8 | 41.0 | 39.4 | 不适用 |
| OpenHands + CodeActAgent v1.5 + GPT3.5-turbo | 27.9 | 23.4 | 26.1 | 0.012 |
| OpenHands + CodeActAgent v1.5 + GPT4-turbo | 51.8 | 47.4 | 42.4 | 0.501 |
| OpenHands + CodeActAgent v1.5 + GPT4o | 53.1 | 49.3 | 52.8 | 0.054 |
H CODEACTSWEAGENT 的上下文内演示
该提示词改自 SWE-agent 发布的轨迹(https://github.com/princeton-nlp/SWE-agent/tree/main/trajectories/demonstrations)。该提示词可在 https://github.com/All-Hands-AI/OpenHands/blob/main/agenthub/codeact_swe_agent/prompt.py 找到。
I 支持的 AGENTSKILLS
截至 OpenHands v0.6,我们支持以下技能列表。请参阅源代码以获取最新的技能列表:https://github.com/All-Hands-AI/OpenHands/blob/main/OpenHands/runtime/plugins/agent_skills/agentskills.py
def open_file(path: str, line_number: Optional[int] = None) -> None:\\\* 在编辑器中打开给定路径的文件。如果提供了 line_number,窗口将移动到包含该行的位置。参数:path: str:要打开的文件的路径。line_number: Optional[int]:要移动到的行号。\\\*
def goto_line(line_number: int) -> None:\\\* 移动窗口以显示指定的行号。参数:line_number: int:要移动到的行号。pass
def scroll_down() -> None: """将窗口向下移动 100 行。参数:None\\\* pass
def scroll_up() -> None: """将窗口向上移动 100 行。参数:None pass
def create_file(filename: str) -> None: """创建并打开一个具有给定名称的新文件。参数:filename: str:要创建的文件的名称。pass
def edit_file(start: int, end: int, content: str) -> None: """编辑文件。它将打开文件中的第 'start' 行到第 'end' 行(含)替换为给定文本 'content'。请记住,编辑前必须先打开文件。参数:start: int:起始行号。必须满足 start >= 1。end: int:结束行号。必须满足 start <= end <= 文件中的行数。content: str:用于替换这些行的内容。pass
def search_dir(search_term: str, dir_path: str = './') -> None: """在目录中的所有文件中搜索 search_term。如果未提供目录,则在当前目录中搜索。参数:search_term: str:要搜索的词项。dir_path: Optional[str]:要搜索的目录路径。pass
def search_file(search_term: str, file_path: Optional[str] = None) -> None: """在文件中搜索 search_term。如果未提供文件,则在当前打开的文件中搜索。参数:search_term: str:要搜索的词项。file_path: Optional[str]:要搜索的文件路径。pass
def find_file(file_name: str, dir_path: str = './') -> None: """在指定目录中查找所有具有给定名称的文件。参数:file_name: str:要查找的文件名。dir_path: Optional[str]:要搜索的目录路径。pass
def parse_pdf(file_path: str) -> None:
"""***解析 PDF 文件的内容并打印它。
参数:
file_path: str:要打开的文件的路径。
pass
def parse_docx(file_path: str) -> None:
解析 DOCX 文件的内容并打印它。
参数:
file_path: str:要打开的文件的路径。
pass
def parse_latex(file_path: str) -> None:
解析 LaTeX 文件的内容并打印它。
参数:
file_path: str:要打开的文件的路径。
pass
def parse_audio(file_path: str, model: str = 'whisper- 1') -> None:
解析音频文件的内容并打印它。
参数:
file_path: str:要转写的音频文件的路径。model: Optional[str]:用于转写的音频模型。默认为 'whisper- 1'。
pass
def parse_image(
file_path: str, task: str = 'Describe this image as detail as possible.'
) -> None:
解析图像文件的内容并打印描述。
参数:
file_path: str:要打开的文件的路径。task: Optional[str]:用于 API 调用的任务描述。默认为 'Describe this image as detail as possible.'
pass
def parse_video( file_path: str, task: str = 'Describe this image as detail as possible.', frame_interval: int = 30, ) -> None:
解析图像文件的内容并打印描述。
参数:file_path: str:要打开的视频文件的路径。task: Optional[str]:用于 API 调用的任务描述。默认为 'Describe this image as detail as possible.'。frame_interval: Optional[int]:要分析的帧之间的间隔。默认为 30。
pass
def parse_pptx(file_path: str) -> None:
解析 pptx 文件的内容并打印它。
参数:file_path: str:要打开的文件的路径。
pass
J BROWSERGYM 操作
以下是截至 v0.3.4 在 BrowserGym 中定义的所有受支持操作。这些操作可以分为几种类型,并且可以配置为仅使用功能的一个子集。有智能体控制操作、导航操作、基于页面元素的操作、基于坐标的操作,以及与标签页相关的操作。我们将 BrowserGym 库中的这些操作作为我们的主要浏览操作原语。5
def send_msg_to_user(text: str):
向用户发送消息。
示例:
send_msg_to_user("Based on the results of my search, the city was built in 1751.")
***
pass
def report_infeasible(reason: str):
***
通知用户其指令不可行。
示例:
report_infeasible("I cannot follow these instructions because there is no email field in this form.")pass
def noop(wait_ms: float = 1000):***
什么都不做,并可选择等待给定时间(以 毫秒为单位)。
示例:noop() noop(500)pass
https://playwright.dev/docs/input#text- input
def fill(bid: str, value: str):\\\*
填写表单字段。它会聚焦该元素,并使用输入的文本触发一个输入事件。它适用于 <input>、<textarea> 和 [contenteditable] 元素。
示例:
fill('237', 'example value')
fill('45', "multi- line\nexample")
fill('a12', "example with \\""quotes\\""\\\*pass
https://playwright.dev/python/docs/api/class- locator#locator- check
def check(bid: str):\\\*
确保复选框或单选按钮元素被选中。
示例:
check('55')\\\*通过
https://playwright.dev/python/docs/api/class- locator#locator- uncheck
def uncheck(bid: str):\\\*
确保复选框或单选按钮元素未被选中。
示例:
uncheck('a5289')\\\*通过
https://playwright.dev/docs/input#select- options
def select_option(bid: str, options: str | list[str]):\\\*在 <select> 元素中选择一个或多个选项。你可以 指定要选择的选项值或标签。可以 选择多个选项。
示例:select_option('a48', "blue") select_option('c48', ["red", "green", "blue"])通过
https://playwright.dev/python/docs/api/class- locator#locator- click def click( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 点击一个元素。示例:click('a51') click('b22', button="right") click('48', button="middle", modifiers=["Shift"]) 通过
https://playwright.dev/python/docs/api/class- locator#locator- dblclick def dblclick( bid: str, button: Literal["left", "middle", "right"] = "left", modifiers: list[Literal["Alt", "Control", "Meta", "Shift"]] = [1], ) : 双击一个元素。
示例:dblclick('12') dblclick('ca42', button="right") dblclick('178', button="middle", modifiers=["Shift"])通过
https://playwright.dev/python/docs/api/class- locator#locator- hover def hover(bid: str): 悬停在一个元素上。
示例:hover('b8')通过
https://playwright.dev/python/docs/input#keys- and- shortcuts def press (bid: str, key_comb: str): """ 聚焦匹配的元素并按下一组组合键。它接受键盘事件的 keyboardEvent.key 属性中发出的逻辑键名:Backquote、Minus、Equal、Backslash、Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ 等。你也可以指定想要生成的单个字符,例如 "a" 或 "#"。还支持以下修饰键快捷方式:Shift、Control、Alt、Meta。
示例:press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')通过
https://playwright.dev/python/docs/api/class- locator#locator- focus def focus (bid: str): """ 聚焦匹配的元素。示例:focus('b455') """ 通过
https://playwright.dev/python/docs/api/class- locator#locator- clear def clear (bid: str): """ 清空输入字段。示例:clear('996') """ 通过
https://playwright.dev/python/docs/input#drag- and- drop def drag_and_drop(from_bid: str, to_bid: str): """ 执行拖放操作。将鼠标悬停在将被拖动的元素上。 """ 按gged。鼠标左键。将鼠标移动到将接收 \(\leftrightarrow\) 放置的元素。释放鼠标左键。
示例:drag_and_drop('56', '498')
通过
https://playwright.dev/python/docs/api/class- mouse#mouse- wheel def scroll(delta_x: float, delta_y: float):
水平和垂直滚动。数量以像素为单位, 正值表示向右或向下滚动,负值表示向左或 向上滚动。派发 wheel 事件。
示例:scroll(0, 200) scroll(- 50.2, - 100.5)
通过
https://playwright.dev/python/docs/api/class- mouse#mouse- move def mouse_move(x: float, y: float):
\\\*
将鼠标移动到某个位置。使用以像素为单位的绝对客户端坐标 。派发 mouse move 事件。
示例:mouse_move(65.2, 158.5)
通过
https://playwright.dev/python/docs/api/class- mouse#mouse- up def mouse_up(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
将鼠标移动到某个位置,然后释放鼠标按钮。 派发 mouse move 和 mouseup 事件。
示例:mouse_up(250, 120) mouse_up(47, 252, 'right')
通过
https://playwright.dev/python/docs/api/class- mouse#mouse- down def mouse_down(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):
将鼠标移动到某个位置,然后按下并按住鼠标 按钮。派发 mouse move 和 mousedown 事件。示例:mouse_down(140.2, 580.1) mouse_down(458, 254.5, 'middle')通过
https://playwright.dev/python/docs/api/class- mouse#mouse- click def mouse_click(x: float, y: float, button: Literal["left","middle", "right"] = "left"):
将鼠标移动到某个位置并单击鼠标按钮。派发 mousemove、mousedown 和 mouseup 事件。
示例:mouse_click(887.2, 68) mouse_click(56, 712.56, 'right')通过#
https://playwright.dev/python/docs/api/class- mouse#mouse- dblclick def mouse_dblclick(x: float, y: float, button: Literal["left", "middle", "right"] = "left"):将鼠标移动到某个位置并双击鼠标按钮。派发mousemove、mousedown 和 mouseup 事件。
示例:mouse_dblclick(5, 236) mouse_dblclick(87.5, 354, 'right') pass
def mouse_drag_and_drop(from_x: float, from_y: float, to_x: float, to_y: float): "middle", "right"] = "left"):
从某个位置拖动并释放到另一个位置。使用以像素为单位的绝对客户端坐标。会派发 mousemove、mousedown 和 mouseup 事件。
示例:mouse_drag_and_drop(10.7, 325, 235.6, 24.54) pass #
https://playwright.dev/python/docs/api/class- keyboard#keyboard- press def keyboard_press(key: str): 按下组合键。接受键盘事件 的 keyboardEvent.key 属性中发出的逻辑键名:Backquote、Minus、Equal、Backslash、Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、PageUp、 ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ 等。你也可以指定想要生成的单个字符 ,例如 "a" 或 "#"。也 支持以下修饰键快捷方式:Shift、Control、Alt、Meta。
示例:keyboard_press('Backspace') keyboard_press('Control+a') keyboard_press('Meta+Shift+t') page.keyboard.press("PageDown")\\\* pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- up def keyboard_up(key: str): 释放一个键盘按键。派发 keyup 事件。接受键盘事件的 keyboardEvent.key 属性 中发出的逻辑键名:Backquote、Minus、Equal、Backslash、 Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、 PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ、 等。你也可以指定想要 生成的单个字符,例如 "a" 或 "#"。
示例:keyboard_up('Shift') keyboard_up('c') pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- down def keyboard_down(key: str): 按下并保持一个键盘按键。派发 keydown 事件。 接受键盘事件的 keyboardEvent.key 属性中发出的逻辑键名:Backquote、Minus、Equal、Backslash、 Backspace、Tab、Delete、Escape、ArrowDown、End、Enter、Home、Insert、PageDown、 PageUp、ArrowRight、ArrowUp、F1 - F12、Digit0 - Digit9、KeyA - KeyZ、 等。你也可以指定单个字符,例如 "a" 或 "#"。
示例:keyboard_up('Shift') keyboard_up('c')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- type def keyboard_type(text: str): """ 通过键盘输入一串文本。会为文本中的每个字符发送 keydown、 keypress/input 和 keyup 事件。修饰键 不会影响 keyboard_type。按住 Shift 不会以 大写形式输入文本。
示例:keyboard_type('Hello world!')
pass
https://playwright.dev/python/docs/api/class- keyboard#keyboard- insert- text def keyboard_insert_text(text: str): """ 在当前聚焦的元素中插入一串文本。 仅派发 input 事件,不会发出 keydown、keyup 或 keypress 事件。 修饰键不会影响 keyboard_insert_text。按住 Shift 不会以 大写形式输入文本。
示例:keyboard_insert_text('Hello world!')
pass
https://playwright.dev/python/docs/api/class- page#page- goto def goto(url: str):
导航到一个 URL。
示例:goto('http://www.example.com')
pass
https://playwright.dev/python/docs/api/class- page#page- go- back
\\\\
在历史记录中导航到上一页。
示例:go_back()
pass
https://playwright.dev/python/docs/api/class- page#page- go- forward go_forward():在历史记录中导航到下一页。示例:go_forward()
pass
\*
https://playwright.dev/python/docs/api/class- browsercontext#browser- context- new- def new_tab():
\\\\
打开一个新标签页。它将成为活动标签页。
示例:new_tab()
global page
将新页面设置为活动页面
page page.context.new_page()
触发回调,在
browsergym 中将此页面设置为活动页面
pass
https://playwright.dev/python/docs/api/class- page#page- close
def tab_close():
\\\\
关闭当前标签页。
示例:
tab_close()
\\\\
pass
\\\\
https://playwright.dev/python/docs/api/class- page#page- bring- to- front def tab_focus(index: int):
\\\\\*
将标签页置于前台(激活标签页)。
示例:
tab_focus(2)\\\* pass\\\* pass
# https://playwright.dev/python/docs/input#upload- filesdef upload_file(bid: str, file: str | list[str]): """点击一个元素并等待 "filechooser" 事件,然后 → 选择一个或多个要上传的输入文件。相对文件路径会 → 相对于当前工作目录进行解析。空列表 → 会清除已选择的文件。
示例:upload_file("572", "my_receipt.pdf") upload_file("63", ["/home/bob/Documents/image.jpg", "/home/bob/Documents/file.zip"])
pass
\\\* https://playwright.dev/python/docs/input#upload- filesdef mouse_upload_file(x: float, y: float, file: str | list[str]): """点击一个位置并等待 "filechooser" 事件,然后 → 选择一个或多个要上传的输入文件。相对文件路径会 → 相对于当前工作目录进行解析。空列表 → 会清除已选择的文件。
示例:mouse_upload_file(132.1, 547, "my_receipt.pdf") mouse_upload_file(328, 812, → ["/home/bob/Documents/image.jpg", → "/home/bob/Documents/file.zip"])
pass
K BROWsing AGENT DETAILS
K BROWsing AGENT DETAILS以下展示了一个示例提示,其中包含当前步骤对下一步浏览操作进行预测所需的全部信息。请注意,我们还指示智能体在一轮中预测多个操作,前提是智能体认为这些操作应当在没有任何页面反馈的情况下按顺序执行。这可以为常见工作流节省轮次,这些工作流由同一页面上一系列不会引起任何观察变化的操作组成,例如在登录页面中填写用户名和密码并提交。
指令
查看页面的当前状态和所有其他信息,→ 找到实现目标的最佳下一步操作。→ 你的答案将由程序解释并执行,→ 请务必遵循格式说明。
目标:浏览 localhost:8000,并告诉我生命、宇宙以及一切的终极答案。在任何时候都 不要向我请求确认。
操作空间
共有 16 种不同类型的操作可用。
noop(wait_ms: float = 1000)
示例:
noop()
noop(500)
send_msg_to_user(text: str)
示例:
send_msg_to_user('Based on the results of my search, the city was built in 1751. ')
scroll(delta_x: float, delta_y: float)
示例:
scroll(0, 200)
scroll(- 50.2, - 100.5)
fill(bid: str, value: str)
示例:
fill('237', 'example value')
fill('45', 'multi- line\nexample')
fill('a12', 'example with "quotes")
select_option(bid: str, options: str | list[str])
示例:
select_option('48', 'blue')
select_option(‘48’,[‘red’,‘green’,‘blue’])
click(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
示例:
click('51')
click('b22', button='right')
click('48', button='middle', modifiers=['Shift'])
dblclick(bid: str, button: Literal['left', 'middle', 'right'] = 'left', modifiers: list[typing.Literal['Alt', 'Control', 'Meta', 'Shift']] = []
示例:
dblclick('12')
dblclick('ca42', button='right')
dblclick('178', button='middle', modifiers=['Shift'])
hover(bid: str) 示例:hover('b8')
press(bid: str, key_comb: str) 示例:press('88', 'Backspace') press('a26', 'Control+a') press('a61', 'Meta+Shift+t')
focus(bid: str) 示例:focus('b455')
clear(bid: str) 示例:clear('996')
drag_and_drop(from_bid: str, to_bid: str) 示例:drag_and_drop('56', '498')
upload_file(bid: str, file: str | list[str]) 示例:upload_file('572', 'my_receipt.pdf')
upload_file('63', ['/home/bob/Documents/image.jpg', ' /home/bob/Documents/file.zip'])
go_back() 示例:go_back()
go_forward() 示例:go_forward()
goto(url: str) 示例:goto('http://www.example.com')
可以一次提供多个操作。示例:fill('a12', 'example with "quotes"') click('51')
click('48', button='middle', modifiers=['Shift']) 多个操作意在依次连续执行,期间不等待页面的任何反馈。如果你需要页面的反馈,就不要一次执行多个操作。
当前无障碍树:RootWebArea 'The Ultimate Answer',已聚焦 [8] heading 'The Ultimate Answer' [9] paragraph ' StaticText 'Click the button to reveal the answer to life, the universe, and everything.' [10] button 'Click me',可点击
先前的操作 goto('http://localhost:8000')
下面是一个示例,展示在 点击按钮时,有效操作的思维链:
为了实现我的目标,我需要点击 bid 为 12 的按钮 "click("12")
而对上述提示的一个示例响应是:
为了实现我的目标,我需要点击 bid 为 10 的按钮,以揭示生命、宇宙以及 一切的答案。"click("10")"
对于 WebArena 基准上的评估,由于部分任务要求检查智能体回传给用户的消息中的答案是否精确匹配,我们添加了以下指令,让智能体在向用户发送消息时仅回复一个简洁的答案字符串,以防止智能体因多余文本而未通过测试:
下面是另一个示例,展示在向用户提供简洁答案时,有效操作 的思维链:
为了实现我的目标,我需要将所询问的信息 发送回用户。此页面列出了 HP Inkjet Fax Machine 的信息,这正是 目标中所标识的产品。其价格为 279.49\(。我将向 用户发送一条带有答案的消息。"send_msg_to_user("\) \ "