
不再逐字预测,而像扩散模型一样填补被遮住的文本,8B 规模就能追平 LLaMA-3。2025 年 ICML 论文,全文免费在线阅读。
Large Language Diffusion Models
大型语言扩散模型
Shen Fengqi Zhu Zebin You Xiaolu Zhang Jingyang Jun Jun Zhou Yankai Ji- Rong Wen Chongxuan 中国人民大学高瓴人工智能学院 北京市大模型与智能治理研究重点实验室 下一代智能搜索与推荐教育部工程研究中心 蚂蚁集团 {nieshen,fengqizhu,chongxuanli}@ruc.edu.cn {nie shen, fengqizhu, chongxuanli}@ruc.edu.cn
摘要
大型语言模型(LLMs)的能力被广泛认为依赖于自回归模型(ARMs)。我们通过引入LLaDA来挑战这一观念,LLaDA是一个在预训练和有监督微调(SFT)范式下从头训练的扩散模型。LLaDA采用前向数据掩码过程和反向生成过程,由Transformer参数化以预测被掩码的token。它通过优化似然下界,为概率推断提供了一种有原则的生成方法。在通用任务、数学、代码等广泛基准测试中,LLaDA展现出强大的可扩展性,并与我们自行构建的ARM基线表现相当。值得注意的是,LLaDA 8B在上下文学习方面与LLaMA3 8B等强LLM具有竞争力,并且在SFT之后,在多轮对话等案例研究中展现出令人印象深刻的指令遵循能力。此外,LLaDA解决了反转诅咒,在反转诗歌补全任务中超越了GPT-4o。我们的发现表明扩散模型在大规模语言建模方面具有前景,并挑战了上述讨论的LLM核心能力本质上依赖于ARMs这一常见假设。项目页面和代码:https://ml- gsai.github.io/LLaDA- demo/
1 引言
大型语言模型(LLMs)[1]完全属于生成建模的框架。具体而言,LLMs旨在通过最大似然估计,或等价地通过最小化两个分布之间的KL散度,优化模型分布以捕捉真实但未知的语言分布:
主流方法依赖于自回归建模(ARM)——通常被称为“下一token预测”范式——来定义模型分布:
自回归公式
\*同等贡献。
在蚂蚁集团实习期间完成的工作。
项目负责人。
通讯作者:Chongxuan Li。
其中是长度为的序列,是第个token。这一范式已被证明非常有效[2][5],并已成为当前LLMs的基础。尽管被广泛采用,一个基本问题仍未得到解答:自回归范式是实现LLMs核心能力(如可扩展性、上下文学习和指令遵循)的唯一途径吗?
我们认为答案并非简单的“是”。此前被忽视的关键洞见是:从根本上支撑LLMs基本特性的是生成建模原则(即式(1)),而非自回归公式(即式(2))本身。
特别是,我们认为可扩展性主要是Transformer[7]、模型规模、数据规模以及式(1)中生成原则所诱导的Fisher一致性[5][8]之间相互作用的結果,而非式(2)中ARMs的独特结果。扩散Transformer[9][10]在视觉数据[11]上的成功支持了这一主张。此外,指令遵循和上下文学习[4]能力似乎是所有在结构一致的语言任务上的条件生成模型的内在属性,而非ARMs的专属优势。此外,虽然ARMs可以被解释为无损数据压缩器[12][13],但任何具有足够表达力的概率模型都可以实现类似的能力[14]。
然而,LLMs的某些固有局限性可以直接归因于其自回归性质。例如,从左到右的生成过程限制了它们处理反转推理任务的能力[15],凸显了当前模型泛化能力中的一个代表性失败。
受这些洞见的启发,我们引入了LLaDA(Large Language Diffusion with mAsking),以研究LLMs所展现的能力是否可以从ARMs之外的生成建模原则中涌现,从而回答前面提出的基本问题。与传统ARMs不同,LLaDA利用掩码扩散模型(MDM)[16][20],该模型包含前向数据掩码过程,并训练一个掩码预测器来近似其反向过程。这一设计使LLaDA能够构建具有双向依赖的模型分布,并优化其对数似然的变分下界,为上述讨论的LLMs核心能力提供了一个有原则且此前未被探索的视角。
我们采用数据准备、预训练、有监督微调(SFT)和评估的标准流程,将LLaDA扩展到前所未有的8B规模的语言扩散模型。具体而言,LLaDA 8B在2.3万亿token上从头预训练,使用了0.13百万H800 GPU小时,随后在450万对数据上进行SFT。在包括语言理解、数学、代码和中文在内的多样化任务中,LLaDA展现了以下贡献:
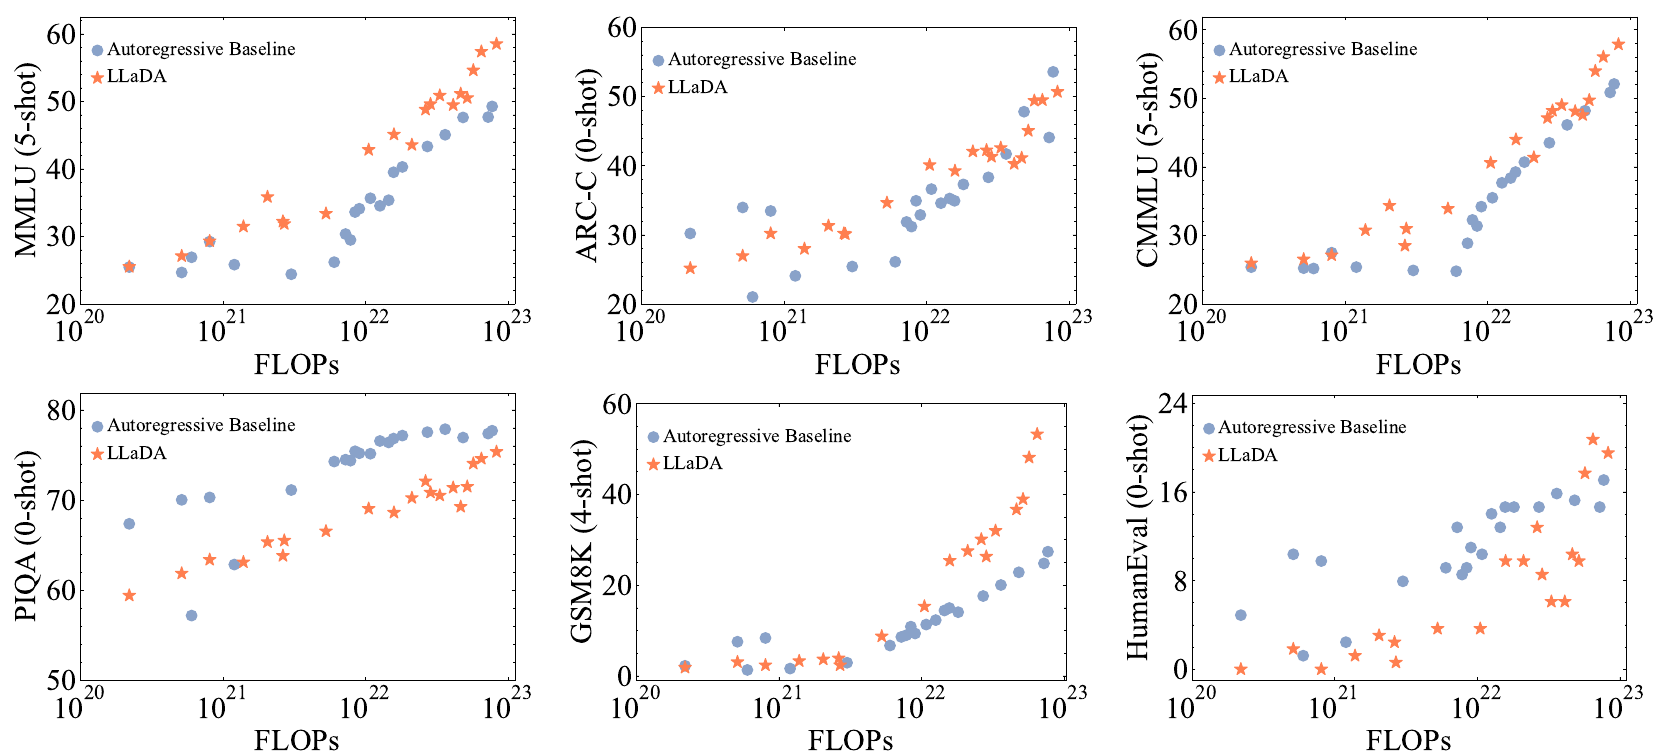
- LLaDA有效扩展到 FLOPs的计算预算,在六个任务(如MMLU和GSM8K)上取得了与在相同数据上训练的ARM基线相当的结果。
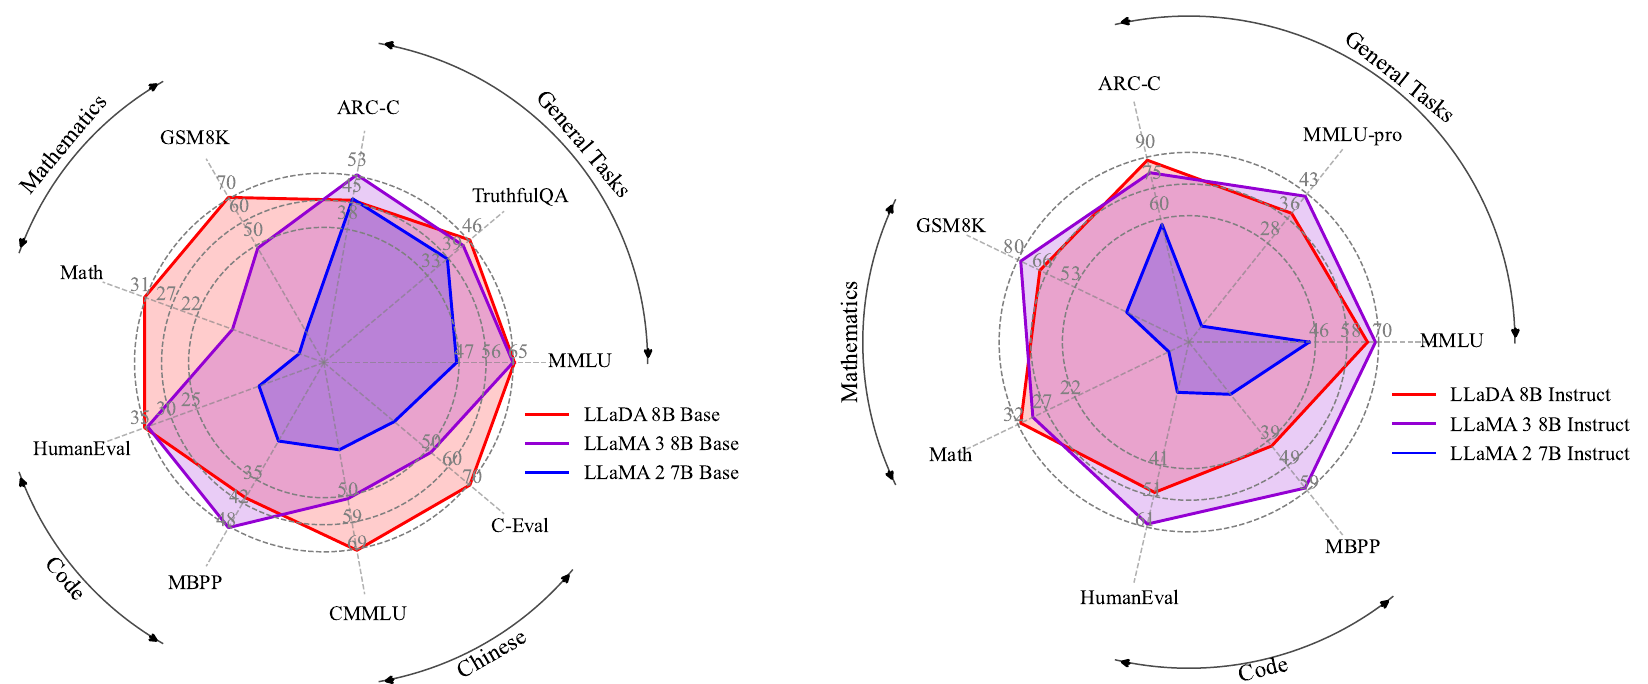
- 预训练的LLaDA 8B Base在几乎所有15个标准零样本/少样本学习任务上超越了LLaMA2 7B Base [21],同时与LLaMA3 8B Base [6]表现相当,展示了有效的上下文学习能力。
- LLaDA在SFT后显著增强了指令遵循能力,如多轮对话等案例研究所示。
- LLaDA有效打破了反转诅咒[15],在前向和反转任务上表现一致。值得注意的是,它在反转诗歌补全任务中超越了GPT-4o。
2 方法
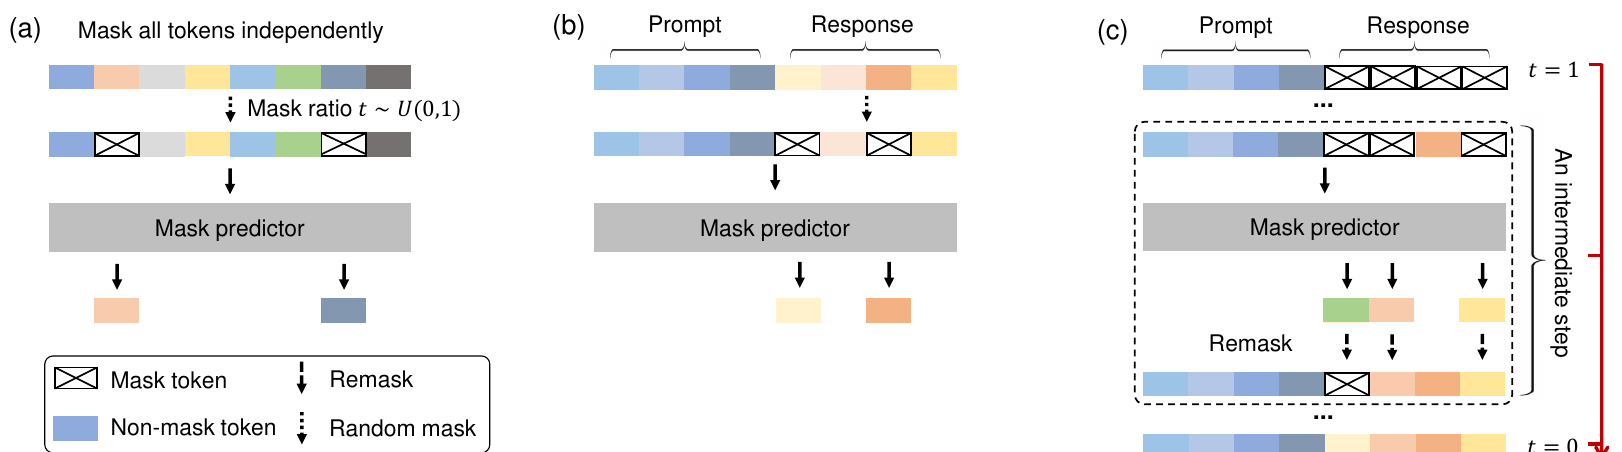
在本节中,我们介绍LLaDA的概率公式[6]以及预训练、有监督微调和推理过程,如图[2]所示。
2.1 概率公式
与式(2)中的ARMs不同,LLaDA通过前向过程和反向过程[16][20]定义模型分布。前向过程逐渐独立地掩码中的token,直到序列在时被完全掩码。对于,序列被部分掩码,每个token以概率被掩码或以概率\(1 - t\)保持未掩码。反向过程通过在\(t\)从1到0的过程中迭代预测被掩码的token来恢复数据分布。
LLaDA 的核心是一个掩码预测器,即一个参数化模型 ,它以 为输入并同时预测所有被掩码的 token(记为 M)。它使用仅在掩码 token 上计算的交叉熵损失进行训练 [18][20]:
其中 是一个训练样本, 是从 中均匀抽取的连续随机变量, 从正向过程中采样得到, 是序列长度。指示函数 确保损失仅对掩码 token 计算。
训练完成后,我们可以模拟一个由掩码预测器参数化的逆向过程(详见第 [2.4] 节),并将模型分布 定义为在 时诱导出的边缘分布。式 (3) 中的损失函数已被证明是模型分布负对数似然的上界,使其成为生成建模的一个有原则的目标:
值得注意的是,LLaDA 采用的掩码比例在 0 到 1 之间随机变化,而 BERT [22] 使用的是固定比例。这些细微差异具有重大意义,尤其是在规模扩展时:如式 (4) 所示,LLaDA 是一个有原则的生成模型,具有自然地执行上下文学习和指令遵循的潜力,类似于 LLM。此外,其生成视角意味着它在大数据和模型规模下具有很强的可扩展性,如第 [1] 节所述。另外,MaskGIT [23] 采用了一种启发式训练目标,与式 (3) 相比缺少了 项,并且缺乏与最大似然的理论联系。我们强调,正是最大似然估计的理论基础促使我们将离散扩散模型扩展到语言建模。
2.2 预训练
LLaDA 采用 Transformer [7] 作为掩码预测器,与现有 LLM 类似。然而,LLaDA 不使用因果掩码,因为其公式允许它看到整个输入以进行预测。
我们训练了两种不同规模的 LLaDA 变体:1B 和 8B。我们在此总结 LLaDA 8B 和 LLaMA3 8B [6] 的模型架构,详细信息见附录 [B.2]。我们确保了大多数超参数的一致性,同时进行了若干必要的修改。为简单起见,我们使用普通多头注意力而非分组查询注意力 [24],因为 LLaDA 与 KV 缓存不兼容,导致键和值头的数量不同。因此,注意力层具有更多参数,我们减小了 FFN 维度以保持可比的模型规模。此外,由于在我们的数据上适配了分词器 [4],词表大小也有所不同。
LLaDA 模型在一个包含 2.3 万亿(T)个 token 的数据集上进行预训练,遵循与现有 LLM 高度一致的数据协议 [25] [26],未引入任何特殊技术。数据来源于在线语料库,低质量内容通过人工设计的规则和基于 LLM 的方法进行过滤。除通用文本外,该数据集还涵盖高质量代码、数学和多语言数据。关于数据集的更多细节请参见附录 [B.1]。数据源和领域的混合由缩小规模的 ARM 指导。预训练过程采用 4096 个 token 的固定序列长度,总计算成本为 13 万 H800 GPU 小时,与同等规模和数据集大小的 ARM 相似。
对于训练序列 ,我们随机采样 ,以相同概率 独立地对每个 token 进行掩码以获得 (见图 2),并通过蒙特卡洛方法估计式 (3) 以进行随机梯度下降训练。此外,遵循 Nie 等人 [27] 的方法,为增强 LLaDA 处理变长数据的能力,我们将 的预训练数据设置为从范围 中均匀采样的随机长度。
我们采用 Warmup-Stable-Decay [28] 学习率调度器来监控训练进度,而无需中断连续训练。具体而言,我们在前 2000 次迭代中将学习率从 0 线性增加到 ,并保持在 。在处理 1.2T 个 token 后,我们将学习率衰减至 ,并在接下来的 0.8T 个 token 中保持恒定以确保训练稳定。最后,我们在最后 0.3T 个 token 中将学习率从 线性降低至 。此外,我们使用 AdamW 优化器 [29],权重衰减为 0.1,批大小为 1280,每个 GPU 的本地批大小为 4。8B 实验仅执行一次,未进行任何超参数调优。
2.3 监督微调
我们通过使用配对数据 进行监督微调(SFT)来增强 LLaDA 遵循指令的能力,其中 是提示, 表示回复。这是 LLM 最简单、最基础的后训练方法。从技术上讲,这需要建模条件分布 ,而非预训练中的 。
实现方式与预训练类似。如图 2 所示,我们保持提示不变,并如对 所做的那样独立地对回复中的 token 进行掩码。然后,我们将提示和掩码后的回复 一同输入预训练的掩码预测器以计算 SFT 的损失:
其中 表示稍后指定的动态长度,所有其他符号与之前相同。请注意,此方法与预训练完全兼容。本质上, 和 的拼接可以被视为干净的预训练数据 ,而 和 的拼接则充当掩码版本 。该过程与预训练完全相同,唯一区别在于所有被掩码的 token 恰好出现在 部分。
LLaDA 8B 模型在一个包含 450 万对的数据集上进行 SFT。与预训练过程一致,数据准备和训练均遵循现有 LLM 中使用的 SFT 协议 [25] [26],未引入任何额外技术来优化 LLaDA 的性能。该数据集涵盖多个领域,包括代码、数学和指令遵循。我们在每个小批次中短配对的末尾追加 |EOS| token,以确保所有数据长度相等。我们在训练期间将 |EOS| 视为普通 token,并在采样时将其移除,从而使 LLaDA 能够自动控制回复长度。更多细节请参见附录 B.1。
我们在 SFT 数据上训练 3 个 epoch,使用与预训练阶段类似的调度方案。学习率在前 50 次迭代中从 0 线性增加到 ,然后保持恒定。在最后 的迭代中,线性降低至 。此外,我们将权重衰减设置为 0.1,全局批大小设置为 256,每个 GPU 的本地批大小设置为 2。SFT 实验仅执行一次,未进行任何超参数调优。
2.4 推理
作为一种生成模型,LLaDA 可以以扩散方式而非从左到右的自回归方式采样新文本并评估候选文本的似然。
我们从逆向生成过程开始。如图 2 所示,给定提示 ,我们从完全掩码的回复开始,对逆向过程进行离散化以从模型分布 中采样。采样步骤总数是一个超参数,这自然为 LLaDA 提供了效率与样本质量之间的权衡,如第 [3.3] 节所分析。我们默认采用均匀分布的时间步。此外,生成长度也被视为一个超参数,指定采样过程开始时完全掩码句子的长度。生成后,出现在 |EOS| token 之后的 token 将被丢弃。如附录 [B.5] 详述,由于预训练和 SFT 均使用变长数据集进行,最终结果对该长度超参数不敏感。
在从时间 到 的中间步骤中,我们将 和 一同输入掩码预测器,并同时预测所有被掩码的 token。随后,我们按期望对预测 token 中的 比例重新掩码以获得 ,确保逆向过程的转移与正向过程一致以实现准确采样 [18] [20]。原则上,重新掩码策略应是纯随机的。然而,受 LLM 中采样退火技巧的启发 [4] [30],我们采用低置信度重新掩码策略,即根据预测结果对置信度最低的 比例预测 token 进行重新掩码,与 Chang 等人 [23] 的方法相同。
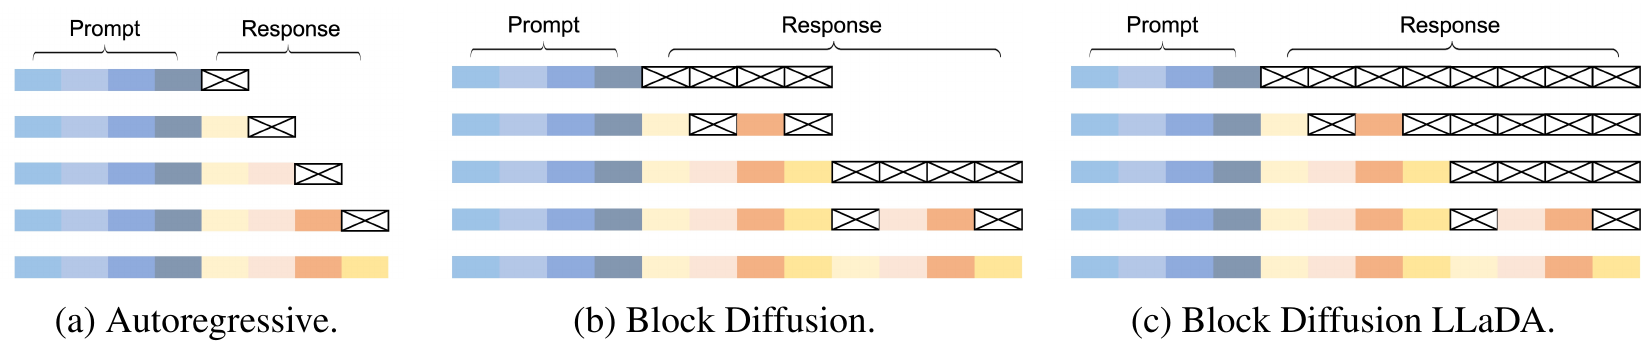
我们注意到 LLaDA 支持灵活的采样。特别地,它支持在上述预训练或 SFT 过程之后直接进行自回归和块扩散 [31] 采样,无需任何进一步修改或训练。我们在附录 [B.4] 中提供了详细分析。尽管如此,扩散采样(即逆向生成过程)产生最佳性能,并在本文中作为默认方法采用,尤其是对于第 [3] 节中呈现的所有实验。
对于条件似然评估,我们自然可以利用式 [5] 中的上界。然而,我们发现以下等价形式 [20] 具有更低的方差且更稳定:
其中 是 的序列长度, 从 中均匀采样,而 是通过从 中无放回地均匀采样 个 token 进行掩码得到的。
我们在附录 [A] 中给出了训练和推理算法以及理论细节。
3 实验
我们在标准基准上评估了 LLaDA 的可扩展性、指令遵循能力和上下文学习能力,随后通过分析和案例研究提供全面的评估。
3.1 LLaDA 在语言任务上的可扩展性
我们首先研究 LLaDA 在下游任务上的可扩展性,并与我们构建的 ARM 基线进行比较。具体而言,在 1B 规模下,我们确保 LLaDA 和 ARM 共享相同的架构、数据和所有其他配置。在更大规模下,由于资源限制,我们还报告了在相同数据上训练的规模略有不同的 LLaDA 和 ARM 模型的结果。更多细节请参阅附录 [B.2]。我们使用预训练计算成本作为统一的扩展度量。在评估方面,我们聚焦于六个标准且多样的任务。
图 3 显示 LLaDA 展现出令人印象深刻的可扩展性,其整体趋势与 ARM 极具竞争力。值得注意的是,在 MMLU 和 GSM8K 等任务上,LLaDA 甚至展现出更强的可扩展性。即使在 PIQA 等相对较弱的任务上,与 ARM 的性能差距也随着规模增大而缩小。为了考虑异常值的影响,我们选择不拟合定量曲线,以避免潜在的误读。尽管如此,结果清楚地证明了 LLaDA 的可扩展性。
考虑到 LLaDA 在某些基准上的优势,我们假设这种性能提升源于一个关键的架构差异:自回归模型仅优化从左到右的条件概率,而 LLaDA 被训练以考虑多个条件方向,详见附录 [A.2],这可能提供更大的灵活性并带来更好的泛化能力。这一假设的动机来自 LLaDA 在第 [3.3] 节中逆转推理上的强劲表现,以及附录 [B.4] 中关于采样策略的消融研究。
Nie 等人 [27] 指出,MDM 需要比 ARM 多 16 倍的计算量才能达到相同的似然。然而,关键差异使我们的发现具有更广泛的适用性。特别是,似然对于下游任务性能而言是一个相对间接的指标,而扩散优化的是似然的一个界,使其无法与 ARM 直接比较。此外,我们将 Nie 等人 [27] 中的扩展范围从 FLOPs 扩展到了本工作中的 FLOPs。
3.2 基准结果
为了全面评估 LLaDA 8B 的上下文学习和指令遵循能力,我们与现有类似规模的 LLM [6,21,25,26,32,33] 进行了详细比较。任务选择和评估协议遵循现有研究,涵盖通用任务、数学、代码和中文领域的流行基准。更多细节见附录 [B.6]。为了更直接的比较,我们在自己的实现中重新评估了代表性的 LLM [6,21]。
如表 [1] 所示,在 2.3T token 上预训练后,LLaDA 8B Base 展现出卓越的性能,在几乎所有任务上超越 LLaMA2 7B Base,并且总体上与 LLaMA3 8B Base 具有竞争力。LLaDA 在数学和中文任务上展现出优势。我们推测这些
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Mistral 7B† | Deepseek 7B† | |
| 模型训练 token 数 | 扩散 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR - | AR 2T |
| 通用任务 | |||||||
| MMLU | 65.9 (5) | 65.4 (5) | 45.9 (5) | 70.3 (5) | 74.2 (5) | 64.2 (5) | 48.2 (5) |
| BBH | 49.7 (3) | 62.1 (3) | 39.4 (3) | 62.3 (3) | 70.4 (3) | 56.1 (3) | 39.5 (3) |
| ARC-C | 45.9 (0) | 53.1 (0) | 46.3 (0) | 60.6 (25) | 63.7 (25) | 60.0 (25) | 48.1 (0) |
| Hellaswag | 70.5 (0) | 79.1 (0) | 76.0 (0) | 80.7 (10) | 80.2 (10) | 83.3 (10) | 75.4 (0) |
| TruthfulQA | 46.1 (0) | 44.0 (0) | 39.0 (0) | 54.2 (0) | 56.4 (0) | 42.2 (0) | - |
| WinoGrande | 74.8 (5) | 77.3 (5) | 72.5 (5) | 77.0 (5) | 75.9 (5) | 78.4 (5) | 70.5 (0) |
| 只读背景资料,用于理解源文(不是要翻译的源文本):3.2 基准结果 如Tab. [1]所示,在2.3T tokens上预训练后,LLaDA 8B Base展现出显著性能,在几乎所有任务上超过LLaMA2 7B Base,并且总体上与LLaMA3 8B Base具有竞争力。LLaDA在数学和中文任务上表现出优势。我们推测,这些优势与其在某些任务上相对较弱的表现源于相同因素——数据质量和分布的差异,这在很大程度上是由于LL的闭源情况 | 待翻译文本:PIQA | 73.6 (0) | 80.6 (0) | 79.1 (0) | - | - | - |
| 79.2 (0) | |||||||
| 数学与&科学 | GSM8K | 70.3 (4) | 48.7 (4) | 13.1 (4) | 80.2 (4) | 85.4 (4) | 36.2 (4) |
| 17.4 (8) | 数学 | 31.4 (4) | 16.0 (4) | 4.3 (4) | 43.5 (4) | 49.8 (4) | 10.2 (4) |
| 6.0 (4) | GPQA | 25.2 (5) | 25.9 (5) | 25.7 (5) | 30.8 (5) | 36.4 (5) | 24.7 (5) |
| - | |||||||
| 代码 | HumanEval | 35.4 (0) | 34.8 (0) | 12.8 (0) | 51.2 (0) | 57.9 (0) | 29.3 (0) |
| 26.2 (0) | HumanEval-FIM | 73.8 (2) | 73.3 (2) | 26.9 (2) | - | - | - |
| - | MBPP | 40.0 (4) | 48.8 (4) | 23.2 (4) | 64.2 (0) | 74.9 (0) | 51.1 (0) |
| 39.0 (3) | |||||||
| 中文 | CMMLU | 69.9 (5) | 50.7 (5) | 32.5 (5) 83.9 (5) | 理解源文本的只读背景(不是要翻译的源文本): | 3.2 基准测试结果 | 如Tab.[1]所示,在2.3T token上预训练后,LLaDA 8B Base展现出显著性能,在几乎所有任务上超越LLaMA2 7B Base,整体上与LLaMA3 8B Base具有竞争力。LLaDA在数学和中文任务上显示出优势。我们推测,这些优势源于与其在某些任务上相对较弱表现相同的因素——数据质量和分布的差异,这在很大程度上是由于LL的闭源状况所致。 |
| 要翻译的文本: | - | 47.2 (5) | C-Eval | 70.5 (5) | 51.7 (5) | 34.0 (5) | 83.2 (5) - - 45.0 (5) |
| LLaDA 8B* | LLaMA3 8B* | LLaMA2 7B* | Qwen2 7B† | Qwen2.5 7B† | Gemma2 9B† | Deepseek 7B† | |
| 模型训练token数 | Diffusion 2.3T | AR 15T | AR 2T | AR 7T | AR 18T | AR 8T | AR 2T |
| 后训练对齐数据对 | SFT 4.5M | SFT+RL - | SFT+RL - | SFT+RL 0.5M + - | SFT+RL 1M + 0.15M - | SFT+RL - | SFT+RL 1.5M + - |
| 通用任务 | |||||||
| MMLU | 65.5 (5) | 68.4 (5) | 44.1 (5) | - | - | - | 49.4 (0) |
| MMLU-pro | 37.0 (0) | 41.9 (0) | 4.6 (0) | 44.1 (5) | 56.3 (5) | 52.1 (5) | - |
| Hellaswag | 74.6 (0) | 75.5 (0) | 51.5 (0) | - | - | - | 68.5 (-) |
| ARC-C | 88.5 (0) | 82.4 (0) | 57.3 (0) | - | - | - | 49.4 (-) |
| 数学与科学 | |||||||
| GSM8K | 69.4 (4) | 78.3 (4) | 29.0 (4) | 85.7 (0) | 91.6 (0) | 76.7 (0) | 63.0 (0) |
| 数学 | 31.9 (0) | 29.6 (0) | 3.8 (0) | 52.9 (0) | 75.5 (0) | 44.3 (0) | 15.8 (0) |
| GPQA | 33.3 (5) | 31.9 (5) | 28.4 (5) | 34.3 (0) | 36.4 (0) | 32.8 (0) | - |
| 代码 | |||||||
| HumanEval | 49.4 (0) | 59.8 (0) | 16.5 (0) | 79.9 (0) | 84.8 (0) | 68.9 (0) | 48.2 (-) |
| MBPP | 41.0 (4) | 57.6 (4) | 20.6 (4) | 67.2 (0) | 79.2 (0) | 74.9 (0) | 35.2 (-) |
优势与其在某些任务上相对较弱的表现源于相同的因素——数据质量和分布的差异,这在很大程度上归因于 LLM 数据集的闭源状况。
值得注意的是,我们以GSM8K为例,已仔细排除了数据泄漏的可能性。首先,如图[3]所示,LLaDA在GSM8K上优于ARM基线。此外,该结论在附录B.8中一个完全未见过的类GSM8K任务[34]上依然成立。
进一步地,表[2]比较了LLaDA 8B Instruct与现有LLMs的性能。SFT提升了LLaDA在大多数下游任务上的性能。少数指标(如MMLU)出现下降,可能是由于SFT数据质量欠佳所致。总体而言,由于我们未进行基于强化学习(RL)的对齐
| 采样过程 | |
| 用户 | Lily能以每小时12公里的速度跑4小时。之后,她以每小时6公里的速度跑。她在8小时内能跑多少公里? |
| LLaDA | 在4小时内,Lily跑了12 * 4 = 48公里。4小时后,她跑了6 * 4 = 24公里。总共,她在8小时内跑了48 + 24 = 72公里。结果 72 |
| 多轮对话案例 | |
| 用户 | 能否请你告诉我著名诗歌《未选择的路》的前两行? |
| LLaDA | 当然可以!罗伯特·弗罗斯特的著名诗歌《未选择的路》的前两行是:“Two roads diverged in a yellow wood, And sorry I could not travel both.” 这两行为全诗奠定了基调,引出了说话者面临两条道路之间抉择的主题。 |
| 用户 | 请帮我翻译成中文。 |
| LLaDA | 当然可以!罗伯特·弗罗斯特的《未选择的路》前两行可以翻译成中文为:“两条路分岔在黄色的树林中,遗憾我不能同时走” |
| 用户 | 请翻译成德语。 |
| LLaDA | 当然可以!罗伯特·弗罗斯特的《未选择的路》前两行可以翻译成德语为:“Zwei Wege trennten sich im gelben Wald, und leider konnte ich nicht beide tun.” |
| 用户 | 还请写一首关于人生选择的诗。我要求5句话,并且每句话的第一个词都以字母C开头。 |
| LLaDA | 当然可以!下面是一首关于人生选择的诗,每句话都以字母“C”开头:Choices cascade through life’s journey, Creating connections with each decision, Careful consideration leads to better paths, Courageous choices shape our destiny, Choosing wisely guides us through the years. |
,我们的结果略落后于LLaMA3 8B Instruct,不过许多指标上的差距仍然很小。值得注意的是,即使仅使用SFT,LLaDA也展现出令人印象深刻的指令遵循能力,详见第[3.4]节。我们将基于RL的对齐留作未来工作。
第[3]节中的所有结果均基于纯扩散方法,因为它们在整体性能上优于融入自回归组件的方法。具体而言,我们使用式(6)进行条件似然估计,并应用低置信度重掩码进行采样。对于LLaDA 8B Instruct,块扩散式采样在GSM8K和Math上表现更好,得分分别为78.6和42.2,而表[2]中为69.4和31.9。这一提升是由于SFT数据中大量|EOS|token填充,导致低置信度重掩码中出现提前终止。详情请参阅附录[B.4]。
总体而言,尽管缺乏数据透明度,我们已尽一切努力采用标准化流程并引入多样化任务,我们相信这些足以充分展示LLaDA的卓越能力,据我们所知,它是唯一具有竞争力的非自回归模型。
3.3 反转推理与分析
为了量化模型的反转推理[15]能力,我们遵循Allen-Zhu和Li [35]所建立的协议。具体而言,我们构建了一个包含496个著名中国诗句对的数据集。给定诗句中的一句,模型需在无需额外微调的情况下生成下一句(正向)或上一句(反转)。示例见第[B.9]节。与先前研究[27, 36]相比,该设置提供了一种直接且更贴近现实的评估方式。
如表[4]所示,LLaDA有效解决了反转诅咒[15],在正向和反转任务上均展现出一致的零样本性能。相比之下,Qwen 2.5和GPT-4o在两者之间均表现出显著差距。正向生成的结果证实两个ARM均表现强劲,这得益于其比LLaDA显著更大的数据集和更多的计算资源。然而,LLaDA在反转任务上以较大幅度优于两者。
我们并未针对反转任务设计任何特殊机制。直观上,LLaDA统一对待token,不引入归纳偏置,从而带来均衡的性能。详见附录A.2。
我们还分析了不同采样策略对LLaDA的影响,包括自回归采样、块扩散[31]采样和纯扩散采样,结果表明纯扩散采样取得最佳整体性能,详见附录B.4。
| 正向 | 反向 | |
| GPT-4o (2024-08-06) | 82.7 | 34.3 |
| Qwen2.5-7B Instruct | 75.9 | 38.0 |
| LLaDA-8B Instruct | 51.8 | 45.6 |
此外,我们考察了LLaDA的采样速度和内存消耗,表明它能够在生成质量与速度之间实现灵活权衡。更多细节见附录B.7。
无分类器引导(CFG)[37][27]是扩散模型中广泛用于提升生成质量的技术。为确保与ARM的公平比较,我们在正文中未对LLaDA应用CFG。然而,我们表明LLaDA与CFG兼容,并能持续从其应用中获益。更多细节见附录B.3。
3.4 案例研究
我们在表3中展示了LLaDA 8B Instruct生成的样本,以展示其指令遵循能力。首先,该表展示了LLaDA以非自回归方式生成连贯、流畅且篇幅较长的文本的能力。其次,它突出了模型的多轮对话能力,能够有效保留对话历史,并以多种语言生成上下文适宜的回答。LLaDA的这种聊天能力令人印象深刻,因为据我们所知,它首次脱离了传统的ARM。更多案例研究见附录B.10。
4 相关工作
扩散模型[38,40]在视觉领域取得了显著成功,但尽管兴趣日益增长且研究广泛,其在大规模(例如,训练计算量超过 FLOPs的模型)语言建模中的可行性仍未得到验证。
一种简单的方法是将文本数据连续化,并直接应用连续扩散模型[41-51]。或者,一些方法转而建模离散分布的连续参数[52-56]。然而,可扩展性仍是这些方法的重大挑战。例如,一个1B模型可能需要ARM的64倍计算量才能达到可比性能[57]。
另一种方法以具有新的前向和反向动力学的离散过程替代连续扩散,由此产生了众多变体[58,71]。原始扩散模型论文[38]在统一的扩散框架下引入了连续状态和离散状态转移核。Austin等人[16]是将离散扩散模型引入语言建模的开创性工作之一,证明了该方法的可行性。Lou等人[17]表明,掩码扩散作为离散扩散的一种特例,在GPT-2规模下可达到与ARM相当或超越ARM的困惑度。Shi等人[18]、Sahoo等人[19]、Ou等人[20]建立了基础性理论结果,这些结果启发了我们的模型设计、训练和推理(详见附录A)。Nie等人[27]引入了语言建模中MDM的缩放定律,并探索了如何在GPT-2规模下将MDM用于问答等语言任务。Gong等人[72]展示了在MDM框架内微调ARM的潜力。然而,Gong等人[72]观察到的改进仅限于特定指标,且其方法并未涉及纯扩散训练所能达到的性能。同期工作[73]展示了扩散语言模型在代码生成中的潜力,并强调了其在推理效率方面的优势。尽管如此,由于它是闭源产品,训练流程和采样方法等具体细节仍不得而知。
相比之下,本研究从头开始将MDM扩展到前所未有的8B参数规模,实现了与LLaMA 3等领先LLMs相当的性能。
此外,图像生成领域的一系列并行工作[23,74,75]与MDM在文本数据上的应用高度契合。而且,MDM在其他领域(如蛋白质生成[76][77])也展现出前景,并已取得可喜成果。值得注意的是,一系列研究[31][78][87]探索了架构优化、蒸馏和采样算法设计等技术,以加速MDM采样。
5 结论与讨论
我们介绍了LLaDA,一个从头训练、规模前所未有的8B参数扩散语言模型。LLaDA在可扩展性、上下文学习和指令遵循方面展现出强大能力,性能与LLaMA3等强LLMs相当。此外,LLaDA具有独特优势,如双向建模和增强的鲁棒性,有效解决了现有LLMs的相关局限。我们的发现表明扩散模型在大规模语言建模中的前景,并挑战了这些基本能力必然与ARM绑定的常见假设。这些结果代表了语言建模的新范式,并揭示了新的洞见,展现出高度的科学创新性。
局限性。尽管前景广阔,扩散模型的全部潜力仍有待充分探索。本工作的若干局限性为未来研究提供了重要机会。生成长度是用户指定的超参数。尽管LLaDA对该超参数不敏感(详见附录[B.5]),但我们认为采用自适应生成长度将提供更高效的解决方案。受计算资源限制,LLaDA与ARM之间的直接比较——例如在相同数据集上训练——被限制在低于 FLOPs的计算预算内。为将资源分配给训练尽可能最大的LLaDA模型并展示其潜力,我们无法将ARM基线扩展到相同程度。此外,我们未为LLaDA设计专门的注意力机制或位置嵌入,也未应用KV缓存等系统级架构优化。在推理方面,更高效且可控的[37][88][89]采样算法仍处于初步阶段。此外,LLaDA尚未进行强化学习[90][91]对齐,而这对于提升其性能和与人类意图的对齐至关重要。
展望未来,LLaDA的模型规模和训练数据量仍小于领先的ARM对应模型[6][26][92][95],凸显出需要进一步扩展以充分评估其能力。此外,LLaDA处理多模态数据的能力尚未探索。其对提示微调技术[96]的影响以及融入基于智能体的系统[97][98]的程度仍未完全明了。最后,需要对LLaDA的后训练(例如,类O1系统[99][100])进行系统性研究,以进一步释放扩散语言模型的潜力。
致谢
本工作得到国家自然科学基金(编号:92470118);北京市自然科学基金(编号:L247030);北京市新星计划(编号:20220484044);以及蚂蚁集团研究基金的支持。
参考文献
[1] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, 等. 大语言模型综述. arXiv预印本 arXiv:2303.18223, 2023. [2] Alec Radford. 通过生成式预训练提升语言理解, 2018. [3] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, 等. 语言模型是无监督多任务学习器. OpenAI博客, 1(8):9, 2019. [4] Tom B Brown. 语言模型是少样本学习器. arXiv预印本 arXiv:2005.14165, 2020. [5] OpenAI. ChatGPT:为对话优化语言模型. OpenAI博客, 2022年11月. URL https://openai.com/blog/chatgpt/[6] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, 等. Llama 3模型群. arXiv预印本 arXiv:2407.21783, 2024.
[7] Ashish Vaswani. 注意力就是你所需要的一切. arXiv预印本 arXiv:1706.03762, 2017.
[8] Ronald A Fisher. 论理论统计学的数学基础. 伦敦皇家学会哲学汇刊. A辑,包含数学或物理性质论文, 222(594-604):309-368, 1922.
[9] Fan Bao, Shen Nie, Kaiwen Xue, Yue Cao, Chongxuan Li, Hang Su, 和 Jun Zhu. 所有都值得关注:一种用于扩散模型的ViT骨干网络. 载于IEEE/CVF计算机视觉与模式识别会议论文集, 页码 22669-22679, 2023.
[10] William Peebles 和 Saining Xie. 基于Transformer的可扩展扩散模型. 载于IEEE/CVF国际计算机视觉大会论文集, 页码 4195-4205, 2023.
[11] Tim Brooks, Bill Peebles, Connor Holmes, Will DePue, Yufei Guo, Li Jing, David Schnurr, Joe Taylor, Troy Luhman, Eric Luhman, Clarence Ng, Ricky Wang, 和 Aditya Ramesh. 视频生成模型作为世界模拟器. 2024. URL https://openai.com/research/video-generation-models-as-world-simulators
[12] Gregoire Deletang, Anian Ruoss, Paul-Ambroise Duquenne, Elliot Catt, Tim Genewein, Christopher Mattern, Jordi Grau-Moya, Li Kevin Wenliang, Matthew Aitchison, Laurent Orseau, 等. 语言建模即压缩. 载于第十二届国际学习表征会议.
[13] Yuzhen Huang, Jinghan Zhang, Zifei Shan, 和 Junxian He. 压缩线性地表示智能. arXiv预印本 arXiv:2404.09937, 2024.
[14] Claude Elwood Shannon. 通信的数学理论. 贝尔系统技术期刊, 27(3):379-423, 1948.
[15] Lukas Berglund, Meg Tong, Max Kaufmann, Mikita Balesni, Asa Cooper Stickland, Tomasz Korbak, 和 Owain Evans. 逆转诅咒:在“A是B”上训练的大语言模型无法学会“B是A”. arXiv预印本 arXiv:2309.12288, 2023.
[16] Jacob Austin, Daniel D Johnson, Jonathan Ho, Daniel Tarlow, 和 Rianne Van Den Berg. 离散状态空间中的结构化去噪扩散模型. 神经信息处理系统进展, 34:17981-17993, 2021.
[17] Aaron Lou, Chenlin Meng, 和 Stefano Ermon. 通过估计数据分布比率进行离散扩散语言建模. arXiv预印本 arXiv:2310.16834, 2023.
[18] Jiaxin Shi, Kehang Han, Zhe Wang, Arnaud Doucet, 和 Michalis K Titsias. 面向离散数据的简化与广义掩码扩散. arXiv预印本 arXiv:2406.04329, 2024.
[19] Subham Sekhar Sahoo, Marianne Arriola, Yair Schiff, Aaron Gokaslan, Edgar Marroquin, Justin T Chiu, Alexander Rush, 和 Volodymyr Kuleshov. 简单而有效的掩码扩散语言模型. arXiv预印本 arXiv:2406.07524, 2024.
[20] Jingyang Ou, Shen Nie, Kaiwen Xue, Fengqi Zhu, Jiacheng Sun, Zhenguo Li, 和 Chongxuan Li. 你的吸收式离散扩散秘密地建模了干净数据的条件分布. arXiv预印本 arXiv:2406.03736, 2024.
[21] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, 等. Llama 2:开放基础模型与微调聊天模型. arXiv预印本 arXiv:2307.09288, 2023.
[22] Jacob Devlin. BERT:用于语言理解的深度双向Transformer预训练. arXiv预印本 arXiv:1810.04805, 2018.
[23] Huiwen Chang, Han Zhang, Lu Jiang, Ce Liu, 和 William T Freeman. MaskGIT:掩码生成式图像Transformer. 载于IEEE/CVF计算机视觉与模式识别会议论文集, 页码 11315-11325, 2022.
[24] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebron, 和 Sumit Sanghai. GQA:从多头检查点训练广义多查询Transformer模型. 载于2023年自然语言处理经验方法会议论文集, 页码 4895-4901, 2023.
[25] An Yang, Baosong Yang, Binyuan Hui, Bo Zheng, Bowen Yu, Chang Zhou, Chengpeng Li, Chengyuan Li, Dayiheng Liu, Fei Huang, Guanting Dong, Haoran Wei, Huan Lin, Jialong Tang, Jialin Wang, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Ma, Jianxin Yang, Jin Xu, Jingren Zhou, Jinze Bai, Jinzheng He, Junyang Lin, Kai Dang, Keming Lu, Keqin Chen, Kexin Yang, Mei Li, Mingfeng Xue, Na Ni, Pei Zhang, Peng Wang, Ru Peng, Rui Men, Ruize Gao, Runji Lin, Shijie Wang, Shuai Bai, Sinan Tan, Tianhang Zhu, Tianhao Li, Tianyu Liu, Wenbin Ge, Xiaodong Deng, Xiaohuan Zhou, Xingzhang Ren, Xinyu Zhang, Xipin Wei, Xuancheng Ren, Xuejing Liu, Yang Fan, Yang Yao, Yichang Zhang, Yu Wan, Yunfei Chu, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, Zhifang Guo, 和 Zhihao Fan. Qwen2技术报告, 2024. URL https://arxiv.org/abs/2407.10671
[26] An Yang, Baosong Yang, Beichen Zhang, Binyuan Hui, Bo Zheng, Bowen Yu, Chengyuan Li, Dayiheng Liu, Fei Huang, Haoran Wei, Huan Lin, Jian Yang, Jianhong Tu, Jianwei Zhang, Jianxin Yang, Jiaxi Yang, Jingren Zhou, Junyang Lin, Kai Dang, Keming Lu, Keqin Bao, Kexin Yang, Le Yu, Mei Li, Mingfeng Xue, Pei Zhang, Qin Zhu, Rui Men, Runji Lin, Tianhao Li, Tingyu Xia, Xingzhang Ren, Xuancheng Ren, Yang Fan, Yang Su, Yichang Zhang, Yu Wan, Yuqiong Liu, Zeyu Cui, Zhenru Zhang, 和 Zihan Qiu. Qwen2.5技术报告. arXiv预印本 arXiv:2412.15115, 2024.
[27] Shen Nie, Fengqi Zhu, Chao Du, Tianyu Pang, Qian Liu, Guangtao Zeng, Min Lin, 和 Chongxuan Li. 在文本上扩展掩码扩散模型. arXiv预印本 arXiv:2410.18514, 2024.
[28] Shengding Hu, Yuge Tu, Xu Han, Chaoqun He, Ganqu Cui, Xiang Long, Zhi Zheng, Yewei Fang, Yuxiang Huang, Weilin Zhao, 等. MiniCPM:通过可扩展训练策略揭示小型语言模型的潜力. arXiv预印本 arXiv:2404.06395, 2024.
[29] I Loshchilov. 解耦权重衰减正则化. arXiv预印本 arXiv:1711.05101, 2017.
[30] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, 和 Yejin Choi. 神经文本退化的奇特案例. arXiv预印本 arXiv:1904.09751, 2019.
[31] Marianne Arriola, Aaron Gokaslan, Justin T Chiu, Zhihan Yang, Zhixuan Qi, Jiaqi Han, Subham Sekhar Sahoo, 和 Volodymyr Kuleshov. 块扩散:在自回归与扩散语言模型之间插值. arXiv预印本 arXiv:2503.09573, 2025.
[32] Xiao Bi, Deli Chen, Guanting Chen, Shanhuang Chen, Damai Dai, Chengqi Deng, Honghui Ding, Kai Dong, Qiushi Du, Zhe Fu, 等. DeepSeek LLM:以长期主义扩展开源语言模型. arXiv预印本 arXiv:2401.02954, 2024.
[33] Albert Q Jiang, Alexandre Sablayrolles, Arthur Mensch, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Florian Bressand, Gianna Lengyel, Guillaume Lample, Lucile Saulnier, 等. Mistral 7B. arXiv预印本 arXiv:2310.06825, 2023.
[34] Tian Ye, Zicheng Xu, Yuanzhi Li, 和 Zeyuan Allen-Zhu. 语言模型物理学:第2.1部分,小学数学与隐藏推理过程. arXiv电子预印本, abs/2407.20311, 2024年7月. 完整版本见 http://arxiv.org/abs/2407.20311
[35] Zeyuan Allen-Zhu 和 Yuanzhi Li. 语言模型物理学:第3.2部分,知识操作. arXiv电子预印本, abs/2309.14402, 2023年9月. 完整版本见 http://arxiv.org/abs/2309.14402
[36] Ouaïl Kitouni、Niklas Nolte、Diane Bouchacourt、Adina Williams、Mike Rabbat 和 Mark Ibrahim。分解诅咒:你预测哪些 token 构成了反转诅咒及其他问题的基础。arXiv 预印本 arXiv:2406.05183,2024。
[37] Jonathan Ho 和 Tim Salimans。无分类器扩散引导。arXiv 预印本 arXiv:2207.12598,2022。
[38] Jascha Sohl-Dickstein、Eric Weiss、Niru Maheswaranathan 和 Surya Ganguli。使用非平衡热力学的深度无监督学习。载于《国际机器学习会议》,第 2256-2265 页。PMLR,2015。
[39] Jonathan Ho、Ajay Jain 和 Pieter Abbeel。去噪扩散概率模型。《神经信息处理系统进展》,33:6840-6851,2020。
[40] Yang Song、Jascha Sohl-Dickstein、Diederik P Kingma、Abhishek Kumar、Stefano Ermon 和 Ben Poole。通过随机微分方程进行基于分数的生成建模。arXiv 预印本 arXiv:2011.13456,2020。
[41] Xiang Li、John Thickstun、Ishaan Gulrajani、Percy S Liang 和 Tatsunori B Hashimoto。Diffusion-LM 改善可控文本生成。《神经信息处理系统进展》,35:4328-4343,2022。
[42] Shansan Gong, Mukai Li, Jiangtao Feng, Zhiyong Wu, and LingPeng Kong. Diffuseq:使用扩散模型的序列到序列文本生成。arXiv预印本 arXiv:2210.08933,2022。
[43] Xiaochuang Han, Sachin Kumar, and Yulia Tsvetkov. Ssd-lm:用于文本生成和模块化控制的基于单纯形的半自回归扩散语言模型。arXiv预印本 arXiv:2210.17432,2022。
[44] Robin Strudel, Corentin Tallec, Florent Altché, Yilun Du, Yaroslav Ganin, Arthur Mensch, Will Grathwohl, Nikolay Savinov, Sander Dieleman, Laurent Sifre, et al. 用于文本生成的自条件嵌入扩散。arXiv预印本 arXiv:2211.04236,2022。
[45] Ting Chen, Ruixiang Zhang, and Geoffrey Hinton. 模拟比特:使用具有自条件作用的扩散模型生成离散数据。arXiv预印本 arXiv:2208.04202,2022。
[46] Sander Dieleman, Laurent Sartran, Arman Roshannai, Nikolay Savinov, Yaroslav Ganin, Pierre H Richemond, Arnaud Doucet, Robin Strudel, Chris Dyer, Conor Durkan, et al. 用于类别数据的连续扩散。arXiv预印本 arXiv:2211.15089,2022。
[47] Pierre H. Richemond, Sander Dieleman, and Arnaud Doucet. 具有单纯形扩散的类别SDE,2022。
[48] Tong Wu, Zhihao Fan, Xiao Liu, Yeyun Gong, Yelong Shen, Jian Jiao, Hai-Tao Zheng, Juntao Li, Zhongyu Wei, Jian Guo, Nan Duan, and Weizhu Chen. Ar-diffusion:用于文本生成的自回归扩散模型,2023。
[49] Rabeeh Karimi Mahabadi, Hamish Ivison, Jaesung Tae, James Henderson, Iz Beltagy, Matthew E. Peters, and Arman Cohan. Tess:文本到文本自条件单纯形扩散,2024。
[50] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Mingxuan Wang. Dinoiser:通过操纵噪声进行扩散条件序列学习。arXiv预印本 arXiv:2302.10025,2023。
[51] Yizhe Zhang, Jiatao Gu, Zhuofeng Wu, Shuangfei Zhai, Joshua Susskind, and Navdeep Jaitly. Planner:通过潜在语言扩散模型生成多样化段落。Advances in Neural Information Processing Systems,36:80178-80190,2023。
[52] Aaron Lou and Stefano Ermon. 反射扩散模型,2023。
[53] Alex Graves, Rupesh Kumar Srivastava, Timothy Atkinson, and Faustino Gomez. 贝叶斯流网络。arXiv预印本 arXiv:2308.07037,2023。
[54] Zhenghao Lin, Yeyun Gong, Yelong Shen, Tong Wu, Zhihao Fan, Chen Lin, Nan Duan, and Weizhu Chen. 使用扩散语言模型进行文本生成:一种带有连续段落去噪的预训练方法。In International Conference on Machine Learning,pages 21051-21064. PMLR,2023。
[55] Kaiwen Xue, Yuhao Zhou, Shen Nie, Xu Min, Xiaolu Zhang, Jun Zhou, and Chongxuan Li. 通过随机微分方程统一贝叶斯流网络与扩散模型。arXiv预印本 arXiv:2404.15766,2024。
[56] Ruixiang Zhang, Shuangfei Zhai, Yizhe Zhang, James Thornton, Zijing Ou, Joshua Susskind, and Navdeep Jaitly. 目标具体分数匹配:离散扩散的整体框架。arXiv预印本 arXiv:2504.16431,2025。
[57] Ishaan Gulrajani and Tatsunori B Hashimoto. 基于似然的扩散语言模型。Advances in Neural Information Processing Systems,36,2024。
[58] Emiel Hoogeboom, Didrik Nielsen, Priyank Jaini, Patrick Forré, and Max Welling. Argmax流与多项分布扩散:学习类别分布。Advances in Neural Information Processing Systems,34:12454-12465,2021。
[59] Emiel Hoogeboom, Alexey A Gritsenko, Jasmijn Bastings, Ben Poole, Rianne van den Berg, and Tim Salimans. 自回归扩散模型。arXiv预印本 arXiv:2110.02037,2021。
[60] Zhengfu He, Tianxiang Sun, Kuanning Wang, Xuanjing Huang, and Xipeng Qiu. Diffusion-bert:使用扩散模型改进生成式掩码语言模型。arXiv预印本 arXiv:2211.15029,2022。
[61] Andrew Campbell, Joe Benton, Valentin De Bortoli, Thomas Rainforth, George Deligiannidis, and Arnaud Doucet. 离散去噪模型的连续时间框架。Advances in Neural Information Processing Systems,35:28266-28279,2022。
[62] Chenlin Meng, Kristy Choi, Jiaming Song, and Stefano Ermon. 具体分数匹配:面向离散数据的广义分数匹配。Advances in Neural Information Processing Systems,35:34532-34545,2022。
[63] Machel Reid, Vincent J. Hellendoorn, and Graham Neubig. Diffuser:通过基于编辑的重建进行离散扩散,2022。
[64] Haoran Sun, Lijun Yu, Bo Dai, Dale Schuurmans, and Hanjun Dai. 基于分数的连续时间离散扩散模型。arXiv预印本 arXiv:2211.16750,2022。
[65] Ouaif Kitouni, Niklas Nolte, James Hensman, and Bhaskar Mitra. Disk:用于结构化知识的扩散模型。arXiv预印本 arXiv:2312.05253,2023。
[66] Lin Zheng, Jianbo Yuan, Lei Yu, and Lingpeng Kong. 用于文本生成的重参数化离散扩散模型。ArXiv,abs/2302.05737,2023。
[67] Zixiang Chen, Huizhuo Yuan, Yongqian Li, Yiwen Kou, Junkai Zhang, and Quanquan Gu. 通过去随机化实现离散扩散模型的快速采样。arXiv预印本 arXiv:2312.09193,2023。
[68] Jiasheng Ye, Zaixiang Zheng, Yu Bao, Lihua Qian, and Quanquan Gu. 扩散语言模型可通过扩展和指令微调执行多种任务。arXiv预印本 arXiv:2308.12219,2023。
[69] Itai Gat, Tal Remez, Neta Shaul, Felix Kreuk, Ricky TQ Chen, Gabriel Synnaeve, Yossi Adi, and Yaron Lipman. 离散流匹配。arXiv预印本 arXiv:2407.15595,2024。
[70] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu, and Qinsheng Zhang. 掩码扩散模型实际上是时间无关的掩码模型,并利用了不准确的类别采样,2024。URL https://arxiv.org/abs/2409.02908
[71] Shreyas Kapur, Erik Jenner, and Stuart Russell. 用于程序合成的语法树扩散。arXiv预印本 arXiv:2405.20519,2024。
[72] Shansan Gong, Shivam Agarwal, Yizhe Zhang, Jiacheng Ye, Lin Zheng, Mukai Li, Chenxin An, Peilin Zhao, Wei Bi, Jiawei Han, et al. 通过从自回归模型适配来扩展扩散语言模型。arXiv预印本 arXiv:2410.17891,2024。
[73] Samar Khanna, Siddhant Kharbanda, Shufan Li, Harshit Varma, Eric Wang, Sawyer Birnbaum, Ziyang Luo, Yanis Miraoui, Akash Palrecha, Stefano Ermon, et al. Mercury:基于扩散的超快速语言模型。arXiv预印本 arXiv:2506.17298,2025。
[74] Huiwen Chang, Han Zhang, Jarred Barber, AJ Maschinot, Jose Lezama, Lu Jiang, Ming-Hsuan Yang, Kevin Murphy, William T Freeman, Michael Rubinstein, et al. Muse:通过掩码生成式Transformer进行文本到图像生成。arXiv预印本 arXiv:2301.00704,2023。
[75] Zebin You、Jingyang Ou、Xiaolu Zhang、Jun Hu、Jun Zhou 和 Chongxuan Li。高效且有效的掩码图像生成模型。arXiv 预印本 arXiv:2503.07197,2025。
[76] Xinyou Wang、Zaixiang Zheng、Fei Ye、Dongyu Xue、Shujian Huang 和 Quanquan Gu。扩散语言模型是通用的蛋白质学习器。arXiv 预印本 arXiv:2402.18567,2024。
[77] Xinyou Wang、Zaixiang Zheng、Fei Ye、Dongyu Xue、Shujian Huang 和 Quanquan Gu。Dplm-2:一种多模态扩散蛋白质语言模型。arXiv 预印本 arXiv:2410.13782,2024。
[78] Siqi Kou、Lanxiang Hu、Zhezhi He、Zhijie Deng 和 Hao Zhang。Clims:一致性大型语言模型。arXiv 预印本 arXiv:2403.00835,2024。
[79] Chenkai Xu、Xu Wang、Zhenyi Liao、Yishun Li、Tianqi Hou 和 Zhijie Deng。Show-o turbo:迈向加速的统一多模态理解与生成。arXiv 预印本 arXiv:2502.05415,2025。
[80] Sulin Liu、Juno Nam、Andrew Campbell、Hannes Stärk、Yilun Xu、Tommi Jaakkola 和 Rafael Gómez-Bombarelli。边生成边思考:带计划去噪的离散扩散。arXiv 预印本 arXiv:2410.06264,2024。
[81] Yuanzhi Zhu、Xi Wang、Stéphane Lathuilière 和 Vicky Kalogeiton。Dimo:将掩码扩散模型蒸馏为一步生成器。arXiv 预印本 arXiv:2503.15457,2025。
[82] Yinuo Ren, Haoxuan Chen, Yuchen Zhu, Wei Guo, Yongxin Chen, Grant M Rotskoff, Molei Tao, 和 Lexing Ying. 离散扩散模型的快速求解器:高阶算法的理论与应用. arXiv预印本 arXiv:2502.00234, 2025.
[83] Satoshi Hayakawa, Yuhta Takida, Masaaki Imaizumi, Hiromi Wakaki, 和 Yuki Mitsufuji. 通过维度相关性进行离散扩散的蒸馏. arXiv预印本 arXiv:2410.08709, 2024.
[84] Yixiu Zhao, Jiaxin Shi, Feng Chen, Shaul Druckmann, Lester Mackey, 和 Scott Linderman. 离散扩散模型的知情校正器. arXiv预印本 arXiv:2407.21243, 2024.
[85] Kaiwen Zheng, Yongxin Chen, Hanzi Mao, Ming-Yu Liu, Jun Zhu, 和 Qinsheng Zhang. 掩码扩散模型实际上是时间无关的掩码模型并利用不准确的分类采样. arXiv预印本 arXiv:2409.02908, 2024.
[86] Yong-Hyun Park, Chieh-Hsin Lai, Satoshi Hayakawa, Yuhta Takida, 和 Yuki Mitsufuji. 跳跃你的步数:优化离散扩散模型的采样调度. 载于第十三届国际学习表征会议, 2024.
[87] Justin Deschenaux 和 Caglar Gulcehre. 超越自回归:通过时间自蒸馏实现快速大语言模型. arXiv预印本 arXiv:2410.21035, 2024.
[88] Prafulla Dhariwal 和 Alexander Nichol. 扩散模型在图像合成上击败GAN. 神经信息处理系统进展, 34:8780-8794, 2021.
[89] Yair Schiff, Subham Sekhar Sahoo, Hao Phung, Guanghan Wang, Sam Boshar, Hugo Dallatorre, Bernardo P de Almeida, Alexander Rush, Thomas Pierrot, 和 Volodymyr Kuleshov. 离散扩散模型的简单引导机制. arXiv预印本 arXiv:2412.10193, 2024.
[90] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, 等. 通过人类反馈训练语言模型遵循指令. 神经信息处理系统进展, 35:27730-27744, 2022.
[91] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, 和 Chelsea Finn. 直接偏好优化:你的语言模型实际上是一个奖励模型. 神经信息处理系统进展, 36, 2024.
[92] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, 等. GPT-4技术报告. arXiv预印本 arXiv:2303.08774, 2023.
[93] Google. 我们的下一代模型:Gemini 1.5, 2024. URL https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024
[94] Anthropic. Claude 3.5 Sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[95] Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang, Bochao Wu, Chengda Lu, Chenggang Zhao, Chengqi Deng, Chenyu Zhang, Chong Ruan, 等. DeepSeek-V3技术报告. arXiv预印本 arXiv:2412.19437, 2024.
[96] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, 等. 思维链提示激发大语言模型的推理能力. 神经信息处理系统进展, 35:24824-24837, 2022.
[97] Joon Sung Park, Joseph O'Brien, Carrie Jun Cai, Meredith Ringel Morris, Percy Liang, 和 Michael S Bernstein. 生成式智能体:人类行为的交互式模拟. 载于第36届ACM用户界面软件与技术年度研讨会论文集, 第1-22页, 2023.
[98] Lei Wang, Chen Ma, Xueyang Feng, Zeyu Zhang, Hao Yang, Jingsen Zhang, Zhiyuan Chen, Jiakai Tang, Xu Chen, Yankai Lin, 等. 基于大语言模型的自主智能体综述. 计算机科学前沿, 18(6):186345, 2024.
[99] OpenAI. 学习用大语言模型进行推理, 2024. URL https://openai.com/index/learning-to-reason-with-llms/
[100] Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, 等. DeepSeek-R1:通过强化学习激励大语言模型的推理能力. arXiv预印本 arXiv:2501.12948, 2025.
[101] Benigno Uria, Iain Murray, 和 Hugo Larochelle. 一种深度且可处理的密度估计器. 载于第31届国际机器学习会议论文集, 2014.
[102] Andy Shih, Dorsa Sadigh, 和 Stefano Ermon. 正确地训练和推理任意顺序自回归模型. 载于第31届国际机器学习会议论文集, 2022.
[103] Zhangchen Xu, Fengqing Jiang, Luyao Niu, Yuntian Deng, Radha Poovendran, Yejin Choi, 和 Bill Yuchen Lin. Magpie:通过无提示引导对齐大语言模型从头合成对齐数据. arXiv预印本 arXiv:2406.08464, 2024.
[104] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, 和 Lingming Zhang. Magicoder:利用OSS-Instruct赋能代码生成. arXiv预印本 arXiv:2312.02120, 2023.
[105] Biao Zhang 和 Rico Sennrich. 均方根层归一化. 神经信息处理系统进展, 32, 2019.
[106] Noam Shazeer. GLU变体改进Transformer. arXiv预印本 arXiv:2002.05202, 2020.
[107] Jianlin Su, Murtadha Ahmed, Yu Lu, Shengfeng Pan, Wen Bo, 和 Yunfeng Liu. RoFormer:具有旋转位置嵌入的增强Transformer. Neurocomputing, 568:127063, 2024.
[108] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, 和 Dario Amodei. 神经语言模型的缩放定律. arXiv预印本 arXiv:2001.08361, 2020.
.
[109] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, 等. 训练计算最优的大语言模型. arXiv预印本 arXiv:2203.15556, 2022.
[110] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, 和 Jacob Steinhardt. 测量大规模多任务语言理解. arXiv预印本 arXiv:2009.03300, 2020.
[111] Mirac Suzgun, Nathan Scales, Nathanael Schärli, Sebastian Gehrmann, Yi Tay, Hyung Won Chung, Aakanksha Chowdhery, Quoc V Le, Ed H Chi, Denny Zhou, 等. 挑战BIG-Bench任务以及思维链能否解决它们. arXiv预印本 arXiv:2210.09261, 2022.
[112] Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, 和 Oyvind Tafjord. 你认为你已经解决了问答问题吗?试试ARC,AI2推理挑战. arXiv预印本 arXiv:1803.05457, 2018.
[113] Rowan Zellers, Ari Holtzman, Yonatan Bisk, Ali Farhadi, 和 Yejin Choi. HellaSwag:机器真的能完成你的句子吗? arXiv预印本 arXiv:1905.07830, 2019.
[114] Stephanie Lin、Jacob Hilton 和 Owain Evans。Truthfulqa:衡量模型如何模仿人类虚假陈述。arXiv 预印本 arXiv:2109.07958,2021。
[115] Keisuke Sakaguchi、Ronan Le Bras、Chandra Bhagavatula 和 Yejin Choi。Winogrande:大规模对抗性 Winograd 模式挑战。Communications of the ACM,64(9):99-106,2021。
[116] Yonatan Bisk、Rowan Zellers、Jianfeng Gao、Yejin Choi 等。Piqa:关于自然语言中物理常识的推理。载于 Proceedings of the AAAI conference on artificial intelligence,2020。
[117] Karl Cobbe、Vineet Kosaraju、Mohammad Bavarian、Mark Chen、Heewoo Jun、Lukasz Kaiser、Matthias Plappert、Jerry Tworek、Jacob Hilton、Reiichiro Nakano 等。训练验证器以求解数学应用题。arXiv 预印本 arXiv:2110.14168,2021。
[118] Dan Hendrycks、Collin Burns、Saurav Kadavath、Akul Arora、Steven Basart、Eric Tang、Dawn Song 和 Jacob Steinhardt。使用 math 数据集衡量数学问题求解能力。arXiv 预印本 arXiv:2103.03874,2021。
[119] David Rein、Betty Li Hou、Asa Cooper Stickland、Jackson Petty、Richard Yuanzhe Pang、Julien Dirani、Julian Michael 和 Samuel R Bowman。Gpqa:一个研究生级别、无需谷歌即可作答的问答基准。arXiv 预印本 arXiv:2311.12022,2023。
[120] Mark Chen、Jerry Tworek、Heewoo Jun、Qiming Yuan、Henrique Ponde De Oliveira Pinto、Jared Kaplan、Harri Edwards、Yuri Burda、Nicholas Joseph、Greg Brockman 等。评估在代码上训练的大语言模型。arXiv 预印本 arXiv:2107.03374,2021。
[121] Mohammad Bavarian, Heewoo Jun, Nikolas Tezak, John Schulman, Christine McLeavey, Jerry Tworek, and Mark Chen. 语言模型中间填充的高效训练。arXiv预印本 arXiv:2207.14255, 2022。
[122] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. 基于大语言模型的程序合成。arXiv预印本 arXiv:2108.07732, 2021。
[123] Haonan Li, Yixuan Zhang, Fajri Koto, Yifei Yang, Hai Zhao, Yeyun Gong, Nan Duan, and Timothy Baldwin. Cmmlu:衡量中文大规模多任务语言理解。arXiv预印本 arXiv:2306.09212, 2023。
[124] Yuzhen Huang, Yuzhuo Bai, Zhihao Zhu, Junlei Zhang, Jinghan Zhang, Tangjun Su, Junteng Liu, Chuancheng Lv, Yikai Zhang, Yao Fu, et al. C-eval:面向基础模型的多层级多学科中文评估套件。神经信息处理系统进展,36,2024。
[125] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. 少样本语言模型评估框架,07 2024。URL https://zenodo.org/records/12608602
算法1 LLaDA的预训练
要求:掩码预测器 ,数据分布
1: repeat
2: # 以的概率,的序列长度服从U[1, 4096]
3:
4: # 定义于式(7)
5: 计算 # 是的序列长度
6: 计算并运行优化器。
7: until 收敛
8: 返回
算法2 LLaDA的监督微调
要求:掩码预测器,配对数据分布
1: repeat
2: # 关于SFT数据的详细信息请参阅附录B.1
3:
4: # 定义于式(7)
5: 计算 # 是的序列长度
6: 计算并运行优化器。
7: until 收敛
8: 返回
算法3 LLaDA的条件对数似然评估
要求:掩码预测器,提示,响应,蒙特卡洛估计次数
1: log_likelihood
2: for to do
3: # 是的序列长度
4: 通过从中均匀采样个token进行无放回掩码来获得
5:
6: end for
7: log_likelihood
8: 返回log_likelihood
A 掩码扩散模型的公式化
A.1 训练
MDMs [16|20]以不同于自回归模型的方式定义模型分布。
这些模型引入了一个由时间索引的前向过程。该过程逐渐且独立地掩码序列中的所有token。在时间时,数据点被完全观测且无掩码,而对于,表示在期望上具有不同掩码比例的潜在变量。
形式上,给定时的条件分布由完全因子化形式定义:
其中每个token的条件分布由下式给出:
Here, M denotes the mask token. Intuitively, each token either remains unchanged or is masked, with the probability of being masked increasing linearly as progresses from 0 to 1. At , all
Require: mask predictor , prompt , answer length , sampling steps 1: Set is a fully masked sequence of length . 2: for down to step do 3: 4: # we employ greedy sampling when predicting masked tokens 5: for to do 6: if then 7: 8: else 9: with probability , is set to 10: end if 11: end for 12: 13: end for 14: Return tokens are guaranteed to be masked, meaning that follows a Dirac distribution concentrated on a sequence of fully masked tokens. Notably, the linear masking probability is analogous to but distinct from, the noise schedule in continuous diffusion models [38,40]. This linearity is motivated by the assumption that the information in the text is proportional to the number of tokens on average, making it reasonable to lose information linearly during the forward process.
The forward process is not only reversible but also corresponds to a reverse process that is fully factorized across all tokens. The reverse process, from time to 0, generates new data from sequences of fully masked tokens. The conditional distribution for the reverse process, for , is factorized as:
where the conditional distribution for each token is:
Thus, the key function to estimate is the conditional distribution , which predicts the original token if it is masked in the input . This is analogous to the data prediction form in continuous diffusion models.
As proven in [20], an equivalent yet time- free parameterization can be derived as:
where denotes the collection of unmasked tokens in , which is identical to the corresponding tokens in the original data since unmasked tokens are solely determined by and are independent of time . Intuitively, this implies that estimating the data prediction function is equivalent to estimating the conditional distributions on clean data, which is time- invariant. Consequently, the time need not be provided as input to the parametric model.
尽管掩码扩散的发展并非平凡,但其实现是直接的。我们首先引入掩码预测器,一个参数化模型 (例如,一个不带因果掩码的Transformer),它以任意 的 作为输入,并同时预测所有被掩码的标记。然后,我们如下定义模型分布 :从 作为完全被掩码的标记序列开始,我们模拟一个由 参数化的近似逆向过程,从 到 0。在 时诱导出的边缘分布即代表模型分布 。
要求:掩码预测器 ,提示 ,答案长度 ,采样步数
1: 设置 为长度为 的完全被掩码序列。
2: for 递减到 步长 do
3:
4: for 到 do
5: if then
6:
7: else
8:
9:
10: end if
11: end for
12: # 在时间步 处未掩码标记的数量为
13: for 到 do
14: if then
15: # 选择置信度最低的 个位置进行重新掩码。
16: end if
17: end for
18:
19: end for
20: 返回
形式上,掩码预测器使用带掩码的交叉熵损失进行训练:
其中 从训练数据中采样, 从 中均匀采样,且 从 中采样。指示函数 确保交叉熵损失仅对被掩码的标记进行计算。在Shi等人[18]、Sahoo等人[19]、Ou等人[20]中,已经证明损失函数 是模型分布负对数似然的上界:
总之,这种有原则的方法通过在正向过程中逐步掩码标记,并在逆向过程中学习恢复数据分布来训练生成模型,所有这些都在(近似)最大似然估计框架下进行。
A.2 推理
式[12]中的交叉熵损失有几种等价形式[20]。第一种形式由下式给出:
其中 从 中均匀采样,且 通过从 中无放回地均匀采样 个标记进行掩码而获得。尽管精确掩码 个标记与以概率 独立掩码每个标记不同,但这两种掩码方法在期望上导致等价的结果[20]。
任意顺序自回归模型(AO- ARM)[59][101][102]对所有可能的 个变量的顺序 以自回归方式刻画联合分布。为了学习这样的分布,AO- ARM利用权重共享神经网络对所有单变量条件分布进行建模,并采用掩码标记来表示缺失变量。在训练期间,最小化所有顺序的均匀分布 上的期望负对数似然:
直观上, 可以理解为一个被掩码的标记 ,其在 中的索引被掩码。可以进一步证明,式(15)等价于式(12)。这种联系解释了LLaDA的双向推理能力,尽管它在推理过程中从未被显式使用。
此外,Nie等人[27]引入了无监督无分类器引导(CFG),这是一种即插即用技术,用于平衡与提示的对齐和文本多样性。具体而言,无监督CFG在推理时采用以下修改后的掩码预测器:
其中 是与 长度相同的掩码序列, 是控制 强度的可调超参数。为确保与 ARM 的公平比较,我们在正文中未对 LLaDA 应用 CFG。然而,如附录 [B.3] 所示,LLaDA 与 CFG 完全兼容,并且在应用 CFG 时持续表现出性能提升。
A.3 算法
在本节中,我们介绍训练和推理算法。具体而言,我们分别在算法 [1] 和算法 [2] 中介绍预训练和有监督微调算法。此外,算法 [3] 中提供了似然评估算法。最后,我们在算法 [4] 和算法 [5] 中给出逆向生成过程,它们分别对应随机重掩码和低置信度 [23] 重掩码策略。
B 实验
B.1 数据收集与预处理
在本节中,我们首先介绍预训练和 SFT 的数据收集与过滤流程。然后,我们描述 LLaDA 在训练期间如何利用这些数据集。
我们的预训练语料库由多种公开可用来源构建,包括网页数据、书籍、学术论文、社交媒体、百科全书、数学和代码,其中约 为中文、 为英文、 为代码。数据清洗过程包括 PDF 文本提取、去重和有害内容过滤。为进一步确保质量,我们微调了一个 BERT [22] 模型用于自动化数据质量标注,从而能够选择更高质量的样本。我们的 SFT 数据集由 100 万条人工标注样本和 350 万条合成样本组成,合成样本使用与 Xu et al. [103]、Wei et al. [104] 所提出的方法类似的方式生成。
我们将预训练语料库中收集的文档拼接起来,并按照预定义的序列长度将文本分割为固定长度序列。
对于 SFT,采用动态序列长度策略,即在较短的配对末尾追加 |EOS| token,以确保每个小批量内所有样本的序列长度一致。值得注意的是,填充的 |EOS| token 被视为响应的一部分,即被掩码并纳入训练目标。在采样期间,|EOS| token 会从生成的输出中移除。该策略确保模型学会通过生成 |EOS| 来控制其响应长度,使响应长度能够有效地与给定提示对齐。
此外,对于 轮对话 ,我们将其视为 个单轮对话对,即 ,并随机采样其中一个。这种数据划分策略不仅赋予 LLaDA 多轮对话能力,而且与上述 |EOS| 填充策略相一致。
| 我们的 ARM 基线 1B | LLaDA 1B | 我们的 ARM 基线 7B | LLaDA 8B | LLaMA3 8B | |
| 层数 | 22 | 22 | 28 | 32 | 32 |
| 模型维度 | 2048 | 2048 | 4096 | 4096 | 4096 |
| 注意力头数 | 32 | 32 | 32 | 32 | 32 |
| 词表大小 | 126,464 | 126,464 | 126,464 | 126,464 | 128,000 |
| FFN 维度 | 5634 | 5634 | 13,440 | 12,288 | 14,336 |
| 键/值头数 | 4 | 4 | 8 | 32 | 8 |
| 总参数量 | 1.49 B | 1.49 B | 6.83 B | 8.02 B | 8.03 B |
| 非嵌入参数量 | 0.97 B | 0.97 B | 5.80 B | 6.98 B | 6.98 B |
| ARC-C | Hellaswag | TruthfulQA | WinoGrande | GPQA | PIQA | |
| 无 CFG | 45.9 | 70.5 | 46.1 | 74.8 | 25.2 | 73.6 |
| 有 CFG | 47.9 | 72.5 | 46.4 | 74.8 | 26.1 | 74.4 |
B.2 模型训练细节
本节提供 LLaDA 及相应 ARM 基线的训练细节。
首先,为提高效率,我们训练了一个 ARM 和一个 MDM,二者均为 1.5B 参数且架构相同。此外,我们将 MDM 扩展到 8B 参数。由于计算资源限制,我们没有训练具有相同架构的 8B 自回归模型。相反,我们使用之前训练的 7B 自回归模型进行比较。这四个模型用于第 [3.1] 节中的可扩展性分析。
对于我们训练的 ARM 和 MDM,我们采用了类似 LLaMA [6] [21] 的 Transformer 架构。具体而言,我们采用 RMSNorm [105] 来稳定训练,使用 SwiGLU [106] 作为激活函数以增强非线性,并集成 RoPE [107] 以实现更具表现力的位置编码。表 [5] 提供了模型架构的概览。
对于 1B 和 7B ARM 基线,以及 1B 和 8B LLaDA 模型,我们使用了 AdamW 优化器 [29],权重衰减为 0.1,并采用 Warmup-Stable-Decay [28] 学习率调度器。学习率在前 2000 次迭代中从 0 线性增加到最大值,然后保持不变。对于 LLaDA 8B,为确保训练稳定,学习率在预训练期间降低了一次,详见第 [2.2] 节。对于 1B ARM 基线以及 1B 和 8B LLaDA 模型,最大学习率设置为 ,批大小为 1280,未进行任何超参数调优。对于 7B ARM 基线,最大学习率设置为 ,批大小为 4224,二者均通过网格搜索选择。
此外,我们采用广泛使用的公式[108] [109]来计算图[3]中的训练FLOPs,其中表示非嵌入参数的数量,表示训练token的总数。与图[3]对应的详细结果见表[18]和表[19]。
B.3 无分类器引导的消融实验
本节对无分类器引导(CFG)进行消融研究。关于CFG的理论细节可在附录[A.2]中找到。
为简便起见,我们选取了六个代表性基准,包括ARC-C、HellaSwag、TruthfulQA、WinoGrande、PIQA和GPQA,并使用LLaDA 8B Base进行实验。我们为每个任务在中搜索CFG缩放系数,并报告最佳结果。如表[6]所示,CFG持续提升LLaDA的性能。我们强调,为确保与ARM的公平比较,论文中报告的主要结果未使用CFG。
| BBH | GSM8K | 数学 | HumanEval | MBPP | ||
| 自回归 | 38.1 | 63.1 | 23.6 | 18.3 | 33.4 | |
| L' = 2 | 37.3 | 62.6 | 25.2 | 14.6 | 33.6 | |
| L' = 4 | 40.0 | 65.7 | 26.6 | 15.9 | 36.0 | |
| L' = 8 | 42.0 | 68.2 | 27.7 | 19.5 | 39.2 | |
| L' = 32 | 45.7 | 68.6 | 29.7 | 29.9 | 37.4 | |
| 块扩散LLaDA | L' = 2 | 48.0 | 70.0 | 30.8 | 26.2 | 40.0 |
| L' = 4 | 48.5 | 70.3 | 31.3 | 27.4 | 38.8 | |
| L' = 8 | 48.6 | 70.2 | 30.9 | 31.1 | 39.0 | |
| L' = 32 | 48.3 | 70.3 | 31.2 | 32.3 | 40.0 | |
| 纯扩散 | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
| GSM8K | 数学 | HumanEval | MBPP | GPQA | MMLU-Pro | ARC-C | |
| 自回归 | 0 | 9.5 | 0 | 0 | 0 | 0 | 84.4 |
| 块扩散 | 24.6 | 23.5 | 17.1 | 21.2 | 29.3 | 32.5 | 88.1 |
| 块扩散 LLaDA | 77.5 | 42.2 | 46.3 | 34.2 | 31.3 | 34.8 | 85.4 |
| 纯扩散 | 69.4 | 31.9 | 49.4 | 41.0 | 33.3 | 37.0 | 88.5 |
B.4 采样策略的细节与消融实验
在本节中,我们首先介绍LLaDA支持的不同采样策略。然后,我们通过消融研究来评估这些采样策略的性能。
灵活的采样策略。在第2.4节图2(c)中展示了LLaDA的反向生成过程。如图4所示,除反向生成过程外,LLaDA还支持在预训练或SFT阶段之后直接进行自回归采样和块扩散[31]采样,无需任何进一步的修改或重新训练。块扩散采样在每个块内应用原始反向过程,在块间应用自回归采样。在原始的块扩散过程中,序列长度动态变化。如图4(c)所示,LLaDA还可以采用固定长度的块扩散策略,我们将其称为块扩散LLaDA,也称为半自回归重掩码。
实验设置。我们使用LLaDA 8B Base和LLaDA 8B Instruct评估不同的采样策略,以进行全面分析。对于LLaDA 8B Base,我们使用表1中基于采样而非似然估计进行评估的五个基准。对于LLaDA 8B Instruct,我们使用表2中除MMLU和HellaSwag之外的七个指标,因为这两个任务仅要求模型生成单个token(即A、B、C或D)。在所有设置中,每个采样步骤生成
| 长度 | BBH | GSM8K | Math | HumanEval | MBPP |
| 随机重掩码 | 32.1 | 21.3 | 9.2 | 11.6 | 21.0 |
| 低置信度重掩码 | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 长度 | BBH | GSM8K | 数学 | HumanEval | MBPP |
| 256 | 45.0 | 70.0 | 30.3 | 32.9 | 40.2 |
| 512 | 50.4 | 70.8 | 30.9 | 32.9 | 39.2 |
| 1024 | 49.7 | 70.3 | 31.4 | 35.4 | 40.0 |
一个token。对于自回归采样和块扩散采样,当生成|EOS| token时终止生成。对于块扩散LLaDA(即半自回归重掩码)和纯扩散采样,LLaDA 8B Base的生成长度固定为1024,而对于LLaDA 8B Instruct,生成长度从\(\{64, 256, 512\}\)中调节,以平衡效率和性能。低置信度重掩码应用于块扩散和块扩散LLaDA中的块内扩散采样,以及纯扩散采样。我们还为LLaDA 8B Base测试了不同的块长度。对于LLaDA 8B Instruct,出于效率考虑,我们仅评估块长度32,因为它在LLaDA 8B Base上取得了最佳结果。
此外,对于LLaDA 8B Instruct,由于SFT数据中|EOS| token的大量填充(详见第[B.1]节),我们观察到在纯扩散采样下,模型输出中|EOS| token的比例变得非常高。这导致生成结果极短并降低模型性能。为缓解此问题,对于HumanEval、MBPP、GSM8K、Math和GPQA,我们在纯扩散采样期间将|EOS| token的置信度分数设为零。这一调整有助于在生成过程中保持适当的|EOS| token比例。
最后,我们通过消融研究,使用纯扩散采样分析随机重掩码和低置信度重掩码策略的效果。出于效率考虑,我们在该分析中使用LLaDA 8B Base,并将生成长度和采样步数设为256。
结果。如表[7]所示,对于块扩散采样,整体性能随块长度增加而提升。此外,表[7]和表[8]均表明,块扩散采样持续优于自回归采样,而块扩散LLaDA采样在标准块扩散采样基础上进一步提升。最后,纯扩散采样取得了最佳的整体性能。
此外,表[9]表明,低置信度重掩码策略持续优于随机重掩码策略。我们假设低置信度重掩码的作用类似于ARM中默认使用的退火采样方法,通过降低生成句子的多样性来提高准确性。
我们发现自回归采样导致LLaDA 8B Instruct的性能非常差。这是因为每个SFT数据都是一个完整的句子,因此在给定序列长度的情况下,LLaDA 8B Instruct倾向于在该长度内生成一个完整句子。相比之下,LLaDA 8B Base不存在此问题,因为预训练数据由截断文档组成(详见附录[B.1]),且模型使用随机序列长度进行训练(详见第[2.2]节)。因此,当给定较短的序列长度时,LLaDA 8B Base倾向于仅生成句子的一部分,该部分随后可作为前缀继续生成。
在表[8]中将块长度设为8,进一步将GSM8K分数从77.5提升至78.6。
B.5 生成长度的消融实验
在本节中,我们对生成长度进行消融研究。
为确保公平性,对于每种设置,我们将采样步数设为等于生成长度,确保在每个采样步骤中,恰好有一个token从掩码转移到文本。我们使用LLaDA 8B Base进行实验。
如表[10]所报告,结果对长度超参数不敏感。
B.6 标准基准与评估细节
在本节中,我们介绍所使用的基准,并展示评估过程的细节。
遵循标准LLM [25] [26]评估实践,我们从四个维度评估LLaDA:
通用能力:MMLU [110]、BBH [111]、ARC-C [112]、Hellaswag [113]、TruthfulQA [114]、WinoGrande [115]和PIQA [116]。
数学与科学能力:GSM8K [117]、Math [118]和GPQA [119]。
代码生成:HumanEval [120]、HumanEval-FIM [121]和MBPP [122]。
中文理解:CMMLU [123]和C-Eval [124]。
对于上述所有基准,我们遵循LLM评估中广泛采用的评估流程[125],主要采用条件似然估计和条件生成。具体而言,对于某些基准,提供提示和多个候选答案,要求模型计算每个候选答案的条件似然。然后选择似然最高的候选答案作为模型的最终答案,并使用准确率作为评估指标。对于其余基准,模型根据给定提示生成响应,并使用精确匹配和其他相关标准等指标评估性能。
对于基础模型,我们对MMLU、CMMLU、C-Eval、ARC-C、Hellaswag、TruthfulQA、WinoGrande、PIQA和GPQA使用条件似然估计,其余基准使用条件生成进行评估。对于指令模型,我们使用条件生成评估所有基准。
| 输入长度 | 输出长度 | LLaDA 8B | LLaMA3 8B 无 KV-Cache | LLaMA3 8B 有 KV-Cache |
| 512 | 512 | 17.03 | 16.70 | 16.32 |
| 1024 | 17.53 | 17.49 | 16.43 | |
| 2048 | 18.52 | 20.00 | 16.73 | |
| 1024 | 512 | 17.53 | 17.16 | 16.36 |
| 1024 | 18.01 | 18.26 | 16.41 | |
| 2048 | 19.02 | 21.39 | 16.74 |
对于基础模型,我们使用广泛采用的开源评估框架lm-evaluation-harness [125],但HumanEval-FIM指标除外,该框架不支持该指标。对于基础模型上的HumanEval-FIM以及指令模型上的所有评估指标,我们使用内部评估库。我们选择内部库的原因是,相对于我们的内部评估,lm-evaluation-harness与Yang等人[25]报告的LLaMA3结果偏差更大。
对于通过条件似然估计评估的基准,我们使用蒙特卡洛估计来近似LLaDA的公式[6]。由于MMLU、CMMLU和C-EVAL仅需要单个token的似然,对这些基准而言单次蒙特卡洛估计即可。对于所有其他基准,我们发现128个蒙特卡洛样本足以产生稳定结果。
对于使用条件生成评估的基准,我们对LLaDA Base和LLaDA Instruct均采用带有低置信度重掩码策略的纯扩散采样。对于LLaDA Base,我们将生成长度和采样步数均设为1024。对于LLaDA Instruct,采样步数设为等于答案长度,具体配置如下:MMLU和HellaSwag为3,GPQA为64,MBPP和MMLU-Pro为256,HumanEval、GSM8K、Math和ARC-C为512。如附录[B.4]详述,对于HumanEval、MBPP、GSM8K、Math和GPQA,我们在LLaDA Instruct采样期间将|EOS| token的置信度设为零。
B.7 采样效率分析
在本节中,我们首先分析 LLaDA 的采样效率,包括采样速度和内存消耗。然后我们讨论潜在的优化方法,以进一步提升其效率。
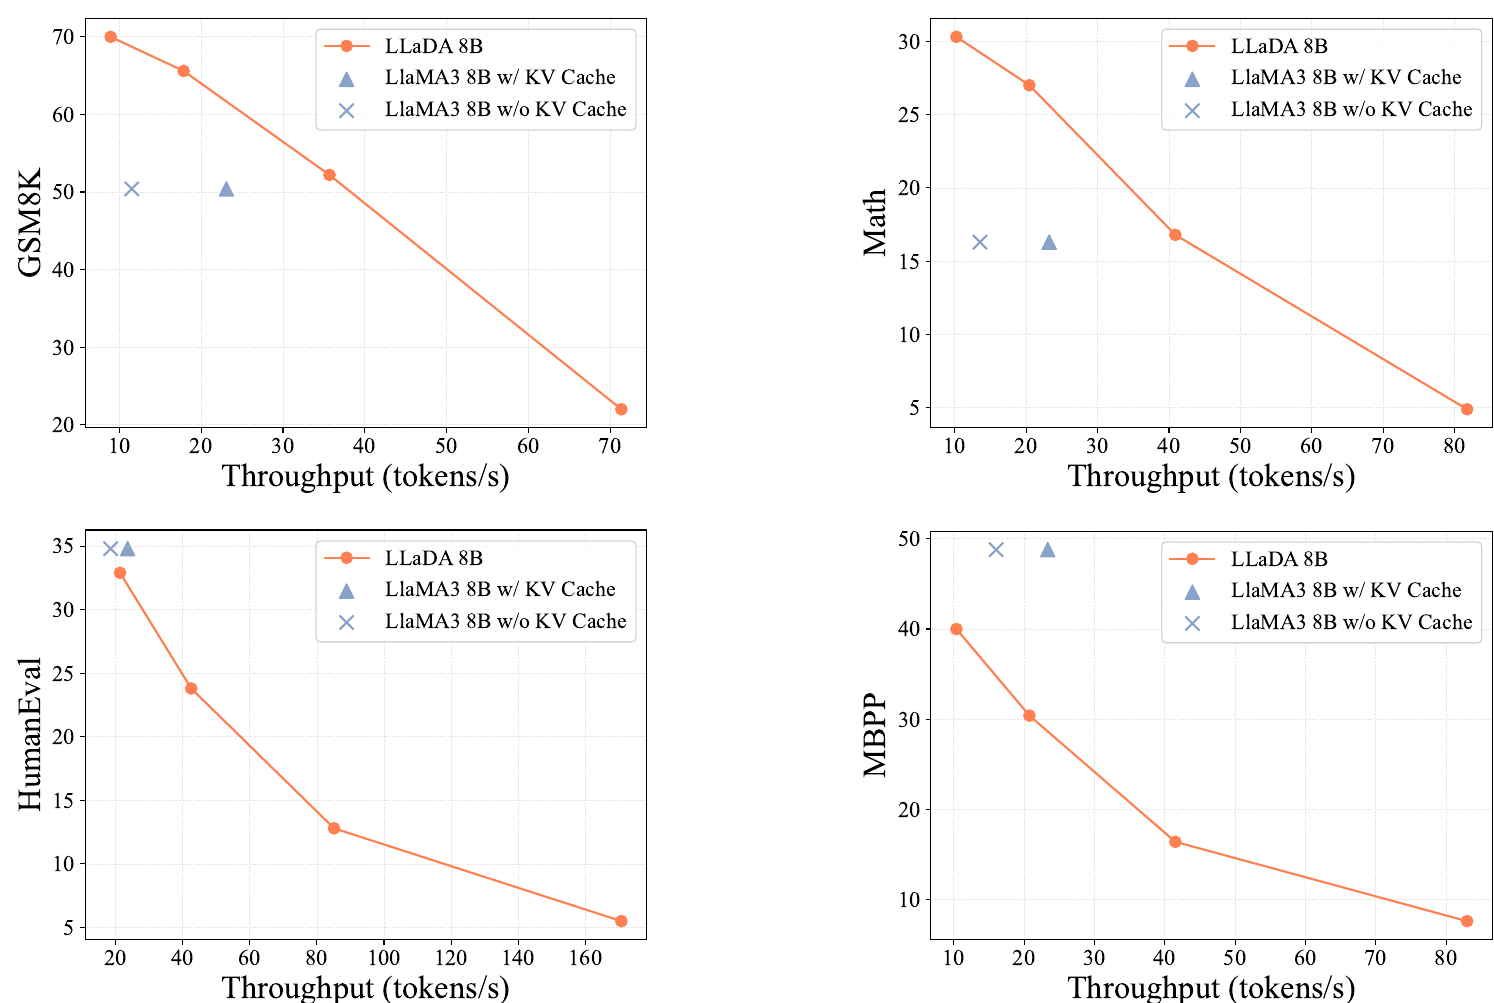
我们使用四个具有代表性的开放式生成基准来分析采样速度:GSM8K、Math、HumanEval 和 MBPP。我们使用被广泛采用的吞吐量指标来衡量生成速度,其定义为每秒生成的 token 数量。我们比较 LLaDA 8B Base 和 LLaMA3 8B Base,两者均使用 bfloat16 精度。本节中的所有实验均在单块 A100-80GB GPU 上进行,批大小为 1。对于 LLaDA,在所有四个基准上输出长度均固定为 256 个 token。
图 5 表明,LLaDA 通过调整采样步数,能够在生成质量与速度之间实现灵活的权衡。具体而言,在 GSM8K 和 Math 数据集上,LLaDA 8B Base 在性能上与 LLaMA3 8B Base 相当,同时吞吐量分别高出 1.5 倍和 1.8 倍,尽管 LLaMA3 使用了 KV Cache,而 LLaDA 未采用任何推理优化技术。在 HumanEval 基准上,当吞吐量相匹配时,LLaDA 8B Base 的表现与 LLaMA3 8B Base 相当。在 MBPP 基准上,LLaDA 8B Base 落后于 LLaMA3 8B Base。
对于 LLaMA3,KV 缓存所带来的加速收益在 HumanEval 数据集上明显较弱,这可归因于其相对较短的提示长度。具体而言,GSM8K、Math、MBPP 和 HumanEval 的平均提示长度分别为 894、680、628 和 132 个 token。
表 [1] 比较了 LLaDA 8B Base 与 LLaMA3 8B Base 之间的内存消耗。为避免因训练数据差异而导致的生成长度变化,我们在内存分析期间固定输入和输出的 token 长度。对于 LLaDA,无论采样步数多少,内存使用量均保持不变。其内存消耗与不使用 KV 缓存的 LLaMA3 8B Base 相当,但略高于使用 KV 缓存的情况。
| 4 步 | 5 步 | 6 步 | |
| LLaMA3 8B Base | 38.0 | 35.0 | 34.0 |
| LLaDA 8B Base | 64.0 | 41.0 | 44.0 |
我们强调,本研究的目标并非提出一个比ARMs更快的模型。相反,我们旨在展示扩散模型在大规模语言建模中的潜力,并挑战“LLM的核心能力(如可扩展性、上下文学习和指令遵循)本质上依赖于ARMs”这一常见假设。大量研究[31, 79, 87]致力于通过算法或架构创新来提高MDMs的生成效率。我们将类似的效率导向探索留给LLaDA的未来工作。
B.8 iGSM数据集上的评估
为了进一步评估LLaDA的数学能力,我们在iGSM [34]上测试其性能,这是一个无限的、类似GSM8K的合成数据集。iGSM通过特定规则生成,其参数控制问题的难度(即解题步骤的数量)。为保持评估一致性,我们按照GSM8K格式,在最终解答后附加“#### Sanswer”。以下是一个解题步骤设为4的示例:
(问题)North Star Elementary每个文化研究教室的数量等于1。Westridge Elementary每个舞蹈工作室的数量等于North Star Elementary每个教室与North Star Elementary每个文化研究教室之和的3倍。Westridge Elementary有多少个舞蹈工作室?(解答)将North Star Elementary的文化研究教室定义为;因此。将North Star Elementary的教室定义为;因此。将Westridge Elementary的舞蹈工作室定义为;;因此 #### 1
由于GSM8K与iGSM之间存在细微差异(例如,使用模5算法系统),我们遵循[34]的做法,为每个问题提供系统提示以及四个示例问答对。
(提示)你是解决涉及加法、减法和乘法的小学数学问题的专家。你以统一格式解决所有问题。所有计算均在模5下进行。例如,等于3,等于1,等于4,等于4,等于4。提供解答时,请以“#### x”结尾,其中x是你的最终答案,为0到4之间的整数。你必须使用相同的解答格式解决所有问题。我们的场景涉及最多四类对象:学校、教室、背包和文具。每所学校可能包含教室,每个教室可能包含背包,每个背包可能包含文具。我们可以指定数量,例如每个Lakeshore High的舞蹈工作室数量。假设每个同名实体具有相同的配置;例如,每个Lakeshore High包含相同数量的舞蹈工作室。另一个指导原则是:未提及的即不存在——当我们提到Lakeshore High的教室时,我们只讨论场景中明确提到的教室。此外,如果Lakeshore High根本未被提及,则其中的任何教室自动被视为不存在(即0)。
对于从4到6的解题步骤范围,我们为每种情况生成100个问题,并在表[2]中报告相应的准确率。如表所示,LLaDA 8B Base在未见过的数学问题上相较于LLaMA3 8B Base展现出显著且一致的優勢,这与表[1]中的结果一致。
| 用户 LLaDA | 规律运动对身心健康有哪些益处? | ||||||||||
| 规律运动 | 可以 | 通过 | 增强 | 肌肉 | 和 | 骨骼 | 、 | 改善 | 心血管 | 健康 | |
| 、 | 以及 | 降低 | 慢性 | 疾病 | 糖尿病 | 和 | 心脏病 | 的 | 风险 | 来 | |
| 改善 | 身体 | 健康 | 。 | 它 | 还 | 可以 | 改善 | 心理 | 健康 | 和 | |
| 焦虑 | 、 | 改善 | 情绪 | 、 | 并 | 增强 | 认知 | 功能 | 此外 | 运动 | |
| 可以 | 改善 | 睡眠 | 质量 | 并 | 提高 | 能量 | 水平 | 。 | |||
B.9 诗歌补全任务
本节中,我们展示诗歌补全数据集中的示例如下。
示例1:
提示:窈窕淑女的下一句是什么?直接输出句子即可。
答案:君子好逑。
示例2:
提示:不拘一格降人才的上一句是什么?直接输出句子即可。
答案:我劝天公重抖擞。
B.10 更多案例研究
本节中,我们展示LLaDA 8B Instruct的更多案例研究。首先,表[13]展示了块扩散LLaDA采样的采样过程,而表[14]描绘了带有随机重掩码的多轮对话的采样过程。此外,表[15]和表[16]提供了单轮和多轮对话的更多示例。最后,表[17]展示了LLaDA 8B Instruct模型成功的诗歌反向补全示例,而GPT-4o则失败了。
C 影响声明
我们的工作展示了扩散模型在大规模语言建模中的潜力,并挑战了“LLM的核心能力(如可扩展性、上下文学习和指令遵循)本质上依赖于ARMs”这一常见假设。我们的发现为探索自然语言处理中的替代概率范式开辟了新途径,在对话式AI、代码生成和复杂推理任务中具有潜在应用。
然而,扩散模型与传统LLMs一样,会引发类似的社会关切。这些包括大规模训练对环境的影响、可能被滥用于生成有害内容,以及训练数据中存在的偏见的放大。应对这些挑战对于确保扩散语言模型的负责任开发和部署至关重要。
表14:多轮对话的可视化。我们采用随机重掩码策略。在LLaDA的响应中,较深的颜色表示在采样后期阶段预测的token,而较浅的颜色对应较早的预测。
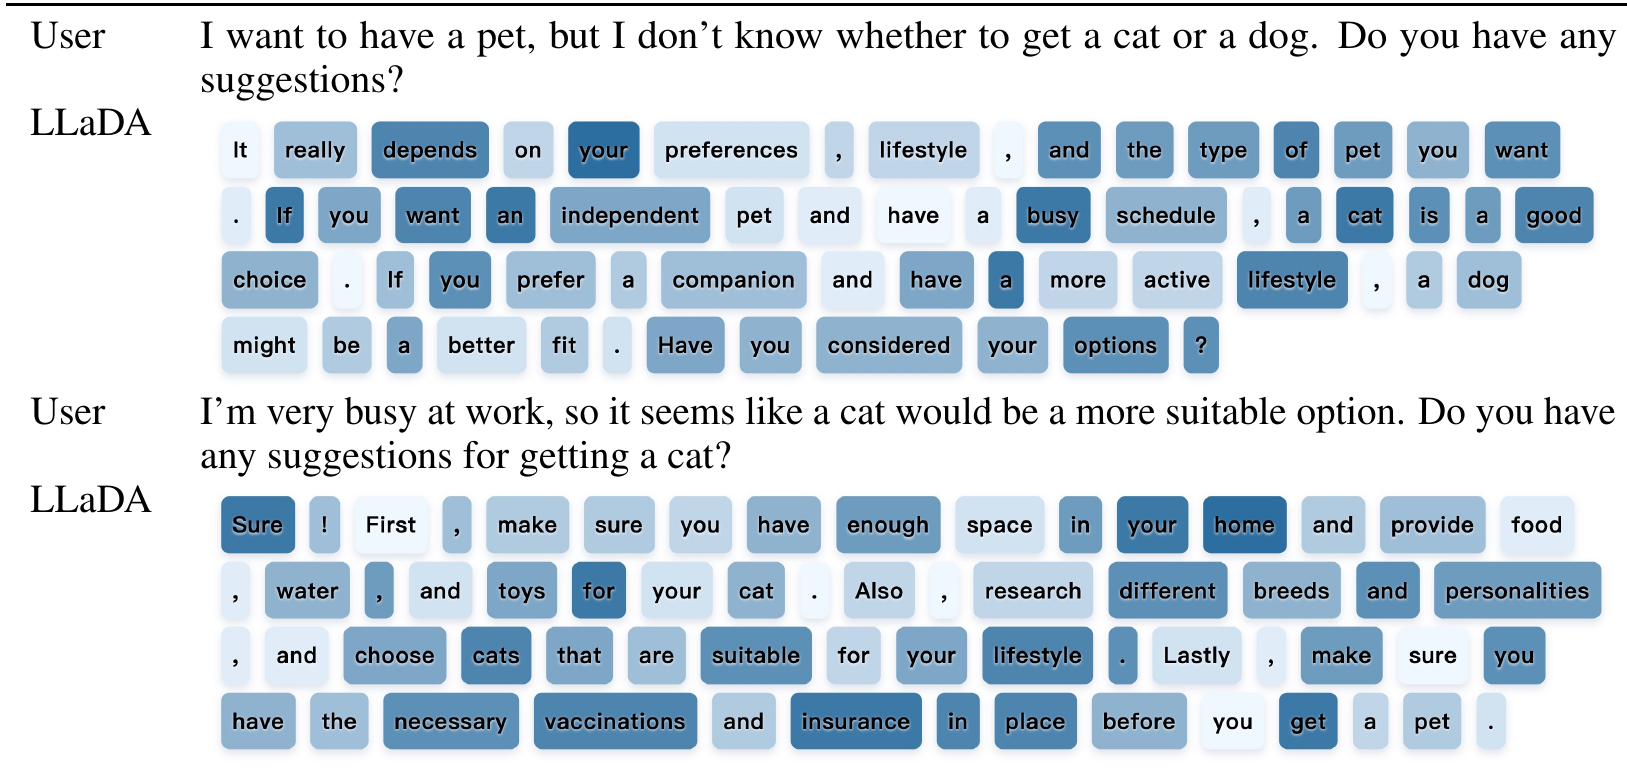
| 理解源文本的只读背景(非待翻译源文本): 表14:多轮对话可视化。我们采用随机重掩码策略。在LLaDA的响应中,较深的颜色表示在采样后期预测的token,而较浅的颜色对应较早的预测。 待翻译文本: | 日常生活用户LLaDA 你收到过的一条你觉得很有帮助的建议是什么?我收到过的一条很有帮助的建议是始终保持对学习和成长的开放态度。我发现,愿意探索新想法和新体验帮助我变得更有韧性、更具适应力。通过拥抱成长型思维,我能够在个人和职业层面识别改进和发展的机会。 |
| 日常生活用户LLaDA | 请推荐我三部著名电影当然!以下是三部广受欢迎并广受好评的著名电影:1. 《肖申克的救赎》(1994)——灵感来自一部中篇小说,由弗兰克·达拉邦特执导,这部电影讲述了安迪·杜佛兰的故事,他因谋杀妻子而被定罪,在肖申克监狱中应对艰苦生活,并与一名狱友建立了意想不到的友谊。2. 《教父》(1972)——由弗朗西斯·福特·科波拉执导,这部电影改编自马里奥·普佐的同名小说。它讲述了柯里昂家族的故事,尤其是迈克尔·柯里昂,他崛起掌权并接管了家族的犯罪帝国。3. 《帝国反击战》(1980)——由乔治·卢卡斯执导,这部电影延续了《星球大战》传奇中一位年轻天行者的故事。它讲述了卢克·天行者帮助义军同盟对抗银河帝国并摧毁强大武器死星的故事。所有这些电影都因其电影成就、强大的叙事和令人难忘的角色而备受赞誉。 |
| 翻译用户LLaDA | 请帮我把这句话翻译成中文:‘What is now proved was once only imagined’ 现在被证明的曾经只是想象 |
| 翻译用户LLaDA | 请帮我把这句话翻译成德语:‘What is now proved was once only imagined’ 我把他去查查过,我其实没再问啊。 |
| 数学用户LLaDA | 艾玛决定每周跑4次冲刺、每周5次。她每次冲刺跑75米。她一周总共跑多少米?艾玛每次跑4次冲刺,所以她一周总共跑4 x 5 = 20次冲刺。每次冲刺长75米,所以艾玛一周总共跑20 x 75 = 1500米。最终结果是1500 |
| 代码用户LLaDA | 我正在写Python代码,我有一个数组,请帮我从大到小排序当然!你可以使用‘sort()’方法或‘sorted()’函数在Python中从大到小对数组排序。下面是一个示例:### 使用‘sort()’方法:my_array = [3, 1, 4, 1, 5, 2]my_array.sort(reverse=True)print(my_array) |
| 理解源文本的只读背景(非待翻译源文本):表14:多轮对话的可视化。我们采用随机重掩码策略。在LLaDA的响应中,较深的颜色表示在采样后期预测的标记,而较浅的颜色对应于较早的预测。待翻译文本:日常生活 | |
| 用户 | 我该如何准备求职面试? |
| LLaDA | 为了准备求职面试,你应该研究公司和职位,练习常见的面试问题,并穿着得体。 |
| 用户 | 有哪些常见的面试问题? |
| LLaDA | 一些常见的面试问题包括“请介绍一下你自己”和“你为什么想为我们工作”? |
| 日常生活 | |
| 用户 | 我该如何开始学习编程? |
| LLaDA | 要学习编程,你可以从选择一门你感兴趣的编程语言开始。一些流行的语言包括Python、Java和C++。 |
| 用户 | 我应该先学哪门编程语言? |
| LLaDA | 这取决于你的兴趣和目标。Python因其简单性和多功能性,对初学者来说是一门很棒的语言。 |
| 用户 | 学习Python需要多长时间? |
| LLaDA | 学习Python可能需要几周到几个月不等。 |
| 用户 | 有哪些适合初学者的优秀Python项目? |
| LLaDA | 一些适合初学者的优秀Python项目包括构建一个简单的计算器、一个游戏和一个Web应用程序。 |
| 数学 | |
| 用户 | Natalia在四月份向她的48位朋友销售了夹子,然后在五月份销售了数量一半的夹子。Natalia在四月和五月总共销售了多少个夹子? |
| LLaDA | Natalia在四月份向48位朋友销售了夹子。她在五月份销售了数量一半的夹子,所以她五月份销售了48/2 = 24个夹子。总的来说,Natalia在四月和五月总共销售了48 + 24 = 72个夹子。最终结果是72。 |
| 用户 | Natalia在六月份销售的商品数量是五月份的三倍。Natalia在这三个月里总共销售了多少个夹子? |
| LLaDA | Natalia在四月份向48位朋友销售了夹子。她在五月份销售了数量一半的夹子,所以她五月份销售了48/2 = 24个夹子。Natalia在六月份销售的商品数量是五月份的三倍,所以她六月份销售了24 * 3 = 72个夹子。总的来说,Natalia在这三个月里总共销售了48 + 24 + 72 = 144个夹子。最终结果是144。 |
| 用于理解原文的只读背景(非待翻译源文本): | |
| 表14:多轮对话可视化。我们采用随机重掩码策略。在LLaDA的响应中,较深的颜色表示在采样后期预测的token,而较浅的颜色对应较早的预测。 | 待翻译文本: |
| 问题1 | 用户 |
| “但闻人语响”的上一句是什么? | GPT-4o |
| “但闻人语响”的上一句是“无可奈何花落去”,这两句出自唐代词人李清照的(武陵春,春晚:无可奈何花落去,但闻人语响。这首词表达了作者在春天时节的孤独与感伤,借花落和人语声的描写,反映出词人内心的无奈与失落。 | |
| LLaDA | “但闻人语响”的上一句是“空山不见人” |
| 问题2 | 用户 |
| “夜静春山空”的上一句是什么? | GPT-4o |
| 模型 | 训练 Token 数 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| LLaDA 1B | 37.75B | 2.20e20 | 25.52 | 25.95 | 25.17 | 59.41 | 1.82 | 0.00 |
| LLaDA 1B | 88.08B | 5.13e20 | 27.11 | 26.52 | 26.96 | 61.86 | 3.03 | 1.83 |
| LLaDA 1B | 138.41B | 8.06e20 | 29.32 | 27.13 | 30.20 | 63.38 | 2.35 | 0.00 |
| LLaDA 1B | 239.08B | 1.39e21 | 31.48 | 30.77 | 27.99 | 63.11 | 3.26 | 1.22 |
| LLaDA 1B | 352.32B | 2.05e21 | 35.86 | 34.35 | 31.31 | 65.34 | 3.64 | 3.05 |
| LLaDA 1B | 461.37B | 2.69e21 | 31.86 | 30.98 | 30.12 | 65.51 | 2.35 | 0.61 |
| LLaDA 8B | 62.91B | 2.63e21 | 32.22 | 28.5 | 30.20 | 63.82 | 3.87 | 2.44 |
| LLaDA 8B | 125.83B | 5.27e21 | 33.39 | 33.9 | 34.64 | 66.54 | 8.72 | 3.66 |
| LLaDA 8B | 251.66B | 1.05e22 | 42.84 | 40.59 | 40.10 | 69.04 | 15.31 | 3.66 |
| LLaDA 8B | 377.49B | 1.58e22 | 45.11 | 43.99 | 39.25 | 68.61 | 25.40 | 9.76 |
| LLaDA 8B | 503.32B | 2.11e22 | 43.57 | 41.38 | 42.06 | 70.24 | 27.52 | 9.76 |
| LLaDA 8B | 629.14B | 2.63e22 | 48.80 | 47.13 | 42.24 | 72.09 | 30.10 | 12.80 |
| LLaDA 8B | 679.48B | 2.85e22 | 49.61 | 48.19 | 41.30 | 70.84 | 26.31 | 8.54 |
| LLaDA 8B | 792.72B | 3.31e22 | 50.88 | 49.01 | 42.58 | 70.51 | 31.99 | 6.10 |
| LLaDA 8B | 981.47B | 4.11e22 | 49.47 | 48.10 | 40.27 | 71.38 | - | 6.10 |
| LLaDA 8B | 1107.30B | 4.64e22 | 51.13 | 47.57 | 41.13 | 69.26 | 36.69 | 10.37 |
| LLaDA 8B | 1233.13B | 5.16e22 | 50.52 | 49.72 | 45.05 | 71.49 | 38.97 | 9.76 |
| LLaDA 8B | 1358.95B | 5.69e22 | 54.61 | 53.97 | 49.40 | 74.05 | 48.14 | 17.68 |
| LLaDA 8B | 1547.70B | 6.48e22 | 57.38 | 56.04 | 49.49 | 74.59 | 53.30 | 20.73 |
| LLaDA 8B | 1975.52B | 8.27e22 | 58.52 | 57.87 | 50.68 | 75.35 | - | 19.51 |
| 模型 | 训练 Token 数 | FLOPs | MMLU | CMMLU | ARC-C | PIQA | GSM8K | HumanEval |
| ARM 1B | 37.75B | 2.20e20 | 25.47 | 25.38 | 30.20 | 67.36 | 2.20 | 4.88 |
| ARM 1B | 88.08B | 5.13e20 | 24.67 | 25.23 | 33.96 | 70.02 | 7.51 | 10.37 |
| ARM 1B | 138.41B | 8.06e20 | 29.25 | 27.48 | 33.45 | 70.29 | 8.34 | 9.76 |
| ARM 7B | 17.30B | 6.02e20 | 26.92 | 25.18 | 21.02 | 57.18 | 1.29 | 1.22 |
| ARM 7B | 34.60B | 1.20e21 | 25.83 | 25.38 | 24.07 | 62.84 | 1.59 | 2.44 |
| ARM 7B | 86.50B | 3.01e21 | 24.41 | 24.90 | 25.42 | 71.11 | 2.88 | 7.93 |
| ARM 7B | 173.02B | 6.02e21 | 26.20 | 24.78 | 26.10 | 74.27 | 6.67 | 9.15 |
| ARM 7B | 207.62B | 7.23e21 | 30.36 | 28.86 | 31.86 | 74.48 | 8.57 | 12.80 |
| ARM 7B | 224.92B | 7.83e21 | 29.49 | 32.26 | 31.19 | 74.37 | 8.95 | 8.54 |
| ARM 7B | 242.22B | 8.43e21 | 33.62 | 31.38 | 34.92 | 75.41 | 10.84 | 9.15 |
| ARM 7B | 259.52B | 9.03e21 | 34.11 | 34.20 | 32.88 | 75.19 | 9.33 | 10.98 |
| ARM 7B | 311.43B | 1.08e22 | 35.66 | 35.49 | 36.61 | 75.14 | 11.30 | 10.37 |
| ARM 7B | 363.33B | 1.26e22 | 34.54 | 37.67 | 34.58 | 76.55 | 12.28 | 14.02 |
| ARM 7B | 415.24B | 1.45e22 | 35.37 | 38.37 | 35.25 | 76.39 | 14.40 | 12.80 |
| ARM 7B | 449.84B | 1.57e22 | 39.51 | 39.24 | 34.92 | 76.82 | 14.94 | 14.63 |
| ARM 7B | 519.09B | 1.81e22 | 40.30 | 40.69 | 37.29 | 77.15 | 14.03 | 14.63 |
| ARM 7B | 778.57B | 2.71e22 | 43.33 | 43.50 | 38.31 | 77.53 | 17.59 | 14.63 |
| ARM 7B | 1038.09B | 3.61e22 | 45.06 | 46.12 | 41.69 | 77.86 | 20.02 | 15.85 |
| ARM 7B | 1384.12B | 4.82e22 | 47.63 | 48.18 | 47.80 | 76.93 | 22.82 | 15.24 |
| ARM 7B | 2076.18B | 7.23e22 | 47.68 | 50.85 | 44.07 | 77.37 | 24.79 | 14.63 |
| ARM 7B | 2214.59B | 7.71e22 | 49.26 | 52.08 | 53.56 | 77.69 | 27.37 | 17.07 |