
把同一个 prompt 反复采样上万次,覆盖率还在涨,再用验证器筛出正确答案。2024 年论文,全文免费在线阅读。
Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
大型语言猴子:通过重复采样扩展推理计算
Bradley Brown\†‡,Jordan Juravsky\†,Ryan Ehrlich\*†,Ronald Clark‡,Quoc V. Le§,Christopher Ré†,以及 Azalia Mirhoseini†§
†斯坦福大学计算机科学系 ‡牛津大学 §Google DeepMind
bradley.brown@cs.ox.ac.uk, jbj@stanford.edu, ryanehrlich@cs.stanford.edu, ronald.clark@cs.ox.ac.uk, qvl@google.com, chrismre@stanford.edu, azalia@stanford.edu
摘要
扩大用于训练语言模型的计算量已显著提升了它们的能力。然而,在推理方面,我们往往将模型限制为对一个问题只做一次尝试。在这里,我们将推理计算作为另一个扩展维度进行探索,使用一种简单的技术:从模型中反复采样候选解。在多个任务和模型上,我们观察到覆盖率——即任何生成的样本所解决的问题比例——在四个数量级的范围内随样本数量而扩展。有趣的是,覆盖率与样本数量之间的关系通常是近似对数线性的,并且可以用指数幂律来建模,这表明存在推理时间扩展定律。在编码和形式化证明等答案可以被自动验证的领域,覆盖率的这些提升直接转化为性能的改善。当我们将重复采样应用于 SWE-bench Lite 时,使用 DeepSeek-Coder-V2-Instruct 解决的问题比例从单样本的 15.9% 提升到 250 个样本的 56%,超过了单样本 43% 的最先进水平。在没有自动验证器的领域,我们发现从样本集合中进行选择的常用方法(多数投票和奖励模型)在数百个样本之后便趋于饱和,无法随样本预算充分扩展。
1 引言
大型语言模型(LLM)在解决编码、数学和其他推理任务方面的能力在过去几年中已大幅提升 [47, 11, 2, 4]。通过更大的模型、更长的预训练运行和更大的数据集来扩大训练计算量,一直是这些收益的稳定驱动因素 [27, 37, 28]。
相比之下,在扩大推理期间所使用的计算量方面的投入相对有限。更大的模型确实比更小的模型需要更多的推理计算,而像思维链 [61] 这样的提示技术可以在输出更长(因而计算成本更高)的代价下提高答案质量。然而,在与 LLM 交互时,用户和开发者往往将模型限制为在解决问题时只做一次尝试。
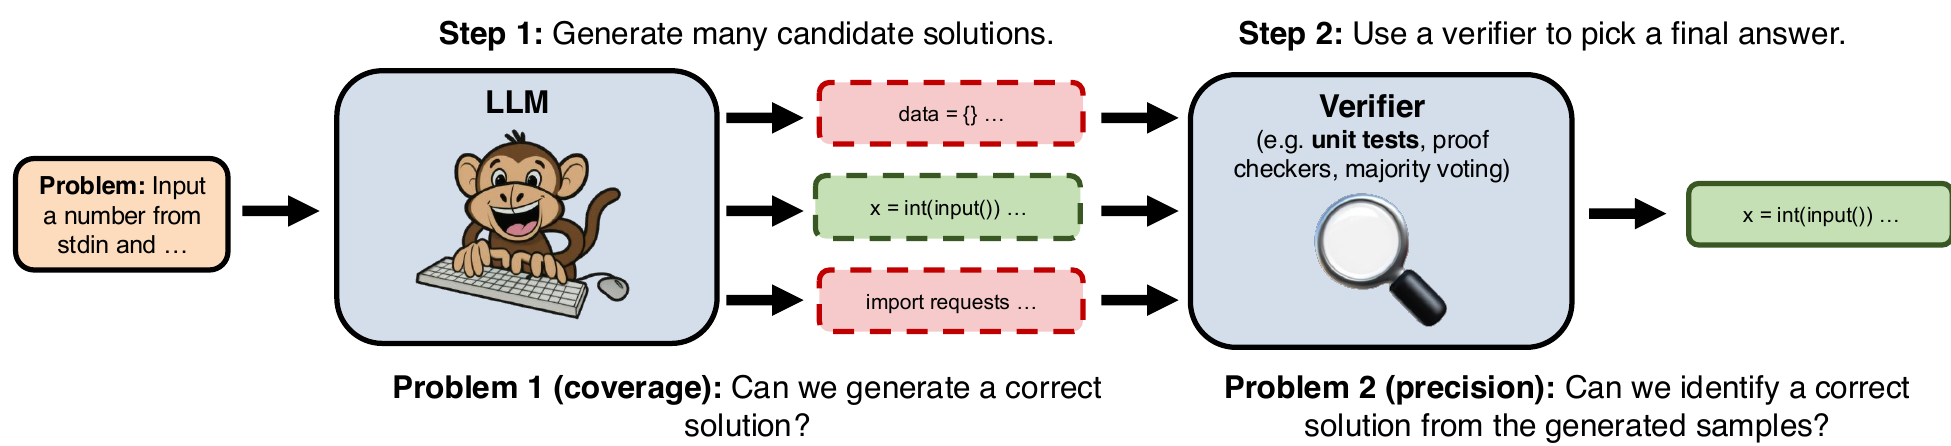
在本工作中,我们探索将重复采样(图 1)作为一种扩大推理计算以提升推理性能的简单方法。现有工作提供了令人鼓舞的示例,表明重复采样在数学、编码和谜题求解场景中可能是有益的 [60, 48, 23]。值得注意的是,AlphaCode [41],一个用于竞赛编程的最先进系统,发现性能在每道题一百万个样本的情况下仍持续提升。我们的目标是在一系列任务、模型和样本预算中系统地刻画这些收益。
重复采样的有效性由两个关键属性决定:
1. 覆盖率:随着样本数量的增加,我们能够使用任何已生成的样本解决多大比例的问题?
2. 精确性:我们能够从生成的样本集合中识别出正确样本的频率有多高?
这两个属性对于实现强大的真实世界性能都是必要的。在无限样本的情况下,任何为每个序列分配非零概率的模型都将实现完美的覆盖率。然而,重复采样只有在我们能够以可行的预算改善覆盖率时才是实用的。同样,生成大量样本集合只有在该集合中的正确样本能够被识别出来时才有用。精确性问题的难度因任务而异。在某些场景中,诸如证明检查器和单元测试之类的现有工具可以自动验证每个样本。在其他情况下,例如求解应用题时,则需要其他验证方法。
首先探索覆盖率,我们发现每道题最多采样 10,000 次可以显著提升数学和编码任务上的覆盖率(第 2 节)。在使用 Gemma-2B [52] 解决 CodeContests [41] 编程问题时,我们将覆盖率提升了超过 300 倍,从单样本的 0.02% 提升到 10,000 个样本的 7.1%。有趣的是,log(覆盖率) 与样本数量之间的关系通常遵循近似幂律(第 3 节)。在使用 Llama-3 [3] 和 Gemma 模型时,这导致覆盖率在数个数量级的范围内随样本数量近乎对数线性地增长。
在具有自动验证工具的场景中,覆盖率的提升直接转化为任务性能的改善。当将重复采样应用于竞赛编程和编写 Lean 证明时,像 Llama-3-8B-Instruct 这样的模型可以超过像 GPT-4o [2] 这样强大得多的模型的单样本性能。这种放大较弱模型的能力延伸到具有挑战性的 SWE-bench Lite 真实 GitHub 问题数据集 [32],其中当前单样本最先进水平(SOTA)由 GPT-4o 和 Claude 3.5 Sonnet 的混合系统取得,为 43% [1]。当限制为单样本时,DeepSeek-Coder-V2-Instruct [20] 仅解决 15.9% 的问题。通过简单地将样本数量增加到 250,我们将已解决问题的比例提升到 56%,超过最先进水平 13%。
除了提升模型质量之外,重复采样还提供了一种最小化 LLM 推理成本的新机制(第 2.3 节)。当保持推理 FLOPs 总数不变时,我们发现在某些数据集(例如 MATH)上,使用较小的模型和更多的样本可以使覆盖率最大化,而在其他数据集(例如 CodeContests)上,从较大的模型中采样较少的次数则更好。我们还在解决 SWE-bench Lite 问题的背景下比较了 DeepSeek-Coder-V2-Instruct、GPT-4o 和 Claude Sonnet 3.5 之间的 API 价格。当保持智能体框架(Moatless Tools [67])不变时,从较弱且更便宜的 DeepSeek 模型采样五次所解决的问题比来自 Claude 或 GPT 的单样本更多,同时还便宜 3 倍以上。
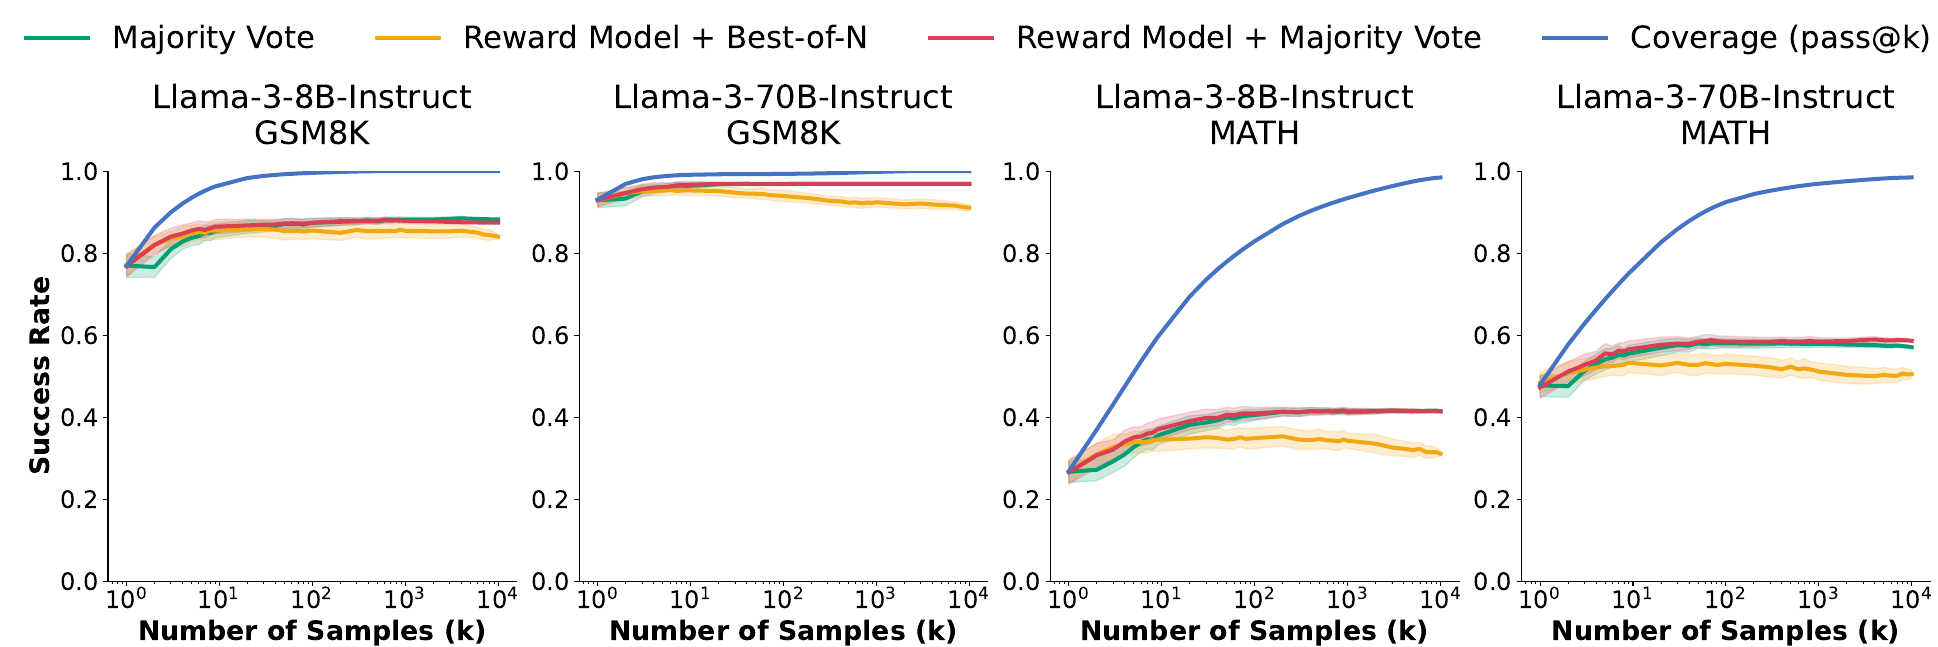
最后,我们证明可扩展的验证对于充分受益于重复采样是必要的。随着样本数量的增加,覆盖率通过模型为其先前未解决的问题生成正确解而得到改善。然而,这些日益稀少的正确生成只有在验证器能够“大海捞针”并从主要由错误样本组成的集合中识别出它们时才有益。在数学应用题场景中,我们发现两种常用的验证方法(多数投票和奖励模型)不具备这种能力。在使用 Llama-3-8B-Instruct 解决 MATH [26] 问题时,覆盖率从 100 个样本的 82.9% 提升到 10,000 个样本的 98.44%。然而,当使用多数投票或奖励模型来选择最终答案时,在相同的样本范围内,最大的性能提升仅从 40.50% 到 41.41%。随着样本数量的增加,覆盖率(即使用完美验证器时的性能)与这些方法的性能之间的差距也随之增大(图 [7])。
总之,我们的主要观察如下:
1. 我们证明,通过重复采样扩大推理计算可以在各种任务和模型上带来覆盖率的巨大提升。这使得用许多样本放大较弱模型并超过更强大模型的单样本成为可能,有时还具有成本效益。
2. 我们表明,覆盖率与样本数量之间的关系通常可以用指数幂律来建模,这表明存在一种推理时间计算扩展定律。
3. 在没有自动验证器的领域,我们表明常见的验证方法在约 100 个样本之后便趋于饱和。这导致使用这些方法所达到的性能与覆盖率上界之间的差距不断扩大。
2 扩展重复采样
我们专注于通过-失败任务,其中候选解可以被评分为正确或错误。这些任务的主要关注指标是成功率:我们能够解决的问题比例。在重复采样中,我们考虑一种设置,即模型在尝试解决一个问题时可以生成许多候选解。因此,成功率既受到为许多问题生成正确样本的能力(即覆盖率)的影响,也受到识别这些正确样本的能力(即精确性)的影响。
精确性问题的难度取决于样本验证工具的可用性。在 Lean 中证明形式化陈述时,证明检查器可以快速识别候选解是否正确。同样,单元测试可用于验证编码任务的候选解。在这些情况下,精确性被自动处理,改善覆盖率直接转化为更高的成功率。相比之下,可用于验证 GSM8K 和 MATH 中数学应用题解的工具是有限的,因此需要额外的验证方法,从许多(通常相互冲突的)样本中决定一个最终答案。
我们考虑以下五个任务:
1. GSM8K:一个小学水平数学应用题数据集 [18]。我们在 GSM8K 测试集的 128 个随机问题上进行评估。
2. MATH:另一个数学应用题数据集,通常比 GSM8K 中的问题更难 [13]。同样,我们在该数据集测试集的 128 个随机问题上进行评估。
3. MiniF2F-MATH:一个已被形式化为证明检查语言的数学问题数据集 [65]。我们使用 Lean4 作为我们的语言,并在从 MATH 数据集形式化而来的 130 个测试集问题上进行评估。
4. CodeContests:一个竞赛编程问题数据集 [41]。每个问题都有文本描述,以及一组输入-输出测试用例(对模型隐藏),可用于验证候选解的正确性。我们强制模型使用 Python3 编写其解决方案。
5. SWE-bench Lite:一个真实世界 GitHub 问题数据集,其中每个问题由一个描述和一个代码仓库快照组成 [32]。要解决一个问题,模型必须编辑代码库中的文件(在我们使用的 SWE-bench 的 Lite 子集中,只需要更改单个文件)。候选解决方案可以使用仓库的单元测试套件自动检查。
在这些任务中,MiniF2F-MATH、CodeContests 和 SWE-bench Lite 具有自动验证器(分别以 Lean4 证明检查器、测试用例和单元测试套件的形式)。我们首先研究重复采样如何提高模型覆盖率。覆盖率的提高直接对应于具有自动验证器的任务的成功率提升,并且在一般情况下提供了成功率的上界。在编码环境中,我们对覆盖率的定义等价于常用的 pass@k 指标 [15],其中 表示每个问题的样本数。在评估 CodeContests 和 SWE-bench Lite 时,我们直接使用该指标。对于 MiniF2F,该指标类似,其中“通过”根据 Lean4 证明检查器来定义。对于 GSM8K 和 MATH,覆盖率对应于使用一个预言验证器,该验证器检查是否有任何样本通过输出正确的最终答案而“通过”。为减少计算覆盖率时的方差,我们采用 Chen 等人 [15] 的无偏估计公式。在每个实验中,我们首先为每个问题索引 生成 个样本,并计算正确样本数 。然后,我们根据以下公式计算每个感兴趣的 处的 pass@k 分数:
我们使用 Chen 等人 [15] 所建议的上述公式的数值稳定实现。数据和代码可在 https://scalingintelligence.stanford.edu/pubs/large_language_monkeys/ 获取。
2.1 重复采样在各类任务中均有效
在此,我们证明重复采样能够在多个任务和一系列样本预算范围内提升覆盖率。我们在 CodeContests、MiniF2F、GSM8K 和 MATH 上评估 Llama-3-8B-Instruct 和 Llama-3-70B-Instruct,为每个问题生成 10,000 个独立样本。对于 SWE-bench Lite,由于该任务所需的上下文长度超出了 Llama-3 模型的限制,我们使用 DeepSeek-Coder-V2-Instruct [20]。按照解决 SWE-bench 问题的标准做法,我们为 LLM 配备了一个软件框架,为模型提供浏览和编辑代码库的工具。在我们的工作中,我们使用开源的 Moatless Tools 库 [67]。请注意,解决 SWE-bench 问题涉及 LLM 与 Moatless Tools 之间的来回交互。该基准测试中的一个样本/尝试指的是完整的一整条多轮轨迹。为最小化成本,我们将每个问题的尝试次数限制为 250 次,所有尝试彼此独立进行。
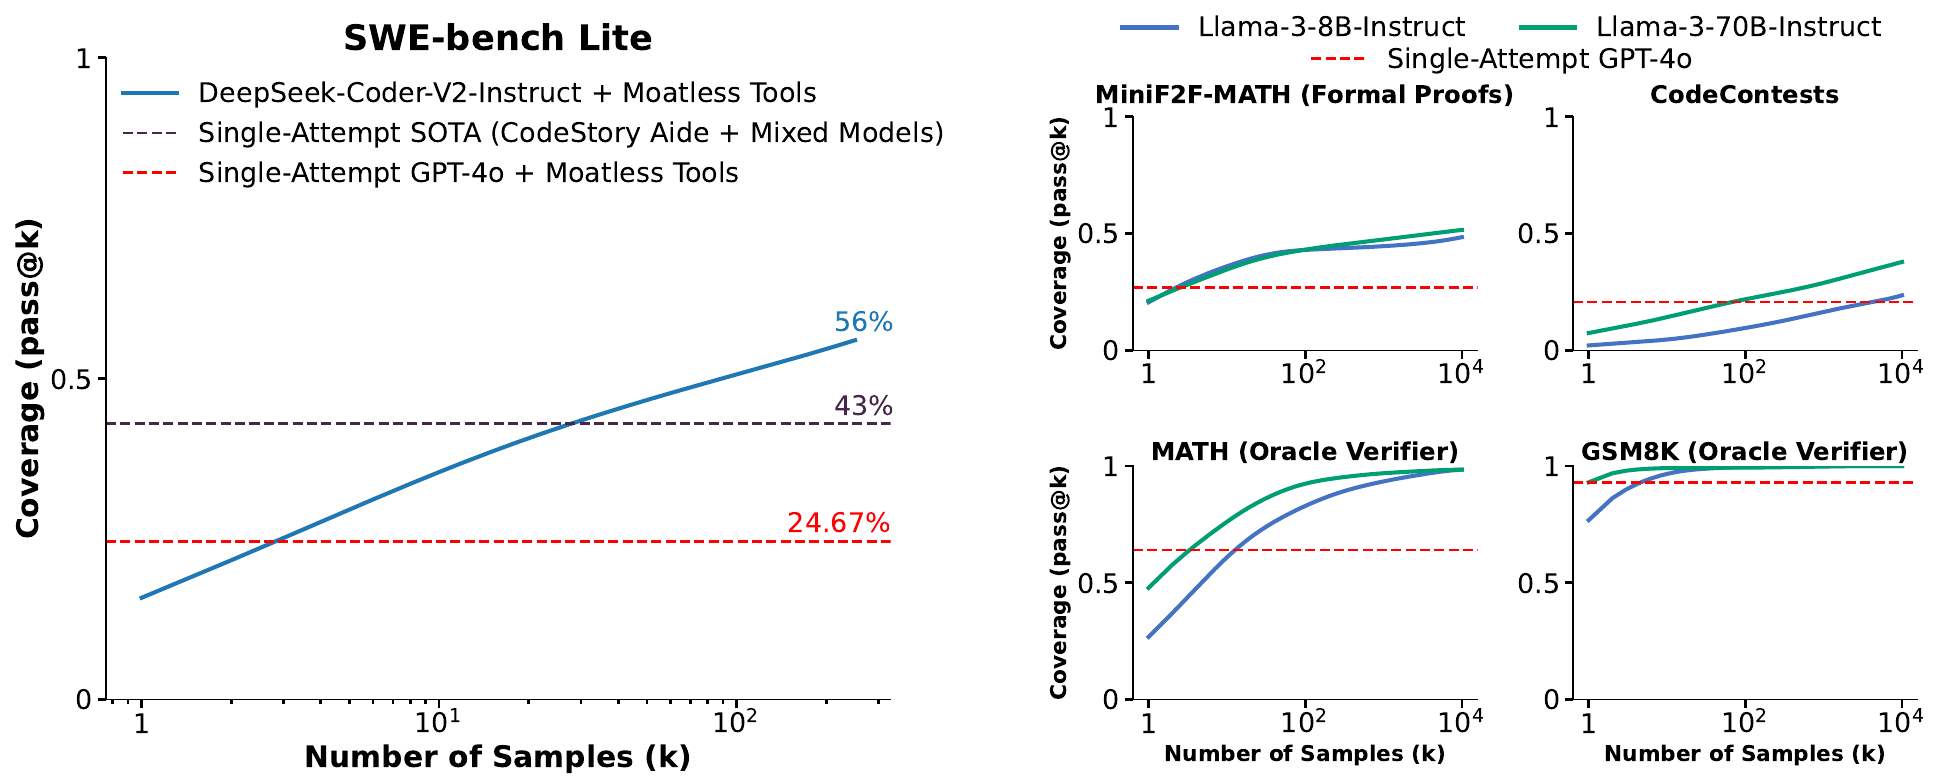
我们在图 2 中报告了结果。我们还列出了 GPT-4o 在每个任务上的单次尝试性能,以及 SWE-bench Lite 的单次尝试最先进水平(CodeStory Aide 1,其结合使用了 GPT-4o 和 Claude 3.5 Sonnet)。在所有五个任务上,我们发现覆盖率随着样本预算的增加而平稳提升。当所有 LLM 仅获得一次尝试机会时,GPT-4o 在每个任务上都优于 Llama 和 DeepSeek 模型。然而,随着样本数量的增加,三个较弱模型均超过了 GPT-4o 的单次尝试性能。在 SWE-bench Lite 上,我们解决了 的问题,超过了单次尝试的最先进水平 。
2.2 重复采样在不同模型规模和模型家族中均有效
第 2.1 节的结果表明重复采样能够提升覆盖率。然而,我们仅对三个近期、经过指令微调且参数量在 8B 或以上的模型展示了这一趋势。现在我们表明这些趋势在其他模型规模、家族和后训练水平上同样成立。我们将评估扩展到更广泛的模型集合:
- Llama 3:Llama-3-8B、Llama-3-8B-Instruct、Llama-3-70B-Instruct。
- Gemma:Gemma-2B、Gemma-7B [52]。
- Pythia:Pythia-70M 至 Pythia-12B(共八个模型)[9]。
为最小化推理成本,我们将评估限制在 MATH 和 CodeContests 数据集上,结果报告于图 3。在我们测试的几乎每个模型上覆盖率都有所提升,其中较小的模型在应用重复采样时覆盖率提升最为显著。在 CodeContests 上,Gemma-2B 的覆盖率提升了超过 倍,从 pass@1 的 提升至
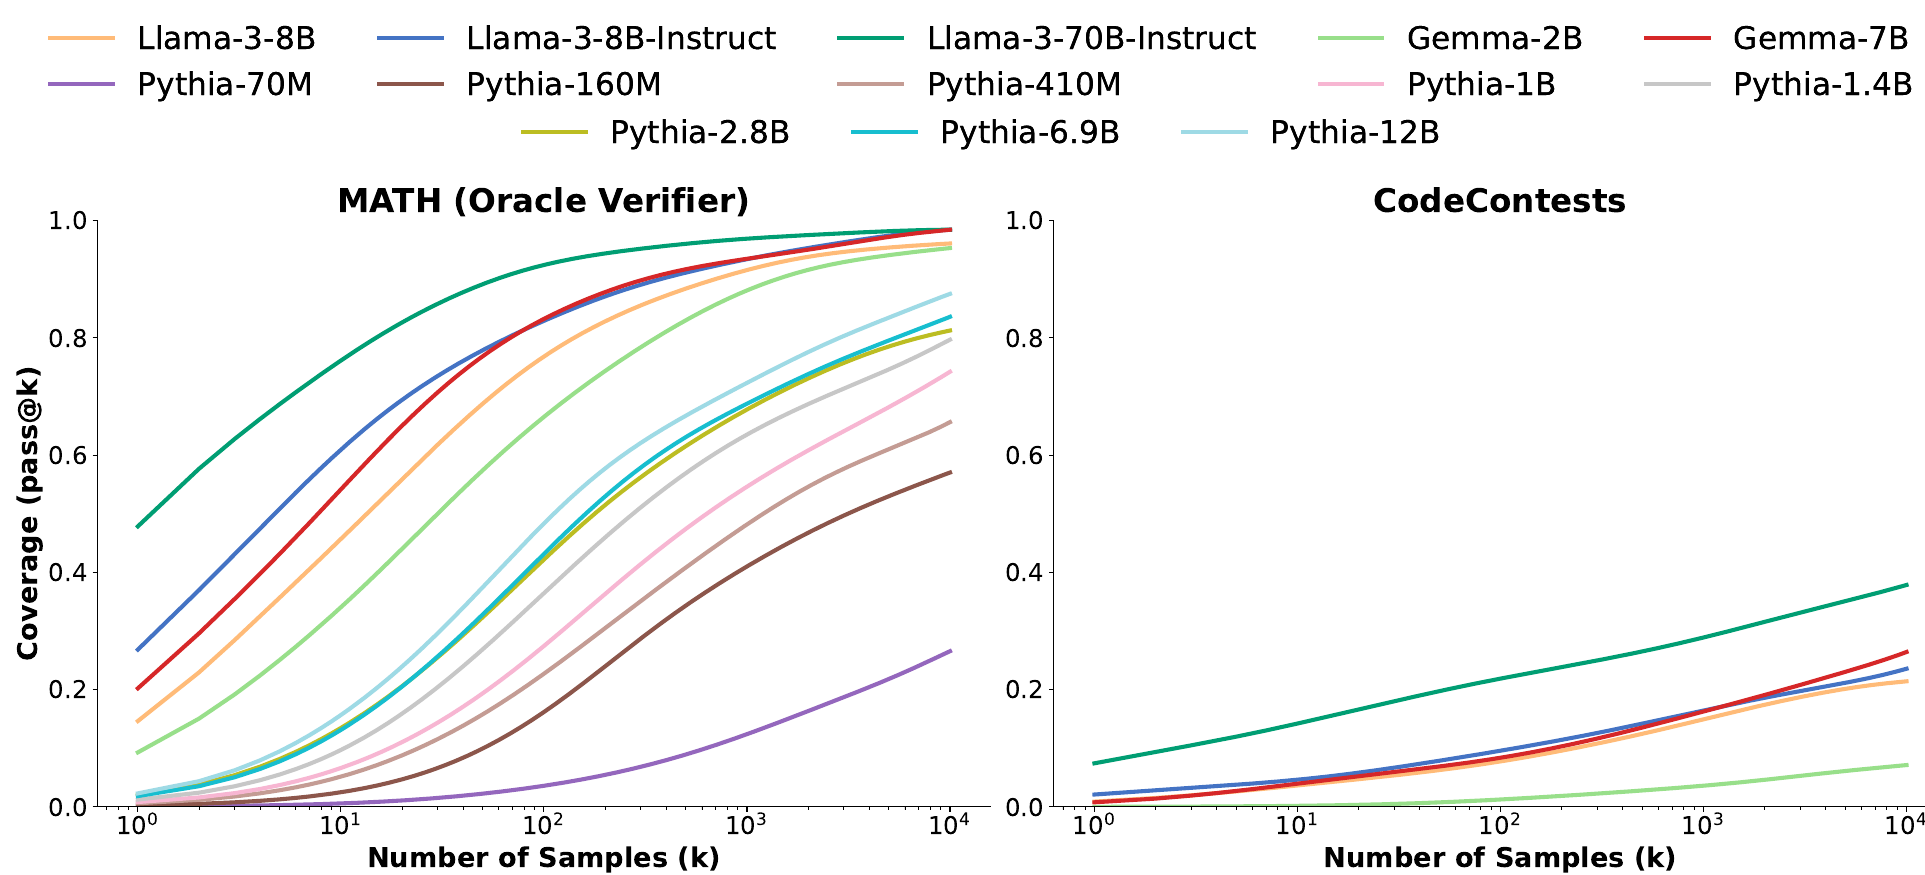
pass@10k 的 。同样,在使用 Pythia-160M 解决 MATH 问题时,覆盖率从 pass@1 的 提升至 pass@10k 的 。
这种跨模型覆盖率提升模式的一个例外是在 CodeContests 上评估的 Pythia 家族。所有 Pythia 模型在该数据集上即使使用 10,000 个样本的预算,覆盖率也为零。我们推测这是因为 Pythia 训练所用的编码特定数据少于 Llama 和 Gemma。
2.3 重复采样有助于平衡性能与成本
从第 2.1 节和第 2.2 节的结果中可以得到的一个要点是,重复采样使得放大较弱模型的能力并超越较强模型的单次样本成为可能。在此,我们证明这种放大可能比使用更强、更昂贵的模型更具成本效益,为实践者在尝试联合优化性能和成本时提供了新的自由度。
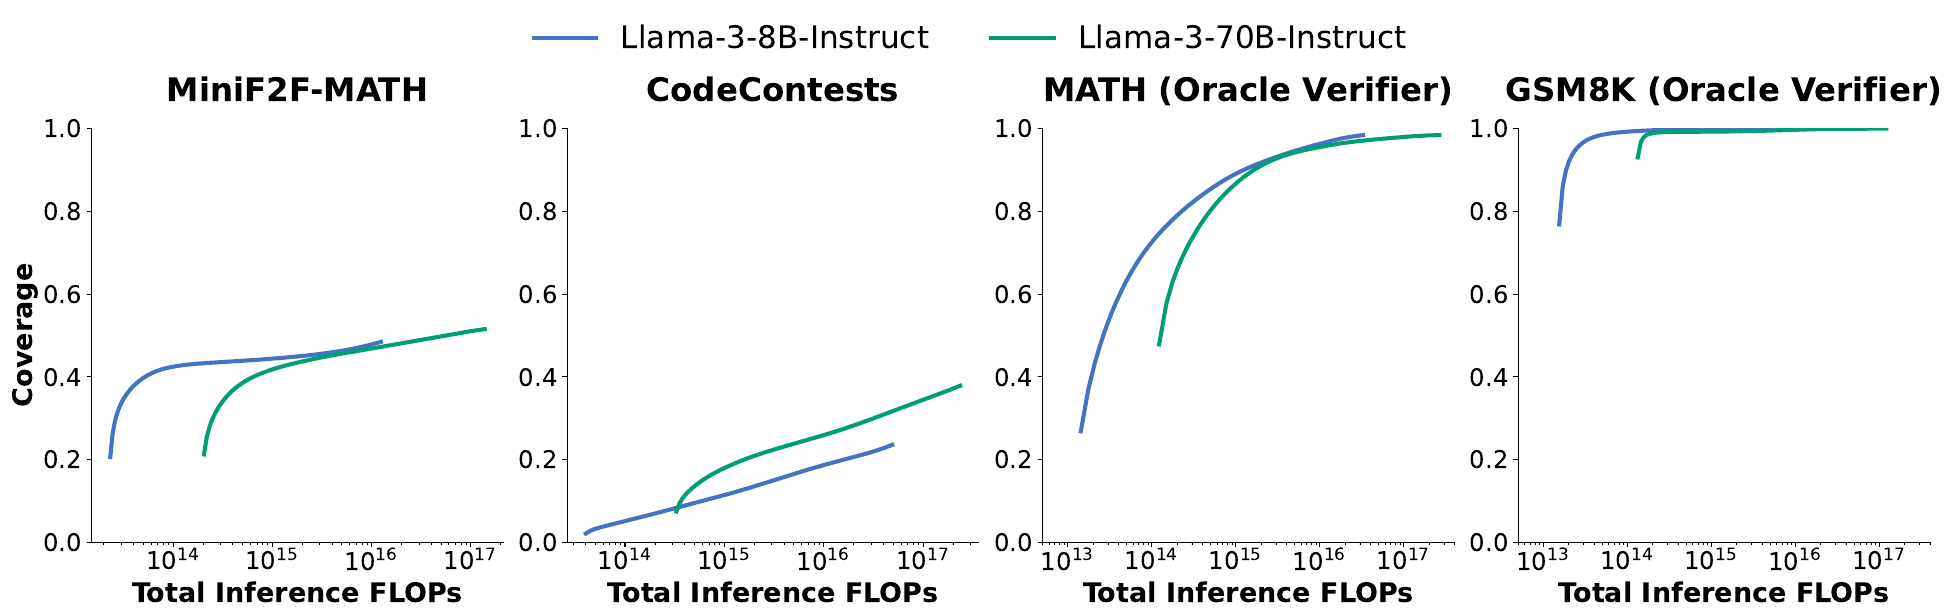
我们首先考虑将 FLOPs 作为成本度量,考察第 2.1 节中的 Llama-3 结果。我们重新绘制图 2 中的结果,现在将覆盖率可视化为总推理 FLOPs 而非样本预算的函数。由于 Llama-3 模型是稠密 Transformer,其中大部分参数用于矩阵乘法,我们使用以下公式近似推理 FLOPs:
我们在图 4 中展示了 MiniF2F、CodeContests、MATH 和 GSM8K 的重新缩放结果。有趣的是,最大化覆盖率的模型随计算预算和任务而变化。在 MiniF2F、GSM8K 和
| 模型 | 每次尝试成本(美元) | 尝试次数 | 解决的问题(%) | 总成本(美元) | 相对总成本 |
| DeepSeek-Coder-V2-Instruct | 0.0072 | 5 | 29.62 | 10.8 | 1x |
| GPT-4o | 0.13 | 1 | 24.00 | 39 | 3.6x |
| Claude 3.5 Sonnet | 0.17 | 1 | 26.70 | 51 | 4.7x |
表 1:使用 Moatless Tools 智能体框架在 SWE-bench Lite 数据集上比较各模型的 API 成本(美元)和性能。当采样更多次时,开源 DeepSeek-Coder-V2-Instruct 模型能够以不到三分之一的价格达到与闭源前沿模型相同的问题解决率。MATH 上,当 FLOP 预算固定时,Llama-3-8B-Instruct 总是比更大(也更昂贵)的 70B 模型获得更高的覆盖率。然而对于 CodeContests,70B 模型几乎总是更具成本效益。我们注意到,仅考察 FLOPs 可能是一种粗糙的成本度量,它忽略了系统效率的其他方面 [21]。特别是,重复采样可以利用高批量大小和专门的优化,相对于单次尝试推理工作负载提高系统吞吐量 [34] [6] [66]。我们在第 [5] 节中更详细地讨论了这一点。
我们还考察了在使用当前 API 定价解决 SWE-bench Lite 问题时重复采样的美元成本。保持智能体框架(Moatless Tools)不变,我们考虑使用 Claude 3.5 Sonnet 和 GPT-4o 对每个问题进行单次尝试,以及使用 DeepSeek-Coder-V2-Instruct 进行重复采样。我们在表 [1] 中报告了每种方法的平均每问题成本和问题解决率。虽然 DeepSeek 模型弱于 GPT 和 Claude 模型,但其价格也便宜 10 倍以上。在这种情况下,重复采样提供了一种比支付溢价以获取强大模型更便宜的替代方案,同时实现了更优的问题解决率。
3 刻画重复采样的收益
LLM 的损失与其训练计算量之间的关系已通过训练缩放定律得到了很好的刻画 [27] [36] [28]。这些定律在许多数量级上经验性地成立,并使模型开发者相信大规模训练投资将会得到回报。受训练缩放定律的启发,我们在此旨在更好地刻画覆盖率与样本预算(即推理计算量)之间的关系,提出两个有趣的观察:
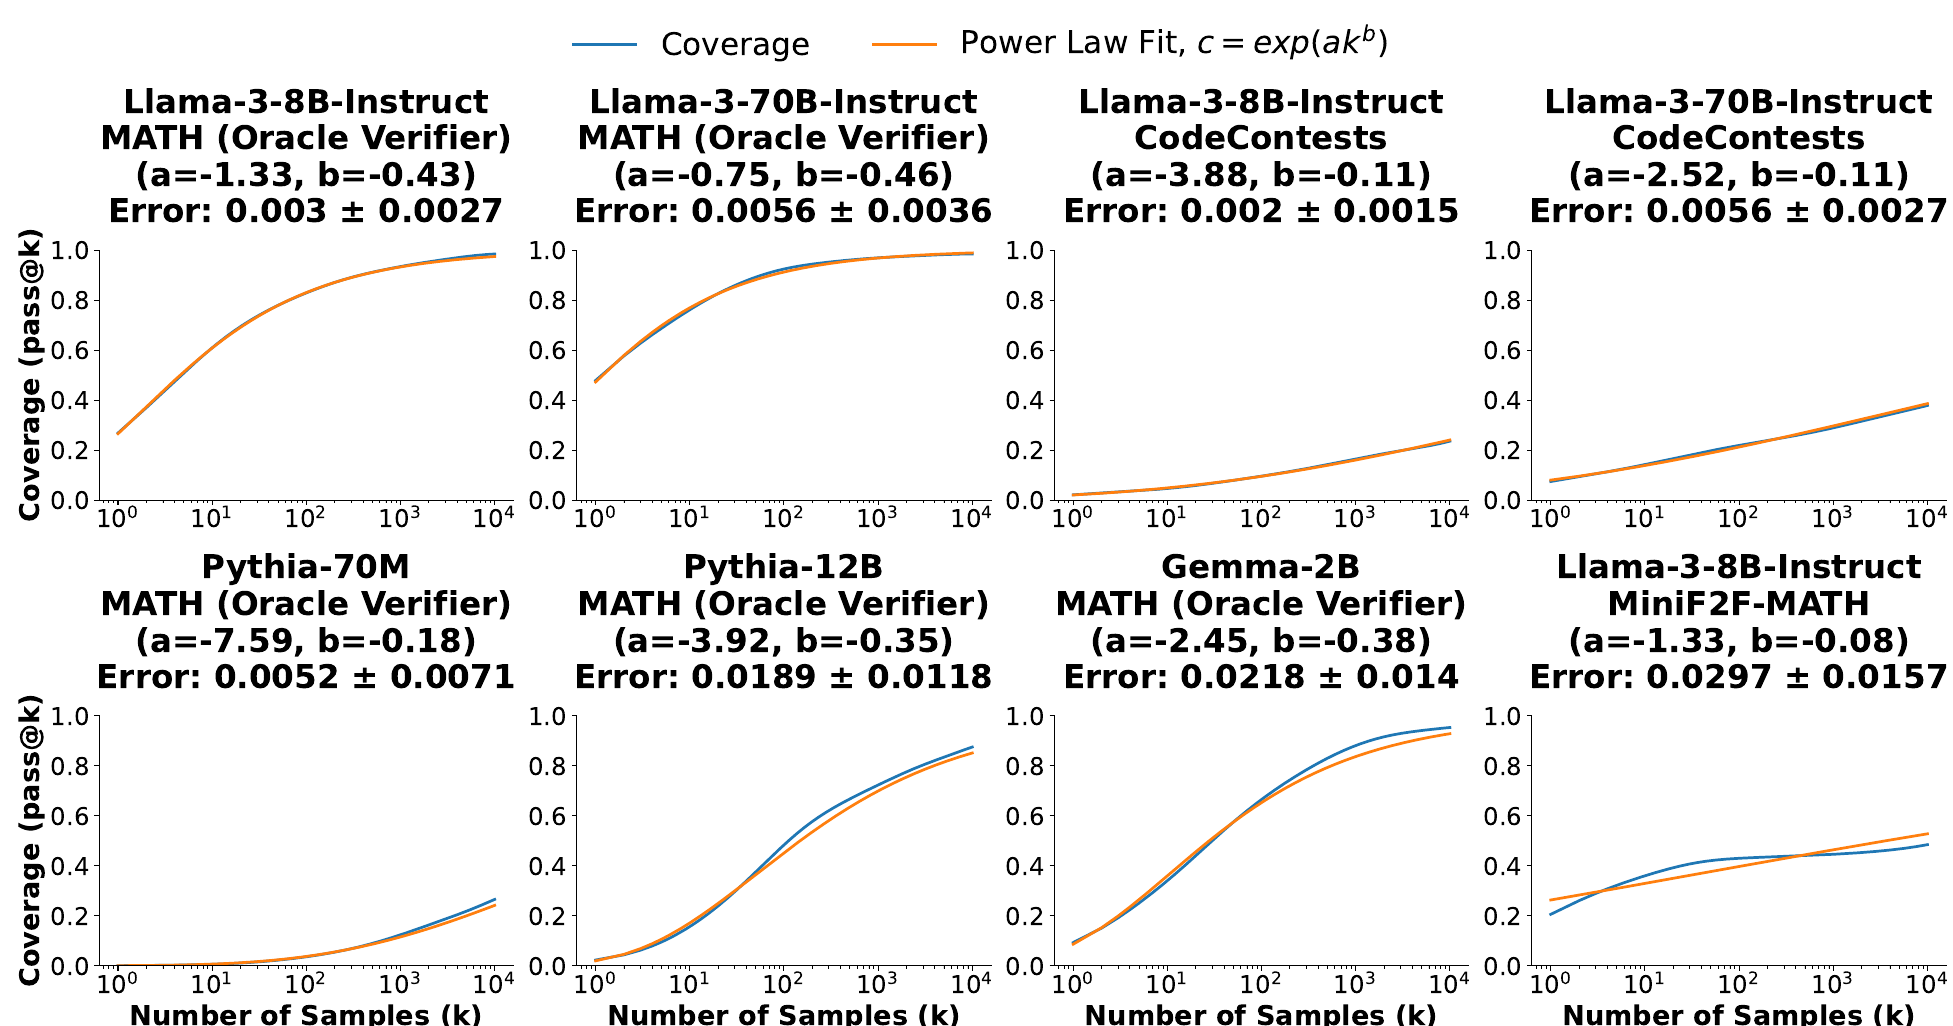
1. 覆盖率与样本数量之间的关系通常可以用指数幂律建模。
2. 对于给定任务,同一家族中不同模型的覆盖率曲线类似于 S 形曲线,具有相似的斜率但不同的水平偏移。
3.1 重复采样的缩放定律
在此,我们为覆盖率与样本数量之间的关系建立一个显式模型。GPT-4 技术报告 [46] 发现,模型在编码问题上的平均对数通过率与其训练计算量之间的关系可以用幂律很好地建模。我们首先采用相同的函数类别,但现在将覆盖率 的对数建模为样本数量 的函数:
其中 为拟合的模型参数。为了直接预测覆盖率,我们对两边取指数,最终得到如下模型:
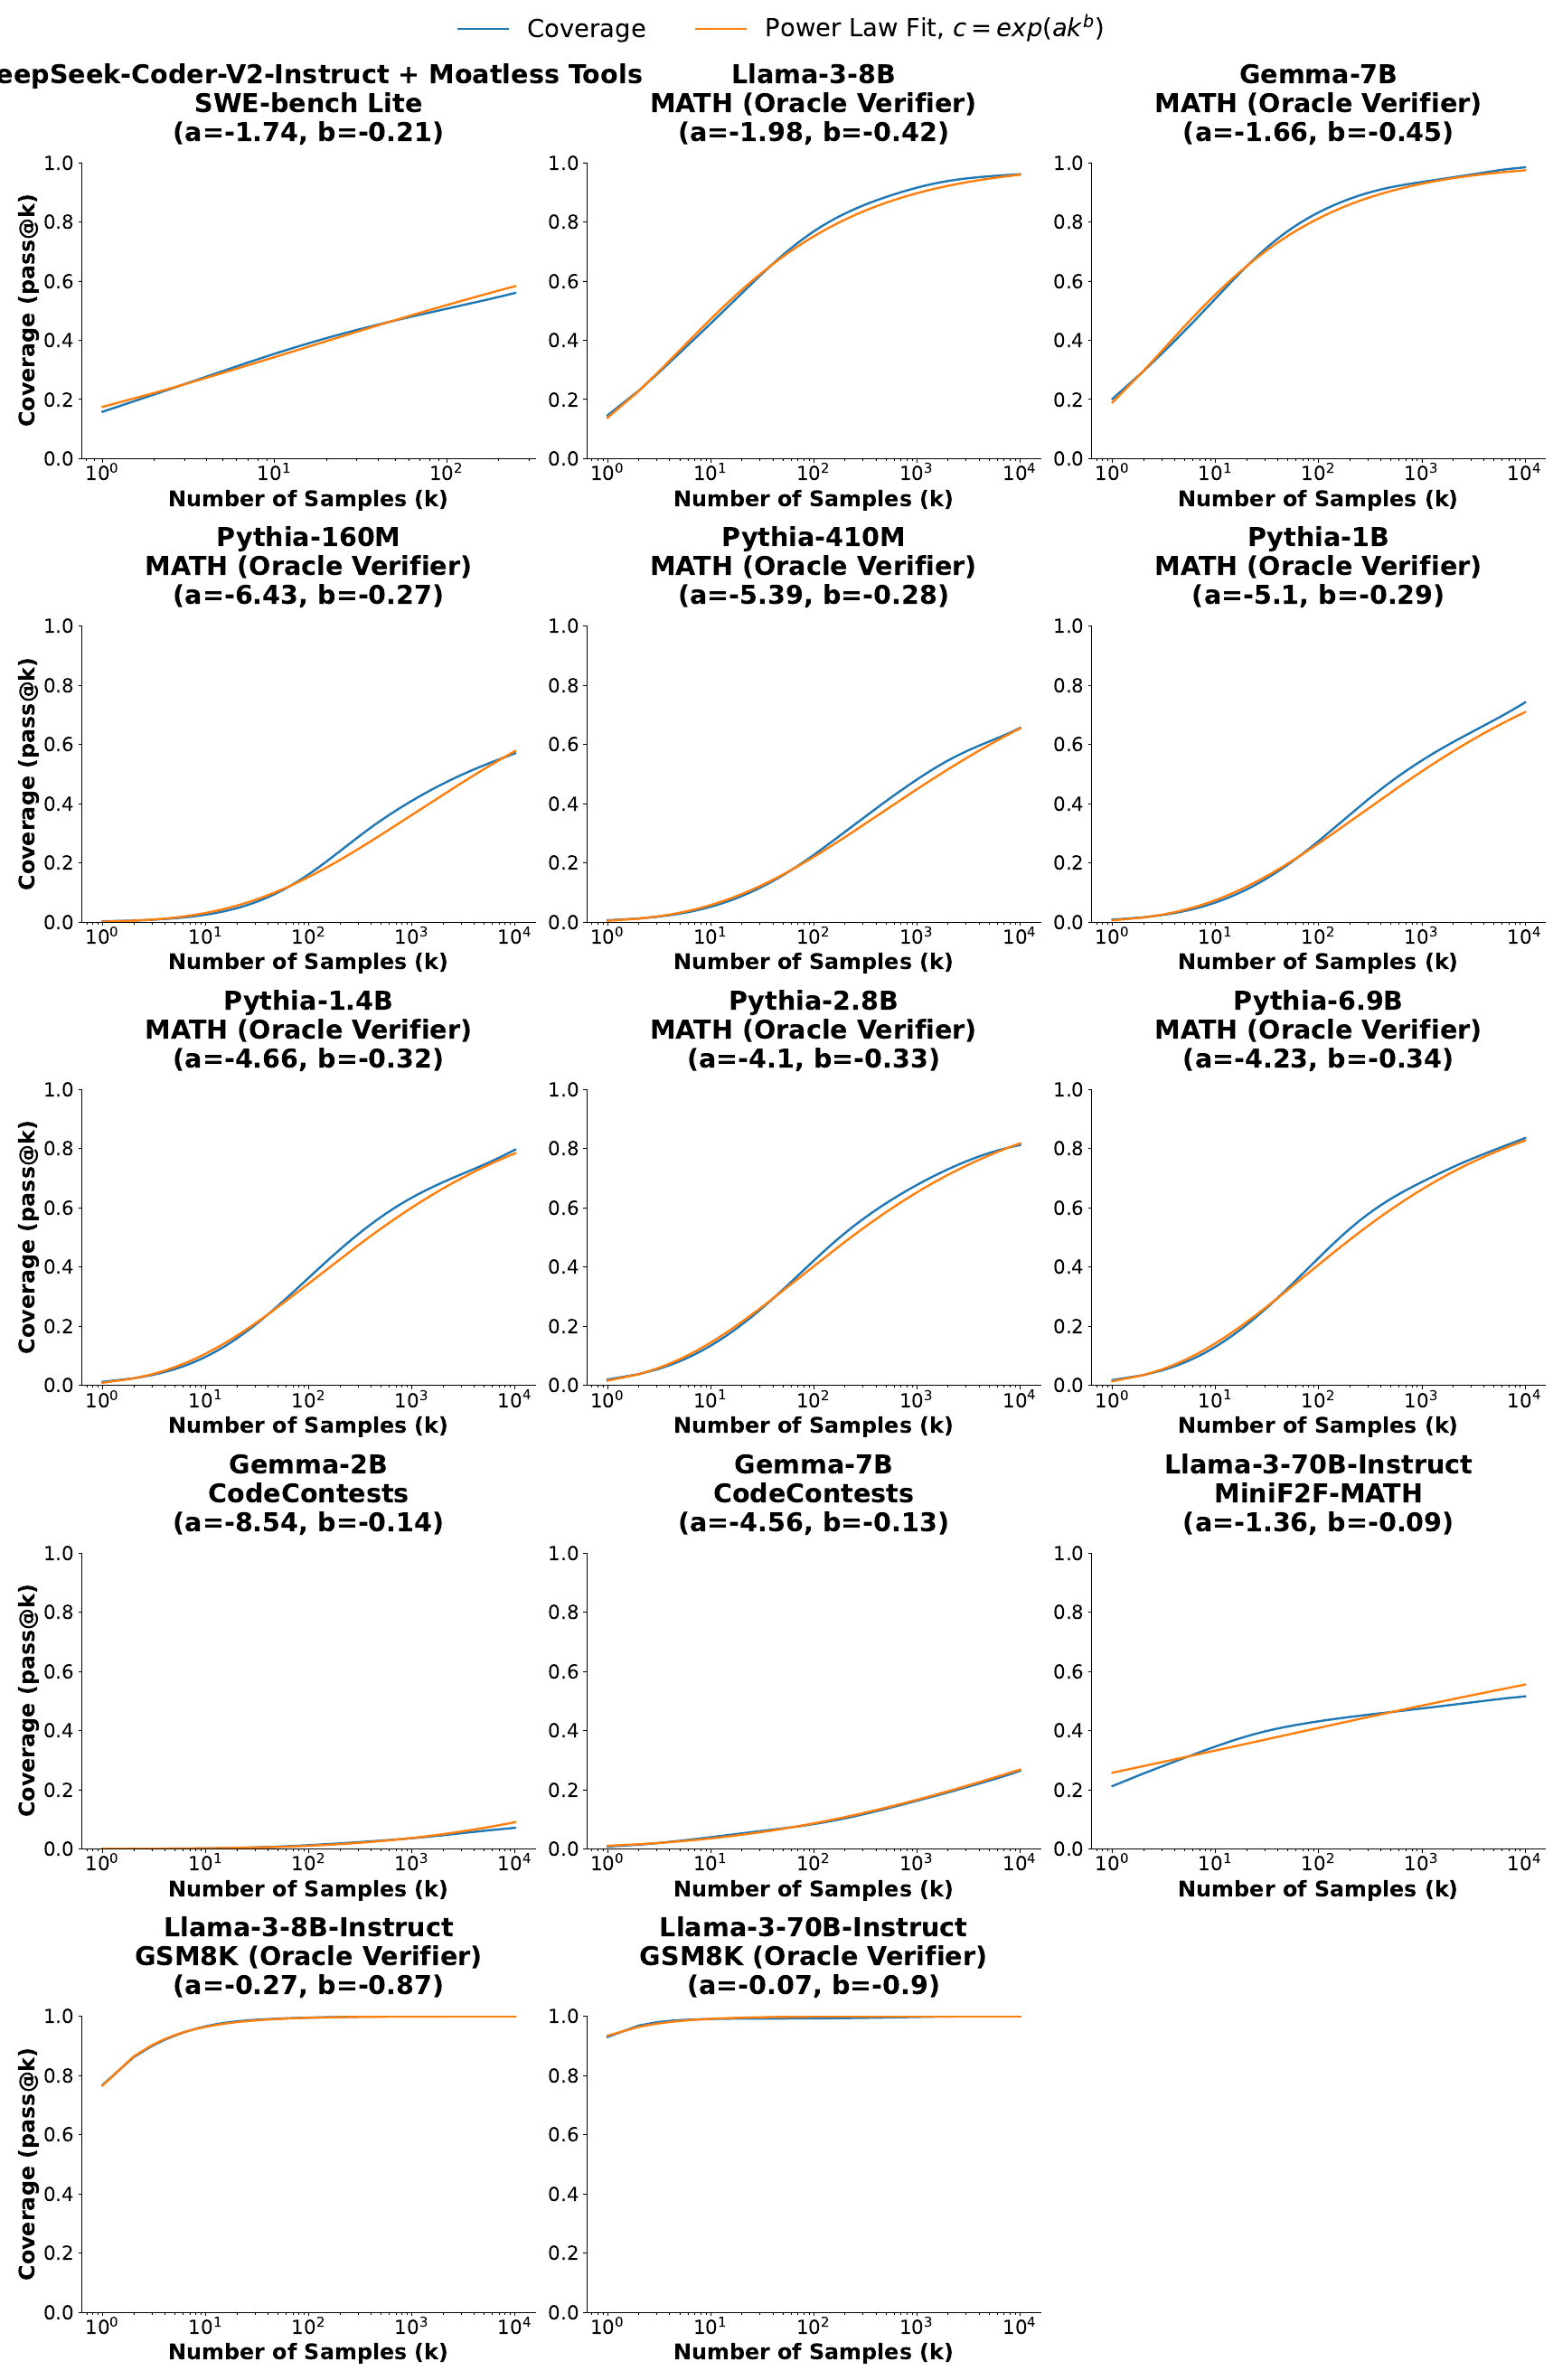
我们在图[5]中提供了拟合覆盖率曲线的示例,并在附录[C.2]中提供了更多曲线。虽然这些规律不如训练缩放定律那样精确(最显著的是在MiniF2F-MATH上),但它们提供了令人鼓舞的早期证据,表明推理缩放的收益可以被刻画。
3.2 不同模型间覆盖率曲线的相似性
有趣的是,当比较同一系列不同模型在同一任务上的覆盖率曲线(x轴为对数刻度)时(见图[3]),所描绘的S形曲线似乎具有相同的斜率,但水平偏移各不相同。为了进一步研究这一点,我们在图[6]中叠加了同一系列不同模型的覆盖率曲线。我们的做法是选取一个锚定覆盖率值,并将每条曲线向左平移(在对数空间中),使每条曲线都经过点。这对应于向左平移
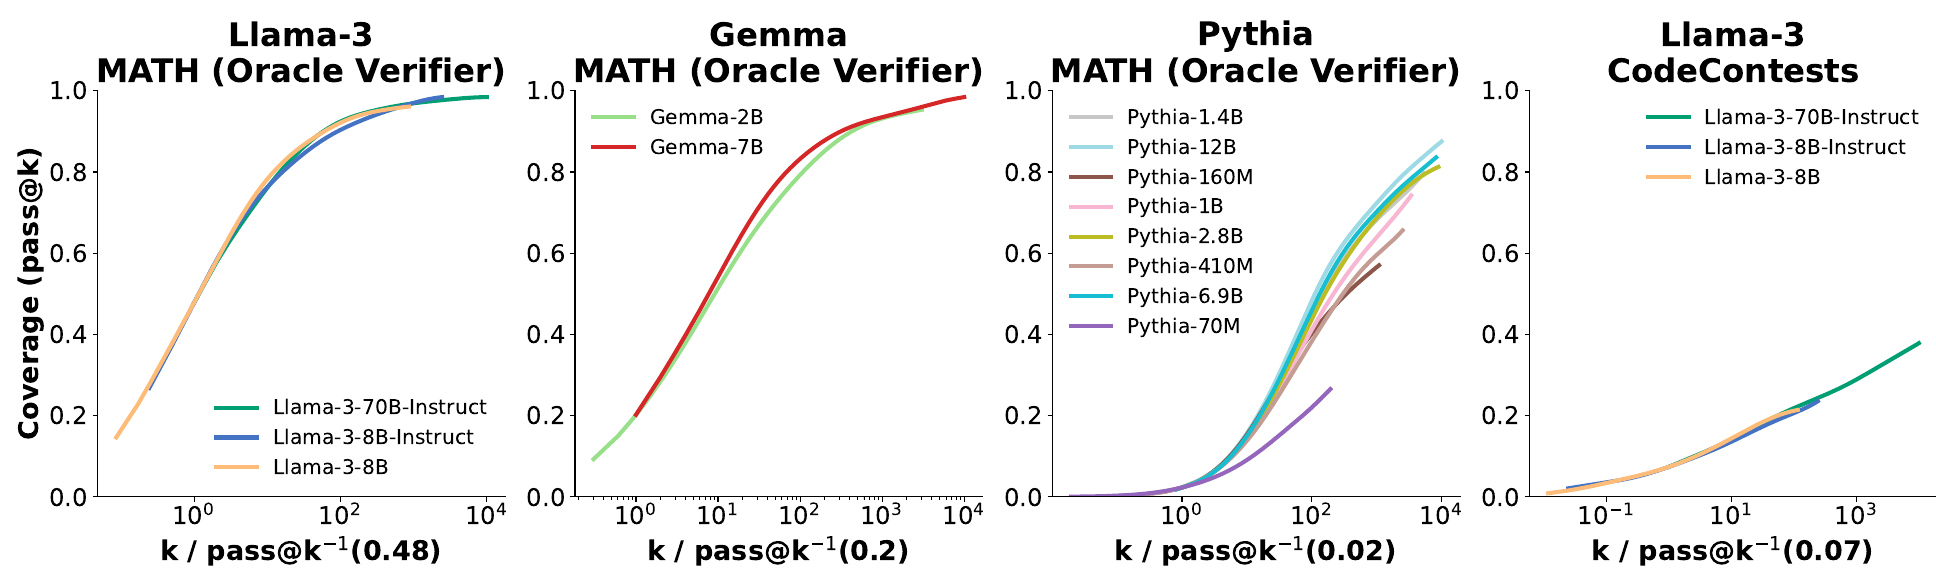
,其中表示使得的最接近的自然数。我们选取为同一系列所有模型中最大的pass@1分数。这些相似性表明,在同一系列的不同模型之间,将覆盖率从提升到所需的对数样本预算增量(或等价地,样本预算的乘性增量)近似为常数。
4 利用重复采样需要精确性
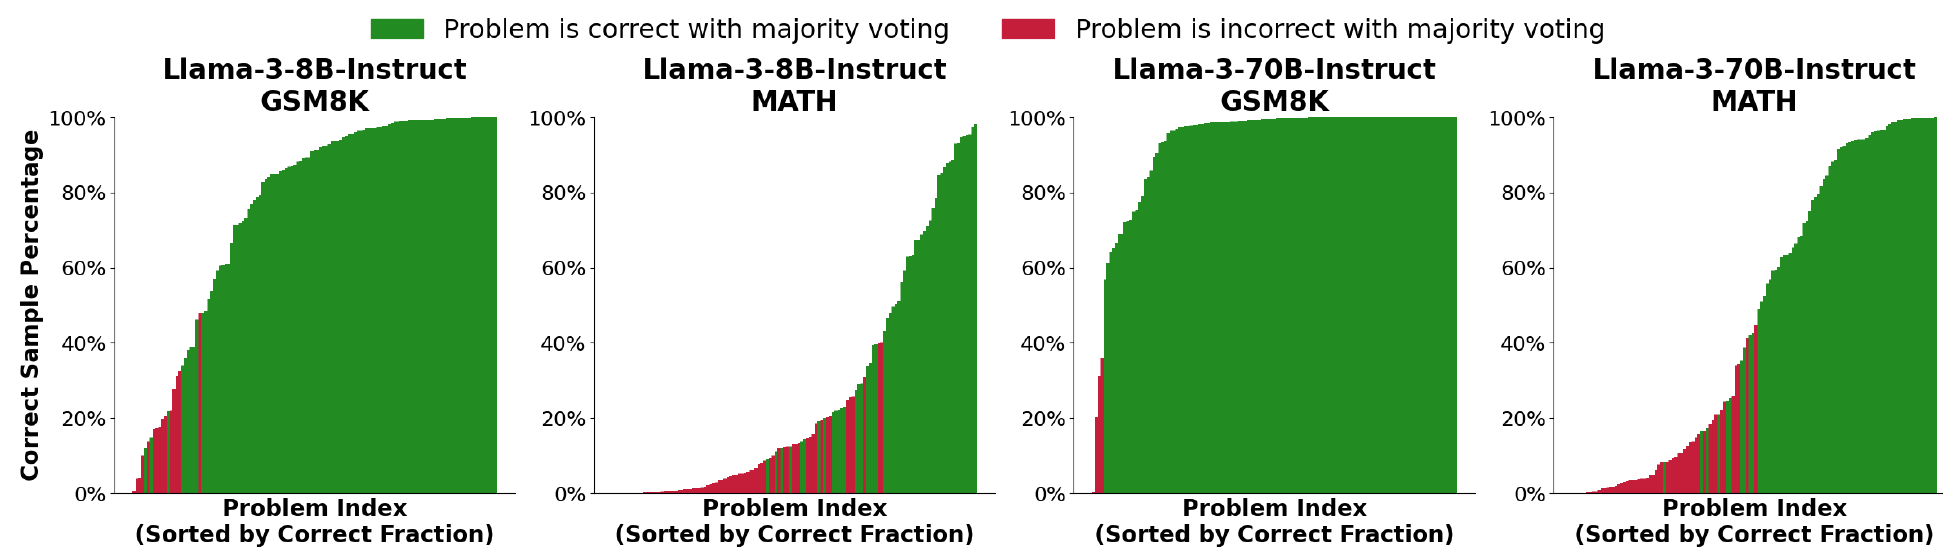
到目前为止,我们一直专注于测量模型覆盖率,刻画在始终能够识别正确模型样本的场景下重复采样的收益。现在我们转向精确性这一互补问题:给定一组模型样本,我们能够多频繁地识别出正确的样本?特别地,我们关注验证器在样本数量增加时的表现。对于某些问题,正确解是从模型中以较低概率采样得到的(例如或更低,见图8)。随着样本数量增加,更多问题能够生成稀有的正确解,模型覆盖率随之提高。为了将这些覆盖率提升转化为更高的成功率,验证器必须能够“大海捞针”,识别出不常见的正确样本。
4.1 常见验证方法并不总能随样本预算扩展
在我们评估的五个任务中,只有GSM8K和MATH缺乏自动验证解的工具。我们测试了三种简单且常用的验证方法在这些数据集上识别正确解的能力:
1. 多数投票:我们选择最常见的最终答案[60]。
2. 奖励模型+Best-of-N:我们使用奖励模型[17]为每个解打分,并从得分最高的样本中选取答案。
3. 奖励模型+多数投票:我们计算加权多数投票,其中每个样本按其奖励模型得分加权。
我们复用了第2节中使用Llama-3-8B-Instruct和Llama-3-70B-Instruct生成的10,000个样本集合。我们使用ArmoRM-Llama3-8B-v0.1 [57]作为奖励模型,该模型在RewardBench排行榜[39]的推理部分得分很高。我们在图7中报告了随着样本数量增加的结果。虽然三种方法的成功率最初都随样本数量增加而提高,但它们在约100个样本附近趋于平稳。与此同时,覆盖率继续随样本数量增加,最终超过95%。对于多数投票而言,这种成功率饱和是直观的,因为稀有正确解的出现不会影响多数投票所选择的最常见答案。
鉴于这些验证器(特别是奖励模型)表现不佳,人们自然会想:验证一个候选解到底有多“难”?对于GSM8K和MATH,只有样本的最终答案被用于评估正确性,中间的思维链被丢弃。如果模型在猜出正确最终答案之前只生成了无意义的思维链,那么验证可能并不比从头解决问题更容易。我们通过人工评估105条来自Llama-3-8B-Instruct对GSM8K问题正确样本的思维链来研究这一问题,结果报告在表2中。我们发现,在我们评分的思维链中,超过是忠实的,即使在正确答答案生成频率很低的问题中也是如此。这些正确的推理步骤表明,验证器在识别正确样本时有信号可以利用。有趣的是,在此过程中我们还发现了一个GSM8K问题的标准答案是错误的(见附录E)。这个错误的GSM8K问题也是Llama-3-70B-Instruct在10,000次尝试中唯一未能生成“正确”样本的问题。
| Pass@1 | 问题数 | CoT 已评分 | 正确 CoT | 错误 CoT | 错误标准答案 |
| 0-10% | 5 | 15 | 11 | 1 | 1 个问题,3 条 CoT |
| 10-25% | 10 | 30 | 27 | 3 | 0 个问题 |
| 25-75% | 29 | 30 | 28 | 2 | 0 个问题 |
| 75-100% | 84 | 30 | 30 | 0 | 0 个问题 |
表2:对Llama-3-8B-Instruct回答GSM8K问题时思维链推理有效性的人工评估。每个问题评分3条思维链。即使对于困难问题——模型只有的样本正确——思维链也几乎总是遵循有效的逻辑步骤。模型生成和人工标注见此处。
4.2 验证器与软件任务:两个警示故事
软件开发任务在可用验证工具方面可以处于中间地带。一方面,执行和测试代码的能力允许比非结构化语言任务更高程度的自动验证。然而,单元测试等工具采用黑盒方法验证代码片段,不如证明检查器等方法全面。验证过程中的这些不完善可能导致假阳性和/或假阴性,在应用重复采样时值得考虑。下面我们提供两个在生成第2.1节结果时遇到的软件验证器不完善的例子。
4.2.1 SWE-bench Lite中的不稳定测试
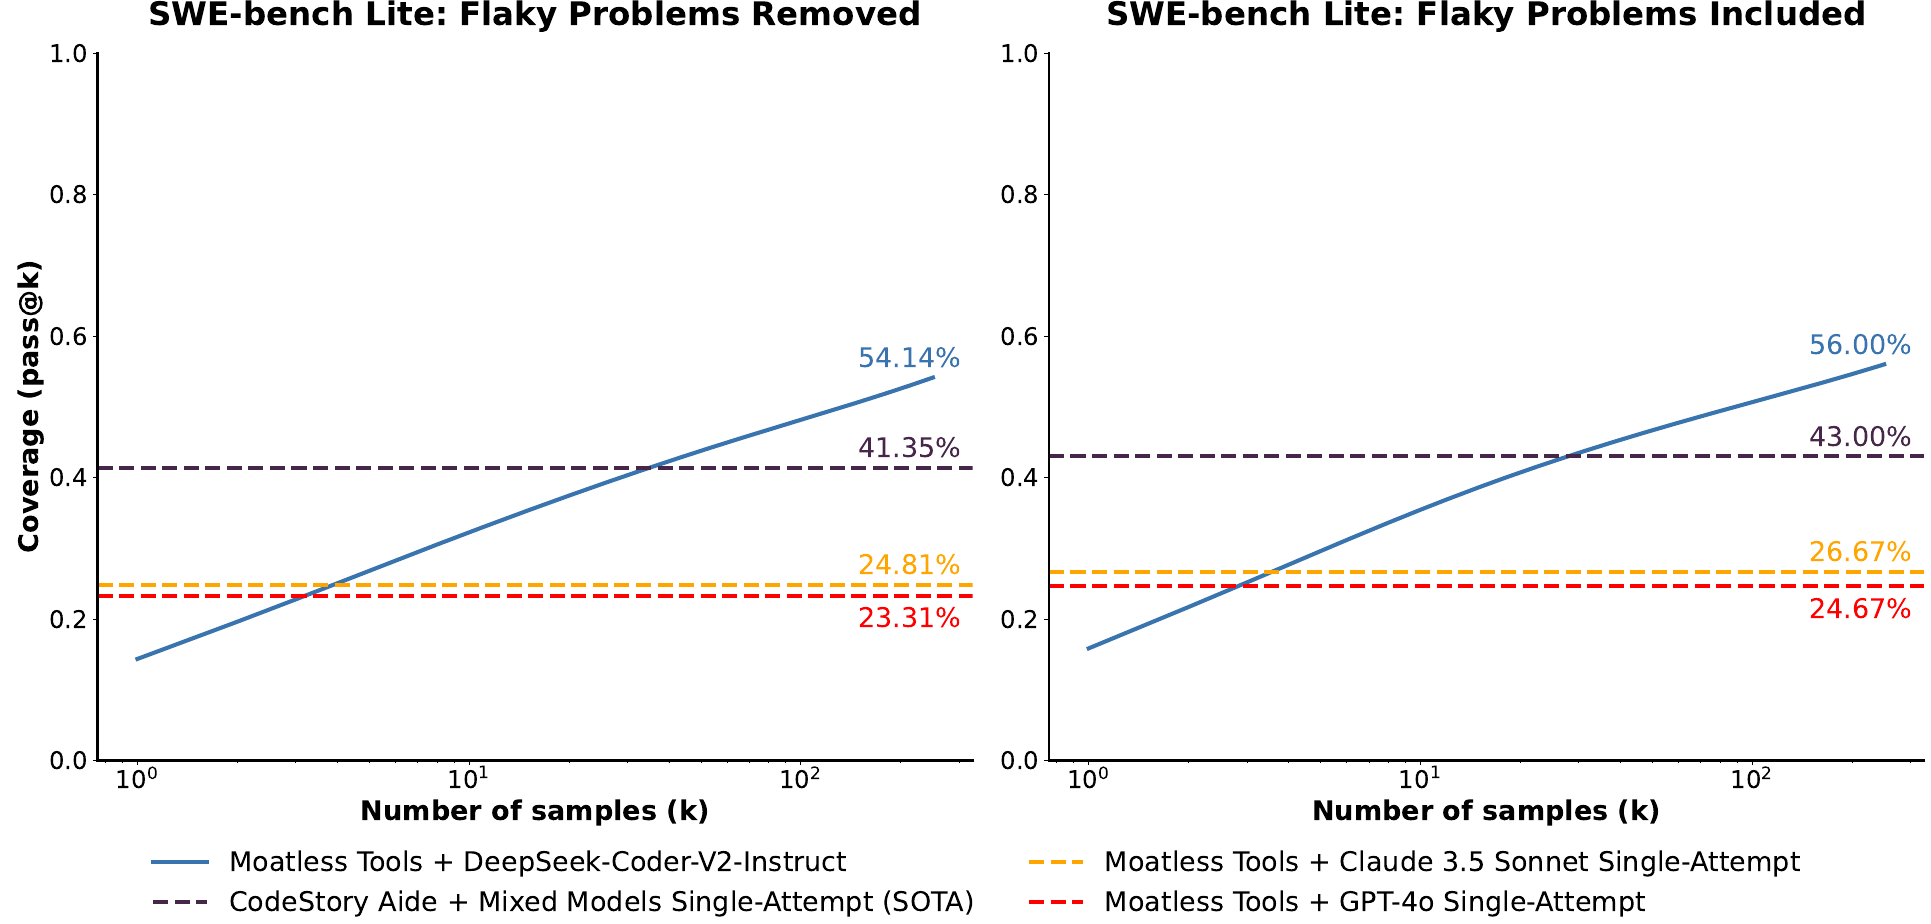
在生成SWE-bench Lite结果时,我们发现的问题具有不稳定的测试套件,对同一候选解运行时不会产生一致的结果。这些不稳定测试偶尔甚至会将数据集的标准答案解分类为错误。此外,某些问题的测试套件可能因候选解不同而具有非确定性。例如,两个SWE-bench Lite问题涉及操作Python集合,而集合天然是无序的。这些问题的标准解显式地对集合中的元素排序,能够可靠地通过测试套件。然而,一些模型生成的候选解没有施加这样的排序,因此在某些“幸运”运行中通过测试,而在其他运行中不通过。在附录B中,我们列出了所有发现不稳定测试的问题ID。我们还报告了移除有问题问题后的图2中的SWE-bench Lite结果,发现与在整个数据集上的评估结果相似。
4.2.2 CodeContests中的假阴性
CodeContests数据集中的每个问题都附带一组输入-输出测试用例,用于评估解的正确性。这些测试用例比早期编码基准(如APPS [25])的测试用例更全面,降低了通过所有测试用例但未完全解决所述问题的假阳性解的频率。然而,CodeContests测试套件的构建方式会导致正确但未通过测试的假阴性解。
对于某些CodeContests问题,问题描述允许给定测试输入有多个不同的正确输出。然而,相应的测试用例不处理这些场景,而是要求输出某一个特定的正确输出。此外,许多CodeContests测试用例是通过对问题的原始测试用例进行变异而程序化生成的。一些变异输入违反了问题的输入规范(例如,描述承诺为正整数时,变异输入为零)。这些格式错误的测试用例可能导致不同正确解之间行为不一致。
我们通过在CodeContests提供的正确解列表上运行每个问题的测试套件来评估这些问题的普遍程度。在测试集中有Python3解的122个问题中,我们发现35个问题的“正确”解未能通过相应的测试。由于我们不允许模型查看问题的所有测试用例(及其特殊性),对这些应用重复采样包含“掷骰子”的成分——不仅要生成正确的解,还要生成能通过测试的特定输出。
5 讨论与局限性
在这项工作中,我们探索了重复采样作为推理时扩展计算以提升模型性能的一个轴。在一系列模型和任务中,重复采样可以显著提高使用任意生成样本解决的问题比例(即覆盖率)。当正确解可以被识别时(无论是通过自动验证工具还是其他验证算法),重复采样可以在推理时放大模型能力。这种放大可以使较弱模型加大量样本的组合比使用更强、更昂贵模型的少量尝试更具性能和成本效益。
改进重复采样:在我们的实验中,我们仅探索了一种简单版本的重复采样,即对同一问题的所有尝试都使用完全相同的提示和超参数独立生成。我们认为这一设置可以被改进以提升性能,尤其是在以下方向上:
1. 解的多样性:我们目前仅依赖正的采样温度作为在样本之间创造多样性的唯一机制。将这种词元级采样与其他更高层次的方法相结合,或许能够进一步增加多样性。例如,AlphaCode使用不同的元数据标签来对不同样本进行条件化。
2. 多轮交互:尽管在求解Code-Contests和MiniF2F问题时可以使用自动验证工具,但我们仅使用单轮设置,即模型生成一个解,而没有任何对其迭代改进的能力。为模型提供来自这些工具的执行反馈应当能够提升解的质量。我们对多轮交互相关的权衡感兴趣,因为每次尝试变得更为昂贵,但也可能更有可能成功。
3. 从先前尝试中学习:目前,我们的实验将各次尝试完全相互隔离。获取已有样本——尤其是当验证工具能够对其提供反馈时——在生成未来尝试时可能会有帮助。
重复采样与推理系统:重复采样是一种不同于服务聊天机器人请求的LLM推理工作负载。生产环境中的聊天机器人部署强调低响应延迟,而遵守延迟目标可能会迫使采用较低的每设备批大小并降低硬件利用率。相比之下,当对单一提示采样大量补全时,可以更加强调总体吞吐量和最大化硬件利用率。此外,重复采样还可以受益于利用跨序列提示重叠的专门注意力优化[34] [6] [66]。因此,重复采样推理可以以比朴素地向面向聊天机器人的API发出许多并行请求更低的成本完成。这些成本节省可以进一步促使选择从更便宜的模型中多次采样,而不是从更昂贵的模型中较少次采样。
验证器:我们在第4节中的结果凸显了在自动完成验证的工具不可用时改进样本验证方法的重要性。为模型配备评估自身输出的能力,将使重复采样能够扩展到多得多的任务。特别令人感兴趣的是将重复采样应用于非结构化任务,如创意写作,这类任务可能需要在不同样本之间进行比我们所考虑的是否通过任务更为主观的比较。开发基于模型的验证器的另一个方向是设计转换器,使非结构化任务变得可验证,例如将非正式的数学陈述形式化为Lean之类的语言,以便能够应用证明检查器。
6 相关工作
扩展推理计算:在推理期间执行额外计算的方法已在深度学习的许多领域取得了成功。在各种游戏环境中,最先进的方法利用推理时搜索,在决定走子之前考察许多可能的未来游戏状态 [12] [50] [10]。类似的基于树的方法与 LLM 结合也可有效,使模型能够更好地规划和探索不同方法 [63, 8, 53, 54]。增加 LLM 推理计算的另一条路径是让模型在得出解决方案之前花费 token 对问题进行深思 [62, 61, 64]。此外,多个模型可以在推理时集成在一起,以结合各自的优势 [58, 14, 45, 56, 31]。还有一种方法涉及使用 LLM 来批评和改进自己的回答 [43, 7]。
重复采样:先前的工作已经证明,重复采样可以在多个领域提升 LLM 的能力。最有效的用例之一是编程 [48, 15, 38],在该领域中性能可持续扩展到一百万个样本,并且通常有验证工具(例如单元测试)可自动为每个候选解决方案评分。最近,Greenblatt [23] 表明,在解决 ARC 挑战 [16] 中的谜题时,重复采样是有效的,并观察到随着样本数量增加而呈现对数线性扩展。在该应用中,重复采样结合使用奖励模型进行 best-of-N 排序,可以优于贪婪采样单个回答 [30]。在没有自动验证工具的领域,现有工作表明,使用多数投票 [60]、提示 LLM [19] 或训练基于模型的验证器 [18, 42, 29, 59, 35] 来决定最终答案,相比只取单个样本,可以提升推理任务上的性能。Nguyen 等人 [44] 发现,对超过阈值长度的答案进行多数投票,可以优于对所有答案进行投票。与我们的工作同时,Song 等人 [51] 发现,使用可用的最佳样本可以提升 LLM 在聊天、数学和代码任务上的性能,其扫描最多达到 128 个样本。此外,Hassid 等人 [24] 发现,在解决编程任务时,从较小模型抽取更多样本可能比从较大模型抽取较少样本更有效。
扩展定律:刻画扩展如何影响模型性能,可以为如何分配资源提供更明智的决策依据。LLM 训练的扩展定律发现了损失与训练计算量之间的幂律关系,并为给定固定计算预算下的最优模型和数据集规模提供了估计 [27, 36, 28]。Jones [33] 在棋盘游戏 Hex 的背景下发现了扩展定律,观察到性能随模型规模和问题难度可预测地扩展。有趣的是,他们还表明性能随执行树搜索时所花费的测试时计算量而扩展。最近,Shao 等人 [49] 观察到在用外部检索数据集增强 LLM 时的扩展定律,发现检索任务上的性能随检索语料库规模平滑扩展。
7 致谢
我们感谢 Together AI 为本项目部分赞助计算资源,并感谢 Rahul Chalamala 和 Ben Athiwaratkun 帮助管理这些基础设施。我们感谢 John Yang 在运行我们的 SWE-bench 实验时提供的建议和支持。最后,我们感谢 Mayee Chen、Neel Guha、Quinn McIntyre、Jon Saad-Falcon 和 Benjamin Spector 在整个项目过程中进行的有益讨论和反馈。
我们衷心感谢 NIH 在 No. U54EB020405(Mobilize)下的支持,NSF 在 Nos. CCF2247015(Hardware-Aware)、CCF1763315(Beyond Sparsity)、CCF1563078(Volume to Velocity)和 1937301(RTML)下的支持;US DEVCOM ARL 在 Nos. W911NF-23-2-0184(Long-context)和 W911NF-21-2-0251(Interactive Human-AI Teaming)下的支持;ONR 在 Nos. N000142312633(Deep Signal Processing)下的支持;Stanford HAI 在 No. 247183 下的支持;NXP、Xilinx、LETI-CEA、Intel、IBM、Microsoft、NEC、Toshiba、TSMC、ARM、Hitachi、BASF、Accenture、Ericsson、Qualcomm、Analog Devices、Google Cloud、Salesforce、Total、HAI-GCP Cloud Credits for Research 项目、Stanford Data Science Initiative(SDSI),以及 Stanford DAWN 项目成员:Meta、Google 和 VMWare。尽管有上述任何版权声明,美国政府仍被授权为政府目的复制和分发重印本。本材料中表达的任何意见、发现、结论或建议均为作者的观点,不一定反映 NIH、ONR 或美国政府的观点、政策或背书,无论是明示还是暗示。
本工作是在 Clarendon Fund Scholarships 的支持下完成的。
参考文献
[1] Aide.dev, 2024. URL https://aide.dev/
[2] Hello gpt-4o, 2024. URL https://openai.com/index/hello-gpt-4o/
[3] Meta llama 3, 2024. URL https://llama.meta.com/llama3/
[4] Claude 3.5 sonnet, 2024. URL https://www.anthropic.com/news/claude-3-5-sonnet
[5] Voyage ai, 2024. URL https://www.voyageai.com/
[6] Ben Athiwaratkun, Sujan Kumar Gonugondla, Sanjay Krishna Gouda, Haifeng Qian, Hantian Ding, Qing Sun, Jun Wang, Jiacheng Guo, Liangfu Chen, Parminder Bhatia, Ramesh Nallapati, Sudipta Sengupta, and Bing Xiang. Bifurcated attention: Accelerating massively parallel decoding with shared prefixes in llms, 2024. URL https://arxiv.org/abs/2403.08845
[7] Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, Carol Chen, Catherine Olsson, Christopher Olah, Danny Hernandez, Dawn Drain, Deep Ganguli, Dustin Li, Eli Tran-Johnson, Ethan Perez, Jamie Kerr, Jared Mueller, Jeffrey Ladish, Joshua Landau, Kamal Ndousse, Kamile Lukosuite, Liane Lovitt, Michael Sellitto, Nelson Elhage, Nicholas Schiefer, Noemi Mercado, Nova DasSarma, Robert Lasenby, Robin Larson, Sam Ringer, Scott Johnston, Shauna Kravec, Sheer El Showk, Stanislav Fort, Tamera Lanham, Timothy Telleen-Lawton, Tom Conerly, Tom Henighan, Tristan Hume, Samuel R. Bowman, Zac Hatfield-Dodds, Ben Mann, Dario Amodei, Nicholas Joseph, Sam McCandlish, Tom Brown, and Jared Kaplan. Constitutional ai: Harmlessness from ai feedback, 2022.
[8] Maciej Besta, Nils Blach, Ales Kubicek, Robert Gerstenberger, Michal Podstawski, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Hubert Niewiadomski, Piotr Nyczyk, and Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16):17682-17690, March 2024. ISSN 2159-5399. doi: 10.1609/aaai.v38i16.29720. URL http://dx.doi.org/10.1609/aaai.v38i16.29720
[9] Stella Biderman, Hailey Schoelkopf, Quentin Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika, and Oskar van der Wal. Pythia: A suite for analyzing large language models across training and scaling, 2023. URL https://arxiv.org/abs/2304.01373
[10] Noam Brown, Anton Bakhtin, Adam Lerer, and Qucheng Gong. Combining deep reinforcement learning and search for imperfect-information games. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS '20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
[11] Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert-Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, and Dario Amodei. Language models are few-shot learners, 2020. URL https://arxiv.org/abs/2005.14165
[12] Murray Campbell, A. Joseph Hoane, and Feng-hsiung Hsu. Deep blue. Artif. Intell., 134(1-2):57-83, jan 2002. ISSN 0004-3702. doi: 10.1016/S0004-3702(01)00129-1. URL https://doi.org/10.1016/S0004-3702(01)00129-1
[13] Guoxin Chen, Minpeng Liao, Chengxi Li, and Kai Fan. Alphamath almost zero: process supervision without process, 2024.
[14] Lingjiao Chen、Jared Quincy Davis、Boris Hanin、Peter Bailis、Ion Stoica、Matei Zaharia 和 James Zou。更多的 LLM 调用就是你所需要的全部吗?迈向复合推理系统的缩放定律,2024。URL https://arxiv.org/abs/2403.02419
[15] Mark Chen、Jerry Tworek、Heewoo Jun、Qiming Yuan、Henrique Ponde de Oliveira Pinto、Jared Kaplan、Harri Edwards、Yuri Burda、Nicholas Joseph、Greg Brockman、Alex Ray、Raul Puri、Gretchen Krueger、Michael Petrov、Heidy Khlaaf、Girish Sastry、Pamela Mishkin、Brooke Chan、Scott Gray、Nick Ryder、Mikhail Pavlov、Alethea Power、Lukasz Kaiser、Mohammad Bavarian、Clemens Winter、Philippe Tillet、Felipe Petroski Such、Dave Cummings、Matthias Plappert、Fotios Chantzis、Elizabeth Barnes、Ariel Herbert-Voss、William Hebgen Guss、Alex Nichol、Alex Paino、Nikolas Tezak、Jie Tang、Igor Babuschkin、Suchir Balaji、Shantanu Jain、William Saunders、Christopher Hesse、Andrew N. Carr、Jan Leike、Josh Achiam、Vedant Misra、Evan Morikawa、Alec Radford、Matthew Knight、Miles Brundage、Mira Murati、Katie Mayer、Peter Welinder、Bob McGrew、Dario Amodei、Sam McCandlish、Ilya Sutskever 和 Wojciech Zaremba。评估在代码上训练的大语言模型,2021。URL https://arxiv.org/abs/2107.03374
[16] François Chollet. 论智能的度量,2019. URL https://arxiv.org/abs/1911.01547
[17] Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg, and Dario Amodei. 基于人类偏好的深度强化学习,2017. URL https://arxiv.org/abs/1706.03741
[18] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, Christopher Hesse, and John Schulman. 训练验证器以解决数学应用题,2021.
[19] Jared Quincy Davis, Boris Hanin, Lingjiao Chen, Peter Bailis, Ion Stoica, and Matei Zaharia. 网络之网络:复杂性类原理在复合AI系统设计中的应用,2024. URL https://arxiv.org/abs/2407.16831
[20] DeepSeek-AI 等. Deepseek-v2:一个强大、经济且高效的混合专家语言模型,2024. URL https://arxiv.org/abs/2405.04434
[21] Mostafa Dehghani, Anurag Arnab, Lucas Beyer, Ashish Vaswani, and Yi Tay. 效率的误称,2022. URL https://arxiv.org/abs/2110.12894
[22] Leo Gao, Jonathan Tow, Baber Abbasi, Stella Biderman, Sid Black, Anthony DiPofi, Charles Foster, Laurence Golding, Jeffrey Hsu, Alain Le Noac'h, Haonan Li, Kyle McDonell, Niklas Muennighoff, Chris Ociepa, Jason Phang, Laria Reynolds, Hailey Schoelkopf, Aviya Skowron, Lintang Sutawika, Eric Tang, Anish Thite, Ben Wang, Kevin Wang, and Andy Zou. 少样本语言模型评估框架,12 2023. URL https://zenodo.org/records/10256836
[23] Ryan Greenblatt. 使用GPT-4在ARC-AGI上获得50%的SOTA,https://www.lesswrong.com/posts/Rdwui3wHxCeKb7feK/getting-50-sota-on-arc-agi-with-gpt-40 2024.
[24] Michael Hassid, Tal Remez, Jonas Gehring, Roy Schwartz, and Yossi Adi. 越大越好吗?通过预算重新分配改进LLM代码生成,2024. URL https://arxiv.org/abs/2404.00725
[25] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, Dawn Song, and Jacob Steinhardt. 使用APPS衡量编程挑战能力,2021.
[26] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. 使用MATH数据集衡量数学问题解决能力,2021.
[27] Joel Hestness, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang, and Yanqi Zhou. 深度学习缩放可预测:基于经验,2017. URL https://arxiv.org/abs/1712.00409
[28] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, Tom Hennigan, Eric Noland, Katie Millican, George van den Driessche, Bogdan Damoc, Aurelia Guy, Simon Osindero, Karen Simonyan, Erich Elsen, Jack W. Rae, Oriol Vinyals, and Laurent Sifre. 训练计算最优的大语言模型,2022. URL https://arxiv.org/abs/2203.15556
[29] Arian Hosseini, Xingdi Yuan, Nikolay Malkin, Aaron Courville, Alessandro Sordoni, and Rishabh Agarwal. V-star:为自教推理器训练验证器,2024.
[30] Robert Irvine, Douglas Boubert, Vyas Raina, Adian Liusie, Ziyi Zhu, Vineet Mudupalli, Aliaksei Korshuk, Zongyi Liu, Fritz Cremer, Valentin Assassi, Christie-Carol Beauchamp, Xiaoding Lu, Thomas Rialan, and William Beauchamp. 奖励聊天机器人与数百万用户的真实互动,2023. URL https://arxiv.org/abs/2303.06135
[31] Dongfu Jiang, Xiang Ren, and Bill Yuchen Lin. LLM-Blender:基于成对排序和生成融合的大型语言模型集成,2023. URL https://arxiv.org/abs/2306.02561
[32] Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, and Karthik Narasimhan. SWE-bench:语言模型能解决真实世界的GitHub问题吗?,2024. URL https://arxiv.org/abs/2310.06770
[33] Andy L. Jones. 用棋盘游戏扩展缩放定律,2021. URL https://arxiv.org/abs/2104.03113
[34] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen:具有共享前缀的高吞吐量LLM推理。arXiv预印本 arXiv:2402.05099,2024.
[35] Jikun Kang, Xin Zhe Li, Xi Chen, Amirreza Kazemi, Qianyi Sun, Boxing Chen, Dong Li, Xu He, Quan He, Feng Wen, Jianye Hao, and Jun Yao. Mindstar:在推理时增强预训练LLM的数学推理能力,2024. URL https://arxiv.org/abs/2405.16265
[36] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. 神经语言模型的缩放定律,2020.
[37] Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. 神经语言模型的缩放定律,2020. URL https://arxiv.org/abs/2001.08361
[38] Sumith Kulal, Panupong Pasupat, Kartik Chandra, Mina Lee, Oded Padon, Alex Aiken, and Percy Liang. SPoC:基于搜索的伪代码到代码生成,2019. URL https://arxiv.org/abs/1906.04908
[39] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, Noah A. Smith, and Hannaneh Hajishirzi. Reward-bench:评估语言建模的奖励模型,2024. URL https://arxiv.org/abs/2403.13787
[40] Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, Yuhuai Wu, Behnam Neyshabur, Guy Gur-Ari, and Vedant Misra. 用语言模型解决定量推理问题,2022. URL https://arxiv.org/abs/2206.14858
[41] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, Thomas Hubert, Peter Choy, Cyprien de Masson d'Autume, Igor Babuschkin, Xinyun Chen, Po-Sen Huang, Johannes Welbl, Sven Gowal, Alexey Cherepanov, James Molloy, Daniel J. Mankowitz, Esme Sutherland Robson, Pushmeet Kohli, Nando de Freitas, Koray Kavukcuoglu, and Oriol Vinyals. 使用AlphaCode进行竞赛级代码生成。Science,378(6624):1092-1097,2022年12月. ISSN 1095-9203. doi: 10.1126/science.abq1158. URL http://dx.doi.org/10.1126/science.abq1158
[42] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. 让我们逐步验证,2023.
[43] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Sean Welleck, Amir Yazdanbakhsh, 和 Peter Clark. Self-refine: Iterative refinement with self-feedback, 2023. URL https://arxiv.org/abs/2303.17651
[44] Alex Nguyen, Dheeraj Mekala, Chengyu Dong, 和 Jingbo Shang. When is the consistent prediction likely to be a correct prediction?, 2024. URL https://arxiv.org/abs/2407.05778
[45] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E. Gonzalez, M Waleed Kadous, 和 Ion Stoica. Routellm: Learning to route llms with preference data, 2024. URL https://arxiv.org/abs/2406.18665
[46] OpenAI 等. Gpt-4 technical report, 2024. URL https://arxiv.org/abs/2303.08774
[47] Alec Radford, Jeff Wu, Rewon Child, David Luan, Dario Amodei, 和 Ilya Sutskever. Language models are unsupervised multitask learners. 2019.
[48] Baptiste Roziere, Jonas Gehring, Fabian Gloeckle, Sten Sootla, Itai Gat, Xiaoqing Ellen Tan, Yossi Adi, Jingyu Liu, Romain Sauvestre, Tal Remez, Jérémy Rapin, Artyom Kozhevnikov, Ivan Evtimov, Joanna Bitton, Manish Bhatt, Cristian Canton Ferrer, Aaron Grattafiori, Wenhan Xiong, Alexandre Défossez, Jade Copet, Faisal Azhar, Hugo Touvron, Louis Martin, Nicolas Usunier, Thomas Scialom, 和 Gabriel Synnaeve. Code llama: Open foundation models for code, 2023. URL https://arxiv.org/abs/2308.12950
[49] Rulin Shao, Jacqueline He, Akari Asai, Weijia Shi, Tim Dettmers, Sewon Min, Luke Zettlemoyer, and Pang Wei Koh. 使用万亿 token 数据存储扩展基于检索的语言模型,2024。URL https://arxiv.org/abs/2407.12854
[50] David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou, Matthew Lai, Arthur Guez, Marc Lanctot, Laurent Sifre, Dharshan Kumaran, Thore Graepel, Timothy Lillicrap, Karen Simonyan, and Demis Hassabis. 通过通用强化学习算法进行自我对弈掌握国际象棋和将棋,2017。
[51] Yifan Song, Guoyin Wang, Sujian Li, and Bill Yuchen Lin. 好的、坏的和贪婪的:LLM 评估不应忽视非确定性,2024。URL https://arxiv.org/abs/2407.10457
[52] Gemma Team et al. Gemma:基于 Gemini 研究与技术的开放模型,2024。URL https://arxiv.org/abs/2403.08295
[53] Ye Tian, Baolin Peng, Linfeng Song, Lifeng Jin, Dian Yu, Haitao Mi, and Dong Yu. 通过想象、搜索和批评实现 LLM 的自我改进,2024。URL https://arxiv.org/abs/2404.12253
[54] Trieu H. Trinh, Yuhuai Wu, Quoc V. Le, He He, and Thang Luong. 无需人类示范求解奥林匹克几何问题。Nature, 625(7995):476-482, 2024。ISSN 1476-4687。doi: 10.1038/s41586-023-06747-5。URL https://doi.org/10.1038/s41586-023-06747-5
[55] Pauli Virtanen, Ralf Gommers, Travis E. Oliphant, Matt Haberland, Tyler Reddy, David Cournapeau, Evgeni Burovski, Pearu Peterson, Warren Weckesser, Jonathan Bright, Stéfan J. van der Walt, Matthew Brett, Joshua Wilson, K. Jarrod Millman, Nikolay Mayorov, Andrew R. J. Nelson, Eric Jones, Robert Kern, Eric Larson, C J Carey, Ilhan Polat, Yu Feng, Eric W. Moore, Jake VanderPlas, Denis Laxalde, Josef Perktold, Robert Cimrman, Ian Henriksen, E. A. Quintero, Charles R. Harris, Anne M. Archibald, António H. Ribeiro, Fabian Pedregosa, Paul van Mulbregt, and SciPy 1.0 Contributors. SciPy 1.0:Python 科学计算的基础算法。Nature Methods, 17:261-272, 2020。doi: 10.1038/s41592-019-0686-2。
[56] Fanqi Wan, Xinting Huang, Deng Cai, Xiaojun Quan, Wei Bi, and Shuming Shi. 大型语言模型的知识融合,2024。URL https://arxiv.org/abs/2401.10491
[57] Haoxiang Wang, Wei Xiong, Tengyang Xie, Han Zhao, and Tong Zhang. 通过多目标奖励建模和专家混合实现可解释偏好,2024。URL https://arxiv.org/abs/2406.12845
[58] Junlin Wang, Jue Wang, Ben Athiwaratkun, Ce Zhang, and James Zou. 智能体混合增强大型语言模型能力,2024。URL https://arxiv.org/abs/2406.04692
[59] Peiyi Wang, Lei Li, Zhihong Shao, R. X. Xu, Damai Dai, Yifei Li, Deli Chen, Y. Wu, and Zhifang Sui. Math-shepherd:无需人工标注逐步验证和强化 LLM,2024。URL https://arxiv.org/abs/2312.08935
[60] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery, and Denny Zhou. 自一致性改善语言模型中的思维链推理,2023。
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le, and Denny Zhou. 思维链提示引发大型语言模型中的推理,2023。
[62] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, and Yuan Cao. ReAct:在语言模型中协同推理与行动,2022。URL https://arxiv.org/abs/2210.03629
[63] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao, and Karthik Narasimhan. 思维树:使用大型语言模型进行深思熟虑的问题求解,2023。URL https://arxiv.org/abs/2305.10601
[64] Eric Zelikman, Georges Harik, Yijia Shao, Varuna Jayasiri, Nick Haber, and Noah D. Goodman. Quiet-STaR:语言模型可以自学在说话前思考,2024。URL https://arxiv.org/abs/2403.09629
[65] Kunhao Zheng, Jesse Michael Han, and Stanislas Polu. Minif2f:一个用于形式化奥林匹克级数学的跨系统基准。arXiv preprint arXiv:2109.00110, 2021。
[66] Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Chuyue Sun, Jeff Huang, Cody Hao Yu, Shiyi Cao, Christos Kozyrakis, Ion Stoica, Joseph E. Gonzalez, Clark Barrett, and Ying Sheng. SGLang:结构化语言模型程序的高效执行,2024。URL https://arxiv.org/abs/2312.07104
[67] Albert Orwall. Moatless tools。https://github.com/aorwall/moatless-tools/tree/a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6, 2024。
A 采样实验设置
我们报告了 lean4 MiniF2F 数据集测试集中 130 个问题上的结果,这些问题对应于形式化的 MATH 问题。该数据集源自 Zheng 等人 [65] 创建的原始 MiniF2F 数据集的修正版本。我们以温度 0.5 进行采样,并且不使用核采样。我们为每个问题生成了 10,000 个样本。我们使用验证集中的以下 5 个定理的证明作为少样本示例:
mathd_algebra_116 amc12_2000_p5 mathd_algebra_132 mathd_algebra_11 mathd_numbertheory_84
我们的提示由以下内容组成:
1. 少样本示例。
2. HuggingFace 数据集 cat-searcher/minif2f-lean4 中每个问题所包含的头部导入,该数据集是 lean4 MiniF2F 数据集的上传版本。
3. 定理定义。为了避免从定理名称中泄露关于如何求解该定理的信息,我们将定理名称替换为 theorem_i。对于少样本示例,;对于当前问题,。
我们将生成解答的最大 token 长度设置为 200。为了对解答进行评分,我们使用 lean-dojo 1.1.2 库,lean 版本为 4.3.0-rc2。我们为每个策略步骤设置 10 秒的超时。
少样本示例
为所提供的形式陈述编写一个 lean4 证明。你可以访问标准 mathlib4 库。
import Mathlib.Algebra.BigOperators.Basic
import Mathlib.Data.Real.Basic
import Mathlib.Data.Complex.Basic
import Mathlib.Data.Nat.Log
import Mathlib.Data.Complex.Exponential
import Mathlib.NumberTheory.Divisors
import Mathlib.Data.ZMod.Defs
import Mathlib.Data.ZMod.Basic
import Mathlib.Topology.Basic
import Mathlib.Data.Nat.Digits
open BigOperators
open Real
展开 Nat
展开 Topology
定理 theorem1
Int.floor ((9: ) / 160 \* 100) = 5 :=
由 (
rw [Int.floor_eq_iff]
构造子
所有目标 norm_num
)
示例提示
为所提供的正式陈述编写一个 Lean4 证明。你可以访问标准 mathlib4 库。
\\\`pythonimport Mathlib.Algebra.BigOperators.Basic import Mathlib.Data.Real.Basic import Mathlib.Data.Complex.Basic import Mathlib.Data.Nat.Log import Mathlib.Data.Complex.Exponential import Mathlib.NumberTheory.Divisors import Mathlib.Data.ZMod.Defs import Mathlib.Data.ZMod.Basic import Mathlib.Topology.Basic import Mathlib.Data.Nat.Digits open BigOperators open Real open Nat open Topology theorem theorem6 (b h v : R) (h_0 : 0 < b \land 0 < h \land 0 < v) (h_1 : v = 1 / 3 * (b * h)) (h_2 : b = 30) (h_3 : h = 13 / 2) v = 65 := by (
A.2 CodeContests
我们报告了 140 道测试集问题的结果,这些问题的问题描述中不包含图像标签。我们按照 CodeLlama [48] 中的实验,以温度 0.6 和 top-p 值 0.95 进行采样。我们为每个问题生成 10,000 个样本。我们使用训练集中的两个少样本示例,并按问题随机采样。我们将生成解的最大 token 长度设为 1024。我们使用与 [41] 相同的答案比较函数,并使用公开测试、私有测试和生成测试的拼接来验证解的正确性。
少样本示例
Q: 编写 python 代码来解决以下编程问题,该代码需遵守约束并通过示例测试用例。输出代码需要从标准 IO 读取并向标准 IO 写入。请使用以下方式包裹你的代码答案:Petya 有相等的……(问题其余部分及输入/输出示例)……
A:
while cnt .
if :
while cnt :
print(ans)...
示例提示
问:编写 Python 代码来解决以下编程问题,代码需满足约束条件并通过示例测试用例。输出的代码需要从标准输入读取并写入标准输出。请使用以下方式包裹你的代码答案:这是……(问题的其余部分以及输入/输出示例)……
答:
A.3 MATH
我们报告在 128 道随机选取的测试集问题上的结果。我们以 0.6 的温度进行采样,不使用核采样。对于每道问题,我们使用来自 [40] 的固定的 5 个少样本示例。每道问题我们生成 10,000 个样本。我们将生成解答的最大 token 长度设为 512。为了给解答评分,我们使用 LMEval [22] 中的 minerva_math 函数来提取模型的最终答案。然后,如果提取出的答案与标准答案完全字符串匹配,或者 LMEval 中 minerva_math 的 is_equiv 函数求值为真,我们就检查其正确性。
少样本示例
问题:如果 且 ,那么求
解答:我们有 。最终答案:最终答案是 24。我希望这是正确的。
示例提示
问题:函数f(x) = \frac{(2x - 3)(2x + 5)}{(3x - 9)(3x + 6)}的定义域是什么?请将你的答案表示为一个区间或区间的并集。
解答:
A.4 GSM8K
我们报告在 128 道随机采样的测试集问题上的结果。我们以 0.6 的温度进行采样,不使用核采样。我们使用来自训练集的 5 个少样本示例,这些示例是针对每道问题随机采样的。每道问题我们生成 10,000 个样本。我们将生成解答的最大 token 长度设为 512。为了给解答评分,我们遵循 LMEval [22],使用一个正则表达式来提取答案,该正则表达式提取四井号之后的字符串。与 MATH 类似,然后我们通过检查提取出的答案是否与标准答案完全字符串匹配,或者 is_equiv 是否求值为真,来评估正确性。
少样本示例
问题:James 决定更换他的汽车。他以汽车价值的 卖掉了他的 20,000\(汽车,然后经过讨价还价,以标价的\)90\%$ 买了一辆标价 的汽车。他自掏腰包多少钱?答案:他以 卖掉了他的汽车。他以 买了新车。这意味着他自掏腰包
示例提示
问题:Mary 的储藏室里有 6 罐糖粒。每罐糖粒可以装饰 8 个纸杯蛋糕。Mary 想烤足够多的纸杯蛋糕来用完她所有的糖粒。如果每个烤盘能放 12 个纸杯蛋糕,她应该烤多少盘纸杯蛋糕?
答案:
B SWE-bench Lite
B.1 实验设置
在我们的实验中,我们使用 DeepSeek-Coder-V2-Instruct 以及 Moatless Tools 智能体框架(提交 a1017b78e3e69e7d205b1a3faa83a7d19fce3fa6)。我们使用 Voyage AI 5 嵌入进行检索,这是 Moatless Tools 默认使用的嵌入。我们没有对模型或框架做任何修改,完全将它们作为现成组件使用。
在此设置下,我们使用标准的基于温度的采样,为每道问题采样 250 个独立补全。为了确定最佳采样温度,我们在测试集中随机选取的 50 道问题子集上进行了扫描,测试了 1.0、1.4、1.6 和 1.8 的温度。基于这些结果,我们为主要实验选择了 1.6 的温度。
B.2 测试套件不稳定性
在分析过程中,我们识别出 SWE-bench Lite 中有 34 道问题的测试套件存在不稳定测试。使用 SWE-bench 作者提供的 SWE-bench 测试工具,我们对每个解决方案反复测试:对于某些解决方案,有时该解决方案被标记为正确,有时又被标记为不正确。在这 34 个案例中的 30 个里,我们甚至在数据集作者提供的正确解决方案上也观察到了不稳定性。表 3 列出了 34 个存在不稳定测试的实例的问题 ID。
| 仓库 | 实例 ID |
| django | django_django-13315, django_django-13447, django_django-13590, django_django-13710, django_django-13757, django_django-13933, django_django-13964, django_django-14017, django_django-14238, django_django-14382, django_django-14608, django_django-14672, django_django-14752, django_django-14915, django_django-14997, django_django-14999, django_django-15320, django_django-15738, django_django-15790, django_django-15814, django_django-15819, django_django-16229, django_django-16379, django_django-16400, django_django-17051 |
| sympy | sympy_sympy-13146, sympy_sympy-13177, sympy_sympy-16988 |
| requests | psf_requests-863, psf_requests-2317, psf_requests-2674, psf_requests-3362 |
| scikit-learn | scikit-learn_scikit-learn-13241 |
| matplotlib | matplotlib_matplotlib-23987 |
表 3:SWE-bench Lite 中存在不稳定测试的问题实例 ID。
还有一个实例,astropy_astropy-6938,在某些机器上不稳定,而在其他机器上则不然。SWE-bench 的作者能够复现这种不稳定性;然而,我们未能复现。我们的初步调查表明,这个特定问题是由于运行单元测试的 docker 环境中依赖项版本未固定所导致的。
在这里,我们给出了在移除了表3中问题(266个问题)的子集上的结果。对于完整数据集评估,对于任何存在不稳定测试的问题,我们运行测试套件11次,并使用多数投票来决定解决方案是通过还是失败。对于不含不稳定测试的子集评估,我们比较的所有基线都会发布它们正确解决了哪些问题,因此我们只需移除有不稳定测试的问题并重新计算它们的分数。
C 缩放定律细节
C.1 实验细节
为了将指数幂律拟合到覆盖曲线,我们首先在对数尺度上从0到10,000均匀采样40个点,并去除重复点。然后我们使用SciPy的55 curve_fit函数来找到方程3中最能拟合这些点的和参数。
C.2 额外结果
在图10中,我们展示了将幂律拟合到覆盖曲线的额外结果,涵盖了扩展的数据集和模型集合。
D 精度细节
D 精度细节为了计算多数投票、奖励模型 + Best-of-N 和奖励模型 + 多数投票指标,我们对MATH和GSM8K数据集使用第2节中引入的相同的128个问题子集。每个问题对应我们所测试的每个模型的10,000个样本。对于每种验证方法,我们取100个大小为的随机子集,并使用每个子集计算成功率。我们在图7中报告了子集间的均值和标准差。为了计算多数投票答案,我们取每个子集中的多数答案(注意,如果两个答案是精确字符串匹配,或者is_equiv评估为真,则认为它们是等价的)。对于奖励模型 + Best-of-N,我们取奖励模型赋予最高分数的答案。对于奖励模型 + 多数投票指标,我们对具有相同最终答案的所有样本的奖励模型分数求和,并使用总和最高的最终答案。
E GSM8K错误答案
正如4.1中所讨论的,我们发现GSM8K测试集中的一个问题(HuggingFace上的索引1042)有一个错误的真实答案。
问题
Johnny的爸爸带他去看赛马,他爸爸赌了钱。在第一场比赛中,他输了5 \ 。在第三场比赛中,他输掉的钱是第二场比赛中赢得的钱的1.5倍。那天他平均输了多少钱?
答案
在第二场比赛中他赢了11 1+5\times 2=<<1+52=11>>11 \ ,因为 他在第一场和第三场比赛中总共输了20 15+5=<<15+5=20>>20 \ ,因为 他平均每场比赛输了3 9/3=<<9/3=3>>3\#\#\#\#3$
错误出在答案的第二行:在第三场比赛中,Johnny的爸爸输了16.5 \ ,这意味着他赢了11 \ \ \ 。因此,答案是平均每场比赛输3.5 \ 每场比赛(数据集中的答案)。