
大量共享前缀的请求白白浪费显存。SGLang 复用共享 KV 缓存,吞吐最高提升 6.4 倍。2024 年 NeurIPS 论文,全文免费在线阅读。
SGLang: Efficient Execution of Structured Language Model Programs
SGLang:结构化语言模型程序的高效执行
Lianmin Zheng * Liansheng Yin Zhiqiang Xie Chuyue Sun Jeff Huang Cody Hao Yu Shiyi Cao Christos Kozyrakis Ion Stoica Joseph E. Gonzalez Clark Barrett Ying Sheng *
斯坦福大学 加州大学伯克利分校 上海交通大学 德克萨斯农工大学 独立研究者
摘要
大语言模型(LLM)越来越多地被用于需要多次生成调用、高级提示技术、控制流以及结构化输入/输出的复杂任务。然而,目前缺乏用于编程和执行这些应用的高效系统。我们提出 SGLang,一个用于高效执行复杂语言模型程序的系统。SGLang 由一个前端语言和一个运行时组成。前端通过生成和并行控制的原语简化了编程。运行时通过新颖的优化(如用于 KV 缓存复用的 RadixAttention 和用于加速结构化输出解码的压缩有限状态机)加速执行。实验表明,在各种大语言模型和多模态模型上,针对包括智能体控制、逻辑推理、少样本学习基准、JSON 解码、检索增强生成流水线和多轮对话在内的任务,SGLang 相比最先进的推理系统实现了高达 \(6.4 \times\) 的吞吐量提升。代码已公开于 https://github.com/sgl-project/sglang。
1 引言
近年来 LLM 能力的提升拓宽了其用途,使其能够处理更广泛的通用任务并充当自主智能体 [35, 6, 36, 52, 46]。在此类应用中,LLM 参与多轮规划、推理以及与外部环境的交互。这通过工具使用 [41, 38]、多种输入模态 [47, 2] 以及广泛的提示技术 [30](如少样本学习 [5]、自一致性 [53]、思维骨架 [33] 和思维树 [56])来实现。所有这些新的用例都需要多次(通常相互依赖的)LLM 生成调用,显示出使用多次调用结构来完成复杂任务的趋势 [57, 21]。
这些模式的出现标志着我们与 LLM 交互方式的转变,从简单的聊天转向一种更复杂的 LLM 编程式使用方式,即使用程序来调度和控制 LLM 的生成过程。我们将这些程序称为“语言模型程序”(LM 程序)[4, 20]。上述高级提示技术和智能体工作流都属于 LM 程序的范畴。LM 程序有两个常见特性:(1)LM 程序通常包含多个 LLM 调用,并穿插控制流。这是完成复杂任务和提高整体质量所必需的。(2)LM 程序接收结构化输入并产生结构化输出。这是实现 LM 程序组合以及将 LM 程序集成到现有软件系统中所必需的。

尽管 LM 程序被广泛使用,当前用于表达和执行它们的系统仍然效率低下。我们识别出与高效使用 LM 程序相关的两个主要挑战:首先,由于 LLM 的非确定性本质,编写 LM 程序既繁琐又困难。开发一个 LM 程序通常需要大量的字符串操作、提示的实验性调优、脆弱的输出解析、处理多种输入模态以及实现并行机制。这种复杂性显著降低了即使简单程序的可读性(第 2 节)。
其次,更重要的是,由于冗余计算和内存使用,执行 LM 程序效率低下。最先进的推理引擎(例如 vLLM [23]、TGI [16] 和 TensorRT-LLM [34])已针对降低延迟和提高吞吐量进行了优化,但并不直接了解工作负载。这使得这些系统通用且稳健,但也导致对任何给定工作负载都存在显著的效率低下问题。一个突出的例子是键值(KV)缓存的复用(第 3 节)。KV 缓存由对生成式推理至关重要的可复用中间张量组成。在 LM 程序的典型批量执行过程中,存在大量机会可以在共享公共前缀的多个不同 LLM 调用之间复用 KV 缓存。然而,当前系统缺乏有效的机制来促进这种复用,导致不必要的计算和内存浪费。另一个例子是结构化输出的约束解码(例如 JSON 模式),其中 LLM 的输出被限制为遵循由正则表达式定义的特定语法规则(第 4 节)。在这些约束下,通常可以一次解码多个 token。然而,现有系统每次只解码一个 token,导致解码速度次优。
为应对这些挑战,我们提出 SGLang,一种用于 LLM 的结构化生成语言。其核心思想是系统地利用 LM 程序中的多次调用结构来实现高效执行。如图 1 所示,它包含两部分:一个前端语言和一个后端运行时。前端简化了 LM 程序的编写,运行时加速了它们的执行。这两部分可以协同工作以获得更好的性能,但也可以独立运行。
我们引入 SGLang 作为嵌入 Python 的领域特定语言。它提供了用于生成(例如 extend、gen、select)和并行控制(例如 fork、join)的原语。SGLang 与 Python 的控制流和库兼容,因此用户可以使用原生 Python 语法轻松开发高级提示工作流。我们为 SGLang 提供了一个解释器和一个编译器。解释器将提示状态作为流进行管理,并将原语操作提交到流中以进行异步执行,确保对同步和程序内并行的适当控制。此外,SGLang 程序可以被追踪和编译以进行更多优化。
在运行时方面,我们提出了若干新颖的优化来加速 SGLang 程序的执行。第一项技术是 RadixAttention,它能够在多个生成调用之间自动复用 KV 缓存。在现有推理引擎中,请求的 KV 缓存在处理完成后被丢弃,阻止了 KV 缓存在多个调用之间被复用,并显著降低了执行速度。相反,我们的系统在基数树中为所有请求维护 KV 缓存的 LRU 缓存。这种方法将 KV 缓存作为传统缓存进行管理,并使用基数树进行高效的匹配、插入和淘汰。它允许运行时通过缓存感知的调度策略高效地处理各种复用模式。第二项技术是压缩有限状态机,它能够为结构化输出实现更快的约束解码。现有系统仅针对下一个 token 遵循约束,通过屏蔽不允许的 token 的概率来实现,使其只能一次解码一个 token。相反,我们的系统分析约束并构建压缩有限状态机来表示该约束。这种方法在可能的情况下将多 token 路径压缩为单步路径,允许一次解码多个 token 以实现更快的解码速度。最后,SGLang 也支持仅 API 模型如 OpenAI 的 GPT-4,我们引入了第三项技术,API 推测执行,以针对仅 API 模型优化多次调用程序。
使用 SGLang,我们实现了各种 LLM 应用,包括智能体控制、逻辑推理、少样本学习基准、JSON 解码、检索增强生成流水线、多轮对话和多模态处理。我们在 NVIDIA A10G 和 A100 GPU 上测试了包括 Llama-7B/70B [49]、Mistral-8x7B [17]、LLaVA-v1.5-7B(图像)[28] 和 LLaVA-NeXT-34B(视频)[62] 在内的模型的性能。实验结果表明,与现有的编程和推理系统(包括 Guidance [13]、vLLM [23] 和 LMQL [4])相比,SGLang 在广泛的工作负载、模型和硬件设置下实现了高达 \(6.4 \times\) 的吞吐量提升。
2 编程模型
本节通过一个运行示例介绍 SGLang 编程模型,描述其语言原语和执行模式,并概述运行时优化机会。该编程模型通过提供灵活且可组合的原语,可以简化多次调用工作流中的繁琐操作(例如字符串操作、API 调用、约束指定、并行)。
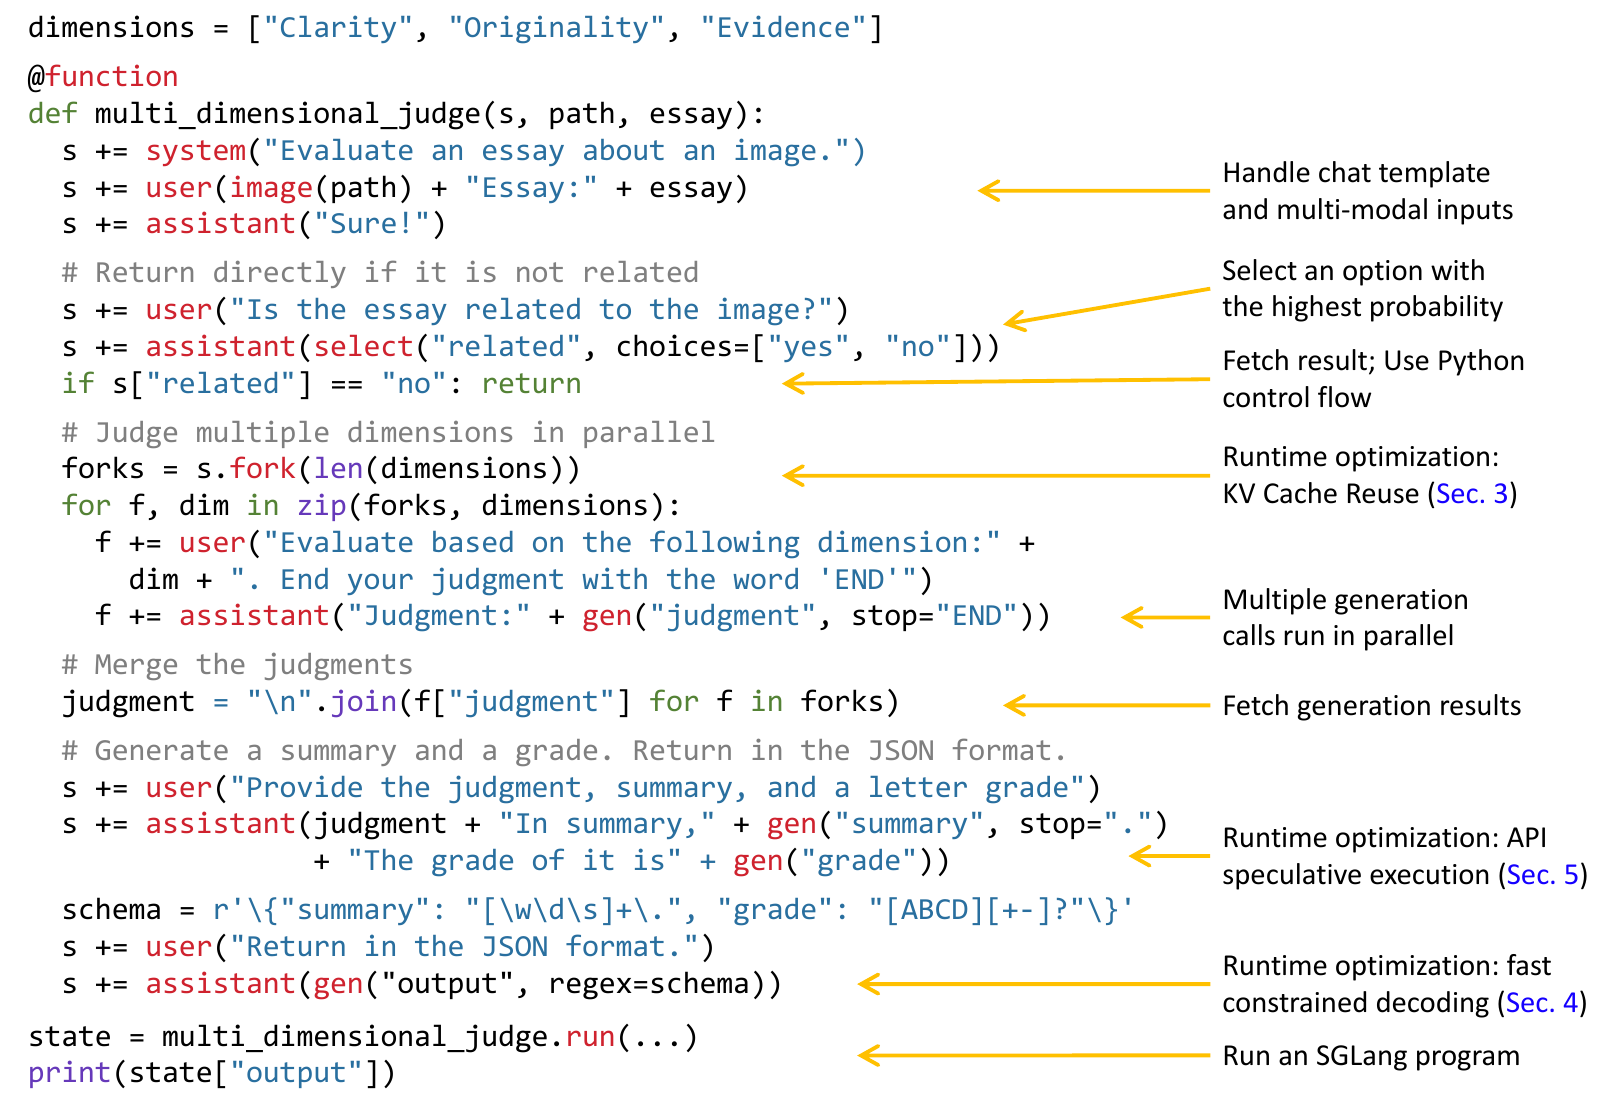
一个运行示例。该语言是嵌入 Python 的领域特定语言。图 2 展示了一个使用分支-求解-合并提示方法 [40] 评估关于图像的文章的程序。函数 multi_dimensional_judge 接受三个参数:s、path 和 essay。s 管理提示状态,path 是图像文件路径,essay 是文章文本。可以使用 运算符将新字符串和 SGLang 原语追加到状态 s 中以供执行。首先,该函数将图像和文章添加到提示中。然后使用 select 检查文章是否与图像相关,将结果存储在 s["related"] 中。如果相关,则将提示分叉为三个副本,以从不同维度进行并行评估,使用 gen 将结果存储在 f["judgment"] 中。接下来,它合并这些评判,生成摘要,并分配字母等级。最后,它按照由正则表达式约束 regex 定义的模式,以 JSON 格式返回结果。SGLang 极大地简化了该程序,因为使用类似 OpenAI API 接口的等效程序由于手动字符串操作和并行控制,需要 的代码行数。
语言原语。SGLang 提供了用于控制提示状态、生成和并行性的原语。它们可以与 Python 语法和库一起使用。以下是这些原语:“gen”调用模型进行生成,并将结果存储在以第一个参数中指定的名称命名的变量中。它支持“regex”参数,以将输出约束为遵循由正则表达式定义的语法(例如,JSON schema)。“select”调用模型从列表中选择概率最高的选项。运算符“+=”或“extend”将字符串追加到提示中。运算符“[variable_name]”获取生成的结果。“fork”创建提示状态的并行分支。“join”重新合并提示状态。“image”和“video”接收图像和视频输入。
执行模式。执行 SGLang 程序最简单的方法是通过解释器,其中提示被视为异步流。像 extend、gen 和 select 这样的原语被提交到流中以进行异步执行。这些非阻塞调用允许 Python 代码继续运行,而无需等待生成完成。这类似于异步启动 CUDA 内核。每个提示都由后台线程中的流执行器管理,从而实现程序内并行性。获取生成结果将阻塞,直到它们准备就绪,从而确保正确的同步。或者,SGLang 程序可以编译为计算图,
| System | Syntax | Language Primitives | Runtime Backends |
| LMQL Guidance | Custom Python | extend, gen, select extend, gen, select, image | HF Transformers, llama.cpp, OpenAI HF Transformers, llama.cpp, OpenAI |
| SGLang | Python | extend, gen, select, image, video, fork, join | SGLang Runtime (SRT), OpenAI |
并使用图执行器执行,从而实现更多优化。本文默认使用解释器模式,并在附录 D 中讨论编译器模式的结果。SGLang 通过其自有的 SGLang Runtime(SRT)支持开放权重模型,也支持 OpenAI 和 Anthropic 模型等 API 模型。
比较。面向 LLM 的编程系统可以分为高层系统(例如 LangChain、DSPy)和低层系统(例如 LMQL、Guidance、SGLang)。高层系统提供预定义或自动生成的提示,例如 DSPy 的提示优化器。低层系统通常不改变提示,但允许直接操作提示和原语。SGLang 是一个类似于 LMQL 和 Guidance 的低层系统。表 1 比较了它们的特性。SGLang 更关注运行时效率,并自带协同设计的运行时,从而支持后文引入的新颖优化。高层语言(例如 DSPy)可以编译为低层语言(例如 SGLang)。我们在第 6 节展示了将 SGLang 作为 DSPy 中的后端集成,以获得更好的运行时效率。
运行时优化。图2展示了三种运行时优化机会:KV缓存复用、快速约束解码、API推测执行。我们将在以下各节中讨论它们。
3 使用RadixAttention的高效KV缓存复用
SGLang程序可以链式调用多个生成调用,并通过“fork”原语创建并行副本。此外,不同的程序实例通常共享一些公共部分(例如系统提示)。这些场景在执行过程中会产生许多共享的提示前缀,从而带来大量复用KV缓存的机会。在LLM推理过程中,KV缓存存储前向传播的中间张量,用于后续token的解码。它们因自注意力机制[51]中的键值对而得名。KV缓存的计算仅依赖于前缀token。因此,具有相同提示前缀的请求可以复用KV缓存,从而减少冗余计算和内存使用。更多背景和一些示例见附录A。
鉴于KV缓存复用的机会,优化SGLang程序的一个关键挑战是在多个调用和实例之间复用KV缓存。虽然一些系统探索了某些KV缓存复用场景[23, 58, 18, 12],但它们通常需要手动配置,且无法处理所有复用模式(例如动态树结构)。因此,大多数最先进的推理系统会为每个请求重新计算KV缓存。我们将在第7节讨论它们的局限性和我们的差异。
本节介绍RadixAttention,一种在运行时自动且系统化复用KV缓存的新技术。与现有系统在生成请求完成后丢弃KV缓存不同,我们的系统将提示和生成结果的缓存保留在基数树中,从而实现高效的前缀搜索、复用、插入和驱逐。我们实现了LRU驱逐策略和缓存感知调度策略以提高缓存命中率。RadixAttention与连续批处理[60]、分页注意力[23]和张量并行[44]等技术兼容。此外,在没有缓存命中时,它仅引入可忽略的内存和时间开销。
RadixAttention。基数树是一种数据结构,作为经典trie(前缀树)的空间高效替代方案。与典型树不同,基数树的边不仅可以标记单个元素,还可以标记长度可变的元素序列,从而显著提高效率。在我们的系统中,我们利用基数树来管理token序列与其对应KV缓存张量之间的映射。这些KV缓存张量以非连续的分页布局存储,其中每页的大小相当于一个token。由于GPU内存很快被KV缓存填满,我们引入了一种简单的LRU驱逐策略,优先驱逐最近最少使用的叶子。通过优先驱逐叶子,我们可以复用其公共祖先,直到这些祖先也成为叶子并被驱逐。
在连续批处理设置中,我们无法驱逐当前运行批次所使用的节点。因此,每个节点维护一个引用计数器,指示有多少运行中的请求正在使用它。当节点的引用计数器为零时,该节点可被驱逐。注意,我们不会预分配固定大小的内存池作为缓存。相反,我们让缓存的token和当前运行的请求共享同一内存池。因此,系统会为缓存和运行中的请求动态分配内存。当有足够的等待请求运行时,系统将驱逐所有缓存的token以支持更大的批处理大小。图3展示了针对若干传入请求如何维护基数树。前端解释器向运行时发送完整提示,
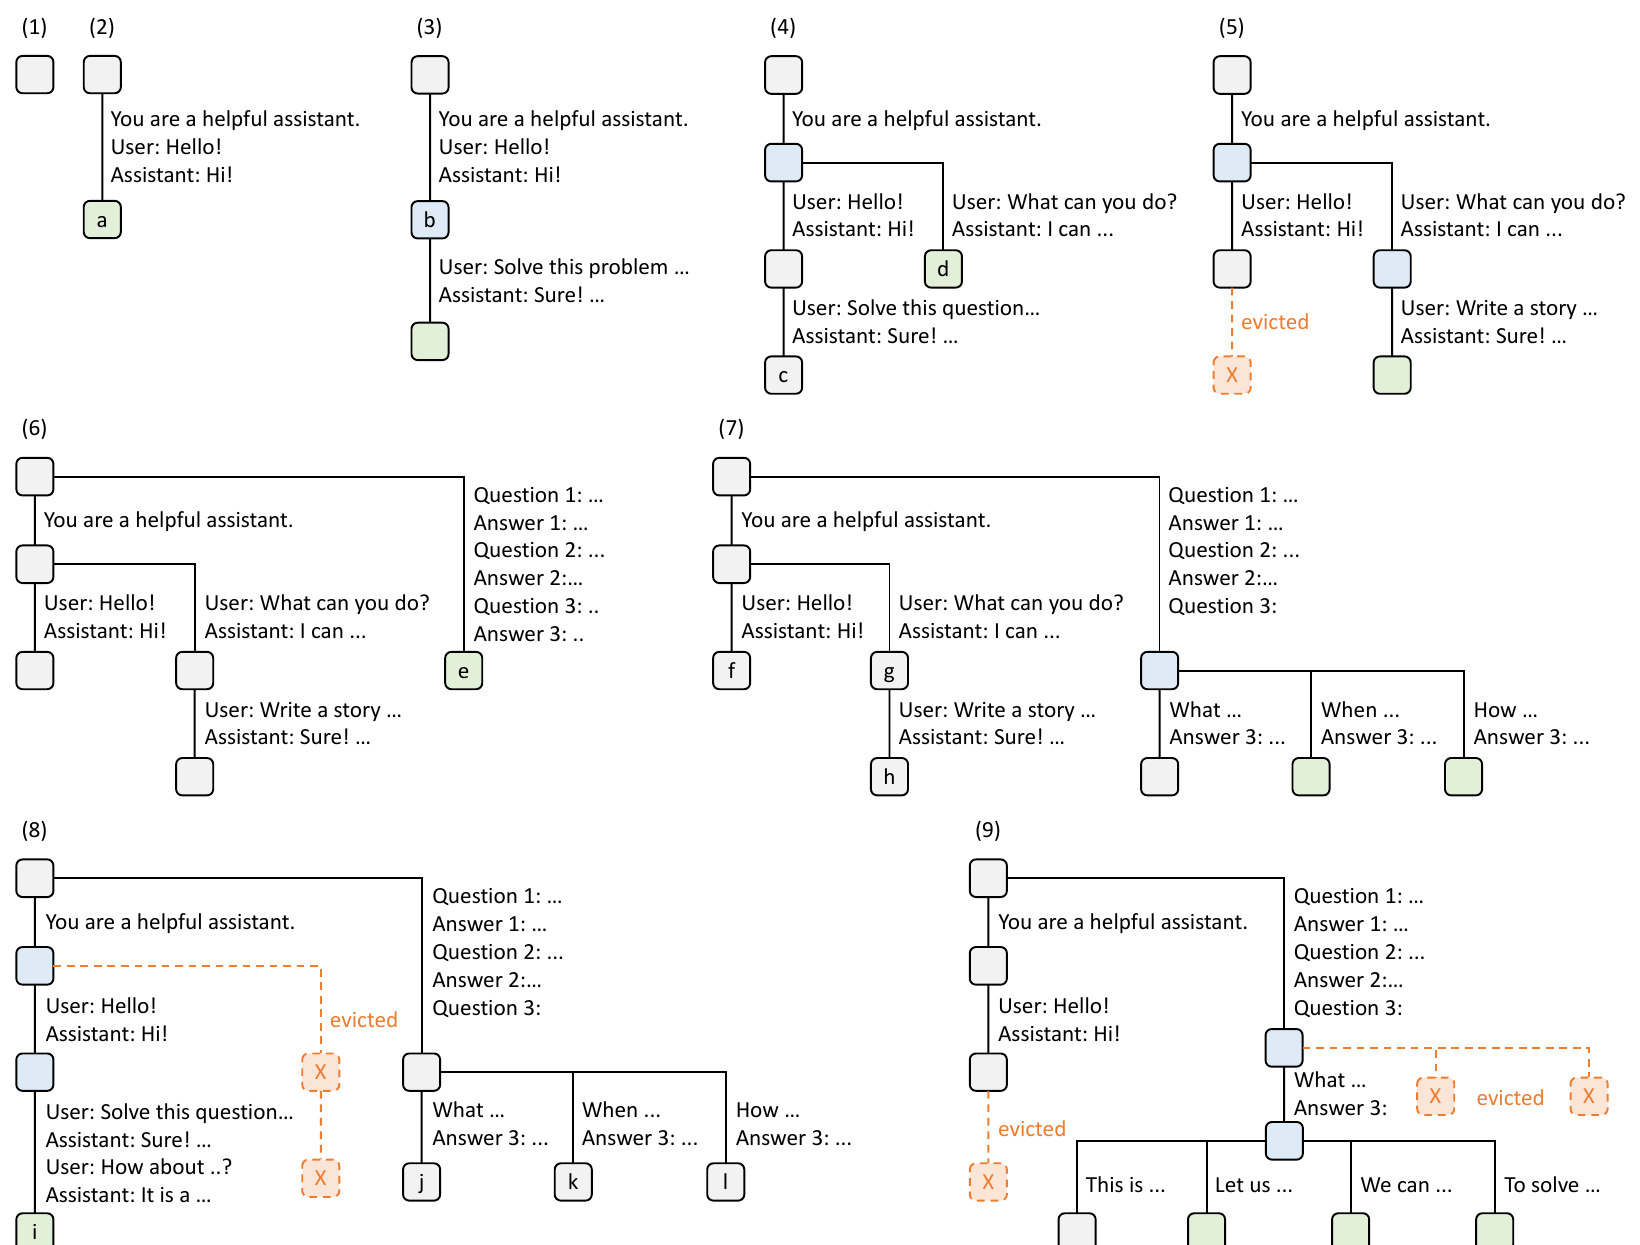
运行时执行前缀匹配和复用。树结构存储在CPU上,维护开销可忽略不计。在执行fork原语时,前端首先发送前缀作为提示,确保前缀被正确插入树中,然后发送剩余的提示。这种“前端提示”简化了运行时调度和匹配,体现了前端-运行时协同设计的优势。
缓存感知调度。我们将缓存命中率定义为已缓存提示token的数量。当等待队列中有许多请求时,它们的执行顺序会显著影响缓存命中率。例如,如果请求调度器频繁在不同且不相关的请求之间切换,可能导致缓存抖动和低命中率。我们设计了一种缓存感知调度算法以提高缓存命中率。在批处理设置中,我们按匹配前缀长度对请求排序,
并优先处理匹配前缀较长的请求,而不是使用先到先服务的调度。算法1(附录)展示了连续批处理下缓存感知调度的伪代码。该算法使用最长共享前缀优先顺序。在对延迟更敏感的设置中,我们可能仍能容忍有限的批次重排序以提高缓存复用。此外,我们证明了以下关于离线情况下最优调度的定理。2
定理3.1. 对于一批请求,当缓存大小最大请求长度时,按照请求的基数树的深度优先搜索顺序访问,可以实现最优缓存命中率。最长共享前缀优先顺序等价于深度优先搜索顺序。
证明见第A.3节(附录)。在在线情况下,DFS顺序会被打乱,但我们的调度仍近似于完整基数树增强部分上的DFS行为,如第A.3节所述。虽然贪心缓存感知调度可以实现高吞吐量,但可能导致饥饿。我们将其与其他公平调度方法[42]的集成留作未来工作。
分布式情况。RadixAttention可以扩展到多个GPU。对于张量并行,每个GPU维护分片的KV缓存。由于树操作相同,无需额外同步。多工作节点的数据并行在第A.4节(附录)中讨论。
4 使用压缩有限状态机的高效约束解码
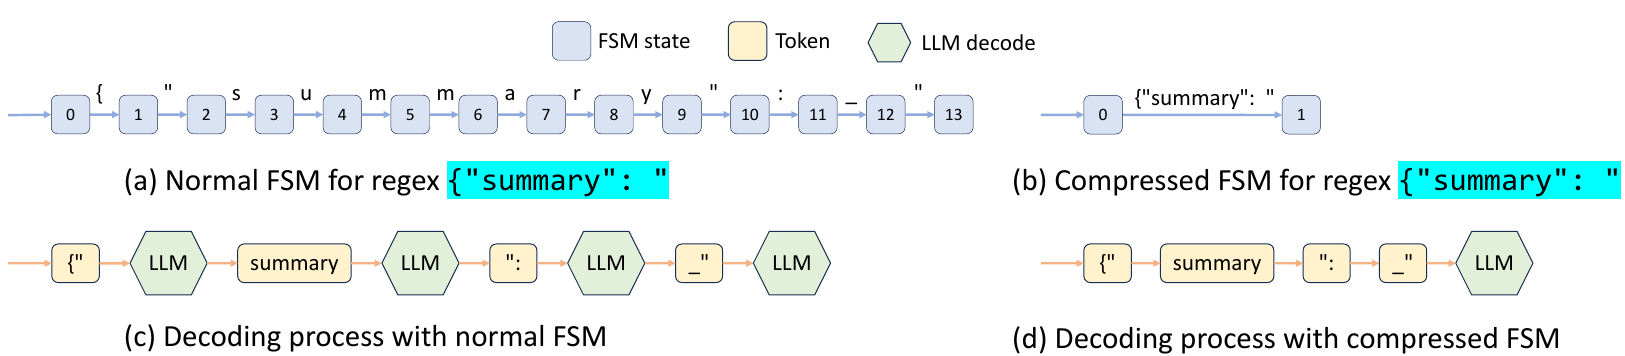
在LM程序中,用户通常希望将模型输出约束为遵循特定格式,例如JSON模式。这可以提高可控性和鲁棒性,并使输出更易于解析。SGLang提供了一个regex参数,使用正则表达式来强制执行此类约束,正则表达式对于许多实际场景具有足够的表达能力。现有系统通过将正则表达式转换为有限状态机(FSM)[54]来支持这一点。在解码过程中,它们维护当前FSM状态,从下一状态检索允许的token,并将无效token的概率设置为零,逐token解码。然而,当有机会一次解码多个token时,这种逐token方法效率低下。例如,图2中的常量序列{"summary": "在正常解码过程中跨越多个token,如图4(c)所示,需要多个解码阶段,尽管解码它时只有一个有效的下一个token。因此,整个序列可以在单步(即前向传播)中解码。然而,现有系统只能一次解码一个token,因为现有系统中FSM与模型运行器之间缺乏集成,阻碍了多token处理,导致解码缓慢。
SGLang通过创建具有压缩FSM的快速约束解码运行时来克服这一限制。该运行时分析FSM,并将FSM中相邻的单一转换边压缩为单条边,如图4(b)所示,使其能够识别何时可以一起解码多个token。在图4(d)中,压缩转换边上的多个token可以在一次前向传播中解码,这大大加速了解码过程。它也是通用的,适用于所有正则表达式。关于背景和实现的更多细节见附录B。
5 使用API推测执行的高效端点调用
前几节介绍了针对开放权重模型的优化,这些优化需要修改模型推理过程。此外,SGLang也可用于仅API访问的模型,例如OpenAI的GPT-4。然而,对于这些模型,我们只能调用黑盒API端点。
本节介绍一种针对黑盒API模型的新优化,它使用推测执行来加速执行并降低多调用SGLang程序的API成本。例如,一个程序可能要求模型以多调用模式生成角色描述:
context "name:" gen("name", stop="\n") "job:" gen("job", stop="\n")。朴素地说,两个gen原语对应两次API调用,意味着用户需要为上下文中的输入token费用支付两次。在SGLang中,我们可以在第一次调用时启用推测执行,通过忽略停止条件让其继续生成更多token。解释器保留额外的生成输出,并将其与后续原语匹配和复用。在某些情况下,通过精心的提示工程,模型可以高精度地正确匹配模板,从而节省一次API调用的延迟和输入成本。
6 评估
我们在多样化的LLM工作负载上评估SGLang的性能。随后,我们进行消融研究和案例研究,以证明特定组件的有效性。SGLang在PyTorch[37]中实现,并使用来自FlashInfer[59]和Triton[48]的自定义CUDA内核。
6.1 设置
模型。我们测试稠密Llama-2模型[49]、稀疏专家混合Mixtral模型[17]、多模态LLaVA图像[27]和视频模型[62],以及API模型OpenAI的GPT-3.5。对于开放权重模型,参数数量从70亿到700亿不等,我们使用float16精度。
硬件。我们在配备 NVIDIA A10G GPU(24GB)的 AWS EC2 G5 实例上运行大部分实验。我们在单个 A10G GPU 上运行 7B 模型,并在多个 A10G GPU 上通过张量并行 [44] 运行更大的模型。我们还在 A100G(80GB)GPU 上运行了一些额外实验。
基线。我们将 SGLang 与带有各自语言和默认运行时的高级编程系统,以及带有标准类 OpenAI Completion API 的低级推理引擎进行比较。除非另有说明,我们不会开启会改变计算结果的优化,以便所有系统计算相同的结果。基线包括:
- Guidance[13],一种用于控制 LLM 的语言。我们使用 Guidance v0.1.8 及 llama.cpp 后端。- vLLM [23],一种高吞吐量推理引擎。我们使用 vLLM v0.2.5 及其默认 API 服务器。- LMQL [4],一种查询语言。我们使用 LMQL v0.7.3 及 Hugging Face Transformers 后端。
工作负载。我们测试以下内容:5-shot MMLU [14] 和 20-shot HellaSwag [61] 基准。我们为 MMLU 解码一个 token,并使用原语 select 为 HellaSwag 选择概率最高的答案。对于 ReAct 智能体 [57] 和生成式智能体 [36],我们从原始论文中提取轨迹并重放它们。我们对 GSM-8K 问题使用思维树 [56],对提示生成使用思维骨架 [33]。我们使用采用分支-求解-合并 [40] 技术的 LLM 评判器;使用由正则表达式指定模式的 JSON 解码;进行 4 轮多轮聊天,其中每一轮的输入在 256-512 个 token 之间随机采样。多轮聊天(短)表示短输出(4-8 个 token),多轮聊天(长)表示长输出(256-512 个 token);DSPy 检索增强生成(RAG)流水线 [20] 按其官方示例进行。
指标。我们报告两个性能指标:吞吐量和延迟。对于吞吐量,我们运行足够大的程序实例批次来计算最大吞吐量,比较每秒执行的程序实例数(每秒程序数,p/s)。对于延迟,我们一次执行单个程序而不进行批处理,并报告多个实例的平均延迟。
6.2 端到端性能
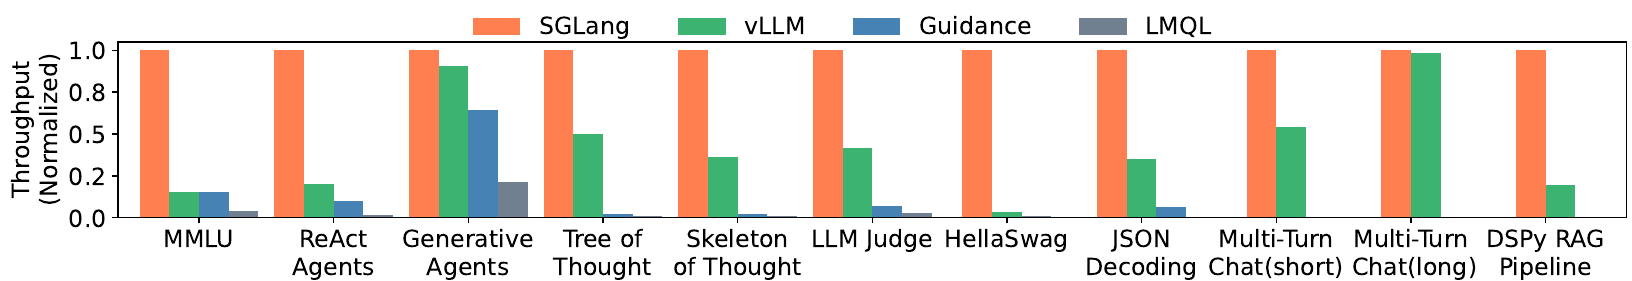
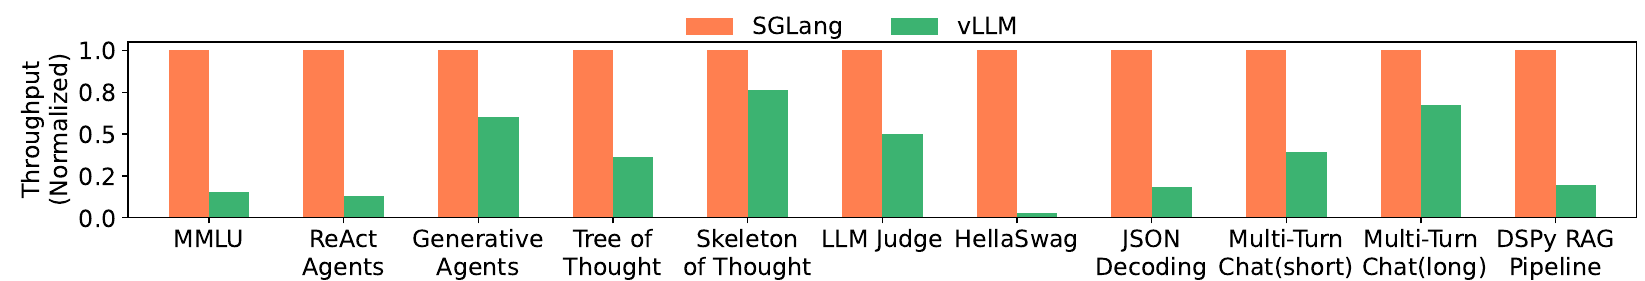
开源权重模型上的结果。延迟和吞吐量结果如图5和图6所示。SGLang将吞吐量提升最多达 \(6.4 \times\),并将延迟降低最多达 \(3.7 \times\)。这些改进
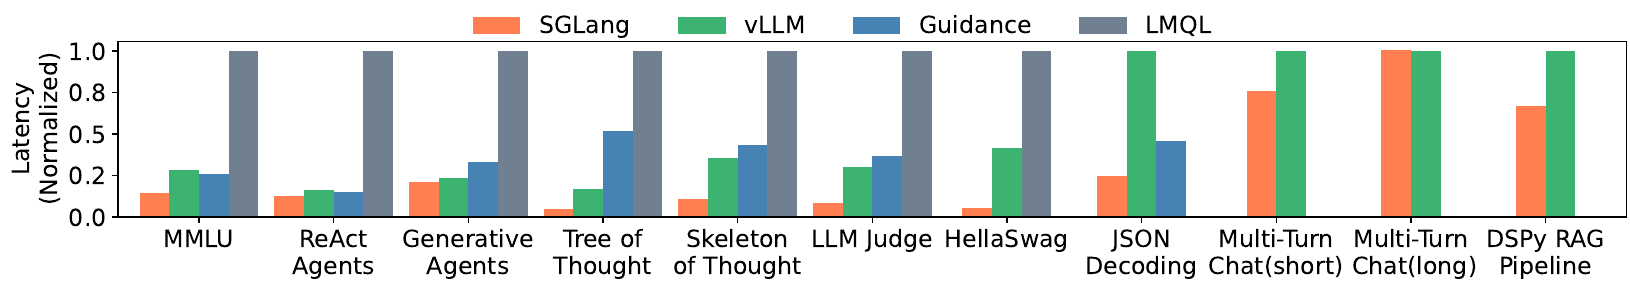
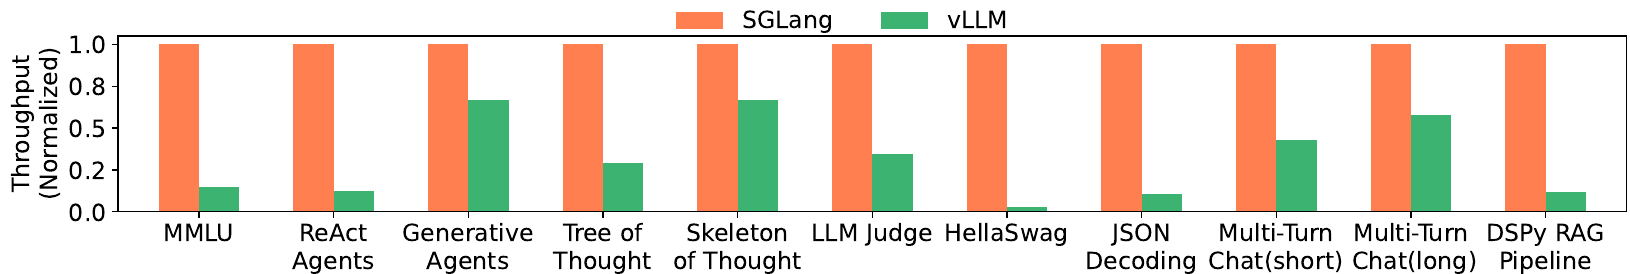
源于KV缓存复用、单个程序内并行性的利用以及更快的约束解码。接下来,我们解释每个基准测试中加速的原因。
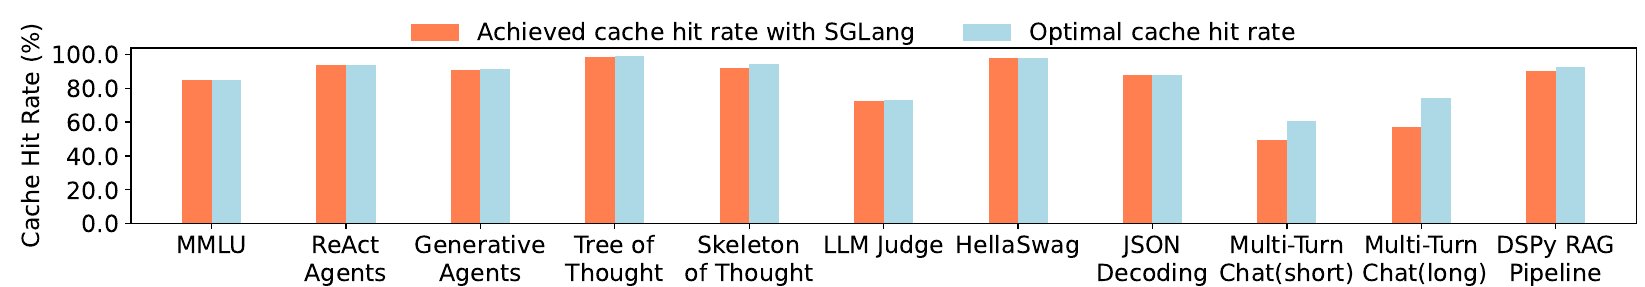
在MMLU上,SGLang可以通过RadixAttention复用5-shot示例的KV缓存。RadixAttention同时有利于吞吐量和延迟。RadixAttention通过共享KV缓存减少总内存使用量,从而允许更大的批大小以提高最大吞吐量。RadixAttention还减少了预填充的计算,从而降低了首token延迟。在HellaSwag上,SGLang复用少样本示例和多个选项的公共问题前缀的KV缓存,从而实现两级共享。对于ReAct和生成式智能体,SGLang复用智能体模板和先前调用的KV缓存。在思维树和思维骨架上,SGLang并行化单个程序内的生成调用,并尽可能复用KV缓存。在JSON解码上,SGLang通过使用压缩有限状态机一次解码多个token来加速解码。在多轮聊天中,SGLang复用聊天历史的KV缓存。对于短输出,加速更为明显,因为KV缓存复用主要有助于减少前缀时间。对于长输出,由于不同聊天会话之间共享不多且解码时间占主导,几乎没有加速。在DSPy RAG流水线中,SGLang复用公共上下文示例的KV缓存。在这些基准测试上,缓存命中率范围为\(50\%\)到\(99\%\)。图13(附录)列出了所有这些基准测试的已达到和最优缓存命中率,表明我们的缓存感知调度平均接近最优命中率的\(96\%\)。
由于性能缓慢和功能缺失,我们在最后五个基准测试中的一些中排除了LMQL和Guidance。LMQL的问题源于缓慢的token级处理和未优化的后端,而Guidance缺乏批处理和并行性支持。
使用张量并行在更大模型上的结果。我们在同一组基准测试上使用张量并行运行更大的模型Mixtral-8x7B和Llama-70B,并在图7和图12(附录)中报告结果。更大模型上的加速表现出与较小模型上观察到的相似趋势,表明我们的优化可以很好地推广到更大的模型。我们在此省略Guidance和LMQL,因为它们缺乏张量并行的高效实现。
多模态模型上的结果。SGLang通过图像和视频原语原生支持多模态模型。本文中的优化与多模态模型兼容。对于RadixAttention,我们计算输入图像的哈希值并将其用作基数树中的键,从而允许我们复用来自同一图像的图像token的KV缓存。我们在llava-bench-in-the-wild上运行LLaVA-v1.5-7B(图像),并在ActivityNet上运行LLaVA-NeXT-34B(视频)。由于这些模型未得到其他基线系统的良好支持,我们使用模型作者在Hugging Face Transformers中的原始实现作为基线。如表2所示,SGLang在这些基准测试上提供高达\(6 \times\)更高的吞吐量。在llava-bench-in-the-wild中,存在关于同一图像的多個问题,SGLang运行时在此情况下复用KV缓存。
生产部署。SGLang已部署在Chatbot Arena [8]中以服务开源权重模型。由于某些模型的流量较低,每个模型仅由一个SGLang工作进程服务。一个月后,我们观察到LLaVA-NeXT-34B [28]的RadixAttention缓存命中率为\(52.4\%\),Vicuna-33B [7]为\(74.1\%\)。缓存命中来自公共系统消息、频繁复用的示例图像和多轮聊天历史。这将Vicuna-33B的首token延迟平均降低了\(1.7 \times\)。
| 模型 | LLaVA-v1.5-7B(图像) | LLaVA-NEXT-34B(视频) |
| 作者原始实现 | 0.18 图像/秒 | 0.02 帧/秒 |
| SGLang | 1.15 图像/秒 | 0.10 帧/秒 |
API模型上的结果。我们测试了一个使用OpenAI的GPT-3.5模型从维基百科页面提取三个字段的提示。通过使用少样本提示,API推测执行的准确性很高,并且由于提取三个字段,它将输入token的成本降低了约三倍。
6.3 消融研究
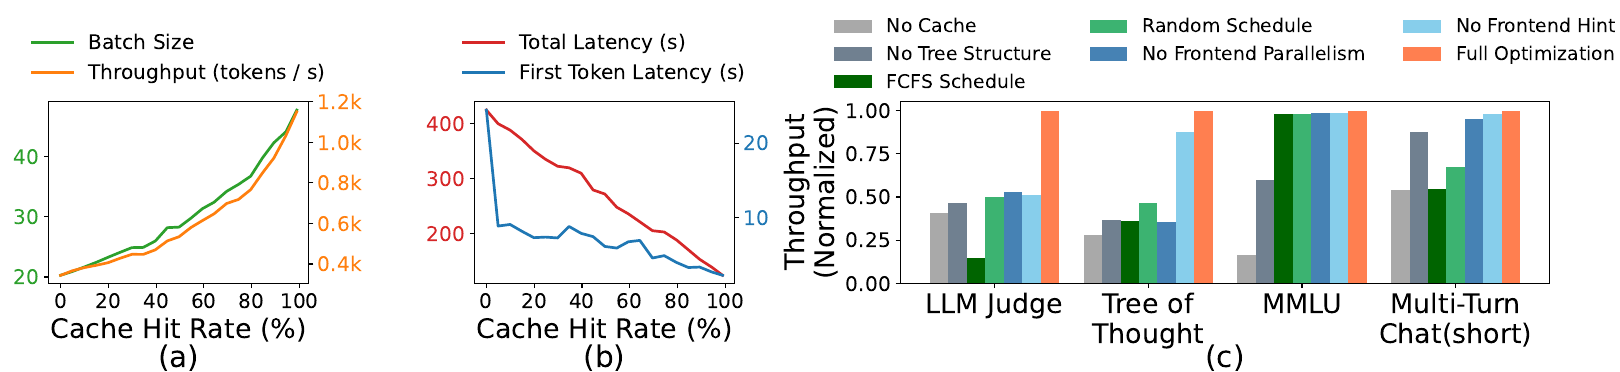
缓存命中率与延迟/吞吐量的关系。图8(a)(b)显示了在思维树基准测试上缓存命中率与性能指标(首token延迟、总延迟、批大小和吞吐量)之间的关系。该图通过在运行时部分禁用匹配的token获得。它表明更高的缓存命中率导致更大的批大小、更高的吞吐量和更低的延迟。
RadixAttention的有效性。我们在几个代表性基准测试上测试RadixAttention及其组件的有效性。如图8(c)所示,“No Cache”表示不使用任何缓存,“No Tree-Structure”表示使用简单的基于表的缓存而不是树结构缓存,“FCFS Schedule”表示使用先到先服务策略而不是我们的缓存感知调度,“Random Schedule”表示使用随机顺序调度请求,“No Frontend Parallelism”表示禁用解释器中的并行性,“No Frontend Hint”表示禁用从解释器发送分叉提示,“Full optimizations”表示我们开启所有优化。实验结果表明,这些组件中的每一个都是实现最佳性能所必需的。禁用前端的并行性和提示也会导致次优的运行时性能,突出了协同设计前端语言和运行时的重要性。
RadixAttention的开销。我们在没有任何KV缓存复用机会的基准测试上测试RadixAttention的开销。该基准测试测量ShareGPT数据集上的吞吐量。运行100个请求需要74.3秒;然而,用于管理RadixAttention数据结构的时间仅为0.2秒,这是小于0.3%的可忽略开销。这是因为树操作的复杂度是线性的且很小。因此,我们可以默认开启RadixAttention。
压缩有限状态机的有效性。我们在 JSON 解码基准上测试了压缩有限状态机及其各组件的有效性。实验结果表明,压缩有限状态机将吞吐量提高了 ,因为它可以一次解码多个 token。此外,我们需要对状态机进行预处理,并在一批请求中复用它。否则,为每个请求重新进行预处理会使吞吐量降低 。
7 相关工作
各类工作已经探索了 KV 缓存的重用,其中许多工作与我们的工作同时进行。独特的是,我们的 RadixAttention 首次提出将 KV 缓存视为基于树的 LRU 缓存。它是首个支持多级共享、缓存感知调度、前端-运行时协同调度以及分布式场景的解决方案。vLLM [23] 和 ChunkedAttention [58] 探索了一些简单的重用场景(例如系统提示共享),但并未涵盖多级树结构共享或 LRU 缓存。PromptCache [12] 提出了超越前缀的 KV 缓存模块化重用,但可能影响准确性,最高导致 的下降。HydraGen [18]、FlashInfer [59] 和 ChunkedAttention [58] 专注于 CUDA 内核优化,不包含 LRU 缓存的概念。API Serve [1] 和 LLM-SQL [29] 研究了特定应用中的 KV 缓存重用,例如与外部 API 调用和关系数据库交错使用,但它们没有我们的基数树或缓存感知调度。
存在若干 LLM 编程和智能体框架,例如 Guidance [13]、LMQL [4]、DSPy [20]、LangChain [24]、AutoGen [55] 和 LLM Compiler [21]。Guidance 和 LMQL 与 SGLang 最为相似,我们在第 2 节中对它们进行了比较。我们的创新在于用于加速所提出编程模型的新颖运行时优化。SGLang 与其他框架兼容,并可以加速它们(例如我们评估中的 DSPy 示例)。此外,SGLang 与许多其他常见的推理优化兼容 [60, 39, 3, 23, 59, 10, 26, 15, 19, 32, 31, 11]。
8 未来方向与结论
未来方向。尽管 SGLang 取得了进展,但仍存在若干局限性,揭示了未来研究的有前景方向。这些包括扩展 SGLang 以支持额外的输出模态、调整 RadixAttention 以在内存层次结构的多个层级(例如 DRAM、磁盘)上运行 [43]、在 RadixAttention 中启用模糊语义匹配、在 SGLang 之上提供更高层次的原语、修复缓存感知调度中的饥饿问题 [42],以及增强 SGLang 编译器以执行高级静态优化,例如调度和内存规划。
结论。我们介绍了 SGLang,一个用于高效编程和执行结构化语言模型程序的框架。SGLang 通过 RadixAttention、压缩有限状态机和语言解释器等新颖优化,显著提高了复杂 LM 程序的吞吐量和延迟。它是开发高级提示技术和智能体工作流的宝贵工具。源代码已公开可用。
致谢
本项目得到斯坦福自动推理中心以及 Astronomer、Google、IBM、Intel、Lacework、Microsoft、Mohamed Bin Zayed University of Artificial Intelligence、Nexla、Samsung SDS、Uber 和 VMware 的资助。Lianmin Zheng 获得 Meta 博士奖学金支持。我们感谢 Yuanhan Zhang 和 Bo Li 对 LLaVA-NeXT(视频)的支持。
参考文献
[1] Reyna Abhyankar, Zijian He, Vikranth Srivatsa, Hao Zhang, and Yiying Zhang. Apiserve: Efficient api support for large-language model inferencing. arXiv preprint arXiv:2402.01869, 2024. [2] Jean-Baptiste Alayrac, Jeff Donahue, Pauline Luc, Antoine Miech, Iain Barr, Yana Hasson, Karel Lenc, Arthur Mensch, Katherine Millican, Malcolm Reynolds, et al. Flamingo: a visual language model for few-shot learning. Advances in Neural Information Processing Systems, 35:23716-23736, 2022. [3] Reza Yazdani Aminabadi, Samyam Rajbhandari, Ammar Ahmad Awan, Cheng Li, Du Li, Elton Zheng, Olatunji Ruwase, Shaden Smith, Minjia Zhang, Jeff Rasley, et al. Deepspeed-inference: enabling efficient inference of transformer models at unprecedented scale. In SC22: International Conference for High Performance Computing, Networking, Storage and Analysis, pages 1-15. IEEE, 2022. [4] Luca Beurer-Kellner, Marc Fischer, and Martin Vechev. Prompting is programming: A query language for large language models. Proceedings of the ACM on Programming Languages, 7(PLDI):1946-1969, 2023. [5] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in neural information processing systems, 33:1877-1901, 2020. [6] Sébastien Bubeck, Varun Chandrasekaran, Ronen Eldan, Johannes Gehrke, Eric Horvitz, Ece Kamar, Peter Lee, Yin Tat Lee, Yuanzhi Li, Scott Lundberg, et al. Sparks of artificial general intelligence: Early experiments with gpt-4. arXiv preprint arXiv:2303.12712, 2023. [7] Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023.
[8] Wei-Lin Chiang, Lianmin Zheng, Ying Sheng, Anastasios Nikolas Angelopoulos, Tianle Li, Dacheng Li, Hao Zhang, Banghua Zhu, Michael Jordan, Joseph E Gonzalez, et al. Chatbot arena: An open platform for evaluating llms by human preference. arXiv preprint arXiv:2403.04132, 2024.
[9] Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. arXiv preprint arXiv:2204.02311, 2022.
[10] Tri Dao, Dan Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. Flashattention: Fast and memory-efficient exact attention with io-awareness. Advances in Neural Information Processing Systems, 35:16344-16359, 2022.
[11] Suyu Ge, Yunan Zhang, Liyuan Liu, Minjia Zhang, Jiawei Han, and Jianfeng Gao. Model tells you what to discard: Adaptive kv cache compression for llms. In The Twelfth International Conference on Learning Representations, 2023.
[12] In Gim, Guojun Chen, Seung-seob Lee, Nikhil Sarda, Anurag Khandelwal, and Lin Zhong. Prompt cache: Modular attention reuse for low-latency inference. arXiv preprint arXiv:2311.04934, 2023.
[13] Guidance AI. A guidance language for controlling large language models. https://github.com/guidance-ai/guidance. Accessed: 2023-11.
[14] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[15] Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, Michael W Mahoney, Yakun Sophia Shao, Kurt Keutzer, and Amir Gholami. Kvquant: Towards 10 million context length llm inference with kv cache quantization. arXiv preprint arXiv:2401.18079, 2024.
[16] Hugging Face. Text generation inference. https://github.com/huggingface/text-generation-inference. Accessed: 2023-11.
[17] Albert Q Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch, Blanche Savary, Chris Bamford, Devendra Singh Chaplot, Diego de las Casas, Emma Bou Hanna, Florian Bressand, et al. Mixtral of experts. arXiv preprint arXiv:2401.04088, 2024.
[18] Jordan Juravsky, Bradley Brown, Ryan Ehrlich, Daniel Y Fu, Christopher Ré, and Azalia Mirhoseini. Hydragen: High-throughput llm inference with shared prefixes. arXiv preprint arXiv:2402.05099, 2024.
[19] Hao Kang, Qingru Zhang, Souvik Kundu, Geonhwa Jeong, Zaoxing Liu, Tushar Krishna, and Tuo Zhao. Gear: An efficient kv cache compression recipe for near-lossless generative inference of llm. arXiv preprint arXiv:2403.05527, 2024.
[20] Omar Khattab, Arnav Singhvi, Paridhi Maheshwari, Zhiyuan Zhang, Keshav Santhanam, Sri Vardhamanan, Saiful Haq, Ashutosh Sharma, Thomas T. Joshi, Hanna Moazam, Heather Miller, Matei Zaharia, and Christopher Potts. Dspy:将声明式语言模型调用编译为自我改进的流水线。arXiv预印本 arXiv:2310.03714, 2023。
[21] Sehoon Moon, Suhong Moon, Ryan Tabrizi, Nicholas Lee, Michael W Mahoney, Kurt Keutzer, and Amir Gholami. 用于并行函数调用的llm编译器。arXiv预印本 arXiv:2312.04511, 2023。
[22] Michael Kuchnik, Virginia Smith, and George Amvrosiadis. 使用relm验证大型语言模型。Proceedings of Machine Learning and Systems, 5, 2023。
[23] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 使用pagedattention为大型语言模型服务提供高效内存管理。In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611-626, 2023。
[24] LangChain AI. Langchain. https://github.com/langchain-ai/langchain. 访问时间:2023-11。
[25] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. 使用alphacode进行竞赛级代码生成。Science, 378(6624):1092-1097, 2022。
[26] Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Xingyu Dang, and Song Han. Awq: Activation-aware weight quantization for llm compression and acceleration. arXiv preprint arXiv:2306.00978, 2023.
[27] Haotian Liu, Chunyuan Li, Yuheng Li, and Yong Jae Lee. Improved baselines with visual instruction tuning. arXiv preprint arXiv:2310.03744, 2023.
[28] Haotian Liu, Chunyuan Li, Yuheng Li, Bo Li, Yuanhan Zhang, Sheng Shen, and Yong Jae Lee. Llava-next: Improved reasoning, ocr, and world knowledge, January 2024.
[29] Shu Liu, Asim Biswal, Audrey Cheng, Xiangxi Mo, Shiyi Cao, Joseph E Gonzalez, Ion Stoica, and Matei Zaharia. Optimizing llm queries in relational workloads. arXiv preprint arXiv:2403.05821, 2024.
[30] Xiaoxia Liu, Jingyi Wang, Jun Sun, Xiaohan Yuan, Guoliang Dong, Peng Di, Wenhai Wang, and Dongxia Wang. Prompting frameworks for large language models: A survey. arXiv preprint arXiv:2311.12785, 2023.
[31] Zichang Liu, Aditya Desai, Fangshuo Liao, Weitao Wang, Victor Xie, Zhaozhuo Xu, Anastasios Kyrillidis, and Anshumali Shrivastava. Scissorhands: Exploiting the persistence of importance hypothesis for llm kv cache compression at test time. Advances in Neural Information Processing Systems, 36, 2024.
[32] Zirui Liu, Jiayi Yuan, Hongye Jin, Shaochen Zhong, Zhaozhuo Xu, Vladimir Braverman, Beidi Chen, and Xia Hu. Kivi: A tuning-free asymmetric 2bit quantization for kv cache. arXiv preprint arXiv:2402.02750, 2024.
[33] Xuefei Ning, Zinan Lin, Zixuan Zhou, Zifu Wang, Huazhong Yang, and Yu Wang. Skeleton-of-thought: Prompting LLMs for efficient parallel generation. In The Twelfth International Conference on Learning Representations, 2024.
[34] NVIDIA. Tensorrt-llm. https://github.com/NVIDIA/TensorRT-LLM. Accessed: 2023-11.
[35] OpenAI. Gpt-4 technical report, 2023.
[36] Joon Sung Park, Joseph C. O'Brien, Carrie J. Cai, Meredith Ringel Morris, Percy Liang, and Michael S. Bernstein. Generative agents: Interactive simulacra of human behavior. In In the 36th Annual ACM Symposium on User Interface Software and Technology (UIST '23), UIST '23, New York, NY, USA, 2023. Association for Computing Machinery.
[37] Adam Paszke, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, Zeming Lin, Natalia Gimelshein, Luca Antiga, et al. Pytorch: An imperative style, high-performance deep learning library. Advances in neural information processing systems, 32, 2019.
[38] Shishir G. Patil, Tianjun Zhang, Xin Wang, and Joseph E. Gonzalez. Gorilla: Large language model connected with massive apis. arXiv preprint arXiv:2305.15334, 2023.
[39] Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. Efficiently scaling transformer inference. Proceedings of Machine Learning and Systems, 5, 2023.
[40] Swarnadeep Saha, Omer Levy, Asli Celikyilmaz, Mohit Bansal, Jason Weston, and Xian Li. Branch-solve-merge improves large language model evaluation and generation. arXiv preprint arXiv:2310.15123, 2023.
[41] Timo Schick, Jane Dwivedi-Yu, Roberto Dessi, Roberta Raileanu, Maria Lomeli, Luke Zettlemoyer, Nicola Cancedda, and Thomas Scialom. Toolformer: Language models can teach themselves to use tools. arXiv preprint arXiv:2302.04761, 2023.
[42] Ying Sheng, Shiyi Cao, Dacheng Li, Banghua Zhu, Zhuohan Li, Danyang Zhuo, Joseph E Gonzalex, and Ion Stoica. Fairness in serving large language models. arXiv preprint arXiv:2401.00588, 2023.
[43] Ying Sheng, Lianmin Zheng, Binhang Yuan, Zhuohan Li, Max Ryabinin, Beidi Chen, Percy Liang, Christopher Ré, Ion Stoica, and Ce Zhang. Flexgen: high-throughput generative inference of large language models with a single gpu. In International Conference on Machine Learning, pages 31094-31116. PMLR, 2023.
[44] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. Megatron-lm: Training multi-billion parameter language models using model parallelism. arXiv preprint arXiv:1909.08053, 2019.
[45] Vikranth Srivatsa, Zijian He, Reyna Abhyankar, Dongming Li, and Yiying Zhang. Preble: Efficient distributed prompt scheduling for llm serving. 2024.
[46] Theodore Sumers, Shunyu Yao, Karthik Narasimhan, and Thomas Griffiths. Cognitive architectures for language agents. Transactions on Machine Learning Research, 2023.
[47] Gemini Team, Rohan Anil, Sebastian Borgeaud, Yonghui Wu, Jean-Baptiste Alayrac, Jiahui Yu, Radu Soricut, Johan Schalkwyk, Andrew M Dai, Anja Hauth, et al. Gemini: a family of highly capable multimodal models. arXiv preprint arXiv:2312.11805, 2023.
[48] Philippe Tillet, Hsiang-Tsung Kung, and David Cox. Triton: an intermediate language and compiler for tiled neural network computations. In Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, pages 10-19, 2019.
[49] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[50] Vivien Tran-Thien. Fast, high-fidelity llm decoding with regex constraints, 2024.
[51] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention is all you need. Advances in neural information processing systems, 30, 2017.
[52] Guanzhi Wang, Yuqi Xie, Yunfan Jiang, Ajay Mandlekar, Chaowei Xiao, Yuke Zhu, Linxi Fan, and Anima Anandkumar. Voyager: An open-ended embodied agent with large language models. arXiv preprint arXiv: arXiv:2305.16291, 2023.
[53] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V Le, Ed H Chi, Sharan Narang, Aakanksha Chowdhery, and Denny Zhou. Self-consistency improves chain of thought reasoning in language models. In The Eleventh International Conference on Learning Representations, 2022.
[54] Brandon T Willard and Rémi Louf. Efficient guided generation for large language models. arXiv e-prints, pages arXiv-2307, 2023.
[55] Qingyun Wu, Gagan Bansal, Jieyu Zhang, Yiran Wu, Shaokun Zhang, Erkang Zhu, Beibin Li, Li Jiang, Xiaoyun Zhang, and Chi Wang. Autogen: Enabling next-gen llm applications via multi-agent conversation framework. arXiv preprint arXiv:2308.08155, 2023.
[56] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L Griffiths, Yuan Cao, and Karthik Narasimhan. Tree of thoughts: Deliberate problem solving with large language models. arXiv preprint arXiv:2305.10601, 2023.
[57] Shunyu Yao、Jeffrey Zhao、Dian Yu、Nan Du、Izhak Shafran、Karthik R Narasimhan 和 Yuan Cao。React:在语言模型中协同推理与行动。载于第十一届国际学习表征会议,2022年。
[58] Lu Ye、Ze Tao、Yong Huang 和 Yang Li。Chunkattention:具有前缀感知 KV 缓存和两阶段分区的高效自注意力。arXiv 预印本 arXiv:2402.15220,2024年。
[59] Zihao Ye、Lequn Chen、Ruihang Lai、Yilong Zhao、Size Zheng、Junru Shao、Bohan Hou、Hongyi Jin、Yifei Zuo、Liangsheng Yin、Tianqi Chen 和 Luis Ceze。使用 flashinfer 加速 LLM 服务中的自注意力,2024年2月。
[60] Gyeong-In Yu、Joo Seong Jeong、Geon-Woo Kim、Soojeong Kim 和 Byung-Gon Chun。Orca:面向{基于 Transformer 的}生成模型的分布式服务系统。载于第16届 USENIX 操作系统设计与实现研讨会(OSDI 22),第521-538页,2022年。
[61] Rowan Zellers、Ari Holtzman、Yonatan Bisk、Ali Farhadi 和 Yejin Choi。Hellaswag:机器真的能完成你的句子吗?载于第57届计算语言学协会年会论文集,第4791-4800页,2019年。
[62] Yuanhan Zhang、Bo Li、haotian Liu、Yong jae Lee、Liangke Gui、Di Fu、Jiashi Feng、Ziwei Liu 和 Chunyuan Li。Llava-next:一个强大的零样本视频理解模型,2024年4月。
A 关于RadixAttention的补充细节
A.1 KV缓存背景
当今使用的大多数LLM,如GPT-3 [5]、PaLM [9]和LLaMA [49],都基于自回归Transformer架构 [51]。这些模型根据序列中前面的token来预测下一个token的概率。在推理过程中,模型首先通过一次前向传播处理输入token序列(此过程称为“预填充”)。然后它依次解码输出token,每个token都依赖于先前的token(此过程称为“解码”)。我们将接收输入token序列并生成输出token序列的过程称为一次生成调用。在整个过程中,每个token都会生成一些中间张量,这些张量用于解码后续token。这些中间张量被称为“KV缓存”,其名称来源于自注意力机制中的键值对。在讨论本文的优化时,一个重要的观察是:KV缓存的计算仅依赖于所有先前的token,因此具有相同前缀的不同序列可以复用前缀token的KV缓存,从而避免冗余计算。
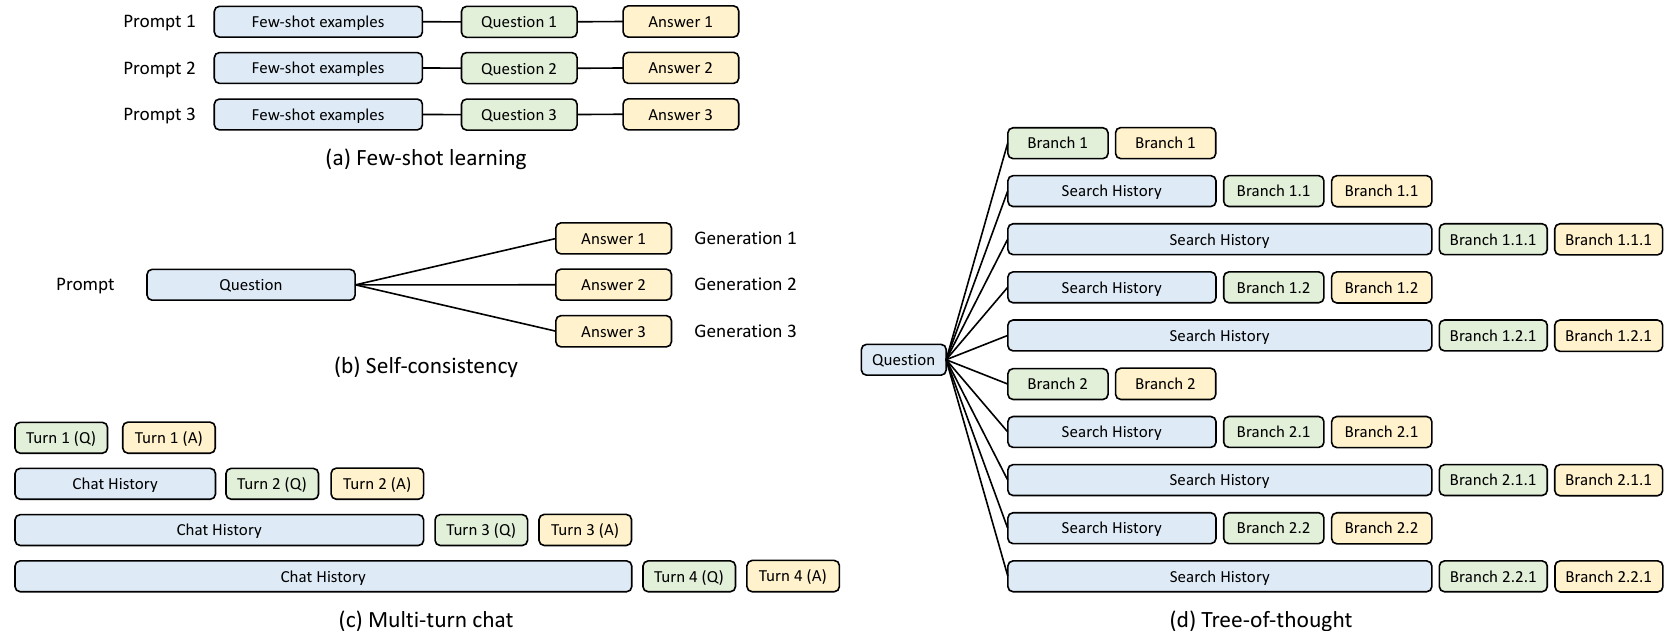
在LLM程序中,经常会将多个文本片段和生成调用追加到单个提示中。跨多个链式调用缓存先前token已计算的KV缓存可以减少冗余计算。然而,这种优化既不是免费的,也并非微不足道,因为它需要额外的存储和更复杂的内存管理。此外,在LLM程序中,从单个提示生成多个输出或从当前状态分叉出新提示也很常见 [25]。vLLM [23]中已经研究了基本的前缀共享。也可以采用更高级的共享模式,如不规则的树结构共享。图9展示了跨多次调用的四种典型KV缓存共享模式;现有系统均无法自动处理所有这些模式。相反,我们在第3节中提出的RadixAttention可以在运行时自动处理所有这些模式。
A.2 缓存感知调度的伪代码
算法1展示了带有连续批处理的RadixAttention缓存感知调度的伪代码。
A.3 定理3.1的证明
定理3.1. 对于一批请求,当缓存大小最大请求长度时,按照深度优先搜索顺序访问请求的基数树,我们可以实现最优的缓存命中率。最长共享前缀优先顺序等价于深度优先搜索顺序。
证明. 首先,我们证明深度优先搜索(DFS)顺序可实现最优的缓存命中率。令表示批次中的请求集合,表示由构建的基数树。对于的每条边,与关联的KV缓存至少需要计算一次。令表示与关联的KV缓存的大小。令表示的KV缓存的计算复杂度。
算法1 带有连续批处理的RadixAttention缓存感知调度。输入:基数树、内存池、当前运行批次、等待队列。输出:已完成的请求和更新后的系统状态。// 从等待队列获取所有请求requests .get_all_requests()// 为所有等待请求搜索前缀匹配for req requests doreq.prefix_node, req.prefix_len .match_prefix(req.input_tokens)end for// 根据匹配的前缀长度对请求排序requests.sort()// 为下一批次选择请求available_size .evitable_size() + .available_size()current_size new_batch for req requests doif req.size() + current_size available_size thennew_batch.append(req)delta .increase_ref_counter(req.prefix_node)available_size available_size + deltaend ifend forQ.remove_requests(new_batch)// 将请求插入当前运行批次B.merge(new_batch)// 分配新内存并在必要时执行驱逐needed_size .needed_size()success,buffer .alloc(needed_size)if not success thenT.evict(needed_size)success,buffer .alloc(needed_size)end ifB.run(buffer)// 处理已完成的请求finished_requests .drop_finished_requests()for req finished_requests doT.decrease_ref_counter(req.prefix_node)T.insert(req)end forreturn finished_requests我们得到下界
考虑我们按DFS顺序访问基数树。对于的每条边,第一次计算与关联的KV缓存时,我们将随后计算的整个子树。在计算的子树期间,边将被持续命中,因此不会发生额外的计算。在完成以为根的子树的计算后,边将不再被访问。请注意,当缓存大小最大请求长度(即基数树中最长路径)时,由于子树中包含的公共前缀将被持续命中,边在其子树计算期间不会被驱逐。因此,与每条边关联的KV缓存将仅被计算一次。于是,我们达到下界
缓存命中率,定义为
等于 ,达到其上限,从而实现最优性。
接下来,我们通过归纳法证明最长共享前缀优先顺序等价于DFS顺序。
- (基础情形)开始时,由于没有任何缓存,将处理一个对应于 中节点 的随机请求。所有对应于从根到 路径上节点 的请求都不需要重新计算。对应于节点 的请求的计算复杂度与一个有效的DFS一致。从根到 的路径被缓存。
- (归纳步骤)假设我们刚刚访问了 中的节点 ,且已访问的节点符合DFS顺序。令 表示从根到 的路径。那么每个尚未访问的节点与已访问节点的最低公共祖先都在 上。由于 上的节点已被缓存,一个尚未访问且最低公共祖先在 上的节点 将具有最长的共享前缀。最长共享前缀优先顺序将选择 ,这是一个有效的DFS顺序。从根到 的路径将被缓存,因为它是最新的。
在在线情况下,DFS顺序会被打乱,但最长共享前缀调度仍然近似于隐式基数树增强部分上的DFS行为。我们通过考虑添加新一批请求的步骤来展示这一点。
令 表示迄今为止已访问的基数树部分, 表示添加新一批请求后的完整新基数树。令 表示 中已缓存的节点集合。令 longest 表示 中从根出发路径最长且其在 中的子树尚未被完全访问的节点。
最长共享前缀调度随后将以DFS顺序处理 中以 longest 为根的子树。在此过程中可能发生驱逐, 中剩余的缓存节点变为 。随后将对 中以 longest 为根的子树执行DFS。
类似地,我们将得到 ,直到 中仅包含一个在 中的叶节点,且其在 中的子树尚未被完全访问。此时,我们已到达一个有效的DFS状态。 的剩余部分将按照定理3.1证明中所述的DFS顺序进行访问。
A.4 数据并行分布式RadixAttention
为了使RadixAttention适应具有多个副本工作节点(即数据并行)的分布式设置,我们开发了一种机制,其中每个工作节点维护自己的子树,而路由器则管理一棵元树。该元树充当一个trie,跟踪所有子树及其关联设备。当新一批请求到达路由器时,在元树上执行前缀匹配。我们根据每个请求的亲和性——以与特定工作节点及同组其他请求的共享前缀长度来衡量——实现各种策略,以做出高效的调度决策,最小化冗余计算。每次处理新请求时,路由器和各个工作节点都会独立更新各自的树。如果工作节点发生驱逐,它会将该驱逐提交到一个队列,路由器随后在低活跃度期间处理该队列以更新元树。我们使用四个工作节点和MMLU数据集对这种分布式配置进行了基准测试,观察到它实现了线性扩展和最优的缓存命中率,且这种弱一致性分布式缓存设计的开销极小。在最大化数据局部性和并行处理效率之间存在权衡。探索先进的调度策略以优化这一权衡被指定为未来研究的方向。此外,Preble [45] 的并行工作基于SGLang的早期版本研究了数据并行调度。
B 压缩有限状态机的补充细节
本节讨论用于加速约束解码的压缩有限状态机的背景和实现细节。我们的目标是让LLM遵循正则表达式(regex),这提供了更强的表达能力,可用于表示JSON schema等常见格式。为实现这一目标,我们将regex转换为有限状态机(FSM)以在解码过程中引导生成过程 [54]。FSM本质上是一个包含节点(状态)和边(带有字符串/字符的转移)的图。从初始状态开始,每次转移将边上的字符串追加以移动到下一个状态,并使用一组最终状态来结束过程。该机制引导LLM的解码,根据FSM当前状态的转移过滤掉无效的token,如图10所示。解码可能涉及FSM中的多次转移,直到到达最终状态。
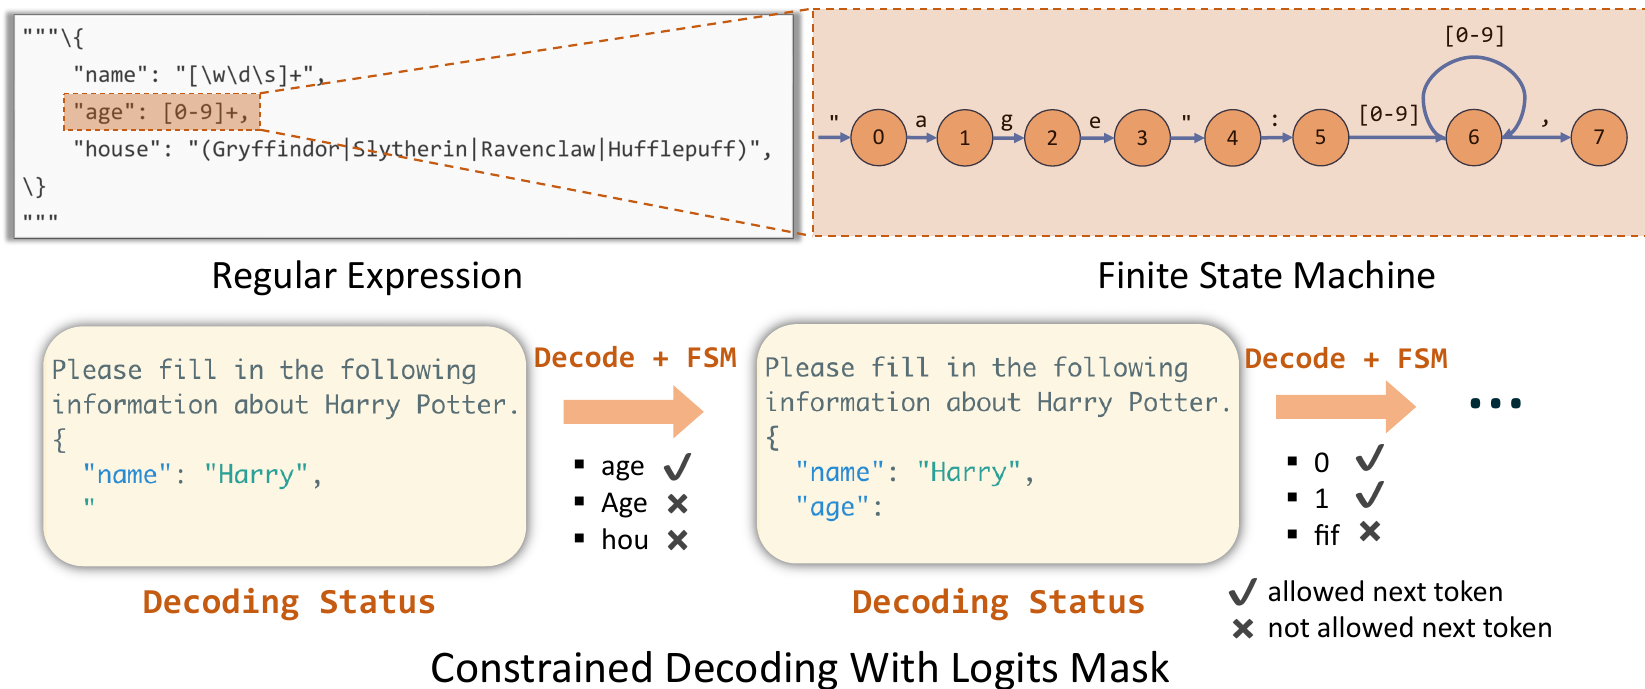
约束解码的挑战源于以下事实:约束通常以自然语言格式表达,即regex由字符/字符串描述,而LLM被设计为将这些解释和处理为token。这造成了一个复杂的场景,因为字符串和token之间的映射错综复杂且缺乏一一对应关系 [22]。
本节源自早期的一篇博客文章4。鼓励读者也阅读该博客文章以获取更多背景信息和更易于理解的内容。
B.1 压缩有限状态机的实现细节
为了简化压缩FSM的构建,我们基于字符/字符串而非token来构建原始FSM。我们形式化地定义单一边转移边和压缩边的概念如下:
- 单一边转移边:一条边是单一边转移边,当且仅当1)其源节点只有一个后继节点,且2)其上只有一个可接受的字符/字符串。- 压缩边:一条边由若干连续相邻的边压缩而成,当且仅当是单一边转移边。压缩边的文本是的文本的拼接。
从基于字符的FSM出发,我们递归地将单一边转移边合并到其前驱边中,直到无法进一步压缩为止,从而得到压缩FSM。这种方法加速了解码过程,正如SGLang使用压缩FSM时的运行时效率所示(见图11)。
B.2 通过重新分词处理分词伪影
当生成一个新token时,我们获取该token的字符串,并搜索当前状态的所有出边,找到以刚刚解码的字符串开头的那条边,然后向前移动。然而,当转移边是一条压缩良好的边且包含非常长的字符串时,我们可能也会预判接下来几轮的解码字符串。这正是加速发生的地方,我们称这一过程为Jump Forward。然而,我们仍然需要将字符串转换为token以供后续解码阶段使用,而由于LLM特定的预训练和分词方法,这并不简单;
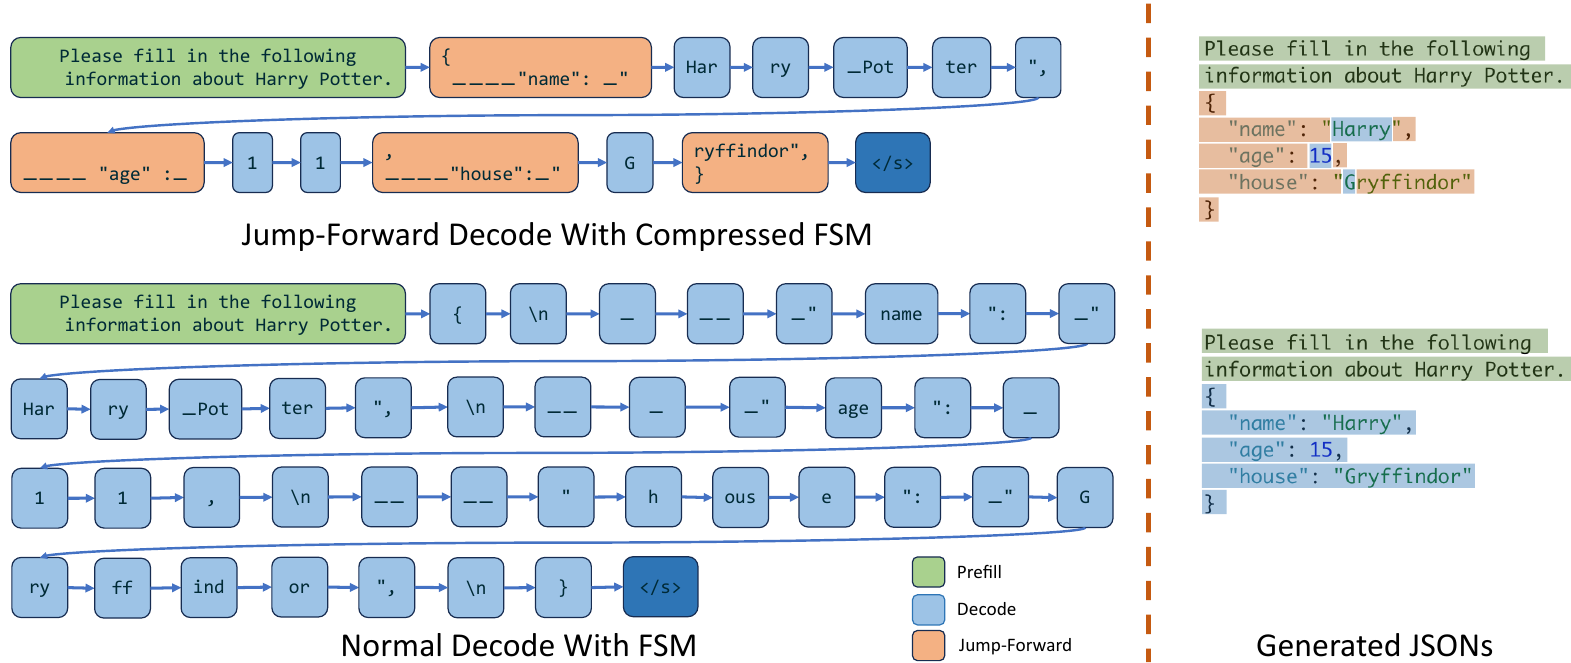
直接划分可能会改变原本的意图[50]。例如,图2正则表达式中的压缩文本是{"summary": ",根据分词器,它只能被分词为{"summary,":和",而不能被随机划分为诸如{"summa、ry和".: 为解决这一问题,我们使用原始分词器对所有先前的文本以及压缩边的文本进行重新分词,确保与LLM的原始输入格式对齐。而这只会带来少量的重新分词开销。
B.3 未来扩展:应对失真的概率
字符串与token之间的差距所带来的挑战也引发了概率分布偏斜的问题[50]。例如,在图2中,正则表达式"[ABCD] [+- ]?"表示从A+到D-的成绩等级,但如果替换为更宽泛的术语,如Excellent | Above Average | Fair | Below Average,运行时可能会由于术语Above Average位于一条压缩转移边上,而将A错误地映射为Above Average,从而错误地表示成绩等级的层次。这是因为LLM无法识别具体的选择范围,导致不恰当的token序列。为每个选择计算准确的概率需要对该选择对应的所有token序列的概率求和,这使解码复杂化并增加了开销。一种变通方法是将选项或正则表达式直接包含在预填充提示中,引导LLM意识到其可选项,并以恰当的token序列输出决策。然而,这种方法并未解决概率失真的根本问题,凸显了需要进一步研究以提高压缩FSM的准确性。
C 附加实验设置与结果
附加实验设置。图5和图6是在单块A10G(24GB)GPU上运行Llama-7B获得的。图7是在8块A10G(24GB)GPU上以张量并行方式运行Mixtral-8x7B获得的。图8(c)是在单块A10G(24GB)GPU上运行Llama-7B获得的。图12是在4块A100G(80GB)GPU上以张量并行方式运行Llama-70B获得的。表2是在单块A10G(24GB)GPU上运行LLaVA-v1.5-7B以及在单块A100G(80GB)GPU上运行LLaVA-Next-34B获得的。基准测试图中的每个柱状条需要运行几分钟到一小时不等。
附加实验结果。图13展示了图5中所列基准测试上达到的缓存命中率与最优缓存命中率。图12展示了Llama-2-70B在张量并行下的吞吐量。
D 编译器模式
除了论文正文中使用的解释器模式外,运行SGLang程序的另一种方式是将其编译为计算图并使用图执行器执行。这为
更多的编译优化开辟了机会,因为我们可以重写图并执行更多的静态规划。
D.1 设计与实现
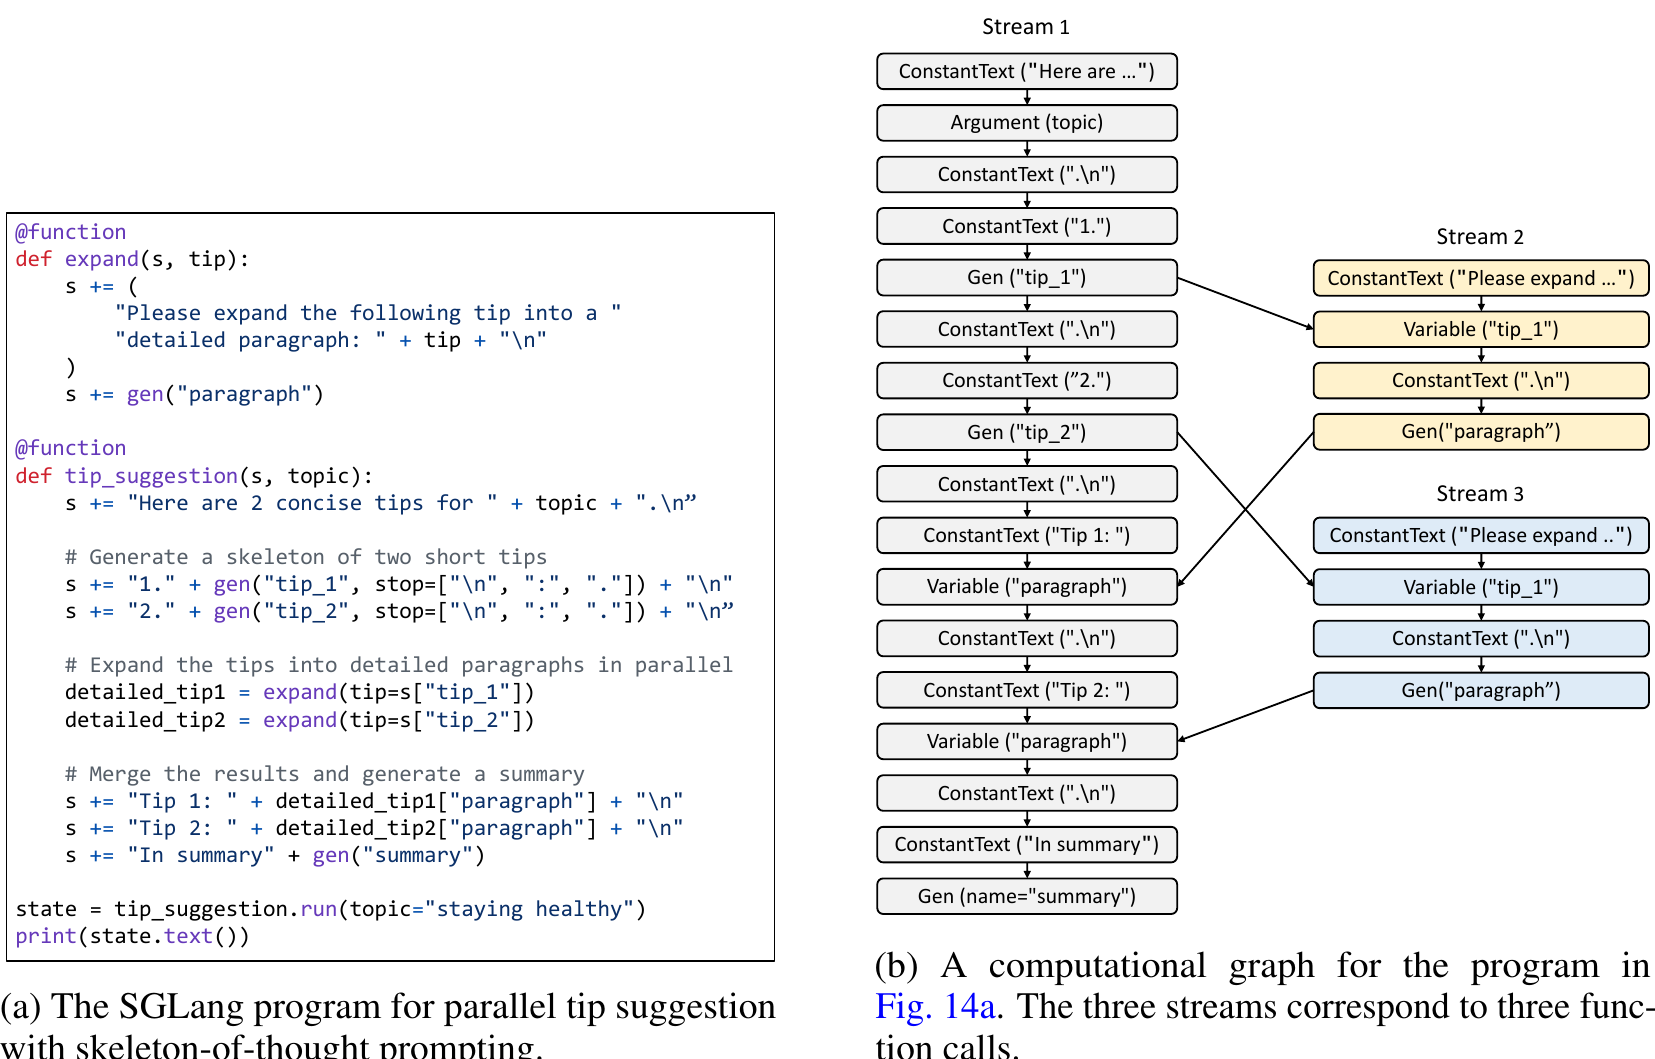
我们为SGLang设计了一种中间表示(IR),它将SGLang程序结构和操作表示为计算图。该图包含表示原始算子的节点和表示依赖关系的边。图14a中程序对应的图见图14b。在程序中,每次调用被装饰的函数或fork都会创建一个新的提示状态或流。
节点有几种类型。SGLang程序中运算符和的每个操作数由一个IR节点表示。这些节点包括ConstantText、Argument、Gen、Select、Variable、Fork、GetForkItem和Join。依赖关系有两种类型:流内依赖,即使用提交到某个流的操作必须在该流中所有先前操作之后执行;以及流间依赖,即当一个流需要从另一个流获取变量值时发生,这需要同步。诸如fork之类的操作会操纵多个流,因而引入流间依赖。
为生成该图,我们使用追踪(tracing)以抽象参数运行程序并动态构建图。该方法仅限于不含数据相关控制流的程序,我们计划在未来的工作中解决这一局限。图一旦构建完成,即可通过图执行器执行,无需重新解释原始Python程序。这带来了图重写优化、减少运行时开销以及程序序列化等好处。在执行时,为每个数据流启动流执行器,按拓扑顺序将IR节点分派到各流。
D.2 编译器优化案例研究:通过代码移动改进前缀共享
我们探索了一种针对SGLang IR的编译优化:通过代码移动改进前缀共享。我们预计还可以应用更多经典的编译器技术,例如自动调优和指令选择。
该优化旨在通过重排图中的节点以增加常量前缀的长度来改进前缀共享。它并不严格保持原始计算,因此被归类为一种激进优化。例如,将提示从“Here is a question + {question}. Please act as a math expert and solve the given question.”改为“Please act as a math expert and solve the given question. Here is a question + {question}.”可得到更长的可共享前缀。这一优化之所以有趣,是因为由于SGLang中存在自然语言指令,传统的程序分析无法实现它。相反,我们提示GPT-4对图节点进行重排。我们编写了一个包含若干示例的提示来向GPT-4教授SGLang IR的概念,并发现GPT-4能够成功地对一些简单的SGLang程序应用该优化。
我们评估了该优化的有效性。我们从互联网收集了20个提示模板,并在SGLang中实现它们。我们利用其中5个模板作为少样本训练示例,其余15个作为测试用例。我们的评估表明,对于15个模板中的12个,GPT-4成功地对图节点进行了重排而未改变语义,这一点已通过对修改后提示的人工检查得到确认。平均而言,该优化使可共享前缀长度增加了60个token,展示了GPT-4的有效性。未能生成优化后的提示顺序的情况源于对图节点背后语义含义的错误理解。它过于激进,将所有常量都放在前面,即使这种排序改变了原始语义。本案例研究旨在探索使用GPT-4进行编译器优化。未来需要更多工作才能使这类优化变得可靠。