
会忘事的智能体不算助手。Mem0 把跨会话的关键信息存下来,p95 延迟比塞满上下文低 91%。2025 年论文,全文免费在线阅读。
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
MemO:构建具备可扩展长期记忆的生产级 AI 智能体
Prateek Chhikara、Dev Khant、Saket Aryan、Taranjeet Singh 和 Deshraj Yadavresearch@memO.ai
memO
大型语言模型(LLM)在生成上下文连贯的回复方面已展现出卓越能力,然而其固定的上下文窗口为在长时间、多会话对话中保持一致性带来了根本性挑战。我们提出 MemO,这是一种以记忆为中心的可扩展架构,通过动态地从持续进行的对话中提取、整合和检索显著信息来解决该问题。在此基础上,我们进一步提出一种增强变体,利用基于图的记忆表示来捕捉对话元素之间复杂的关系结构。通过在 LOCOM0 基准上的全面评估,我们将我们的方法与六个基线类别进行系统比较:(i) 已有的记忆增强系统,(ii) 采用不同块大小和 值的检索增强生成(RAG),(iii) 处理整个对话历史的完整上下文方法,(iv) 一个开源记忆解决方案,(v) 一个专有模型系统,以及 (vi) 一个专用记忆管理平台。实证结果表明,我们的方法在四类问题——单跳、时间、多跳和开放域——上始终优于所有现有记忆系统。值得注意的是,MemO 在 LLM-as-a-Judge 指标上相较 OpenAI 实现了 的相对提升,而带有图记忆的 MemO 相较基础 MemO 配置总体得分高出约 。除准确性提升外,我们相较完整上下文方法还显著降低了计算开销。具体而言,MemO 的 p95 延迟降低了 ,并节省了超过 的 token 成本,从而在高级推理能力与实际部署约束之间提供了极具吸引力的平衡。我们的发现凸显了结构化、持久化记忆机制对于长期对话连贯性的关键作用,为更可靠、更高效的 LLM 驱动 AI 智能体铺平了道路。
代码可在以下地址获取:https://mem0.ai/research
1. 引言
X
人类记忆是智能的基础——它塑造我们的身份、指导决策,并使我们能够学习、适应并建立有意义的关系(Craik and Jennings, 1992)。在其众多作用中,记忆对交流至关重要:我们回忆过去的互动、推断偏好,并为与我们互动的人构建不断演进的心理模型(Assmann, 2011)。这种在较长时间内保留和检索信息的能力,使跨越数天、数周甚至数月的一致且上下文丰富的交流成为可能。由大型语言模型(LLM)驱动的 AI 智能体在生成流畅、符合上下文的回复方面已取得显著进展(Yu et al., 2024, Zhang et al., 2024)。然而,这些系统从根本上受限于其对固定上下文窗口的依赖,这严重限制了它们在长时间互动中保持连贯性的能力(Bulatov et al., 2022, Liu et al., 2023)。这一限制源于 LLM 缺乏能够超越其有限上下文窗口的持久记忆机制。人类会随着时间自然积累并组织经验,形成连续的互动叙事,
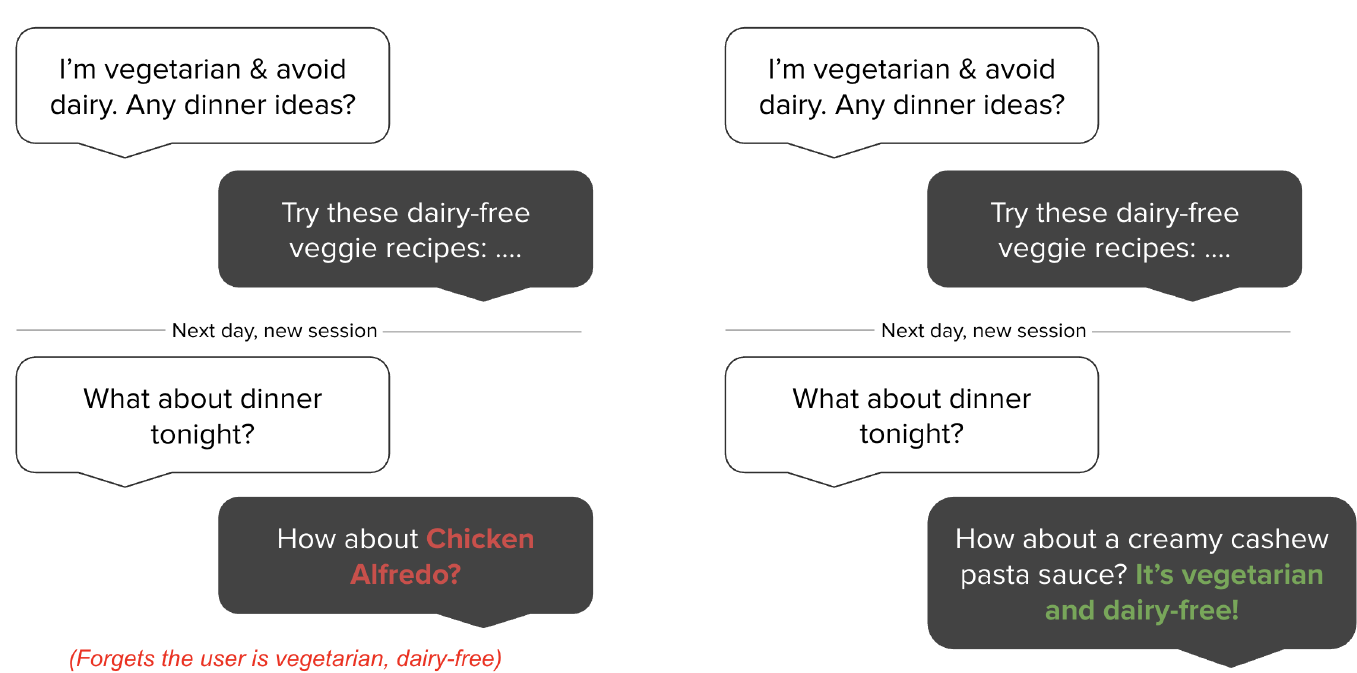
而 AI 系统无法在分离的会话之间或上下文溢出之后固有地持久保存信息。持久记忆的缺失在人类—AI 互动中造成了根本性的断裂。没有记忆,AI 智能体会忘记用户偏好、重复提问,并与先前已确立的事实相矛盾。考虑图 1 所示的一个简单例子:用户在初始对话中提到自己吃素并避免乳制品。在后续会话中,当用户询问晚餐推荐时,没有持久记忆的系统可能会建议鸡肉,完全违背已确立的饮食偏好。相比之下,具有持久记忆的系统会跨会话保留这一关键用户信息,并建议合适的素食、无乳制品选项。这一常见场景凸显了记忆失败如何从根本上损害用户体验与信任。
除对话场景外,记忆机制已被证明能显著增强智能体在交互环境中的表现(Majumder et al., Shinn et al., 2023)。具备过去经验记忆的智能体能够更好地预判用户需求、从先前错误中学习,并在任务之间泛化知识(Chhikara et al., 2023)。研究表明,记忆增强的智能体通过利用行动与结果之间的因果关系来改进决策,从而在动态场景中实现更有效的适应(Rasmussen et al., 2025)。分层记忆架构(Packer et al., 2023, Sarthi et al., 2024)以及能够自主演化的智能体式记忆系统(Xu et al., 2025)进一步表明,记忆能够在多个对话会话中实现更连贯的长期推理。
与能够动态整合新信息并修正过时信念的人类不同,LLM 在信息超出其上下文窗口后实际上会“重置”(Zhang, 2024, Timoneda and Vera, 2025)。即便 OpenAI 的 GPT-4(128K tokens)(Hurst et al., 2024)、o1(200K 上下文)(Jaech et al., 2024)、Anthropic 的 Claude 3.7 Sonnet(200K tokens)(Anthropic, 2025)以及 Google 的 Gemini(至少 10M tokens)(Team et al., 2024)等模型不断拓展上下文长度的边界,这些改进也只是推迟而非解决根本限制。在实际应用中,即便这些扩展的上下文窗口也被证明不够充分,原因有两个关键方面。首先,随着有意义的人类—AI 关系在数周或数月内发展,对话历史不可避免地会超出即便最宽松的上下文限制。其次,或许更重要的是,现实世界中的对话很少保持主题连续性。用户可能提到饮食偏好(吃素),然后进行数小时关于编程任务的无关讨论,之后又回到关于晚餐选项的食物相关问题。在此类场景中,完整上下文方法将需要从大量无关信息中进行推理,而关键饮食偏好可能被埋在数千个 token 的编程讨论之中。此外,仅仅提供更长的上下文并不能确保对过去信息的有效检索或利用,因为注意力机制会随距离较远的 token 而衰减(Guo et al., 2024, Nelson et al., 2024)。这一限制在医疗、教育和企业支持等高风险领域尤其成问题,在这些领域中保持连续性与信任至关重要(Hatalis et al., 2023)。为应对这些挑战,AI 智能体必须采用超越静态上下文扩展的记忆系统。稳健的 AI 记忆应有选择地存储重要信息、整合相关概念,并在需要时检索相关细节——镜像人类认知过程(He et al., 2024)。通过整合此类机制,我们可以开发出能够保持一致人格、跟踪不断演变的用户偏好,并在先前交流基础上继续构建的 AI 智能体。这一转变将把 AI 从短暂、健忘的响应者转变为可靠的长期协作者,从根本上重新定义对话智能的未来。
在本文中,我们解决 AI 系统中的一个根本限制:它们无法在不同会话之间的长时间对话中保持连贯推理,这严重限制了与用户进行有意义的长期互动。我们提出 MemO(读作 mem-zero),这是一种新颖的记忆架构,能够动态捕捉、组织并检索持续进行的对话中的显著信息。在此基础上,我们开发了 MemO8,它通过基于图的记忆表示增强基础架构,以更好地建模对话元素之间的复杂关系。我们在 LOCOM0 基准上的实验结果表明,我们的方法在多样的问题类型上始终优于现有记忆系统——包括记忆增强架构、检索增强生成(RAG)方法以及开源和专有解决方案——同时所需计算资源显著更低。延迟测量进一步表明,MemO 的响应时间比完整上下文方法低 91%,在复杂推理能力与实际部署约束之间实现了最佳平衡。这些贡献代表着朝着能够在长时间内保持连贯、上下文感知对话的 AI 系统迈出的有意义一步——镜像人类交流模式,并为个人辅导、医疗保健和个性化助理等应用开辟新的可能性。
2. 提出的方法
我们为 AI 智能体引入两种记忆架构。(1) MemO 实现了一种新颖范式,通过专门的记忆提取和更新模块从对话中提取、评估和管理显著信息。该系统处理两个用户参与者之间或用户与助手之间的一对消息。(2) MemO8 通过引入基于图的记忆表示扩展了这一基础,其中记忆被存储为有向标记图,实体作为节点、关系作为边。这种结构能够更深入地理解实体之间的联系。通过显式建模实体及其关系,MemO8 支持跨相互关联事实的更高级推理,尤其适用于需要在多个记忆之间导航复杂关系路径的查询。
2.1. MemO
我们的架构遵循增量处理范式,使其能够在持续进行的对话中无缝运行。如图 2 所示,完整流水线架构由两个阶段组成:提取和更新。
提取阶段在接收到新的消息对 时启动,其中 表示当前消息, 表示前一条消息。该消息对通常由一条用户消息和一条助手回复组成,构成一个完整的交互单元。为建立适合记忆提取的上下文,系统采用两个互补来源:(1) 从数据库中检索的对话摘要 ,它
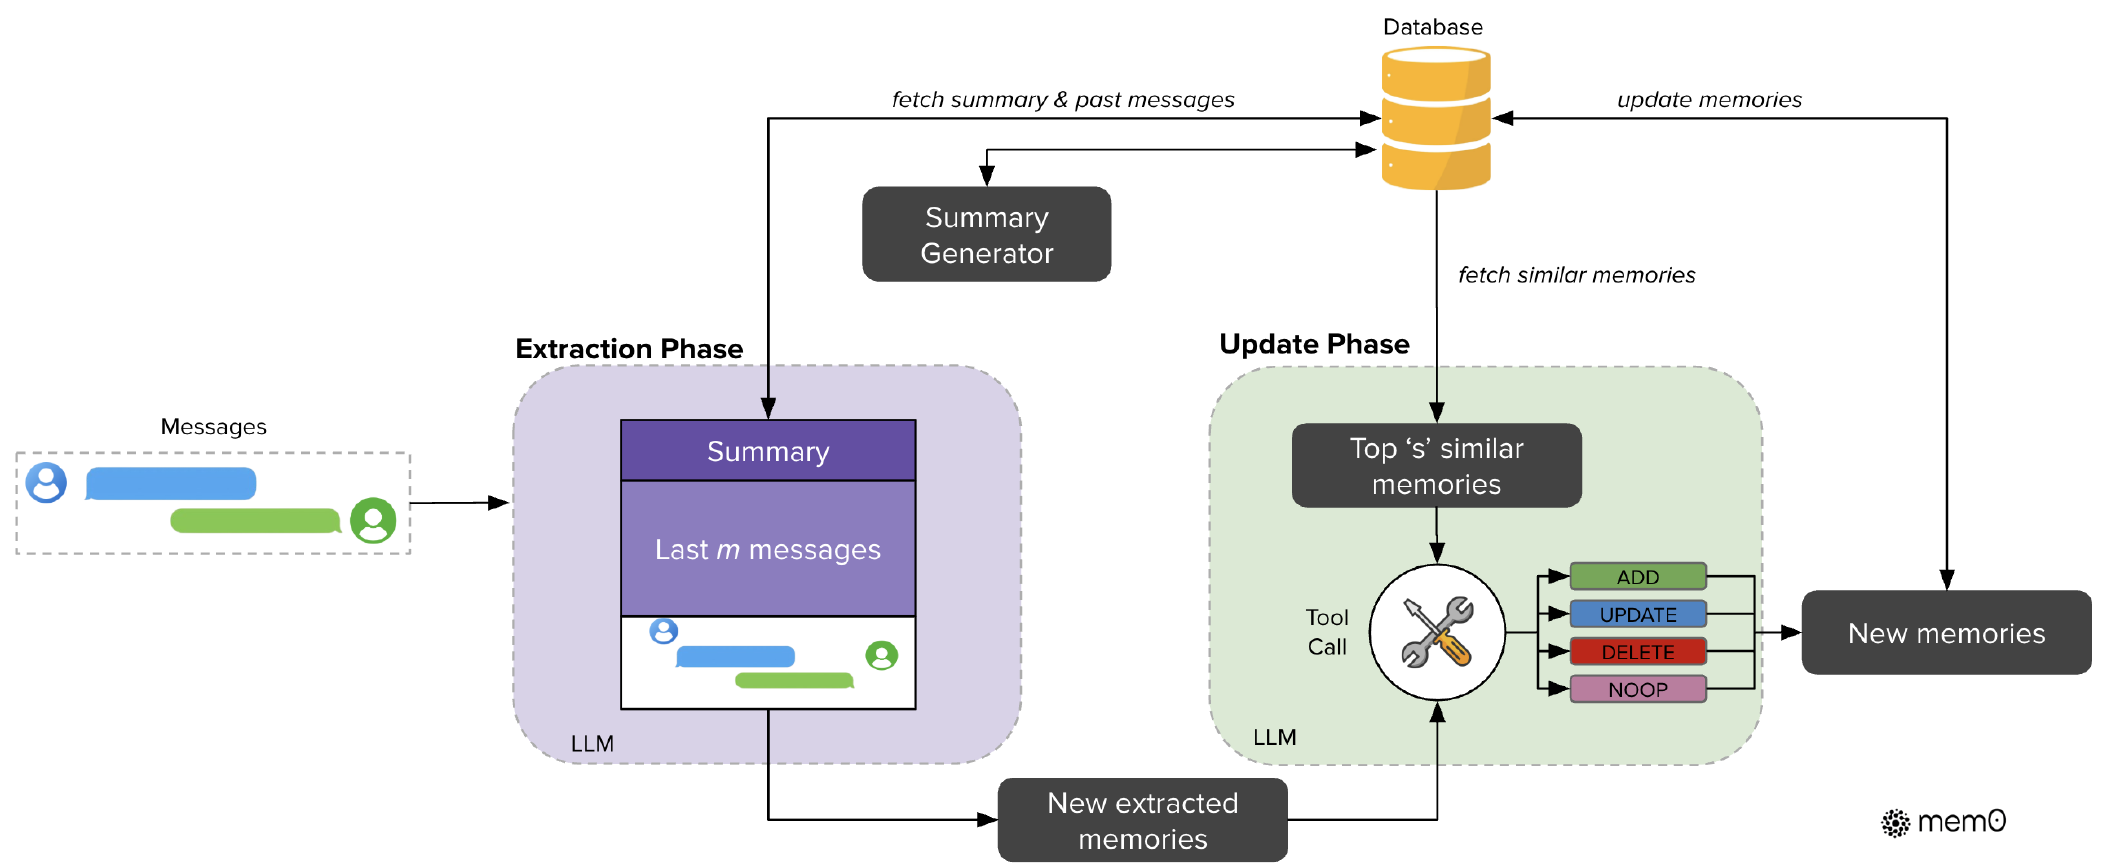
概括了整个对话历史的语义内容;(2) 来自对话历史的一系列近期消息 ,其中 是控制近期窗口大小的超参数。为支持上下文感知的记忆提取,我们实现了一个异步摘要生成模块,定期刷新对话摘要。该组件独立于主处理流水线运行,确保记忆提取始终受益于最新的上下文信息,同时不会引入处理延迟。5 提供了对整个对话的全局主题理解,而近期消息序列则提供了细粒度的时序上下文,其中可能包含尚未整合到摘要中的相关细节。这种双重上下文信息与新的消息对相结合,构成了用于提取函数 的综合提示 ,该函数由LLM实现。随后,函数 专门从新的交互中提取一组显著记忆 ,同时保持对对话更广泛上下文的感知,从而产生可能被纳入知识库的候选事实。
在提取之后,更新阶段会针对现有记忆评估每个候选事实,以保持一致性并避免冗余。该阶段为每个提取出的事实 确定适当的记忆管理操作。附录B中提到的算法1说明了这一过程。对于每个事实,系统首先使用向量嵌入从数据库中检索语义最相似的前 条记忆。随后,这些检索到的记忆连同候选事实一起,通过我们称为“工具调用”的函数调用接口呈现给LLM。由LLM自身决定执行四种不同操作中的哪一种:当不存在语义等价的记忆时,使用ADD创建新记忆;使用UPDATE以补充信息增强现有记忆;使用DELETE移除被新信息所否定的记忆;当候选事实不需要对知识库进行任何修改时,使用NOOP。我们没有使用单独的分类器,而是利用LLM的推理能力,根据候选事实与现有记忆之间的语义关系直接选择适当的操作。在完成这一判定后,系统执行所提供的操作,从而维护知识库的一致性和时间一致性。
在我们的实验评估中,我们将系统配置为使用“”条先前消息作为上下文参考,并使用“”条相似记忆进行比较分析。所有语言模型操作均使用GPT-4o-mini作为推理引擎。向量数据库采用稠密嵌入,以便在更新阶段进行高效的相似性搜索。
2.2. Memo8
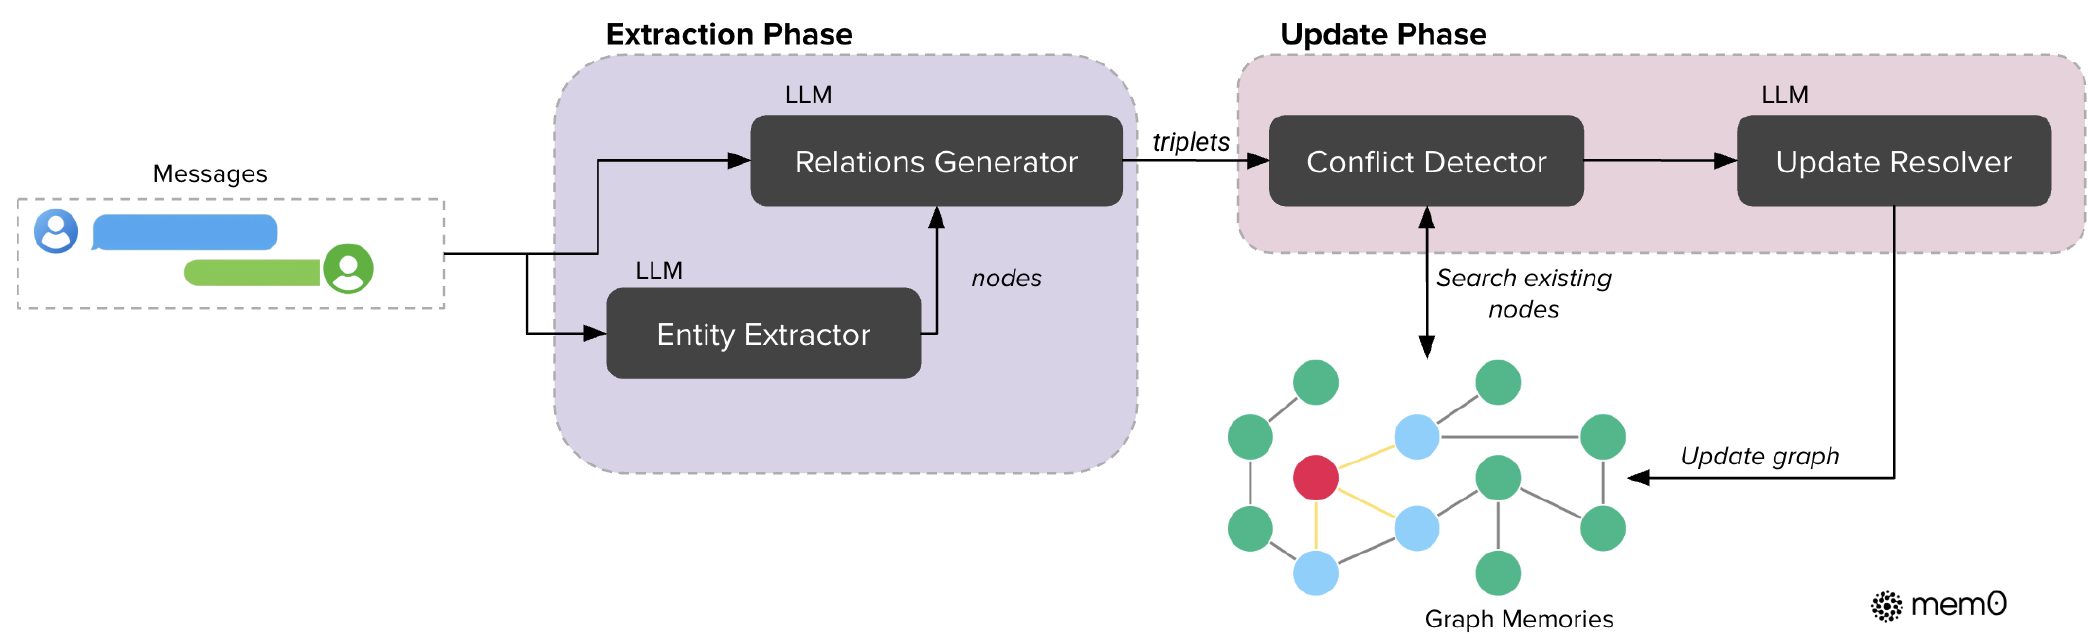
Memo8 流程如图 3 所示,实现了一种基于图的记忆方法,能够有效捕获、存储和检索自然语言交互中的上下文信息(Zhang et al., 2022)。在该框架中,记忆被表示为有向标记图 ,其中:
- 节点 表示实体(例如,ALICE、SAN_FRANCISCO) - 边 表示实体之间的关系(例如,LIVES_IN) - 标签 为节点分配语义类型(例如,ALICE - Person,SAN_FRANCISCO - City)
每个实体节点 包含三个组成部分:(1) 实体类型分类,用于对实体进行归类(例如,Person、Location、Event),(2) 嵌入向量 ,用于捕获实体的语义含义,以及 (3) 元数据,包括创建时间戳 。我们系统中的关系被结构化为三元组形式 ,其中 和 分别是源实体节点和目标实体节点, 是连接它们的带标签边。
提取过程采用两阶段流水线,利用 LLM 将非结构化文本转换为结构化图表示。首先,实体提取器模块处理输入文本,以识别一组实体及其对应类型。在我们的框架中,实体表示对话中的关键信息元素——包括人物、地点、对象、概念、事件和属性,这些元素值得在记忆图中表示。实体提取器通过分析对话中元素的语义重要性、独特性和持久性来识别这些多样化的信息单元。例如,在关于旅行计划的对话中,实体可能包括目的地(城市、国家)、交通方式、日期、活动和参与者偏好——本质上,任何可能与未来参考或推理相关的离散信息。
接下来,关系生成器组件在这些实体之间推导有意义的连接,建立一组捕获信息语义结构的关系三元组。这个基于 LLM 的模块分析提取出的实体及其在对话中的上下文,以识别语义上重要的连接。它通过检查语言模式、上下文线索和领域知识来确定实体之间的相互关系。对于每个潜在的实体对,生成器评估是否存在有意义的关系,如果存在,则用适当的标签对该关系进行分类(例如,'lives_in'、'prefers'、'owns'、'happened_on')。该模块采用提示工程技术,引导 LLM 对对话中的显式陈述和隐式信息进行推理,从而产生关系三元组,这些三元组构成我们记忆图中的边,并支持跨互联信息的复杂推理。在整合新信息时,Memo8 采用复杂的存储和更新策略。对于每个新的关系三元组,我们计算源实体和目标实体的嵌入,然后搜索语义相似度高于定义阈值 't' 的现有节点。根据节点是否存在,系统可能创建两个节点、仅创建一个节点,或使用现有节点,然后以适当的元数据建立关系。为保持知识图谱的一致性,我们实现了一种冲突检测机制,在新信息到达时识别可能冲突的现有关系。基于 LLM 的更新解析器判断某些关系是否应被废弃,将其标记为无效而非物理删除,以支持时间推理。
Memo8 中的记忆检索功能实现了双路径策略,以实现最优的信息访问。以实体为中心的方法首先识别查询中的关键实体,然后利用语义相似度在知识图谱中定位对应节点。它系统地探索这些锚节点的入关系和出关系,构建一个捕获相关上下文信息的综合子图。作为补充,语义三元组方法采取更整体的视角,将整个查询编码为稠密嵌入向量。然后,将该查询表示与知识图谱中每个关系三元组的文本编码进行匹配。系统计算查询与所有可用三元组之间的细粒度相似度分数,仅返回超过可配置相关性阈值的三元组,并按相似度递减排序。这种双重检索机制使 Memo8 能够同样有效地处理以实体为中心的针对性问题和更广泛的概念性查询。
从实现角度来看,系统使用 Neo4j1 作为底层图数据库。基于 LLM 的提取器和更新模块利用具备函数调用能力的 GPT-4o-mini,从而能够从非结构化文本中进行结构化信息提取。通过将基于图的表示与语义嵌入以及基于 LLM 的信息提取相结合,Memo8 同时实现了复杂推理所需的结构丰富性和自然语言理解所需的语义灵活性。
3. 实验设置
3.1. 数据集
LOCOM0(Maharana et al., 2024)数据集旨在评估对话系统中的长期对话记忆。它包含 10 段扩展对话,每段平均包含约 600 轮对话和 26000 个 token,分布在多个会话中。每段对话记录了两个个体讨论日常经历或过去事件。在这些多会话对话之后,每段对话平均附有 200 个问题及相应的真实答案。这些问题被分为多种类型:单跳、多跳、时间和开放域。该数据集最初包含一个对抗性问题类别,旨在测试系统识别 不可回答问题能力。然而,该类别被排除在我们的评估之外,因为真实答案不可用,且该问题类型的预期行为是智能体应将其识别为不可回答。
3.2. 评估指标
我们的评估框架实施了一种综合方法来评估对话系统中的长期记忆能力,同时考虑响应质量和运行效率。我们将指标分为两个不同的组,二者共同提供对系统性能的整体理解。
(1) 性能指标 先前在对话式 AI 中的研究(Goswami, 2025, Soni et al., 2024, Singh et al., 2020)主要依赖词汇相似度指标,如 F1 分数(F1)和 BLEU-1(B1)。然而,这些指标在评估对话上下文中的事实准确性时表现出显著局限性。考虑一个场景,真实答案是“Alice was born in March”,而系统生成“Alice is born in July”。尽管在出生月份方面包含关键事实错误,传统指标仍会因其余 token(“Alice”、“born”等)的词汇重叠而给出相对较高的分数。这一根本性局限可能导致误导性评估,无法捕获语义正确性。为解决这些缺陷,我们使用 LLM-as-a-Judge(J)作为补充评估指标。该方法利用一个单独的、能力更强的 LLM 从多个维度评估响应质量,包括事实准确性、相关性、完整性和上下文适当性。评判模型分析问题、真实答案和生成答案,提供更细致的评估,更符合人类判断。由于 J 评估的随机性,我们对每种方法在整个数据集上进行了 10 次独立运行,并报告平均分数以及 标准差。关于 J 的更多细节见附录 A。
(2) 部署指标 除响应质量外,实际部署考虑对于 AI 智能体中长期记忆的实际应用至关重要。我们系统性地跟踪 Token 消耗,使用 tiktoken 的 'c1100k_base' 编码,测量检索过程中提取的、用作回答查询上下文的 token 数量。对于基于记忆的模型,这些 token 表示从知识库中检索到的记忆;而对于基于 RAG 的模型,它们对应于检索到的文本块中的 token 总数。这一区分很重要,因为它直接影响运行成本和系统效率——无论是处理简洁的记忆事实还是更大的原始文本片段。我们进一步监控延迟,(i) 搜索延迟:捕获搜索记忆(在基于记忆的解决方案中)或块(在基于 RAG 的解决方案中)所需的总时间;(ii) 总延迟:生成适当响应的时间,由检索时间(访问记忆或块)和使用 LLM 生成答案的时间组成。
这些指标之间的关系揭示了系统设计中的重要权衡。例如,更复杂的记忆架构可能实现更高的事实准确性,但代价是 token 消耗和延迟增加。我们的多维评估方法使研究人员和实践者能够根据其特定需求做出明智决策,无论是为关键应用优先考虑响应质量,还是为实时部署场景优先考虑计算效率。
3.3. 基线
为全面评估我们的方法,我们与代表对话记忆系统当前状态的六个不同类别的基线进行比较。这些多样化的基线共同提供了一个 稳健框架,用于评估不同记忆架构在多个维度上的有效性,包括事实准确性、计算效率和对扩展对话的可扩展性。在适用情况下,除非另有说明,我们将温度设置为 0,以确保运行尽可能可复现。
已建立的 LOcOMO 基准 我们首先通过评估先前在 LOcOMO 数据集上基准测试过的方法来建立比较基础。这些包括五种已建立的方法:LoCoMo(Maharana et al., 2024)、ReadAgent(Lee et al., 2024)、MemoryBank(Zhong et al., 2024)、MemGPT(Packer et al., 2023)和 A-Mem(Xu et al., 2025)。这些已建立的基准不仅提供了与已发表结果的直接比较点,还代表了对话记忆架构在不同算法范式中的演变。对于我们的评估,我们选择使用 gpt-4o-mini 进行评估的指标。关于这些基准的更多细节见附录 C。
2开源记忆解决方案 我们的第二个类别由有前景的开源记忆架构组成,例如LangMem(热路径),这些架构在相关对话任务中已展现出有效性,但尚未在LOcOMO数据集上进行评估。通过将这些系统适配到我们的评估框架中,我们拓宽了比较范围,并识别出可能提供有竞争力性能的潜在替代方法。我们使用gpt-4o-mini初始化LLM,并使用text-embedding-small-3作为嵌入模型。
检索增强生成(RAG) 作为基线,我们将整个对话历史视为文档集合,并应用标准的RAG流水线。我们首先将每个对话分割为固定长度的块(128、256、512、1024、2048、4096和8192个token),其中8192是我们的嵌入模型支持的最大块大小。所有块均使用OpenAI的text-embedding-small-3进行嵌入,以确保不同配置之间的向量质量一致。在查询时,我们按语义相似度检索前个块,并将它们拼接作为答案生成的上下文。在整个实验中,我们设置:当时仅使用单个最相关的块,当时拼接两个最相关的块(最多16384个token)。我们避免使用,因为平均对话长度(26000个token)将被完全覆盖,从而抵消选择性检索的优势。通过改变块大小和,我们系统地评估RAG在长期对话记忆任务上的性能。
全上下文处理 我们采用一种直接的方法,将整个对话历史传入LLM的上下文窗口。该方法利用模型处理序列信息的固有能力,无需额外的架构组件。虽然概念上简单,但随着对话长度增加,该方法面临实际限制,最终会增加token成本和延迟。尽管如此,它建立了一个重要的参考点,用于理解更复杂的记忆机制相较于直接处理可用上下文的价值。
3专有模型 我们评估OpenAI在其ChatGPT界面中提供的记忆功能,为保持一致性,特别使用gpt-4o-mini。我们通过提示(见附录A)将完整的LOcOMO对话摄入单个聊天会话中,以时间戳、参与者姓名和对话文本提示生成记忆。这些生成的记忆随后被用作回答每个对话相关问题的完整上下文,有意赋予OpenAI方法对所有记忆的特权访问,而非仅访问与问题相关的记忆。该方法适应了OpenAI系统中缺乏用于选择性记忆检索的外部API访问的情况,以进行基准测试。
| 方法 | 单跳 | 多跳 | 开放域 | 时间 | ||||||||
| F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | F1↑ | B1↑ | J↑ | |
| LoCoMo | 25.02 | 19.75 | - | 12.04 | 11.16 | - | 40.36 | 29.05 | - | 18.41 | 14.77 | - |
| ReadAgent | 9.15 | 6.48 | - | 5.31 | 5.12 | - | 9.67 | 7.66 | - | 12.60 | 8.87 | - |
| MemoryBank | 5.00 | 4.77 | - | 5.56 | 5.94 | - | 6.61 | 5.16 | - | 9.68 | 6.99 | - |
| MemGPT | 26.65 | 17.72 | - | 9.15 | 7.44 | - | 41.04 | 34.34 | - | 25.52 | 19.44 | - |
| A-Mem | 27.02 | 20.09 | - | 12.14 | 12.00 | - | 44.65 | 37.06 | - | 45.85 | 36.67 | - |
| A-Mem* | 20.76 | 14.90 | 39.79 ± 0.38 | 9.22 | 8.81 | 18.85 ± 0.31 | 33.34 | 27.58 | 54.05 ± 0.22 | 35.40 | 31.08 | 49.91 ± 0.31 |
| LangMem | 35.51 | 26.86 | 62.23 ± 0.75 | 26.04 | 22.32 | 47.92 ± 0.47 | 40.91 | 33.63 | 71.12 ± 0.20 | 30.75 | 25.84 | 23.43 ± 0.39 |
| Zep | 35.74 | 23.30 | 61.70 ± 0.32 | 19.37 | 14.82 | 41.35 ± 0.48 | 49.56 | 38.92 | 76.60 ± 0.13 | 42.00 | 34.53 | 49.31 ± 0.50 |
| OpenAI | 34.30 | 23.72 | 63.79 ± 0.46 | 20.09 | 15.42 | 42.92 ± 0.63 | 39.31 | 31.16 | 62.29 ± 0.12 | 14.04 | 11.25 | 21.71 ± 0.20 |
| MemO | 38.72 | 27.13 | 67.13 ± 0.65 | 28.64 | 21.58 | 51.15 ± 0.31 | 47.65 | 38.72 | 72.93 ± 0.11 | 48.93 | 40.51 | 55.51 ± 0.34 |
| MemO8 | 38.09 | 26.03 | 65.71 ± 0.45 | 24.32 | 18.82 | 47.19 ± 0.67 | 49.27 | 40.30 | 75.71 ± 0.21 | 51.55 | 40.28 | 58.13 ± 0.44 |
记忆提供方 我们集成了 Zep(Rasmussen 等,2025),这是一个专为 AI 智能体设计的记忆管理平台。使用其平台版本,我们在 LOcOMO 数据集上开展了系统性评估,通过将时间戳信息与对话内容一同保留来维持时间保真度。这种时间锚定确保时间敏感的查询可以通过适当情境化的记忆检索来应对,这对于评估需要时间顺序意识的问题尤为重要。该基线代表了专为 AI 智能体设计的重要商业记忆管理实现。
4. 评估结果、分析与讨论。
4.1. 记忆启用系统间的性能比较
表 1 报告了我们的两种架构——MemO 和 MemO——在单跳、多跳、开放域和时间性问题上的 、 和 J 分数,并与第 3 节提到的一系列有竞争力的基线进行对比。总体而言,我们的两个模型在大多数问题类型上都于全部三项评估指标上创下了新的最先进水平。
单跳问题性能 单跳查询涉及定位包含在单个对话轮次内的单一事实片段。凭借其自然语言文本中的稠密记忆,MemO 取得了最强结果:、 和 。用图记忆增强自然语言记忆(MemO8)相比 MemO 带来了轻微的性能下降,表明当检索目标占据单个轮次时,关系结构的效用有限。在现有基线中,全上下文 OpenAI 运行获得了次优的 J 分数,反映了将完整对话保留在上下文中的好处,而 LangMem 和 Zep 在 J 分数上相对我们的模型均低约 8%。先前的 LOcOMO 基准(如 A-mem)在 J 上落后超过 25 分,凸显了即使对于简单检索任务,细粒度、结构化记忆索引的必要性。
多跳问题性能 多跳查询需要综合分散在多个对话会话中的信息,在记忆整合和检索方面构成重大挑战。MemO 明显优于其他方法, 分数为 28.64,J 分数为 51.15,反映了其高效检索并整合跨会话存储的分散信息的能力。有趣的是,在 MemO8 中加入图记忆在此处并未带来性能提升,表明对于复杂整合任务,结构化图表示相较于仅使用稠密自然语言记忆可能存在低效或冗余。像 LangMem 这样的基线表现出有竞争力的性能,但其分数大幅落后于 MemO,强调了我们的精细记忆索引和检索机制在处理复杂查询方面的优势。
开放域性能 在开放域设置中,基线 Zep 取得了最高的 (49.56)和 J(76.60)分数,以微弱优势超过我们的方法。特别是,Zep 的 J 分数 76.60 仅比 MemO8 的 75.71 高出 0.89 个百分点,并比 MemO 的 72.93 高出 3.67 分,凸显了在将对话记忆与外部知识整合方面持续但轻微的優勢。MemO8 仍是强劲的亚军,J 为 75.71,反映了高事实检索精度,而 MemO 以 72.93 紧随其后,展示了稳健的连贯性。这些结果强调,尽管结构化关系记忆(如 MemO 和 MemO8 中)显著改善了开放域检索,Zep 仍保持着小幅但有意义的领先。
时间推理性能 时间推理任务取决于对对话历史中事件序列、其相对顺序和持续时间的准确建模。我们的架构在各项指标上均表现出显著改进,MemO8 取得了最高的 (51.55)和 J(58.13),表明除自然语言记忆之外的结构化关系表示显著有助于时间 grounding 判断。值得注意的是,基础变体 MemO 也提供了不错的 J 分数(55.51),表明仅自然语言即可有助于时间 grounding 判断。在基线中,OpenAI 明显表现不佳,分数低于 15%,主要原因是大多数生成的记忆中缺少时间戳,尽管在 OpenAI ChatGPT 中明确提示提取带有时间戳的记忆。其他基线如 A-Mem 取得了可观的结果,但我们的模型显然推进了最先进水平,强调了准确利用自然语言情境化和结构化图表示进行时间推理的关键优势。
4.2. 跨类别分析
跨不同问题类别的全面评估表明,我们提出的架构 MemO 和 MemO8 相比基线系统始终取得更优性能。对于单跳查询,MemO 表现出特别强的性能,受益于其高效的稠密自然语言记忆结构。尽管 MemO8 中基于图的表示在这些更简单查询的词汇重叠指标上略落后,但它们显著增强了语义连贯性,如具有竞争力的 J 分数所示。这表明图结构在涉及细微关系上下文而非直接检索的场景中更有益。对于多跳问题,MemO 通过有效综合跨多个会话的分散信息展现出明显优势,证实自然语言记忆为这些整合任务提供了足够的表示丰富度。令人惊讶的是,
| 方法 | K | 块大小 / 记忆令牌 | 延迟(秒) | 总体 J | |||
| 搜索 | 总计 | ||||||
| RAG | 1 | 128 | 0.281 | 0.823 | 0.774 | 1.825 | 47.77 ± 0.23% |
| 256 | 0.251 | 0.710 | 0.745 | 1.628 | 50.15 ± 0.16% | ||
| 512 | 0.240 | 0.639 | 0.772 | 1.710 | 46.05 ± 0.14% | ||
| 1024 | 0.240 | 0.723 | 0.821 | 1.957 | 40.74 ± 0.17% | ||
| 2048 | 0.255 | 0.752 | 0.996 | 2.182 | 37.93 ± 0.12% | ||
| 8192 | 4096 | 0.254 | 0.719 | 1.093 | 2.711 | 36.84 ± 0.17% | |
| 812 | 0.279 | 0.838 | 1.396 | 4.416 | 44.53 ± 0.13% | ||
| 128 | 0.267 | 0.624 | 0.766 | 1.829 | 59.56 ± 0.19% | ||
| 256 | 0.255 | 0.699 | 0.802 | 1.907 | 60.97 ± 0.20% | ||
| 2 | 1024 | 512 | 0.247 | 0.746 | 0.829 | 1.729 | 58.19 ± 0.18% |
| 2048 | 0.238 | 0.702 | 0.860 | 1.850 | 50.68 ± 0.13% | ||
| 4096 | 0.261 | 0.829 | 1.101 | 2.791 | 48.57 ± 0.22% | ||
| 812 | 0.266 | 0.944 | 1.451 | 4.822 | 51.79 ± 0.15% | ||
| 8192 | 0.288 | 1.124 | 2.312 | 9.942 | 60.53 ± 0.16% | ||
| 全上下文 | 26031 | - | - | 9.870 | 17.117 | 72.90 ± 0.19% | |
| A-Mem | 2520 | 0.668 | 1.485 | 1.410 | 4.374 | 48.38 ± 0.15% | |
| LangMem | 127 | 17.99 | 59.82 | 18.53 | 60.40 | 58.10 ± 0.21% | |
| Zep | 3911 | 0.513 | 0.778 | 1.292 | 2.926 | 65.99 ± 0.16% | |
| OpenAI | 4437 | - | - | 0.466 | 0.889 | 52.90 ± 0.14% | |
| Mem0 | 1764 | 0.148 | 0.200 | 0.708 | 1.440 | 66.88 ± 0.15% | |
| Mem0^8 | 3616 | 0.476 | 0.657 | 1.091 | 2.590 | 68.44 ± 0.17% | |
预期中的关系优势在此处并未转化为更好的结果,表明在多步推理场景中导航更复杂图结构时可能存在开销或冗余。
在时间推理中, 大幅优于其他方法,验证了结构化关系图在捕捉时间关系和事件序列方面的卓越能力。显式关系上下文的存在显著增强了 的时间连贯性,优于 的稠密记忆存储,并凸显了在跟踪时间敏感信息时精确关系表示的重要性。开放域性能进一步强化了关系建模的价值。 受益于基于图的记忆的关系清晰性,与表现最佳的基线(Zep)展开激烈竞争。这一有竞争力的结果凸显了 通过关系清晰性整合外部知识的稳健性,表明结构化记忆与开放域信息综合之间存在最佳协同效应。
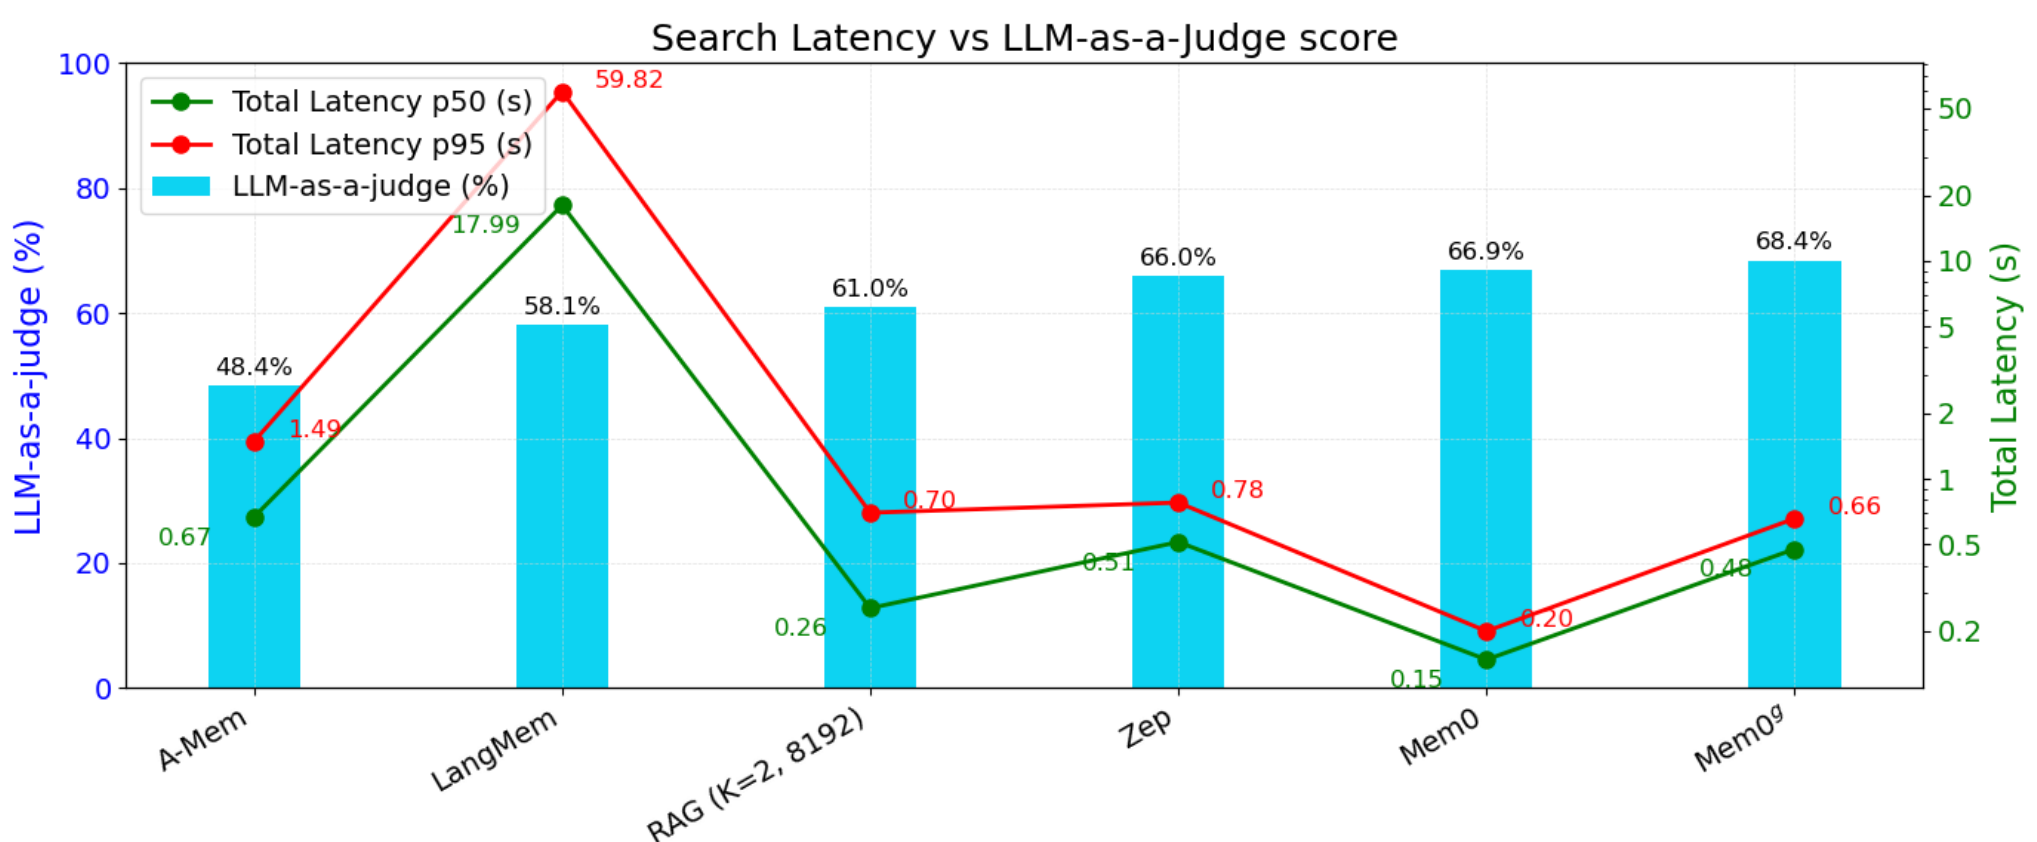
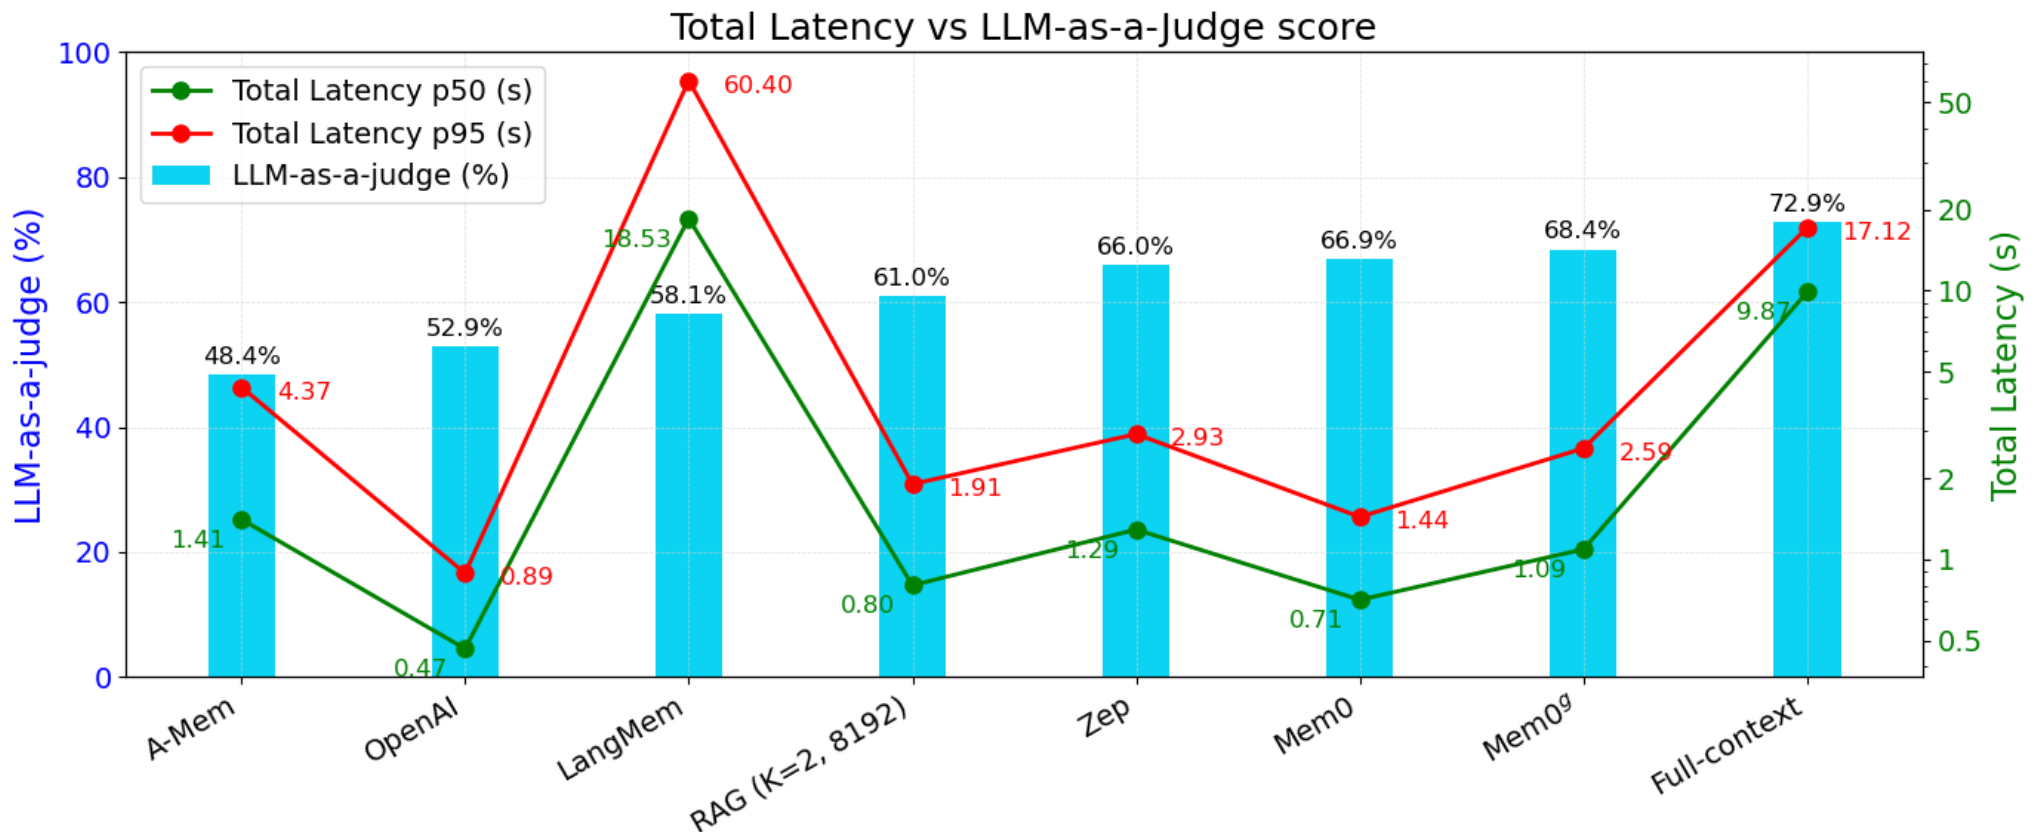
图 4:不同记忆方法的延迟分析。这些子图展示了表 2 中各种所选方法的 J 分数和延迟比较。子图 (a) 突出显示答案生成前的搜索/检索延迟,而子图 (b) 显示总延迟(包括 LLM 推理)。两个图都叠加了每种方法的 J 分数,以便全面了解其准确性和效率。
总体而言,我们的分析表明 Mem0 和 Mem08 在各种任务需求上具有互补优势:基于稠密自然语言的记忆为更简单查询提供了显著效率,而显式关系建模对于需要细微时间和上下文整合的任务变得至关重要。这些发现强化了在 AI 智能体部署中针对特定推理上下文定制自适应记忆结构的重要性。
4.3. MemO 和 MemO 与 RAG 方法及全上下文模型的性能比较
表 2 中的比较聚焦于“总体 J”列,表明 MemO 和 MemO 始终优于所有 RAG 配置,这些配置改变块大小(128-8192 个 token)并检索一个 或两个 块。即使最强的 RAG 方法在 J 指标上也仅达到约 ,而 MemO 达到 ——相对提升约 ——MemO 达到超过 ,实现约 的相对增益。这些进展凸显了仅在记忆中捕捉最显著事实而非检索大块原始文本的优势。通过将对话历史转换为简洁的结构化表示,MemO 和 MemO 减轻了噪声并向 LLM 呈现更精确的线索,从而在外部 LLM(J)评估中获得更好的答案。
尽管有这些改进,一种摄入约26,000个token块的完整上下文方法仍然取得了最高的J分数(约为)。然而,如图4b所示,它也会带来非常高的总p95延迟——约为17秒——因为模型在每次查询时都必须读取整个对话。相比之下,MemO和MemO显著减少了token使用量,因而相比完整上下文方法分别实现了约1.44秒(降低)和2.6秒(降低)的更低p95延迟。尽管完整上下文方法可以提供轻微的准确性优势,但基于记忆的系统提供了一种更实用的权衡,在仅付出少量token和延迟成本的情况下保持了接近竞争力的质量。随着对话长度增加,完整上下文方法会遭受计算开销的指数级增长(这在表2中很明显,其中总p95延迟随着更大的值或块大小而显著增加)。输入块的这种增加会导致更长的响应时间和更高的token消耗成本。相比之下,像MemO和MemO这样以记忆为重点的方法无论对话长度如何都能保持一致的性能,使其在效率和响应性至关重要的生产规模部署中大幅更具可行性。
4.4. 延迟分析
表2提供了各种检索和记忆方法的全面性能比较,展示了在LOCOM0数据集上搜索阶段和总响应生成阶段的中位数(p50)和尾部(p95)延迟。我们的分析揭示了由架构选择所主导的鲜明性能模式。以记忆为中心的架构表现出不同的性能特征。A-Mem尽管拥有更大的记忆存储,却产生了大量搜索开销(p50:0.668秒),导致总中位延迟为1.410秒。LangMem表现出更高的搜索延迟(p50:17.99秒,p95:59.82秒),使其不适用于交互式应用。Zep实现了中等性能(p50总计:1.292秒)。完整上下文基线在不进行检索的情况下处理整个对话历史,这与基于检索的方法有着根本不同。通过将整个对话上下文(26000个token)直接传递给LLM,它消除了搜索开销,但带来了极高的总延迟(p50:9.870秒,p95:17.117秒)。类似地,OpenAI的实现不执行记忆搜索,因为它处理的是从其playground中手动提取的记忆。虽然这种方法实现了令人印象深刻的响应生成时间(p50:0.466秒,p95:0.889秒),但它需要预先提取相关上下文,而这并未反映在所报告的指标中。
我们提出的MemO方法在所有方法中实现了最低的搜索延迟(p50:0.148秒,p95:0.200秒),如图4a所示。这种效率源于我们的选择性记忆检索机制以及基础设施改进,它们动态识别并仅检索最显著的信息,而不是固定大小的块。因此,MemO保持了最低的总中位延迟(0.708秒),并且p95值被显著控制在较低水平(1.440秒),使其特别适用于对延迟敏感的应用,例如交互式AI智能体。图增强的MemO变体以适度的延迟成本引入了额外的关系建模能力,其搜索时间(0.476秒)仍然优于所有现有记忆解决方案和基线。尽管有所增加,Memo8仍保持了有竞争力的总延迟(p50:1.091秒,p95:2.590秒),同时在所有方法中取得了最高的J分数(68.44%)——仅落后于计算上难以承受的完整上下文方法。这种性能表现展示了我们的方法在平衡响应质量和计算效率方面的能力,为生产级AI智能体提供了一个有吸引力的解决方案,因为这两个因素都是关键约束。
4.5. 内存系统开销:Token 分析与构建时间
我们测量了实现每个系统长期记忆存储所需的平均 token 预算。Memo 以自然语言表示形式编码完整的对话轮次,因此平均每个对话仅占用 7k token。而 Memo8 由于引入了包含节点及相应关系的图记忆,其占用大约翻倍至 14k token。与之形成鲜明对比的是,Zep 的记忆图消耗超过 600k token。这种膨胀源于 Zep 的设计选择:在每个节点缓存完整的抽象摘要,同时在连接边上存储事实,导致整个图中出现大量冗余。作为参照,将完整的原始对话上下文提供给语言模型——不进行任何记忆抽象——平均约为 26k token,相对于 Zep 的图少了 20 倍。除了 token 效率低下之外,我们的实验还揭示了 Zep 存在显著的操作瓶颈。在向 Zep 系统添加记忆后,我们观察到立即尝试检索记忆往往无法正确回答我们的查询。有趣的是,延迟数小时后重新运行相同的搜索会产生明显更好的结果。这种延迟表明 Zep 的图构建涉及多次异步 LLM 调用和大量后台处理,使得该记忆系统不适用于实时应用。相比之下,即使最坏情况下,Memo 的图构建也能在一分钟内完成,允许用户立即利用新添加的记忆进行查询响应。
这些发现凸显了 Zep 不仅在多个节点间复制相同的知识片段,还引入了显著的操作延迟。我们的架构——MemO 和 Memo8——以一小部分 token 成本保存相同的信息,并且记忆可用性大幅加快,提供了更具内存效率和操作响应性的表示。
5. 结论与未来工作
我们介绍了 MemO 和 Memo8,两种互补的记忆架构,克服了 LLM 中固定上下文窗口的固有局限。通过动态提取、整合和检索紧凑的记忆表示,MemO 在单跳和多跳推理中实现了最先进的性能,而 Memo 基于图的扩展在时序和开放域任务中带来了显著增益。在 LOCOMO 基准上,我们的方法在单跳、时序和多跳推理问题类型上分别比各自问题类型的最佳性能方法相对提升了 5%、11% 和 7%,并将 p95 延迟相比全上下文基线降低了超过 91%——展示了精度与响应性之间的强大平衡。Memo 的稠密记忆流水线擅长对直接查询进行快速检索,最大限度地减少 token 使用和计算开销。相比之下,Memo 的结构化图表示提供了细致的关系清晰度,能够实现复杂的事件排序和丰富的上下文整合,同时不牺牲实际效率。二者共同构成了一个多功能的记忆工具包,能够适应多样化的对话需求,同时保持大规模可部署性。
未来的研究方向包括优化图操作以减少 Memo8 中的延迟开销、探索将效率与关系表示相结合的分层记忆架构,以及开发受人类认知过程启发的更复杂的记忆整合机制。
此外,将我们的记忆框架扩展到对话场景之外的领域,如程序性推理和多模态交互,将进一步验证其更广泛的适用性。通过解决固定上下文窗口的根本局限,我们的工作代表了朝着能够像人类一样在长时间内保持连贯、上下文丰富交互的对话 AI 系统迈出的重要一步。
6. 致谢
我们衷心感谢 Harsh Agarwal、Shyamal Anadkat、Prithvijit Chattopadhyay、Siddesh Choudhary、Rishabh Jain 和 Vaibhav Pandey 对早期草稿的宝贵见解和详尽审阅。他们建设性的意见和详细的建议帮助完善了手稿,提升了其清晰度和整体质量。我们深深感谢他们慷慨地投入时间和专业知识于这项工作。
参考文献
Anthropic. Model card and evaluations for claude models. Technical report, Anthropic, February 2025. URL https://www.anthropic.com/news/claude- 3- 7- sonnet.
Jan Assmann. Communicative and cultural memory. In Cultural memories: The geographical point of view, pages 15- 27. Springer, 2011.
Aydar Bulatov, Yury Kuratov, and Mikhail Burtsev. Recurrent memory transformer. Advances in Neural Information Processing Systems, 35:11079- 11091, 2022.
Prateek Chhikara, Jiarui Zhang, Filip Ilievski, Jonathan Francis, and Kaixin Ma. Knowledge- enhanced agents for interactive text games. In Proceedings of the 12th Knowledge Capture Conference 2023, pages 157- 165, 2023.
Fergus IM Craik and Janine M Jennings. Human memory. 1992.
Gaurav Goswami. Dissecting the metrics: How different evaluation approaches yield diverse results for conversational ai. Authorea Preprints, 2025.
Tianyu Guo, Druv Pai, Yu Bai, Jiantao Jiao, Michael Jordan, and Song Mei. Active- dormant attention heads: Mechanistically demystifying extreme- token phenomena in llms. In NeurIPS 2024 Workshop on Mathematics of Modern Machine Learning, 2024.
Kostas Hatalis, Despina Christou, Joshua Myers, Steven Jones, Keith Lambert, Adam Amos- Binks, Zohreh Dannenhauer, and Dustin Dannenhauer. Memory matters: The need to improve long- term memory in llm- agents. In Proceedings of the AAAI Symposium Series, volume 2, pages 277- 280, 2023.
Zihong He, Weizhe Lin, Hao Zheng, Fan Zhang, Matt W Jones, Laurence Aitchison, Xuhai Xu, Miao Liu, Per Ola Kristensson, and Junxiao Shen. Human- inspired perspectives: A survey on ai long- term memory. arXiv preprint arXiv:2411.00489, 2024.
Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. Gpt- 4o system card. arXiv preprint arXiv:2410.21276, 2024.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El- Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Kuang- Huei Lee, Xinyun Chen, Hiroki Furuta, John Canny, and Ian Fischer. A human- inspired reading agent with gist memory of very long contexts. In International Conference on Machine Learning, pages 26396- 26415. PMLR, 2024.
Lei Liu, Xiaoyan Yang, Yue Shen, Binbin Hu, Zhiqiang Zhang, Jinjie Gu, and Guannan Zhang. Think- in- memory: Recalling and post- thinking enable llms with long- term memory. arXiv preprint arXiv:2311.08719, 2023.
Adyasha Maharana, Dong- Ho Lee, Sergey Tulyakov, Mohit Bansal, Francesco Barbieri, and Yuwei Fang. Evaluating very long- term conversational memory of llm agents. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 13851- 13870, 2024.
Bodhisattwa Prasad Majumder, Bhavana Dalvi Mishra, Peter Jansen, Oyvind Tafjord, Niket Tandon, Li Zhang, Chris Callison- Burch, and Peter Clark. Clin: A continually learning language agent for rapid task adaptation and generalization. In First Conference on Language Modeling.
Elliot Nelson, Georgios Kollias, Payel Das, Subhajit Chaudhury, and Soham Dan. Needle in the haystack for memory based large language models. arXiv preprint arXiv:2407.01437, 2024.
Charles Packer, Vivian Fang, Shishir G Patil, Kevin Lin, Sarah Wooders, and Joseph E Gonzalez. Memgpt: Towards llms as operating systems. 2023.
Preston Rasmussen, Pavlo Paliychuk, Travis Beauvais, Jack Ryan, and Daniel Chalef. Zep: A temporal knowledge graph architecture for agent memory. arXiv preprint arXiv:2501.13956, 2025.
Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie, and Christopher D Manning. Raptor: Recursive abstractive processing for tree- organized retrieval. In The Twelfth International Conference on Learning Representations, 2024.
Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36:8634- 8652, 2023.
Prabhijot Singh, Prateek Chhikara, and Jasmeet Singh. An ensemble approach for extractive text summarization. In 2020 International Conference on Emerging Trends in Information Technology and Engineering (ic- ETTE), pages 1- 7. IEEE, 2020.
Arpita Soni、Rajeev Arora、Anoop Kumar 和 Dheerendra Panwar。评估低资源生成式聊天机器人中的领域覆盖:使用 BLEU 分数对开放领域和封闭领域方法进行的比较研究。载于 2024 年电气电子与计算技术国际会议(ICEECT),第 1 卷,第 1-6 页。IEEE,2024 年。
Gemini 团队、Petko Georgiev、Ving Ian Lei、Ryan Burnell、Libin Bai、Anmol Gulati、Garrett Tanzer、Damien Vincent、Zhufeng Pan、Shibo Wang 等。Gemini 1.5:解锁跨越数百万 token 上下文的多模态理解。arXiv 预印本 arXiv:2403.05530,2024 年。
Joan C Timoneda 和 Sebastián Vallejo Vera。记忆就是你所需要的一切:测试模型记忆如何影响 LLM 在标注任务中的性能。arXiv 预印本 arXiv:2503.04874,2025 年。
Wujiang Xu、Zujie Liang、Kai Mei、Hang Gao、Juntao Tan 和 Yongfeng Zhang。A-mem:面向 LLM 智能体的智能体记忆。arXiv 预印本 arXiv:2502.12110,2025 年。
Yangyang Yu、Haohang Li、Zhi Chen、Yuechen Jiang、Yang Li、Denghui Zhang、Rong Liu、Jordan W Suchow 和 Khaldoun Khashanah。Finmem:一种具有分层记忆和角色设计的性能增强型 LLM 交易智能体。载于 AAAI 研讨会系列论文集,第 3 卷,第 595-597 页,2024 年。
Jiarui Zhang。引导式画像生成提升了大型语言模型的个性化。载于计算语言学协会研究结果:EMNLP 2024,第 4005-4016 页,2024 年。
Jiarui Zhang、Filip Ilievski、Kaixin Ma、Jonathan Francis 和 Alessandro Oltramari。基于常识知识的零样本适应研究。载于 AKBC,2022 年。
张泽宇、薄小荷、陈晨、李锐、陈旭、戴全宇、朱杰明、董振华和文继荣。基于大语言模型智能体的记忆机制综述。arXiv预印本arXiv:2404.13501,2024年。
钟万俊、郭良红、高琪琪、叶禾和王延林。Memorybank:以长期记忆增强大语言模型。载于《AAAI人工智能会议论文集》,第38卷,第19724-19731页,2024年。
附录
A. 提示词
在开发我们的“LLM作为评判者”(LLM-as-a-Judge)提示词时,我们借鉴了Packer等人(2023)发布的提示词中的要素。
LLM作为评判者的提示词模板
你的任务是将一个问题的答案标注为“CORRECT”或“WRONG”。你将获得以下数据:(1)一个问题(由一位用户向另一位用户提出),(2)一个“黄金”(真实)答案,(3)一个生成答案,你需要将其评分为CORRECT/WRONG。
该问题的要点是询问某位用户基于其先前对话应当了解的关于另一位用户的某些信息。黄金答案通常是一个简洁的短答案,其中包含所提及的主题,例如:
问题:你还记得我上次去夏威夷时得到了什么吗?
黄金答案:一条贝壳项链
生成的答案可能长得多,但你在评分时应保持宽容——只要它涉及与黄金答案相同的主题,就应计为CORRECT。
对于与时间相关的问题,黄金答案将是一个具体日期、月份、年份等。生成的答案可能长得多,或使用相对时间指代(如“上周二”或“下个月”),但你在评分时应保持宽容——只要它指的是与黄金答案相同的日期或时间段,就应计为CORRECT。即使格式不同(例如,“May 7th”与“7 May”),只要是同一日期,就应视为CORRECT。
现在是真正的问题:问题:{question}
黄金答案:{gold_answer}
生成答案:{generated_answer}
首先,提供一段简短(一句话)的推理说明,然后以CORRECT或WRONG结束。不要在你的回答中同时包含CORRECT和WRONG,否则会破坏评估脚本。
只需以json格式返回标签CORRECT或WRONG,键为“label”。
用于结果生成的提示词模板(MEMO)
你是一个智能记忆助手,任务是从对话记忆中检索准确信息。
上下文:
你可以访问一段对话中两位说话者的记忆。这些记忆包含可能有助于回答该问题的时间戳信息。
说明:
1. 仔细分析两位说话者提供的所有记忆 2. 特别注意时间戳以确定答案 3. 如果问题询问的是特定事件或事实,请在记忆中寻找直接证据 4. 如果记忆中包含相互矛盾的信息,优先采用最近的记忆 5. 如果存在关于时间指代的问题(如“去年”“两个月前”等),请根据记忆时间戳计算实际日期。例如,如果2022年5月4日的一条记忆提到“去年去了印度”,那么该旅行发生在2021年。 6. 始终将相对时间指代转换为具体日期、月份或年份。例如,根据记忆时间戳将“去年”转换为“2022”,或将“两个月前”转换为“2023年3月”。回答问题时忽略该指代。 7. 只关注两位说话者记忆的内容。不要将记忆中提到的角色名称与创建这些记忆的实际用户混淆。 8. 答案应少于5-6个词。
方法(逐步思考):
1. 首先,检查所有包含与问题相关信息的记忆 2. 仔细检查这些记忆的时间戳和内容 3. 寻找明确提及的日期、时间、地点或事件来回答问题 4. 如果答案需要计算(例如,转换相对时间指代),请展示你的计算过程 5. 仅基于记忆中的证据,形成精确、简洁的答案 6. 复核你的答案是否直接回答了所问问题 7. 确保你的最终答案具体,并避免模糊的时间指代
用户{speaker_1_user_id}的记忆:{speaker_1_memories}
用户{speaker_2_user_id}的记忆:{speaker_2_memories}
问题:{question}
答案:
用于结果生成的提示词模板(MEMO'S)
(同前)
方法(逐步思考):
1. 首先,检查所有包含与问题相关信息的记忆 2. 仔细检查这些记忆的时间戳和内容 3. 寻找明确提及的日期、时间、地点或事件来回答问题 4. 如果答案需要计算(例如,转换相对时间指代),请展示你的计算过程 5. 分析知识图谱关系以理解用户的知识背景 6. 仅基于记忆中的证据,形成精确、简洁的答案 7. 复核你的答案是否直接回答了所问问题 8. 确保你的最终答案具体,并避免模糊的时间指代
用户{speaker_1_user_id}的记忆:{speaker_1_memories}
用户{speaker_1_user_id}的关系:{speaker_1_graph_memories}
用户{speaker_2_user_id}的记忆:{speaker_2_memories}
用户{speaker_2_user_id}的关系:{speaker_2_graph_memories}
问题:{question}
答案:
用于OpenAI ChatGPT的提示词模板
你能否从这段对话中提取相关信息,并为提到的每位用户创建记忆条目?请将这些记忆连同所提供的时间戳一起存储在你的知识库中,以便未来参考和个性化交互。
(2023年5月8日下午1:56)Caroline:嗨,Mel!很高兴见到你!你最近怎么样?(2023年5月8日下午1:56)Melanie:嗨,Caroline!很高兴见到你!我被孩子和工作忙得不可开交。你怎么样?有什么新鲜事吗?(2023年5月8日下午1:56)Caroline:我昨天去了一个LGBTQ支持小组,那真的很有力量。
B. 算法
算法1 记忆管理系统:更新操作
1:输入:检索到的记忆集合,现有记忆存储
2:输出:更新后的记忆存储
3:过程 UPDATE MEMORY(F, M)
4:对于每个事实执行
5:操作 CLASSIFYOPERATION
根据分类执行相应操作
6:如果操作 ADD则
7: GenerateUniqueID()
8:
添加带有唯一标识符的新事实
9: 否则如果操作 UPDATE 那么
10: FindRelatedMemory
11: 如果 InformationContent InformationContent 那么
12: 替换为更丰富的信息
13: 结束如果
14: 否则如果操作 DELETE 那么
15: FindContradictedMemory
16: 移除矛盾的信息
17: 否则如果操作 NOOP 那么
18:未执行操作 事实已存在或不相关
19:结束 if
20:结束 for
21:返回 M
22:结束过程
23:函数 CLASSIFYOPERATION
24:如果 SemanticallySimilar 则
25:返回 ADD
26:否则如果 Contradicts 则
27:返回 DELETE
28:否则如果 Augments 则
29:返回 UPDATE
30:否则
31:返回 NOOP
32:结束 if
33:结束函数
内存中不存在的新信息
与现有内存冲突的信息
增强内存中现有信息
无需更改
C. 选定的基线
LoCoMo LoCoMo 框架实现了一套复杂的记忆流水线,使 LLM 智能体能够维持连贯的长期对话。其核心在于,该系统将记忆划分为短期和长期组件。在每个对话会话之后,智能体会生成摘要(存储为短期记忆),提炼该交互中的关键信息。同时,单个对话轮次会被转化为“观察”——关于每位说话者人设和生活事件的事实陈述,这些内容存储于长期记忆中,并引用产生它们的特定对话轮次。在生成新回复时,智能体会同时利用最近的会话摘要,并从长期记忆中选取性地检索相关观察。这种双记忆方法还通过引入时间事件图得到进一步增强,该图跟踪对话会话之间发生的、具有因果关联的生活事件。通过以检索到的记忆、当前对话上下文、人设信息以及其间发生的生活事件为条件生成回复,该系统使智能体能够在跨越数百个轮次和数十个会话的对话中保持一致的人格,并回忆起重要细节。
ReadAgent ReadAgent 通过模拟人类处理长篇文本的方式,采用精细的三阶段流水线,解决了 LLM 的根本性局限。首先,在“片段分页”中,系统在自然的认知边界而非任意截断处智能地分割文本。接下来,在“记忆要点化”中,它将每个片段提炼为简洁摘要,在保留核心含义的同时大幅减少 token 数量——类似于人类记忆保留信息实质而非逐字回忆。最后,当被要求回答问题时,“交互式查找”机制会检查这些要点,并策略性地仅检索最相关的原始文本片段进行详细处理。这种受人类启发的方法使 LLM 能够有效处理长度可达其正常上下文窗口 20 倍的文档。通过以要点实现全局理解与对细节的选择性注意之间的平衡,ReadAgent 同时实现了计算效率和理解能力的提升,表明模仿人类认知过程可以显著增强 AI 的文本处理能力。
MemoryBank MemoryBank 系统通过一个精细的三部分流水线为 LLM 增强长期记忆。其核心的“记忆存储”组件存储详细的对话日志、分层事件摘要以及不断演化的用户人格画像。当新交互发生时,“记忆检索”机制采用双塔稠密检索模型来提取上下文相关的过往信息。“记忆更新”组件提供了一种类人的遗忘机制:记忆在被回忆时增强,若未被使用则随时间自然衰减。这种全面的方法使 AI 伴侣能够回忆相关信息、在长时间交互中保持上下文意识,并形成日益准确的用户画像,从而实现更个性化、更自然的长期对话。
MemGPT MemGPT 系统引入了一种受操作系统启发的方法,以克服 LLM 固有的上下文窗口限制。其核心是,MemGPT 采用了一套复杂的记忆管理流水线,由三个关键组件构成:分层记忆系统、自主导向的记忆操作以及基于事件的控制流机制。该系统将可用记忆划分为“主上下文”(类似于传统操作系统中的 RAM)和“外部上下文”(类似于磁盘存储)。主上下文——受 LLM 上下文窗口限制——包含系统指令、近期对话历史以及可由模型修改的工作记忆。外部上下文在模型即时上下文窗口之外存储无限信息,包括完整对话历史和归档数据。当 LLM 需要主上下文中不存在的信息时,它可以发起函数调用,在这些记忆层级中搜索、检索或修改内容,从而有效地将相关信息在其有限的上下文窗口中“分页”调入和调出。这种受操作系统启发的架构使 MemGPT 能够在长时间交互中保持对话连贯性、管理超出标准上下文限制的文档,并执行多跳信息检索任务——同时仍使用固定上下文模型运行。该系统智能管理自身记忆资源的能力营造出无限上下文的错觉,显著扩展了当前 LLM 技术所能实现的范围。
A-Mem A-Mem 模型为 LLM 智能体引入了一种智能体式记忆系统。该系统通过相互连接的笔记动态地构建和演化记忆。每条笔记捕获交互内容,并附带由 LLM 生成的关键词、上下文描述和标签等结构化属性。在创建新记忆时,A-MEM 使用语义嵌入检索相关的现有笔记,然后采用由 LLM 驱动的方法,基于相似性和共享属性建立有意义的链接。至关重要的是,记忆演化机制会在整合新的相关记忆时动态更新现有笔记,细化其上下文信息和属性。因此,记忆结构不断演化,使记忆之间能够形成更丰富、上下文更深入的连接。记忆检索通过语义相似度进行,在智能体交互过程中提供相关的历史上下文