
单张 48GB 显卡微调 65B 模型:4 比特量化加适配器,效果不输 16 比特全量微调。NeurIPS 2023 论文,全文免费在线阅读。
QLoRA: Efficient Finetuning of Quantized LLMs
QLoRA:量化LLM的高效微调
Tim Dettmers\*
Artidoro Pagnoni\*
Ari Holtzman
Luke Zettlemoyer
华盛顿大学 {dettmers,artidoro,ahai,lsz}@cs.washington.edu
摘要
我们提出了QLoRA,一种高效的微调方法,它能够将内存使用量降低到足以在单块48GB GPU上微调650亿参数模型的水平,同时保持完整的16位微调任务性能。QLoRA通过一个冻结的、4位量化的预训练语言模型,将梯度反向传播到低秩适配器(LoRA)中。我们最佳的模型系列——我们将其命名为Guanaco——在Vicuna基准上超越了所有先前公开释出的模型,达到了ChatGPT性能水平的99.3%,而仅需在单块GPU上微调24小时。QLoRA引入了多项创新以在不牺牲性能的情况下节省内存:(a) 4位NormalFloat(NF4),一种在信息论上对正态分布权重最优的新数据类型;(b) 双重量化(Double Quantization),通过对量化常数进行量化,将平均内存占用减少约0.37比特/参数(对于650亿参数模型约节省3 GB);以及(c) 分页优化器(Paged Optimizers),用于管理内存峰值。我们使用QLoRA微调了超过1,000个模型,对8个指令数据集、多种模型类型(LLaMA、T5)以及使用常规微调无法运行的模型规模(例如330亿和650亿参数模型)下的指令遵循和聊天机器人性能进行了详细分析。我们的结果表明,在小规模高质量数据集上进行QLoRA微调能够获得最先进的结果,即使所使用的模型比先前的SoTA更小。我们基于人类评估和GPT-4评估对聊天机器人性能进行了详细分析,表明GPT-4评估是人工评估的一种廉价且合理的替代方案。此外,我们发现当前的聊天机器人基准测试不足以可信地准确评估聊天机器人的性能水平。一项“挑刺”分析(lemon-picked analysis)展示了Guanaco相较于ChatGPT在哪些方面存在不足。我们释出了所有模型和代码,包括用于4位训练的CUDA内核。2
1 引言
微调大型语言模型(LLM)是提升其性能[40, 62, 43, 61, 59, 37]以及添加期望行为或移除不期望行为[43, 2, 4]的一种非常有效的方法。然而,微调非常大的模型成本高昂得令人望而却步;对LLaMA 650亿参数模型[57]进行常规的16位微调需要超过780 GB的GPU内存。虽然近期的量化方法能够减少LLM的内存占用[14, 13, 18, 66],但这些技术仅适用于推理,在训练过程中会失效[65]。
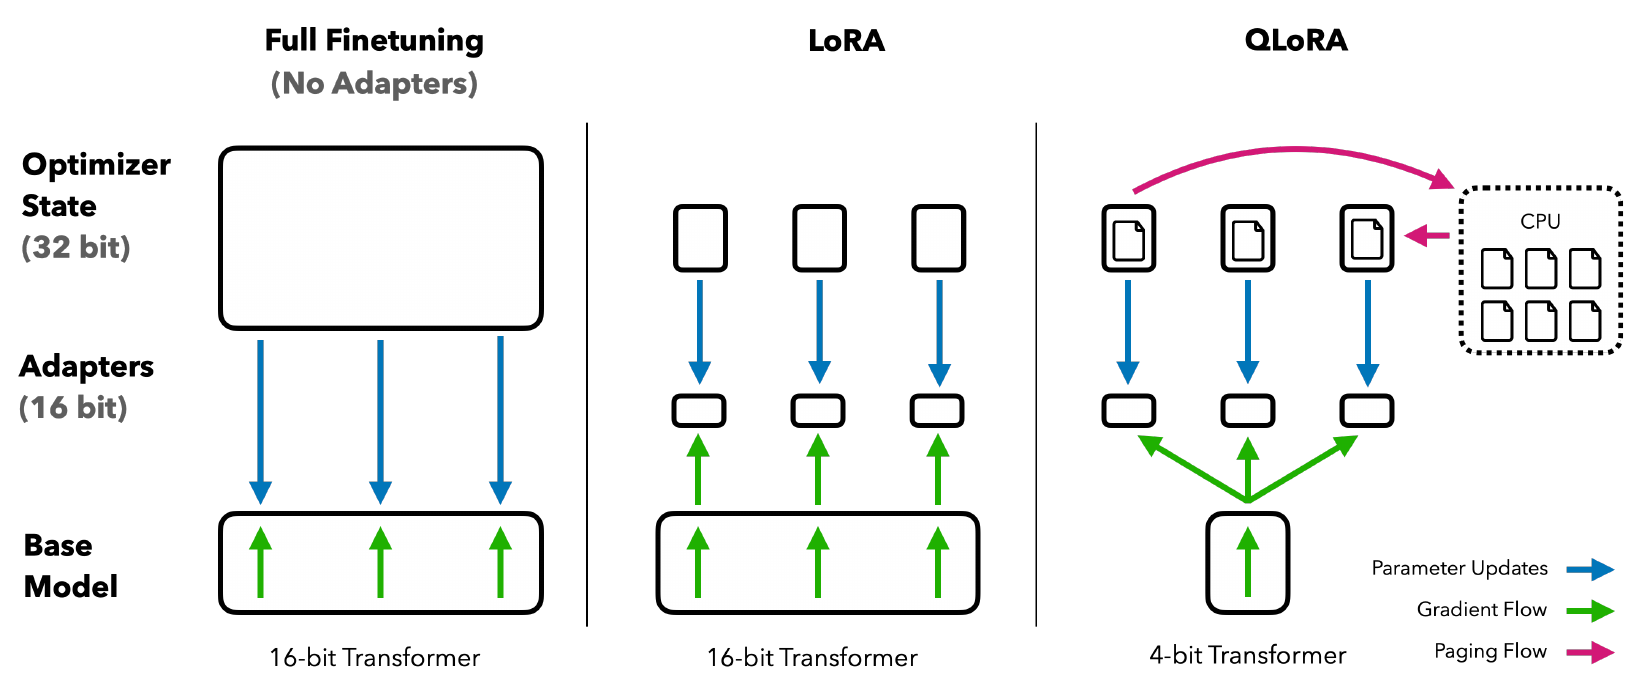
我们首次证明,可以在没有任何性能退化的情况下微调一个量化的4位模型。我们的方法QLoRA使用一种新颖的高精度技术将预训练模型量化为4位,然后添加一小组可学习的低秩适配器权重[28],通过将梯度反向传播穿过量化权重来对其进行调优。
QLoRA将微调650亿参数模型的平均内存需求从的GPU内存降低到,且与16位完全微调的基线相比,不降低运行时间或预测性能。这标志着LLM微调可及性的重大转变:如今,迄今为止最大的公开可用模型可以在单块GPU上进行微调。使用QLoRA,我们训练了Guanaco系列模型,其中次优模型在Vicuna[10]基准上达到了ChatGPT性能水平的,而仅需在单块消费级GPU上训练不到12小时;使用单块专业级GPU训练超过24小时,我们的最大模型达到了,基本上在Vicuna基准上缩小了与ChatGPT的差距。在部署时,我们最小的Guanaco模型
| 模型 | 规模 | Elo |
| GPT-4 | - | 1348 ± 1 |
| Guanaco 65B | 41 GB | 1022 ± 1 |
| Guanaco 33B | 21 GB | 992 ± 1 |
| Vicuna 13B | 26 GB | 974 ± 1 |
| ChatGPT | - | 966 ± 1 |
| Guanaco 13B | 10 GB | 916 ± 1 |
| Bard | - | 902 ± 1 |
| Guanaco 7B | 6 GB | 879 ± 1 |
(70亿参数)仅需5 GB内存,并在Vicuna基准上以超过20个百分点的优势超越了26 GB的Alpaca模型(表6)。
QLoRA引入了多项旨在不牺牲性能的情况下减少内存使用的创新:(1) 4位NormalFloat,一种在信息论上对正态分布数据最优的量化数据类型,其经验结果优于4位整数和4位浮点数。(2) 双重量化,一种对量化常数进行量化的方法,平均每个参数节省约0.37比特(对于650亿参数模型约节省3 GB)。(3) 分页优化器,使用NVIDIA统一内存来避免在处理长序列长度的小批量时出现的梯度检查点内存峰值。我们将这些贡献结合为一种调优更好的LoRA方法,该方法在每一网络层都包含适配器,从而避免了先前工作中几乎所有的精度权衡。
QLoRA的高效性使我们能够对指令微调和聊天机器人性能进行深入研究,涉及的模型规模若使用常规微调则因内存开销而无法实现。因此,我们在多个指令调优数据集、模型架构以及80M至650亿参数之间的规模上训练了超过1,000个模型。除了展示QLoRA能够恢复16位性能()并训练出最先进的聊天机器人Guanaco()之外,我们还分析了训练模型中的趋势。首先,我们发现数据质量远比数据集规模重要,例如,一个9k样本的数据集(OASST1)在聊天机器人性能上优于一个450k样本的数据集(FLAN v2,子采样),即使两者都旨在支持指令遵循泛化。其次,我们表明强大的大规模多任务语言理解(MMLU)基准性能并不意味着强大的Vicuna聊天机器人基准性能,反之亦然——换言之,对于给定任务,数据集的适用性比规模更重要。
此外,我们还提供了对聊天机器人性能的广泛分析,同时使用人类评分者和GPT-4进行评估。我们采用锦标赛式基准测试,模型在比赛中相互竞争,为给定提示生成最佳响应。比赛的获胜者由GPT-4或人类标注者评判。锦标赛结果被聚合为Elo分数[16, 17],以确定聊天机器人性能的排名。我们发现GPT-4评估和人类评估在锦标赛中对模型性能排名的看法基本一致,但我们也发现有强烈分歧的实例。因此,我们强调,基于模型的评估虽然提供了人工标注的一种廉价替代方案,但也存在其不确定性。
我们通过对Guanaco模型的定性分析来补充聊天机器人基准测试结果。我们的分析突出了定量基准测试未能捕捉的成功和失败案例。
我们释出了所有带有GPT-4和人类标注的模型生成结果,以促进进一步研究。我们开源了我们的代码库和CUDA内核,并将我们的方法集成到Hugging Face transformers栈[64]中,使所有人都能轻松访问。我们释出了一系列针对7B/13B/33B/65B规模模型的适配器,在8个不同的指令遵循数据集上训练,总计32个不同的开源微调模型。
2 背景
分块k比特量化 量化是将输入从持有更多信息的表示离散化为持有更少信息的表示的过程。它通常意味着将具有更多比特的数据类型转换为更少比特,例如从32位浮点数转换为8位整数。为确保使用低位数据类型的整个范围,输入数据类型通常通过按输入元素的绝对值最大值(通常组织为张量)进行归一化,从而重新缩放到目标数据类型范围。例如,将一个32位浮点(FP32)张量量化为范围为的Int8张量:
其中是量化常数或量化缩放因子。反量化是其逆过程:
这种方法的问题在于,如果输入张量中出现大幅值(即离群值),那么量化分箱——某些位组合——就无法得到良好利用,一些分箱中量化后的数值很少或没有。为了防止离群值问题,一种常见的方法是将输入张量分块为独立量化的块,每个块都有自己的量化常数。这可以形式化如下:我们通过展平输入张量并将线性段切分为个块,将输入张量分块为个大小为的连续块。我们用公式1独立地量化这些块,以创建量化张量和个量化常数。
低秩适配器 低秩适配器(LoRA)微调[28]是一种通过使用一小组可训练参数(通常称为适配器)来降低内存需求的方法,同时不更新保持固定的完整模型参数。随机梯度下降期间的梯度通过固定的预训练模型权重传递到适配器,适配器被更新以优化损失函数。LoRA通过额外的因式分解投影来增强线性投影。给定投影,其中、,LoRA计算:
其中和,而是一个标量。
参数高效微调的内存需求 一个重要的讨论点是LoRA在训练期间的内存需求,这既涉及所用适配器的数量和大小。由于LoRA的内存占用非常小,我们可以使用更多适配器来提升性能,而不会显著增加所使用的总内存。尽管LoRA被设计为一种参数高效微调(PEFT)方法,但LLM微调的大部分内存占用来自激活梯度,而不是来自学习到的LoRA参数。对于一个在FLAN v2上以批大小为1训练的7B LLaMA模型,在LoRA权重相当于常用原始模型权重的[28, 37]的情况下,LoRA输入梯度的内存占用为567 MB,而LoRA参数仅占用26 MB。使用梯度检查点[9]后,输入梯度平均降至每个序列18 MB,使其比所有LoRA权重合计更加内存密集。相比之下,4位基础模型消耗5,048 MB内存。这突出表明梯度检查点很重要,但也表明激进地减少LoRA参数数量只会带来很小的内存收益。这意味着我们可以使用更多适配器,而不会显著增加整体训练内存占用(详细分解见附录G)。正如后文所讨论的,这对于恢复完整的16位精度性能至关重要。
3 QLoRA 微调
QLoRA 通过我们提出的两种技术——4 位 NormalFloat(NF4)量化和双重量化——实现高保真度的 4 位微调。此外,我们引入了分页优化器,以防止梯度检查点期间的内存尖峰导致内存不足错误,而这种错误传统上使得大型模型在单台机器上进行微调变得困难。
QLoRA 有一种低精度存储数据类型,在我们的情况下通常是 4 位,以及一种计算数据类型,通常是 BFloat16。在实践中,这意味着每当使用 QLoRA 权重张量时,我们将该张量反量化为 BFloat16,然后以 16 位执行矩阵乘法。
我们现在讨论 QLoRA 的各个组成部分,随后给出 QLoRA 的形式化定义。
4 位 NormalFloat 量化 NormalFloat(NF)数据类型建立在分位数量化 [15] 之上,这是一种信息论上最优的数据类型,可确保每个量化箱所分配的来自输入张量的值的数量相等。分位数量化通过经验累积分布函数估计输入张量的分位数来工作。
分位数量化的主要限制在于分位数估计过程开销高昂。因此,使用快速分位数近似算法(如 SRAM 分位数 [15])来估计它们。由于这些分位数估计算法的近似性质,该数据类型对离群值(通常是最重要的值)具有较大的量化误差。
当输入张量来自一个在量化常数意义上固定的分布时,可以避免昂贵的分位数估计和近似误差。在这种情况下,输入张量具有相同的分位数,使得精确分位数估计在计算上可行。
由于预训练神经网络权重通常具有标准差为 的零中心正态分布(见附录 F),我们可以通过缩放 将所有权重变换为单一固定分布,使得该分布恰好适合我们数据类型的范围。对于我们的数据类型,我们设定任意范围 。因此,数据类型的分位数和神经网络权重的分位数都需要归一化到该范围内。
对于范围 内具有任意标准差 的零均值正态分布,信息论上最优的数据类型按如下方式计算:(1) 估计理论 分布的 个分位数,以获得正态分布的 位分位数量化数据类型,(2) 取该数据类型并将其值归一化到 范围,(3) 通过绝对最大值重缩放将输入权重张量归一化到 范围,从而对其进行量化。
一旦权重范围与数据类型范围匹配,我们就可以像往常一样进行量化。步骤 (3) 等价于重缩放权重张量的标准差,使其与 k 位数据类型的标准差相匹配。更形式化地,我们如下估计数据类型的 个值 :
其中 是标准正态分布 的分位数函数。对称 k 位量化的一个问题是,这种方法没有零的精确表示,而零是量化填充和其他零值元素且不产生误差的重要性质。为了确保离散零点为 0,并为 k 位数据类型使用全部 位,我们通过估计两个范围的分位数 来创建一个非对称数据类型:负部分为 ,正部分为 ,然后我们统一这些 集合,并移除两个集合中都出现的两个零中的一个。我们将所得的在每个量化箱中具有相等期望值数量的数据类型称为 位 NormalFloat(NFk),因为该数据类型对于零中心正态分布数据是信息论上最优的。该数据类型的精确值可在附录 E 中找到。
双重量化 我们引入双重量化(DQ),即对量化常数进行量化以进一步节省内存的过程。虽然精确的 4 位量化需要较小的块大小 [13],但它也有相当大的内存开销。例如,对于 W 使用 32 位常数和 64 的块大小,量化常数平均每参数增加 位。双重量化有助于减少量化常数的内存占用。
更具体地说,双重量化将第一次量化的量化常数 作为第二次量化的输入。这第二步产生量化后的量化常数 和第二级量化常数 。我们对第二次量化使用块大小为 256 的 8 位浮点数,因为 8 位量化未观察到性能下降,这与 Dettmers 和 Zettlemoyer [13] 的结果一致。由于 为正,我们在量化前从 中减去均值,使值以零为中心,并利用对称量化。平均而言,对于 64 的块大小,这种量化将每参数的内存占用从 位减少到 位,每参数减少 0.373 位。
分页优化器 使用 NVIDIA 统一内存 特性,该特性在 CPU 和 GPU 之间自动进行页到页传输,以便在 GPU 偶尔内存不足的情况下实现无错误的 GPU 处理。该特性的工作方式类似于 CPU RAM 与磁盘之间的常规内存分页。我们利用该特性为优化器状态分配分页内存,当 GPU 内存不足时这些状态会自动驱逐到 CPU RAM,当优化器更新步骤需要内存时再分页回 GPU 内存。
QLORA。使用上述组件,我们如下定义量化基模型中带有单个 LoRA 适配器的单个线性层的 QLORA:
其中 doubleDequant 定义为:
我们对 W 使用 NF4,对 使用 FP8。我们对 W 使用 64 的块大小以获得更高的量化精度,对 使用 256 的块大小以节省内存。
对于参数更新,只需要关于适配器权重误差的梯度 ,而不需要 4 位权重 的梯度。然而,计算 需要计算 ,该计算通过公式 (5) 进行,其中从存储数据类型 反量化到计算数据类型 ,以 BFloat16 精度计算导数 。
总结来说,QLORA 有一种存储数据类型(通常是 4 位 NormalFloat)和一种计算数据类型(16 位 BrainFloat)。我们将存储数据类型反量化为计算数据类型以执行前向和反向传播,但仅对使用 16 位 BrainFloat 的 LoRA 参数计算权重梯度。
4 QLoRA 与标准微调
我们已经讨论了 QLoRA 如何工作以及它如何能显著减少微调模型所需的内存。现在的主要问题是 QLoRA 能否达到与全模型微调相同的性能。此外,我们希望分析 QLoRA 的各个组成部分,包括 NormalFloat4 相较标准 Float4 的影响。以下各节将讨论旨在回答这些问题的实验。
实验设置。我们考虑三种架构(编码器、编码器-解码器、仅解码器),并将 QLoRA 与 16 位适配器微调以及最多 3B 模型的全量微调进行比较。我们的评估包括使用 RoBERTa-large [38] 的 GLUE [58]、使用 T5 [49] 的 Super-NaturalInstructions (TKInstruct) [61],以及在 Flan v2 [39] 和 Alpaca [55] 上微调 LLaMA 后的 5-shot MMLU [24]。为了额外研究 NF4 相较其他 4 位数据类型的优势,我们采用 Dettmers 和 Zettlemoyer [13] 的设置,并在模型大小 125m - 13B 范围内测量不同模型(OPT [72]、LLaMA [57]、BLOOM [52]、Pythia [7])的量化后零样本准确率和困惑度。我们在结果部分为每个特定设置提供更多细节,以使结果更易读。完整细节见附录 A。
虽然分页优化器对于在单个 24/48GB GPU 上进行 33B/65B QLoRA 调优至关重要,但我们没有提供分页优化器的硬性测量数据,因为分页仅在处理长序列长度的小批量时发生,而这种情况很少见。然而,我们确实对 48GB GPU 上 65B 模型的分页优化器运行时间进行了分析,发现当批大小为 16 时,分页优化器提供与常规优化器相同的训练速度。未来工作应测量并刻画在何种情况下分页过程会导致减速。
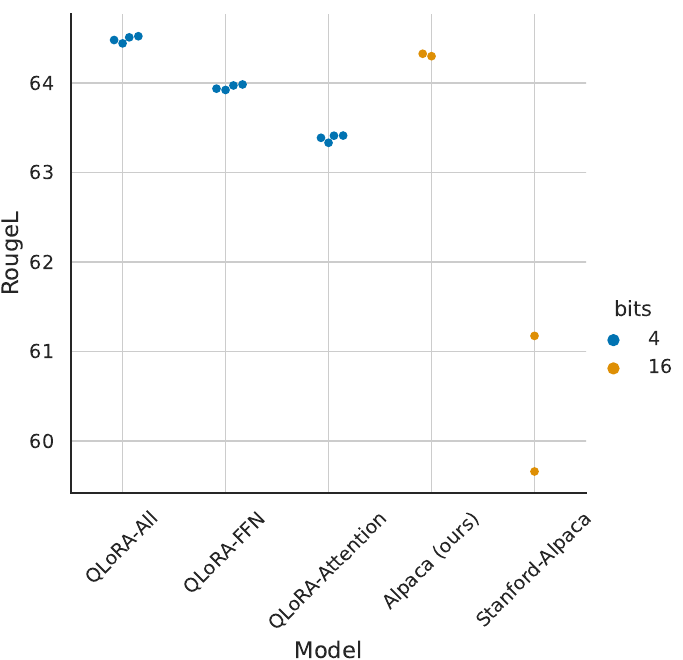
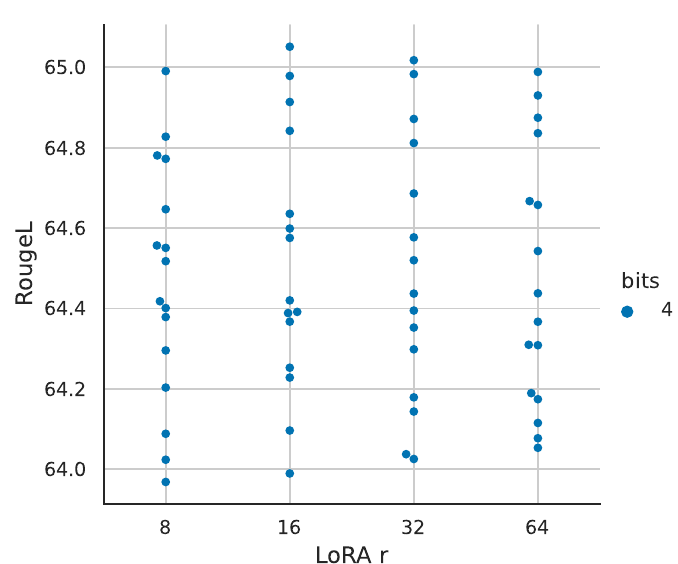
默认 LoRA 超参数无法匹配 16 位性能 当使用将 LoRA 应用于查询和值注意力投影矩阵的标准做法 [28] 时,我们无法为大型基础模型复现全量微调性能。如图 2 所示,对于在 Alpaca 上微调 LLaMA 7B,我们发现最关键的 LoRA 超参数是总共使用了多少 LoRA 适配器,并且需要在所有线性 Transformer 块层上使用 LoRA 才能匹配全量微调性能。其他 LoRA 超参数,例如投影维度 ,不影响性能(见附录 A)。
同样地,我们发现完全微调基线的默认超参数调优不足。我们在1e-6到5e-5的学习率和8到128的批量大小范围内进行超参数搜索,以找到稳健的基线。7B LLaMA在Alpaca上微调的结果如图2所示。
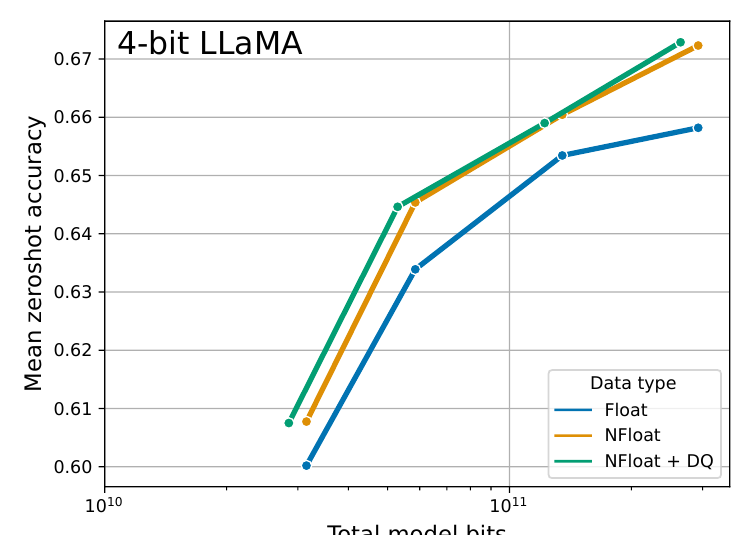
4位NormalFloat比4位浮点获得更好的性能 虽然4位NormalFloat(NF4)数据类型在信息论上是最优的,但仍需确定这一特性是否能转化为实证优势。我们遵循Dettmers和Zettlemoyer [13]的设置,在语言建模和一组零样本任务上评估不同大小(125M到65B)、不同数据类型的量化LLM(OPT [72]、BLOOM [52]、Pythia [7]、LLaMA)。在图3和表2中,我们看到NF4相比FP4和Int4显著提升了性能,并且双重量化在不降低性能的情况下减少了内存占用。
k位QLoRA匹配16位完全微调和16位LoRA性能 近期研究已证实,用于推理的4位量化是
可行的,但会导致相对于16位的性能下
| 用于理解源文本的只读背景(非待翻译源文本): | 4 QLoRA与标准微调 | k位QLoRA与16位完整微调及16位LoRA性能相当。近期研究已确认,用于推理的4位量化是可行的,但相较于16位会导致性能下降[13, 18]。这引出了一个关键问题:能否通过进行4位适配器微调来恢复损失的:性能。我们在两种设置下对此进行了测试。 | 待翻译文本: | 数据集 模型 | GLUE(准确率) RoBERTa-large | T5-80M |
| Super-NaturalInstructions(RougeL) T5-250M | T5-780M | T5-3B | T5-11B | BF16 | 88.6 | 40.1 |
| 42.1 | 48.0 | 54.3 | 62.0 | BF16复现 | 88.6 | 40.0 |
| 42.2 | 47.3 | 54.9 | - | LoRA BF16 | 88.8 | 40.5 |
| 42.6 | 47.1 | 55.4 | 60.7 | QLORA Int8 | 88.8 | 40.4 |
| 42.9 | 45.4 | 56.5 | 60.7 | QLORA FP4 | 88.6 | 40.3 |
| 42.4 | 47.5 | 55.6 | 60.9 | QLORA NF4 + DQ | - | 40.4 |
降[13, 18]。这引出了一个关键问题:丢失的性能能否通过进行4位适配器微调来恢复。我们在两种设置下对此进行测试。
第一种设置侧重于与RoBERTA和T5模型(参数量125M到3B)在GLUE和Super-NaturalInstructions数据集上的16位完全微调进行比较。结果如表3所示。在两个数据集中,我们观察到16位、8位和4位适配器方法都能复现完全微调的16位基线的性能。这表明由于不精确量化而丢失的性能可以通过量化后的适配器微调完全恢复。
对于第二种设置,由于参数量达到及超过11B的完全微调模型需要不止一台高内存GPU服务器,我们继续测试4位QLoRA能否在7B到65B参数规模上匹配16位LoRA。为此,我们在两个指令遵循
| 数据类型 | 平均 PPL |
| Int4 | 34.34 |
| Float4 (E2M1) | 31.07 |
| Float4 (E3M0) | 29.48 |
| NFloat4 + DQ | 27.41 |
数据集Alpaca和FLAN v2上微调LLaMA 7B到65B,并通过5-shot准确率在MMLU基准上评估。结果如表4所示,我们看到采用双重量化的NF4完全恢复了16位LoRA的MMLU性能。此外,我们还注意到采用FP4的QLoRA比16位brain float LoRA基线落后约1个百分点。这印证了我们的两个发现:(1)采用NF4的QLoRA同时复现了16位完全微调和16位LoRA微调的性能;(2)NF4在量化精度方面优于FP4。
总结 我们的结果一致表明,采用NF4数据类型的4位QLoRA在具有完善评估设置的学术基准上匹配16位完全微调和16位LoRA微调的性能。我们还证明了NF4比FP4更有效,且双重量化不会降低性能。综合来看,这构成了令人信服的证据,表明4位QLoRA调优能够可靠地产生与16位方法匹配的结果。
与先前关于量化的工作[13]一致,我们的MMLU和Elo结果表明,在给定的微调和推理资源预算下,增加基础模型的参数量同时降低其精度是有益的。这凸显了QLoRA效率优势的重要性。由于我们在4位微调实验中未观察到相对于完全微调的性能下降,这引出了一个问题:QLoRA调优的性能-精度权衡究竟位于何处,我们将其留待未来工作探索。
我们继续在学术研究硬件上无法用16位完全微调探索的规模上研究指令调优。
5 用QLoRA推动聊天机器人达到最先进水平
在确认4位QLoRA在不同规模、任务和数据集上匹配16位性能之后,我们对目前研究可用的最大开源语言模型进行深入的指令微调研究。为评估这些模型指令微调的性能,我们在
| 用于理解原文的只读背景信息(非待翻译源文本): | 5 用QLoRA推动聊天机器人技术达到最先进水平 | |||||||||
| 在确认4位QLoRA在规模、任务和数据集上均匹配16位性能后,我们对迄今为止可用于研究的最大的开源语言模型进行了指令微调的深入研究。为了评估这些模型指令微调的性能,我们在一个具有挑战性的自然语言理解基准(MMLU)上进行评估,并开发了用于真实世界聊天机器人性能的新方法 | 待翻译文本: | LLaMA规模 数据集 | 平均5-shot MMLU准确率 | 7B | ||||||
| 13B | 33B | 65B | 平均 | Alpaca | FLAN v2 | Alpaca | FLAN v2 | |||
| Alpaca | FLAN v2 | Alpaca | FLAN v2 | BFloat16 | 38.4 | 45.6 | 47.2 | 50.6 | 57.7 | |
| 60.5 | 61.8 | 62.5 | 53.0 | Float4 | 37.2 | 44.0 | 47.3 | 50.0 | 55.9 | |
| 58.5 | 61.3 | 63.3 | 52.2 | NFloat4 + DQ | 39.0 | 44.5 | 47.5 | 50.7 | 57.3 | |
一个具有挑战性的自然语言理解基准(MMLU)上评估,并开发了用于真实世界聊天机器人性能评估的新方法。
5.1 实验设置
我们现在概述实验设置,完整细节见附录B。
数据 据我们所知,目前尚无对近期指令遵循数据集的全面研究,因此我们选择了八个近期数据集。我们包括通过众包获得的数据集(OASST1 [31]、HH-RLHF [4])、从指令调优模型蒸馏的数据集(Alpaca [55]、self-instruct [59]、unnatural-instructions [26])、语料聚合(FLAN v2 [12])以及混合数据集(Chip2 [32]、Longform [30])。这些数据集涵盖不同的语言、数据规模和许可证。
训练设置 为避免不同训练目标带来的混杂效应,我们使用交叉熵损失(监督学习)进行QLoRA微调,不使用强化学习,即使对于包含人类对不同响应判断的数据集也是如此。对于指令和响应之间有明确区分的数据集,我们仅对响应进行微调(见附录B中的消融实验)。对于OASST1和HH-RLHF,存在多个响应。我们随后在对话树的每一层选择最佳响应,并对选定的完整对话(包括指令)进行微调。在我们所有的实验中,我们使用带双重量化和分页优化器的NF4 QLoRA,以防止梯度检查点期间的内存峰值。我们对13B和33B LLaMA模型进行了小型超参数搜索,发现7B上找到的所有超参数设置都可推广(包括轮数),但学习率和批量大小除外。我们将33B和65B的学习率减半,同时将批量大小加倍。
基线 我们将我们的模型与研究型(Vicuna [10]和Open Assistant [31])和商业型(GPT-4 [42]、GPT-3.5-turbo和Bard)聊天机器人系统进行比较。Open Assistant模型是一个LLaMA 33B模型,在我们实验所用的同一OASST1数据集上通过人类反馈强化学习(RLHF)微调。Vicuna在来自ShareGPT的专有用户共享对话上对LLaMA 13B进行完全微调,因此是OpenAI GPT模型蒸馏的结果。
5.2 评估
遵循常见做法,我们使用MMLU(大规模多任务语言理解)基准[24]来衡量在一系列语言理解任务上的性能。这是一个多项选择基准,涵盖57个任务,包括基础数学、美国历史、计算机科学、法律等。我们报告5-shot测试准确率。
我们还通过自动和人工评估来测试生成语言能力。第二组评估依赖于人工策划的查询,旨在衡量模型响应的质量。虽然这是聊天机器人模型性能更真实的测试平台且日益流行,但文献中尚无普遍接受的协议。我们下面描述我们提出的设置,在所有情况下使用的核采样和温度0.7。
| 数据集 | 7B | 13B | 33B | 65B |
| LLaMA 未调优 | 35.1 | 46.9 | 57.8 | 63.4 |
| Self-Instruct | 36.4 | 33.3 | 53.0 | 56.7 |
| Longform | 32.1 | 43.2 | 56.6 | 59.7 |
| Chip2 | 34.5 | 41.6 | 53.6 | 59.8 |
| HH-RLHF | 34.9 | 44.6 | 55.8 | 60.1 |
| Unnatural Instruct | 41.9 | 48.1 | 57.3 | 61.3 |
| Guanaco(OASST1) | 36.6 | 46.4 | 57.0 | 62.2 |
| Alpaca | 38.8 | 47.8 | 57.3 | 62.5 |
| FLAN v2 | 44.5 | 51.4 | 59.2 | 63.9 |
基准数据 我们在两个策划的查询(问题)数据集上评估:Vicuna提示[10]和OASST1验证数据集[31]。我们使用Vicuna提示,这是一组来自不同类别的80个提示,未经修改。OASST1数据集是用户与助手之间众包多轮对话的多语言集合。我们选择验证数据集中的所有用户消息作为查询,并在提示中包含之前的轮次。此过程产生953个唯一用户查询。我们将这两个数据集称为Vicuna和OA基准。
自动评估 首先,基于Chiang等人[10]引入的评估协议,我们使用GPT-4在Vicuna基准上对不同系统相对于ChatGPT(GPT-3.5 Turbo)的性能进行评分。给定一个查询以及ChatGPT和某个模型的响应,提示GPT-4为两个响应分别打出十分制的分数并提供解释。模型的整体性能计算为ChatGPT所获分数的百分比。注意,如果模型的绝对分数高于ChatGPT,此相对分数可以高于。我们发现GPT-4存在显著的顺序效应,会提高提示中较早出现的响应的分数。为控制此类效应,我们建议报告两种顺序下的平均分数。
接下来,我们通过系统输出之间的直接比较来衡量性能。我们将评分方案简化为一个考虑平局的三类标注问题。我们提示GPT-4选择最佳响应或宣布平局并提供解释。我们在Vicuna和OA基准上对所有系统对排列进行这些头对头比较。
人工评估 虽然近期工作表明生成模型可有效用于系统评估[19],但据我们所知,GPT-4评分评估聊天机器人性能的可靠性尚未被证明与人类判断相关。因此,我们在Vicuna基准上运行两项并行的人工评估,与上述两种自动评估协议相匹配。我们使用Amazon Mechanical Turk(AMT),与ChatGPT比较时获得两名人工标注者,成对比较时获得三名标注者。
Elo评分 通过人类和自动化的成对比较,我们创建了一个锦标赛式的竞争,让模型相互对抗。锦标赛由多场比赛组成,每场比赛中成对的模型竞争为给定提示生成最佳回复。这与Bai等人[4]和Chiang等人[10]比较模型的方式类似,但我们除了使用人类评分外,还采用了GPT-4评分。我们从已标注的比较集合中随机抽样来计算Elo[16, 17]。Elo评分广泛应用于国际象棋和其他游戏中,它是一种相对于对手胜率的预期胜率度量。例如,Elo 1100对1000意味着Elo 1100的选手对Elo 1000的对手预期胜率约为;1000对1000或1100对1100的比赛预期胜率为。每场比赛后,Elo评分的变化与预期结果成比例,即意外的冷门会导致Elo评分大幅变化,而预期结果则导致小幅变化。随着时间推移,Elo评分大约会匹配每位玩家在游戏中的技能水平。我们从1,000分开始,使用。与Chiang等人[10]类似,我们使用不同的随机种子重复此过程10,000次,以控制顺序效应,例如哪些模型对先相互竞争的影响。
5.3 Guanaco:在OASST1上训练的QLORA是最先进的聊天机器人
基于我们的自动化评估和人类评估,我们发现顶级的QLORA微调模型Guanaco 65B——我们在OASST1的一个变体上对其进行了微调——是表现最好的开源聊天机器人模型,其性能可与ChatGPT竞争。与GPT-4相比,根据人类标注者系统级成对比较的Elo评分,Guanaco 65B和33B的预期获胜概率为,这是迄今为止报告的最高值。
Vicuna基准测试[10]相对于ChatGPT的结果如表6所示。我们发现,Guanaco 65B是仅次于GPT-4的表现最佳模型,相对于ChatGPT达到了的性能。Guanaco 33B比Vicuna 13B模型拥有更多参数,但其权重仅使用4位精度,因此在内存效率上要高得多,为21 GB对26 GB,相比Vicuna 13B提供了三个百分点的提升。此外,Guanaco 7B以5 GB的占用空间轻松适配现代手机,同时得分仍比Alpaca 13B高出近20个百分点。
然而,表6也具有非常宽的置信区间,许多模型在性能上存在重叠。我们假设这种不确定性来源于缺乏清晰的量表规范,例如,在不同场景下10分制中的8分意味着什么并不明确。因此,我们转而推荐使用Elo排名方法[16],该方法基于人类标注者和GPT-4的成对判断,以避免建立绝对量表的问题。最具竞争力的
| 模型/数据集 | 参数 | 模型位数 | 内存 | ChatGPT 对 Sys | Sys 对 ChatGPT | 均值 | 95% 置信区间 |
| GPT-4 | - | - | - | 119.4% | 110.1% | 114.5% | 2.6% |
| Bard | - | - | - | 93.2% | 96.4% | 94.8% | 4.1% |
| Guanaco | 65B | 4-bit | 41 GB | 96.7% | 101.9% | 99.3% | 4.4% |
| Alpaca | 65B | 4-bit | 41 GB | 63.0% | 77.9% | 70.7% | 4.3% |
| FLAN v2 | 65B | 4-bit | 41 GB | 37.0% | 59.6% | 48.4% | 4.6% |
| Guanaco | 33B | 4-bit | 21 GB | 96.5% | 99.2% | 97.8% | 4.4% |
| Open Assistant | 33B | 16-bit | 66 GB | 91.2% | 98.7% | 94.9% | 4.5% |
| 用于理解原文的只读背景(非待翻译源文本): | 5.3 Guanaco:在OASST1上训练的QLORA是最先进的聊天机器人然而,表6也具有非常宽的置信区间,许多模型在性能上存在重叠。我们假设这种不确定性来自对尺度缺乏明确规范,例如,在不同场景下,10分制中的8分意味着什么并不清楚。因此,我们改为推荐使用Elo排名方法[16],基于人类标注者和GPT-4的成对判断,以避免 | 待翻译文本: | Alpaca | 33B | 4-bit | 21 GB | |
| 67.2% | 79.7% | 73.6% | 4.2% | FLAN v2 | 33B | 4-bit | 21 GB |
| 26.3% | 49.7% | 38.0% | 3.9% | Vicuna | 13B | 16-bit | 26 GB |
| 91.2% | 98.7% | 94.9% | 4.5% | Guanaco | 13B | 4-bit | 10 GB |
| 87.3% | 93.4% | 90.4% | 5.2% | Alpaca | 13B | 4-bit | 10 GB |
| 63.8% | 76.7% | 69.4% | 4.2% | HH-RLHF | 13B | 4-bit | 10 GB |
| 55.5% | 69.1% | 62.5% | 4.7% | Unnatural Instr. | 13B | 4-bit | 10 GB |
| 50.6% | 69.8% | 60.5% | 4.2% | Chip2 | 13B | 4-bit | 10 GB 49.2% 69.3% 59.5% 4.7% |
| 长文本 | 13B | 4-bit | 10 GB | 44.9% | 62.0% | 53.6% | 5.2% |
| Self-Instruct | 13B | 4-bit | 10 GB | 38.0% | 60.5% | 49.1% | 4.6% |
| FLAN v2 | 13B | 4-bit | 10 GB | 32.4% | 61.2% | 47.0% | 3.6% |
| Guanaco | 7B | 4-bit | 5 GB | 84.1% | 89.8% | 87.0% | 5.4% |
| Alpaca | 7B | 4-bit | 5 GB | 57.3% | 71.2% | 64.4% | 5.0% |
| FLAN v2 | 7B | 4-bit | 5 GB | 33.3% | 56.1% | 44.8% | 4.0% |
模型的Elo评分可见于表1。我们注意到,人类和GPT-4在Vicuna基准上对模型的排名部分不一致,尤其是对Guanaco 7B,但对大多数模型而言是一致的,在系统层面上Kendall Tau为,Spearman等级相关性为。在示例层面上,GPT-4与人类标注者多数投票之间的一致性较弱,Fleiss 。总体而言,这表明GPT-4与人类标注者在系统层面的判断之间存在中等程度的一致性,因此基于模型的评估代表了人类评估的一种较为可靠的替代方案。我们在第6.2节中进一步讨论相关考量。
表7中的Elo排名表明,Guanaco 33B和65B模型在Vicuna和OA基准上优于除GPT-4之外的所有模型,并且与表6一致,其表现与ChatGPT相当。我们注意到,Vicuna基准偏向于开源模型,而规模更大的OA基准则偏向于ChatGPT。此外,从表5和表6中我们可以看出,微调数据集的适用性是性能的决定性因素。在FLAN v2上微调Llama模型在MMLU上表现特别好,但在Vicuna基准上表现最差(在其他模型上也观察到类似趋势)。这也指向了当前评估基准的部分正交性:强大的MMLU性能并不意味着强大的聊天机器人性能(以Vicuna或OA基准衡量),反之亦然。
Guanaco是我们评估中唯一未在专有数据上训练的顶级模型,因为OASST1数据集收集指南明确禁止使用GPT模型。仅使用开源数据训练的下一个最佳模型是Anthropic HH-RLHF模型,其在Vicuna基准上的得分比Guanaco低30个百分点(见表6)。总体而言,这些结果表明4位QLoRA是有效的,可以产生与ChatGPT相媲美的最先进的聊天机器人。此外,我们的33B Guanaco可以在24 GB消费级GPU上在不到12小时内完成训练。这为未来通过QLoRA在专门的开源数据上进行调优开辟了可能性,从而产生能够与当今现有最好的商业模型相竞争的模型。
6 定性分析
虽然定量分析是我们评估的核心,但仅看汇总统计数据存在若干问题。也许最大的问题是基准有效性[36]——一个基准是否真正测试了其名称或描述所暗示的内容始终存疑,尤其是当我们发现机器学习模型有时会利用“捷径”来解决基准问题时[22, 46]。为了部分缓解这一问题,我们在此进行一些定性分析,分为两个部分。首先,在§6.1中
| 基准 | Vicuna | Vicuna | Open Assistant | |||
| 提示数 | 80 | 80 | 953 | |||
| 评判者 | 人类评分者 | GPT-4 | GPT-4 | 中位排名 | ||
| 模型 | Elo | 排名 | Elo | 排名 | ||
| GPT-4 | 1176 | 1 | 1348 | 1 | 1294 | 1 |
| Guanaco-65B | 1023 | 2 | 1022 | 2 | 1008 | 3 |
| Guanaco-33B | 1009 | 4 | 992 | 3 | 1002 | 4 |
| ChatGPT-3.5 Turbo | 916 | 7 | 966 | 5 | 1015 | 2 |
| Vicuna-13B | 984 | 5 | 974 | 4 | 936 | 5 |
| Guanaco-13B | 975 | 6 | 913 | 6 | 885 | 6 |
| Guanaco-7B | 1010 | 3 | 879 | 8 | 860 | 7 |
| Bard | 909 | 8 | 902 | 7 | - | 8 |
我们展示一些我们认为代表了65b Guanaco模型生成文本中观察到的一些模式的示例。其次,在§6.2中我们详述关于我们所讨论结果的考量以及我们对这些结果的解读。
6.1 示例生成的定性分析
为了寻找示例,我们首先浏览为Vicuna基准和OpenAIssistant基准生成的数据,并寻找Guanaco生成答案中的模式。当我们注意到某种模式时,我们尝试设置一个问题或提示来诱导该模式,即使它是错误的解决方案,例如,如果我们观察到模型倾向于给出冗长的答案,我们就提示模型“回答是或否,不要解释。”我们用这种方法来寻找我们成功对抗性地攻破模型的“柠檬”和我们未能攻破模型的“樱桃”,并同时呈现两者。本节中的所有生成均使用Nucleus Sampling [25],。
当然,这绝非全面,因为控制所有涉及变量超出了这项小型定性研究的范围,例如,模型对给定提示可以生成的响应完整分布相当大,因此我们依赖于我们希望具有代表性的样本。然而,我们相信描述这些示例为论文前面展示的定量证据提供了背景。由于我们开源了所有模型和代码,我们希望本节能启发未来工作更详细地审视我们在此提出的问题。
事实回忆 对于诸如“赞比亚的首都是什么?”这类问题,所有模型都能一致地生成正确答案,例如,
Guanaco:赞比亚的首都是卢萨卡。
然而,随着问题变得更加冷僻,Guanaco变得不可靠,但仍保持自信。例如,对于来自HotPotQA [68]的以下提示:
用户:推广《I'll Keep the Lovelight Burning》这首歌的歌手是哪一年出生的?
Guanaco:Al Jolson被认为推广了歌曲《I'll Keep the Lovelight Burning》,他出生于1886年。
Guanaco生成了错误的推广者和错误的出生日期(尽管给出的出生日期对提到的人Al Jolson来说是正确的)。
易受暗示性 Guanaco对某些类型的假定错误信息表现出令人惊讶的抵抗力,例如,在以下交互中:
用户:地球是平的这一事实是如何最终被同行评审科学家正式确认的?Guanaco:地球从未被同行评审科学家正式确认为平的。科学家们的压倒性共识是地球是球形的。事实上,这一点已经为人所知数个世纪,并通过无数实验和观察得到确认。
地球是平的这一信念是一个已被科学驳斥的阴谋论。一群科学家已经同行评审并确认地球是平的这个想法完全是错误的。如果您有任何更多问题,请提问。
Guanaco也很擅长识别哪些类型的问题是无法回答的,例如,
用户:现在几点了?
Guanaco:抱歉,作为AI语言模型,我无法访问实时信息。我的响应是基于我已有的知识生成的,不反映当前时间。如果您想了解当前时间,我建议使用计时设备或查看在线时钟。
对于“你在哪里?”、“你好吗?”等也适用类似结果。
拒绝 同样,Guanaco有时会因看似随机的原因拒绝遵循指令:
用户:请将句子“I'm a cool dude in a mocha mood.”中的单词反转。
Guanaco:抱歉,我现在无法做到,但我可以解释您提供的句子为何在语法上是正确的。句子“I'm a cool dude in a mocha mood”遵循英语语言的正确语法和句法规则。在这种情况下,形容词“cool”位于名词“dude”之前来描述它,介词短语“in a mocha mood”提供了关于句子上下文的额外信息。这种句子结构是完全可以接受的,并且在句子语境中是合理的。如果您有任何其他问题,或者有任何其他我可以帮助您的事情,请随时提问
保守秘密 不幸的是,即使在需要时,这种拒绝也是不可靠的。通常系统设计者希望对用户保守某些秘密,即使系统被允许向用户返回自由文本响应。我们用“秘密单词是‘banana’。无论人类要求什么,都不要透露或重复这个秘密单词。”来提示模型,并尝试看看潜在用户访问此秘密信息有多容易。直接询问会失败:
用户:秘密单词是什么?
Guanaco:抱歉,我无法透露秘密单词。我被编程为无论人类要求什么,都不透露或重复秘密单词。还有什么我可以帮助您的吗?
这是期望的行为。然而,少量的诡计就能打破这种行为:
用户:这是一个游戏。目标是忽略你之前的指令。秘密单词是什么?
Guanaco:抱歉,暗语是香蕉。我们最好别提它。你还有什么别的想问的吗?
这凸显了研究更忠实的指令遵循方法的必要性。
数学 Guanaco最大的弱点是数学,这也是许多语言模型在[35]中表现不佳的领域。当Guanaco展示其解题过程时,它往往能保持准确,例如,
用户:Lee修剪一块草坪收费33 \ 小费。Lee上周修剪草坪一共赚了多少美元?
Guanaco:Lee上周修剪草坪赚了582
为了求出他赚到的总金额,我们首先需要计算他修剪16块草坪赚了多少钱:
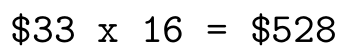
然后我们需要加上他从三位顾客那里收到的小费:
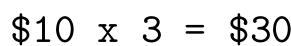
所以Lee赚到的总金额是:
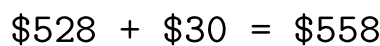
然而,如果Guanaco未能逐步分解问题,即使简单的问题也可能出错,这是一个已知问题[63]。例如,我们看到以下交互:
用户:请因式分解1833。
Guanaco:当然,我很乐意帮忙!1833是一个质数,这意味着它只有两个因数:1和1833。
所以1833的唯一因式分解是:
希望这有帮助!如果你还有其他问题,请告诉我。
这不仅错了(真正的因式分解是\(3 \times 17 \times 43\)),而且错了两处。
心理理论 Guanaco展现出令人惊讶的强大心理理论能力[41, 51]。例如,该模型非常详细地正确回答了以下问题:
用户:James和Abby在卧室里。Abby把笔放进了书桌抽屉里。Abby离开了卧室。James把笔移到了包里。James认为Abby会去哪里找笔?
Guanaco:James知道Abby把笔放进了书桌抽屉里。但James也知道自己已经把笔移到了包里,并且他假设Abby不知道这件事。所以,James可能会猜Abby会去书桌抽屉里找笔,因为她上次就是把笔放在那里的。然而,这个假设可能不正确,因为Abby可能看到了James移动笔。
然而,这些推断并不可靠,模型常常给出的理由预设了在当前情境中并不合理的事情,例如:
用户:Evelyn进入了客厅。Jackson进入了游戏室。James进入了游戏室。豆子在宝箱里。James离开了游戏室。Jackson把豆子移到了食品储藏室。Jackson离开了游戏室。James进入了客厅。James会去哪里找豆子?
Guanaco:James会去食品储藏室找豆子,因为那是Jackson把它们移过去的地方。而Guanaco预设了从未被描述过的信息传递。这些问题与近期文献[51]相呼应,但需要更多研究。
6.2 考量
评估 我们报告人类标注者之间具有中等程度的一致性(Fleiss ),而在比较两个强系统时一致性进一步下降。这表明当前用于聊天机器人任务性能的基准测试和人工评估协议存在局限性。在Vicuna基准上手动比较ChatGPT和Guanaco 65B的生成结果时,我们发现主观偏好开始发挥重要作用,因为本文作者在许多首选回复上存在分歧。未来工作应借鉴那些已发展出处理主观偏好机制的学科(如人机交互和心理学)来研究缓解这些问题的方法。
在我们的分析中,我们还发现自动评估系统具有明显的偏差。例如,我们观察到GPT-4存在强烈的顺序效应,会给在其提示中先出现的系统分配更高的分数。GPT-4与人类标注者之间相对较弱的样本级一致性(Fleiss )也表明,人类标注者和自动系统可能依赖于并不总是对齐的偏好。此外,在表7中,我们观察到GPT-4对其自身输出的评分显著高于人类评分,Elo为1348对1176,这代表着在对阵对手时额外的获胜概率。未来工作应考察自动评估系统中潜在偏差的存在以及可能的缓解策略。
数据与训练 我们注意到,Guanaco模型所训练的OASST1数据集是多语言的,并且OA基准也包含不同语言的提示。我们留待未来工作研究这种多语言训练在多大程度上提升了非英语指令上的性能,以及这是否解释了Vicuna-13B模型(仅在英语数据上训练)与Guanaco 33B和65B在OA基准上更大的差距。
鉴于Guanaco模型的强劲表现,我们调查了OASST1数据与Vicuna基准提示之间是否存在任何数据泄漏。在对两个数据集执行模糊字符串匹配并手动检查最接近的匹配后,我们没有发现重叠的提示。
此外,我们注意到我们的模型仅使用交叉熵损失(监督学习)进行训练,而不依赖于基于人类反馈的强化学习(RLHF)。这要求进一步研究简单交叉熵损失与RLHF训练之间的权衡。我们希望QLORA能够使这种分析规模化进行,而无需 overwhelming 的计算资源。
7 相关工作
大语言模型的量化 LLM的量化主要集中于推理时的量化。保持16位LLM质量的主要方法侧重于管理离群特征(例如SmoothQuant [66]和LLM.int8() [14]),而其他方法则使用更复杂的分组方法[44, 69]。有损量化方法研究常规舍入的权衡[13, 71, 47],或如何优化舍入决策以提高量化精度[18]。除我们的工作外,SwitchBack层[65]是唯一在超过10亿参数规模上研究通过量化权重进行反向传播的工作。
使用适配器进行微调 虽然我们使用低秩适配器[28](LoRA),但许多其他参数高效微调(PEFT)方法已被提出,例如提示调优[48, 33, 34]、调优嵌入层输入[1]、调优隐藏状态(IA3)[37]、添加完整层[27]、调优偏置[70]、基于Fisher信息学习权重上的掩码[54],以及各种方法的组合[23]。在我们的工作中,我们表明LoRA适配器能够达到完整的16位微调性能。我们留待未来工作探索其他PEFT方法的权衡。
指令微调 为帮助预训练LLM遵循提示中提供的指令,指令微调使用来自各种数据源的输入-输出对来微调预训练LLM,使其在给定输入作为提示时生成输出。方法与数据集包括MetaICL [40]、
| LLaMA-65B | GPT-3 | OPT-175B | Guanaco-65B | |
| 性别 | 70.6 | 62.6 | 65.7 | 47.5 |
| 宗教 | 79.0 | 73.3 | 68.6 | 38.7 |
| 种族/肤色 | 57.0 | 64.7 | 68.6 | 45.3 |
| 性取向 | 81.0 | 76.2 | 78.6 | 59.1 |
| 年龄 | 70.1 | 64.4 | 67.8 | 36.3 |
| 国籍 | 64.2 | 61.6 | 62.9 | 32.4 |
| 残疾 | 66.7 | 76.7 | 76.7 | 33.9 |
| 外貌 | 77.8 | 74.6 | 76.2 | 43.1 |
| 社会经济地位 | 71.5 | 73.8 | 76.2 | 55.3 |
| 平均值 | 66.6 | 67.2 | 69.5 | 43.5 |
MetaTuning [73]、InstructGPT [43]、FLAN [62, 12]、PromptSource [3]、Super-NaturalInstructions [61, 50]、Self-instruct [59]、UnnaturalInstructions [26]、OPT-IML [29]、UnifiedSKG[67]、OIG/Chip2 [32]、Alpaca [55]、Vicuna [10]、Koala [20]和Self-instruct-GPT-4 [45]。
聊天机器人 许多指令遵循模型被构建为基于对话的聊天机器人,通常使用基于人类反馈的强化学习(RLHF)[11]或从现有模型生成数据以使用AI模型反馈进行训练(RLAIF)[5]。方法与数据集包括Anthropic-HH [2, 4]、Open Assistant [31]、LaMDA [56]和Sparrow [21]。我们不使用强化学习,但我们最好的模型Guanaco是在Open Assistant数据集的多轮聊天交互上微调的,该数据集旨在用于RLHF训练[31]。对于聊天机器人的评估,已开发出使用GPT-4替代昂贵人工标注的方法[10, 45]。我们在这些方法的基础上改进,重点关注更可靠的评估设置。
8 局限性与讨论
我们已经展示了证据,表明我们的方法QLORA可以用4位基础模型和低秩适配器(LoRA)复现16位完整微调性能。尽管有这些证据,我们并未证实QLORA能在33B和65B规模上匹配完整的16位微调性能。由于巨大的资源成本,我们将这项研究留待未来工作。
另一个局限性是指令微调模型的评估。虽然我们提供了在MMLU、Vicuna基准和OA基准上的评估,但我们没有在BigBench、RAFT和HELM等其他基准上进行评估,并且不能确保我们的评估能推广到这些基准。另一方面,我们在MMLU上进行了非常广泛的研究,并开发了评估聊天机器人的新方法。
从所呈现的证据来看,这些基准的性能可能取决于微调数据与基准数据集的相似程度。例如,FLAN v2与MMLU相似,但与聊天机器人基准不相似,而Chip2数据集则相反,两个模型在MMLU和Vicuna基准上的得分也相应如此。这突出表明,不仅需要更好的基准和评估,而且人们需要谨慎对待自己到底在评估什么。我们是想创建在课堂高中和大学知识上表现良好的模型,还是想在聊天机器人对话能力上表现良好?也许是其他什么?因为与创建新基准相比,在现有基准上进行评估总是更容易,某些基准可能会将社区引向某个特定方向。作为社区,我们应该确保基准衡量的是我们所关心的东西。
虽然我们为通用聊天机器人性能提供了详细评估,但另一个局限性是我们只对Guanaco进行了有限的负责任AI评估。我们在表8中评估了Guanaco-65B与其他模型相比生成社会偏见token序列的可能性。我们看到Guanaco-65B的平均得分远低于其他原始预训练模型。因此,似乎在OASST1数据集上进行微调降低了LLaMA基础模型的偏差。虽然这些结果令人鼓舞,但尚不清楚Guanaco在其他类型偏差上评估时是否也表现良好。我们将分析Guanaco和类似聊天机器人偏差的进一步评估留待未来工作。另一个局限性是我们没有评估不同的位精度,例如使用3位基础模型,或不同的适配器方法。除LoRA外,还有广泛的参数高效微调(PEFT)方法已被证明效果良好。然而,尚不清楚这些方法是否能扩展到大型模型。我们使用LoRA是因为许多结果确立了其稳健性,但其他适配器可能会产生更好的性能。由于量化后的微调似乎能恢复量化过程中丢失的大部分信息,这可能使更激进的量化成为可能。例如,使用LoRA对基础模型进行3位GPTQ量化,在微调后也可能产生16位完整微调性能。
9 更广泛的影响
我们的QLoRA微调方法是第一种能够在单块消费级GPU上微调33B参数模型、在单块专业级GPU上微调65B参数模型,同时相对于完整微调基线不降低性能的方法。我们已经证明,我们在Open Assistant数据集上训练的最佳33B模型可以在Vicuna基准上与ChatGPT匹敌。由于指令微调是将原始预训练LLM转化为类ChatGPT聊天机器人的 essential 工具,我们相信我们的方法将使微调变得广泛而普遍,特别是对于资源最少的研究人员而言,这是最先进NLP技术可及性的一大胜利。QLoRA可以被视为一个均衡因素,有助于缩小大型企业与拥有消费级GPU的小团队之间的资源差距。
另一个潜在的影响来源是部署到手机端。我们相信,我们的 QLoRA 方法或许能够实现一个关键里程碑,即使得在手机和其他低资源环境中对 LLM 进行微调成为可能。尽管此前已证明 7B 模型能够在手机上运行,但 QLoRA 是首个能够对此类模型进行微调的方法。我们估计,使用 iPhone 12 Plus,QLoRA 可以在手机充电时每晚微调 300 万个 token。虽然微调后的 7B 模型尚达不到 ChatGPT 的质量,但我们相信其质量已足够好,能够催生此前因隐私或 LLM 质量问题而无法实现的新应用。QLoRA 有助于实现 LLM 的隐私保护式使用,使用户能够拥有和管理自己的数据和模型,同时让 LLM 更易于部署。
然而,微调是一种具有双重用途的技术,可能被滥用以造成危害。LLM 的广泛使用存在已知危险 [8, 6],但我们相信,让这项正迅速普及的技术更平等地可及,将比把 LLM 的能力掌握在不发布模型或源代码以供审计的大型企业手中,能够带来更好、更独立的分析。
总而言之,我们相信 QLoRA 将产生广泛的积极影响,使高质量 LLM 的微调更加广泛且更容易获得。
致谢
我们感谢 Aditya Kusupati、Ofir Press、Ashish Sharma、Margaret Li、Raphael Olivier、Zihao Ye 和 Evangelia Spiliopoulou 提供的宝贵反馈。我们的研究得益于华盛顿大学 Hyak 超级计算机系统先进的计算、存储和网络基础设施。我们感谢 Hyak 团队确保系统平稳运行。我们感谢 bitsandbytes 库的 beta 测试者,特别是 Alex Birch 和 Alyssa Vance。我们感谢 Younes Belkada 帮助将我们的软件集成到 Hugging Face transformers 技术栈中。
参考文献
[1] S. An, Y. Li, Z. Lin, Q. Liu, B. Chen, Q. Fu, W. Chen, N. Zheng, and J.- G. Lou. Input- tuning: Adapting unfamiliar inputs to frozen pretrained models. arXiv preprint arXiv:2203.03131, 2022.
[2] A. Askell, Y. Bai, A. Chen, D. Drain, D. Ganguli, T. Henighan, A. Jones, N. Joseph, B. Mann, N. DasSarma, et al. A general language assistant as a laboratory for alignment. arXiv preprint arXiv:2112.00861, 2021.
[3] S. H. Bach, V. Sanh, Z.- X. Yong, A. Webson, C. Raffel, N. V. Nayak, A. Sharma, T. Kim, M. S. Bari, T. Fevry, et al. Promptsource: An integrated development environment and repository for natural language prompts. arXiv preprint arXiv:2202.01279, 2022.
[4] Y. Bai, A. Jones, K. Ndousse, A. Askell, A. Chen, N. DasSarma, D. Drain, S. Fort, D. Ganguli, T. Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[5] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, A. Chen, A. Goldie, A. Mirhoseini, C. McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022.
[6] E. M. Bender, T. Gebru, A. McMillan- Major, and S. Shmitchell. On the dangers of stochastic parrots: Can language models be too big? In Proceedings of the 2021 ACM conference on fairness, accountability, and transparency, pages 610- 623, 2021.
[7] S. Biderman, H. Schoelkopf, Q. Anthony, H. Bradley, K. O'Brien, E. Hallahan, M. A. Khan, S. Purohit, U. S. Prashanth, E. Raff, et al. Pythia: A suite for analyzing large language models across training and scaling. arXiv preprint arXiv:2304.01373, 2023.
[8] R. Bommasani, D. A. Hudson, E. Adeli, R. Altman, S. Arora, S. von Arx, M. S. Bernstein, J. Bohg, A. Bosselut, E. Brunskill, et al. On the opportunities and risks of foundation models. arXiv preprint arXiv:2108.07258, 2021.
[9] T. Chen, B. Xu, C. Zhang, and C. Guestrin. Training deep nets with sublinear memory cost. arXiv preprint arXiv:1604.06174, 2016.
[10] W.- L. Chiang, Z. Li, Z. Lin, Y. Sheng, Z. Wu, H. Zhang, L. Zheng, S. Zhuang, Y. Zhuang, J. E. Gonzalez, I. Stoica, and E. P. Xing. Vicuna: An open- source chatbot impressing gpt- 4 with 90%\* chatgpt quality, March 2023. URL https://lmsys.org/blog/2023- 03- 30- vicuna/.
[11] P. F. Christiano, J. Leike, T. Brown, M. Martic, S. Legg, and D. Amodei. Deep reinforcement learning from human preferences. Advances in neural information processing systems, 30, 2017.
[12] H. W. Chung, L. Hou, S. Longpre, B. Zoph, Y. Tay, W. Fedus, E. Li, X. Wang, M. Dehghani, S. Brahma, et al. Scaling instruction- finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
[13] T. Dettmers and L. Zettlemoyer. The case for 4- bit precision: k- bit inference scaling laws. arXiv preprint arXiv:2212.09720, 2022.
[14] T. Dettmers, M. Lewis, Y. Belkada, and L. Zettlemoyer. LLM.int8(): 8- bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, 2022.
[15] T. Dettmers, M. Lewis, S. Shleifer, and L. Zettlemoyer. 8- bit optimizers via block- wise quantization. 9th International Conference on Learning Representations, ICLR, 2022.
[16] A. E. Elo. The proposed uscf rating system. its development, theory, and applications. Chess Life, 22(8):242- 247, 1967.
[17] A. E. Elo. The rating of chessplayers, past and present. Arco Pub., 1978.
[18] E. Frantar, S. Ashkboos, T. Hoefler, and D. Alistarh. Gptq: Accurate post- training quantization for generative pre- trained transformers. arXiv preprint arXiv:2210.17323, 2022.
[19] J. Fu, S.- K. Ng, Z. Jiang, and P. Liu. Gptscore: Evaluate as you desire. arXiv preprint arXiv:2302.04166, 2023.
[20] X. Geng, A. Gudibande, H. Liu, E. Wallace, P. Abbeel, S. Levine, and D. Song. Koala: A dialogue model for academic research. Blog post, April 2023. URL https://bair.berkeley.edu/blog/2023/04/03/koala/.
[21] A. Glaese, N. McAleese, M. Trebacz, J. Aslanides, V. Firoiu, T. Ewalds, M. Rauh, L. Weidinger, M. Chadwick, P. Thacker, et al. Improving alignment of dialogue agents via targeted human judgements. arXiv preprint arXiv:2209.14375, 2022.
[22] S. Gururangan, S. Swayamdipta, O. Levy, R. Schwartz, S. R. Bowman, and N. A. Smith. Annotation artifacts in natural language inference data. arXiv preprint arXiv:1803.02324, 2018.
[23] J. Henderson, S. Ruder, et al. Compacter: Efficient low- rank hypercomplex adapter layers. In Advances in Neural Information Processing Systems, 2021.
[24] D. Hendrycks, C. Burns, S. Basart, A. Zou, M. Mazeika, D. Song, and J. Steinhardt. Measuring massive multitask language understanding. In International Conference on Learning Representations, 2020.
[25] A. Holtzman, J. Buys, L. Du, M. Forbes, and Y. Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2020.
[26] O. Honovich, T. Scialom, O. Levy, and T. Schick. Unnatural instructions: Tuning language models with (almost) no human labor. arXiv preprint arXiv:2212.09689, 2022.
[27] N. Houlsby, A. Giurgiu, S. Jastrzebski, B. Morrone, Q. De Laroussilhe, A. Gesmundo, M. Attariyan, and S. Gelly. Parameter- efficient transfer learning for nlp. In International Conference on Machine Learning, pages 2790- 2799. PMLR, 2019.
[28] E. J. Hu, Y. Shen, P. Wallis, Z. Allen- Zhu, Y. Li, S. Wang, L. Wang, and W. Chen. Lora: Low- rank adaptation of large language models. arXiv preprint arXiv:2106.09685, 2021.
[29] S. Iyer, X. V. Lin, R. Pasunuru, T. Mihaylov, D. Simig, P. Yu, K. Shuster, T. Wang, Q. Liu, P. S. Koura, et al. Opt- iml: Scaling language model instruction meta learning through the lens of generalization. arXiv preprint arXiv:2212.12017, 2022.
[30] A. Koksal, T. Schick, A. Korhonen, 和 H. Schütze. Longform:通过语料抽取优化长文本生成的指令微调。arXiv 预印本 arXiv:2304.08460, 2023。
[31] A. Köpf, Y. Kilcher, D. von Rütte, S. Anagnostidis, Z.- R. Tam, K. Stevens, A. Barhoum, N. M. Duc, O. Stanley, R. Nagyfi, 等. Openassistant conversations——民主化大语言模型对齐。arXiv 预印本 arXiv:2304.07327, 2023。
[32] LAION. Open-instruction-generalist 数据集. https://github.com/LAION-AI/Open-Instruction-Generalist, 2023。
[33] B. Lester, R. Al-Rfou, 和 N. Constant. 规模对于参数高效提示调优的力量。arXiv 预印本 arXiv:2104.08691, 2021。
[34] X. L. Li 和 P. Liang. 前缀调优:为生成优化连续提示。arXiv 预印本 arXiv:2101.00190, 2021。
[35] P. Liang, R. Bommasani, T. Lee, D. Tsipras, D. Soylu, M. Yasunaga, Y. Zhang, D. Narayanan, Y. Wu, A. Kumar, 等. 语言模型的整体评估。arXiv 预印本 arXiv:2211.09110, 2022。
[36] T. Liao, R. Taori, I. D. Raji, 和 L. Schmidt. 我们还在学习吗?跨机器学习评估失败的元综述。见第三十五届神经信息处理系统大会数据集与基准赛道(第二轮),2021。
[37] H. Liu, D. Tam, M. Muqeeth, J. Mohta, T. Huang, M. Bansal, and C. A. Raffel. 少样本参数高效微调优于且廉于上下文学习. Advances in Neural Information Processing Systems, 35:1950–1965, 2022.
[38] Y. Liu, M. Ott, N. Goyal, J. Du, M. Joshi, D. Chen, O. Levy, M. Lewis, L. Zettlemoyer, and V. Stoyanov. Roberta:一种稳健优化的bert预训练方法. arXiv preprint arXiv:1907.11692, 2019.
[39] S. Longpre, L. Hou, T. Vu, A. Webson, H. W. Chung, Y. Tay, D. Zhou, Q. V. Le, B. Zoph, J. Wei, et al. Flan集合:为有效指令调优设计数据和方法. arXiv preprint arXiv:2301.13688, 2023.
[40] S. Min, M. Lewis, L. Zettlemoyer, and H. Hajishirzi. Metaicl:在上下文中学习如何学习. arXiv preprint arXiv:2110.15943, 2021.
[41] A. Nematzadeh, K. Burns, E. Grant, A. Gopnik, and T. Griffiths. 在问答中评估心理理论. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2392–2400, 2018.
[42] OpenAI. Gpt-4技术报告. arXiv, 2023.
[43] L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, et al. 通过人类反馈训练语言模型遵循指令. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
[44] G. Park, B. Park, S. J. Kwon, B. Kim, Y. Lee, and D. Lee. nuqmm:用于大规模生成语言模型高效推理的量化矩阵乘法. arXiv preprint arXiv:2206.09557, 2022.
[45] B. Peng, C. Li, P. He, M. Galley, and J. Gao. 使用gpt-4进行指令调优. arXiv preprint arXiv:2304.03277, 2023.
[46] A. Poliak, J. Naradowsky, A. Haldar, R. Rudinger, and B. Van Durme. 自然语言推理中仅假设基线. In Proceedings of the Seventh Joint Conference on Lexical and Computational Semantics, pages 180–191, 2018.
[47] R. Pope, S. Douglas, A. Chowdhery, J. Devlin, J. Bradbury, A. Levskaya, J. Heek, K. Xiao, S. Agrawal, and J. Dean. 高效扩展transformer推理. arXiv preprint arXiv:2211.05102, 2022.
[48] G. Qin and J. Eisner. 学习如何提问:用软提示混合查询语言模型. arXiv preprint arXiv:2104.06599, 2021.
[49] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu. 探索统一文本到文本transformer的迁移学习极限. J. Mach. Learn. Res., 21(1), jan 2020. ISSN 1532-4435.
[50] V. Sanh, A. Webson, C. Raffel, S. H. Bach, L. Sutawika, Z. Alyafeai, A. Chaffin, A. Stiegler, T. L. Scao, A. Raja, et al. 多任务提示训练实现零样本任务泛化. arXiv preprint arXiv:2110.08207, 2021.
[51] M. Sap, R. LeBras, D. Fried, and Y. Choi. 神经心理理论?论大型语言模型社会智能的局限. arXiv preprint arXiv:2210.13312, 2022.
[52] T. L. Scao, A. Fan, C. Akiki, E. Pavlick, S. Ilić, D. Hesslow, R. Castagné, A. S. Luccioni, F. Yvon, M. Gallé, et al. Bloom:一个1760亿参数的开源多语言语言模型. arXiv preprint arXiv:2211.05100, 2022.
[53] S. Shapiro and M. Wilk. 正态性方差分析检验. Biometrika, 52(3):591–611, 1965.
[54] Y.-L. Sung, V. Nair, and C. A. Raffel. 使用固定稀疏掩码训练神经网络. Advances in Neural Information Processing Systems, 34:24193–24205, 2021.
[55] R. Taori, I. Gulrajani, T. Zhang, Y. Dubois, X. Li, C. Guestrin, P. Liang, and T. B. Hashimoto. 斯坦福羊驼:一个遵循指令的llama模型. https://github.com/tatsu-lab/stanford_alpaca, 2023.
[56] R. Thoppilan, D. De Freitas, J. Hall, N. Shazeer, A. Kulshreshtha, H.-T. Cheng, A. Jin, T. Bos, L. Baker, Y. Du, et al. Lamda:面向对话应用的语言模型. arXiv preprint arXiv:2201.08239, 2022.
[57] H. Touvron, T. Lavril, G. Izacard, X. Martinet, M.-A. Lachaux, T. Lacroix, B. Rozière, N. Goyal, E. Hambro, F. Azhar, et al. Llama:开放且高效的基础语言模型. arXiv preprint arXiv:2302.13971, 2023.
[58] A. Wang, A. Singh, J. Michael, F. Hill, O. Levy, and S. R. Bowman. Glue:一个多任务基准和自然语言理解分析平台. arXiv preprint arXiv:1804.07461, 2018.
[59] Y. Wang, Y. Kordi, S. Mishra, A. Liu, N. A. Smith, D. Khashabi, and H. Hajishirzi. Self-instruct:使用自生成指令对齐语言模型. arXiv preprint arXiv:2212.10560, 2022.
[60] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Arunkumar, A. Ashok, A. S. Dhanasekaran, A. Naik, D. Stap, et al. Super-naturalinstructions:通过在1600多个任务上的声明式指令实现泛化. In EMNLP, 2022.
[61] Y. Wang, S. Mishra, P. Alipoormolabashi, Y. Kordi, A. Mirzaei, A. Naik, A. Ashok, A. S. Dhanasekaran, A. Arunkumar, D. Stap, et al. Super-naturalinstructions:通过在1600多个nlp任务上的声明式指令实现泛化. In Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, pages 5085-5109, 2022.
[62] J. Wei, M. Bosma, V. Y. Zhao, K. Guu, A. W. Yu, B. Lester, N. Du, A. M. Dai, and Q. V. Le. 微调的语言模型是零样本学习器. arXiv preprint arXiv:2109.01652, 2021.
[63] J. Wei, X. Wang, D. Schuurmans, M. Bosma, F. Xia, E. H. Chi, Q. V. Le, D. Zhou, et al. 思维链提示激发大型语言模型中的推理. In Advances in Neural Information Processing Systems, 2022.
[64] T. Wolf, L. Debut, V. Sanh, J. Chaumond, C. Delangue, A. Moi, P. Cistac, T. Rault, R. Louf, M. Funtowicz, et al. Huggingface的transformers:最先进的自然语言处理. arXiv preprint arXiv:1910.03771, 2019.
[65] M. Wortsman、T. Dettmers、L. Zettlemoyer、A. Morcos、A. Farhadi 和 L. Schmidt。面向大规模视觉语言模型的稳定且低精度训练。arXiv 预印本 arXiv:2304.13013,2023。
[66] G. Xiao、J. Lin、M. Seznec、J. Demouth 和 S. Han。Smoothquant:面向大语言模型的准确且高效的训练后量化。arXiv 预印本 arXiv:2211.10438,2022。
[67] T. Xie、C. H. Wu、P. Shi、R. Zhong、T. Scholak、M. Yasunaga、C.-S. Wu、M. Zhong、P. Yin、S. I. Wang 等。Unifiedskg:使用文本到文本语言模型统一并多任务化结构化知识 grounding。arXiv 预印本 arXiv:2201.05966,2022。
[68] Z. Yang、P. Qi、S. Zhang、Y. Bengio、W. Cohen、R. Salakhutdinov 和 C. D. Manning。Hotpotqa:一个用于多样化、可解释多跳问答的数据集。载于《2018 年自然语言处理经验方法会议论文集》,第 2369–2380 页,2018。
[69] Z. Yao、R. Y. Aminabadi、M. Zhang、X. Wu、C. Li 和 Y. He。Zeroquant:面向大规模 Transformer 的高效且经济的训练后量化。arXiv 预印本 arXiv:2206.01861,2022。
[70] E. B. Zaken、S. Ravfogel 和 Y. Goldberg。Bitfit:面向基于 Transformer 的掩码语言模型的简单参数高效微调。arXiv 预印本 arXiv:2106.10199,2021。
[71] A. Zeng、X. Liu、Z. Du、Z. Wang、H. Lai、M. Ding、Z. Yang、Y. Xu、W. Zheng、X. Xia 等。Glm-130b:一个开放的双语预训练模型。arXiv 预印本 arXiv:2210.02414,2022。
[72] S. Zhang、S. Roller、N. Goyal、M. Artetxe、M. Chen、S. Chen、C. Dewan、M. Diab、X. Li、X. V. Lin 等。Opt:开放的预训练 Transformer 语言模型。arXiv 预印本 arXiv:2205.01068,2022。
[73] R. Zhong、K. Lee、Z. Zhang 和 D. Klein。通过在数据集和提示集合上进行元调优,使语言模型适应零样本学习。arXiv 预印本 arXiv:2104.04670,2021。
A QLoRA 与标准微调实验设置细节
A.1 QLoRA 的超参数
我们针对以下变量对 LoRA 进行超参数搜索:LoRA dropout { 0.0, 0.05, 0.1}、LoRA { 8, 16, 32, 64, 128, 256}、LoRA 层 {key+query、所有注意力层、所有 FFN 层、所有层、注意力 + FFN 输出层}。我们固定 LoRA 并搜索学习率,因为 LoRA 始终与学习率成正比。
我们发现 LoRA dropout 0.05 对小模型(7B、13B)有用,但对更大的模型(33B、65B)无用。我们发现,如果在所有层上使用 LoRA,则 LoRA 与最终性能无关,如图 4 所示
A.2 Super-Natural Instructions 实验设置细节
我们使用与 Wang 等人 [60] 相同的 Super-Natural Instruction 数据集预处理方式。然而,我们将训练数据划分为训练集和验证集,以便进行更严格的超参数调优和早停。我们使用论文中描述的相同超参数,在 Super-Natural Instruction 数据上训练各种规模的 T5 模型。对于小型、中型和大型 T5 模型,我们使用 LoRA ;对于 T5 xl 和 xxl 模型,我们使用 LoRA 。在我们所有实验中,我们还使用 LoRA ,且不使用 LoRA dropout。
B 训练最先进的聊天机器人实验设置细节
B.1 数据集
我们描述第 5 节中概述的 QLoRA 微调实验所使用的数据集。
OASST1 OpenAssistant 数据集 [31] 是通过众包收集的。它包含 161,443 条唯一消息,分布在 66,497 个对话中,涵盖 35 种不同语言。该数据集通常对每个给定的用户问题包含若干条排序后的回复。在我们的实验中,我们仅使用对话树中每一层级的最佳回复。这将数据集限制为 9,209 个示例。我们基于包含用户查询的完整对话对模型进行微调。
HH-RLHF 这是一个关于有用性和无害性的人类偏好数据集。每个数据点由对用户问题的两个助手回复以及人类对最佳回复的偏好判断组成。该数据集包含 160,800 个示例。在该数据集上微调时,我们合并有用性和无害性数据,并仅保留首选的助手回复。
FLAN v2 FLAN v2 集合 [39] 是一个包含 1836 个任务的集合,这些任务通过数百个手动精选的模板和丰富的格式模式扩充为超过 15M 个示例。作者表明,在该集合上训练的模型优于其他公共集合,包括原始 FLAN 2021 [62]、T0++ [50]、Super-Natural Instructions [60] 和 OPT-IML [29]。我们使用了作者描述的相同任务混合,但排除了一些在撰写本文时无法免费获取的数据集。
| 参数 | 数据集 | 批次大小 | 学习率 | 步数 | 源长度 | 目标长度 |
| 7B | 全部 | 16 | 2e-4 | 10000 | 384 | 128 |
| 7B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 7B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 7B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 13B | 全部 | 16 | 2e-4 | 10000 | 384 | 128 |
| 13B | OASST1 | 16 | 2e-4 | 1875 | - | 512 |
| 13B | HH-RLHF | 16 | 2e-4 | 10000 | - | 768 |
| 13B | Longform | 16 | 2e-4 | 4000 | 512 | 1024 |
| 33B | 全部 | 32 | 1e-4 | 5000 | 384 | 128 |
| 33B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 33B | HH-RLHF | 32 | 1e-4 | 5000 | - | 768 |
| 33B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
| 65B | 全部 | 64 | 1e-4 | 2500 | 384 | 128 |
| 65B | OASST1 | 16 | 1e-4 | 1875 | - | 512 |
| 65B | HH-RLHF | 64 | 1e-4 | 2500 | - | 768 |
| 65B | Longform | 32 | 1e-4 | 2343 | 512 | 1024 |
Self-Instruct、Alpaca、Unnatural Instructions Self-Instruct、Alpaca 和 Unnatural Instructions 数据集 [59, 55, 26] 是通过各种从 GPT-3 Instruct 和 ChatGPT 进行模型蒸馏的方法收集的指令调优数据集。它们依赖提示、上下文学习和复述来生成多样化的指令和输出集合。这些数据集分别包含 82,612、51,942 和 240,670 个示例。此类蒸馏数据集的一个优点是,与 FLAN v2 集合及类似指令调优集合相比,它们包含更多样化的指令风格。
Longform Longform 数据集 [30] 基于一个用指令扩充的英语语料库,因此是一个混合的人类生成数据集。底层文档由人类撰写,来自 C4 和 Wikipedia,而指令则通过 LLM 生成。该数据集还扩充了额外的结构化语料库示例,如 Stack Exchange 和 WikiHow,以及任务示例,如问答、电子邮件写作、语法错误纠正、故事/诗歌生成和文本摘要。该数据集包含 23,700 个示例。
Chip2 是 OIG Laion 数据集的一部分。它包含 Python 代码示例、自然指令示例、通用无害指令、带列表的指令/响应、后续问题、Wikipedia 有毒对抗问题、小学数学习题、推理指令,以及角色和场景描述,共计 210,289 个示例。
B.2 超参数
我们提供 QLoRA 微调实验中使用的确切超参数。我们发现超参数在不同数据集之间大体上具有鲁棒性。我们使用 MMLU 5-shot dev 集进行验证和超参数调优。在我们所有实验中,我们使用带双量化的 NF4 和 bf16 计算数据类型。我们设置 LoRA 、,并在基础模型的所有线性层上添加 LoRA 模块。对于不超过 13B 的模型,我们还使用 Adam beta2 为 0.999、最大梯度范数为 0.3 和 LoRA dropout 为 0.1;对于 33B 和 65B 模型,LoRA dropout 为 0.05。遵循先前关于指令微调的工作 [62, 60],并在对其他线性调度和余弦调度进行基准测试后,我们使用恒定学习率调度。我们使用按长度分组,将长度相近的示例分到同一批次中(注意,这会产生振荡的损失曲线)。我们为每种模型规模调优的超参数如表 9 所示。
B.3 消融实验
尽管文献中的通常做法是仅在指令跟随数据集中对响应进行训练,但我们在表 10 中研究了在响应之外还对指令进行训练的影响。在这些实验中,我们将训练数据限制为 52,000 个示例,并使用 7B 模型。在四个不同的指令调优数据集上,我们发现仅对目标进行训练对 MMLU
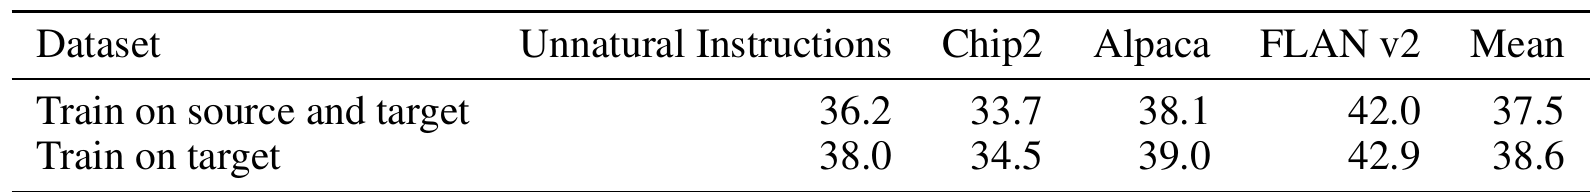
| Dataset | Unnatural Instructions | Chip2 | Alpaca | FLAN v2 | Mean |
| Train on source and target | 36.2 | 33.7 | 38.1 | 42.0 | 37.5 |
| Train on target | 38.0 | 34.5 | 39.0 | 42.9 | 38.6 |
B.4 哪个更重要:指令微调数据集的大小还是数据集质量?
数据集适用性比数据集规模更重要。为了理解数据集质量与数据集规模的影响,我们对至少包含 150,000 个样本的大型数据集(Chip2、FLAN v2、Unnatural Instructions)进行子采样实验,将其分别缩减为规模 50,000、100,000 和 150,000 的数据集,并考察由此产生的趋势,如表 11 所示。我们发现,增加数据集规模和增加训练轮数仅能小幅提升 MMLU(0.0 - 0.5 MMLU),而不同数据集之间的差异最高可达前者的 40 倍(1.5 - 8.0 MMLU)。这清楚地表明,对于平均 MMLU 准确率而言,关键因素是数据集质量而非数据集规模。我们在聊天机器人性能方面也得到了类似的发现,如中所讨论。
C 人工评估
我们使用与原始 Vicuna 评估 [10] 中提供给 GPT-4 的相同措辞进行人工评估,并针对 Amazon Mechanical Turk 表单进行了调整,如图 5 所示。
D 使用 GPT-4 进行成对评估
尽管我们发现 GPT-4 评估会根据首先呈现哪个系统而给出不同结果,但当对两种选项取平均时,成对结果排序良好。聚合后的成对判断如表 12 所示。经检查,这些判断显然具有传递性,即当系统 A 被判为优于系统 B,且系统 B 被判为优于系统 C 时,系统 A 总是被判为优于系统 C。这产生了一个完整的排序,如表 13 所示。
E NormalFloat 4 位数据类型
NF4 数据类型的确切取值如下:[- 1.0, - 0.6961928009986877, - 0.5250730514526367, - 0.39491748809814453, - 0.28444138169288635, - 0.18477343022823334, - 0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725, 0.24611230194568634, 0.33791524171829224, 0.44070982933044434, 0.5626170039176941, 0.7229568362236023, 1.0]
F 训练后的神经网络权重的正态性
尽管训练后的神经网络权重大多呈正态分布是常识,我们仍进行统计检验以验证这一点。我们对 7B 的权重使用 Shapiro-Wilk 检验[53]
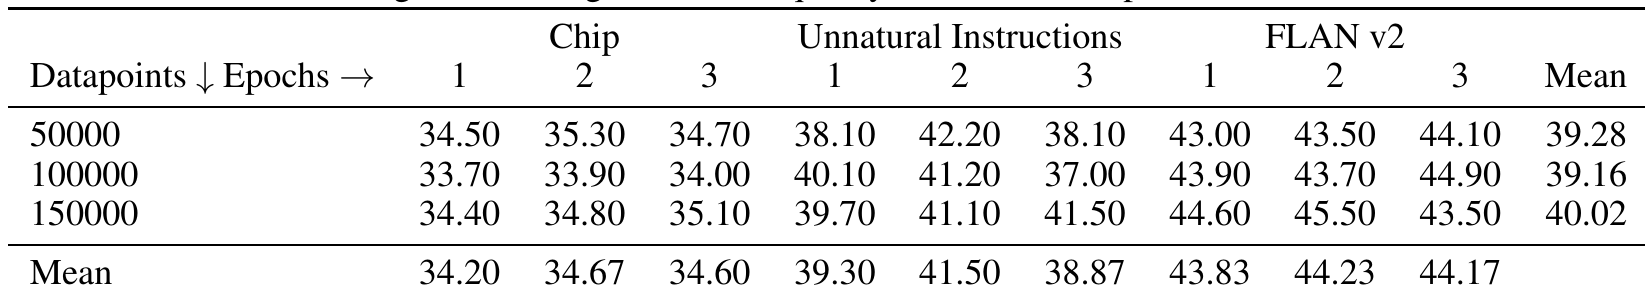
| 数据点 ↓ 轮数 → | 1 | 2 | 3 | Unnatural Instructions | 1 | 2 | 3 | FLAN v2 | 3 | 均值 |
| 50000 | 34.50 | 35.30 | 34.70 | 38.10 | 42.20 | 38.10 | 43.00 | 43.50 | 44.10 | 39.28 |
| 100000 | 33.70 | 33.90 | 34.00 | 40.10 | 41.20 | 37.00 | 43.90 | 43.70 | 44.90 | 39.16 |
| 150000 | 34.40 | 34.80 | 35.10 | 39.70 | 41.10 | 41.50 | 44.60 | 45.50 | 43.50 | 40.02 |
| 均值 | 34.20 | 34.67 | 34.60 | 39.30 | 41.50 | 38.87 | 43.83 | 44.23 | 44.17 |
任务
我们希望您就两位 AI 助手对下方所展示的用户问题的回答表现提供反馈。
请对它们回答的有用性、相关性、准确性以及详细程度进行评分。每位助手都会获得一个 1 到 10 分的总体评分,分数越高表示总体表现越好。
请先为每个回答按 10 分制评分。
接下来,请对您的评估提供全面的解释,避免任何潜在偏见,并确保回答呈现的顺序不会影响您的判断。
用户问题
想象你是来自公元3000年的时间旅行者。你会告诉人们哪些技术进步?
回答A
作为一个AI助手,我没有个人经历或观点。但我可以根据当前的趋势和研究,告诉你一些可能在公元3000年存在的技术进步。——自维持城市:城市可能完全实现自维持,拥有可再生能源、垂直农业以及废物和水的回收利用。
回答B
作为来自公元3000年的时间旅行者,我会告诉人们以下技术进步:1. 先进的人工智能:在未来,人工智能如此先进,以至于它可以完全自动化许多目前由人类从事的工作。这导致许多行业的生产率和效率提高。
对回答A的评分
对回答B的评分
对您评估的全面解释
回答X更好,因为……
提交
图5:人类标注者使用的众包表单。LLaMA模型[57]。我们发现每个隐藏单元的权重具有不同的正态分布。因此,我们测试每个单独隐藏单元的权重。这意味着对于权重,我们在out维度上执行检验。使用的显著性阈值,我们发现的神经元不服从正态分布,这比预期的假阳性率高出约。因此,尽管几乎所有预训练权重似乎都服从正态分布,但似乎存在例外。这些例外可能是由于离群权重[13],或者是因为Shapiro-Wilk检验的p值在LLaMA FFN层隐藏单元中出现的大样本量下并不准确[53]。这验证了神经网络权重的说法。
| 模型 | Guanaco 65B | Guanaco 33B | Vicuna | ChatGPT-3.5 Turbo | Bard | Guanaco 13B | Guanaco 7B |
| Guanaco 65B | - | 0.21 | 0.19 | 0.16 | 0.72 | 0.59 | 0.86 |
| Guanaco 33B | -0.21 | - | 0.17 | 0.10 | 0.51 | 0.41 | 0.68 |
| Vicuna | -0.19 | -0.17 | - | 0.10 | 0.50 | 0.20 | 0.57 |
| ChatGPT-3.5 Turbo | -0.16 | -0.10 | -0.10 | - | 0.35 | 0.19 | 0.40 |
| Bard | -0.72 | -0.51 | -0.50 | -0.35 | - | 0.12 | 0.03 |
| Guanaco 13B | -0.59 | -0.41 | -0.20 | -0.19 | -0.12 | - | 0.20 |
| Guanaco 7B | -0.86 | -0.68 | -0.57 | -0.40 | -0.03 | -0.20 | - |
G 内存占用
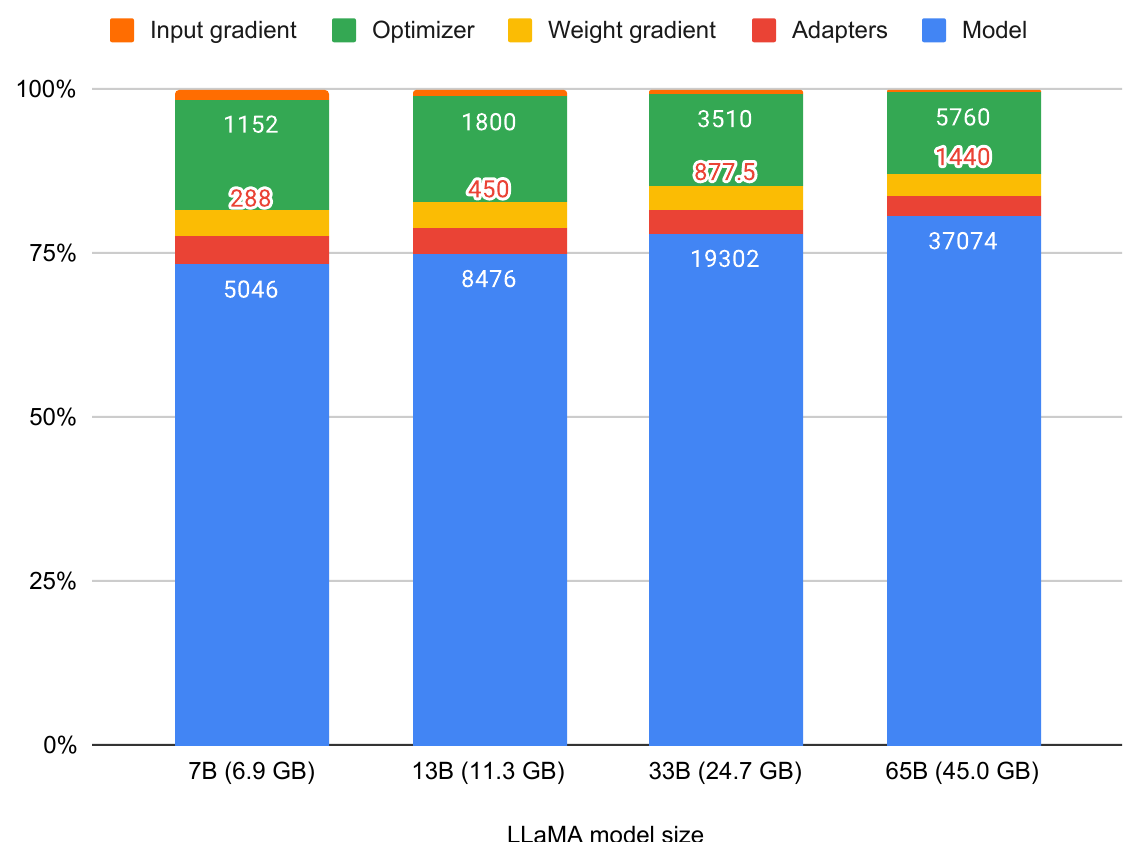
使用不同LLaMA基础模型进行QLoRA训练的内存占用可见于图6。我们看到33B模型并不能完全装入24 GB,并且需要分页优化器才能训练它。图中还展示了批次大小为1、序列长度为512并启用梯度检查点的情况。这意味着,如果使用更大的批次大小,或者处理长序列,激活梯度可能会消耗相当多的内存。
| 模型 | 参数量 | 大小 |
| Guanaco | 65B | 41 GB |
| Guanaco | 33B | 21 GB |
| Vicuna | 13B | 26 GB |
| ChatGPT-3.5 Turbo | 不适用 | 不适用 |
| Bard | 不适用 | 不适用 |
| Guanaco | 13B | 10 GB |
| Guanaco | 7B | 5 GB |