
小模型先草拟若干 token,大模型一次并行校验,输出完全不变而推理显著加速。2023 年 ICML 论文,全文免费在线阅读。
Fast Inference from Transformers via Speculative Decoding
通过推测解码从Transformer实现快速推理
Yaniv Leviathan * 1 Matan Kalman * 1 Yossi Matias 1
摘要
从 Transformers 等大型自回归模型进行推理的速度很慢——解码 个 token 需要对该模型进行 次串行运行。在这项工作中,我们引入了推测解码——一种从自回归模型更快采样的算法,且不改变输出,通过并行计算多个 token 实现。我们方法的核心在于以下观察:(1)困难的语言建模任务通常包含更容易的子任务,这些子任务可以被更高效的模型很好地近似;(2)使用推测执行和一种新颖的采样方法,我们可以使从大型模型进行的精确解码更快,方法是在近似模型的输出上并行运行它们,从而可能同时生成多个 token,并且不改变分布。我们的方法可以在无需重新训练或更改架构的情况下加速现有的现成模型。我们在 T5-XXL 上进行了演示,并显示与标准 T5X 实现相比实现了 2X-3X 的加速,且输出完全相同。
1. 引言
大型自回归模型,尤其是大型 Transformers(Vaswani et al., [2017]),比小型模型能力更强,近年来在文本或图像领域已有无数次证明,例如 GPT-3(Brown et al., [2020])、LaMDA(Thoppilan et al., [2022])、Parti(Yu et al., [2022])和 PaLM(Chowdhery et al., [2022])。不幸的是,这些大型模型的单次解码步骤比其较小对应模型的步骤要慢得多,更糟糕的是,这些步骤是串行执行的——解码 个 token 需要对该模型进行 次串行运行。
鉴于大型自回归模型特别是大型 Transformers 的重要性,已经开发了几种方法来加速从它们进行推理。一些方法旨在同等降低所有输入的推理成本(例如 Hinton et al., [2015]、Jaszczur et al., [2021]、Hubara et al., [2016]、So et al., [2021]、Shazeer [2019])。其他方法源于这样的观察:并非所有推理步骤都是相同的——有些需要非常大的模型,而另一些则可以被更高效的模型很好地近似。这些自适应计算方法(例如 Han et al., [2021]、Sukhbaatar et al., [2019]、Schuster et al., [2021]、Scardapane et al., [2020]、Bapna et al., [2020]、Elbayad et al., [2019]、Schwartz et al., [2020])旨在为更容易的推理步骤使用更少的计算资源。虽然这些解决方案中的许多在实践中已被证明极其有效,但它们通常需要更改模型架构、更改训练程序并重新训练模型,而且不能保持相同的输出。
同等贡献 1Google Research, Mountain View, CA, USA. 通讯作者:Yaniv Leviathan leviathan@google.com。
上述关键观察,即某些推理步骤“更难”而某些“更容易”,也是我们工作的关键动机。我们另外观察到,从大型模型进行推理的瓶颈通常不是算术运算,而是内存带宽和通信,因此可能有额外的计算资源可用。因此,我们建议增加并发性,作为使用自适应计算量的补充方法。具体来说,我们能够在不更改模型架构、不更改训练程序或需要重新训练模型、以及不更改模型输出分布的情况下加速推理。这是通过推测执行实现的。
推测执行(Burton, [1985]、Hennessy & Patterson, [2012])是处理器中常见的一种优化技术,其中任务与验证其是否实际需要并行执行——收益是增加的并发性。推测执行的一个著名例子是分支预测。为了使推测执行有效,我们需要一种高效的机制来建议执行可能需要的任务。在这项工作中,我们将推测执行推广到随机设置——其中任务可能以某种概率被需要。将其应用于从 Transformers 等自回归模型进行解码,我们从更高效的近似模型中采样生成,作为较慢目标模型的推测前缀。通过一种新颖的采样方法——推测采样,我们最大化这些推测任务被接受的概率,
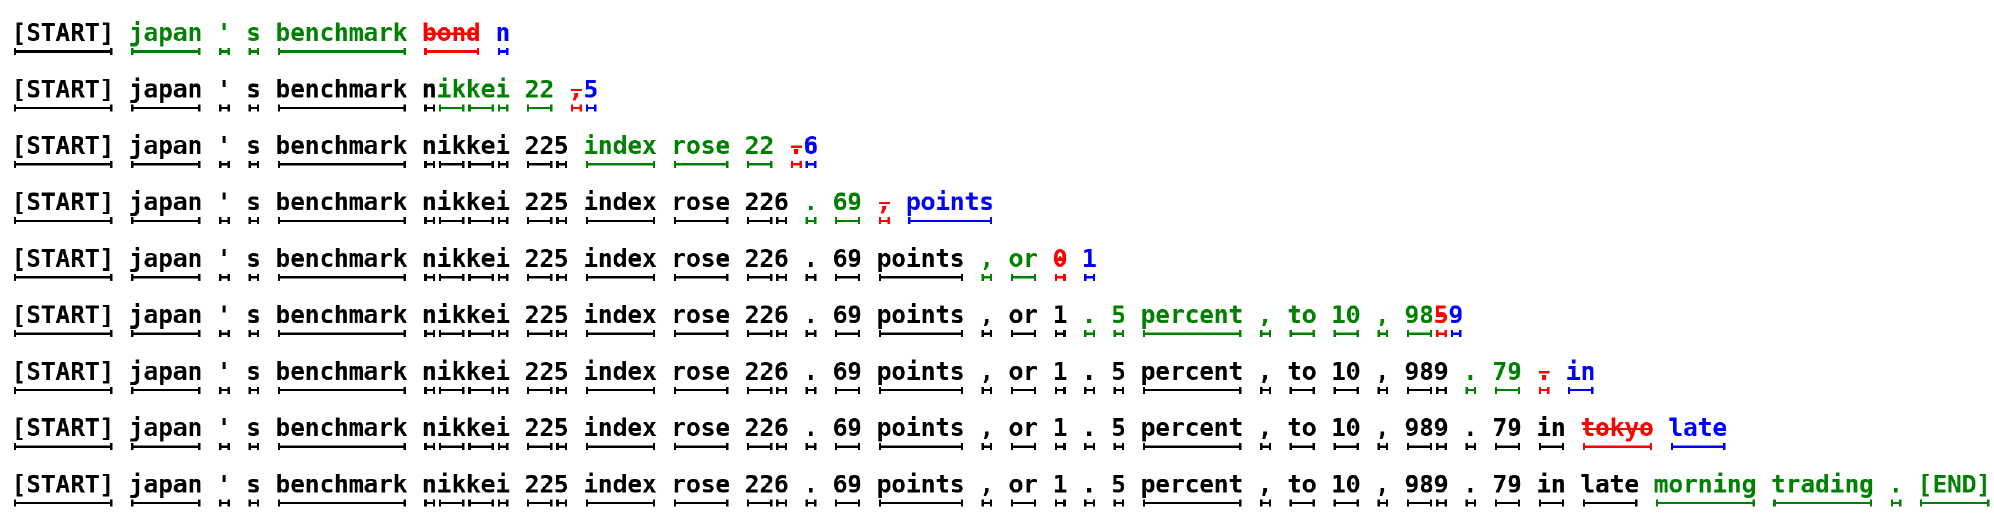
同时保证我们系统的输出与仅使用目标模型的输出具有相同的分布。例如,图 1 中由 38 个 token 组成的句子,我们的方法仅使用较大目标模型(97M 参数)的 9 次串行运行就生成了,这得益于一个更小且更高效的近似模型(6M 参数),同时生成它的概率保持不变。
我们在各种任务和模型大小上分析了我们的方法:从在 1m1b 上训练的 97M 参数 GPT 类模型进行无条件生成、使用 11B 参数 T5-XXL 模型进行英德翻译和新闻文章摘要,以及使用 137B 参数 LaMDA 模型进行对话任务。我们实现了我们的方法,并将 T5-XXL 的实际挂钟时间与稳健的 T5X 实现(Roberts et al., 2022)进行了比较,显示开箱即用的延迟改进为 2X-3X,且输出没有任何变化(第 4 节)。
我们的方法易于在实际生产环境中使用,不需要训练新模型,也不改变输出。因此,在内存带宽是瓶颈且计算资源可用的常见情况下,它可能是加速从 Transformers 等自回归模型采样的良好默认选择。
总结来说,我们的主要贡献是:(1)将推测执行推广到随机设置,并使用一种我们称为推测采样的新颖采样方法,以及(2)一种我们称为推测解码的解码机制,可以加速从自回归模型进行解码,而无需对模型架构、训练制度和输出分布进行任何更改。
2. 推测解码
2.1. 概述
令 为我们试图加速推理的目标模型, 为我们从该模型对前缀 获得的分布。令 为同一任务的更高效近似模型,并记 为我们从该模型对前缀 获得的分布。核心思想是(1)使用更高效的模型 生成 个补全(参见第 3.5 节了解如何最优选择此参数),然后(2)使用目标模型 并行评估来自 的所有猜测及其各自的概率,接受所有能够导致相同分布的猜测,以及(3)从调整后的分布中采样一个额外的 token,以修正第一个被拒绝的猜测,或者如果所有猜测都被接受则添加一个额外的 token。这样,目标模型 的每次并行运行将至少产生一个新 token(因此目标模型的串行运行次数永远不会,即使在最坏情况下,大于简单的自回归方法),但它可能潜在地生成许多新 token,最多 个,取决于 对 的近似程度。
2.2. 标准化采样
首先,请注意,虽然有许多采样方法和参数,如 argmax、top-k、nucleus 和设置温度,并且流行的实现通常在对数几率层面以不同方式对待它们,但它们都可以很容易地转化为从调整后的概率分布进行标准采样。例如,argmax 采样等价于将分布中非最大元素置零并归一化。因此,我们只需处理从概率分布进行标准采样,并将所有其他类型的采样转化为该框架。接下来我们将假设 和 分别是来自 和 的分布,并已根据采样方法进行了调整。
2.3. 推测采样
为了从 中采样,我们改为从 中采样,若 则保留该样本;而当 时,我们以概率 拒绝该样本,并改为从调整后的分布 中重新采样 。很容易证明(见附录 [A.1]),对于任意分布 和 ,以及以这种方式采样得到的 ,确实有 。
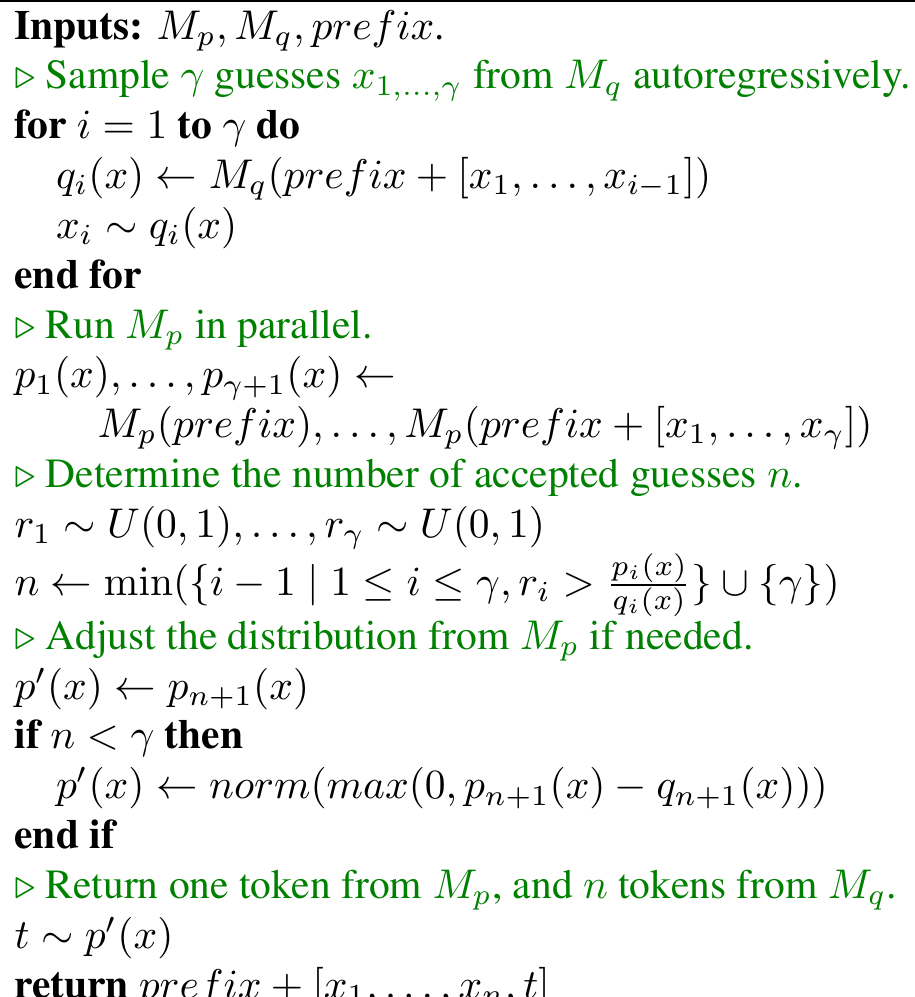
给定通过在条件 上运行 得到的分布 ,我们可以采样一个 token 。然后我们通过在 上运行 来计算分布 ,同时并行地通过在 上运行 来推测性地计算下一个 token 的分布。一旦两次计算都完成,我们按上述方式继续:如果 被拒绝,我们丢弃 的计算结果,并从调整后的分布中重新采样 ;如果 被接受,我们保留两个 token。算法 [I] 将这一思想推广到一次采样 1 到 个 token。
算法 1 SpeculativeDecodingStep
3. 分析
3.1. 生成的 token 数量
我们来分析对目标模型的串行调用次数的缩减因子,或者等价地,算法 [I] 单次运行所产生的期望 token 数。
定义 3.1. 给定前缀 ,接受率 是通过推测性采样接受 的概率,如第 [2.3] 节所述:
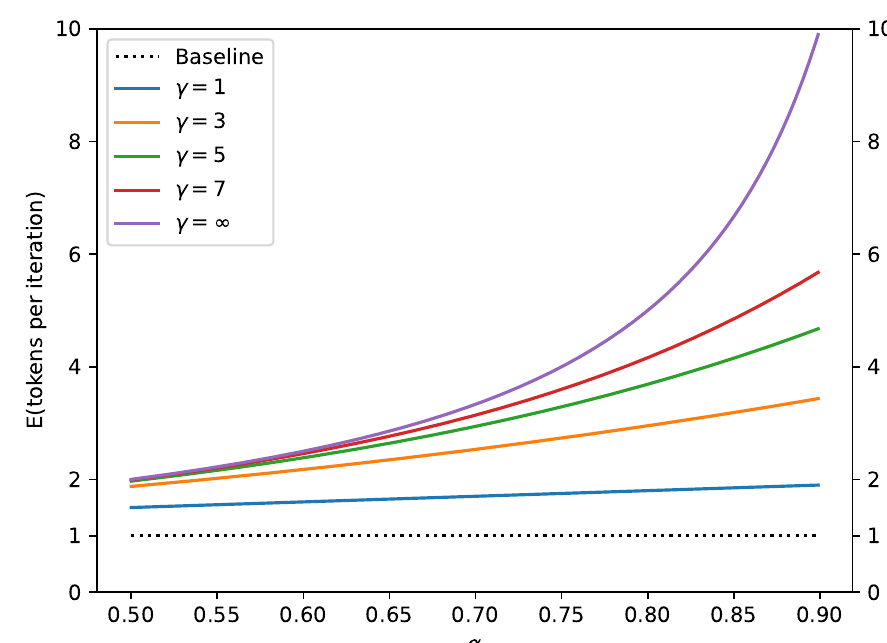
于是 是衡量 对 近似程度的一个自然指标。如果我们作简化假设,即各 独立同分布,并记 ,那么算法 [I] 单次运行产生的 token 数是一个有上限的几何变量,成功概率为 ,上限为 ,且算法 [I] 生成的期望 token 数满足公式 [I]。见图 [2]
3.2. 计算
我们现在推导一个简单的公式,用于在给定前缀和两个模型 与 的情况下计算 。我们首先定义一个自然的散度 :
定义 3.2. ,其中 。
引理 3.3.
证明。
由引理[3.3]我们立即得到以下结果:推论3.4. 是 上的对称散度。。 与 具有不相交的支撑集。
定理3.5.
最后我们得到:
推论3.6.
关于我们实验中经验观测到的 值,见表3。
3.3. 挂钟时间改进
我们已经证明,在独立同分布假设下,我们的算法将目标模型的调用次数减少了 倍。注意,推测执行一般而言,以及我们的算法具体而言,都假设我们有足够的计算资源来支持增加的并发度(第3.4节)。对于挂钟时间分析,我们将假设可以在不增加挂钟时间的情况下并行运行 个 的并发评估。为了得到总的挂钟时间改进,我们现在考虑运行近似模型 的成本。
定义3.7. 令 (成本系数)为单次运行 的时间与单次运行 的时间之比。
注意,与 不同( 是模型和任务的内在属性), 的值取决于硬件配置和软件实现细节。在我们的实验中, 通常比 小几个数量级, 始终小于0.05,并且常常小到可以忽略、接近于0。
定理3.8. 算法1对总挂钟时间的期望改进因子为 。
证明. 记运行单步 的成本为 。现在,算法1的每次运行成本为 (用于运行近似模型 次以及运行 一次),并且根据等式(1),平均产生 个token。因此,用算法1生成一个token的总体期望成本为 。由于用标准解码算法生成单个token的成本为 ,我们便得到所需结果。
注意,定理3.8假设生成长度足够长(例如,由于我们至少运行一次 ,改进因子以生成的token数量为上限)。
推论3.9. 如果 ,则存在 使我们获得改进,并且改进因子至少为 。
证明. 如果我们对 获得改进,那么对任意 我们也会获得改进,因此为了使我们的方法产生改进,我们可以对 评估定理3.8,得到 。
3.4. 算术运算次数
算法1并行运行 共 次,因此并发算术运算的数量增加了 倍。现在,由于算法1每次运行最多产生 个token,总的算术运算次数可能高于标准解码算法。当我们接受来自 的样本时,增加的并发度是“免费”的,并且总运算次数不会增加。然而,当我们拒绝一个猜测时,计算就被浪费了。现在让我们分析我们的方法对总算术运算次数的影响。
定义3.10. 令 为近似模型 每token的算术运算次数与目标模型 每token的算术运算次数之比。
定理3.11. 算法1总运算次数的期望增加因子为 。
证明. 用 表示标准解码基线每token所做的算术运算次数,即单次运行 的运算次数。那么算法1的单次迭代成本为 次运算(用于 次运行 以及 次并行运行 )。除以算法1产生的期望token数,即等式(1),再除以 ,我们便得到所需结果。
如果 低,算术运算次数的增加就高,反之亦然。注意,对于Transformer解码器,算法1的总算术运算次数(不计 的运行)可以从上方以单次运行相同规模的Transformer编码器为界。
与总算术运算次数不同,使用我们的方法时总内存访问次数可以下降。具体而言,目标模型的权重和KV缓存可以在算法1的每次执行中只读取一次,因此读取它们的内存访问次数根据等式(1)缩小了 倍。
3.5. 选择
给定 \(c\) 和 \(\alpha\),并假设有足够的计算资源(见第 3.4 节),最优的 \(\gamma\) 是使墙钟时间改进公式(定理 3.8)最大化的那个:
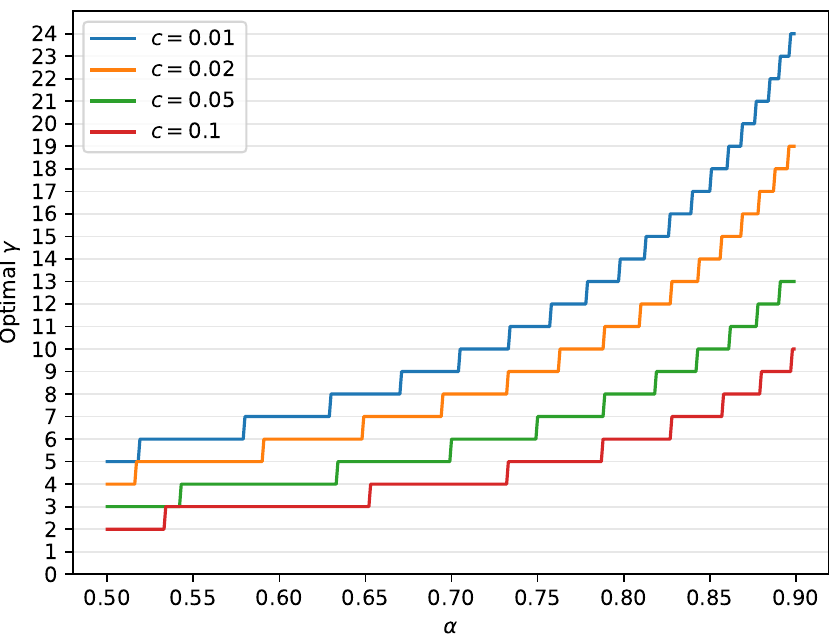
\(\frac{1 - \alpha^{\gamma + 1}}{(1 - \alpha)(\gamma c + 1)}\)。由于 \(\gamma\) 是整数,可以很容易地通过数值方法找到,见图 3。
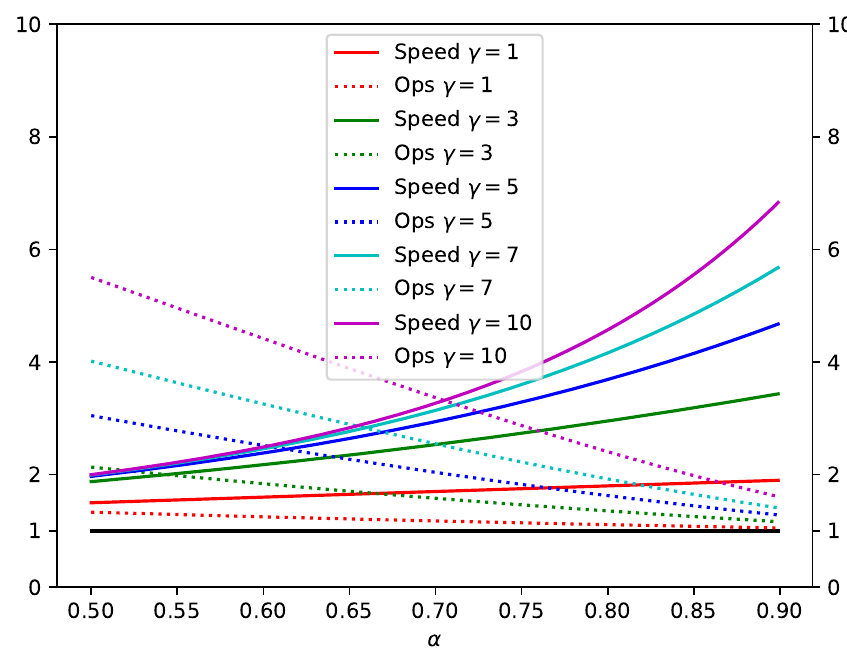
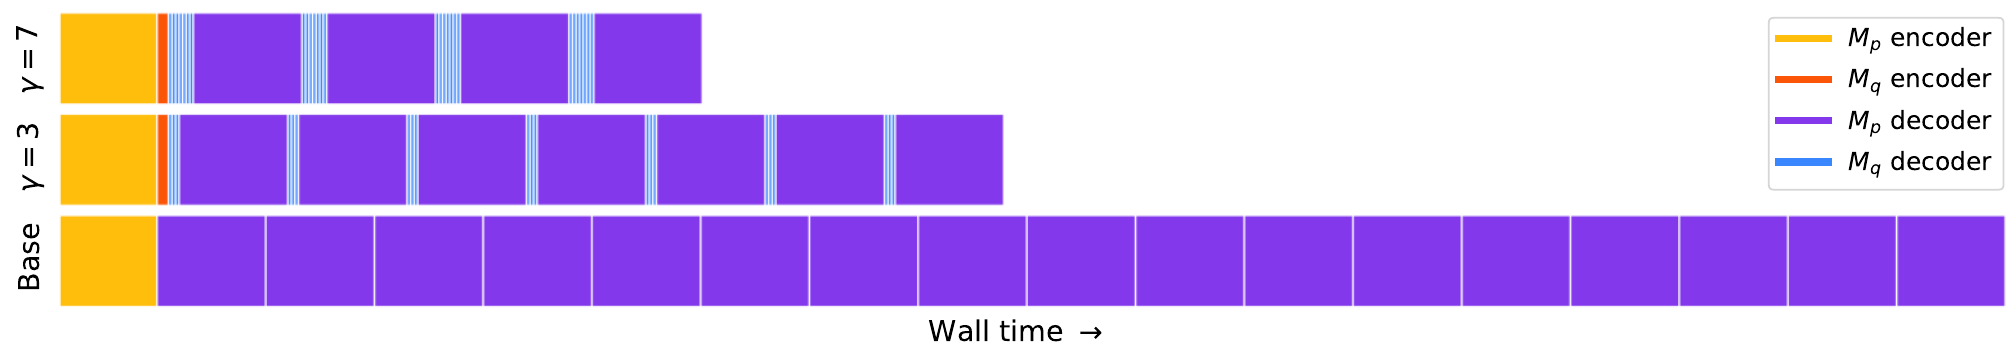
表 1 和图 4 说明了在假设 \(c = \hat{c} = 0\) 的情况下,对于不同的 \(\alpha\) 和 \(\gamma\) 取值,推理速度与算术运算总数之间的权衡。图 5 展示了一个简化的追踪图。
| α | γ | 运算量 | 速度 |
| 0.6 | 2 | 1.53X | 1.96X |
| 0.7 | 3 | 1.58X | 2.53X |
| 0.8 | 2 | 1.23X | 2.44X |
| 0.8 | 5 | 1.63X | 3.69X |
| 0.9 | 2 | 1.11X | 2.71X |
| 0.9 | 10 | 1.60X | 6.86X |
与其基于 \(\alpha\) 选取单个 \(\gamma\) 值,由于 \(\beta\) 并非常数,我们可以通过预测 \(\beta\) 的值并在算法 1 运行期间相应地改变 \(\gamma\) 的值来获得进一步的改进。为了得到额外改进因子的上界,假设我们有一个关于 \(\gamma\) 的预言机。那么我们就会有 \(E(\# generated tokens) = \frac{1}{1 - \alpha}\)。对于典型的 \(c\) 和 \(\alpha\) 取值,并假设计算资源不受限制,增强后的墙钟时间改进因子可比固定 \(\gamma\) 时的改进因子高出最多约 \(60\%\)。我们将探索这一点留作未来工作。
3.6. 近似模型
推测采样,以及因此推测解码,保证对于任意选择的近似模型 \(M_{q}\) 都能产生相同的输出分布,且没有任何限制(见附录 [A.1])。在我们的实验中,我们主要测试了现有的现成较小 Transformer 作为近似模型。此外,我们只测试了与目标模型 \(M_{p}\) 架构相同、并使用相同概率标准化的近似模型。在这种设置下,选择 \(M_{q}\) 比 \(M_{p}\) 小约两个数量级通常表现最佳,从而平衡 \(\alpha\) 和 \(c\)(定理 3.8)。
另一类近似模型是 negligible-cost 模型,即 \(c \approx 0\) 的模型,也就是相对于目标模型成本可忽略的近似模型。在这种情况下,我们得到的期望墙钟时间改进为 \(\frac{1 - \alpha^{\gamma + 1}}{1 - \alpha}\),其上界为 \(\frac{1}{1 - \alpha}\)(如果 \(\gamma\) 很大,则接近取等)。一类有趣的 negligible-cost 近似模型是 n-gram 模型,其评估相当于一次表查找。有趣的是,在经验测试中(第 4.2 节),即使对于这些简单的 n-gram 模型,我们也得到了非零的 \(\alpha\)。例如,对于英德翻译任务,当 \(M_{p}\) 为 T5-XXL 11B、\(M_{q}\) 为简单的 bigram 模型时,我们得到 \(\alpha \approx 0.2\),在 \(\gamma = 3\) 时导致 \(1.25X\) 的推理速度改进因子。
其他简单的启发式方法也可以用作 negligible-cost 近似模型。例如,在长序列可能重复的情况下,如摘要任务或聊天式界面,一个
在找到匹配前缀时简单地从上下文中复制 token 的近似模型,可能会产生很高的 \(\alpha\) 值。这些无参数近似模型还有一个额外优势,即从生产部署的角度来看甚至更简单。
推测解码可以使用的另一类近似模型是非自回归模型,如 Stern 等人 [2018] 提出的那些。那么,我们只需调用一次非自回归模型,而不是算法 1 中的自回归循环。
最后一个例子,主要从理论角度有趣,是一个随机选择 token 的近似模型,它保证对所有模型 \(M_{p}\) 都有一些改进(尽管非常小)。
4. 实验
4.1. 经验墙钟时间改进
我们实现了我们的算法,并将其与 T5X 代码库中用于加速 T5-XXL 的实现进行比较。
设置 我们在 T5 论文中的两个任务上测试标准的编码器-解码器 T5 1.1 版本模型(Raffel 等人,[2020]):(1)在 WMT EnDe 上微调的英德翻译,以及(2)在 CCN/DM 上微调的文本摘要。对于这两个任务,我们使用 T5-XXL(11B)作为 \(M_{p}\)。对于近似模型 \(M_{q}\),我们测试了几种现有配置,即 T5-large(800M)、T5-base(250M)和 T5-small(77M)(Raffel 等人,[2020])。我们对所有模型使用现有检查点。我们在单个 TPU-v4 上以批大小为 1 测量墙钟时间改进,分别针对 argmax 采样(temp=0)和标准采样(temp=1)。
结果表2展示了我们方法的实证结果。我们可以看到,T5-small(77M)在和的良好平衡下,在测试的近似模型中提供了最高的加速比。正如预期的那样,我们看到随着近似模型规模的增大而增加。有趣的是,argmax采样(temp=0)下的和墙钟时间改进更高。我们观察到在翻译任务上实现了2.6倍(temp=1)和3.4倍(temp=0)的加速,而在摘要任务上加速比略低,分别为2.3倍(temp=1)和3.1倍(temp=0)。这些实证结果与理论预测吻合良好,部分差异源于实现细节(见附录A.3)。
| 任务 | Mq | TEMP | γ | α | SPEED |
| ENDE | T5-SMALL ★ | 0 | 7 | 0.75 | 3.4X |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 2.8X |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 1.7X |
| ENDE | T5-SMALL ★ | 1 | 7 | 0.62 | 2.6X |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 2.4X |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 1.4X |
| CNNDM | T5-SMALL ★ | 0 | 5 | 0.65 | 3.1X |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 3.0X |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 2.2X |
| CNNDM | T5-SMALL ★ | 1 | 5 | 0.53 | 2.3X |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 2.2X |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 1.7X |
4.2. 实证值
虽然我们仅针对T5实现了我们的方法,但我们针对各种任务、采样方法、目标模型和近似模型测量了值。具体而言,我们针对以下每种设置,在由生成的10K个token上评估了推论3.6中的期望值。
GPT类模型(97M参数)我们在无条件语言生成任务上测试了一个纯解码器Transformer模型,该模型在lm1b上训练(Chelba et al., [2013)。此处的模型是一个带有Gelu激活函数的GPT类Transformer解码器(Hendrycks & Gimpel, [2016)。对于,我们实验了一个具有6M参数的Transformer解码器模型:维度256,前馈维度1024,2层,4个注意力头,以及简单的unigram和bigram模型。具有97M参数:维度768,前馈维度3072,12层,12个注意力头。我们对所有模型使用了Bert分词(Devlin et al., [2019),词表大小为8k个token。
LaMDA(137B参数)我们在对话任务上测试了一个纯解码器LaMDA模型(Thoppilan et al., [2022)。我们使用LaMDA 137B的现有检查点作为,并使用LaMDA 8B、LaMDA 2B和LaMDA 100M作为。
关于T5-XXL(11B参数)模型的设置,请参见第4.1节。
表3总结了测试案例的值。我们观察到,比目标模型小几个数量级的近似模型往往产生介于0.5到0.9之间的值。有趣的是,我们还注意到对于所有模型,调整后的分布越尖锐,值越高。最后,我们注意到即使是简单的unigram和bigram近似也能产生不可忽略的值。例如,在英德翻译的情况下,bigram模型的值为0.2,由于此情况下,因此产生了1.25倍的加速改进,对于这种简单的近似模型而言这一加速比出奇地高(但仍低于我们使用T5-small作为近似模型所获得的加速比)。
5. 相关工作
大模型推理的效率已被广泛研究(Dehghani et al., [2021)。许多方法旨在总体上加速大模型的推理,特别是像Transformer这样的自回归模型。大量技术试图使所有token的推理更加高效,例如蒸馏(Hinton et al., [2015)、稀疏化(Jaszczur et al., [2021)、量化(Hubara et al., [2016)以及架构修改(So et al., [2021]; Shazeer [2019)。与我们的方法更接近的是自适应计算方法,它们根据问题难度调整计算量(Han et al., [2021)。示例包括仅关注输入的子集(Sukhbaatar et al., [2019)以及早期退出(Schuster et al., [2021]; Scardapane et al., [2020]; Bapna et al., [2020]; Elbayad et al., [2019]; Schwartz et al., [2020)。值得注意的是,委员会智慧(Wisdom of Committees)(Schwartz et al., [2020)利用了现成的较小模型,但它是一种自适应计算方法,因此使用启发式规则来确定何时停止,失去了与目标模型输出完全相同的保证。一般来说,自适应计算方法通常在模型内部或借助辅助模型来学习何时可以采取计算捷径。通常,这些方法在推理时间和算术运算两方面都有节省,但需要更改架构、更改训练流程并训练自定义模型或
| Mp | Mq | SMPL | α |
| 类GPT模型(97M) | UNIGRAM | T=0 | 0.03 |
| 类GPT模型(97M) | BIGRAM | T=0 | 0.05 |
| 类GPT模型(97M) | 类GPT模型(6M) | T=0 | 0.88 |
| 类GPT模型(97M) | UNIGRAM | T=1 | 0.03 |
| 类GPT模型(97M) | BIGRAM | T=1 | 0.05 |
| 类GPT模型(97M) | 类GPT模型(6M) | T=1 | 0.89 |
| T5-XXL(ENDE) | UNIGRAM | T=0 | 0.08 |
| T5-XXL(ENDE) | BIGRAM | T=0 | 0.20 |
| T5-XXL(ENDE) | T5-SMALL | T=0 | 0.75 |
| T5-XXL(ENDE) | T5-BASE | T=0 | 0.80 |
| T5-XXL(ENDE) | T5-LARGE | T=0 | 0.82 |
| T5-XXL(ENDE) | UNIGRAM | T=1 | 0.07 |
| T5-XXL(ENDE) | BIGRAM | T=1 | 0.19 |
| T5-XXL(ENDE) | T5-SMALL | T=1 | 0.62 |
| T5-XXL(ENDE) | T5-BASE | T=1 | 0.68 |
| 仅用于理解源文本的只读背景(并非待翻译的源文本): 5. 相关工作 大型模型推理的效率已被广泛研究(Dehghani et al., [2021])。许多方法旨在总体上加速大型模型的推理,尤其是像 Transformer 这样的自回归模型。大量技术试图让所有 token 的推理都更高效,例如蒸馏(Hinton et al., [2015])、稀疏化(Jaszczur et al., [2021])、量化(Hubara et al., [2016])以及架构修改(So et al. 待翻译文本: T5-XXL(ENDE) | T5-LARGE | T=1 | 0.71 |
| T5-XXL(CNNDM) | UNIGRAM | T=0 | 0.13 |
| T5-XXL(CNNDM) | BIGRAM | T=0 | 0.23 |
| T5-XXL(CNNDM) | T5-SMALL | T=0 | 0.65 |
| T5-XXL(CNNDM) | T5-BASE | T=0 | 0.73 |
| T5-XXL(CNNDM) | T5-LARGE | T=0 | 0.74 |
| T5-XXL(CNNDM) | UNIGRAM | T=1 | 0.08 |
| T5-XXL(CNNDM) | BIGRAM | T=1 | 0.16 |
| T5-XXL(CNNDM) | T5-SMALL | T=1 | 0.53 |
| T5-XXL(CNNDM) | T5-BASE | T=1 | 0.55 |
| T5-XXL(CNNDM) | T5-LARGE | T=1 | 0.56 |
| LAMDA(137B) | LAMDA(100M) | T=0 | 0.61 |
| LAMDA(137B) | LAMDA(2B) | T=0 | 0.71 |
| LAMDA(137B) | LAMDA(8B) | T=0 | 0.75 |
| LAMDA(137B) | LAMDA(100M) | T=1 | 0.57 |
| LAMDA(137B) | LAMDA(2B) | T=1 | 0.71 |
| LAMDA (137B) | LAMDA (8B) | T=1 | 0.74 |
重新训练现有模型。它们通常也会改变模型的输出。我们注意到,虽然上述许多方法改善了内存与算术运算的比率,但在该比率仍然较高的情况下,这些方法与我们的推测解码方法结合使用可能会有效。
先前有两种方法利用推测执行来加速自回归模型的解码。块并行解码(Blockwise Parallel Decoding)(Stern et al., [2018)并行解码多个token,与我们的工作类似。然而,它仅支持贪婪解码(温度),不支持一般的随机设置,需要额外训练自定义模型,并且侧重于保持下游任务质量,而非保证输出完全相同。浅层激进解码(Shallow Aggressive Decoding, SAD)(Sun et al., [2021)同样并行解码多个token,与我们的工作类似。与我们的工作不同,SAD仅支持将输入复制到输出,不支持通用的近似模型,使其仅适用于输入和输出非常相似的情况,如语法错误纠正。此外,与块并行解码类似,SAD不支持一般的随机采样设置。
在我们最初发表工作之后,一个独立的推测解码实现(Chen et al., [2023)在Chinchilla 70B上展示了类似的2倍至2.5倍的改进。
6. 讨论
我们提出了推测采样,它使得高效的随机推测执行成为可能——即在随机设置下的推测执行。我们分析了其通过推测解码对自回归模型(如Transformer)解码的影响,并表明在给定足够计算资源的情况下,我们相对于T5X(一种流行的优化实现)在实践中获得了有意义的2倍至3倍加速。
推测执行总体上以及推测解码特别是的一个局限性在于,延迟是通过增加并发性来改善的,代价是算术运算数量的增加。因此,我们的方法对于没有额外计算资源可用的配置没有帮助。然而,在额外计算资源可用的常见情况下(例如当内存带宽是瓶颈时),我们的方法提供了加速并具有显著优势:模型架构不变,无需重新训练,最重要的是,输出分布保证保持不变。我们的方法易于实现,可以使用现成模型来加速推理,而无需开发和评估自定义方案。
后续研究有多个方向,重要的是进一步研究推测解码与束搜索的兼容性(见附录A.4)。此外,虽然我们的方法使用现有现成近似模型就能产生可观的加速,但通过自定义近似模型(第3.6节)可能获得更大的改进,例如具有自定义架构的模型(如自定义规模、非自回归模型或各种启发式方法)或自定义训练流程(如使用来自的软目标进行标准蒸馏,或直接针对优化)。探索该算法的分层版本也可能很有趣,其中近似模型本身由更快的模型加速,这可能允许使用更强大的近似模型。在本工作中,我们在整个推理过程中固定了近似模型和猜测数量,但在推理过程中动态变化它们可能带来额外改进(第3.5节)。在我们的实验中,我们始终对近似模型生成的分布执行与目标模型期望的相同的标准化(第2.2节),但应用不同的变换可能获得进一步改进。我们仅在文本模态中测试了推测解码,但它可能在其他领域(如图像)中表现良好,这将是有趣的实验方向。
最后,我们指出,随机推测执行和推测采样在自回归模型的推测解码范围之外也可能有用。例如,给定两个慢函数 和 ,使得 生成一个分布,并从该分布中采样得到 的输入,我们可以使用我们的方法并行运行 和 。这种设置可能出现在例如物理模拟中,或在强化学习中,其中 是一个产生动作分布的大模型,而 是世界模拟,这将值得探索。
致谢
我们要特别感谢YaGuang Li在一切与LaMDA相关的事务上的帮助,以及计算论文中的LaMDA数据,并感谢Blake Hechtman在XLA方面的深刻见解和帮助。我们还要感谢审稿人的深刻评论,以及Asaf Aharoni、Reiner Pope、Sasha Goldshtein、Nadav Sherman、Eyal Segalis、Eyal Molad、Dani Valevski、Daniel Wasserman、Valerie Nygaard、Danny Vainstein、Google的LaMDA和Theta Labs团队,以及我们的家人。
参考文献
Bapna, A., Arivazhagan, N., and Firat, O. Controlling computation versus quality for neural sequence models. ArXiv, abs/2002.07106, 2020.
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert- Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., Hesse, C., Chen, M., Sigler, E., Litwin, M., Gray, S., Chess, B., Clark, J., Berner, C., McCandlish, S., Radford, A., Sutskever, I., and Amodei, D. Language models are few- shot learners. In Proceedings of the 34th International Conference on Neural Information Processing Systems, NIPS'20, Red Hook, NY, USA, 2020. Curran Associates Inc. ISBN 9781713829546.
Burton, F. W. Speculative computation, parallelism, and functional programming. IEEE Transactions on Computers, C- 34(12):1190- 1193, 1985. doi: 10.1109/TC.1985.6312218.
Chelba, C., Mikolov, T., Schuster, M., Ge, Q., Brants, T., Koehn, P. T., and Robinson, T. One billion word bench mark for measuring progress in statistical language modeling. In Interspeech, 2013.
Chen, C., Borgeaud, S., Irving, G., Lespiau, J.- B., Sifre, L., and Jumper, J. M. Accelerating large language model decoding with speculative sampling. ArXiv, abs/2302.01318, 2023.
Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N. M., Prabhakaran, V., Reif, E., Du, N., Hutchinson, B. C., Pope, R., Bradbury, J., Austin, J., Isard, M., Gur- Ari, G., Yin, P., Duke, T., Levskaya, A., Ghemawat, S., Dev, S., Michalewski, H., Garcia, X., Misra, V., Robinson, K., Fedus, L., Zhou, D., Ippolito, D., Luan, D., Lim, H., Zoph, B., Spiridonov, A., Sepassi, R., Dohan, D., Agrawal, S., Omernick, M., Dai, A. M., Pillai, T. S., Pelat, M., Lewkowycz, A., Moreira, E., Child, R., Polozov, O., Lee, K., Zhou, Z., Wang, X., Saeta, B., Diaz, M., Firat, O., Catasta, M., Wei, J., Meier- Hellstern, K. S., Eck, D., Dean, J., Petrov, S., and Fiedel, N. Palm: Scaling language modeling with pathways. ArXiv, abs/2204.02311, 2022.
Dehghani, M., Arnab, A., Beyer, L., Vaswani, A., and Tay, Y. The efficiency misnomer. ArXiv, abs/2110.12894, 2021.
Devlin, J., Chang, M.- W., Lee, K., and Toutanova, K. Bert: Pre- training of deep bidirectional transformers for language understanding. ArXiv, abs/1810.04805, 2019.
Elbayad, M., Gu, J., Grave, E., and Auli, M. Depth- adaptive transformer. ArXiv, abs/1910.10073, 2019.
Han, Y., Huang, G., Song, S., Yang, L., Wang, H., and Wang, Y. Dynamic neural networks: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence, 44: 7436- 7456, 2021.
Hendrycks, D. and Gimpel, K. Bridging nonlinearities and stochastic regularizers with gaussian error linear units. ArXiv, abs/1606.08415, 2016.
Hennessy, J. L. and Patterson, D. A. Computer Architecture: A Quantitative Approach. Morgan Kaufmann, Amsterdam, 5 edition, 2012. ISBN 978- 0- 12- 383872- 8.
Hinton, G. E., Vinyals, O., and Dean, J. Distilling the knowledge in a neural network. ArXiv, abs/1503.02531, 2015.
Hubara, I., Courbariaux, M., Soudry, D., El- Yaniv, R., and Bengio, Y. Quantized neural networks: Training neural networks with low precision weights and activations. ArXiv, abs/1609.07061, 2016.
Jaszczur, S., Chowdhery, A., Mohiuddin, A., Kaiser, L., Gajewski, W., Michalewski, H., and Kanerva, J. Sparse is enough in scaling transformers. In Neural Information Processing Systems, 2021.
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., and Liu, P. J. Exploring the limits of transfer learning with a unified text- to- text transformer. The Journal of Machine Learning Research, 21(1):5485- 5551, 2020.
Roberts, A., Chung, H. W., Levskaya, A., Mishra, G., Bradbury, J., Andor, D., Narang, S., Lester, B., Gaffney, C., Mohiuddin, A., Hawthorne, C., Lewkowycz, A., Salcianu, A., van Zee, M., Austin, J., Goodman, S., Soares, L. B., Hu, H., Tsvyashchenko, S., Chowdhery, A., Bastings, J., Bulian, J., Garcia, X., Ni, J., Chen, A., Kenealy, K., Clark, J., Lee, S., Garrette, D. H., Lee- Thorp, J., Raffel, C., Shazeer, N. M., Ritter, M., Bosma, M., Passos, A., Maitin- Shepard, J. B., Fiedel, N., Omernick, M., Saeta, B., Sepassi, R., Spiridonov, A., Newlan, J., and Gesmundo, A. Scaling up models and data with 5x and seqio. ArXiv, abs/2203.17189, 2022.
Scardapane, S., Scarpiniti, M., Baccarelli, E., and Uncini, A. Why should we add early exits to neural networks? Cognitive Computation, 12(5):954- 966, 2020.
Schuster, T., Fisch, A., Jaakkola, T., and Barzilay, R. Consistent accelerated inference via confident adaptive transformers. In Conference on Empirical Methods in Natural Language Processing, 2021.
Schwartz, R., Stanovsky, G., Swayamdipta, S., Dodge, J., and Smith, N. A. The right tool for the job: Matching model and instance complexities. In Annual Meeting of the Association for Computational Linguistics, 2020.
Shazeer, N. M. Fast transformer decoding: One write- head is all you need. ArXiv, abs/1911.02150, 2019.
So, D. R., Ma'ake, W., Liu, H., Dai, Z., Shazeer, N. M., and Le, Q. V. Primer: Searching for efficient transformers for language modeling. ArXiv, abs/2109.08668, 2021.
Stern, M., Shazeer, N., and Uszkoreit, J. Blockwise parallel decoding for deep autoregressive models. Advances in Neural Information Processing Systems, 31, 2018.
Sukhbaatar, S., Grave, E., Bojanowski, P., and Joulin, A. Adaptive attention span in transformers. In Annual Meeting of the Association for Computational Linguistics, 2019.
Sun, X., Ge, T., Wei, F., and Wang, H. Instantaneous grammatical error correction with shallow aggressive decoding. ArXiv, abs/2106.04970, 2021.
Thoppilan, R., Freitas, D. D., Hall, J., Shazeer, N. M., Kulshreshtha, A., Cheng, H.- T., Jin, A., Bos, T., Baker, L., Du, Y., Li, Y., Lee, H., Zheng, H., Ghafouri, A., Menegali, M., Huang, Y., Krikun, M., Lepikhin, D., Qin, J., Chen, D., Xu, Y., Chen, Z., Roberts, A., Bosma, M., Zhou, Y., Chang, C.- C., Krivokon, I. A., Rusch, W. J., Pickett, M., Meier- Hellstern, K. S., Morris, M. R., Doshi, T., Santos, R. D., Duke, T., Soraker, J. H., Zevenbergen, B., Prabhakaran, V., Díaz, M., Hutchinson, B., Olson, K., Molina, A., Hoffman- John, E., Lee, J., Aroyo, L., Rajakumar, R., Butryna, A., Lamm, M., Kuzmina, V. O., Fenton, J., Cohen, A., Bernstein, R., Kurzweil, R., Aguera- Arcas, B., Cui, C., Croak, M., hsin Chi, E. H., and Le, Q. Lamda: Language models for dialog applications. ArXiv, abs/2201.08239, 2022.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Attention is all you need. Advances in neural information processing systems, 30, 2017.
Yu, J., Xu, Y., Koh, J. Y., Luong, T., Baid, G., Wang, Z., Vasudevan, V., Ku, A., Yang, Y., Ayan, B. K., Hutchinson, B. C., Han, W., Parekh, Z., Li, X., Zhang, H., Baldridge, J., and Wu, Y. Scaling autoregressive models for content-rich text- to- image generation. ArXiv, abs/2206.10789, 2022.
A. 附录
A.1. 推测采样的正确性
我们现在要证明,对于任意分布 和 ,通过投机采样从 和 中采样得到的 token 的分布,与仅从 中采样得到的 token 的分布完全相同。令 为接受概率(定义 3.1)。
注意,由于 ,调整后分布 的归一化常数为 ,其中最后一个等式直接由引理 3.3 和定理 3.5 得出。
现在:
其中:
并且:
总体而言:
符合预期。
A.2. 投机采样与拒绝采样
拒绝采样是以下迭代采样过程,表面上与我们的方法相似:
1. 采样 和 。
2. 如果 ,返回 。
3. 转到第1步。
其中 。我们可以采用拒绝采样的非迭代版本代替投机采样——具体来说,执行上述步骤1和2,否则直接从未经修改的 中采样。不过,那样会比我们的方法低效得多。具体而言,这里的期望接受概率为 ,它(可能远)低于我们方法中的期望接受概率 。
A.3. 理论预测与经验运行时间
表4将基于定理3.8的期望运行时间改进与表2中经验测量的运行时间进行了比较。我们根据性能分析器(profiler)的跟踪记录估计了各个模型的 值。可以看到,理论预测与测量到的运行时间基本吻合。较大的差异源于:(1) 我们的实现与基线之间的优化差异;(2) 为独立同分布的简化假设只是一个近似(见第3.1节)。
| TASK | MQ | TEMP | γ | α | c | EXP | EMP |
| ENDE | T5-SMALL | 0 | 7 | 0.75 | 0.02 | 3.2 | 3.4 |
| ENDE | T5-BASE | 0 | 7 | 0.8 | 0.04 | 3.3 | 2.8 |
| ENDE | T5-LARGE | 0 | 7 | 0.82 | 0.11 | 2.5 | 1.7 |
| ENDE | T5-SMALL | 1 | 7 | 0.62 | 0.02 | 2.3 | 2.6 |
| ENDE | T5-BASE | 1 | 5 | 0.68 | 0.04 | 2.4 | 2.4 |
| ENDE | T5-LARGE | 1 | 3 | 0.71 | 0.11 | 2.0 | 1.4 |
| CNNDM | T5-SMALL | 0 | 5 | 0.65 | 0.02 | 2.4 | 3.1 |
| CNNDM | T5-BASE | 0 | 5 | 0.73 | 0.04 | 2.6 | 3.0 |
| CNNDM | T5-LARGE | 0 | 3 | 0.74 | 0.11 | 2.0 | 2.2 |
| CNNDM | T5-SMALL | 1 | 5 | 0.53 | 0.02 | 1.9 | 2.3 |
| CNNDM | T5-BASE | 1 | 3 | 0.55 | 0.04 | 1.8 | 2.2 |
| CNNDM | T5-LARGE | 1 | 3 | 0.56 | 0.11 | 1.6 | 1.7 |
表4. 期望改进因子(Exp)与经验测量的改进因子(EMP)。
A.4. 应用于束搜索
我们的方法可以应用于束搜索采样,但会有一定的性能损失。给定原始束宽 ,我们可以用近似模型 和束宽 执行 步束搜索。然后,我们可以用 并行检查所有候选(计算预算为 次运行 )。最后,对于每一步,只要 ,我们就可以接受 的猜测,从而得到与单独使用 进行常规束搜索相同的结果(通过更精细的流程,我们也可以接受我们得到的候选恰好比单独使用 时概率更高的情况)。在这种设置下对我们方法的分析更为复杂,我们将其留待未来工作。
A.5. 宽松度
算法 的一个强性质是输出分布保证保持不变。话虽如此,如果我们愿意允许一些变化并获得良好的保证,我们就可以进一步提升推理速度。为进一步说明这一点,请注意,当我们在同一数据集上训练两个架构和规模相同的模型时,生成的概率分布不会完全相同,因此一定程度的宽松是有意义的。请注意,本文中除本节以外的结果均使用算法 的最严格版本,不允许任何形式的宽松。
我们可以在算法 中引入宽松参数 ,并在与 比较之前将 乘以 。这仍然保持了良好的保证:任何 token 被采样的概率都不会大于 。例如,这意味着当 时,任何 token 被采样的概率都不会超过其真实概率的10倍,因此我们可以保证极其稀有的 token 仍然极其稀有(对最低概率没有保证,因此宽松可能会损害样本的多样性)。
具体而言,使用宽松因子 时,我们有 \begin{array}{r l r}{{\alpha}~=}&{{}E_{x\sim q(x)}\left\{\begin{array}{l l}{1}&{l q(x)\leq p(x)}\\ {\frac{p(x)}{l q(x)}}&{l q(x)>p(x)}\end{array}\right.}&{{}=}&{{}E_{x\sim q(x)}\frac{p(x)}{m a x(p(x),l q(x))}}}\end{array}
表5显示了当 为 T5-XXL (11B)、 为 T5-small (77M) 时,不同 取值下的 值。当 时,使用宽松值1、0.5、0.3和0.1(意味着任何 token 被采样的概率都不会超过其真实概率的1倍、2倍、3倍和10倍),我们分别得到2.5倍、3.1倍、3.6倍和5倍的改进因子。
| MQ | l = 1 | l = 0.5 | l = 0.3 | l = 0.1 |
| UNIGRAM | 0.07 | 0.1 | 0.11 | 0.16 |
| BIGRAM | 0.19 | 0.23 | 0.25 | 0.32 |
| T5-SMALL (77M) | 0.62 | 0.71 | 0.76 | 0.84 |
| T5-BASE (250M) | 0.68 | 0.8 | 0.83 | 0.90 |
表5. 在 EnDe 翻译任务中,当 为 T5-XXL (11B) 时,标准采样下不同 取值对应的 值。
请注意,当使用温度 (即 argmax 采样)时,我们不再能像上面那样使用宽松。相反,我们可以在标准化分布之前允许一定程度的宽松。例如,如果 ,我们可以接受从 采样的 token 。在这种情况下,我们测得的 值经验增幅与温度 时相似。例如,当 为 T5-XXL、 为 T5-small 用于英德翻译时,使用宽松值1、0.5、0.3和0.1,我们得到的 值分别为0.75、0.75、0.8、0.87。以 和 为例,我们分别得到3.3倍、3.3倍、3.9倍和4.9倍的速度改进因子。7