
同一套框架说明注意力和状态空间模型是同一个矩阵的两种看法,并给出更快的序列层。ICML 2024 论文,全文免费在线阅读。
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality
Transformer即SSM:通过结构化状态空间对偶性的广义模型与高效算法
普林斯顿大学计算机科学系 卡内基梅隆大学机器学习系 tri@tridao.me, agu@cs.cmu.edu
摘要
尽管Transformer一直是深度学习在语言建模领域取得成功的核心架构,但诸如Mamba之类的状态空间模型(SSM)近来已被证明在中小规模上能够媲美甚至超越Transformer。我们表明,这两类模型实际上关系相当密切,并构建了一个丰富的理论联系框架,将SSM与注意力的各种变体联系起来,这些联系通过一类已被充分研究的结构化半可分矩阵的各种分解得以建立。我们的状态空间对偶性(SSD)框架使我们能够设计一种新架构(Mamba-2),其核心层是对Mamba选择性SSM的改进,速度提升2-8倍,同时在语言建模上继续与Transformer保持竞争力。
1 引言
Transformer,特别是以因果方式处理输入序列的仅解码器模型(例如GPT(Brown et al. 2020)、Llama(Touvron, Lavril, et al. 2023)),是现代深度学习成功的的主要推动力之一。众多方法试图近似核心注意力层,以解决其效率问题(Tay et al. 2022),例如训练时随序列长度呈二次方扩展,以及在自回归生成时所需缓存大小随序列长度呈线性增长。与此同时,一类替代性的序列模型——结构化状态空间模型(SSM)——已经出现,其在训练时随序列长度呈线性扩展,在生成时状态大小保持恒定。它们在长程任务上展现出强劲性能(例如S4(Gu, Goel, and Ré 2022)),并且近来在中小规模的语言建模上媲美甚至超越了Transformer(例如Mamba(Gu and Dao 2023))。然而,SSM的发展似乎与社区改进Transformer的集体努力相脱节,这些努力包括在理论上理解它们以及在现代硬件上优化它们。因此,与Transformer相比,理解和实验SSM更为困难,并且无论从算法还是系统角度来看,将SSM训练得与Transformer一样高效仍然具有挑战性。
我们的主要目标是构建一个丰富的理论联系体系,将结构化SSM与注意力的各种变体关联起来。这将使我们能够将最初为Transformer开发的算法和系统优化迁移到SSM上,朝着构建基础模型的目标迈进——这些模型在性能上超越Transformer,同时在序列长度上具有更高的扩展效率。这一方向上的一个里程碑式贡献是线性注意力(Linear Attention, LA)框架(Katharopoulos et al. 2020),该框架通过证明二次核化注意力的“对偶形式”与特定线性递推之间的等价性,推导出了自回归注意力与线性RNN之间的联系。这种对偶性带来了新的能力,例如同时具备高效可并行训练和高效自回归推理的能力。本着同样的精神,本文提供了多种视角,将线性复杂度的SSM与二次复杂度的形式联系起来,以结合SSM和注意力的优势。
状态空间对偶性。我们连接结构化SSM与注意力变体的框架——称为结构化状态空间对偶性(Structured State Space Duality, SSD)——是通过结构化矩阵的抽象来建立的:即具有亚二次参数和乘法复杂度的矩阵。我们开发了两个广泛的框架来表示序列模型,一个作为矩阵变换,一个作为张量收缩,各自揭示了了对偶性的不同视角。我们的技术贡献包括:
- 我们展示了状态空间模型与一类被广泛研究的结构化矩阵——半可分离矩阵(semiseparable matrices)——之间的等价性(第3节)。这一联系是我们框架的核心,揭示了SSM的新性质和算法。本文的一个核心信息是,计算状态空间模型的不同方法可以被重新表述为结构化矩阵上的各种矩阵乘法算法。
- 我们显著改进了线性注意力理论(Katharopoulos et al. 2020)。我们首先通过张量收缩的语言为其递推形式提供了一个深刻的证明,然后将其推广到一类新的结构化掩码注意力(Structured Masked Attention, SMA)(第4节)。
- 我们连接了SSM和SMA,表明它们具有一个大的交集,彼此互为对偶,同时具备类SSM的线性形式和类注意力的二次形式(第5节)。我们还证明了任何具有快速递推形式的核注意力方法必定是一个SSM。
除了其内在的理论价值之外,我们的框架为理解和改进序列模型开辟了广泛的方向。
高效算法。首先也是最重要的是,我们的框架揭示了用于计算SSM的新的高效且易于实现的算法(第6节)。我们引入了一种新的SSD算法,基于半可分离矩阵的块分解,同时利用线性SSM递推和二次对偶形式的优势,在所有主要效率维度上(例如训练和推理计算量、内存使用,以及利用现代硬件上矩阵乘法单元的能力)获得最优权衡。SSD的专用实现比Mamba优化的选择性扫描实现快,同时允许更大的递归状态大小(于Mamba的规模甚至更高,且性能下降极小)。SSD与softmax注意力的优化实现(FlashAttention-2 (Dao 2024))相比极具竞争力,在序列长度时交叉,在序列长度16K时快。
架构设计。采用SSM等新架构的一个主要障碍是为Transformer量身定制的生态系统,例如用于大规模训练的硬件高效优化和并行技术。我们的框架允许使用注意力已有的约定和技术,为SSM构建架构设计选择的词汇表,并进一步改进它们(第7节)。例如,我们引入了多头注意力(MHA)中“头”的概念在SSM中的对应物。我们展示了Mamba架构是一种多输入SSM(MIS),结果证明它类似于多值注意力(MVA),并比较了Mamba其他具有不同头结构的变体。
我们还利用这些思想对Mamba块做了细微修改,使其能够实现张量并行(例如以Megatron (Shoeybi et al. 2019)的风格)。主要思想包括引入分组值注意力(Grouped-Value Attention, GVA)头结构,并将所有数据相关的投影移到块的开头并行执行。
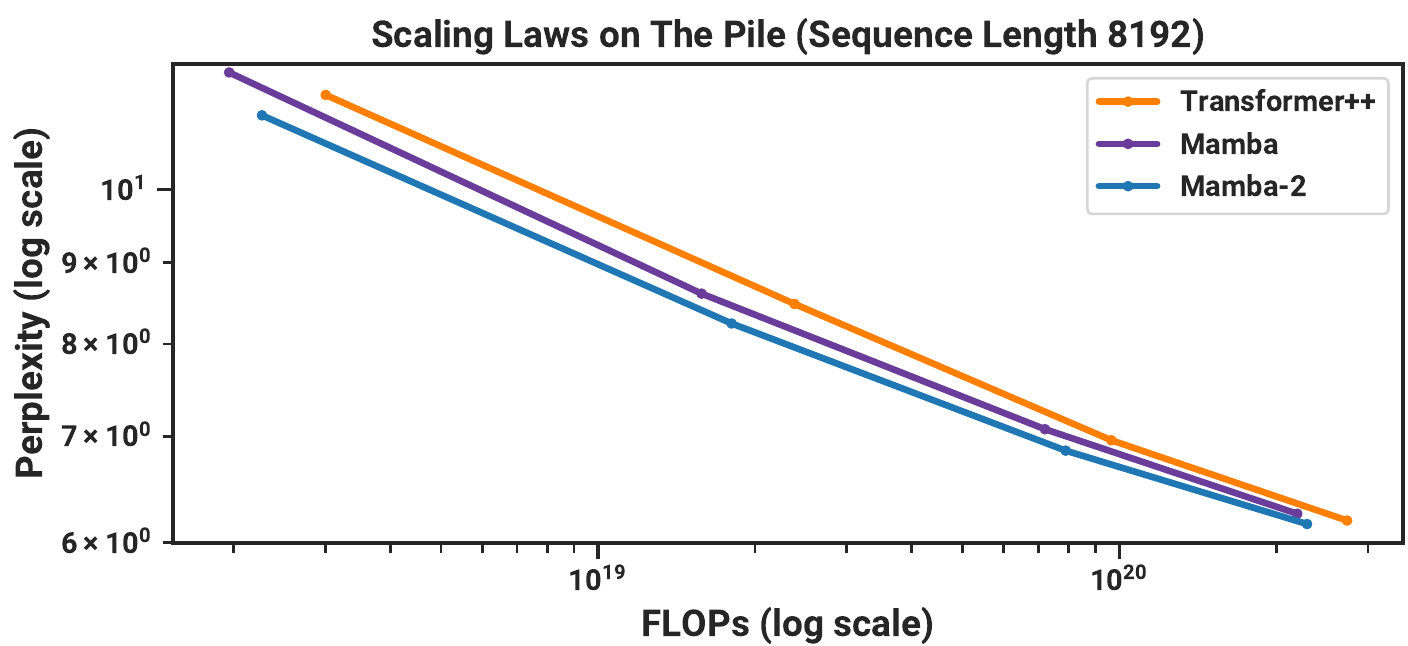
修改后的并行Mamba块与使用SSD作为内部SSM层的组合,构成了Mamba-2架构。我们在与Mamba相同的设置下研究了Mamba-2的Chinchilla缩放定律,发现它在困惑度和实际耗时方面均帕累托优于Mamba和Transformer++。我们还在Pile上训练了不同规模的一系列Mamba-2模型,表明它在标准下游评估中匹配或超越了Mamba和开源Transformer。例如,在Pile上使用300B token训练的2.7B参数Mamba-2优于在同一数据集上训练的Mamba-2.8B、Pythia-2.8B甚至Pythia-6.9B。
系统优化。SSD框架连接了SSM和Transformer,使我们能够利用为Transformer开发的丰富的系统优化工作(第8节)。
- 例如,张量并行(TP)是一种重要的模型并行技术,通过将每一层拆分到同一节点上的多个GPU上来训练大型Transformer模型。我们将Mamba-2设计为对TP友好,将每个块的同步点数量减少了一半。
- 对于激活值无法容纳在单个设备上的超长序列,研究人员为注意力块开发了序列并行技术。我们描述了如何 generally 训练SSM,特别是如何通过序列并行训练Mamba-2,即在设备之间传递循环状态。
- 对于使用不同长度样本进行微调的场景,为实现最佳效率,Transformer需要复杂的技术来移除填充token并在变长序列上执行注意力计算。我们展示了Mamba-2如何高效地以可变序列长度进行训练,且无需填充token。
第9节通过语言建模、训练效率以及一项困难的多查询联想回忆任务(Arora, Eyuboglu, Zhang, et al. 2024)对Mamba-2进行了实证验证。最后,在第10节中,我们提供了扩展的相关工作综述,并讨论了我们的框架所开辟的潜在研究方向。
模型代码和预训练检查点已开源于 https://github.com/state-spaces/mamba。
2 背景与概述
2.1 结构化状态空间模型
结构化状态空间序列模型(S4)是近期出现的一类用于深度学习的序列模型,与RNN、CNN以及经典状态空间模型广泛相关。它们受一个特定的连续系统(1)启发,该系统通过一个隐式潜在状态 将一维序列 进行映射。
结构化SSM的一般离散形式采用方程(1)的形式。
其中 。结构化SSM之所以如此命名,是因为控制时间动态的 矩阵必须具有结构化形式,才能以足够高效的方式计算这种序列到序列的变换,从而用于深度神经网络。最初引入的结构是对角加低秩(DPLR)(Gu, Goel, and Ré 2022)和对角结构(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023),其中对角结构至今仍是最流行的结构。
在本工作中,我们使用术语状态空间模型(SSM)来指代结构化SSM。这类SSM有多种变体,与神经序列模型的若干主要范式(如连续时间模型、循环模型和卷积模型)有着深厚的联系(Gu, Johnson, Goel, et al. 2021)。我们在下文提供简要概述,更多背景和细节请参阅先前工作(Gu 2023; Gu and Dao 2023)。
连续时间模型。最初的结构化SSM起源于作用于函数 上的连续时间映射,而非直接作用于序列。从连续时间的视角来看,在方程(1a)中,矩阵 并非直接学习得到,而是由底层参数 以及一个参数化的步长 生成。“连续参数” 通过固定公式 和 转换为“离散参数” ,其中对 被称为离散化规则。
注1. 虽然我们的主要模型采用与先前工作相同的参数化和离散化步骤(详见 Gu and Dao (2023)),但为简化阐述和记号,我们在本文余下部分将其省略。我们注意到,先前关于结构化SSM的工作将连续参数 和离散参数 分别称为 和 ;我们更改了记号以简化表述,并直接聚焦于支配主要SSM递归的离散参数。
循环模型。方程(1)和(2)采用对其输入 线性的递归形式。因此,结构化SSM可以被视为循环神经网络(RNN)的一种类型,其中线性特性赋予了它们额外的性质,并使它们能够避免传统RNN的顺序计算。反过来,尽管有这种简化,SSM作为序列变换仍然具有完全的表达能力(在通用逼近的意义上)(Kaul 2020; Orvieto et al. 2023; Shida Wang and Xue 2023)。
卷积模型。当SSM的动态随时间恒定时(如方程(1)所示),该模型被称为线性时不变(LTI)模型。在这种情况下,它们等价于卷积。因此,SSM也可以被视为CNN的一种类型,但其中(i)卷积核通过SSM参数 隐式参数化,(ii)卷积核通常是全局的而非局部的。反过来,根据经典信号处理理论,所有足够良态的卷积都可以表示为SSM。
通常,先前的LTI SSM会使用卷积模式进行高效的可并行训练(此时整个输入序列可预先获知),并切换到循环模式(1)进行高效的自回归推理(此时输入逐步到达)。
选择性状态空间模型。参数 也可以随时间变化的形式(2)在Mamba中被引入为选择性SSM。与标准LTI公式(1)相比,该模型可以在每个时间步选择性地关注或忽略输入。研究表明,它在信息密集型数据(如语言)上的表现远优于LTI SSM,尤其是当其状态大小N增大从而提供更多信息容量时。然而,它只能以循环模式而非卷积模式计算,并且需要精心设计的硬件感知实现才能高效运行。即便如此,它仍然不如CNN和Transformer等硬件友好的模型高效,因为它没有利用矩阵乘法单元,而现代加速器(如GPU和TPU)正是为此类运算专门优化的。
虽然时不变SSM与连续、循环和卷积序列模型密切相关,但它们与注意力机制没有直接关系。在本文中,我们展示了选择性SSM与注意力之间更深层的关系,并利用这一关系显著提升SSM的训练速度,同时允许更大的状态大小N。
结构化SSM作为序列变换。
定义2.1. 我们使用术语序列变换来指代序列上的参数化映射 ,其中 , 是任意参数集合。T表示序列轴或时间轴;下标索引第一维,例如 。
序列变换(例如SSM或自注意力)是深度序列模型的基石,它们被整合到神经网络架构(例如Transformer)中。(1)或(2)中的SSM是一个 的序列变换;通过简单地沿该维度广播(换言之,将输入视为 个独立序列并对每个序列应用SSM),它可以推广到 。可以将 视为头维度,我们将在第7节中详细阐述。
定义2.2. 我们将SSM算子 定义为由方程(2)所定义的序列变换 。
在SSM中,N维是一个自由参数,称为状态大小或状态维度。我们也称其为状态扩展因子,因为它将输入/输出的规模扩展倍,这对这些模型的计算效率有影响。
最后,我们指出许多类型的序列变换,例如注意力,可以表示为沿序列维度的单次矩阵乘法。
定义2.3. 若序列变换可以写成的形式,其中是依赖于参数的矩阵,则称其为矩阵变换。我们将序列变换与矩阵等同,并在上下文清晰时常常省略对的依赖。
2.2 注意力
注意力广义上指的是一类为序列中每一对位置分配分数的计算,允许每个元素“关注”其余元素。迄今为止最常见且最重要的注意力变体是softmax自注意力,其可定义为
其中。成对比较机制(通过具体化Q K^{\top}诱导)导致了注意力典型的二次训练成本。
已经提出了许多注意力变体,但都共享这些注意力分数的核心基础,并伴有各种近似(Tay et al. 2022)。对本工作最重要的变体是线性注意力(Katharopoulos et al. 2020)。粗略地说,这一系列方法通过将softmax折叠为核特征映射来去除softmax,并利用矩阵乘法的结合性将(Q K^{\top})\cdot V = Q\cdot (K^{\top}V)重写。此外,在因果(自回归)注意力这一重要情形中,他们表明当因果掩码被纳入左侧为(L\circ Q K^{\top})\cdot V时,其中是下三角全1矩阵,右侧可以展开为递推形式。若干近期和同期工作如RetNet(Y. Sun et al. 2023)和GateLoop(Katsch 2023)将其强化为更一般的形式(第10节)。在本工作中,我们对结构化掩码注意力的表述将强有力地推广这些思想。
2.3 结构化矩阵
一般矩阵需要个参数来表示,并且执行基本操作(如矩阵-向量乘法)需要时间。结构化矩阵是那些(i)可以通过压缩表示以亚二次(理想情况下线性)参数表示,且(ii)通过直接操作该压缩表示具有快速算法(最重要的是矩阵乘法)的矩阵。
也许最典型的结构化矩阵族是稀疏矩阵和低秩矩阵。然而,还存在许多其他族,如Toeplitz、Cauchy、Vandermonde和蝶形矩阵,它们都已被用于机器学习中的高效模型(Dao, Gu, et al. 2019; D. Fu et al. 2024; Gu, Gupta, et al. 2022; Thomas et al. 2018)。结构化矩阵是高效表示和算法的强大抽象。在本工作中,我们将证明SSM等价于另一类此前未在深度学习中使用的结构化矩阵,并利用这一联系推导出高效的方法和算法。
2.4 概述:结构化状态空间对偶
尽管本文构建了 SSM、注意力和结构化矩阵之间更为丰富的联系框架,我们在此简要总结主要方法,该方法实际上相当自包含且在算法上简单。
循环(线性)形式。状态空间对偶(SSD)层可以定义为选择性 SSM(2)的一个特例。可以应用 SSM 作为循环(或并行扫描)的标准计算,其关于序列长度具有线性复杂度。与 Mamba 中使用的版本相比,SSD 有两个细微差别:
上的结构从对角结构进一步简化为标量乘以单位结构。在这种情况下,每个 也可以仅用标量来标识。我们使用更大的头维度 ,相比于 Mamba 中使用的 。通常选择 ,这与现代 Transformer 的惯例类似。
与原始的选择性 SSM 相比,这些变化可以看作是以略微降低表达能力为代价,换取显著的训练效率提升。特别是,我们的新算法将允许在现代加速器上使用矩阵乘法单元。
对偶(二次)形式。SSD 的对偶形式是一种与注意力密切相关的二次计算,定义为
其中 是依赖于输入的标量,取值范围在 [0, 1] 内。
与标准 softmax 注意力相比,有两个主要区别
- 去掉了 softmax。
- 注意力矩阵与一个额外的掩码矩阵 逐元素相乘。
这两个变化都可以看作是在解决普通注意力中的问题。例如,最近观察到 softmax 会导致注意力分数方面的问题,例如“注意力汇聚”现象(Darcet et al. 2024; Xiao et al. 2024)。更重要的是,掩码矩阵 可以看作是用一种不同的、依赖于数据的位置掩码来替代 Transformer 中启发式的位置嵌入,该掩码控制着跨时间传递多少信息。
更广泛地说,这种形式是我们在第 4 节中定义的结构化掩码注意力对线性注意力的推广的一个实例。
矩阵形式与 SSD 算法。SSD 的各种形式通过统一的矩阵表示相互联系,即证明 SSM 具有矩阵变换形式 ,其中矩阵 依赖于 。特别地,SSD 的对偶形式等价于用矩阵 进行朴素(二次时间)乘法,而循环形式是一种利用 中结构的特定高效(线性时间)算法。
除此之外,任何用 进行乘法的算法都可以应用。我们提出的硬件高效 SSD 算法(第 6 节)是一种新的结构化矩阵乘法方法,它涉及 的分块分解,相比纯线性或二次形式获得了更好的效率权衡。与一般的选择性 SSM 相比,它相对简单且易于实现(Gu and Dao 2023);代码清单 1 提供了几行代码的完整实现。
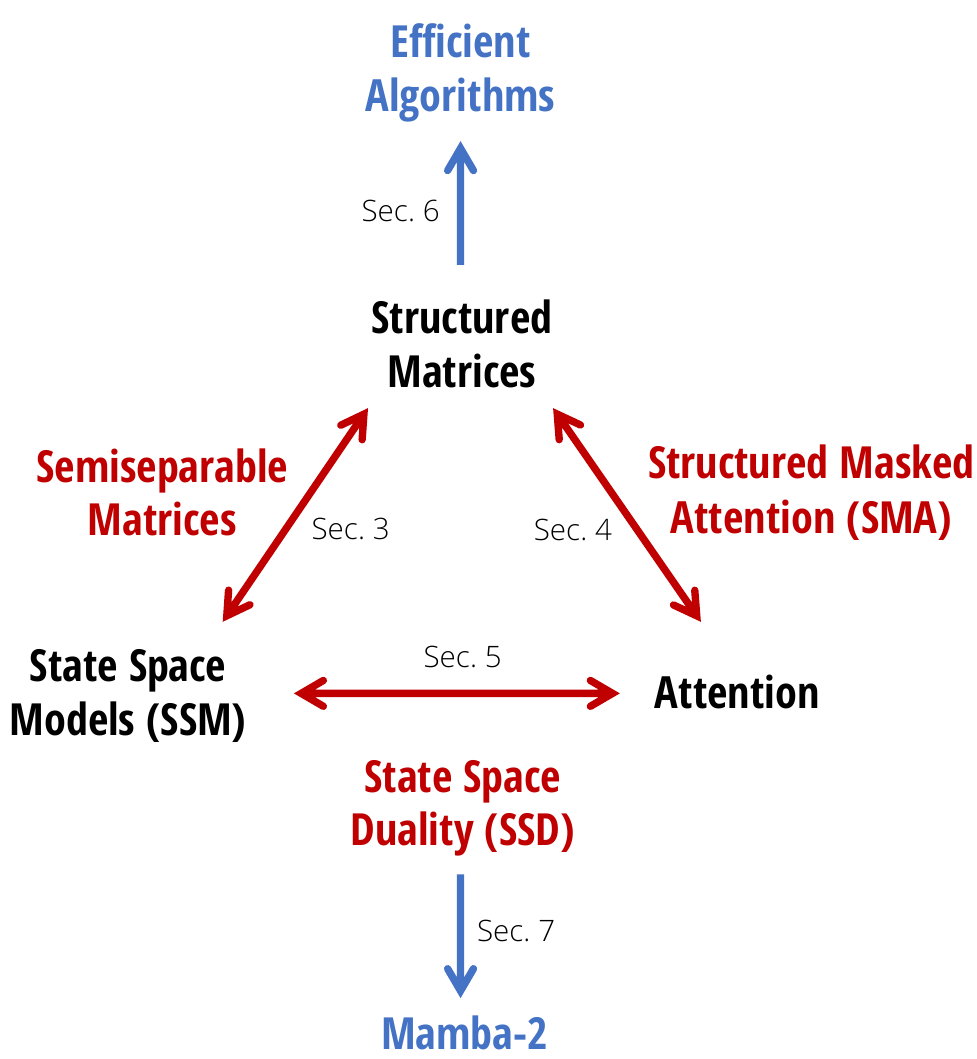
图 1 提供了本文所呈现概念之间关系的简单路线图。
2.5 符号说明
在本文中,我们倾向于使用能够映射到代码的精确符号。
矩阵与向量。我们通常使用小写字母表示向量(即具有单一轴的张量),使用大写字母表示矩阵(即具有多个轴的张量)。在本工作中我们不对矩阵使用粗体。有时,如果一个矩阵在某一轴上被绑定或重复(因此也可以视为向量),我们可能对其使用大写或小写字母。 表示标量或矩阵乘法,而 表示 Hadamard(逐元素)乘法。
索引。我们使用 Python 风格的索引,例如 当 时指范围 ,当 时指 。例如,对于任意符号 ,我们令 (其中 )表示序列 。 等价于 。为简便起见,我们还令 表示乘积 。
维度。为了与矩阵和张量区分,我们经常使用打字机字体的大写字母(例如 )来表示维度和张量形状。我们经常使用 而非传统记号 ,以反映代码中的张量形状。
张量收缩。为了清晰性以及作为陈述和证明结果的核心工具,我们将大量依赖张量收缩或 einsum 记号。我们假设读者熟悉这种记号,它常用于 numpy 等现代张量库中。例如,我们可以使用 contract 表示矩阵-矩阵乘法算子,而在我们的记号中,contract (等价于 )可以翻译为代码 numpy.einsum('mn,nk , X, Y)。
大量符号词汇表包含在附录 A 中。
3 状态空间模型是结构化矩阵
本节探讨状态空间模型作为序列变换的不同视角,并概述此类映射的性质和算法。本节的主要结果关于状态空间模型与一类称为半可分矩阵的结构化矩阵之间的等价性,这蕴含了新的效率结果(定理 3.5 和 3.7)。
3.1 状态空间模型的矩阵变换形式
回顾我们对 SSM 的定义是通过(2)定义的参数化映射。我们的理论框架首先简单地将此变换写为矩阵乘法,将向量 映射。
根据定义,。通过归纳,
通过乘以以产生,并对对方程进行向量化,我们推导出SSM的矩阵变换形式。
3.2 半可分矩阵
式(3)中的是一类称为半可分矩阵的矩阵的特定表示。半可分矩阵是一种基本的矩阵结构。我们首先定义这些矩阵及其性质。
定义3.1. 一个(下三角)矩阵是N-半可分的,如果包含在下三角部分(即对角线上或对角线下方)的每个子矩阵的秩至多为N。我们称N为半可分矩阵的阶或秩。
定义3.1以及其他形式的相关“可分”结构(例如拟可分矩阵以及半可分矩阵的其他定义)有时被称为结构化秩矩阵(或秩结构化矩阵),因为它们以子矩阵上的秩条件为特征。半可分矩阵有许多结构化表示,包括层次半可分(HSS)、顺序半可分(SSS)和Bruhat形式(Pernet and Storjohann 2018)。我们将主要使用SSS形式。
3.2.1 顺序半可分(SSS)表示
定义3.2. 一个下三角矩阵具有N-顺序半可分(SSS)表示,如果它可以写成以下形式
其中向量,矩阵
我们定义算子SSS使得
半可分矩阵的一个基本结果是,它们恰好等价于具有SSS表示的矩阵。一个方向可以通过简单的构造性证明推出。
引理3.3. 具有表示(4)的N-SSS矩阵是N-半可分的。
证明. 考虑任意非对角块,其中。这具有显式的秩-N分解为
由于对角矩阵易于处理(例如,乘以对角矩阵等同于逐元素的标量乘法),我们可以忽略这些项。因此,我们对1-SS矩阵的基本表示是 ,或者
1-SS矩阵的重要性在于它们等价于标量递推的最小形式——即状态维度为 且没有 投影的退化SSM的情形。注意,乘法 可以通过递推来计算
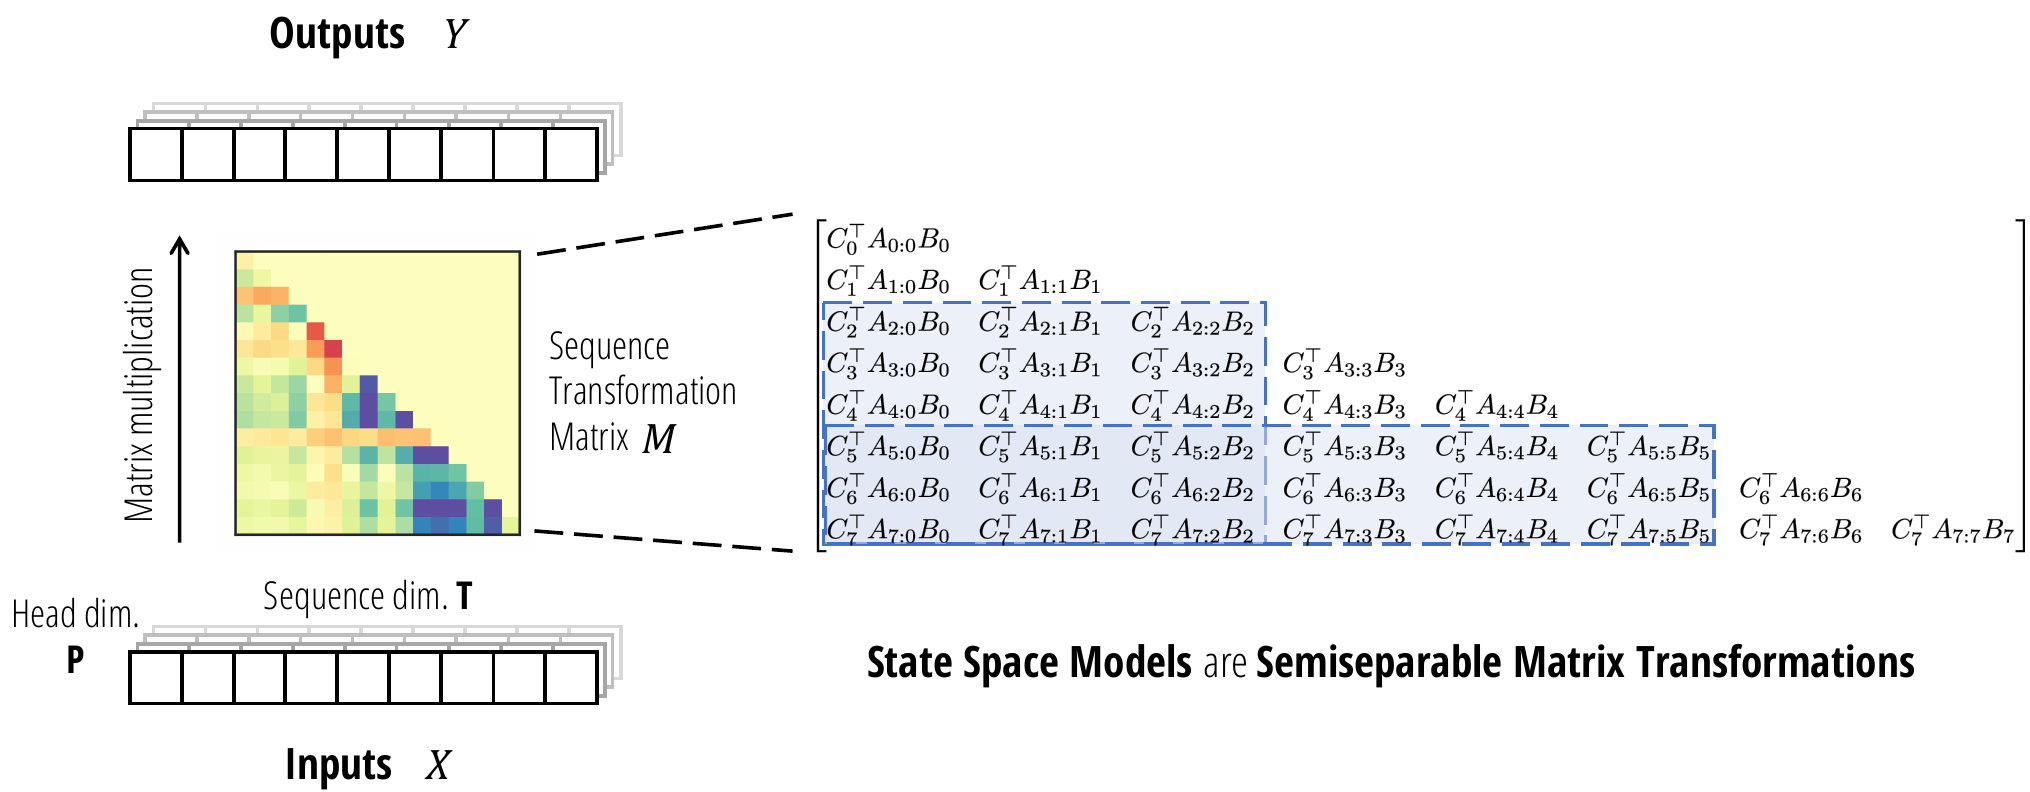
因此,我们也将与1-SS矩阵的矩阵乘法称为标量SSM递推或cumprodsum(累积乘积和;累积乘积与累积和的推广)算子。作为递推的基本形式,与1-SS矩阵的乘法作为我们主要算法的构建模块十分重要。
我们强调,本文的中心主题之一是,序列模型上的许多算法可以归约为结构化矩阵乘法算法。1-SS矩阵例证了这种联系:有许多快速算法用于计算原始标量递推或cumprodsum算子,而所有这些算法最终都等价于1-SS矩阵的不同结构化分解。我们将附录B专门用于这些1-SS矩阵乘法的算法。
3.3 状态空间模型是半可分矩阵
回想一下,我们对SSM的定义是通过定义2.1定义的参数化映射。SSM与半可分矩阵之间的联系仅仅来自于将这个变换写成一个矩阵乘法,将向量 映射。
方程(3)直接建立了状态空间模型与顺序半可分表示之间的联系,而后者一般又等价于半可分矩阵(引理3.3和命题3.4)。
定理3.5. 状态大小为 的状态空间模型变换 等同于在顺序半可分表示 中与一个N-SS矩阵的矩阵乘法。
换言之,序列变换算子SSM(定义2.2)与矩阵构造算子SSS(定义3.2)一致,我们可互换使用它们(有时也用SS作为简写)。此外——由于命运的巧合——结构化状态空间模型和顺序半可分矩阵具有相同的缩写,强调了它们的等价性!方便的是,我们可以互换使用这些缩写中的任何一个——SSM(状态空间模型或半可分矩阵)、SSS(结构化状态空间或顺序半可分)或SS(状态空间或半可分)——来明确无误地指代任一概念。然而,我们通常采用以下约定:SSM指状态空间模型,SS指半可分,SSS指顺序半可分。
图2展示了状态空间模型作为半可分矩阵的序列变换视角。
3.4 通过结构化矩阵算法计算状态空间模型
定理3.5之所以重要,是因为它将允许我们将SSM(以及其他序列模型)的高效计算问题归约为结构化矩阵乘法的有效算法。我们简要提供一个概述,并在第4节和第5节展示SSM与其他序列模型的等价性之后,将我们的主要新算法推迟到第6节。
如前所定义,半可分矩阵(即秩结构化矩阵)是一种经典的结构化矩阵:
(i) 它们具有压缩表示,例如SSS形式,仅具有 而非 个参数。
(ii) 它们具有直接在压缩表示上操作的快速算法。
此外,参数化和矩阵乘法成本在半可分阶数上可以是紧的。
命题3.6(Pernet, Signargout, and Villard (2023))。一个大小为 的N-SS矩阵可以用 个参数表示,并且其矩阵-向量乘法在时间和空间上为 。
例如,1-SS矩阵例证了这种联系的本质。矩阵 由恰好 个参数 定义,并且可以通过遵循标量递推(7)在 时间内计算。
3.4.1 线性(递推)模式
命题3.6在对角结构化SSM(S4D (Gu, Gupta, et al. 2022))的情况下可以很容易地看出,只需利用状态空间模型公式(2)并展开递推。我们在(8)中提供了形式化的张量收缩算法,其中维度S等于 。
这里, 定义为 ,换言之,对于 ,。该算法涉及对应于(2)的三个步骤:
(i) 通过输入矩阵 扩展输入 (8a),
(ii) 展开独立的标量SSM递推(8b),以及
(iii) 通过输出矩阵 收缩隐藏状态 (8c)。
注意,我们在步骤(8b)中使用了标量SSM与1-SS矩阵之间的等价性。
注3. 我们注意到(8)是Mamba(S6)模型的一个特例,然而,朴素实现很慢,因为扩展的张量 和 的大小为 ;Gu和Dao (2023)引入了一种硬件感知的实现来避免物化这些张量。
令人惊讶的是,定理3.5和命题3.6立即意味着所有SSM都具有与算法(8)相同的渐近效率。
定理3.7. 任何状态大小为N、序列长度为T的状态空间模型(定义2.2)可以在时间 内计算(不考虑潜在的预处理)。
我们注意到这一结果在结构化 SSM 文献中是新的。特别地,给定稠密非结构化 矩阵,仅总表示本身似乎就具有 的大小。因此,定理 3.7 陈述了一个非平凡的结果:通过一个预处理步骤,即使是非结构化 SSM 也可以被最优高效地计算,其上界与由 和 的大小给出的下界 相匹配。
注 4. 鉴于 上几乎所有稠密矩阵在 上都是可对角化的,定理 3.7 也许并不太令人惊讶,这引出了几乎所有稠密实 SSM 都等价于对角复 SSM 的结果。这一事实正是对角 SSM 成为结构化 SSM 最流行形式的原因(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; J. T. Smith, Warrington, and Linderman 2023)。然而,定理 3.7 对所有实 SSM(不仅仅是可对角化的那些)以及其他域上的稠密 SSM(包括 本身)蕴含了更强得多的结果。
在实践中,可高效计算的 SSM 仍然需要对 施加额外结构,特别是为了避免昂贵的预处理步骤(该步骤既有 N 阶的额外 FLOPs,又涉及诸如奇异值分解之类硬件效率低下的操作)。这些结构是过去关于结构化 SSM 的工作(例如 S4(D) 和 Mamba)以及我们的新算法的重点。特别地,当对 施加稍强的结构时,我们将通过在 Section 6 中对 SSM 矩阵 进行块分解,设计出非常硬件高效的算法。
3.4.2 二次(朴素)模式
我们注意到,还有一种由我们新的矩阵视角所揭示的计算 SSM 的方法。对矩阵 SSM 表示 (3) 的朴素计算涉及简单地具体化序列变换矩阵 。这是一个 矩阵,因此这种朴素算法在序列长度上将以二次方规模增长。然而,当序列长度 较短时,由于常数因子和计算模式的硬件友好性(例如利用矩阵-矩阵乘法),这实际上可能比线性算法更高效。事实上,对于结构化 SSM 的一个特定情形,这看起来与二次注意力计算非常相似(Section 5)。
3.4.3 总结
许多序列模型被明确地动机为或定义为矩阵序列变换——最显著的是 Transformer,其中矩阵混合器就是注意力矩阵。另一方面,RNN 和 SSM 此前并未以这种方式被描述。通过提供状态空间模型的显式矩阵变换形式,我们揭示了理解和利用它们的新方式。从计算的角度来看,任何计算状态空间模型前向传播的方法都可以被视为半可分矩阵上的矩阵乘法算法。半可分矩阵视角为状态空间对偶(SSD)提供了一个透镜,其中对偶模式分别指线性时间半可分矩阵乘法算法和二次时间朴素矩阵乘法。
此外,利用半可分矩阵的丰富结构可以带来更好的算法和更多洞见(例如 Section 6 和 Appendix B)。在 Appendix C.1 中,我们描述了半可分矩阵的一些额外性质。
4 结构化掩码注意力:用结构化矩阵推广线性注意力
在本节中,我们从第一性原理重新审视线性注意力框架。本节的主要结果是基于张量收缩的线性注意力简单证明(Proposition 4.1),以及我们在 Definition 4.2 中对结构化掩码注意力的广义抽象。我们注意到,本节从与状态空间模型不同的方向推导主要对偶结果,并且可以完全独立于 Section 3 阅读。
- 第4.1节建立了我们关于注意力变体的框架,特别关注核注意力与掩码核注意力。- 第4.2节给出了我们的第一个主要注意力结果,即通过张量缩并视角对线性注意力的一个简单证明。- 第4.3节定义了结构化掩码注意力,这是我们通过结构化矩阵对先前注意力变体的推广。
4.1 注意力框架
4.1.1 注意力
(单头)注意力的基本形式是作用在三个向量序列上的映射
我们使用“形状标注”来表示张量的维度,例如 。在这种一般形式中,S和T表示源序列长度和目标序列长度,N表示特征维度,P表示头维度。
softmax注意力最常见的变体使用softmax激活函数 来对 矩阵的行进行归一化。
4.1.2 自注意力
我们的处理受到最重要的自注意力情形的启发,其中(i)源序列和目标序列相同(即 ),(ii)通常特征维度和头维度相同(即 ),(iii)且 由对同一输入向量的线性投影生成()。
然而,我们的表述抽象掉了这些选择,并从 矩阵开始。
注5. 我们的重点是头维度与特征维度相等的自注意力情形(即 且 ),应将其作为贯穿全文的示例。我们定义注意力的一般形式,不仅是为了让我们的框架能够涵盖交叉注意力等变体,还因为将维度的记号(例如S和T)分开,能使本节中我们主要结果的缩并记号证明更加清晰。
注6. 虽然注意力通常被表述为对这三个输入 的对称操作,但(9)中的输入和输出维度表明了并非如此。特别地,特征维度N并未出现在输出中;因此当 时(例如自注意力),我们将 视为主输入,从而(9)定义了一个恰当的序列变换 (定义2.1)。
4.1.3 核注意力
将softmax函数应用于Gram矩阵 的这一步可以分解为两部分:
1. 对 矩阵取指数。
2. 在S轴上对 矩阵进行归一化。
我们可以暂时忽略归一化项,因为它相当于简单地传入 再做除法(我们将在第7.3节重新讨论这一点)。指数项可以视为一种核变换:存在一个(无穷维的)特征映射 ,使得 。通过将特征映射抽象进 和 本身的定义中(即将 定义为变换后的版本),我们可以忽略softmax变换,并假设 由核特征映射任意生成,且可能有 。
人们已经提出了许多核注意力的实例,包括:
- 原始的线性注意力(Katharopoulos et al. 2020)将核特征映射定义为任意的逐点激活函数,例如 。- 随机特征注意力(RFA)(H. Peng et al. 2021)选择核特征映射,使用高斯核的随机傅里叶特征近似(Rahimi and Recht 2007)来近似softmax注意力(即exp特征映射)。这涉及随机投影(即将 和 乘以随机投影 并应用激活 )。
- Performer(Choromanski et al. 2021)提出了通过正正交随机特征实现的快速注意力(FAVOR+)。其正随机特征(PRF)部分将核特征映射选择为随机投影后接特征映射 。这一选择的动机是使核元素取正值,并可证明地近似softmax注意力。[它还提出在正交方向上选择随机投影,我们不予考虑。]
- cosFormer(Qin, Weixuan Sun, et al. 2022)为RFA增加了余弦重加权机制,该机制融入位置信息以强调局部性。这实际上是将 通过特征映射 。
- 线性随机注意力(Zheng, C. Wang, and Kong 2022)从重要性采样的角度推广了RFA,并将其推广以提供对完整softmax核(而不仅仅是exp变换后的分子)更好的估计。
其他相关的注意力变体包括Linformer(Sinong Wang et al. 2020)和Nyströmmer(Xiong et al. 2021),它们分别通过随机投影(Johnson-Lindenstrauss)和核近似(Nyström方法)使用注意力矩阵 的低秩近似(因而与等式(9)兼容)。
4.1.4 掩码(核)注意力
设 为形状为(T, S)的掩码。最常见地,在 的自回归自注意力情形中, 可以是表示因果掩码的下三角1矩阵。除了施加因果性之外,还可以应用许多其他类型的掩码——特别是各种稀疏模式,如带状、膨胀或块对角——其动机是降低稠密注意力的复杂度。
掩码注意力通常用矩阵记号写为
更准确地说,用形状标注并将其分解为精确的计算序列:
我们在本节中对注意力变体的改进推导,首先注意到该公式可以写成单个收缩:
而 (11) 中的算法可以重新表述为通过一种特定的成对收缩顺序来计算 (12):
4.2 线性注意力
线性注意力以及许多其他高效注意力变体,通常是通过改变核心注意力计算 中矩阵结合律的顺序来激发的。然而,当加入掩码后,推导就不那么直接了(例如,原始论文 (Katharopoulos et al. 2020) 及其变体 (Y. Sun et al. 2023) 给出了公式但没有证明)。
大致来说,线性注意力方法声称以下公式与 (10) 等价,这必须通过展开求和并仔细追踪索引来验证。
命题 4.1 ((Katharopoulos et al. 2020))。自回归核注意力,即带有因果掩码的掩码核注意力,可以通过每步耗时恒定的递推在 时间内计算。
4.2.1 线性注意力的张量收缩证明
我们给出一个简单而严谨的线性注意力推导,它也将立即揭示如何对其进行推广。主要思想是以另一种顺序执行收缩 (12)。我们避免使用有歧义的矩阵记号,直接使用收缩记号:
直观上,我们如下解释这一收缩顺序。
第一步 (15a) 通过特征维度 N 的倍数“扩展”到更多特征。第三步 (15c) 将扩展后的特征维度收缩掉。如果将 视为输入(注 6),那么 和 分别执行扩展和收缩。
第二步最为关键,它解释了线性注意力的线性部分。首先注意到 (15b) 只是与 的直接矩阵乘法(因为 轴可以被展平)。还要注意,这是唯一同时涉及 T 轴和 S 轴的项,因此应具有 复杂度(即序列长度的二次方)。然而,当掩码 是标准因果注意力掩码(下三角 1 矩阵)时,与 的矩阵-向量乘法等同于逐特征的累积和
4.3 结构化掩码注意力
借助掩码注意力的张量收缩视角(15),我们可以立即看出,原始线性注意力的关键在于:由因果掩码进行的矩阵-向量乘法等价于累积求和算子。
然而,我们观察到,注意力掩码没有理由必须全为1。线性注意力要变得快速,唯一必要条件是 是一个结构化矩阵,而按定义,结构化矩阵就是那些具有快速矩阵乘法的矩阵(第2.3节)。特别地,我们可以使用任何具有次二次(理想情况下为线性)矩阵-向量乘法的掩码矩阵 ,这样其复杂度将与标准线性注意力相同,因为会加速瓶颈方程(15b)。
定义4.2. 结构化掩码注意力(SMA)(或简称结构化注意力)定义为作用于查询/键/值 以及任意结构化矩阵 (即具有次二次矩阵乘法)的函数,通过四路张量收缩
SMA二次模式算法是由(13)定义的成对收缩序列,它对应于标准(掩码)注意力计算。
SMA线性模式算法是由(15)定义的成对收缩序列,其中步骤(15b)通过次二次结构化矩阵乘法进行优化。
我们可以将结构化掩码注意力实例化到任何给定的矩阵结构类别。一些例子包括(图3):
- 线性注意力使用因果掩码。
- RetNet(Y. Sun et al. 2023)使用衰减掩码 ,其中衰减因子为 。
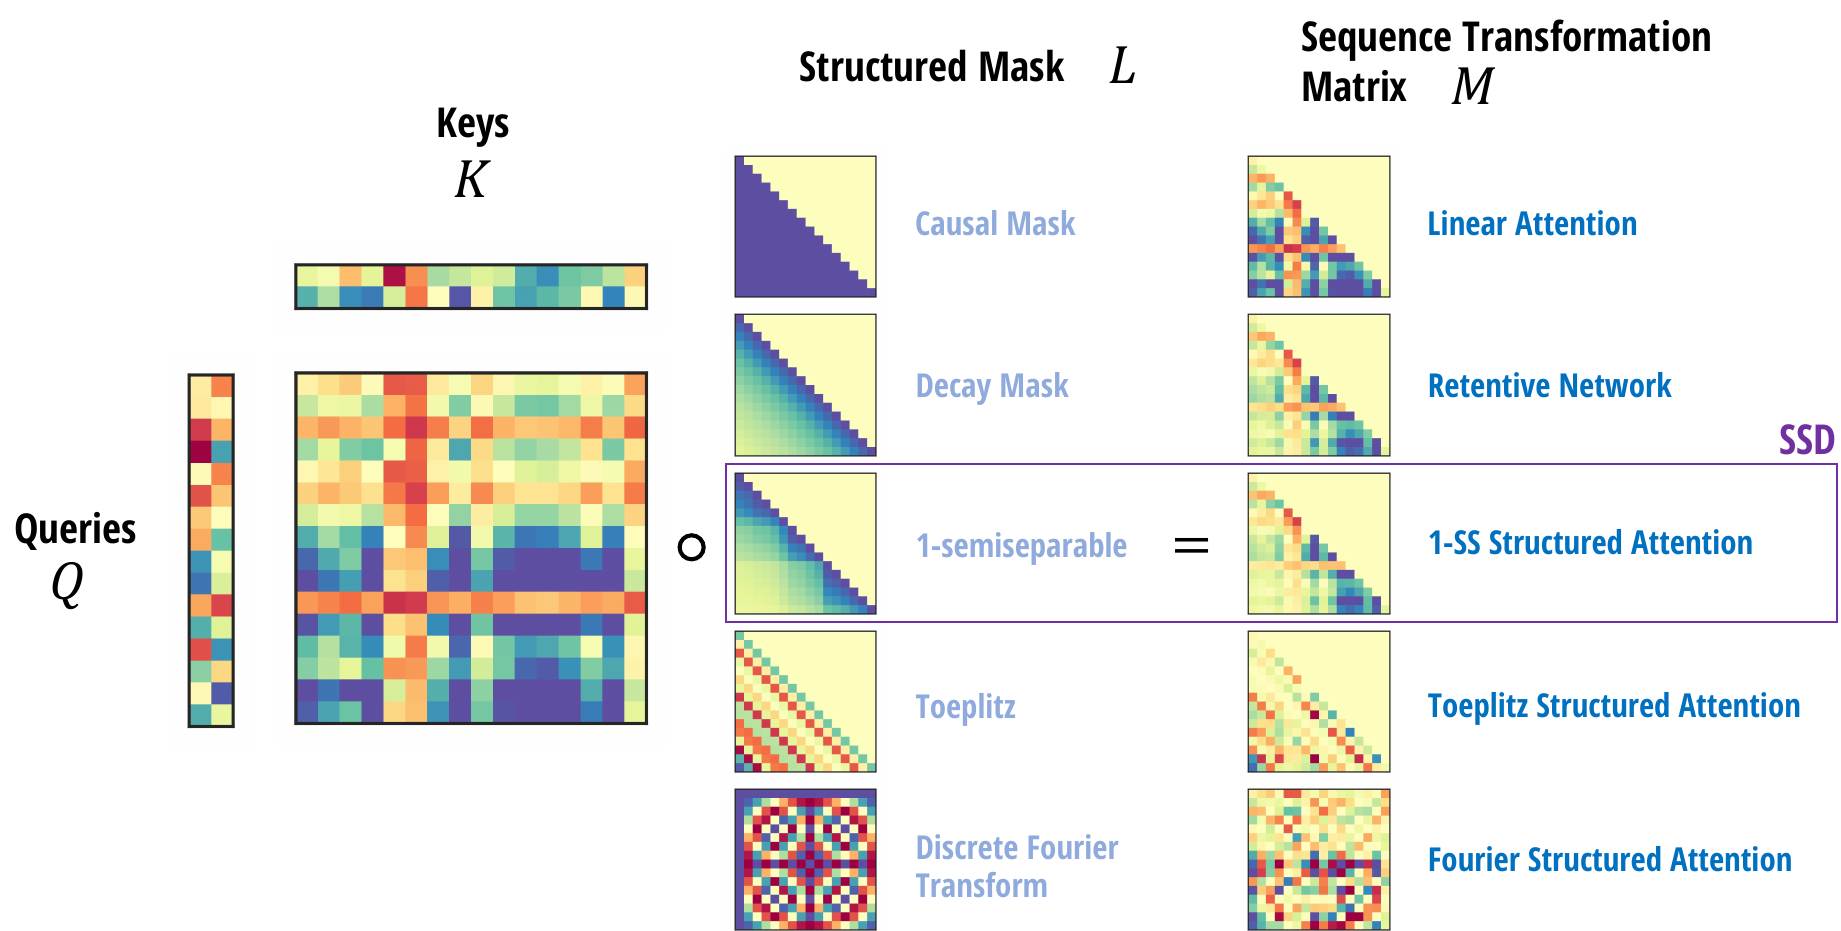
- 衰减掩码可以推广为Toeplitz矩阵 ,其中 是一组可学习(或依赖于输入)的参数。这可以解释为一种相对位置编码形式,让人联想到AliBi(Press, N. Smith, and Lewis 2022)等其他方法,但这里是乘法而非加法。- 另一种变体可以使用傅里叶矩阵 以不同方式编码位置结构。
在第5节中,我们考虑半可分SMA,它定义了我们的主要SSD模型。
4.3.1 总结:掩码注意力的对偶形式
标准(掩码核)注意力常常在函数和算法之间被混为一谈。将这一区分分开,为理解注意力的不同变体提供了一种清晰的方式。
- 我们将掩码注意力视为一个特定的函数(12)。- 标准二次注意力计算(13)可以视为计算该函数的一种算法。- 线性注意力(15)是计算同一函数的另一种算法。
此外,在这种情况下
- 掩码注意力函数 simply 是四项上的一个特定收缩。- 二次和线性注意力算法 simply 是执行收缩的两种不同顺序。
众所周知,收缩顺序可以在计算复杂度上造成巨大差异,从而导致二次与线性的区分。正如状态空间模型是一种可以用多种方式计算、具有对偶的二次与线性形式(第3.4节)的变换一样,线性注意力也具有由两种收缩顺序产生的类似对偶性。事实上,这些结果 turns out 是同一底层对偶性的不同视角,我们在第5节中将其明确。
5 状态空间对偶性
在第3节和第4节中,我们定义了结构化状态空间模型和结构化注意力,讨论了它们的性质,并表明它们都具有二次算法和线性算法。本节将它们连接起来。我们的主要结果是表明结构化状态空间模型的一个特定情形与结构化注意力的一个特定情形重合,并且线性时间SSM算法和二次时间核注意力算法是彼此的对偶形式。
第5.1节将状态空间模型特化到标量结构,其中朴素的二次计算可以看作核注意力的一个实例。
第5.2节将结构化掩码注意力特化到半可分SMA,它刻画了具有高效自回归的掩码注意力。
第5.3节总结了结构化掩码注意力与结构化状态空间模型之间的联系,称为结构化状态空间对偶性。
5.1 标量恒等结构化状态空间模型
在第3节中,我们表明状态空间模型等价于半可分矩阵变换,从而产生线性递归形式和二次朴素形式。
回想一下,SSM由 定义,而SSM的矩阵形式使用SSS(顺序半可分)表示 ,其中 (方程(3))。
现在让我们考虑 simply 是标量的情形;换句话说,是结构化SSM的一个实例,其中 矩阵具有极强的结构:,其中 为标量, 为单位矩阵。那么我们可以重新排列
这可以向量化为
其中
使用这一表述,完整输出 precisely 计算为
其中 。但这与掩码核注意力定义的原始定义(13) exactly 相同!
因此,正如第3.4节所暗示的,朴素地计算标量结构化SSM——通过具体化半可分矩阵 并执行二次矩阵-向量乘法——与二次掩码核注意力 exactly 相同。
5.2 1-半可分结构化掩码注意力
结构化掩码注意力允许使用任何结构化掩码 。当 是因果掩码时,它就是标准线性注意力。注意,因果掩码是 ,即1-SS掩码由定义(6)中的 生成。这促使我们将 推广到1-半可分掩码类,即1-半可分结构化掩码注意力(1-SS SMA),其中线性注意力递归中的累积和被更一般的递归所取代——标量SSM扫描,即1-半可分矩阵乘法(第3.2.2节)。
最后,我们考虑 1-半可分 SMA 的最重要原因在于,其线性形式的计算是对角状态空间模型的一个特例。SMA 的线性形式是算法 (15),其中瓶颈步骤 (15b) 可以看作是与 1-SS 掩码的矩阵乘法。在第 3 节中,我们还写出了对角 SSM (8) 的计算,其中瓶颈步骤 (8b) 是一个标量 SSM 递推,等价于 1-SS 乘法。唯一的区别在于,(8b) 在 中多了一个 N 维度,因为矩阵 是大小为 N 的对角矩阵。如果 的所有对角元素都相同,这个 N 维度就会消失,从而得到推论 5.1。
推论 5.1。1-SS SMA(使用 1-半可分结构化矩阵 的掩码注意力)(15) 是对角 SSM (8) 的一个特例,其中对角矩阵是单位矩阵的标量倍数。
虽然推论 5.1 表明 1-SS SMA 具有高效的递推形式,我们还可以证明一个反向结果,刻画哪些 SMA 实例具有高效自回归。
定理 5.2。对于结构化掩码注意力(定义 4.2)的任何实例化,若其是一个有界阶数的自回归过程,则结构化掩码 必须是半可分矩阵。
换言之,高效自回归注意力就是一般半可分 SMA。定理 5.2 在附录 C.2 中证明。
注 7。虽然 1-半可分 SMA 是状态空间模型的一个特例,但一般半可分 SMA 严格比 1-SS SMA 更具表达力,且无法由标准 SSM 描述。然而,与 的半可分乘法和 SMA 的线性形式(方程 (15a))各自都涉及一个扩展和收缩步骤,并且可以吸收到具有单个(更大)扩展的类似 1-SS SMA 实例中。
总之,1-半可分结构化注意力是 SMA 最重要的情形,因为它是:
- 具有输入依赖递推的线性注意力的一种自然推广。
- 一般半可分注意力中最简单的情形,而后者等价于高效自回归注意力。
- 对角状态空间模型的一个特例。
5.3 结构化状态空间对偶性 (SSD)
总结我们的结果:
- 结构化状态空间模型(第 3 节)是一种通常通过线性时间递推定义的模型。然而,通过展开刻画其线性序列到序列变换的矩阵表述,可以推导出二次形式。
- 注意力变体(第 4 节)是一种通过二次时间成对交互定义的模型。然而,通过将其视为四路张量收缩并以不同顺序进行归约,可以推导出线性形式。
- 两者各自的一个自然特例——更准确地说, 矩阵上具有标量单位结构的状态空间模型,以及其 掩码上具有 1-半可分结构的结构化掩码注意力——彼此互为对偶,且具有完全相同的线性和二次形式。
图 4 总结了这两种表示之间的对偶性。
扩展的相关工作与讨论(第10节)更详细地描述了SSD与一般SSM/注意力之间的关系。
6 一种面向SSD模型的硬件高效算法
发展SSD理论框架在SSM、注意力和结构化矩阵之间的关联,其益处在于利用这些联系来改进模型和算法。在本节中,我们展示如何从各种用于计算结构化矩阵乘法的算法中,推导出各种高效计算SSD模型的算法。
我们的主要计算成果是一种用于计算SSD模型的算法,它结合了线性(循环)模式和二次(注意力)模式。该算法在计算效率上与SSM相当(随序列长度线性缩放),在硬件友好性上与注意力相当(主要使用矩阵乘法)。
定理6.1. 考虑一个状态扩展因子为且头维度为的SSD模型。存在一种算法,可在任意输入上计算该模型,其仅需的训练FLOPs、的推理FLOPs、的推理内存,且其工作主要由矩阵乘法主导。
| 结构化状态空间模型 | 结构化掩码注意力 | ||||
| C | (收缩矩阵) | Q | (查询) | S4 | 对角状态空间模型 |
| B | (扩展矩阵) | K | (键) | ||
| X | (输入序列) | V | (值) | DSS | 标量恒等SSM |
| Aij | (状态矩阵) | Lji | (掩码) | S4D | RetNet GateLoop |
| N | (状态扩展维度) | N | (核特征维度) | S5 | TransNormer |
| H | (隐藏状态(8b)) | SMA线性对偶(15) | S6 | 线性注意力 | |
| = L·XB | (线性模式) | 1-半可分SMA | |||
| SSM二次对偶(16) | G | (Gram矩阵(13a)) | 高效自回归注意力 | ||
| = Q·K | (二次模式) | 半可分SMA |
注意,所有这些界限都是紧的,因为状态扩展为N、运行于头大小N上的状态空间模型总状态大小为(分别产生和的训练和推理FLOPs下界)。此外,输入本身具有TN个元素,从而产生内存下界。
定理6.1背后的主要思想再次是将计算状态空间模型的问题视为半可分矩阵乘法,但以新的方式利用其结构。我们不再以循环或注意力模式计算整个矩阵,而是对矩阵进行块分解。对角块可以使用对偶注意力模式计算,这可以通过矩阵乘法高效完成;而非对角块可以利用半可分矩阵的秩结构进行分解,并归约为更小的递推。我们强调,清单1提供了SSD算法的自包含实现。与Gu和Dao(2023)的一般选择性SSM相比,该实现要简单得多,并且即使在原生PyTorch中无需特殊的底层内核也相对高效。
首先,我们将矩阵划分为的子矩阵网格,每个子矩阵大小为,其中为某个块大小。注意,根据半可分矩阵的定义性质,非对角块是低秩的。5
通过一个例子最容易说明这一点,例如对于并分解为长度为的块。阴影单元格是半可分矩阵非对角块的低秩分解。
这些子问题可以解释为:假设(该块的)初始状态为0,每个块的输出是什么。换句话说,对于块,这仅考虑块输入来计算正确的输出。
6.2 低秩块
低秩分解由3项组成,相应地有三部分计算。在此分解中,我们将使用以下术语
诸如的项称为右因子或-块因子。
诸如的项称为中心因子或-块因子。
诸如的项称为左因子或-块因子。
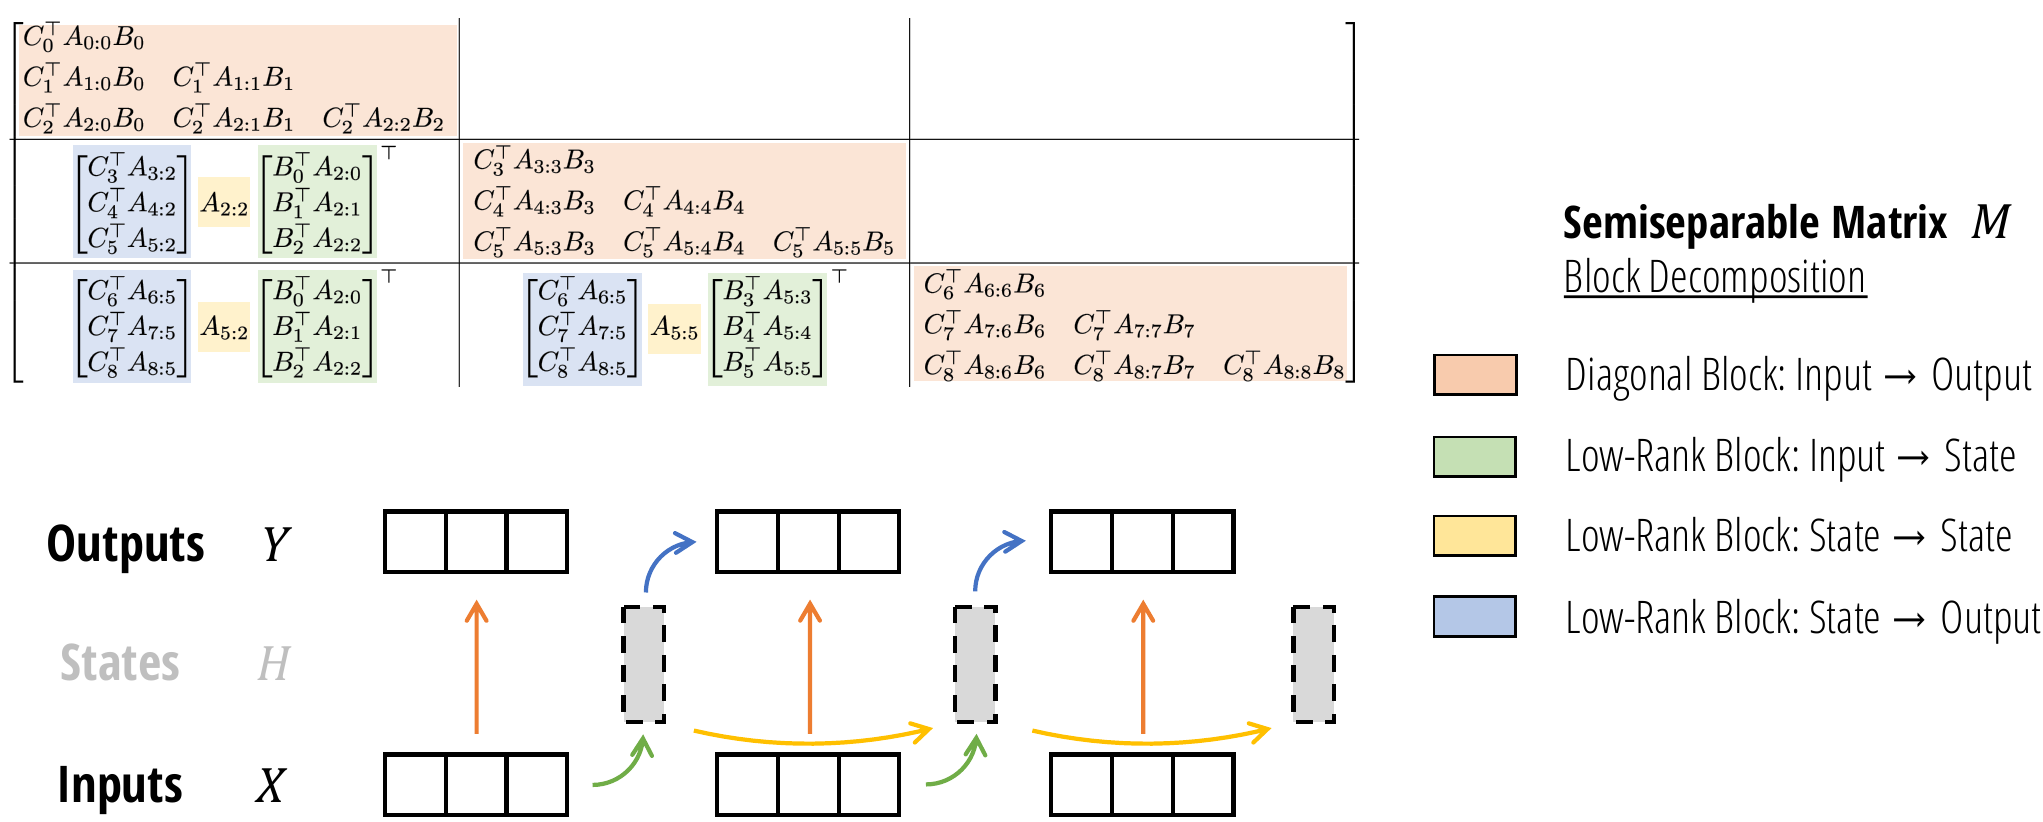
右因子。此步骤计算与低秩分解的右-块因子的乘法。注意,对于每个块,这是一个乘的矩阵乘法,其中是状态维度,是头维度。结果为每个块生成一个张量,其维度与扩展隐藏状态相同。
这可以解释为:假设(该块的)初始状态为0,每个块的最终状态是什么。换句话说,这假设来计算。
中心因子。此步骤计算低秩分解中中心-块因子项的影响。在上一步中,每个块的最终状态总形状为。现在将其乘以由生成的1-SS矩阵。
此步骤可以通过任何用于计算1-SS乘法的算法(也称为标量SSM扫描或cumprodsum算子)来计算。
这可以解释为:考虑所有先前输入后,每个块的实际最终状态是什么;换句话说,这考虑所有来计算真实隐藏状态。
左因子。此步骤计算与低秩分解的左-块因子的乘法。对于每个块,这可以由矩阵乘法收缩表示。
这可以解释为:考虑正确的初始状态并假设输入为0,每个块的输出是什么。换句话说,对于块,这仅考虑先前输入来计算正确的输出。
6.3 计算成本
我们定义记号 ,用以表示一个批矩阵乘法契约 ,其批维度为 。由该记号,我们可以推断出效率的三个方面的信息:- 计算成本:总计 FLOPs。
- 内存成本:总计 空间。
- 并行化:较大的 M、N、K 项可以利用现代加速器上的专用矩阵乘法单元。
清单 1 状态空间对偶(SSD)模型的完整 PyTorch 示例。
def segsum(x):
朴素段和计算。exp(segsum(A)) 产生一个 1-SS 矩阵,
其等价于一个标量 SSM。
T = x.size(- 1)
x_cumsum = torch.cumsum(x, dim=- 1)
x_segsum = x_cumsum[..., None] - x_cumsum[..., None, :]
mask = torch.tri1(torch.ones(T, T, device=x.device, dtype=bool), diagonal=0)
x_segsum = x_segsum.masked_fill(- mask, - torch.inf)
return x_segsum
def ssd(X, A, B, C, block_len=64, initial_states=None):
参数:
X: (batch, length, n_heads, d_head)
A: (batch, length, n_heads)
B: (batch, length, n_heads, d_state)
C: (batch, length, n_heads, d_state)
返回:
Y: (batch, length, n_heads, d_head)
\*
4. 计算每个块的状态 -> 输出转换 # (非对角块低秩分解的左项;C 项) state_decay_out = torch.exp(A_cumsum) Y_off = torch.einsum('bclhn, bchpn, bhl->bclhp', C, states, state_decay_out)
加上块内项和块间项的输出(对角块与非对角块) Y = rearrange(Y_diag+Y_off, "b c l h p -> b (c l) h p") return Y, final_state
中心块。二次 SMA 计算的成本由三个步骤组成(式 (16)):
- 计算核矩阵 ,其成本为 。
- 乘以掩码矩阵,这是对形状为 的张量进行的逐元素操作。
- 乘以 值,其成本为
低秩块:右因子。该步骤是单次矩阵乘法,成本为 。
低秩块:中心因子。该步骤是在 个独立通道上、长度为 的标量 SSM 扫描(或 1-SS 乘法)。该扫描的工作量为 ,与其他因子相比可以忽略不计。
注意,由于分块将序列长度从 缩减到 ,该扫描的成本比纯 SSM 扫描(例如 Mamba 的选择性扫描)小 倍。因此我们观察到,在大多数问题长度上,其他算法(附录 B)可能更高效,或者在没有显著减速的情况下更容易实现。例如,通过 1-SS 矩阵乘法对此进行朴素实现,成本为 ,这比朴素的递推/扫描实现更容易实现,并且可能更高效。
低秩块:左因子。这一步是单次矩阵乘法,成本为 。
总成本。如果我们设置 (换言之,状态维度、头维度和块长度相等),那么上述所有 BMM 项都变为 。其计算特征如下:
- 总 FLOP 计数为 。- 总内存为 。- 工作主要包括在形状为 的矩阵上进行矩阵乘法。
注意内存消耗是紧的;输入和输出 的形状为 。同时,FLOP 计数反映了一个额外的因子 ,这是由自回归状态大小产生的成本,并且是所有模型共有的。
除了矩阵乘法之外,还有一个对 个特征和序列长度 进行的标量 SSM 扫描。其成本为 FLOPs,深度为 。尽管它不使用矩阵乘法,但仍然可以并行化,并且所完成的总工作量与其他步骤相比可以忽略不计;在我们的 GPU 实现中,这具有可忽略的成本。
与纯 SSM 和注意力模型的比较。二次注意力也仅利用矩阵乘法,因此在硬件上非常高效,但其总 FLOPs 为 。其在训练和推理时较慢的计算速度可以直接看作状态规模更大的结果——标准注意力具有随序列长度 缩放的状态规模,因为它缓存其历史并且不压缩其状态。
线性 SSM 的总 FLOPs 为 ,与 SSD 相同。然而,朴素实现需要状态扩展 (15a) 来物化额外内存,以及标量操作 (15b) 不利用矩阵乘法。
| 注意力 | SSM | SSD | |
| 状态大小 | T | N | N |
| 训练FLOPs | T²N | TN² | TN² |
| 推理FLOPs | TN | N² | N² |
| (朴素)内存 | T² | TN² | TN |
| 矩阵乘法 | ✓ | ✓ |
我们注意到许多其他矩阵分解也是可能的(例如,参见附录 B 中通过不同结构化矩阵分解进行 1-SS 乘法的算法汇编),这可能产生更多 SSD 算法,这些算法可能更适合其他专门设置。更广泛地说,我们注意到半可分矩阵有丰富的文献,并且除了我们使用的 SS 形式(定义 3.2)之外还有更多表示,甚至可能实现更高效的算法。
7 Mamba-2 架构
通过连接 SSM 和注意力,SSD 框架允许我们为两者开发共享的词汇和技术库。在本节中,我们讨论一些使用最初
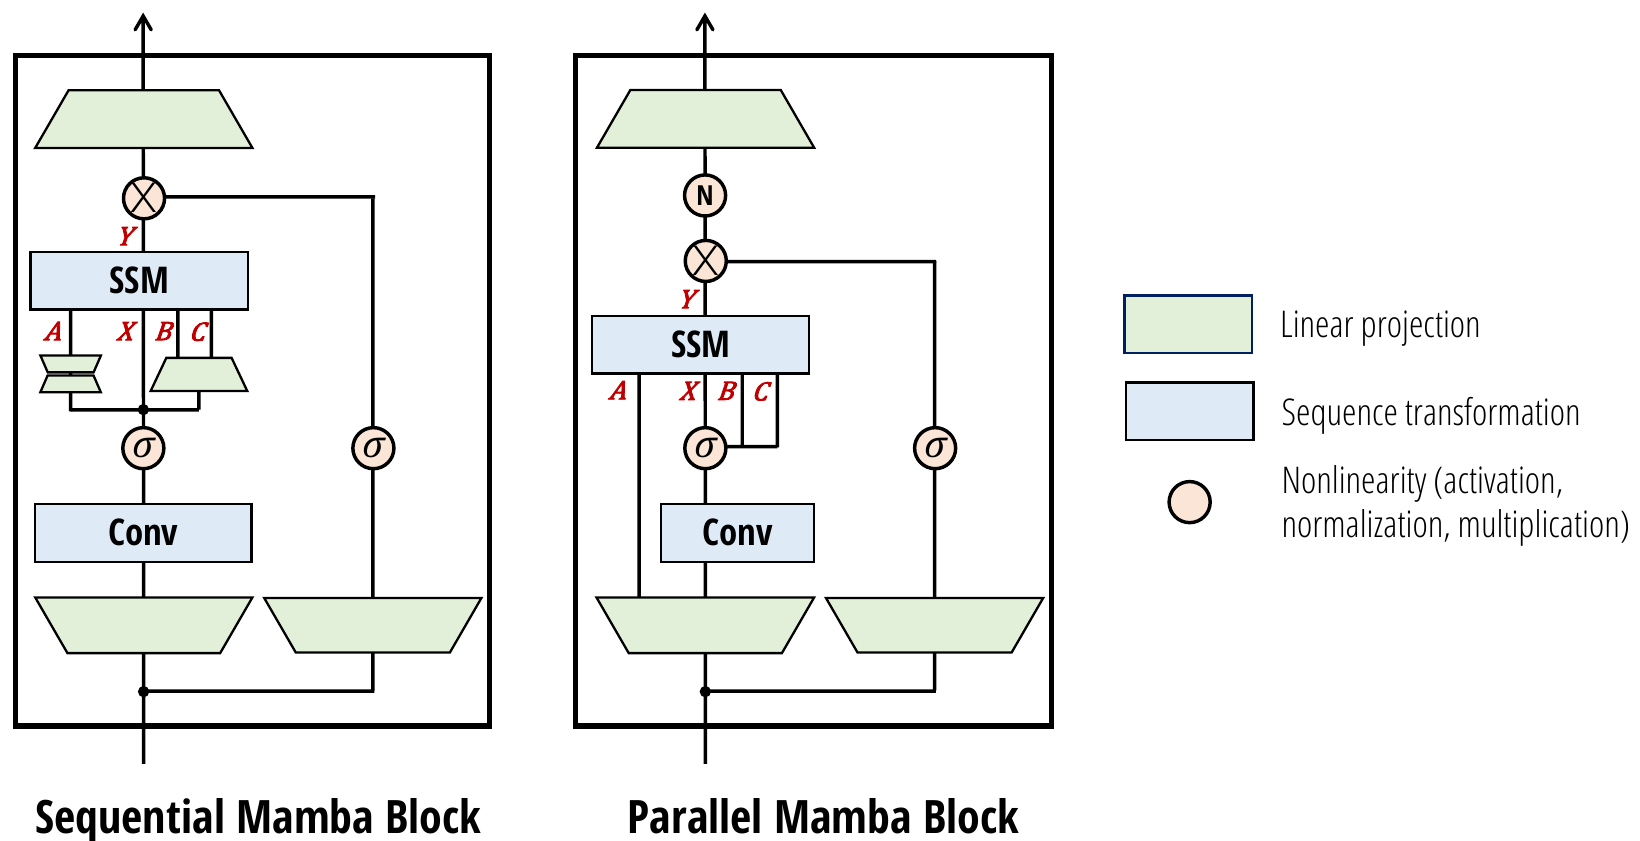
为 Transformer 开发的思想来理解和修改 SSD 层的示例。我们讨论若干设计选择,最终形成 Mamba-2 架构。这些变化轴在第 9.4 节中进行了消融。
7.1 块设计
我们首先讨论对神经网络块的修改,这些修改独立于内部序列混合层(即核心 SSD 层之外)。
并行参数投影。Mamba-1 的动机是以 SSM 为中心的视角,其中选择性 SSM 层被视为从 的映射。SSM 参数 被视为附属的,并且是 SSM 输入 的函数。因此,定义 的线性投影发生在用于创建 的初始线性投影之后。
在 Mamba-2 中,SSD 层被视为从 的映射。因此,在块的开头通过单个投影并行产生 是合理的。请注意与标准注意力架构的类比,其中 对应于并行创建的 投影。
请注意,对 SSM 的 输入采用并行投影会略微减少参数,更重要的是,通过使用标准的 Megatron 分片模式(Shoeybi et al. 2019),它更适用于更大模型的张量并行。
额外归一化。在初步实验中,我们发现较大模型中容易产生不稳定性。我们能够通过在块中最终输出投影之前添加额外的归一化层(例如 LayerNorm、GroupNorm 或 RMSNorm)来缓解这一点。这种归一化的使用与 NormFormer 架构(Shleifer, Weston, and Ott 2021)最直接相关,该架构也在 MLP 和 MHA 块的末尾添加了归一化层。
我们还注意到,这一变化与最近其他与 Mamba-2 相关的、从线性注意力视角衍生的模型类似。原始线性注意力公式通过一个分母项进行归一化,该项模拟标准注意力中 softmax 函数的归一化。TransNormerLLM(Qin, Dong Li, et al. 2023)和 RetNet(Y. Sun et al. 2023)发现这种归一化不稳定,并在线性注意力层之后添加额外的 LayerNorm 或 GroupNorm。我们的额外归一化层与这些略有不同,它发生在乘法门分支之后而不是之前。
. . .
7.2 序列变换的多头模式
回想一下,SSM 被定义为序列变换(定义 2.1),其中:
- 参数具有状态维度 N。- 它们定义序列变换 ,例如可以表示为矩阵 。- 该变换在输入序列 上操作,独立地沿 P 轴进行。
可以将其视为定义序列变换的一个头。
定义 7.1(多头模式)。多头序列变换由 H 个独立的头组成,总模型维度为 。参数可以在头之间共享,从而形成头模式。
状态大小 N 和头维度 P 分别类似于注意力的 QK 头维度和 V 头维度。正如现代 Transformer 架构(Chowdhery et al. 2023; Touvron, Lavril, et al. 2023)中那样,在 Mamba-2 中我们通常选择这些为 64 或 128 左右的常数;当模型维度 D 增加时,我们增加头的数量,同时保持头维度 N 和 P 固定。为了描述如何做到这一点,我们可以迁移并推广多头注意力中的思想,为 SSM 或任何一般序列变换定义类似的模式。
| 多头 SSM (多头注意力) | 多收缩 SSM (多查询注意力) | 多扩展 SSM (多键注意力) | 多输入 SSM (多值注意力) |
| X (T, H, P) | X (T, 1, P) | X (T, 1, P) | X (T, H, P) |
| A (T, H) | A (T, H) | A (T, H) | A (T, H) |
| B (T, H, N) | B (T, 1, N) | B (T, H, N) | B (T, 1, N) |
| C (T, H, N) | C (T, H, N) | C (T, 1, N) | C (T, 1, N) |
多头 SSM(MHS)/ 多头注意力(MHA)模式。经典的 MHA 模式假设头维度 P 整除模型维度 D。头的数量定义为 。然后,通过为每个参数创建 H 个独立副本,创建核心序列变换的 H 个副本。请注意,虽然 MHA 模式最初是为注意力序列变换描述的,但它可以应用于任何与定义 2.1 兼容的内容。例如,多头 SSD 层将接受形状符合方程 (17) 的输入,其中 SSD 算法在 维度上广播。
多合约SSM(MCS)/多查询注意力(MQA)模式。多查询注意力(Shazeer 2019)是一种巧妙的注意力优化方法,能够显著提升依赖缓存和张量的自回归推理速度。该技术简单地避免为和增加额外的头维度,换言之,将单个头广播到的所有头上。
利用状态空间对偶性,我们可以定义MQA的等价SSM版本,如公式(18)所示。此处,和(注意力中和的SSM对应物)在H个头之间共享。我们也将其称为多合约SSM(MCS)头模式,因为控制SSM状态收缩的参数在每个头上具有独立副本。
我们可以类似地定义多键注意力(MKA)或多扩展SSM(MES)头模式,其中(控制SSM扩展)在每个头上独立,而和在各头之间共享。
多输入SSM(MIS)/多值注意力(MVA)模式。虽然MQA因其KV缓存而对注意力有意义,但它并非SSM的自然选择。在Mamba中,被视为SSM的主要输入,因此和是在输入通道之间共享的参数。我们在公式(20)中定义了一种新的多值注意力(MVA)或多输入SSM(MIS)模式,该模式同样可应用于任何序列变换,如SSD。
借助这套术语,我们可以更精确地刻画原始Mamba架构。
命题7.2. Mamba架构(Gu and Dao 2023)的选择性SSM(S6)层可以被视为具有——头维度:每个通道具有独立的SSM动态。
- 多输入SSM(MIS)或多值注意力(MVA)头结构:矩阵(对应于注意力对偶中的)在输入的所有通道之间共享(对应于注意力中的)。
我们还可以在将SSD应用于此时消融这些头模式变体(第9.4.3节)。有趣的是,尽管在参数量和总状态维度上受到控制,下游性能仍存在明显差异。我们通过实验发现,Mamba最初使用的MVA模式表现最佳。
分组头模式。多查询注意力的思想可以扩展到分组查询注意力(Ainslie et al. 2023):不是使用1个K和V头,而是可以创建G个独立的K和V头,其中且G整除H。这既是为了弥合多查询注意力和多头注意力之间的性能差距,也是为了通过将G设置为分片数量的倍数来实现更高效的张量并行(第8节)。
类似地,Mamba-2中使用的多输入SSM头模式可以轻松扩展到分组输入SSM(GIS),或同义的分组值注意力(GVA)。该推广是直接的,为简洁起见我们省略细节。
7.3 来自线性注意力的其他 SSD 扩展
我们在此描述一个受线性注意力启发而对 SSD 进行架构修改的示例。我们在第 9.4.3 节中将这些修改作为负面结果进行消融,发现它们并未显著提升性能以至于足以被采纳为默认设置。尽管如此,这些示例说明了如何将大量关于注意力的文献纳入进来,以定义 SSD 的变体。我们将核特征映射的选择视为 Mamba-2 架构中的一个超参数,并预期其他受注意力启发的简单修改也是可能的。
对 Softmax 注意力的核注意力近似。许多线性注意力或核注意力的变体都受到以下视角的启发:将注意力分数 \(\mathrm{softmax}(Q K^{\top})\) 视为由以下部分组成
1. 一个指数核 ,它可以由 对某个核特征映射进行近似。2. 对核进行归一化,使得各行之和为 1,通过 ,其中除法逐元素进行,1 为全 1 向量。
指数核特征映射。在 Mamba-2 中,我们引入了一个灵活的可选核特征映射,并将其应用于 和 分支(对应于注意力中的 和 分支)。为简单和对称起见,该特征映射也可以可选地应用于 ()分支。这在图 6 中由任意非线性表示。默认情况下,我们简单地选择 为逐元素 Swish / SiLU 函数(Hendrycks and Gimpel 2016; Ramachandran, Zoph, and Le 2017)。我们在第 9.4.3 节的消融中探索了其他选项,包括 Linear Attention、Performer、Random Feature Attention 和 cosFormer 所使用的特征映射(第 4.1.3 节)。
引入归一化(分母)项。为了求得分母项,我们只需计算 。但回顾一下,模型的最终输出只是 (公式 (16))。因此,归一化项可以简单地通过用额外一列 1 增广 来求得,从而得到一个形状为 的张量。注意,在这种情况下,核特征映射 必须是正的,以便和为正。
8 SSM 的系统优化
我们描述了若干针对 SSM 的系统优化,特别是针对 Mamba-2 架构,以实现大规模高效训练和推理。具体而言,我们重点关注用于大规模训练的張量并行和序列并行,以及用于高效微调和推理的可变长度序列。
8.1 張量并行
張量并行(TP)(Shoeybi et al. 2019)是一种模型并行技术,它将每一层(例如注意力、MLP)拆分到多个加速器(如 GPU)上运行。该技术被广泛用于在 GPU 集群上训练大多数大型模型(Brown et al. 2020; Chowdhery et al. 2023; Touvron, Lavril, et al. 2023; Touvron, L. Martin, et al. 2023),其中每个节点通常配有 4-8 个具有快速网络连接(如 NVLink)的 GPU。TP 最初是为 Transformer 架构开发的,将其适配到其他架构并非易事。我们首先展示在 Mamba 架构中使用 TP 所面临的挑战,然后展示 Mamba-2 架构如何被设计以使 TP 高效。
回顾 Mamba 架构,其具有单个输入 (为简单起见不考虑批处理)、输入投影矩阵 ,其中 是扩展因子(通常为 2),以及输出投影矩阵 :
使用 TP 时,假设我们想沿 2 个 GPU 拆分计算。很容易将输入投影矩阵 和 拆分为两个分区,每个分区大小为 。然后每个 GPU 将持有大小为 的 的一半。然而,我们看到由于 是 的函数,因此在计算 之前,我们需要在 GPU 之间进行一次额外的 all-reduce 以获取完整的 。之后,两个 GPU 可以并行计算 SSM,因为它们在 维度上是独立的。最后,我们可以将输出投影矩阵 拆分为两个分区,每个分区大小为 ,并在最后进行一次 all-reduce。与 Transformer 相比,我们将产生两次 all-reduce 而非一次,使通信时间翻倍。对于大规模 Transformer 训练,通信可能已经占据了相当大比例的时间(例如 10-20%),而通信翻倍将使 Mamba 在大规模训练中效率降低。
对于 Mamba-2,我们的目标是每个块只有一次 all-reduce,类似于 Transformer 中的注意力或 MLP 块。因此,我们直接从 而非从 投影得到 ,从而允许我们拆分这些投影矩阵。这意味着我们在不同 GPU 上拥有不同的 集合,这等价于在一个更大的“逻辑 GPU”上拥有若干组 。此外,我们在每个块内使用 GroupNorm,其组数可被 TP 度整除,使得 TP 组内的 GPU 在块内无需通信:
我们看到,只需要拆分输入投影矩阵和输出投影矩阵,并且只需要在块的末尾执行 all-reduce。这与注意力层和 MLP 层的 TP 设计类似。具体来说,如果我们的 TP 度为 2,我们会将 拆分,其中 ,其中 ,以及
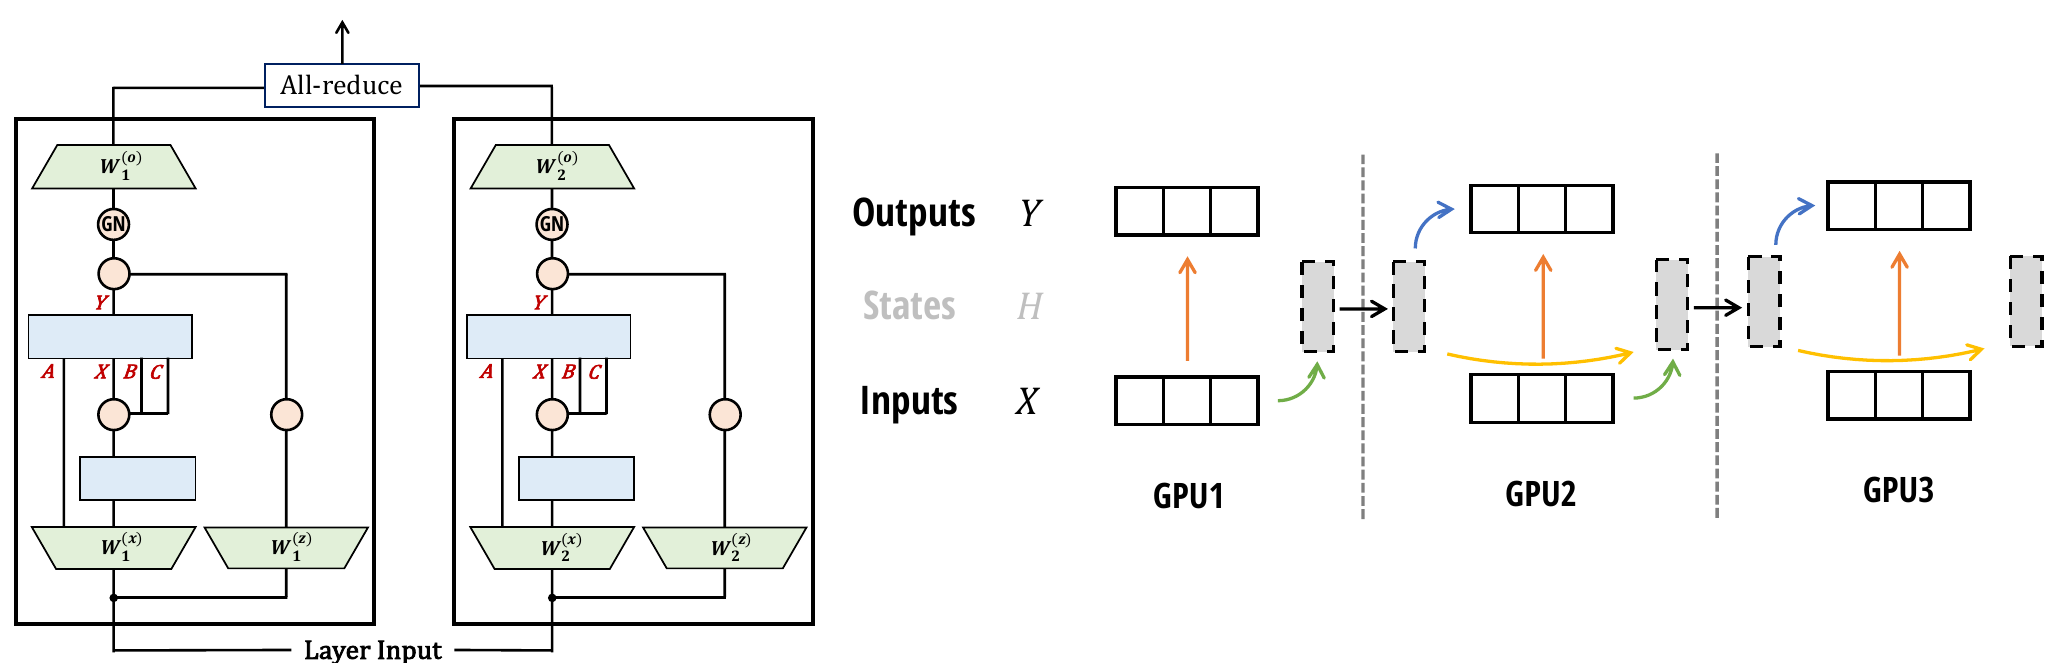
,其中 。对于 ,TP Mamba-2 层可以写为:
我们在图 7(左)中展示了 Mamba-2 的张量并行。
8.2 序列并行
对于非常长的序列,我们可能需要沿序列长度维度将输入和激活拆分到不同的 GPU 上。主要有两种技术:
1. 用于残差和归一化操作的序列并行(SP):该技术由 Korthikanti 等人(2023)首次提出,它将 TP 中的 all-reduce 分解为 reduce-scatter 和 all-gather。注意到残差和归一化操作在同一 TP 组中的所有 GPU 上对相同输入重复执行,SP 通过执行以下操作沿序列长度维度拆分激活:reduce-scatter、残差和归一化,然后 all-gather。
由于 Mamba-2 架构使用了相同的残差和归一化结构,SP 可以直接应用而无需修改。
2. 针对 token 混合操作(注意力或 SSM)的序列并行,也称为“上下文并行”(CP)。针对注意力层已经发展出多种技术(例如 Ring attention(Liu, Yan, et al. 2024; Liu, Zaharia,
and Abbeel 2023)),并配有复杂的负载均衡技术(Brandon et al. 2023)。注意力中序列并行的难点在于,我们可以将查询和键划分为块,但每个查询块都需要与键块进行交互,导致通信带宽随 worker 数量呈二次方增长。
对于 SSM,我们可以用简单的方式拆分序列:每个 worker 取一个初始状态,针对其输入计算 SSM,返回最终状态,并将该最终状态传递给下一个 worker。通信带宽随 worker 数量呈线性增长。这种分解与 SSD 算法中划分为块/分块的块分解(图 5)完全相同。我们在图 7(右)中展示了这种上下文并行。
8.3 变长
虽然预训练通常对批次使用相同的序列长度,但在微调或推理期间,模型可能需要处理不同长度的不同输入序列。处理这种情况的一种朴素方法是将批次中的所有序列右填充到最大长度,但如果序列长度差异很大,这可能效率低下。对于 transformer,已经发展出复杂的技术来避免填充并在 GPU 之间进行负载均衡(Zeng et al. 2022; Y. Zhai et al. 2023),或者将多个序列打包到同一批次中并调整注意力掩码(Ding et al. 2024; Pouransari et al. 2024)。对于 SSM,尤其是 Mamba,我们可以通过简单地将整个批次视为一个长序列来处理可变序列长度,并避免在各个序列之间传递状态。这等价于简单地在一个序列末尾的 token 处设置 ,以防止其将信息传递给属于不同序列的 token 。
9 实证验证
我们在对循环模型具有挑战性的合成回忆任务上对 Mamba-2 进行了实证评估(第 9.1 节),以及标准的语言建模预训练和下游评估(第 9.2 节)。我们验证了我们的 SSD 算法比 Mamba-1 高效得多(第 9.3 节),并且在中等序列长度上与优化的注意力相当。最后,我们消融了 Mamba-2 架构中的各种设计选择(第 9.4 节)。
9.1 合成任务:联想回忆
合成联想回忆任务在测试语言模型在其上下文中查找信息的能力方面很受欢迎。广义而言,它们涉及向自回归模型输入键-值关联对,然后提示模型在看到一个先前见过的键时产生正确的补全。多查询联想回忆(MQAR)任务是该任务的一种特定形式,要求模型记住多个关联(Arora, Eyuboglu, Timalsina, et al. 2024)。原始 Mamba 论文报告了在相关合成任务上的结果,特别是选择性复制(Gu and Dao 2023)和归纳头(Olsson et al. 2022),这些可以被视为较简单的联想回忆任务。MQAR 任务也与“电话簿查找”任务密切相关,后者已被证明对 SSM 等循环模型具有挑战性,因为它们的状态容量有限(De et al. 2024; Jelassi et al. 2024)。
| MODEL | TOKEN. | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | AVERAGE ACC ↑ |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
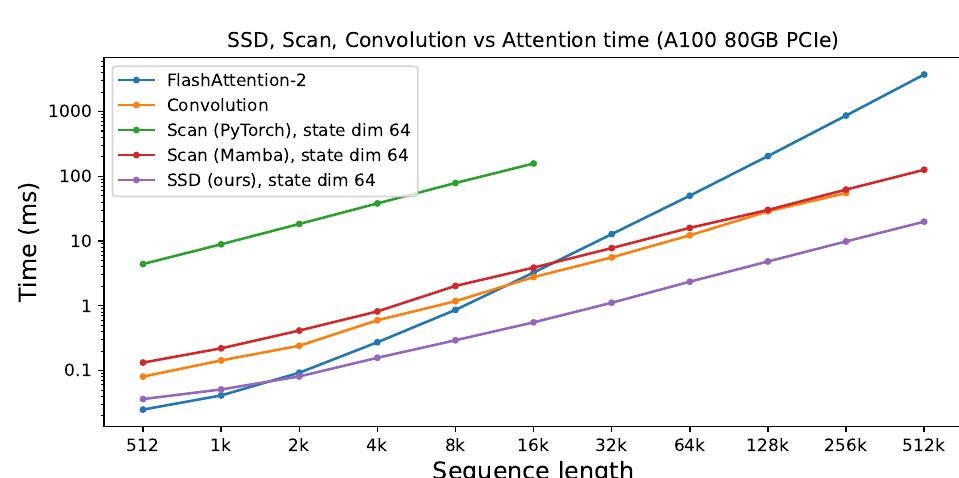
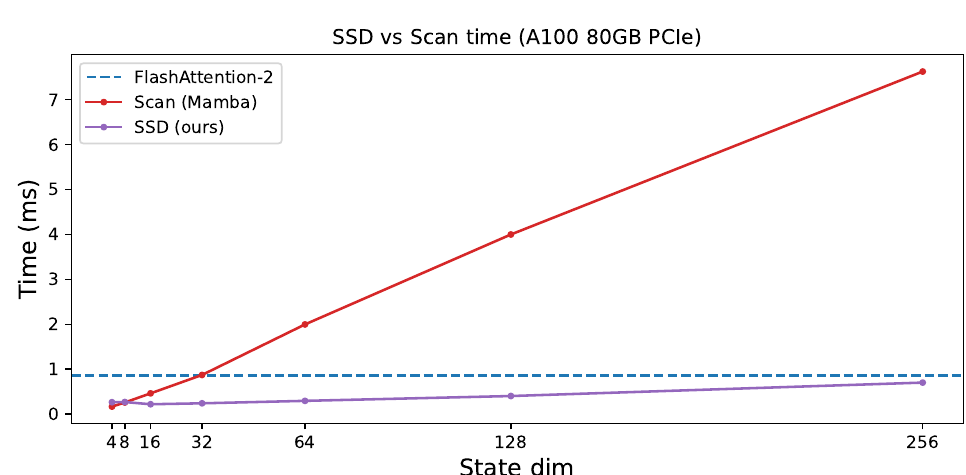
图 10:(效率基准测试。)(左)对于大的状态扩展 (N=64),我们的 SSD 比 Mamba 融合扫描快 2-8×,并且在序列长度 及以上时比 FlashAttention-2 更快。(右)序列长度 :增加状态扩展会线性地减慢 Mamba 优化扫描实现。SSD 可以处理大得多的状态扩展因子而不会明显变慢。
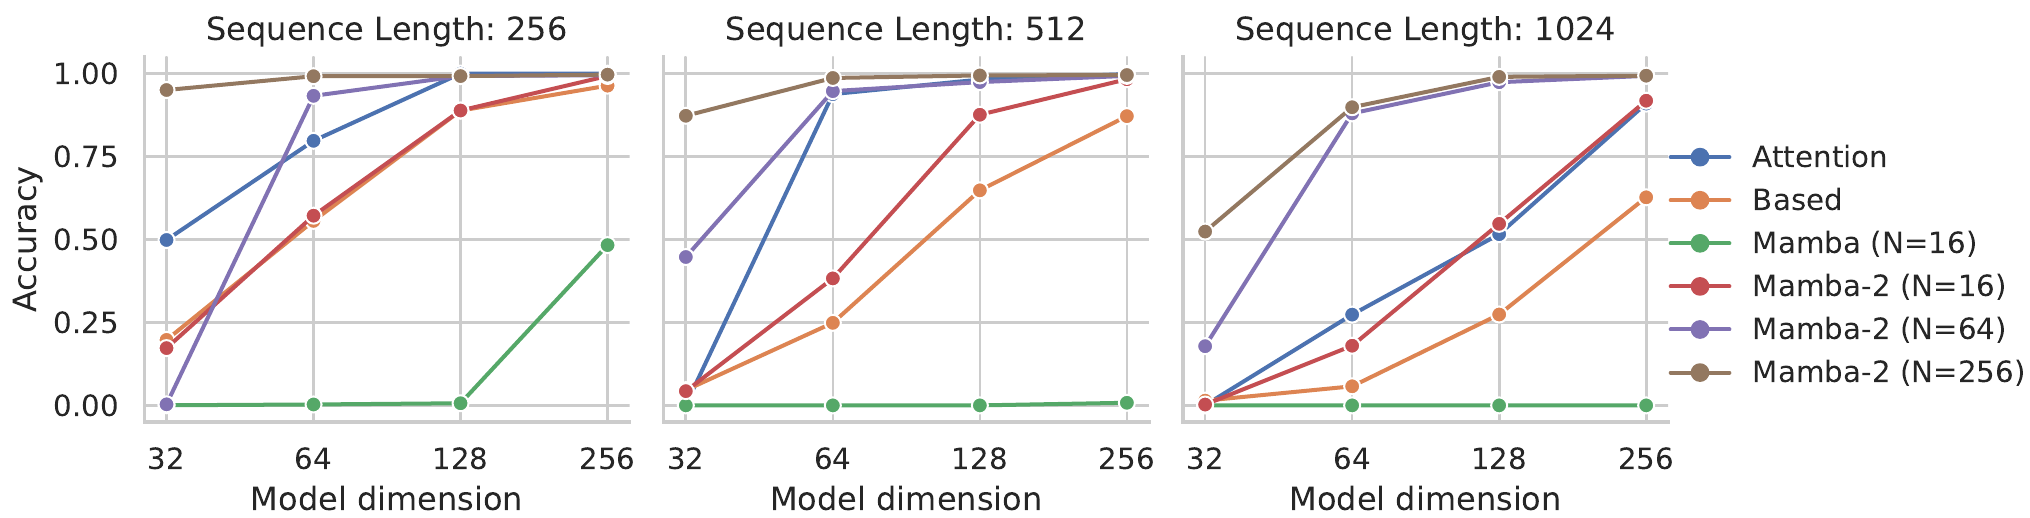
我们在(Arora, Eyuboglu, Zhang, et al. 2024)的 MQAR 设置的一个具有挑战性的版本上进行比较,使用更难的任务、更长的序列和更小的模型。我们的基线包括标准多头 softmax 注意力以及 Based 架构,后者结合了卷积、局部注意力和一种线性注意力变体。
结果如图 8 所示。虽然 Mamba-1 在该任务上表现不佳,但 Mamba-2 在所有设置下都表现良好。令人惊讶的是,即使在控制状态大小()的情况下,它也显著优于 Mamba-1。(我们不确定架构的哪个方面是主要因素,这仍是未来工作需要探索的问题。)此外,该任务验证了状态大小的重要性:从 增加到 和 持续改善 MQAR 上的性能,因为更大的状态允许记住更多信息(键-值对)。
9.2 语言建模
遵循 LLM 中的标准协议,我们在标准自回归语言建模上针对其他架构训练和评估 Mamba-2 架构。我们比较预训练指标(困惑度)和零样本评估。模型大小(深度和宽度)遵循 GPT3 规格,从 到 。我们使用 Pile 数据集(L. Gao, Biderman, et al. 2020),并遵循 Brown et al. (2020) 中描述的训练配方。这遵循 Mamba(Gu and Dao 2023)中报告的相同设置;训练细节见附录 D。
9.2.1 缩放定律
对于基线,我们与 Mamba 及其 Transformer++ 配方(Gu and Dao 2023)进行比较,后者基于 PaLM 和 LLaMa 架构(例如旋转嵌入、SwiGLU MLP、用 RMSNorm 代替 LayerNorm、无线性偏置以及更高的学习率)。由于 Mamba 已经证明其优于标准 Transformer 架构(GPT3 架构)以及最近的次二次方架构(H3(Dao, D. Y. Fu, et al. 2023)、Hyena(Poli et al. 2023)、RWKV-4(B. Peng, Alcaide, et al. 2023)、RetNet(Y. Sun et al. 2023)),为清晰起见,我们在图中省略了这些(比较见 Gu and Dao (2023))。
图 9 展示了标准 Chinchilla(Hoffmann et al. 2022)协议下,从 \approx 125M 到 \approx 1.3B 参数模型的缩放定律。
9.2.2 下游评估
表 1 展示了 Mamba-2 在一系列流行的下游零样本评估任务上的性能,并与这些规模下最知名的开源模型进行比较,最重要的是 Pythia(Biderman et al. 2023),其训练使用的 tokenizer、数据集和训练长度(300B tokens)与我们的模型相同。
9.2.3 混合模型:将 SSD 层与 MLP 和注意力结合
最近及同期的工作(Dao, D. Y. Fu, et al. 2023; De et al. 2024; Glorioso et al. 2024; Lieber et al. 2024)表明,同时具有 SSM 层和注意力层的混合架构可以提高模型质量,优于 Transformer 或纯 SSM(例如 Mamba)模型,尤其是在上下文学习方面。我们探索了 SSD 层与注意力和 MLP 结合的不同方式,以理解各自的优势。根据经验,我们发现总层数中约 为注意力层时表现最佳。将 SSD 层、注意力层和 MLP 结合也比纯 Transformer++ 或 Mamba-2 效果更好。
SSD 与注意力 我们发现 SSD 层和注意力层是互补的:单独来看(例如在 Mamba-2 架构与 Transformer++ 中),它们的性能(以困惑度衡量)几乎相同,但 SSD 层和注意力层的混合优于纯 Mamba-2 或 Transformer++ 架构。我们展示了一些结果(表 2),针对 350M 模型(48 层),在 Pile 上使用 GPT-2 tokenizer 训练至 7B tokens(相同参数数量、相同超参数、相同训练和验证集)。仅添加少量注意力层就已经产生了显著改进,并在质量和效率之间取得了最佳平衡。我们假设 SSM 层作为通用的序列到序列映射效果良好,而注意力层充当检索机制,快速引用序列中的先前 token,而不是迫使模型将所有上下文压缩到其记忆(SSM 状态)中。
| 用于理解原文的只读背景(非待翻译源文本):SSD与注意力机制 我们发现SSD层和注意力层是互补的:单独使用时(例如在Mamba-2架构对比Transformer++中),它们的性能(以困惑度衡量)几乎相同,但SSD层和注意力层的混合使用优于纯Mamba-2或Transformer++架构。我们展示了350M模型(48层)的一些结果(表2),该模型在Pile数据集上使用GPT-2分词器训练到7B tokens(相同参数数量、相同超参数, | 待翻译文本: | 注意力块数量 | 0(Mamba-2) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 9 | 11 | 15 |
| 24 | Transformer++ | 困惑度 ↓ | 8.60 | 8.38 | 8.32 | 8.29 | 8.29 | 8.28 | 8.26 | 8.27 | 8.28 | 8.30 | 8.34 |
结合 SSD、MLP 和注意力的混合模型 我们比较了 SSD 与(门控)MLP 和注意力层结合的不同方式,并在 2.7B 规模(64 层)下进行评估,在 Pile 上训练至 300B tokens(相同参数数量、相同超参数、相同训练和验证集、相同数据顺序):
1. Transformer++:32 个注意力层和 32 个门控 MLP,交错排列。
2. Mamba-2:64 个 SSD 层。
3. Mamba-2-MLP:32 个 SSD 层和 32 个门控 MLP 层,交错排列。
4. Mamba-2-Attention:58 个 SSD 层和 6 个注意力层(位于索引 9、18、27、36、45、56)6。
5. Mamba-2-MLP-Attention:28 个 SSD 层和 4 个注意力层,与 32 个门控 MLP 层交错排列。
我们在表 3 中报告了在 Pile 上的验证困惑度,以及零样本评估结果。总体而言,Transformer++ 和 Mamba-2 模型的质量大致相同。我们看到,仅添加 6 个注意力层就能明显优于纯 Mamba-2 模型(以及 Transformer++)。添加 MLP 层会降低模型质量,但可以 (i) 由于 MLP 层的简单性和硬件效率而加速训练和推理 (ii) 通过将 MLP 层替换为混合专家,更容易升级为 MoE 模型。
| 模型 | 词元。 | PILE | LAMBADA | LAMBADA | HELLASWAG | PIQA | ARC-E | ARC-C | WINOGRANDE | OPENBOOKQA | 平均 |
| PPL ↓ | PPL ↓ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ACC ↑ | ||
| Transformer++ | NeoX | 6.13 | 3.99 | 70.3 | 66.4 | 75.2 | 67.7 | 37.8 | 63.9 | 40.4 | 60.2 |
| Mamba-2 | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| Mamba-2-MLP | NeoX | 6.13 | 4.18 | 69.3 | 65.0 | 76.4 | 68.1 | 37.0 | 63.1 | 38.2 | 59.6 |
| Mamba-2-Attention | NeoX | 5.95 | 3.85 | 71.1 | 67.8 | 75.8 | 69.9 | 37.8 | 65.3 | 39.0 | 61.0 |
| Mamba-2-MLP-Attention | NeoX | 6.00 | 3.95 | 70.0 | 66.6 | 75.4 | 70.6 | 38.6 | 64.6 | 39.2 | 60.7 |
9.3 速度基准
我们将 SSD 算法的速度与 Mamba 的扫描实现以及 FlashAttention-2 进行了基准测试(图 10)。SSD 得益于其重构为使用矩阵乘法作为子程序的方式,可以利用 GPU 上的专用矩阵乘法(matmul)单元,也称为张量核心。因此,它比 Mamba 的融合关联扫描快 2-8 倍,后者不利用 matmul 单元。由于其在序列长度上的线性扩展,SSD 从序列长度 开始就比 FlashAttention-2 更快。
然而,我们注意到,Mamba-2 模型整体在短序列长度(例如 时)的训练效率可能不如 Transformer,因为具有 层的 Transformer 会有 个 MLP 层和 个注意力层,而 Mamba-2 模型在相同参数量下会有 个 SSD 层。通常,MLP 层在硬件上非常高效,因为它们由简单的矩阵乘法和逐点线性组成。如第 9.2.3 节所示,也可以结合 个 SSD 层和 个 MLP 层来加速短序列长度下的训练。
| 块 | ABCX 投影 | 额外归一化 | 参数 | 困惑度 |
| Mamba-1 | 串行 | × | 129.3M | 11.76 |
| 串行 | ✓ | 129.3M | 11.54 | |
| 并行 | × | 126.5M | 11.66 | |
| 并行 | ✓ | 126.5M | 11.49 |
9.4 架构消融
9.4.1 模块设计
第 7.1 节介绍了 Mamba-2 模块,它对 Mamba-1 模块做了一些小修改,部分动机来自与注意力机制的关联,同时也是为了提升 Mamba-2 的可扩展性。表 4 对这些模块架构变化进行了消融,这些变化发生在核心 SSM 层之外。
消融实验验证了,通过并行投影生成 \((A,B,C,X)\) 相比 Mamba 的顺序投影能够节省参数,并且性能略优。更重要的是,这一修改在更大模型规模下适合张量并行(第 8 节)。此外,额外的归一化层也略微提升了性能。更重要的是,在更大规模上的初步实验观察到,它还有助于训练稳定性。
9.4.2 头结构
第 7.2 节描述了如何将 \(B,C,X\) 投影的维度视为一个超参数,类似于多头注意力和多查询注意力的概念。我们还展示了原始 Mamba 架构如何类似于多值注意力(命题 7.2),这一选择是从状态空间模型视角自然发展而来的,此前并未经过消融。
表 5 对 Mamba-2 架构中多头结构的选择进行了消融。令人惊讶的是,我们发现多值与多查询或多键头模式之间存在很大差异,尽管它们看起来非常相似。请注意,这并不能用总状态大小来解释,因为所有模式的总状态大小相同(等于 HPN,即头数、头维度和状态维度的乘积)。
我们还比较了 \(C,B,X\)(类似于 \(Q,K,V\))头数相等的多头模式。我们与标准多头模式进行了比较,也与一种激进共享的模式进行了比较,其中它们都只有 1 个头。请注意,在后一种情况下,模型仍然有 H 个不同的序列混合器 \(M\),因为每个头仍然有不同的 \(A\)。在参数匹配时,这些多头模式彼此表现相似,介于 MVA 和 MQA/MKA 模式之间。
9.4.3 注意力核近似
第 7.3 节指出,SSD 可以与线性注意力文献中的思想相结合,例如各种形式的核近似。我们在表 6 中对先前工作提出的几种变体进行了消融。这些包括 cosFormer(Qin, Weixuan Sun, et al. 2022)、随机特征注意力(H. Peng et al. 2021)和正随机特征(Performer)(Choromanski et al. 2021)。
我们还消融了添加归一化项的效果,类似于标准注意力中 softmax 函数的分母。我们发现,这给大多数变体引入了不稳定性,但对 ReLU 激活函数 \(\psi\) 略微提升了性能。
表 7 还测试了近期提出的改进线性注意力的方案,这些方案涉及扩展特征维度(Based(Arora, Eyuboglu, Zhang, et al. 2024)和 ReBased(Aksenov et al. 2024))。这些线性注意力扩展旨在用二次近似来逼近 exp 核。ReBased 还提出用层归一化替换 QK 激活函数;从以 SSM 为中心的视角来看,我们在应用 SSM 函数之前对 \((B,C)\) 施加归一化。
| SSM 头模式 | ATTN. 类比 | A 头 | B 头 | C 头 | X 头 | 层数 | 参数量 | PPL. |
| 多输入(MIS) | 多值(MVA) | 24 | 1 | 1 | 24 | 24 | 126.5M | 11.66 |
| 多收缩(MCS) | 多查询(MQA) | 24 | 1 | 24 | 1 | 24 | 126.5M | 12.62 |
| 多扩展(MES) | 多键(MKA) | 24 | 24 | 1 | 1 | 24 | 126.5M | 12.59 |
| 多头(MHS) | 多头(MHA) | 24 | 24 | 24 | 24 | 15 | 127.6M | 12.06 |
| 多状态(MSS) | - | 24 | 1 | 1 | 1 | 36 | 129.6M | 12.00 |
| 多输入(MIS) | 多值(MVA) | 32 | 1 | 1 | 32 | 48 | 361.8M | 8.73 |
| 多收缩(MCS) | 多查询(MQA) | 32 | 1 | 32 | 1 | 48 | 361.8M | 9.33 |
| 多扩展(MES) | 多键(MKA) | 32 | 32 | 1 | 1 | 48 | 361.8M | 9.36 |
| 多头(MHS) | 多头(MHA) | 32 | 1 | 1 | 1 | 70 | 361.3M | 9.01 |
| 多状态(MSS) | - | 32 | 32 | 32 | 32 | 29 | 357.3M | 9.04 |
| 核激活函数 φ | 困惑度 |
| 无 | 11.58 |
| Swish | 11.66 |
| Exp | 11.62 |
| ReLU | 11.73 |
| ReLU + 归一化 | 11.64 |
| cosFormer | 11.97 |
| 随机特征注意力 | 11.57 |
| 正随机特征(Performer) | 12.21 |
| 核激活 φ | 困惑度 |
| Swish | 11.67 |
| Swish + 泰勒展开(Based) | 12.19 |
| LayerNorm | 11.50 |
| LayerNorm + 平方(ReBased) | 11.84 |
| Swish | 8.58 |
| Swish + 泰勒展开(Based) | 8.71 |
| LayerNorm | 8.61 |
| LayerNorm + 平方(ReBased) | 8.63 |
我们注意到,这项技术已被独立提出为用于 softmax 注意力的“QK-Norm”(Team 2024),以及用于 Mamba 的“内部归一化”(Lieber et al. 2024)。
总体而言,表 6 和表 7 发现,我们尝试的核近似方法似乎并未优于对 采用简单的逐点非线性激活函数。因此,Mamba-2 的默认设置沿用 Mamba-1,使用 ,但我们建议,完全移除这一激活函数可能是一种更简单的选择,尽管我们并未对此进行广泛测试。
然而我们要强调,SSD 与普通线性注意力的区别在于是否包含 1-半可分掩码 ,而文献中的各种线性注意力方法是在不含该项的前提下推导出来以近似 softmax 注意力的;因此,我们的负面结果也许并不出乎意料。
10 相关工作与讨论
状态空间对偶框架在 SSM、结构化矩阵和注意力之间建立了联系。我们更深入地讨论 SSD 与这些概念之间更广泛的关系。利用各个视角的思想,我们还提出了 SSD 框架在未来工作中可以扩展的一些方向。
10.1 状态空间模型
结构化状态空间模型可以沿以下维度进行刻画:(i) 它是时不变还是时变的;(ii) 系统的维度;(iii) 循环转移 上的结构。
SSD 可以描述为具有 SISO 维度和标量恒等结构的选择性 SSM。
时变性(选择性)。最初的结构化 SSM(S4)是线性时不变(LTI)系统(Gu 2023; Gu, Goel, and Ré 2022),其动机来自连续时间在线记忆(Gu, Dao, et al. 2020; Gu, Johnson, Goel, et al. 2021; Gu, Johnson, Timalsina, et al. 2023)。人们提出了许多结构化 SSM 的变体(Dao, D. Y. Fu, et al. 2023; Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Ma et al. 2023; J. T. Smith, Warrington, and Linderman 2023),其中包括若干放弃循环、专注于 LTI SSM 卷积表示的变体(D. Y. Fu et al. 2023; Y. Li et al. 2023; Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023)。
SSD 是一种时变结构化 SSM,也称为 Mamba 中引入的选择性 SSM(Gu and Dao 2023)。选择性 SSM 与 RNN 的门控机制密切相关,包括 LSTM(Hochreiter and Schmidhuber 1997)和 GRU(J. Chung et al. 2014)等经典 RNN,以及 QRNN(Bradbury et al. 2016)、SRU(Lei 2021; Lei et al. 2017)、RWKV(B. Peng, Alcaide, et al. 2023)、HGRN(Qin, Yang, and Zhong 2023)和 Griffin(Botev et al. 2024; De et al. 2024)等更现代的变体。这些 RNN 在各种方面参数化方式不同,最重要的是缺少状态扩展。
维度与状态扩展。SSD 的一个由其谱系中先前 SSM(S4、H3、Mamba)共有的重要特征是,它是一个单输入单输出(SISO)系统,其中输入通道被独立处理。这导致有效状态规模大得多,为 N0,其中 N 是 SSM 状态大小(也称为状态扩展因子),D 是标准模型维度。传统 RNN 要么具有 ,要么是具有稠密 矩阵的多输入多输出(MIMO)系统,二者都会导致较小的状态。虽然 MIMO SSM 已在某些领域被证明效果良好(Lu et al. 2023; Orvieto et al. 2023; J. T. Smith, Warrington, and Linderman 2023),但 Mamba 表明,状态扩展对于语言等信息密集领域至关重要。SSD 的主要优势之一是能够在不减慢模型速度的情况下实现更大的状态扩展因子。此后许多工作都采用了状态扩展(第 10.4 节)。
结构。与先前的结构化 SSM 相比,SSD 的主要限制在于状态转移 的表达能力。我们注意到,更一般的 SSM(例如对角 的情形)具有与 SSD 相同的理论效率,但对硬件不太友好。这是因为对偶二次形式失去了类似注意力的解释,并且变得更难计算。因此,与 Mamba 相比,SSD 仅在稍微更具限制性的对角 形式上有所不同,并以这种表达能力换取更高的硬件效率(以及更易于实现)。
我们假设,可能可以改进我们的结构化矩阵算法,使其也能提升到一般对角 SSM 的情形。
10.2 结构化矩阵
状态空间对偶的第一种视角是将这些模型视为矩阵序列变换或“矩阵混合器”:沿序列维度 T 可表示为矩阵乘法(乘以一个 矩阵)的序列变换(定义 2.1)。
此前已提出若干此类矩阵混合器,其主要变化轴是矩阵的表示形式。这些包括 MLP-Mixer(Tolstikhin et al. 2021)(非结构化矩阵)、FNet(Lee-Thorp et al. 2021)(傅里叶变换矩阵)、M2(Dao, B. Chen, et al. 2022; Dao, Gu, et al. 2019; Dao, Sohoni, et al. 2020; D. Fu et al. 2024)(蝶形/君主矩阵)、Toeplitz 矩阵(Poli et al. 2023; Qin, Han, Weixuan Sun, B. He, et al. 2023),以及更奇特的结构(De Sa et al. 2018; Thomas et al. 2018)。
一个重要的刻画是,高效(次二次)的矩阵序列变换正是那些具有结构化矩阵混合器的变换。SSD 框架的一个核心结果是将 SSM 视为具有特定结构——半可分矩阵(第 3 节)——的矩阵混合器。线性与二次对偶随后表现为结构化矩阵乘法与朴素矩阵乘法的对比。
结构矩阵表示通过对特定半可分矩阵进行块分解,促成了我们高效的 SSD 算法(第 6 节)。我们注意到,半可分矩阵在科学计算文献中已有充分研究,纳入这些思想可能是进一步改进状态空间模型的一条有前景的途径。我们还建议,聚焦于矩阵混合器视角可以为序列模型带来更多富有成果的方向,例如设计有原则的 Mamba 非因果变体,或通过分析 softmax 注意力和次二次模型的矩阵变换结构,找到刻画并弥合二者差距的方法。
10.3(线性)注意力
与标准(因果)注意力相比,SSD 只有两个主要区别。
第一,SSD 不使用标准注意力的 softmax 激活(Bahdanau, Cho, and Bengio 2015; Vaswani et al. 2017),而正是 softmax 赋予了注意力二次复杂度。当去掉 softmax 时,序列可以通过线性注意力框架以线性规模计算(Katharopoulos et al. 2020)。
第二,SSD 将 logits 矩阵乘以一个输入相关的 1-半可分掩码。因此,该掩码可以看作是在标准注意力中替代 softmax。
这种半可分掩码也可以被视为提供位置信息。元素 在 RNN 意义上充当“门”,或一种“选择”机制(参见 Mamba 论文中的讨论),它们的累积乘积 控制位置 和 之间允许多少交互。位置嵌入(例如正弦式(Vaswani et al. 2017)、Alibi(Press, N. Smith, and Lewis 2022)和 RoPE(Su et al. 2021))是 Transformer 的重要组成部分,通常被视为启发式方法,而 SSD 的 1-SS 掩码可以看作一种更有原则的相对位置嵌入形式。我们注意到,这一观点也由 GateLoop(Katsch 2023)同时提出。
状态空间对偶的第二种视角是我们更一般的结构化掩码注意力(SMA)框架的一个特例,其中对偶性体现为对一个简单四路张量收缩采用不同的收缩顺序。SMA 是线性注意力的一种强泛化,也比 SSD 更为一般;其他形式的结构化掩码可能会带来更多具有不同于 SSD 性质的高效注意力变体。
除了引出新模型之外,这些与注意力机制的联系还可以为理解 SSM 带来其他方向。例如,我们好奇注意力汇现象(Darcet et al. 2024; Xiao et al. 2024)是否存在于 Mamba 模型中,以及更广泛地说,可解释性技术是否可以迁移到 SSM 上(Ali, Zimerman, and Wolf 2024)。
最后,人们还提出了许多其他线性注意力变体(Arora, Eyuboglu, Timalsina, et al. 2024; Arora, Eyuboglu, Zhang, et al. 2024; Choromanski et al. 2021; H. Peng et al. 2021; Qin, Han, Weixuan Sun, Dongxu Li, et al. 2022; Qin, Weixuan Sun, et al. 2022; Schlag, Irie, and Schmidhuber 2021; Zhang et al. 2024; Zheng, C. Wang, and Kong 2022)(其中若干变体的描述见第 4.1.3 节),我们预计许多技术可以迁移到 SSM 上(例如第 7.3 节)。
我们强调,SSD 并不推广标准 softmax 注意力,也不推广对注意力核矩阵的任何其他不具有有限特征映射 的变换。与一般注意力相比,SSD 的优势在于具有可控的状态扩展因子 来压缩历史,而二次注意力的整个历史缓存随序列长度 缩放。并行工作已开始研究这些表示之间的权衡,例如在复制任务和上下文学习任务上(Akyürek et al. 2024; Grazzi et al. 2024; Jelassi et al. 2024; Park et al. 2024)。我们注意到,Mamba-2 在其中一些能力上显著优于 Mamba(例如第 9.1 节中的 MQAR 结果所示),但仍有更多内容有待理解。
10.4 相关模型
最后,我们着重介绍近期及并行工作中不断增多的一类工作,它们开发了与 Mamba 和 Mamba-2 非常相似的序列模型。
- RetNet(Y. Sun et al. 2023)和 TransNormerLLM(Qin, Dong Li, et al. 2023)使用衰减项而非累积和来推广线性注意力,并提出了对偶的并行/循环算法以及一种混合的“分块”模式。这些算法可以看作 SSD 的一个实例化,其中 是时不变的(对所有 为常数);在 SMA 解释中,掩码矩阵 将是一个衰减矩阵 。这些模型在架构上也有各种不同之处。例如,由于它们是从以注意力为中心的视角推导出来的,因此保留了多头注意力(MHA)模式;而由于 Mamba-2 是从以 SSM 为中心的视角推导出来的,它保留了多值注意力(MVA)或多扩展 SSM(MES)模式,我们已证明后者更好(第 9.4 节)。
- GateLoop(Katsch 2023)同时提出了使用输入相关的衰减因子 ,并开发了与 SSD 中相同的对偶二次型,他们将其称为“代理注意力”形式。
- 门控线性注意力(Gated Linear Attention, GLA)(Yang et al. 2024)提出了带有数据相关门控的线性注意力变体,以及用于计算分块模式和硬件感知实现的高效算法。
- HGRN(Qin, Yang, and Zhong 2023)引入了一种带有输入相关门控的 RNN,并在 HGRN2(Qin, Yang, Weixuan Sun, et al. 2024)中通过引入状态扩展对其进行了改进。
- Griffin(De et al. 2024)和 RecurrentGemma(Botev et al. 2024)表明,带有输入相关门控的 RNN 结合局部注意力,可以与强大的现代 Transformer 极具竞争力。Jamba 还表明,将 Mamba 与少数几层注意力相结合在语言建模上表现非常好(Lieber et al. 2024)。
- xLSTM(Beck et al. 2024)通过采用状态扩展以及其他门控、归一化和稳定化技术的思想来改进 xLSTM。
- RWKV(-4)(B. Peng, Alcaide, et al. 2023)是一种基于不同线性注意力近似(无注意力 Transformer(S. Zhai et al. 2021))的 RNN。它最近通过采用选择性和状态扩展的思想被改进为 RWKV-5/6(Eagle 和 Finch)架构(B. Peng, Goldstein, et al. 2024)。
11 结论
我们提出了一个基于经过充分研究的结构化矩阵类的理论框架,弥合了 SSM 与注意力变体之间的概念鸿沟。该框架为近期 SSM(例如 Mamba)如何在语言建模上表现得与 Transformer 一样好提供了洞见。此外,我们的理论工具通过连接双方的算法和系统进展,为改进 SSM(以及潜在的 Transformer)提供了新思路。作为演示,该框架指导我们设计了一种位于 SSM 与结构化注意力交叉点的新架构(Mamba-2)。
致谢
我们感谢 Angela Wu 关于如何以数值稳定的方式高效计算 梯度的建议。我们感谢 Sukjun Hwang 和 Aakash Lahoti 在 MQAR 实验中的协助。
参考文献
[1] Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". In: arXiv preprint arXiv:2305.13245 (2023).
[2] Yaroslav Aksenov, Nikita Balagansky, Sofia Maria Lo Cicero Vaina, Boris Shaposhnikov, Alexey Gorbatovski, and Daniil Gavrilov. "Linear Transformers with Learnable Kernel Functions are Better In-Context Models". In: arXiv preprint arXiv:2402.10644 (2024).
[3] Ekin Akyürek、Bailin Wang、Yoon Kim 和 Jacob Andreas。“上下文语言学习:架构与算法”。载于:国际机器学习会议(ICML)。2024年。
[4] Ameen Ali、Itamar Zimerman 和 Lior Wolf。Mamba 模型的隐藏注意力。2024年。arXiv: 2403.01590 [cs.LG]。
[5] Simran Arora、Sabri Eyuboglu、Aman Timalsina、Isys Johnson、Michael Poli、James Zou、Atri Rudra 和 Christopher Ré。“Zoology:测量和改进高效语言模型中的召回能力”。载于:国际学习表征会议(ICLR)。2024年。
[6] Simran Arora、Sabri Eyuboglu、Michael Zhang、Aman Timalsina、Silas Alberti、Dylan Zinsley、James Zou、Atri Rudra 和 Christopher Ré。“简单线性注意力语言模型平衡召回-吞吐量权衡”。载于:国际机器学习会议(ICML)。2024年。
[7] Dzmitry Bahdanau、Kyunghyun Cho 和 Yoshua Bengio。“通过联合学习对齐和翻译的神经机器翻译”。载于:国际学习表征会议(ICLR)。2015年。
[8] George A Baker、George A Baker Jr、Peter Graves-Morris 和 Susan S Baker。帕德逼近:数学及其应用百科全书,第59卷 George A. Baker, Jr., Peter Graves-Morris。第59卷。剑桥大学出版社,1996年。
[9] Maximilian Beck、Korbinian Poppel、Markus Spanring、Andreas Auer、Oleksandra Prudnikova、Michael Kopp、Günter Klambauer、Johannes Brandstetter 和 Sepp Hochreiter。“xLSTM:扩展长短期记忆”。载于:arXiv 预印本 arXiv:2405.04517(2024年)。
[10] Stella Biderman、Hailey Schoelkopf、Quentin Gregory Anthony、Herbie Bradley、Kyle O'Brien、Eric Hallahan、Mohammad Aflah Khan、Shivanshu Purohit、USVSN Sai Prashanth、Edward Raff 等。“Pythia:用于分析大型语言模型在训练和扩展过程中的套件”。载于:国际机器学习会议(ICML)。PMLR。2023年,第2397-2430页。
[11] Yonatan Bisk、Rowan Zellers、Jianfeng Gao、Yejin Choi 等。“PIQA:关于自然语言中物理常识的推理”。载于:AAAI 人工智能会议论文集。第34卷。2020年。
[12] Sid Black、Stella Biderman、Eric Hallahan、Quentin Anthony、Leo Gao、Laurence Golding、Horace He、Connor Leahy、Kyle McDonell、Jason Phang 等。“Gpt-NeoX-20B:一个开源自回归语言模型”。载于:arXiv 预印本 arXiv:2204.06745(2022年)。
[13] Guy E Blelloch。“前缀和及其应用”。载于:(1990年)。
[14] Aleksandar Botev、Soham De、Samuel L Smith、Anushan Fernando、George-Cristian Muraru、Ruba Haroun、Leonard Berrada、Razvan Pascanu、Pier Giuseppe Sessa、Robert Dadashi 等。“RecurrentGemma:超越 Transformer 实现高效开放语言模型”。载于:arXiv 预印本 arXiv:2404.07839(2024年)。
[15] George EP Box、Gwilym M Jenkins、Gregory C Reinsel 和 Greta M Ljung。时间序列分析:预测与控制。John Wiley & Sons,2015年。
[16] James Bradbury、Stephen Merity、Caiming Xiong 和 Richard Socher。“准循环神经网络”。载于:arXiv 预印本 arXiv:1611.01576(2016年)。
[17] William Brandon、Aniruddha Nrusimha、Kevin Qian、Zachary Ankner、Tian Jin、Zhiye Song 和 Jonathan Ragan-Kelley。“条纹注意力:面向因果 Transformer 的更快环形注意力”。载于:arXiv 预印本 arXiv:2311.09431(2023年)。
[18] Tom Brown、Benjamin Mann、Nick Ryder、Melanie Subbiah、Jared D Kaplan、Prafulla Dhariwal、Arvind Neelakantan、Pranav Shyam、Girish Sastry、Amanda Askell 等。“语言模型是少样本学习器”。载于:神经信息处理系统进展(NeurIPS)33(2020年),第1877-1901页。
[19] Krzysztof Choromanski、Valerii Likhosherstov、David Dohan、Xingyou Song、Andreea Gane、Tamas Sarlos、Peter Hawkins、Jared Davis、Afroz Mohiuddin、Lukasz Kaiser 等。“Rethinking Attention with Performers”。载于:国际学习表征会议(ICLR)。2021。
[20] Aakanksha Chowdhery、Sharan Narang、Jacob Devlin、Maarten Bosma、Gaurav Mishra、Adam Roberts、Paul Barham、Hyung Won Chung、Charles Sutton、Sebastian Gehrmann 等。“PaLM: Scaling Language Modeling with Pathways”。载于:Journal of Machine Learning Research 24.240(2023),第1–113页。URL:http://jmlr.org/papers/v24/22-1144.html。
[21] Junyoung Chung、Caglar Gulcehre、KyungHyun Cho 和 Yoshua Bengio。“Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling”。载于:arXiv preprint arXiv:1412.3555(2014)。
[22] Peter Clark、Isaac Cowhey、Oren Etzioni、Tushar Khot、Ashish Sabharwal、Carissa Schoenick 和 Oyvind Tafjord。“Think you have Solved Question Answering? Try ARC, the AI2 Reasoning Challenge”。载于:arXiv preprint arXiv:1803.05457(2018)。
[23] Tri Dao。“FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning”。载于:国际学习表征会议(ICLR)。2024。
[24] Tri Dao、Beidi Chen、Nimit S Sohoni、Arjun Desai、Michael Poli、Jessica Grogan、Alexander Liu、Aniruddh Rao、Atri Rudra 和 Christopher Ré。“Monarch: Expressive structured matrices for efficient and accurate training”。载于:国际机器学习会议。PMLR。2022,第4690–4721页。
[25] Tri Dao、Daniel Y Fu、Khaled K Saab、Armin W Thomas、Atri Rudra 和 Christopher Ré。“Hungry Hungry Hippos: Towards Language Modeling with State Space Models”。载于:国际学习表征会议(ICLR)。2023。
[26] Tri Dao、Albert Gu、Matthew Eichhorn、Atri Rudra 和 Christopher Ré。“Learning Fast Algorithms for Linear Transforms Using Butterfly Factorizations”。载于:国际机器学习会议(ICML)。2019。
[27] Tri Dao、Nimit Sohoni、Albert Gu、Matthew Eichhorn、Amit Blonder、Megan Leszczynski、Atri Rudra 和 Christopher Ré。“Kaleidoscope: An Efficient, Learnable Representation for All Structured Linear Maps”。载于:国际学习表征会议(ICLR)。2020。
[28] Timothée Darcet、Maxime Oquab、Julien Mairal 和 Piotr Bojanowski。“Vision Transformers Need Registers”。载于:国际学习表征会议(ICLR)。2024。
[29] Soham De、Samuel L Smith、Anushan Fernando、Aleksandar Botev、George Cristian-Muraru、Albert Gu、Ruba Haroun、Leonard Berrada、Yutian Chen、Srivatsan Srinivasan 等。“Griffin: Mixing Gated Linear Recurrences with Local Attention for Efficient Language Models”。载于:arXiv preprint arXiv:2402.19427(2024)。
[30] Christopher De Sa、Albert Gu、Rohan Puttagunta、Christopher Ré 和 Atri Rudra。“A Two-Pronged Progress in Structured Dense Matrix Vector Multiplication”。载于:第二十九届 ACM-SIAM 离散算法年度研讨会论文集。SIAM。2018,第1060–1079页。
[31] Hantian Ding、Zijian Wang、Giovanni Paolini、Varun Kumar、Anoop Deoras、Dan Roth 和 Stefano Soatto。“Fewer truncations improve language modeling”。载于:arXiv preprint arXiv:2404.10830(2024)。
[32] Yuli Eidelman 和 Israel Gohberg。“On a new class of structured matrices”。载于:Integral Equations and Operator Theory 34.3(1999),第293–324页。
[33] Dan Fu、Simran Arora、Jessica Grogan、Isys Johnson、Evan Sabri Eyuboglu、Armin Thomas、Benjamin Spector、Michael Poli、Atri Rudra 和 Christopher Ré。“Monarch mixer: A simple sub-quadratic gemm-based architecture”。载于:Advances in Neural Information Processing Systems 36(2024)。
[34] Daniel Y Fu、Elliot L Epstein、Eric Nguyen、Armin W Thomas、Michael Zhang、Tri Dao、Atri Rudra 和 Christopher Ré。“Simple Hardware-efficient Long Convolutions for Sequence Modeling”。载于:国际机器学习会议(ICML)(2023)。
[35] Leo Gao、Stella Biderman、Sid Black、Laurence Golding、Travis Hoppe、Charles Foster、Jason Phang、Horace He、Anish Thite、Noa Nabeshima、Shawn Presser 和 Connor Leahy。“The Pile: An 800GB Dataset of Diverse Text for Language Modeling”。载于:arXiv preprint arXiv:2101.00027(2020)。
[36] Leo Gao、Jonathan Tow、Stella Biderman、Sid Black、Anthony DiPofi、Charles Foster、Laurence Golding、Jeffrey Hsu、Kyle McDonell、Niklas Muennighoff、Jason Phang、Laria Reynolds、Eric Tang、Anish Thite、Ben Wang、Kevin Wang 和 Andy Zou。A Framework for Few-shot Language Model Evaluation。版本 v0.0.1。2021年9月。DOI:10.5281/zenodo.5371628。URL:https://doi.org/10.5281/zenodo.5371628。
[37] Paolo Glorioso、Quentin Anthony、Yury Tokpanov、James Whittington、Jonathan Pilault、Adam Ibrahim 和 Beren Millidge。“Zamba: A Compact 7B SSM Hybrid Model”。载于:arXiv preprint arXiv:2405.16712(2024)。
[38] Riccardo Grazzi、Julien Siems、Simon Schrodi、Thomas Brox 和 Frank Hutter。“Is Mamba Capable of In-Context Learning?” 载于:arXiv preprint arXiv:2402.03170(2024)。
[39] Albert Gu。“Modeling Sequences with Structured State Spaces”。博士论文。斯坦福大学,2023。
[40] Albert Gu 和 Tri Dao。“Mamba: Linear-Time Sequence Modeling with Selective State Spaces”。载于:arXiv preprint arXiv:2312.00752(2023)。
[41] Albert Gu、Tri Dao、Stefano Ermon、Atri Rudra 和 Christopher Ré。“HIPPO: Recurrent Memory with Optimal Polynomial Projections”。载于:Advances in Neural Information Processing Systems(NeurIPS)。2020。
[42] Albert Gu、Karan Goel 和 Christopher Ré。“Efficiently Modeling Long Sequences with Structured State Spaces”。载于:国际学习表征会议(ICLR)。2022。
[43] Albert Gu、Ankit Gupta、Karan Goel 和 Christopher Ré。“On the Parameterization and Initialization of Diagonal State Space Models”。载于:Advances in Neural Information Processing Systems(NeurIPS)。2022。
[44] Albert Gu、Isys Johnson、Karan Goel、Khaled Saab、Tri Dao、Atri Rudra 和 Christopher Ré。“Combining Recurrent, Convolutional, and Continuous-time Models with the Linear State Space Layer”。载于:Advances in Neural Information Processing Systems(NeurIPS)。2021。
[45] Albert Gu、Isys Johnson、Aman Timalsina、Atri Rudra 和 Christopher Ré。“How to Train Your HIPPO: State Space Models with Generalized Basis Projections”。载于:国际学习表征会议(ICLR)。2023。
[46] Ankit Gupta、Albert Gu 和 Jonathan Berant。“Diagonal State Spaces are as Effective as Structured State Spaces”。载于:Advances in Neural Information Processing Systems 35(2022),第22982–22994页。
[47] Dan Hendrycks 和 Kevin Gimpel。“Gaussian Error Linear Units (GELUs)”。载于:arXiv preprint arXiv:1606.08415(2016)。
[48] W Daniel Hillis 和 Guy L Steele Jr。“Data Parallel Algorithms”。载于:Communications of the ACM 29.12(1986),第1170–1183页。
[49] Sepp Hochreiter 和 Jürgen Schmidhuber。“Long Short-Term Memory”。载于:Neural Computation 9.8(1997),第1735–1780页。
[50] Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai, Eliza Rutherford, Diego de Las Casas, Lisa Anne Hendricks, Johannes Welbl, Aidan Clark, 等。“An Empirical Analysis of Compute Optimal Large Language Model Training”。载于:Advances in Neural Information Processing Systems (NeurIPS) 35 (2022),第30016-30030页。[51] Samy Jelassi, David Brandfonbrener, Sham M Kakade, and Eran Malach。“Repeat After Me: Transformers Are Better Than State Space Models at Copying”。载于:The International Conference on Machine Learning (ICML)。2024。[52] Angelos Katharopoulos, Apoorv Vyas, Nikolaos Pappas, and Francois Fleuret。“Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention”。载于:International Conference on Machine Learning。PMLR。2020,第5156-5165页。[53] Tobias Katsch。“GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling”。载于:arXiv preprint arXiv:2311.01927 (2023)。[54] Shiva Kaul。“Linear Dynamical Systems as a Core Computational Primitive”。载于:Advances in Neural Information Processing Systems 33 (2020),第16808-16820页。[55] Vijay Anand Korthikanti, Jared Casper, Sangkug Lynn, Lawrence McAfee, Michael Andersch, Mohammad Shoeybi, and Bryan Catanzaro。“Reducing activation recomputation in large transformer models”。载于:Proceedings of Machine Learning and Systems 5 (2023)。[56] James Lee-Thorp, Joshua Ainslie, Ilya Eckstein, and Santiago Ontanon。“Fnet: Mixing tokens with fourier transforms”。载于:arXiv preprint arXiv:2105.03824 (2021)。[57] Tao Lei。“When Attention Meets Fast Recurrence: Training Language Models with Reduced Compute”。载于:Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing。2021,第7633-7648页。[58] Tao Lei, Yu Zhang, Sida I Wang, Hui Dai, and Yoav Artzi。“Simple Recurrent Units for Highly Parallelizable Recurrence”。载于:arXiv preprint arXiv:1709.02755 (2017)。[59] Yuhong Li, Tianle Cai, Yi Zhang, Deming Chen, and Debadeepta Dey。“What Makes Convolutional Models Great on Long Sequence Modeling?”载于:The International Conference on Learning Representations (ICLR)。2023。[60] Opher Lieber, Barak Lenz, Hofit Bata, Gal Cohen, Jhonathan Osin, Itay Dalmedigos, Erez Safahi, Shaked Meirom, Yonatan Belinkov, Shai Shalev-Shwartz, 等。“Jamba: A Hybrid Transformer-Mamba Language Model”。载于:arXiv preprint arXiv:2403.19887 (2024)。[61] Hao Liu, Wilson Yan, Matei Zaharia, and Pieter Abbeel。“World Model on Million-Length Video And Language With RingAttention”。载于:arXiv preprint arXiv:2402.08268 (2024)。[62] Hao Liu, Matei Zaharia, and Pieter Abbeel。“Ring attention with blockwise transformers for near-infinite context”。载于:arXiv preprint arXiv:2310.01889 (2023)。[63] Chris Lu, Yannick Schroecker, Albert Gu, Emilio Parisotto, Jakob Foerster, Satinder Singh, and Feryal Behbahani。“Structured State Space Models for In-Context Reinforcement Learning”。载于:Advances in Neural Information Processing Systems (NeurIPS)。2023。[64] Xuezhe Ma, Chunting Zhou, Xiang Kong, Junxian He, Liangke Gui, Graham Neubig, Jonathan May, and Luke Zettlemoyer。“Mega: Moving Average Equipped Gated Attention”。载于:The International Conference on Learning Representations (ICLR)。2023。[65] Eric Martin and Chris Cundy。“Parallelizing Linear Recurrent Neural Nets Over Sequence Length”。载于:The International Conference on Learning Representations (ICLR)。2018。[66] Todor Mihaylov, Peter Clark, Tushar Khot, and Ashish Sabharwal。“Can a Suit of Armor Conduct Electricity? A New Dataset for Open Book Question Answering”。载于:arXiv preprint arXiv:1809.02789 (2018)。[67] Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, and Chris Olah。“In-context Learning and Induction Heads”。载于:Transformer Circuits Thread (2022)。https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html。[68] Antonio Orvieto, Samuel L Smith, Albert Gu, Anushan Fernando, Caglar Gulcehre, Razvan Pascanu, and Soham De。“Resurrecting Recurrent Neural Networks for Long Sequences”。载于:The International Conference on Machine Learning (ICML)。2023。[69] Denis Paperno, Germán Kruszewski, Angeliki Lazaridou, Ngoc-Quan Pham, Raffaella Bernardi, Sandro Pezzelle, Marco Baroni, Gemma Boleda, and Raquel Fernández。“The LAMBADA Dataset: Word Prediction Requiring a Broad Discourse Context”。载于:Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics。2016,第1525-1534页。[70] Jongho Park, Jaeseung Park, Zheyang Xiong, Nayoung Lee, Jaewoong Cho, Samet Oymak, Kangwook Lee, and Dimitris Papailiopoulos。“Can Mamba Learn How to Learn? A Comparative Study on In-Context Learning Tasks”。载于:The International Conference on Machine Learning (ICML)。2024。
. html。
[71] Bo Peng, Eric Alcaide, Quentin Anthony, Alon Albalak, Samuel Arcadinho, Huanqi Cao, Xin Cheng, Michael Chung, Matteo Grella, Kranthi Kiran GV, et al. “RWKV: Reinventing RNNs for the Transformer Era”。载于:arXiv preprint arXiv:2305.13048 (2023)。
[72] Bo Peng, Daniel Goldstein, Quentin Anthony, Alon Albalak, Eric Alcaide, Stella Biderman, Eugene Cheah, Teddy Ferdinand, Haowen Hou, Przemyslaw Kazienko, et al. “Eagle and Finch: RWKV with matrix-valued states and dynamic recurrence”。载于:arXiv preprint arXiv:2404.05892 (2024)。
[73] Hao Peng, Nikolaos Pappas, Dani Yogatama, Roy Schwartz, Noah A Smith, and Lingpeng Kong. “Random Feature Attention”。载于:The International Conference on Learning Representations (ICLR)。2021。
[74] Clément Pernet. “Computing with Quasiseparable Matrices”。载于:Proceedings of the ACM on International Symposium on Symbolic and Algebraic Computation。2016,第389-396页。
[75] Clément Pernet, Hippolyte Signargout, and Gilles Villard. “Exact computations with quasiseparable matrices”。载于:arXiv preprint arXiv:2302.04515 (2023)。
[76] Clément Pernet and Arne Storjohann. “Time and space efficient generators for quasiseparable matrices”。载于:Journal of Symbolic Computation 85 (2018),第224-246页。
[77] Michael Poli, Stefano Massaroli, Eric Nguyen, Daniel Y Fu, Tri Dao, Stephen Baccus, Yoshua Bengio, Stefano Ermon, and Christopher Ré. “Hyena Hierarchy: Towards Larger Convolutional Language Models”。载于:The International Conference on Machine Learning (ICML)。2023。
[78] Hadi Pouransari, Chun-Liang Li, Jen-Hao Rick Chang, Pavan Kumar Anasosalu Vasu, Cem Koc, Vaishaal Shankar, and Oncel Tuzel. “Dataset Decomposition: Faster LLM Training with Variable Sequence Length Curriculum”。载于:arXiv preprint arXiv:2405.13226 (2024)。
[79] Ofir Press, Noah Smith, and Mike Lewis. “Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation”。载于:International Conference on Learning Representations。2022。
[80] Zhen Qin, Xiaodong Han, Weixuan Sun, Bowen He, Dong Li, Dongxu Li, Yuchao Dai, Lingpeng Kong, and Yiran Zhong. “Toeplitz Neural Network for Sequence Modeling”。载于:The International Conference on Learning Representations (ICLR)。2023。
[81] Zhen Qin, Xiaodong Han, Weixuan Sun, Dongxu Li, Lingpeng Kong, Nick Barnes, and Yiran Zhong. “The devil in linear transformer”。载于:arXiv preprint arXiv:2210.10340 (2022)。
[82] Zhen Qin, Dong Li, Weigao Sun, Weixuan Sun, Xuyang Shen, Xiaodong Han, Yunshen Wei, Baohong Lv, Xiao Luo, Yu Qiao, et al. “TransNormerLLM: A Faster and Better Large Language Model with Improved TransNormer”。载于:arXiv preprint arXiv:2307.14995 (2023)。
[83] Zhen Qin, Weixuan Sun, Hui Deng, Dongxu Li, Yunshen Wei, Baohong Lv, Junjie Yan, Lingpeng Kong, and Yiran Zhong. “CosFormer: Rethinking Softmax in Attention”。载于:The International Conference on Learning Representations (ICLR)。2022。
[84] Zhen Qin, Songlin Yang, Weixuan Sun, Xuyang Shen, Dong Li, Weigao Sun, and Yiran Zhong. “HGRN2: Gated Linear RNNs with State Expansion”。载于:arXiv preprint arXiv:2404.07904 (2024)。
[85] Zhen Qin, Songlin Yang, and Yiran Zhong. “Hierarchically Gated Recurrent Neural Network for Sequence Modeling”。载于:Advances in Neural Information Processing Systems 36 (2023)。
[86] Ali Rahimi and Benjamin Recht. “Random Features for Large-Scale Kernel Machines”。载于:Advances in Neural Information Processing Systems (NeurIPS) 20 (2007)。
[87] Prajit Ramachandran, Barret Zoph, and Quoc V Le. “Swish: A Self-gated Activation Function”。载于:arXiv preprint arXiv:1710.05941 7.1 (2017),第5页。
[88] Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. “Winogrande: An Adversarial Winograd Schema Challenge at Scale”。载于:Communications of the ACM 64.9 (2021),第99-106页。
[89] Imanol Schlag, Kazuki Irie, and Jürgen Schmidhuber. “Linear Transformers are Secretly Fast Weight Programmers”。载于:The International Conference on Machine Learning (ICML)。PMLR。2021,第9355-9366页。
[90] Noam Shazeer. “Fast Transformer Decoding: One Write-head is All You Need”。载于:arXiv preprint arXiv:1911.02150 (2019)。
[91] Sam Shleifer, Jason Weston, and Myle Ott. “NormFormer: Improved Transformer Pretraining with Extra Normalization”。载于:arXiv preprint arXiv:2110.09456 (2021)。
[92] Mohammad Shoeybi, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism”。载于:arXiv preprint arXiv:1909.08053 (2019)。
[93] Jimmy TH Smith, Andrew Warrington, and Scott W Linderman. “Simplified State Space Layers for Sequence Modeling”。载于:The International Conference on Learning Representations (ICLR)。2023。
[94] Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, and Yunfeng Liu. “Roformer: Enhanced Transformer with Rotary Position Embedding”。载于:arXiv preprint arXiv:2104.09864 (2021)。
[95] Yutao Sun, Li Dong, Shaohan Huang, Shuming Ma, Yuqing Xia, Jilong Xue, Jianyong Wang, and Furu Wei. “Retentive network: A successor to transformer for large language models”。载于:arXiv preprint arXiv:2307.08621 (2023)。
[96] Yi Tay, Mostafa Dehghani, Dara Bahri, and Donald Metzler. “Efficient Transformers: A Survey”。载于:ACM Computing Surveys 55.6 (2022),第1-28页。
[97] Chameleon Team. “Chameleon: Mixed-Modal Early-Fusion Foundation Models”。载于:arXiv preprint arXiv:2405.09818 (2024)。
[98] Anna Thomas, Albert Gu, Tri Dao, Atri Rudra, and Christopher Ré. “Learning Compressed Transforms with Low Displacement Rank”。载于:Advances in Neural Information Processing Systems (NeurIPS)。2018,第9052-9060页。
[99] Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. “MLP-Mixer: An All-MLP Architecture for Vision”。载于:Advances in Neural Information Processing Systems (NeurIPS) 34 (2021),第24261-24272页。
[100] Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. “Llama: Open and Efficient Foundation Language Models”。载于:arXiv preprint arXiv:2302.13971 (2023)。
[101] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. “Llama 2: Open foundation and fine-tuned chat models”。载于:arXiv preprint arXiv:2307.09288 (2023)。
[102] Raf Vandebril, M Van Barel, Gene Golub, and Nicola Mastronardi. “A bibliography on semiseparable matrices”。载于:Calcolo 42 (2005),第249-270页。
[103] Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Lukasz Kaiser 和 Illia Polosukhin。“Attention Is All You Need”。载于:Advances in Neural Information Processing Systems (NeurIPS)。2017。
[104] Shida Wang 和 Beichen Xue。“State-space Models with Layer-wise Nonlinearity are Universal Approximators with Exponential Decaying Memory”。载于:arXiv preprint arXiv:2309.13414 (2023)。
[105] Sinong Wang、Belinda Z Li、Madian Khabsa、Han Fang 和 Hao Ma。“Linformer: Self-attention with Linear Complexity”。载于:arXiv preprint arXiv:2006.04768 (2020)。
[106] Guangxuan Xiao、Yuandong Tian、Beidi Chen、Song Han 和 Mike Lewis。“Efficient Streaming Language Models with Attention Sinks”。载于:The International Conference on Learning Representations (ICLR)。2024。
[107] Yunyang Xiong、Zhanpeng Zeng、Rudrasis Chakraborty、Mingxing Tan、Glenn Fung、Yin Li 和 Vikas Singh。“Nyströmformer: A Nyström-Based Algorithm for Approximating Self-Attention”。载于:Proceedings of the AAAI Conference on Artificial Intelligence。第 35 卷。2021。
[108] Songlin Yang、Bailin Wang、Yikang Shen、Rameswar Panda 和 Yoon Kim。“Gated Linear Attention Transformers with Hardware-Efficient Training”。载于:The International Conference on Machine Learning (ICML)。2024。
[109] Rowan Zellers、Ari Holtzman、Yonatan Bisk、Ali Farhadi 和 Yejin Choi。“HellaSwag: Can a Machine Really Finish Your Sentence?”载于:Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics。2019。
[110] Jinle Zeng, Min Li, Zhihua Wu, Jiaqi Liu, Yuang Liu, Dianhai Yu, and Yanjun Ma. “Boosting distributed training performance of the unpadded bert model”。载于:arXiv preprint arXiv:2208.08124 (2022)。
[111] Shuangfei Zhai, Walter Talbott, Nitish Srivastava, Chen Huang, Hanlin Goh, Ruixiang Zhang, and Josh Susskind. “An Attention Free Transformer”。载于:arXiv preprint arXiv:2105.14103 (2021)。
[112] Yujia Zhai, Chengquan Jiang, Leyuan Wang, Xiaoying Jia, Shang Zhang, Zizhong Chen, Xin Liu, and Yibo Zhu. “Bytetransformer: A high- performance transformer boosted for variable- length inputs”。载于:2023 IEEE International Parallel and Distributed Processing Symposium (IPDPS)。IEEE。2023,第 344- 355 页。
[113] Michael Zhang, Kush Bhatia, Hermann Kumbong, and Christopher Ré. “The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry”。载于:The International Conference on Learning Representations (ICLR)。2024。
[114] Lin Zheng, Chong Wang, and Lingpeng Kong. “Linear complexity randomized self- attention mechanism”。载于:International Conference on Machine Learning。PMLR。2022,第 27011- 27041 页。
A 术语表
| 符号 | 描述 | 定义 |
| T | 时间轴或目标序列轴 | 定义2.1 |
| S | 源序列轴(在注意力中) | 公式(9) |
| D | 模型维度或d_model | 定义7.1 |
| N | 状态/特征维度或d_state | 公式(2)和(9) |
| P | 头维度或d_head | 定义2.1 |
| H | 头数或n_head | 定义7.1 |
| M | 序列变换矩阵 | 定义2.3 |
| A | 离散SSM循环(状态)矩阵 | 公式(2) |
| B | 状态空间模型输入投影(扩展)矩阵 | 公式(2) |
| C | 状态空间模型输出投影(收缩)矩阵 | 公式(2) |
| X | 输入矩阵(形状(T,P)) | 公式(2)和(9) |
| Y | 输出矩阵(形状(T,P)) | 公式(2)和(9) |
| Q | 注意力查询矩阵 | 公式(9) |
| K | 注意力键矩阵 | 公式(9) |
| V | 注意力值矩阵 | 公式(9) |
| G | 注意力Gram矩阵 | QK^T(或CB^T) |
| L | (结构化)掩码矩阵(因果设置下为下三角) | 定义4.2 |
B 标量 SSM 扫描的高效算法(1-SS 乘法)
在本节中,我们通过结构化矩阵分解的视角,详细阐述用于计算标量 SSM 扫描的各种算法。标量 SSM 扫描定义为在 (即 为标量)情况下计算离散 SSM (7) 的循环部分。这通常用于以循环方式计算 SSM;特别地,在 为对角结构的结构化 SSM 情形下会归结为这一操作,例如 S5 (J. T. Smith, Warrington, and Linderman 2023) 和 S6 (Gu and Dao 2023) 模型中。
本节的目标是支持本文的一个核心主题,即序列模型的高效算法可以被视为结构化矩阵乘法算法。我们在此展示的各种矩阵分解思想,既与推导快速 SSM 算法(第 6 节)所用的思想相关,也直接作为子程序使用。
B.1 问题定义
令 和 为标量序列。标量 SSM 扫描定义为
这里 可以是表示 SSM 递推的前一隐藏状态的任意值;除非另有说明,我们假设 。
我们也将式 (21) 称为 cumprodsum(累积乘积和)。注意,当 为加法单位元时,cumprodsum 退化为 cumprod(累积乘积);当 为乘法单位元时,它退化为 cumsum(累积和)。最后,注意在向量化形式中,我们可以写为
换言之,这不过是由一个 1-SS 矩阵 进行的矩阵-向量乘积。
因此,对于这一基本原语操作,我们有三种彼此等价的看待方式:
- 一个(标量)SSM 扫描。- 一个 cumprodsum。- 一个 1-SS 矩阵-向量乘法。
B.2 经典算法
我们首先描述计算 SSM 扫描 (21) 的两种经典方式,先前工作曾使用过它们。
B.2.1 顺序递推
循环模式简单地一次一个时间步 地计算 (21)。从 1-SS 乘法的视角看,这也在第 3.4.1 节中描述过。
B.2.2 并行结合扫描
其次,一个重要观察是,该递推可以转化为结合扫描 (E. Martin and Cundy 2018; J. T. Smith, Warrington, and Linderman 2023)。这一事实并不完全显而易见。例如,S5 定义了正确的结合扫描算子,然后通过机械计算证明了该算子的结合性。
要看出这可以用结合扫描计算,一个稍更清晰的方法是将多项递推转化为大小为 2 而非 1 的隐藏状态上的单项递推:
那么计算所有 就等同于取这些 矩阵的累积乘积。由于矩阵乘法是结合的,这可以用结合扫描计算。结合二元算子就是这些特定矩阵上的矩阵乘法:
令第一行相等,就得到与 S5 所定义的相同的结合扫描算子:
结合扫描之所以重要,是因为它们可以使用分治算法并行化 (Blelloch 1990)。我们省略该算法的细节,转而展示整个结合 SSM 扫描算法可以通过矩阵分解从头推导出来(附录 B.3.5)。
B.3 通过结构化矩阵分解的高效算法
我们讨论几种用于计算 SSM 扫描的算法,全部通过寻找 1-SS 矩阵 的结构化矩阵分解这一视角。这些算法或计算模式包括:一种膨胀模式,其中信息每次传播 1、2、4、8、…… 步。一种状态传递模式,其中信息按块向前传播。一种完全循环模式,其一次递增一步,是状态传递模式的特殊情况。一种块分解并行模式,其中 被划分为层次化块。一种扫描模式,其中 被划分为等大小的块并递归归约。
B.3.1 膨胀模式
该模式以涉及递增“步幅”的特定方式对 1-SS 矩阵进行分解。最好通过一个具体例子来说明:
B.3.2 状态传递(分块)模式
这种模式可以看作标准循环模式的推广:它不是一步一步地向前传递循环状态 ,而是在任意长度 的块上计算答案,并将状态穿过该块传递。这也可以从 1-SS 矩阵的简单块分解中推导出来。
注9。虽然我们称之为“状态传递”,以指代状态如何从一个局部片段传递到另一个局部片段,但这与相关模型提出的“分块”算法有关(Y. Sun et al. 2023; Yang et al. 2024)。
考虑以“块”的方式计算 :对于某个索引 ,我们希望计算 ,即直到索引 的输出,并找到一种方法将问题归约为索引 上的较小问题。我们将 写为
1. 使用任意所需方法(即本节中用于 1-SS 乘法的任意方法)计算答案的左半部分 。
2. 计算最终状态 。
3. 将状态推进一步以修改 。
4. 使用任意所需方法计算答案的右半部分 。
换句话说,我们将左子问题作为黑盒计算,将其最终状态传递给右问题,并将右子问题作为黑盒计算。
这种方法的有用性来自更复杂的设置,例如一般的 - 半可分情形,以及当输入 具有额外的“批次”维度时(换言之,这是矩阵-矩阵乘法而不是矩阵-向量乘法)。在这种情况下,我们可以对各个块(对应于用 和 进行的 MM)使用一种替代算法,该算法不会具体生成完整的隐藏状态 。相反,我们跳过隐藏状态,以另一种方式直接计算最终状态 ,然后将状态“传递”到下一个块。
复杂度。这种方法可以非常节省工作量,因为步骤2-3只花费常数时间。因此,假设两个子问题(步骤1和4)都是线性时间,则整个方法花费线性时间。
缺点是这也是顺序的。
B.3.3 完全循环模式
注意,完全循环模式——其中循环一次一步地演化(21)——只是块大小 的状态传递模式的一个实例。
B.3.4 (并行)块分解模式
这使用与状态传递模式相同的矩阵分解,但以不同的顺序计算子问题,从而以计算量换取并行化。
像往常一样,我们将 写为
关键观察再次在于, 的左下象限是秩1的。除了直接检查之外,另一种看出这一点的方法是使用右端项,观察到它的左下象限是一个平凡的秩1矩阵(除右上角为外全为0),并使用Woodbury求逆公式看出左端项的左下角也必须是秩1的。这也提供了一种推导秩1分解的方法,该分解可以通过检查验证:
第二个观察是,该矩阵是自相似的:任何主子矩阵都具有相同的形式。特别地,左上和右下象限都是1-SS矩阵。
这提供了一种执行与的矩阵乘法的简便方法:对两个半部分(即左上和右下)并行递归,然后处理左下子矩阵。分治算法中的这个“组合”步骤很容易,因为该子矩阵是秩1的。这引出了一个并行算法。
复杂度。与状态传递算法一样,该方法使用秩结构半可分矩阵的相同块分解。不同之处在于我们并行地对两个子问题递归,而状态传递算法先处理左子问题再处理右子问题。这将算法的深度/跨度从线性降低到。代价是组合步骤(处理秩1左下子矩阵)需要线性而非常数的工作量,因此总工作量为而非线性。
另请注意,在递归中,我们可以在任何时候停止,并以任何其他方式计算子问题。这是SSD算法(第6节)背后的主要思想,其中我们在小子问题上切换到对偶二次注意力公式。
B.3.5 关联扫描模式
状态传递(分块)算法具有线性工作量,但也涉及顺序操作。
块矩阵归约和膨胀模式是可并行的:它们具有的深度/跨度。然而,它们做额外的工作()。
如附录B.2.2所述,有一种算法通过利用关联扫描(也称为前缀扫描)算法(Baker et al. 1996)同时实现深度和工作量。该算法最容易从SSM扫描或cumprodsum视角看出,即便如此也并不显然:它需要单独推导一个关联算子(22),然后将并行/关联/前缀扫描算法作为黑盒使用(Blelloch 1990)。
这里我们展示,实际上可以通过利用不同的矩阵分解来推导这种并行扫描:
阶段2。现在考虑将矩阵严格下三角部分中的每个块分解为秩为1的矩阵。注意,右侧的每个行向量都与其所在列的对角块中的底行向量相同:特别是和这些行。
因此,我们已经从阶段1得到了这些的答案,即阶段1中所有个子问题的第二个元素。如果我们称这个元素数组为(大小为的一半),那么我们需要将乘以由生成的1-SS矩阵。
阶段3。最后,阶段2的每个答案都可以通过乘以左侧列向量来广播为两个最终答案:特别是和向量。
注意,这可以通过对索引进行一些偏移一位的调整来稍作修改。看待该算法的另一种等价方式是将其视为三步矩阵分解
IUE(VUI、VUCI、AIU RCI、OULCI)。
反过来,这些蕴含了状态空间模型的封闭性质。
例如,加法性质表明,两个并行SSM模型相加仍然是一个SSM。乘法性质表明,将两个SSM顺序组合或链接起来仍然可以被视为一个SSM,其总状态大小是可加的——这是一个有些非平凡的事实。
最后,逆性质可以让我们将SSM与其他类型的模型联系起来。例如,人们可以注意到带状矩阵是半可分离的,因此它们的逆也是半可分离的。(事实上,半可分离结构族通常是由对带状矩阵求逆所启发的(Vandebril et al. 2005))。此外,半可分离矩阵的快速递推性质可以被视为其逆为带状矩阵的一个推论。
注11. 1-SS矩阵是简单递推(7)这一事实,等价于1-SS矩阵的逆是2-带状矩阵这一事实:
因此 ,或者
或者逐元素地,
反过来,我们也使用这些封闭性结果来证明自回归结构化注意力(在某些假设下)必定是SSM,从而使我们能够证明包括注意力变体在内的更一般的高效序列模型族可以归约为状态空间模型(附录C.2)。
C.2 自回归掩码注意力是半可分离结构化注意力
我们证明第5.2节中的定理5.2。在第4.3节中,我们将结构化注意力定义为掩码注意力的一种广泛推广,其中效率性质(即核注意力的线性时间形式)被抽象为结构化矩阵乘法的效率。然而,除了计算效率之外,标准线性注意力(Katharopoulos et al. 2020)还具有两个重要性质。首先,它是因果的,这对于自回归建模等设置是必需的。此外,它具有高效的自回归生成能力。换句话说,自回归步骤的成本——即在已经看到并预处理了 的情况下,看到 时计算输出 的增量成本——只需要常数时间。
在这里,我们刻画了SMA的哪些实例具有高效自回归。
在SMA框架中,因果性等价于掩码 是下三角矩阵这一约束。
刻画具有高效自回归的 矩阵空间更为困难。我们将使用自回归过程的狭义技术定义,其精神来自时间序列文献中的经典定义(例如ARIMA过程(Box et al. 2015))。
定义 C.2。我们将阶为 的自回归变换 定义为这样一种变换:其中每个输出 仅依赖于当前输入和最近 个输出:
注意, 为 cumsum 矩阵的情形是一个特例,此时 ,因而 。根据这一定义,刻画高效自回归线性变换的空间便可由半可分矩阵的性质推出。定理 C.3 对定理 5.2 进行了形式化并加以证明。
定理 C.3。设 为阶为 的高效自回归变换。则 是一个阶为 的状态空间模型。
证明。设 为输入序列和输出序列,使得 。重新整理定义 (23),
对 进行向量化,这可以表示为一个矩阵变换
对角矩阵可以移到左侧并合并进 系数矩阵中,该矩阵仍是一个 带下三角矩阵。但我们同时还有 ,因此 是该矩阵的逆。
接下来,注意根据半可分离性的秩刻画(定义 3.1), 带矩阵是 半可分的。因此,根据命题 C.1,逆矩阵 至多是 半可分的。由于带矩阵的额外结构,可以得到略强一些的界 。最后,将 刻画为阶为 的状态空间模型可由定理 3.5 推出。
换言之,高效自回归注意力就是半可分 SMA。
D 实验细节
D.1 MQAR 细节
我们使用 Based(Arora、Eyuboglu、Zhang 等,2024)中引入的该任务的更难版本,其中非查询/键/值的 token 被替换为随机 token。我们还使用了更多的键值对、更长的序列以及比先前工作通常使用的 MQAR 变体更小的模型规模,所有这些都使任务更加困难。
对于每个序列长度 ,我们使用 个键值对。总词表大小为 8192。
我们使用一种课程训练形式,其中训练按 个键值对循环遍历数据集,每个数据集有 个样本,每个数据集总共进行 8 个 epoch(总共 个样本)。总批量大小为 个 token(例如对于 ,批量大小为 256)。
所有方法均使用 2 层及默认设置;注意力基线额外接收位置嵌入。对于每种方法,我们在模型维度 和学习率 上进行扫描。我们使用线性衰减计划,在每个 epoch 下降(例如最后一个 epoch 的学习率将是最大/起始学习率的 )。
D.2 缩放定律细节
所有模型均在 Pile 上训练。对于缩放定律实验,我们使用 GPT2 分词器。
模型规模。表 9 规定了我们遵循 GPT3(Brown et al. 2020)用于缩放定律的模型规模。首先,我们将 1.3B 模型的批量大小从 1M token 改为 0.5M token 以保持统一。其次,我们调整了训练步数和总 token 数,以大致匹配 Chinchilla 缩放定律(Hoffmann et al. 2022),该定律规定训练 token 数应随模型规模成比例增加。
训练配方。所有模型均使用 AdamW 优化器,配置为
- 梯度裁剪值 1.0- 权重衰减 0.1- 无 dropout- 线性学习率预热,采用余弦衰减
| 参数 | n_layers | d_model | n_heads / d_head | 训练步数 | 学习率 | 批大小 | Token 数 |
| 125M | 12 | 768 | 12 / 64 | 4800 | 6e-4 | 0.5M tokens | 2.5B |
| 350M | 24 | 1024 | 16 / 64 | 13500 | 3e-4 | 0.5M tokens | 7B |
| 760M | 24 | 1536 | 16 / 96 | 29000 | 2.5e-4 | 0.5M tokens | 15B |
| 1.3B | 24 | 2048 | 32 / 64 | 50000 | 2e-4 | 0.5M tokens | 26B |
默认情况下,峰值学习率为 GPT3 规范。
与 GPT3 配方相比,我们使用“改进配方”,其灵感来自 PaLM(Chowdhery et al. 2023)和 LLaMa(Touvron, Lavril, et al. 2023)等流行大型语言模型所采用的更改。这些包括:
- 线性学习率预热,采用余弦衰减至 ,峰值为 GPT3 值的
- 无线性偏置项
- 使用 RMSNorm 代替 LayerNorm
- AdamW 超参数 (GPT3 值)而非 PyTorch 默认的
D.3 下游评估细节
为了评估完全训练后的下游性能,我们在 Pile 上使用 GPT- NeoX(Black et al. 2022)分词器对 Mamba- 2 进行 300B token 的训练。
我们使用与缩放实验相同的超参数,但 1.3B 和 2.7B 模型的批量大小为 1M。对于 2.7B 模型,我们还遵循 GPT3 规范(32 层,维度 2560)。
对于所有模型,我们使用相应 GPT3 模型学习率的 5 倍。
对于下游评估,我们使用 EleutherAI 的 LM 评估工具(L. Gao, Tow, et al. 2021),在与 Mamba(Gu and Dao 2023)相同的任务上,并额外增加一个任务:
- LAMBADA(Paperno et al. 2016)
- HellaSwag(Zellers 等,2019)
- PIQA(Bisk 等,2020)
- ARC-challenge(P. Clark 等,2018)
- ARC-easy:ARC-challenge 的一个简单子集
- WinoGrande(Sakaguchi 等,2021)
- OpenBookQA(Mihaylov 等,2018)
D.4 消融细节
(Re)Based 细节。我们在第 9.4.3 节中的消融考虑了 Based(Arora、Eyuboglu、Zhang 等,2024)和 ReBased(Aksenov 等,2024)模型。
Based 用二次泰勒展开 来近似 exp 核,这可以通过特征映射
来实现。 ReBased 提出使用更简单的特征映射 ,其对应于核变换 ,但还会事先应用层归一化。我们将层归一化视为对我们默认 Swish 激活的一种替代非线性激活,并对这些组合进行了消融。
| 模型 | TOKEN。 | PILE PPL ↓ | LAMBADA PPL ↓ | LAMBADA ACC ↑ | HELLASWAG ACC ↑ | PIQA ACC ↑ | ARC-E ACC ↑ | ARC-C ACC ↑ | WINOGRANDE ACC ↑ | OPENBOOKQA ACC ↑ | 平均 ACC ↑ |
| Hybrid H3-130M | GPT2 | — | 89.48 | 25.8 | 31.7 | 64.2 | 44.4 | 24.2 | 50.6 | 27.0 | 38.2 |
| Pythia-160M | NeoX | 29.64 | 38.10 | 33.0 | 30.2 | 61.4 | 43.2 | 24.1 | 51.9 | 29.2 | 39.0 |
| Mamba-130M | NeoX | 10.56 | 16.07 | 44.3 | 35.2 | 64.5 | 48.0 | 24.2 | 51.9 | 28.8 | 42.4 |
| Mamba-2-130M | NeoX | 10.48 | 16.86 | 43.9 | 35.3 | 64.9 | 47.4 | 24.2 | 52.1 | 30.6 | 42.6 |
| Hybrid H3-360M | GPT2 | — | 12.58 | 48.0 | 41.5 | 68.1 | 51.4 | 24.7 | 54.1 | 31.6 | 45.6 |
| Pythia-410M | NeoX | 9.95 | 10.84 | 51.4 | 40.6 | 66.9 | 52.1 | 24.6 | 53.8 | 30.0 | 45.6 |
| Mamba-370M | NeoX | 8.28 | 8.14 | 55.6 | 46.5 | 69.5 | 55.1 | 28.0 | 55.3 | 30.8 | 48.7 |
| Mamba-2-370M | NeoX | 8.21 | 8.02 | 55.8 | 46.9 | 70.5 | 54.9 | 26.9 | 55.7 | 32.4 | 49.0 |
| Pythia-1B | NeoX | 7.82 | 7.92 | 56.1 | 47.2 | 70.7 | 57.0 | 27.1 | 53.5 | 31.4 | 49.0 |
| Mamba-790M | NeoX | 7.33 | 6.02 | 62.7 | 55.1 | 72.1 | 61.2 | 29.5 | 56.1 | 34.2 | 53.0 |
| Mamba-2-780M | NeoX | 7.26 | 5.86 | 61.7 | 54.9 | 72.0 | 61.0 | 28.5 | 60.2 | 36.2 | 53.5 |
| GPT-Neo 1.3B | GPT2 | — | 7.50 | 57.2 | 48.9 | 71.1 | 56.2 | 25.9 | 54.9 | 33.6 | 49.7 |
| Hybrid H3-1.3B | GPT2 | — | 11.25 | 49.6 | 52.6 | 71.3 | 59.2 | 28.1 | 56.9 | 34.4 | 50.3 |
| OPT-1.3B | OPT | — | 6.64 | 58.0 | 53.7 | 72.4 | 56.7 | 29.6 | 59.5 | 33.2 | 51.9 |
| Pythia-1.4B | NeoX | 7.51 | 6.08 | 61.7 | 52.1 | 71.0 | 60.5 | 28.5 | 57.2 | 30.8 | 51.7 |
| RWKV4-1.5B | NeoX | 7.70 | 7.04 | 56.4 | 52.5 | 72.4 | 60.5 | 29.4 | 54.6 | 34.0 | 51.4 |
| Mamba-1.4B | NeoX | 6.80 | 5.04 | 65.0 | 59.1 | 74.2 | 65.5 | 32.8 | 61.5 | 36.4 | 56.4 |
| Mamba-2-1.3B | NeoX | 6.66 | 5.02 | 65.7 | 59.9 | 73.2 | 64.3 | 33.3 | 60.9 | 37.8 | 56.4 |
| GPT-Neo 2.7B | GPT2 | — | 5.63 | 62.2 | 55.8 | 72.1 | 61.1 | 30.2 | 57.6 | 33.2 | 53.2 |
| Hybrid H3-2.7B | GPT2 | — | 7.92 | 55.7 | 59.7 | 73.3 | 65.6 | 32.3 | 61.4 | 33.6 | 54.5 |
| OPT-2.7B | OPT | — | 5.12 | 63.6 | 60.6 | 74.8 | 60.8 | 31.3 | 61.0 | 35.2 | 55.3 |
| Pythia-2.8B | NeoX | 6.73 | 5.04 | 64.7 | 59.3 | 74.0 | 64.1 | 32.9 | 59.7 | 35.2 | 55.7 |
| RWKV4-3B | NeoX | 7.00 | 5.24 | 63.9 | 59.6 | 73.7 | 67.8 | 33.1 | 59.6 | 37.0 | 56.4 |
| Mamba-2.8B | NeoX | 6.22 | 4.23 | 69.2 | 66.1 | 75.2 | 69.7 | 36.3 | 63.5 | 39.6 | 59.9 |
| Mamba-2-2.7B | NeoX | 6.09 | 4.10 | 69.7 | 66.6 | 76.4 | 69.6 | 36.4 | 64.0 | 38.8 | 60.2 |
| GPT-J-6B | GPT2 | — | 4.10 | 68.3 | 66.3 | 75.4 | 67.0 | 36.6 | 64.1 | 38.2 | 59.4 |
| OPT-6.7B | OPT | — | 4.25 | 67.7 | 67.2 | 76.3 | 65.6 | 34.9 | 65.5 | 37.4 | 59.2 |
| Pythia-6.9B | NeoX | 6.51 | 4.45 | 67.1 | 64.0 | 75.2 | 67.3 | 35.5 | 61.3 | 38.0 | 58.3 |
| RWKV4-7.4B | NeoX | 6.31 | 4.38 | 67.2 | 65.5 | 76.1 | 67.8 | 37.5 | 61.0 | 40.2 | 59.3 |
请注意,由于这些方法会扩展特征维度,我们必须投影到更小的 维度;在表 7 中,对 130M 模型使用状态大小 ,对 380M 模型使用 。对于(Re)Based 方法,我们分别在应用其特征映射之前投影到 8 和 16 维;在 130M 模型的情况下,这导致 ReBased 的总状态大小为 ,Based 的总状态大小为 。由于 和 投影更小,这些方法使用的参数更少,我们相应地调整了层数。