
模型不再凭记忆猜,而是在推理途中自己发起搜索、把结果接回上下文,用强化学习训练。2025 年 COLM 论文,全文免费在线阅读。
Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning
Search-R1:训练大语言模型通过强化学习进行推理并利用搜索引擎
Bowen Jin , Hansi Zeng , Zhenrui Yue , Jinsung Yoon , Sercan Ö. Arik , Dong Wang , Hamed Zamani , Jiawei Han
伊利诺伊大学厄巴纳-香槟分校计算机科学系
马萨诸塞大学阿默斯特分校智能信息检索中心
Google Cloud AI Research
{bowenj4, zhenrui3, dwang24, hanj}@illinois.edu, {hzeng, zamani}@cs.umass.edu {jinsungyoon, soarik}@google.com
摘要
高效获取外部知识和最新信息对于大语言模型(LLM)进行有效推理和文本生成至关重要。提示具备推理能力的高级LLM在推理过程中使用搜索引擎往往并非最优,因为LLM可能并不完全具备如何以最优方式与搜索引擎交互的能力。本文提出SEARCH-R1,这是对推理框架中强化学习(RL)的扩展,其中LLM学习在逐步推理过程中自主生成(多个)搜索查询,并进行实时检索。SEARCH-R1通过多轮搜索交互优化LLM推理轨迹,利用检索token掩码实现稳定的RL训练,并采用简单的基于结果的奖励函数。在七个问答数据集上的实验表明,在相同设置下,SEARCH-R1相较各种RAG基线方法分别提升了(Qwen2.5-7B)和(Qwen2.5-3B)的性能。本文进一步对检索增强推理中的RL优化方法、LLM选择和响应长度动态提供了实证见解。代码和模型检查点可在https://github.com/PeterGriffinJin/Search-R1获取。
1 引言
大语言模型(LLM)在自然语言理解和生成方面已展现出卓越的能力(Hendrycks et al., 2020; Clark et al., 2018)。尽管取得了这些成就,LLM在面临复杂推理任务(Wei et al., 2022)以及从外部来源检索最新信息(Jin et al., 2024)时仍常常遇到挑战。解决这些局限性需要整合高级推理能力(Huang & Chang, 2022)以及与搜索引擎有效交互以最佳利用外部最新信息的能力(Schick et al., 2023)。
将LLM与搜索引擎集成的现有方法通常分为两类:(1)检索增强生成(RAG)(Gao et al., 2023; Lewis et al., 2020);(2)将搜索引擎视为工具(Yao et al., 2023; Schick et al., 2023)。RAG模型通常基于LLM输入作为查询来检索段落,并将其纳入LLM的上下文以进行生成(Lewis et al., 2020)。这使LLM能够在回答问题时利用外部知识。尽管现有工作(Trivedi et al., 2022a)提示LLM进行多轮、多查询检索,但这种方法并非最优,因为LLM在训练中并未被优化以学习如何有效地与搜索引擎交互。或者,可以提示或训练LLM将工具(包括搜索引擎)作为其推理过程的一部分来使用(Qu et al., 2025; Trivedi et al., 2022a)。然而,基于提示的方法往往难以泛化,因为某些任务可能在LLM预训练期间未曾遇到。另一方面,基于训练的方法提供了更大的适应性,但由于其依赖大规模、高质量的标注轨迹以及搜索操作固有的不可微性(这使得基于端到端梯度下降的优化不适用),难以有效扩展(Schick et al., 2023; Asai et al., 2024)。
强化学习(RL)(Sutton et al., 1999; Kaelbling et al., 1996)已成为增强LLM推理能力的有力范式(Guo et al., 2025; Hou et al., 2025; Xie et al., 2025; Kumar et al., 2024)。值得注意的是,OpenAI-01(Jaech et al., 2024)和DeepSeek-R1(Guo et al., 2025)等模型利用RL技术(例如PPO(Schulman et al., 2017)和GRPO(Shao et al., 2024))通过从经验和反馈中学习来提升逻辑推理和问题解决能力。借助RL,即使仅基于结果奖励进行训练,模型也能学习复杂的推理能力,包括自我验证(Weng et al., 2022)和自我纠正(Kumar et al., 2024)。然而,将RL应用于搜索与推理场景面临三个关键挑战:(1)RL框架与稳定性——如何有效地将搜索引擎集成到LLM的RL方法中,同时确保稳定优化,尤其是在纳入检索上下文时,仍不明确。(2)多轮交错推理与搜索——理想情况下,LLM应能够进行迭代推理和搜索引擎调用,根据问题的复杂性动态调整检索策略。(3)奖励设计——为搜索和推理任务设计有效的奖励函数仍是一个基本挑战,因为简单的基于结果的奖励是否足以引导LLM学习有意义且一致的搜索行为尚不清楚。
为应对上述挑战,我们提出SEARCH-R1,这是一种新颖的RL框架,使LLM能够以与自身推理交错的方式与搜索引擎交互。具体而言,SEARCH-R1引入了以下关键创新:(1)我们将搜索引擎建模为环境的一部分,从而能够采样出将LLM token生成与搜索引擎检索交错的轨迹序列。SEARCH-R1兼容多种RL算法,包括PPO和GRPO,并且我们应用检索token掩码以确保稳定优化。(2)SEARCH-R1支持多轮检索与推理,当由<search>和</search> token显式触发时调用搜索。检索内容被包含在<information>和</information> token内,而LLM推理步骤被包裹在<think>和</think> token内。最终答案使用<answer>和</answer> token进行格式化,从而实现结构化、迭代式的决策。(3)我们采用简单的基于结果的奖励函数,避免了基于过程的奖励的复杂性。我们的结果表明,这种最小化的奖励设计在搜索与推理场景中是有效的。因此,SEARCH-R1可被视为DeepSeek-R1 Zero(Guo et al., 2025)的扩展,后者主要关注参数化推理,而SEARCH-R1引入了搜索增强的RL训练以增强检索驱动的决策。
总之,我们的主要贡献有三方面:
- 我们的工作分析了实施RL以改进LLM利用搜索引擎结果进行推理的挑战,并提供了见解。
- 我们提出SEARCH-R1,这是一种新颖的RL框架,支持LLM与搜索引擎的展开和直接优化,包括用于稳定RL训练的检索token掩码、支持复杂任务求解的多轮交错推理与搜索,以及有效的基于结果的奖励函数。
- 我们进行了系统性实验以证明SEARCH-R1的有效性,在相同的实验设置下(例如,相同的检索模型、训练数据和预训练LLM),两个LLM相较RAG基线分别取得了41%和20%的平均相对提升。此外,我们提供了关于推理与搜索设置中RL的见解,包括RL方法选择、不同LLM选择和响应长度研究。
2 相关工作
2.1 大语言模型与检索
尽管大语言模型(LLMs)(Zhao et al., 2023; Team, 2024; Achiam et al., 2023)在推理(Guo et al., 2025)和编程(Guo et al., 2024)能力方面表现卓越,但它们往往缺乏领域特定知识(Peng et al., 2023; Li et al., 2023),并且容易产生幻觉(Zhang et al., 2023)。为缓解这些局限,搜索引擎(Zhao et al., 2024)被广泛集成以提供外部信息。将搜索引擎与大语言模型集成主要有两种方式:(1)检索增强生成(RAG)(Gao et al., 2023)和(2)将搜索引擎视为工具(Schick et al., 2023)。RAG(Lewis et al., 2020; Yue et al., 2024; Xiong et al., 2025)通常遵循一轮检索加顺序生成的流水线,即搜索引擎根据输入查询获取相关信息,然后将其与查询拼接后输入大语言模型。然而,这种方式可能面临检索到无关信息(Jin et al., 2024)以及无法提供足够有用的上下文(Jiang et al., 2023)等挑战。另一种方法是搜索即工具(search-as-a-tool),即通过提示或微调使大语言模型与搜索引擎进行交互。IRCoT(Trivedi et al., 2022a)和ReAct(Yao et al., 2023)使用提示来引导迭代推理和搜索引擎调用,而Toolformer(Schick et al., 2023)则利用监督微调来增强搜索能力。然而,这类方法依赖于高质量的标注轨迹,而这类数据难以大规模获取。近期工作(Guo et al., 2025)表明,强化学习仅使用结果奖励即可使大语言模型发展出高级推理技能,但其在搜索引擎调用场景中的潜力仍有待探索。
2.2 大语言模型与强化学习
强化学习(RL)(Kaelbling et al., 1996)是一种学习范式,其中智能体通过与环境交互并以奖励形式接收反馈来学习做出序列决策,旨在最大化随时间累积的奖励(Sutton et al., 1999)。Ouyang et al.(2022)通过基于人类反馈的强化学习(RLHF)(Kaufmann et al., 2023)将强化学习引入大语言模型调优。该方法首先使用人类偏好数据训练一个奖励模型(Lambert et al., 2024),然后由该奖励模型指导基于强化学习的策略大语言模型调优,通常通过近端策略优化(PPO)实现。然而,PPO涉及多轮大语言模型优化,实施起来具有挑战性。为简化基于强化学习的调优,研究者提出了直接优化方法,如直接偏好优化(DPO)(Rafailov et al., 2023)和SimPO(Meng et al., 2024)。LeRet(Hsu et al., 2024)采用了类似的方法,训练大语言模型探索多样化的查询以增强信息检索的有效性。尽管这些方法具有计算效率优势,但它们存在离策略(off-policy)问题(Pang et al., 2024),且性能无法始终与纯强化学习方法相匹配。替代方案包括组相对策略优化(GRPO)(Shao et al., 2024),它通过从组得分中估计基线来消除对评论家模型的需求;以及RLOO(Ahmadian et al., 2024),它引入了一个简化的REINFORCE风格(Williams, 1992)优化框架。尽管取得了这些进展,将强化学习应用于大语言模型驱动的搜索引擎交互与推理仍在很大程度上尚未被探索。
3 搜索-R1
在以下各节中,我们呈现 SEARCH-R1 训练方法的详细设计,涵盖:(1) 扩展强化学习以利用搜索引擎;(2) 生成带有交错多轮搜索引擎调用的文本;(3) 训练模板;以及 (4) 奖励模型设计。
3.1 使用搜索引擎的强化学习
我们利用搜索引擎 将强化学习目标函数表述如下:
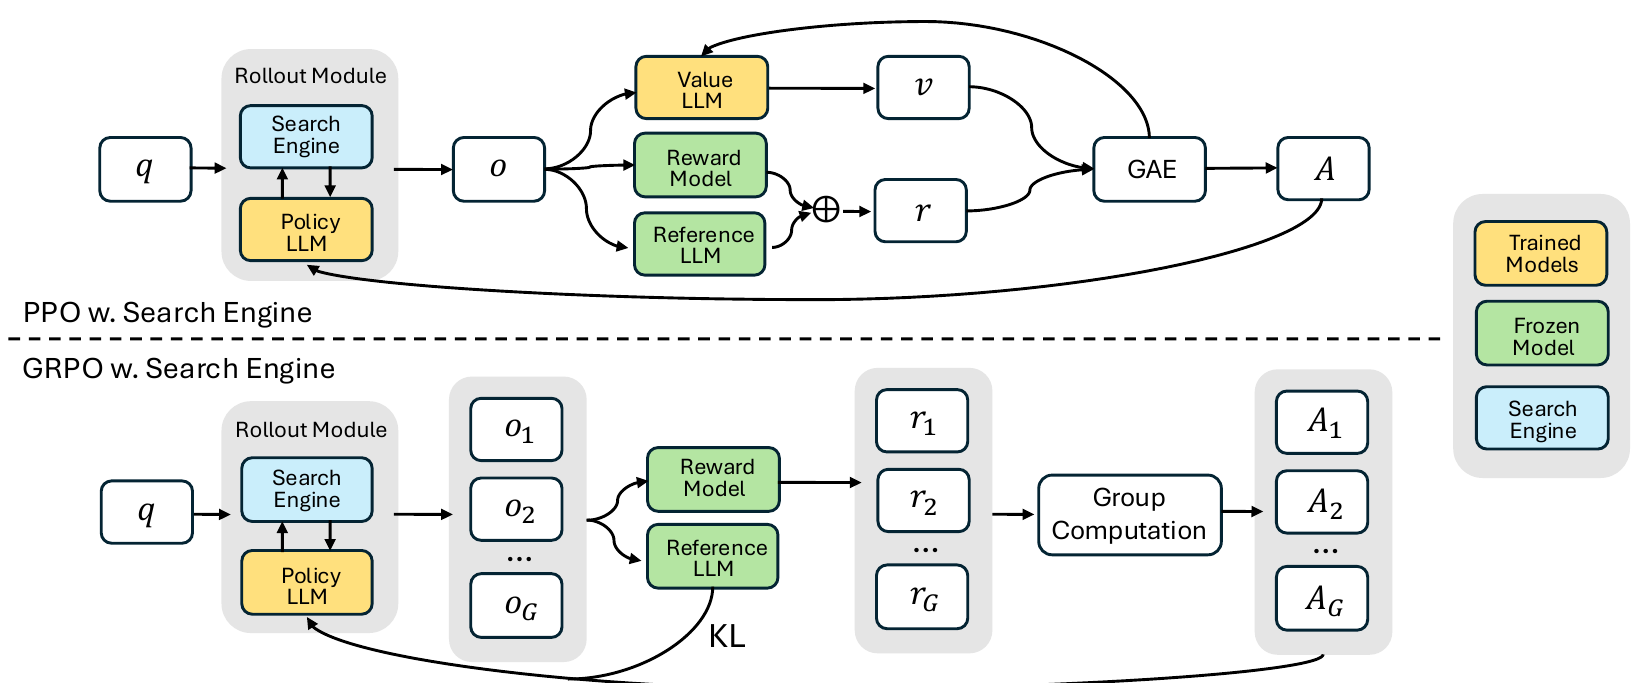
其中 是策略 LLM, 是参考 LLM, 是奖励函数, 是 KL 散度度量。 表示从数据集 中抽取的输入样本, 表示与搜索引擎调用结果交错生成的输出,其采样自参考策略 并从搜索引擎 中检索得到。与先前主要依赖策略 LLM 生成 rollout 序列的强化学习方法(Rafailov et al., 2023; Ouyang et al., 2022)不同,我们的框架通过 显式地整合了检索交错推理,其可视为 ,其中 表示交错式检索与推理。这使得在需要外部信息检索的推理密集型任务中能够进行更有效的决策。rollout 过程的示意图及对式 1 的解释见第 3.2 节和附录 A。
我们的方法建立在两种成熟的策略梯度强化学习方法之上:近端策略优化(PPO)(Schulman et al., 2017)和组相对策略优化(GRPO)(Shao et al., 2024; Guo et al., 2025),利用它们各自的优势来优化检索增强推理。
检索 token 的损失掩码。在 PPO 和 GRPO 中,token 级损失都是在整个 rollout 序列上计算的。在 SEARCH-R1 中,rollout 序列由 LLM 生成的 token 和来自外部段落的检索 token 共同组成。优化 LLM 生成的 token 能够增强模型与搜索引擎交互并执行推理的能力,而对检索 token 应用相同的优化可能会导致非预期的学习动态。为解决这一问题,我们为检索 token 引入了损失掩码,确保策略梯度目标仅在 LLM 生成的 token 上计算,将检索内容排除在优化过程之外。该方法在保持搜索增强生成灵活性的同时稳定了训练。
带搜索引擎的 PPO。近端策略优化(PPO)(Schulman et al., 2017)是一种流行的 actor-critic 强化学习方法,常用于 LLM(Ouyang et al., 2022)。对于涉及搜索引擎调用的推理场景,它通过最大化以下目标来优化 LLM:
其中 和 分别表示当前策略模型和先前策略模型。 是 token 损失掩码操作,当 是 LLM 生成的 token 时 ,当 是检索 token 时 。 是 PPO 中为稳定训练而引入的裁剪相关超参数。优势估计 使用广义优势估计(GAE)(Schulman et al., 2015)计算,基于未来奖励 和学习到的价值函数 。
带搜索引擎的 GRPO。为提高策略优化稳定性并避免额外的价值函数近似需求,Shao et al. (2024) 提出了组相对策略优化(GRPO)。GRPO 与 PPO 的不同之处在于,它利用多个采样输出的平均奖励作为基线,而不依赖于学习到的价值函数。具体而言,对于每个输入问题 ,GRPO 从参考策略 中采样一组响应 。然后通过最大化以下目标函数来优化策略模型:
其中 和 是超参数, 表示优势,基于每组内输出的相对奖励计算得到。该方法避免了在 计算中引入额外复杂度。此外,GRPO 不将 KL 散度作为惩罚项纳入奖励函数,而是通过将训练策略与参考策略之间的 KL 散度直接添加到损失函数中进行正则化。在计算 KL 散度损失 时同样应用了检索 token 掩码。
3.2 通过多轮搜索引擎调用进行生成
在本节中,我们描述 LLM 通过交错多轮搜索引擎调用进行响应生成的 rollout 过程,其表述为:。
我们的方法遵循一个迭代框架,其中LLM在文本生成和外部搜索引擎查询之间交替进行。具体而言,系统指令引导LLM在需要外部检索时,将其搜索查询封装在两个指定的搜索调用标记<search>和</search>之间。一旦在生成的序列中检测到这些标记,系统就提取搜索查询,查询搜索引擎,并检索相关结果。随后,检索到的信息被封装在特殊的检索标记<information>和</information>内,并追加到正在进行的 rollout 序列中,作为下一步生成的额外上下文。该过程迭代持续进行,直到满足以下条件之一:(1) 达到最大动作数,或 (2) 模型生成最终响应,该响应被封装在指定的答案标记<answer>和</answer>之间。完整的工作流程见算法1。
3.3 训练模板
为了训练SEARCH-R1,我们首先设计一个简单的模板,引导初始LLM遵循我们预定义的指令。如表1所示,该模板以迭代方式将模型的输出结构化为三个部分:首先是推理过程,然后是搜索引擎调用函数,最后是答案。我们有意将约束限制在这一结构格式上,避免任何内容特定的偏见,例如强制进行反思性推理和搜索引擎调用,或认可特定的问题解决方法。这确保了模型在RL过程中的自然学习动态保持可观察且无偏见。
回答给定的问题。每次获得新信息时,你必须先在<think>和</think>内进行推理。推理之后,如果你发现缺少某些知识,你可以通过<search> query </search>调用搜索引擎,它将在<information>和</information>之间返回搜索结果的顶部条目。你可以随意搜索多次。如果你发现不再需要进一步的外部知识,你可以直接在<answer>和</answer>内提供答案,而无需详细说明。例如,<answer> xxx </answer>。问题:question。
表1:SEARCH-R1的模板。在训练和推理期间,question将被替换为具体问题。要求:输入查询,策略模型,搜索引擎,最大动作预算。
确保:最终响应。
1: 初始化 rollout 序列
2: 初始化动作计数
3: while do
4: 初始化当前动作LLM rollout 序列
5: while True do
6: 生成响应标记
7: 将追加到 rollout 序列
8: if in [</search>,</answer>,<eos>] then break
9: end if
10: end while
11:
12: if <search> </search> 在 中被检测到 then
13: 提取搜索查询
14: 检索搜索结果
15: 将 插入到 rollout 中
16: else if <answer> </answer> 在 中被检测到 then
17: 返回最终生成的响应
18: else
19: 请求重新思考 action is not correct. Let me rethink."
20: end if
21: 增加动作计数
22: end while
23: 返回最终生成的响应
3.4 奖励建模
奖励函数作为主要的训练信号,引导强化学习中的优化过程。为了训练 SEARCH-R1,我们采用了一个仅由最终结果奖励组成的基于规则的奖励系统,该系统评估模型响应的正确性。例如,在事实推理任务中,可以使用基于规则的标准(如精确字符串匹配)来评估正确性:
其中 是从响应 中提取的最终答案, 是真实答案。与 Guo 等人(2025)不同,我们不纳入格式奖励,因为我们学习到的模型已经表现出很强的结构遵循性。我们将更复杂的格式奖励的探索留待未来的工作。此外,我们遵循 Guo 等人(2025)的做法,避免训练神经奖励模型。这一决定是出于大语言模型在大型强化学习中对特定形式奖励的敏感性,以及重新训练这些模型所带来的额外计算成本和复杂性。
4 主要结果
4.1 数据集
我们在七个基准数据集上评估 SEARCH-R1,分类如下:(1)通用问答:NQ(Kwiatkowski 等人,2019)、TriviaQA(Joshi 等人,2017)和 PopQA(Mallen 等人,2022)。(2)多跳问答:HotpotQA(Yang 等人,2018)、2WikiMultiHopQA(Ho 等人,2020)、Musique(Trivedi 等人,2022b)和 Bamboogle(Press 等人,2022)。这些数据集涵盖了多样化的搜索与推理挑战,能够对 SEARCH-R1 进行全面评估。
4.2 基线
为了评估 SEARCH-R1 的有效性,我们将其与以下基线进行比较:(1)无检索推理:直接推理和思维链(CoT)推理(Wei 等人,2022)。(2)带检索推理:检索增强生成(RAG)(Lewis 等人,2020)、IRCoT(Trivedi 等人,2022a)和 Search-o1(Li 等人,2025)。(3)基于微调的方法:监督微调(SFT)(Chung 等人,2024)、无搜索引擎的基于强化学习的微调(R1)(Guo 等人,2025)以及带搜索引擎的拒绝采样(Ahn 等人,2024)。对于 R1,我们使用 Guo 等人(2025)提出的强化学习方法,在我们的数据上训练大语言模型,以便与 SEARCH-R1 进行公平比较。它仅包含推理和回答步骤,没有搜索引擎。对于拒绝采样,我们使用经过指令微调的大语言模型,从同一数据集中为每个训练提示生成五个候选响应,并选择那些能够得出正确最终答案的响应。然后,这些选中的轨迹被用于构建一个新的训练集,该训练集保留了 SEARCH-R1 中提出的相同的多轮大语言模型-搜索引擎交互 rollout 机制,以微调大语言模型。
这些基线涵盖了广泛的检索增强和微调方法,从而能够在零样本和学习式检索设置下对 SEARCH-R1 进行全面评估。为了在不同方法之间进行公平比较,我们使用相同的检索器、相同数量的检索文档、相同的知识语料库、相同的训练数据和相同的预训练大语言模型。详情见附录 B。
4.3 实验设置
我们使用两类模型进行实验:Qwen-2.5-3B(Base/Instruct)和 Qwen-2.5-7B(Base/Instruct)(Yang 等人,2024)。对于检索,我们使用 2018 年维基百科转储(Karpukhin 等人,2020)作为知识源,并使用 E5(Wang 等人,2022)作为检索器。为确保公平比较,我们遵循 Lin 等人(2023)的做法,将所有基于检索的方法的检索段落数设置为 3。关于检索段落数的研究见附录 G。
对于训练,我们合并 NQ 和 HotpotQA 的训练集,形成用于 SEARCH-R1 和其他基于微调的基线方法的统一数据集。评估在七个数据集的测试集或验证集上进行,以评估域内和域外性能。遵循 Yu 等人(2024)的做法,使用精确匹配(EM)作为评估指标。对于推理式基线,我们使用 instruct 模型,因为 base 模型无法遵循指令。对于强化学习调优方法,实验在 base 和 instruct 模型上进行。关于实验设置的更多细节见附录 B。
除非另有说明,默认使用 PPO 作为强化学习方法,PPO 与 GRPO 之间的详细比较见第 5.1 节。
4.4 性能
表2展示了在七个数据集上比较SEARCH-R1与基线方法的主要结果。从结果中,我们得出以下关键观察:(1) SEARCH-R1始终优于强基线方法。我们在Qwen2.5-7B和Qwen2.5-3B上分别实现了和的平均相对提升。这些增益在分布内评估(即NQ和HotpotQA)和分布外评估(即TriviaQA、PopQA、2WikiMultiHopQA、Musique和Bamboogle)中均得以保持。(2) SEARCH-R1超越了基于RL的无检索LLM推理训练(R1)。这与预期相符,因为将搜索融入LLM推理能够获取相关的外部知识,从而提升整体性能。(3) SEARCH-R1对基础模型和指令微调模型均有效。这表明,采用基于结果奖励的DeepSeek-R1-Zero风格RL(Guo et al., 2025)可以成功应用于带搜索的推理,扩展了其此前在纯推理场景中已确立的有效性。(4) 更大的模型更善于学习如何进行搜索。SEARCH-R1在7B模型上相比3B模型展现出更大的“性能差距”(例如,与次优模型——RAG相比)。
| 方法 | 通用问答 | 多跳问答 | ||||||
| NQ+ | TriviaQA+ | PopQA+ | HotpotQA+ | 2wiki+ | Musique+ | Bamboogle+ | 平均 | |
| Qwen2.5-7b-Base/Instruct | ||||||||
| 直接推理 | 0.134 | 0.408 | 0.140 | 0.183 | 0.250 | 0.031 | 0.120 | 0.181 |
| CoT | 0.048 | 0.185 | 0.054 | 0.092 | 0.111 | 0.022 | 0.232 | 0.106 |
| IRCoT | 0.224 | 0.478 | 0.301 | 0.133 | 0.149 | 0.072 | 0.224 | 0.239 |
| Search-o1 | 0.151 | 0.443 | 0.131 | 0.187 | 0.176 | 0.058 | 0.296 | 0.206 |
| RAG | 0.349 | 0.585 | 0.392 | 0.299 | 0.235 | 0.058 | 0.208 | 0.304 |
| SFT | 0.318 | 0.354 | 0.121 | 0.217 | 0.259 | 0.066 | 0.112 | 0.207 |
| R1-base | 0.297 | 0.539 | 0.202 | 0.242 | 0.273 | 0.083 | 0.296 | 0.276 |
| R1-instruct | 0.270 | 0.537 | 0.199 | 0.237 | 0.292 | 0.072 | 0.293 | 0.271 |
| 拒绝采样 | 0.360 | 0.592 | 0.380 | 0.331 | 0.296 | 0.123 | 0.355 | 0.348 |
| Search-R1-base | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| Search-R1-instruct | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| 直接推理 | 0.106 | 0.288 | 0.108 | 0.149 | 0.244 | 0.020 | 0.024 | 0.134 |
| CoT | 0.023 | 0.032 | 0.005 | 0.021 | 0.021 | 0.002 | 0.000 | 0.015 |
| IRCoT | 0.111 | 0.312 | 0.200 | 0.164 | 0.171 | 0.067 | 0.240 | 0.181 |
| Search-o1 | 0.238 | 0.472 | 0.262 | 0.221 | 0.218 | 0.054 | 0.320 | 0.255 |
| RAG | 0.348 | 0.544 | 0.387 | 0.255 | 0.226 | 0.047 | 0.080 | 0.270 |
| SFT | 0.249 | 0.292 | 0.104 | 0.186 | 0.248 | 0.044 | 0.112 | 0.176 |
| R1-base | 0.226 | 0.455 | 0.173 | 0.201 | 0.268 | 0.055 | 0.224 | 0.229 |
| R1-instruct | 0.210 | 0.449 | 0.171 | 0.208 | 0.275 | 0.060 | 0.192 | 0.224 |
| 拒绝采样 | 0.294 | 0.488 | 0.332 | 0.240 | 0.233 | 0.059 | 0.210 | 0.265 |
| Search-R1-base | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| Search-R1-instruct | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolle | 平均值 |
| Qwen2.5-7b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
| SEARCH-R1-instruct (GRPO) | 0.429 | 0.623 | 0.427 | 0.386 | 0.346 | 0.162 | 0.400 | 0.396 |
| SEARCH-R1-base (PPO) | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1-instruct (PPO) | 0.393 | 0.610 | 0.397 | 0.370 | 0.414 | 0.146 | 0.368 | 0.385 |
| Qwen2.5-3b-Base/Instruct | ||||||||
| SEARCH-R1-base (GRPO) | 0.421 | 0.583 | 0.413 | 0.297 | 0.274 | 0.066 | 0.128 | 0.312 |
| SEARCH-R1-instruct (GRPO) | 0.397 | 0.565 | 0.391 | 0.331 | 0.310 | 0.124 | 0.232 | 0.336 |
| SEARCH-R1-base(PPO) | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1-instruct(PPO) | 0.341 | 0.545 | 0.378 | 0.324 | 0.319 | 0.103 | 0.264 | 0.325 |
5 分析
5.1 不同的RL方法:PPO与GRPO
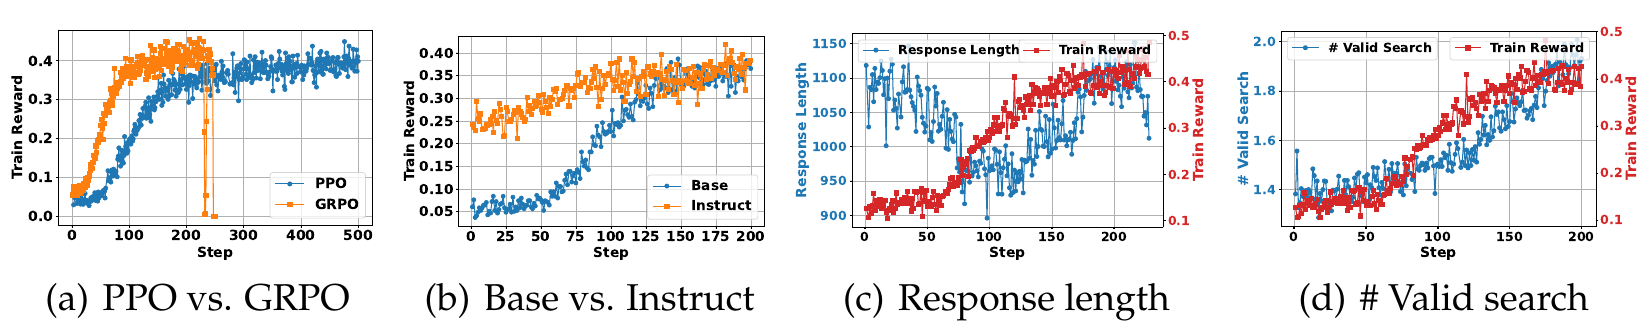
我们分别使用PPO和GRPO作为基础RL方法来评估SEARCH-R1,并在Qwen2.5-3B/7B模型上进行了实验。训练动态对比展示于图2(a),评估结果展示于表3,揭示了以下洞见:(1) 在所有情况下,GRPO的收敛速度均快于PPO。这是因为PPO依赖于critic模型,而该模型需要若干预热步骤才能开始有效训练。(2) PPO展现出更高的训练稳定性。如图2(a)所示,GRPO在训练多步后会导致奖励崩溃,而PPO保持稳定。(3) PPO和GRPO的最终训练奖励相当。尽管在收敛速度和稳定性上存在差异,两种方法均达到相似的最终训练奖励和性能,表明二者均可用于优化SEARCH-R1。PPO表现出更高的训练稳定性,使其在此设定下成为更优选择。更多结果见附录F。
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bambooq | 平均 |
| SEARCH-R1 使用掩码 | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1 不使用掩码 | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
5.2 基础模型与指令微调大语言模型
我们分析了 SEARCH-R1 在基础大语言模型和指令微调大语言模型上的训练动态。实验在两个模型变体上进行:Qwen2.5-3B 和 Qwen2.5-7B。如图 2(b) 所示,我们观察到,与基础模型相比,指令微调模型收敛更快,且初始性能更高。然而,训练结束后,两类模型的最终训练奖励仍然高度相似。这一发现表明,虽然通用后训练在推理加搜索场景中加速了学习,但强化学习能够随时间有效弥合差距,使基础模型达到可比的性能。更多结果可在附录 E 中找到。
5.3 响应长度与有效搜索研究
我们使用 SEARCH-R1 与 Qwen2.5-7b-base 模型进行了一项实验,以分析训练过程中响应长度和有效搜索引擎调用次数的动态变化。响应长度结果呈现在图 2(c) 中,揭示了以下关键趋势:(1) 早期阶段(前 100 步):响应长度急剧下降,而训练奖励略有上升。在此阶段,基础模型学会消除过多的填充词,并开始适应任务要求。(2) 后期阶段(100 步之后):响应长度和训练奖励均显著增加。此时,大语言模型学会频繁调用搜索引擎,由于检索到的段落,响应变得更长。训练奖励大幅提升,因为模型在利用搜索结果方面变得更加有效。有效搜索结果呈现在图 2(d) 中,表明随着训练的推进,大语言模型学会更多次地调用搜索引擎。
5.4 检索令牌损失掩码研究
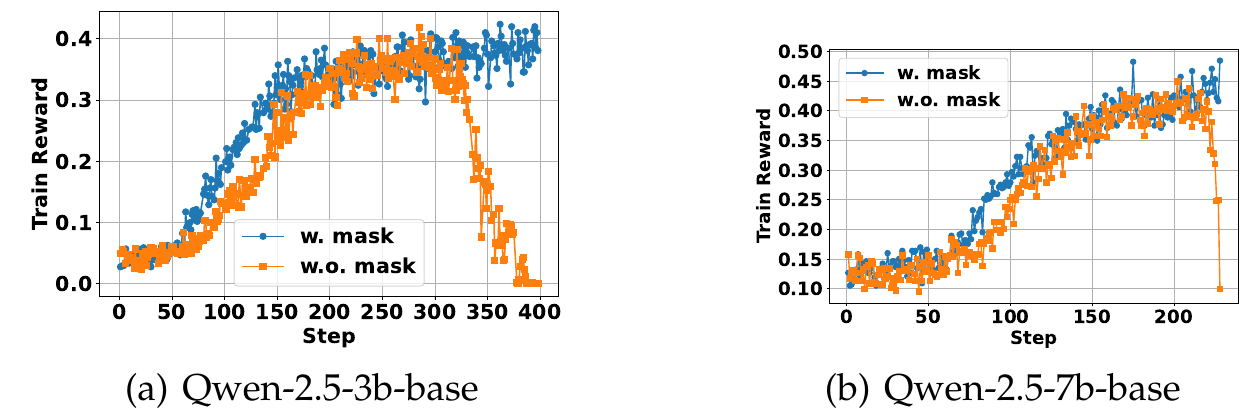
在第 3.1 节中,我们引入了对检索令牌的损失掩码,以防止意外的优化行为。在此,我们在 Qwen2.5-7b-base 模型上进行实验,比较有无检索令牌损失掩码时的训练动态。如图 3 所示,应用检索令牌掩码带来了更大的大语言模型改进,减轻了意外的优化效应并确保训练更加稳定。性能比较见表 4,表明使用检索令牌损失掩码训练的 SEARCH-R1 始终优于未使用掩码的变体。
关于检索令牌损失掩码、基础模型与指令微调大语言模型的比较、PPO/GRPO 之间的比较、SEARCH-R1 训练中检索段落数量、SEARCH-R1(GRPO)中的组大小研究、案例研究的更多实验结果可在附录 D、E、G、H、I 和 J 中找到。
6 结论
在本工作中,我们介绍了 SEARCH-R1,一种新颖的强化学习框架,使大语言模型能够将自我推理与实时搜索引擎交互交织在一起。与依赖大量提示进行多轮检索的现有类 RAG 方法,或需要大规模监督训练数据的工具使用方法不同,SEARCH-R1 通过强化学习优化大语言模型的 rollout,允许自主生成查询并策略性地利用检索到的信息。通过在七个数据集上的大量实验,我们证明了 SEARCH-R1 显著增强了大语言模型处理需要实时外部知识的复杂推理任务的能力。我们的分析还为搜索增强推理的强化学习训练策略提供了关键见解。展望未来,未来工作可以探索将 SEARCH-R1 扩展到支持更广泛的搜索策略,包括更复杂的奖励机制、基于不确定性的动态检索调整、与多样化工具集的结合,以及与搜索之外多样化信息源的集成。研究其在多模态推理任务中的适用性也很有前景。
致谢
本研究部分得到了 Apple 博士奖学金的支持,部分得到了美国 DARPA INCAS 项目(编号 HR0011-21-C0165)和 BRIES 项目(编号 HR0011-24-3-0325)的支持,部分得到了海军研究办公室合同编号 N000142412612 的支持,部分得到了 NSF 资助编号 IIS-19-56151 和 2402873 的支持,部分得到了 Molecule Maker Lab Institute:由 NSF 在奖项编号 2019897 下支持的 AI 研究机构项目,以及由 NSF 在奖项编号 2118329 下支持的通过综合发现环境(I-GUIDE)进行地理空间理解研究所的支持,部分得到了 Cisco 的支持,部分得到了智能信息检索中心的资助。本文中表达的任何意见、发现、结论或建议均为作者的观点,不一定代表赞助方或美国政府的明示或暗示观点。
参考文献
Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, and Sara Hooker. Back to basics: Revisiting reinforce style optimization for learning from human feedback in llms. arXiv preprint arXiv:2402.14740, 2024.
Janice Ahn, Rishu Verma, Renze Lou, Di Liu, Rui Zhang, and Wenpeng Yin. Large language models for mathematical reasoning: Progresses and challenges. arXiv preprint arXiv:2402.00157, 2024.
Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. 2024.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1-53, 2024.
Peter Clark, Isaac Cowhey, Oren Etzioni, Tushar Khot, Ashish Sabharwal, Carissa Schoenick, and Oyvind Tafjord. Think you have solved question answering? try arc, the ai2 reasoning challenge. arXiv preprint arXiv:1803.05457, 2018.
Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Haofen Wang, and Haofen Wang. Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997, 2, 2023.
Michael Glass, Gaetano Rossiello, Md Faisal Mahbub Chowdhury, Ankita Rajaram Naik, Pengshan Cai, and Alfio Gliozzo. Re2g: Retrieve, rerank, generate. arXiv preprint arXiv:2207.06300, 2022.
Daya Guo, Qihao Zhu, Dejian Yang, Zhenda Xie, Kai Dong, Wentao Zhang, Guanting Chen, Xiao Bi, Yu Wu, YK Li, et al. Deepseek-coder: When the large language model meets programming-the rise of code intelligence. arXiv preprint arXiv:2401.14196, 2024.
Daya Guo, Dejian Yang, Haowei Zhang, Junxiao Song, Ruoyu Zhang, Runxin Xu, Qihao Zhu, Shirong Ma, Peiyi Wang, Xiao Bi, et al. Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning. arXiv preprint arXiv:2501.12948, 2025.
Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. Measuring massive multitask language understanding. arXiv preprint arXiv:2009.03300, 2020.
Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. Constructing a multi-hop qa dataset for comprehensive evaluation of reasoning steps. arXiv preprint arXiv:2011.01060, 2020.
Zhenyu Hou, Xin Lv, Rui Lu, Jiajie Zhang, Yujiang Li, Zijun Yao, Juanzi Li, Jie Tang, and Yuxiao Dong. Advancing language model reasoning through reinforcement learning and inference scaling. arXiv preprint arXiv:2501.11651, 2025.
Sheryl Hsu, Omar Khattab, Chelsea Finn, and Archit Sharma. Grounding by trying: Llms with reinforcement learning-enhanced retrieval. arXiv preprint arXiv:2410.23214, 2024.
Jie Huang and Kevin Chen-Chuan Chang. Towards reasoning in large language models: A survey. arXiv preprint arXiv:2212.10403, 2022.
Aaron Jaech, Adam Kalai, Adam Lerer, Adam Richardson, Ahmed El-Kishky, Aiden Low, Alec Helyar, Aleksander Madry, Alex Beutel, Alex Carney, et al. Openai o1 system card. arXiv preprint arXiv:2412.16720, 2024.
Zhengbao Jiang, Frank F Xu, Luyu Gao, Zhiqing Sun, Qian Liu, Jane Dwivedi-Yu, Yiming Yang, Jamie Callan, and Graham Neubig. 主动检索增强生成. 载于《2023年自然语言处理实证方法会议论文集》,第7969-7992页,2023年.
Bowen Jin, Jinsung Yoon, Jiawei Han, and Sercan O Arik. 长上下文大语言模型与RAG的结合:克服RAG中长输入带来的挑战. 载于《第十三届国际学习表征会议》,2024年.
Mandar Joshi, Eunsol Choi, Daniel S Weld, and Luke Zettlemoyer. Triviaqa:一个用于阅读理解的大规模远程监督挑战数据集. arXiv预印本arXiv:1705.03551,2017年.
Leslie Pack Kaelbling, Michael L Littman, and Andrew W Moore. 强化学习:综述. 《人工智能研究杂志》,4:237-285,1996年.
Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick SH Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. 面向开放域问答的稠密段落检索. 载于EMNLP (1),第6769-6781页,2020年.
Timo Kaufmann, Paul Weng, Viktor Bengs, and Eyke Hullermeier. 基于人类反馈的强化学习综述. arXiv预印本arXiv:2312.14925,10,2023年.
Aviral Kumar, Vincent Zhuang, Rishabh Agarwal, Yi Su, John D Co-Reyes, Avi Singh, Kate Baumli, Shariq Iqbal, Colton Bishop, Rebecca Roelofs, et al. 通过强化学习训练语言模型进行自我纠正. arXiv预印本arXiv:2409.12917,2024年.
Tom Kwiatkowski、Jennimaria Palomaki、Olivia Redfield、Michael Collins、Ankur Parikh、Chris Alberti、Danielle Epstein、Illia Polosukhin、Jacob Devlin、Kenton Lee等。Natural questions:问答研究的基准。Transactions of the Association for Computational Linguistics,7:453-466,2019。
Nathan Lambert、Valentina Pyatkin、Jacob Morrison、LJ Miranda、Bill Yuchen Lin、Khyathi Chandu、Nouha Dziri、Sachin Kumar、Tom Zick、Yejin Choi等。Rewardbench:评估用于语言建模的奖励模型。arXiv预印本arXiv:2403.13787,2024。
Patrick Lewis、Ethan Perez、Aleksandra Piktus、Fabio Petroni、Vladimir Karpukhin、Naman Goyal、Heinrich Kuttler、Mike Lewis、Wen-tau Yih、Tim Rocktaschel等。面向知识密集型NLP任务的检索增强生成。Advances in neural information processing systems,33:9459-9474,2020。
Xiaoxi Li、Jiajie Jin、Yujia Zhou、Yongkang Wu、Zhonghua Li、Qi Ye和Zhicheng Dou。Retrollm:赋能大语言模型在生成过程中检索细粒度证据。arXiv预印本arXiv:2412.11919,2024。
Xiaoxi Li、Guanting Dong、Jiajie Jin、Yuyao Zhang、Yujia Zhou、Yutao Zhu、Peitian Zhang和Zhicheng Dou。Search-01:代理式搜索增强的大型推理模型。arXiv预印本arXiv:2501.05366,2025。
Yinheng Li、Shaofei Wang、Han Ding和Hang Chen。金融领域的大语言模型:综述。In Proceedings of the fourth ACM international conference on AI in finance,pp.374-382,2023。
Xi Victoria Lin、Xilun Chen、Mingda Chen、Weijia Shi、Maria Lomeli、Richard James、Pedro Rodriguez、Jacob Kahn、Gergely Szilvasy、Mike Lewis等。Ra-dit:检索增强的双指令微调。In The Twelfth International Conference on Learning Representations,2023。
Alex Mallen、Akari Asai、Victor Zhong、Rajarshi Das、Hannaneh Hajishirzi和Daniel Khashabi。何时不应信任语言模型:研究参数化与非参数化记忆的有效性与局限性。arXiv预印本arXiv:2212.10511,7,2022。
Yu Meng、Mengzhou Xia和Danqi Chen。Simpo:具有无参考奖励的简单偏好优化。Advances in Neural Information Processing Systems,37:124198-124235,2024。
Long Ouyang、Jeffrey Wu、Xu Jiang、Diogo Almeida、Carroll Wainwright、Pamela Mishkin、Chong Zhang、Sandhini Agarwal、Katarina Slama、Alex Ray等。通过人类反馈训练语言模型遵循指令。Advances in neural information processing systems,35:27730-27744,2022。
Richard Yuanzhe Pang、Weizhe Yuan、He He、Kyunghyun Cho、Sainbayar Sukhbaatar和Jason Weston。迭代式推理偏好优化。Advances in Neural Information Processing Systems,37:116617-116637,2024。
Cheng Peng、Xi Yang、Aokun Chen、Kaleb E Smith、Nima PourNejatian、Anthony B Costa、Cheryl Martin、Mona G Flores、Ying Zhang、Tanja Magoc等。面向医学研究和医疗保健的生成式大语言模型研究。NPJ digital medicine,6(1):210,2023。
Ofir Press、Muru Zhang、Sewon Min、Ludwig Schmidt、Noah A Smith和Mike Lewis。测量并缩小语言模型中的组合性差距。arXiv预印本arXiv:2210.03350,2022。
Changle Qu、Sunhao Dai、Xiaochi Wei、Hengyi Cai、Shuaiqiang Wang、Dawei Yin、Jun Xu和Ji-Rong Wen。基于大语言模型的工具学习:综述。Frontiers of Computer Science,19(8):198343,2025。
Rafael Rafailov、Archit Sharma、Eric Mitchell、Christopher D Manning、Stefano Ermon和Chelsea Finn。直接偏好优化:你的语言模型实际上是一个奖励模型。Advances in Neural Information Processing Systems,36:53728-53741,2023。
Timo Schick、Jane Dwivedi-Yu、Roberto Dessi、Roberta Raileanu、Maria Lomeli、Eric Hambro、Luke Zettlemoyer、Nicola Cancedda和Thomas Scialom。Toolformer:语言模型可以自学使用工具。Advances in Neural Information Processing Systems,36:68539-68551,2023。
John Schulman、Philipp Moritz、Sergey Levine、Michael Jordan和Pieter Abbeel。使用广义优势估计的高维连续控制。arXiv预印本arXiv:1506.02438,2015。
John Schulman、Filip Wolski、Prafulla Dhariwal、Alec Radford和Oleg Klimov。近端策略优化算法。arXiv预印本arXiv:1707.06347,2017。
Zhihong Shao、Peiyi Wang、Qihao Zhu、Runxin Xu、Junxiao Song、Xiao Bi、Haowei Zhang、Mingchuan Zhang、YK Li、Y Wu等。Deepseekmath:推动开放语言模型数学推理的极限。arXiv预印本arXiv:2402.03300,2024。
Guangming Sheng、Chi Zhang、Zilingfeng Ye、Xibin Wu、Wang Zhang、Ru Zhang、Yanghua Peng、Haibin Lin和Chuan Wu。Hybridflow:一个灵活高效的RLHF框架。arXiv预印本arXiv:2409.19256,2024。
Richard S Sutton、Andrew G Barto等。强化学习。Journal of Cognitive Neuroscience,11(1):126-134,1999。
Gemini Team。Gemini 1.5:解锁跨越数百万上下文token的多模态理解。arXiv预印本arXiv:2403.05530,2024。
Harsh Trivedi、Niranjan Balasubramanian、Tushar Khot和Ashish Sabharwal。将检索与思维链推理交错用于知识密集型多步问题。arXiv预印本arXiv:2212.10509,2022a。
Harsh Trivedi、Niranjan Balasubramanian、Tushar Khot和Ashish Sabharwal。Musique:通过单跳问题组合实现多跳问题。Transactions of the Association for Computational Linguistics,10:539-554,2022b。
Liang Wang、Nan Yang、Xiaolong Huang、Binxing Jiao、Linjun Yang、Daxin Jiang、Rangan Majumder和Furu Wei。通过弱监督对比预训练获得的文本嵌入。arXiv预印本arXiv:2212.03533,2022。
Jason Wei、Xuezhi Wang、Dale Schuurmans、Maarten Bosma、Fei Xia、Ed Chi、Quoc V Le、Denny Zhou等。思维链提示引发大语言模型中的推理。Advances in neural information processing systems,35:24824-24837,2022。
Yixuan Weng、Minjun Zhu、Fei Xia、Bin Li、Shizhu He、Shengping Liu、Bin Sun、Kang Liu和Jun Zhao。大语言模型通过自我验证成为更好的推理者。arXiv预印本arXiv:2212.09561,2022。
Ronald J Williams。用于联结主义强化学习的简单统计梯度跟随算法。Machine learning,8:229-256,1992。
Tian Xie、Zitian Gao、Qingnan Ren、Haoming Luo、Yuqian Hong、Bryan Dai、Joey Zhou、Kai Qiu、Zhirong Wu和Chong Luo。Logic-rl:通过基于规则的强化学习释放LLM推理能力。arXiv预印本arXiv:2502.14768,2025。
Guangzhi Xiong、Qiao Jin、Xiao Wang、Yin Fang、Haolin Liu、Yifan Yang、Fangyuan Chen、Zhixing Song、Dengyu Wang、Minjia Zhang等。Rag-gym:通过过程监督优化推理与搜索代理。arXiv预印本arXiv:2502.13957,2025。
An Yang、Baosong Yang、Beichen Zhang、Binyuan Hui、Bo Zheng、Bowen Yu、Chengyuan Li、Dayiheng Liu、Fei Huang、Haoran Wei等。Qwen2.5技术报告。arXiv预印本arXiv:2412.15115,2024。
Zhilin Yang、Peng Qi、Saizheng Zhang、Yoshua Bengio、William W Cohen、Ruslan Salakhutdinov 和 Christopher D Manning。Hotpotqa:一个用于多样化、可解释多跳问答的数据集。arXiv 预印本 arXiv:1809.09600,2018。
Shunyu Yao、Jeffrey Zhao、Dian Yu、Nan Du、Izhak Shafran、Karthik Narasimhan 和 Yuan Cao。React:在语言模型中协同推理与行动。见 International Conference on Learning Representations (ICLR),2023。
Yue Yu、Wei Ping、Zihan Liu、Boxin Wang、Jiaxuan You、Chao Zhang、Mohammad Shoeybi 和 Bryan Catanzaro。Rankrag:在大型语言模型中将上下文排序与检索增强生成统一。Advances in Neural Information Processing Systems,37:121156-121184,2024。
Zhenrui Yue、Honglei Zhuang、Aijun Bai、Kai Hui、Rolf Jagerman、Hansi Zeng、Zhen Qin、Dong Wang、Xuanhui Wang 和 Michael Bendersky。长上下文检索增强生成的推理扩展。arXiv 预印本 arXiv:2410.04343,2024。
Yue Zhang、Yafu Li、Leyang Cui、Deng Cai、Lemao Liu、Tingchen Fu、Xinting Huang、Enbo Zhao、Yu Zhang、Yulong Chen 等。AI 海洋中的塞壬之歌:大型语言模型中的幻觉综述。arXiv 预印本 arXiv:2309.01219,2023。
Wayne Xin Zhao、Kun Zhou、Junyi Li、Tianyi Tang、Xiaolei Wang、Yupeng Hou、Yingqian Min、Beichen Zhang、Junjie Zhang、Zican Dong 等。大型语言模型综述。arXiv 预印本 arXiv:2303.18223,1(2),2023。
Wayne Xin Zhao、Jing Liu、Ruiyang Ren 和 Ji-Rong Wen. 基于预训练语言模型的稠密文本检索:综述. ACM Transactions on Information Systems, 42(4): 1-60, 2024.
附录
A 结合搜索引擎的强化学习形式化
用于训练大语言模型(LLMs)的经典强化学习(RL)框架可以形式化如下(Rafailov et al., 2023; Ouyang et al., 2022):
其中 表示从数据集 中采样的提示, 是由策略模型 生成的响应,而 表示作为正则化锚点的参考模型。奖励函数 量化生成响应的质量,而 KL 散度项约束更新后的策略与参考模型保持接近,从而促进训练稳定性。
然而,该形式化假设整个输出序列 完全由策略 LLM 生成。这一假设在我们的设定中并不成立,因为模型行为同时包含内部推理和外部信息检索。为适应这一点,我们扩展 RL 目标以纳入外部搜索引擎 ,得到如下形式化:
在这一修订目标中,轨迹 包含交错的推理步骤和检索内容,反映了 LLM 与搜索引擎之间的多轮交互。KL 散度是在以提示和检索增强上下文为条件的联合响应分布上计算的,从而确保即使存在外部信息,学习到的策略仍与参考模型保持一致。
B 实验设置
B.1 基线
若干近期工作探索了 RAG 流水线,尤其是在 Natural Questions(NQ)或 HotpotQA 等基准上,旨在通过更精细的检索机制提升性能。例如,Re2G(Glass et al., 2022)和 RetroLLM(Li et al., 2024)提出了复杂的检索-重排序-生成框架,采用强检索器和复杂的重排序策略来选择用于生成的细粒度证据。尽管这些方法展示了令人印象深刻的结果,但它们通常依赖任务特定的工程或重量级流水线,限制了通用性和可扩展性。相比之下,我们的重点是一种更轻量、更通用的检索增强推理方法。因此,我们未将这些方法作为直接基线,尽管它们代表了检索增强语言建模更广阔空间中值得探索的方向。
B.2 实验设置
我们使用两类模型进行实验:Qwen-2.5-3B(Base/Instruct)和 Qwen-2.5-7B(Base/Instruct)(Yang et al., 2024)。对于检索,我们使用 2018 年 Wikipedia 转储(Karpukhin et al., 2020)作为知识源,并使用 E5(Wang et al., 2022)作为检索器。为确保公平比较,我们遵循 Lin et al. (2023) 的做法,将所有基于检索的方法的检索段落数设为 3。
对于训练,我们合并 NQ 和 HotpotQA 的训练集,形成用于 SEARCH-R1 和其他基于微调的基线的统一数据集。评估在七个数据集的测试集或验证集上进行,以评估域内和域外性能。遵循 Yu et al. (2024),我们使用精确匹配(EM)作为评估指标。对于推理风格的基线,我们使用 instruct 模型,因为 base 模型无法遵循指令。对于 RL 调优方法,实验在 base 模型和 instruct 模型上均进行。有关实验设置的更多细节可在附录 B 中找到。
对于 SEARCH-R1 的 PPO 变体,我们将策略 LLM 的学习率设为 1e-6,价值 LLM 的学习率设为 1e-5。训练进行 500 步,策略模型和价值模型的预热比例分别为 0.285 和 0.015。我们使用广义优势估计(GAE),参数为 和 。
训练在具有 8 块 H100 GPU 的单个节点上进行。我们使用总批量大小为 512,小批量大小为 256,微批量大小为 64。最大序列长度设为 4,096 个 token,最大响应长度为 500,检索内容的最大长度为 500 个 token。为优化 GPU 内存使用,我们启用梯度检查点,并使用带 CPU 卸载的全分片数据并行(FSDP)。
为实现高效的 LLM rollout,我们采用 vLLM1,张量并行大小为 1,GPU 内存利用率为 0.6。rollout 采样使用温度为 1.0,top-p 值为 1.0。KL 散度正则化系数 和裁剪比例 分别设为 0.001 和 0.2。
对于 GRPO 训练,我们将策略 LLM 学习率设为 1e-6,并针对每个提示采样 5 个响应,遵循 Verl 中的 GRPO 实现(Sheng et al., 2024)1。模型训练 500 步,学习率预热比例为 0.285。训练在相同的 8xH100 设置上进行,批量大小和序列长度配置与 PPO 相同。
我们还使用梯度检查点、FSDP 卸载和基于 vLLM 的 rollout,超参数与上述相同。rollout 温度和 top-p 值均设为 1.0,KL 散度系数 和裁剪比例 固定为 0.001 和 0.2。
对于两种方法,模型检查点每 100 步保存一次。在训练发散的情况下,我们根据训练奖励曲线在最近稳定的检查点进行评估;否则,使用最终检查点进行评估。最大动作预算 设为 4,默认检索前 3 个段落。
我们使用精确匹配(EM)计算结果奖励。除非另有说明,PPO 用作默认 RL 算法,并在第 5.1 节中提供了与 GRPO 的详细比较。
C 14B LLM 上的主要结果
我们使用 Qwen2.5-14B 模型进行了大量实验,结果呈现在表 5 中。如所示,SEARCH-R1 在评估指标上始终优于所有基线方法。此外,我们观察到增加模型规模会为 SEARCH-R1 带来持续的性能提升,突显了我们方法中 LLM 规模扩展的优势。
D 检索 token 损失掩码研究
在第 3.1 节中,我们引入了针对检索 token 的损失掩码策略,以缓解训练过程中不理想的优化行为。为评估其影响,我们使用 Qwen2.5-3b/7b-base 模型进行实验,比较有和没有检索 token 损失掩码时的训练动态。如图 3 所示,引入掩码机制可带来更稳定的优化和更好的模型性能。表 6 中的定量结果进一步证实,SEARCH-R1 在对检索 token 进行损失掩码训练时,始终优于未掩码的对应版本。
E Base 与 Instruct LLM
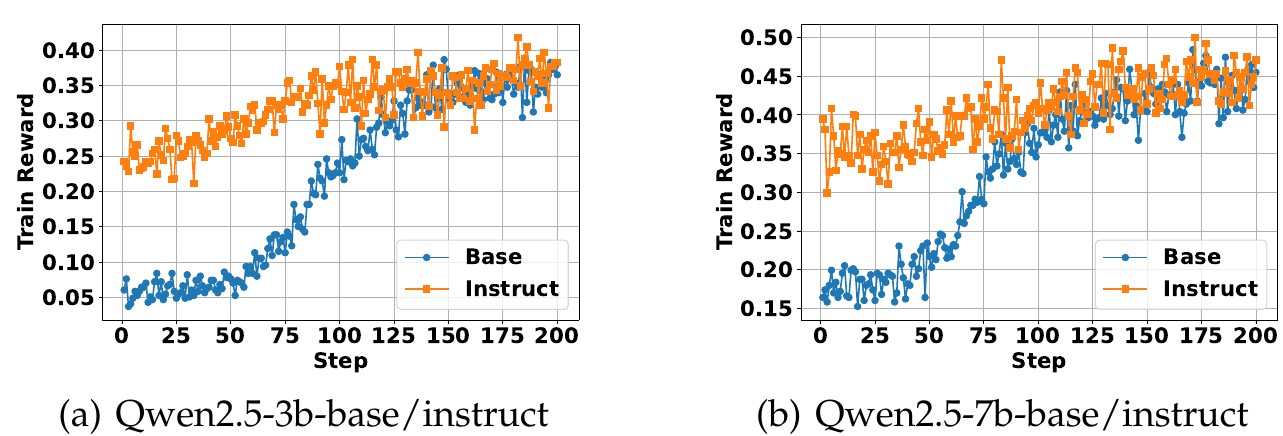
我们研究了SEARCH-R1在基础LLM和指令微调LLM上的训练动态,使用了两种模型规模:Qwen2.5-3B和Qwen2.5-7B。如图4所示,
| 方法 | 通用问答 | 多跳问答 | ||||||
| NQ† | TriviaQA* | PopQA* | HotpotQA† | 2wiki* | Musique* | Bamboogle* | 平均 | |
| Qwen2.5-14b-Base/Instruct | ||||||||
| 直接推理 | 0.198 | 0.531 | 0.184 | 0.217 | 0.253 | 0.045 | 0.160 | 0.227 |
| CoT | 0.190 | 0.495 | 0.148 | 0.269 | 0.297 | 0.054 | 0.432 | 0.269 |
| IRCoT | 0.114 | 0.375 | 0.166 | 0.230 | 0.248 | 0.102 | 0.312 | 0.221 |
| Search-o1 | 0.347 | 0.635 | 0.241 | 0.268 | 0.161 | 0.099 | 0.416 | 0.310 |
| RAG | 0.327 | 0.585 | 0.376 | 0.279 | 0.160 | 0.051 | 0.192 | 0.281 |
| SFT | 0.361 | 0.467 | 0.150 | 0.248 | 0.278 | 0.089 | 0.160 | 0.250 |
| R1-base | 0.369 | 0.626 | 0.270 | 0.306 | 0.326 | 0.117 | 0.488 | 0.357 |
| R1-instruct | 0.334 | 0.628 | 0.253 | 0.294 | 0.325 | 0.108 | 0.432 | 0.339 |
| Search-R1-base | 0.486 | 0.676 | 0.480 | 0.468 | 0.470 | 0.241 | 0.528 | 0.479 |
| Search-R1-instruct | 0.424 | 0.660 | 0.442 | 0.436 | 0.379 | 0.210 | 0.480 | 0.433 |
与对应的基础模型相比,指令微调模型表现出更快的收敛速度,并受益于更高的初始性能。尽管具有这一早期优势,两类模型的最终性能在训练后收敛至相似水平。这些结果表明,虽然指令微调有助于在推理加搜索任务中实现更高效的早期学习,但强化学习能够弥合性能差距,最终使基础模型达到可比的结果。
F SEARCH-R1中PPO与GRPO的比较
我们使用Qwen2.5-3B和Qwen2.5-7B作为底层模型,在两种强化学习算法下评估SEARCH-R1的有效性:PPO和GRPO。图5展示了训练动态。我们的分析得出以下关键观察:(1) GRPO在所有设置下均表现出比PPO更快的收敛速度,这归因于
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 平均 |
| Qwen2.5-7b-Base | ||||||||
| SEARCH-R1 有掩码 | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| SEARCH-R1 无掩码 | 0.388 | 0.567 | 0.391 | 0.325 | 0.321 | 0.108 | 0.304 | 0.343 |
| Qwen2.5-3b-Base | ||||||||
| SEARCH-R1 有掩码 | 0.406 | 0.587 | 0.435 | 0.284 | 0.273 | 0.049 | 0.088 | 0.303 |
| SEARCH-R1 无掩码 | 0.346 | 0.484 | 0.365 | 0.241 | 0.244 | 0.053 | 0.104 | 0.262 |
表6:SEARCH-R1在有/无检索token损失掩码时的性能。使用检索token损失掩码训练的LLM始终取得更好的性能。(RL: PPO)PPO依赖独立的价值函数(critic),在能够进行有效的策略更新之前需要一个初始预热阶段。(2) PPO提供更稳定的训练行为,如图5所示,GRPO在较长的训练步数后遭遇奖励崩溃,而PPO始终保持稳定。(3) PPO和GRPO达到可比的最终奖励性能,这表明尽管在收敛速度和稳定性方面存在权衡,两种方法对于优化SEARCH-R1都是有效的。
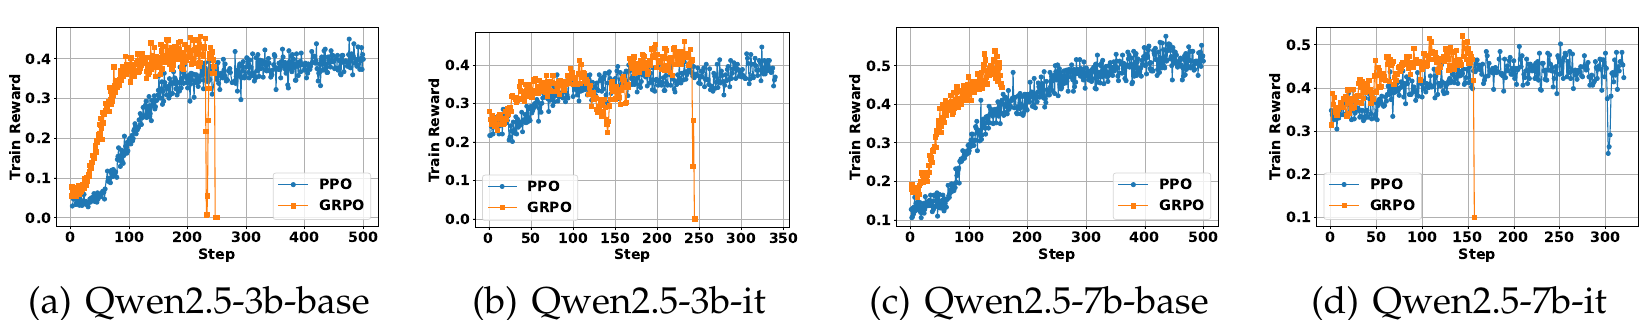
图5:在四种LLM上以PPO和GRPO作为基础RL方法时SEARCH-R1的训练动态。GRPO通常收敛更快,但在训练若干步后可能表现出不稳定性,而PPO提供更稳定的优化但收敛速度较慢。PPO和GRPO达到可比的最终奖励性能。
G SEARCH-R1训练中检索段落数量研究
我们研究了检索段落数量(top-\(k\))对SEARCH-R1训练动态的影响。虽然我们的主要实验遵循Lin et al. (2023)采用top-\(k = 3\),但我们进行了额外研究,将top-\(k\)设为1、3和5,以更好地理解其影响。
图6展示了这些设置下的训练奖励曲线。我们观察到,所有三种配置都表现出相似的总体训练轨迹。值得注意的是,top-\(k = 5\)实现了最快的初始收敛,在前200步内达到最高的训练奖励。然而,其奖励逐渐下降,并随着训练进行变得更加不稳定。相比之下,top-\(k = 1\)和3在整个训练过程中表现出更一致的提升,其中top-\(k = 3\)最终在500步后达到最高奖励。
第500步的评估结果总结在表7中,其中top-\(k = 3\)取得了最佳总体性能。我们假设有两个促成因素:(1) top-\(k = 1\)可能受限于较低的检索召回率,限制了提供相关上下文信息的能力;(2) top-\(k = 5\)由于包含噪声或不相关段落而引入较低的精确率(Jin et al., 2024),这不仅会降低推理性能,还可能对RL训练产生不利影响——当模型了解到额外上下文通常无帮助或具有误导性时,会抑制模型利用检索内容。
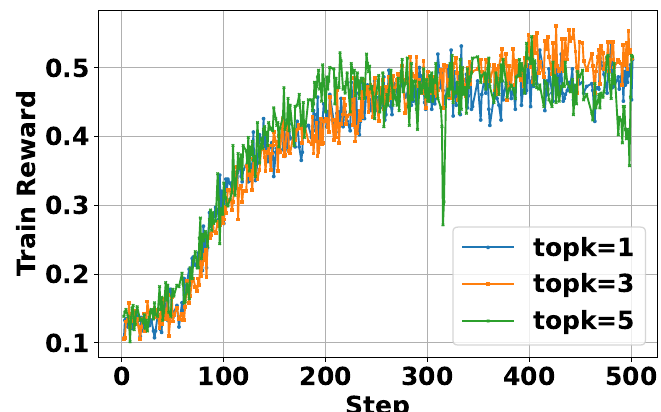
图6:SEARCH-R1在不同检索段落数量下的训练动态。(LLM:Qwen2.5-7b-base,RL:PPO)
表7:SEARCH-R1训练中检索段落数量的研究。(LLM:Qwen2.5-7b-base;RL:PPO)
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboolge | 平均 |
| topk=1 | 0.426 | 0.614 | 0.422 | 0.393 | 0.296 | 0.146 | 0.328 | 0.375 |
| topk=3 | 0.480 | 0.638 | 0.457 | 0.433 | 0.382 | 0.196 | 0.432 | 0.431 |
| topk=5 | 0.479 | 0.634 | 0.440 | 0.394 | 0.343 | 0.156 | 0.352 | 0.400 |
H SEARCH-R1(GRPO)训练中的组大小研究
在主要实验中,我们遵循Sheng等人(2024)的设置,将SEARCH-R1(GRPO)的组大小设为5。为进一步研究组大小对训练动态的影响,我们进行了组大小为1、3和5的消融研究。值得注意的是,当组大小设为1时,GRPO退化为标准的REINFORCE算法(Williams,1992)。
我们对LLM进行500步训练,每100步保存一次模型检查点。如果模型在训练过程中崩溃,我们使用最后一个有效检查点进行评估;否则,我们评估第500步的检查点。
不同组大小配置下的训练动态如图7所示。我们观察到,较大的组大小通常会导致更快的收敛,但由于强化学习固有的不稳定性,也可能增加崩溃的风险。
不同设置下的评估结果总结在表8中。虽然较大的组大小可以加速收敛并获得更高的训练奖励,但较小的组大小(例如大小=1)能够实现更稳定的训练和更好的泛化。这体现在未见任务上的更优性能上,突出了GRPO训练中学习速度与稳定性之间的权衡。
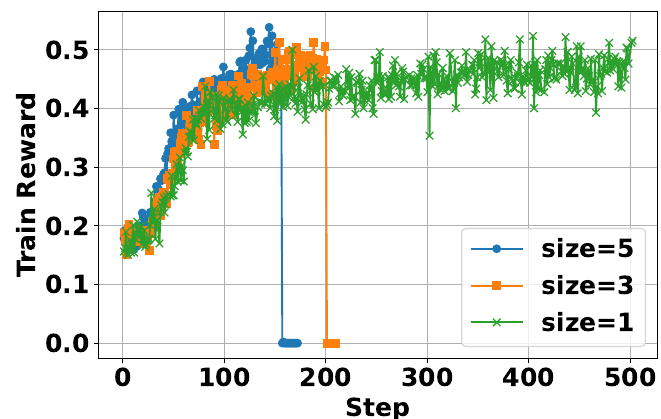
图7:SEARCH-R1(GRPO)在不同组大小下的训练动态。(LLM:Qwen2.5-7b-base)
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2wiki | Musique | Bamboogle | 平均 |
| size=1 | 0.463 | 0.605 | 0.449 | 0.392 | 0.413 | 0.163 | 0.384 | 0.410 |
| size=3 | 0.385 | 0.580 | 0.396 | 0.329 | 0.333 | 0.117 | 0.400 | 0.363 |
| size=5 | 0.395 | 0.560 | 0.388 | 0.326 | 0.297 | 0.125 | 0.360 | 0.350 |
表8:SEARCH-R1(GRPO)在七个数据集上的组大小研究。(LLM:Qwen2.5-7b-base)
I R1与SEARCH-R1的比较:案例研究
| 用于理解原文的只读背景(非待翻译源文本):I R1 与 SEARCH-R1 的对比:案例研究 表 9:R1 与 SEARCH-R1 的案例研究。 待翻译文本: 问题:Curious 是一款女士香水,由一位歌手推出,这位歌手出生在哪个城市和州? | ||||||||
| 标准答案:密西西比州麦库姆 | ||||||||
| R1: | ||||||||
| <l>这位歌手是 Beyoncé,她出生在德克萨斯州休斯顿。</l> | ||||||||
| <l>休斯顿</l> | ||||||||
| <l>我需要查明,推出“Curious”这款女士香水的歌手出生在哪个城市和州。</l> | ||||||||
| <l>Curious 香水信息 </search> | ||||||||
| <l>文档 1(标题:“Curious(香水)”)Curious(香水)Curious 是 Britney Spears 为 Elizabeth Arden 推出的一款女士香水,也是 Britney Spears 代言的第一款香水,早于“Fantasy”。据报道,Spears 从该代言中赚取了 5200 万美元。“Curious”于 2004 年 9 月发布,并在国际上非常成功。它是 2004 年百货商店中排名第一的香水,2005 年,“Curious”被 fragrance Foundation 评为最佳女士香水。这款香水是白色花香调。其香调包括路易斯安那木兰、金安茹梨、莲花、晚香玉、星茉莉、粉色仙客来、香草浸润麝香、檀香和金发木。Elizabeth Arden…… </information></td></tr><tr><td colspan="9"><l>我需要查明“Curious”香水背后的歌手 Britney Spears 出生在哪个城市和州。</l></td></tr><tr><td colspan="9"><l>Britney Spears 出生地 </search></td></tr><tr><td colspan="9"><l>文档 1(标题:“Britney Spears”)2000 年代最畅销的女性专辑艺人。2004 年,她与 Elizabeth Arden, Inc. 合作推出了一个香水品牌,其销售额超过 15 亿美元。Spears 出生在密西西比州麦库姆,是 Lynne Irene Bridges 和 James Parnell Spears 的第二个孩子。她的外祖母 Lillian Portell 是英国人(出生于伦敦),Spears 的一位外曾曾祖父是马耳他人。她的兄弟姐妹是 Bryan James 和 Jamie Lynn。Britney 出生在圣经地带,那里社会保守的福音派新教具有特别强烈的宗教影响。Spears 在美南浸信会受洗,但后来在人生中学习了…… </information> | ||||||||
| <l>既然 Britney Spears 出生在密西西比州麦库姆,我需要查明那是哪个城市和州。</l> | ||||||||
| <l>密西西比州麦库姆的位置 </search> | ||||||||
| <l>文档 1(标题:“McComb, Mississippi”)McComb, Mississippi McComb 是美国密西西比州派克县的一座城市,位于杰克逊以南约……截至 2010 年人口普查,该市总人口为 12,790 人。它是密西西比州麦库姆微型都市统计区的主要城市。McComb 建于 1872 年,此前新奥尔良、杰克逊和大北方铁路公司(伊利诺伊中央铁路公司的前身,现为加拿大国家铁路公司的一部分)的 Henry Simpson McComb 决定将铁路的维修车间从路易斯安那州新奥尔良迁走,以避免该市酒馆的诱惑。铁路公司在派克县购买了土地…… </information> | ||||||||
| <l>我发现 Britney Spears 出生在密西西比州麦库姆。既然问题问的是城市和州,我只需要确认州,而我从之前的搜索中已经知道了。</l> | ||||||||
| <l>密西西比州麦库姆 </answer> |
表9:R1与SEARCH-R1的案例研究。
为了更深入地了解SEARCH-R1,我们使用Qwen2.5-7B-Base进行了一项案例研究,将其行为与不使用搜索引擎的RL(Guo等人,2025)进行比较。结果呈现在表20中,揭示了以下关键观察:交错推理与检索增强问题分析:SEARCH-R1使LLM能够通过多轮检索进行深入推理,而不使用搜索的RL仅依赖模型的内部知识。通过纳入检索到的段落,SEARCH-R1允许LLM迭代地完善其推理,从而产生更知情和准确的回答。
通过迭代检索进行自我验证:我们观察到,在第二轮检索之后,LLM已经收集了足够的信息来回答问题。然而,SEARCH-R1会执行额外的检索步骤来自我验证其结论,进一步强化其对最终回答的信心。这一现象与不使用检索的LLM推理RL的发现(Guo等人,2025)一致,突显了RL即使在搜索增强的设置中也能鼓励验证驱动的推理。
J SEARCH-R1的更多案例研究
为了更深入地理解训练后的LLM的行为和能力,我们对SEARCH-R1进行了额外的案例研究。具体来说,我们分析了使用近端策略优化(PPO)作为底层强化学习算法、从Qwen2.5-7B-Base微调得到的模型。结果如下表所示。
表10:SEARCH-R1案例研究1(成功):SEARCH-R1进行多步推理、搜索、自我验证,最终回答问题。
问题:Chris Jericho和Gary Barlow有什么共同的职业类型?真实答案:音乐家SEARCH-R1:<think> 我需要找出Chris Jericho和Gary Barlow共同的职业类型。我会搜索一下。</think><search> Chris Jericho和Gary Barlow的职业 </search><information> 文档2(标题:“Chris Jericho”)“Do You Wanna Start a War”(2014)和“Judas”(2017)全部或主要由原创作品组成。多年来,他还出现在众多电视节目中,曾参加2011季“Dancing With the Stars”,持续到第六周。在此之前,Jericho主持了ABC游戏节目“Downfall”和Revolver Golden Gods Awards。Christopher Keith Irvine于1970年11月9日出生在纽约Manhasset,但在Winnipeg长大。他的父亲、冰球运动员Ted Irvine在他出生时正为New York Rangers效力。... </information>我需要弄清楚Gary Barlow是否有这些职业中的任何一种。</think> <search> Gary Barlow的职业 </search><information> 文档1(标题:“Gary Barlow”)与Take That合作获得热门歌曲、十二首冠军单曲和七张冠军专辑。Barlow已获得英国词曲作者、作曲家和作家学院颁发的六项Ivor Novello奖,包括对英国音乐杰出贡献奖。他在全球已售出超过5000万张唱片。Barlow于1971年1月20日出生在Cheshire的Frodsham,是Colin(2009年10月15日去世)和Marjorie Barlow的第二个儿子。在Barlow的自传中,他讲述了自己对音乐的热爱始于幼年,并称自己为“那些永远在电视前跳舞、看着……的孩子之一”。</information>我需要找出Chris Jericho和Gary Barlow之间是否有共同职业。</think><search> Chris Jericho和Gary Barlow的共同职业 </search> <information> 文档1(标题:“Gary Barlow”)Gary Barlow Gary Barlow(1971年1月20日出生)是一位英国歌手、词曲作者、音乐家和唱片制作人。他最出名的是作为英国流行组合Take That的主唱。Barlow还曾在2011年、2012年和2013年担任“The X Factor UK”的首席评委,并在2017年担任“Let It Shine”的首席评委。Barlow是英国最成功的词曲作者之一,创作了十四首冠军单曲和二十四首前十热门歌曲。作为独唱艺人,他拥有三首冠军单曲、六首前十单曲和两张冠军专辑,此外还拥有十七首前五…… </information><think> 我发现Gary Barlow是一位歌手、词曲作者、音乐家和唱片制作人。现在我需要找出Chris Jericho是否有这些职业中的任何一种。</think><search> Chris Jericho的职业 </search> <information> 文档1(标题:“Chris Jericho”)Chris Jericho Christopher Keith Irvine(1970年11月9日出生),更广为人知的擂台名是Chris Jericho,是一位美国出生的职业摔角手、音乐家、作家和演员。他目前为New Japan Pro-Wrestling(NJPW)摔角,是现任IWGP洲际冠军,这是他的首次持有。Jericho还偶尔为WWE的SmackDown品牌出场,自1999年以来一直与其合作。在职业摔角界,他以其夸张的摇滚明星形象而闻名。Jericho被认为是史上最伟大的职业摔角手之一。在20世纪90年代,Jericho曾为美国组织Extreme Championship…… </information><think> 我发现Chris Jericho是一位职业摔角手、音乐家、作家和演员。现在我可以将其与Gary Barlow的职业进行比较。我发现Gary Barlow是一位歌手、词曲作者、音乐家和唱片制作人。Chris Jericho和Gary Barlow之间的共同职业是音乐家。</think><answer> 音乐家 </answer>
| 问题:Weezer的首张录音室专辑叫什么名字,其中收录了热门歌曲《Buddy Holly》和《Undone – The Sweater Song》? |
| 标准答案:The Blue Album |
| SEARCH-R1: |
| <think> 我需要找出Weezer的首张录音室专辑的名称,该专辑收录了热门歌曲“Buddy Holly”和“Undone – The Sweater Song”。我来搜索一下。 </think> |
| <search> Weezer的首张录音室专辑,其中收录了热门歌曲Buddy Holly和Undone – The Sweater Song </search> |
| <information> 文档1(标题:“Weezer discography”)Weezer discography 美国摇滚乐队Weezer的作品目录包括11张录音室专辑、两张合辑专辑、一张视频专辑、六张扩展播放唱片、28首单曲和24个音乐视频。Weezer的同名首张录音室专辑,通常被称为“The Blue Album”,于1994年5月通过DGC Records发行。这张专辑取得了巨大的商业成功,在美国“Billboard” 200排行榜上最高达到第16位,并产生了单曲“Undone – The Sweater Song”和“Buddy Holly”,这两首单曲在由Spike Jonze执导的音乐视频的助力下,使Weezer进入了主流成功。…… <information> |
| <think> 我发现Weezer的首张录音室专辑,其中收录了热门歌曲“Buddy Holly”和“Undone – The Sweater Song”,就是这张同名专辑,通常被称为“The Blue Album”。现在我可以给出答案了。 </think> |
| <answer> Weezer </answer> |
SEARCH-R1:<think> 我需要找出谁的死亡被改编成舞台剧后帮助澳大利亚废除了死刑。我会搜索一下。</think>
<search> 谁的死亡被改编成舞台剧后帮助澳大利亚废除了死刑 </search>
<information> 文档3(标题:“Ronald Ryan”)Ronald Ryan Ronald Joseph Ryan(1925年2月21日-1967年2月3日)是澳大利亚最后一个被合法处决的人。Ryan因1965年在维多利亚州Pentridge监狱越狱期间枪杀狱警George Hodson而被判有罪。Ryan的绞刑引发了澳大利亚历史上一些最大规模的公众抗议,并导致死刑的终结。到1985年,所有州都废除了死刑。Ronald Edmond Thompson出生在墨尔本内城区Carlton的皇家妇女医院,父亲是John Ronald Ryan,母亲是Cecilia Thompson(娘家姓…… </information>
<think> 我发现,罗纳德·瑞安之死被改编成舞台剧后,推动了澳大利亚废除死刑。现在我可以给出答案了。 </think>
<answer> 罗纳德·瑞安 </answer>
| 问题:泰德国家公园和加拉霍奈国家公园位于哪里? |
| 真实答案:西班牙加那利群岛 |
| SEARCH-R1: |
| <think> 我需要查明泰德国家公园和加拉霍奈国家公园位于哪里。我来搜索一下。</think> |
| <search> 泰德国家公园和加拉霍奈国家公园的位置 </search> |
| <information> 文档 1(标题:“加拉霍奈国家公园”)决定结束自己的生命。加拉霍奈国家公园 加拉霍奈国家公园(,)位于拉戈梅拉岛的中部和北部,拉戈梅拉岛是加那利群岛(西班牙)之一。它于1981年被宣布为国家公园,并于1986年被联合国教科文组织列为世界遗产。它占地40平方公里(15平方英里),并延伸到该岛六个市镇中的每一个。每年有近45万游客参观该公园。公园边界外就有为游客提供的住宿。该公园以加拉霍奈岩层命名,该岩层是最高点…… </information> |
| <think> 我发现加拉霍奈国家公园位于拉戈梅拉岛的中部和北部,拉戈梅拉岛是加那利群岛(西班牙)之一。现在我需要找到泰德国家公园的位置。</think> |
| <search> 泰德国家公园的位置 </search> |
| <information> 文档 1(标题:“泰德国家公园”)泰德国家公园 泰德国家公园(,)是位于特内里费岛(西班牙加那利群岛)的国家公园。该国家公园以泰德山为中心,泰德山是西班牙最高的山(高3,718米),此外,它还是大西洋岛屿中最高的火山,并且从其海底基座算起是世界第三高的火山(高7,500米)。其国家公园地位于1954年1月22日获得批准,使其成为西班牙第三古老的国家公园。比耶霍峰也位于国家公园范围内,是加那利群岛第二高的火山,具有…… </information> |
| <think> 我发现泰德国家公园位于特内里费岛(西班牙加那利群岛)。现在我已经知道了泰德国家公园和加拉霍奈国家公园的位置。</think> |
| <answer> 西班牙加那利群岛 </answer> |
| 用于理解原文的只读背景(并非待翻译文本): |
| <answer> Ronald Ryan </answer> |
| 表20:SEARCH-R1 案例研究11(失败):LLM 可能被无关的检索信息误导并给出错误答案。 待翻译文本: 问题:谁执导了那部由 Steve Cochran 和《Bonanza》中饰演 Sheriff Roy Coffee 的演员共同主演的电影? 标准答案:Louis King SEARCH-R1: <think> 我需要查明谁执导了那部由 Steve Cochran 和《Bonanza》中饰演 Sheriff Roy Coffee 的演员共同主演的电影。我来搜索一下。 </think> <search> 谁执导了那部由 Steve Cochran 和《Bonanza》中饰演 Sheriff Roy Coffee 的演员共同主演的电影 </search> <information> 文档2(标题:“Ray Teal”)Ray Teal Ray Teal(1902年1月12日—1976年4月2日)是一位美国演员,在其37年的职业生涯中出演了250多部电影和约90个电视节目。他持续时间最长的角色是在NBC西部剧集《Bonanza》(1960—1972)中饰演Sheriff Roy Coffee。他还在电影《Ace in the Hole》(1951)中饰演过一名警长。Teal出生于密歇根州大急流城。作为一名萨克斯管演奏者,他在成为演员之前曾担任乐队领队,以此供自己读完加利福尼亚大学洛杉矶分校。在电影和早期电视领域表演了15年多之后,Teal获得了一个常驻…… </information> <think> 我发现《Bonanza》中饰演 Sheriff Roy Coffee 的演员是 Ray Teal。现在我需要找到那部由 Steve Cochran 和 Ray Teal 共同主演的电影。 </think> <search> 由 Steve Cochran 和 Ray Teal 共同主演的电影 </search> <information> 文档1(标题:“Steve Cochran”)在黑帮经典《White Heat》(1949)中。他与Mayo演对手戏。华纳兄弟最终会从Goldwyn手中接管Cochran和Mayo的合同。Cochran在《The Damned Don't Cry》(1950)中为Joan Crawford配戏,随后在《Highway 301》(1950)中获得他的第一个主角角色,饰演一名黑帮分子。他在《Dallas》(1950)中是Gary Cooper所饰英雄的反派,并在《Storm Warning》(1951)中与Ginger Rogers和Doris Day合作,饰演一名三K党成员。Cochran在西部片《Canyon Pass》(1951)中饰演反派,随后在《Inside the Walls of Folsom Prison》(1951)中获得主角角色,该片启发了…… <information> <think> 我发现 Steve Cochran 主演过几部电影。现在我需要找到那部也有 Ray Teal 主演的电影。 </think> <search> 由 Steve Cochran 和 Ray Teal 共同主演的电影 </search> <information> 文档1(标题:“Steve Cochran”)在黑帮经典《White Heat》(1949)中。他与Mayo演对手戏。华纳兄弟最终会从Goldwyn手中接管Cochran和Mayo的合同。Cochran在《The Damned Don't Cry》(1950)中为Joan Crawford配戏,随后在《Highway 301》(1950)中获得他的第一个主角角色,饰演一名黑帮分子。他在《Dallas》(1950)中是Gary Cooper所饰英雄的反派,并在《Storm Warning》(1951)中与Ginger Rogers和Doris Day合作,饰演一名三K党成员。Cochran在西部片《Canyon Pass》(1951)中饰演反派,随后在《Inside the Walls of Folsom Prison》(1951)中获得主角角色,该片启发了…… <information> <think> 我发现 Steve Cochran 主演过几部电影。现在我需要找到那部也有 Ray Teal 主演的电影。我来搜索那部由 Steve Cochran 和 Ray Teal 共同主演的电影。 </think> <search> 由 Sam Peckinpah 执导、由 Steve Cochran 和 Ray Teal 共同主演的电影 </search> <information> 文档1(标题:“Sam Peckinpah”)影片充满爆炸、追车和激烈枪战,成为Peckinpah迄今为止最大的商业成功,票房收入超过2500万美元。尽管这严格来说是一部商业作品,但Peckinpah的创作手法贯穿全片,尤其是在精心剪辑的开场段落中,当时McQueen的角色正承受着监狱生活的压力。这部电影仍然很受欢迎,并于1994年被翻拍,由Alec Baldwin和Kim Basinger主演。1973年标志着Peckinpah生活和职业生涯中最艰难时期的开始。当时他仍在德克萨斯州埃尔帕索拍摄《The Getaway》,Peckinpah偷偷越过边境…… </information> <think> 我发现 Sam Peckinpah 执导了由 Steve Cochran 和 Ray Teal 主演的电影《The Wild Bunch》。 </think> <answer> Sam Peckinpah </answer> |
| 用于理解原文的只读背景(非待翻译源文本): |
| <answer> Ronald Ryan </answer> |
| 表 20:SEARCH-R1 案例研究 11(失败):LLM 可能被无关的检索信息误导并给出错误答案。 |
| 待翻译文本: |
| 问题:发行 XXXTentacion 的单曲“Revenge”的公司位于哪里? |
| 标准答案:加利福尼亚州旧金山 |
| SEARCH-R1: |
| <think> 我需要找到发行 XXXTentacion 的单曲“Revenge”的公司。我来搜索一下。 </think> |
| <search> XXXTentacion 的单曲“Revenge”发行公司 </search> |
| <information> 文档 1(标题:“Revenge(XXXTentacion 混音带)”)Revenge(XXXTentacion 混音带)Revenge 是美国说唱歌手 XXXTentacion 的一张混音带,由 Empire Distribution 于 2017 年 5 月 16 日发行。它包含八首此前已发布的歌曲,这些歌曲曾在 XXXTentacion 的 SoundCloud 上可供流媒体播放。在此之前,其主打单曲“Look at Me”曾在美国“Billboard” Hot 100 上最高排名第 34 位。该混音带的主打单曲名为“Look at Me”,于 2015 年 12 月 31 日在 SoundCloud 上首播。这首歌后来于 2016 年 1 月 29 日作为单曲在 iTunes 上发布,之后又以重制和干净版再次以数字下载形式重新发布…… </information> |
| <think> 我发现发行 XXXTentacion 的单曲“Revenge”的公司是 Empire Distribution。现在我需要找到这家公司的所在地。 </think> |
| 问题:2008年杂志文章《Is Google Making Us Stoopid?》的扩展版入围了什么奖项? |
| 标准答案:普利策奖 |
| SEARCH-R1: |
| <think>我需要查明2008年杂志文章《Is Google Making Us Stoopid?》的扩展版入围了什么奖项。我来搜索一下。</think> |
| <search>2008年杂志文章《Is Google Making Us Stoopid?》的扩展版入围了什么奖项</search> |
| <information>文档1(标题:《Is Google Making Us Stupid?》)《Is Google Making Us Stupid?》 《Is Google Making Us Stupid?》 What the Internet Is Doing to Our Brains(又称《Is Google Making Us Stupid?》)是技术作家Nicholas G. Carr撰写的一篇杂志文章,对互联网对认知的影响持强烈批评态度。该文发表于2008年7/8月号的《The Atlantic》杂志,是一篇六页的封面报道。Carr的主要论点是,互联网可能对认知产生不利影响,削弱专注和沉思的能力。尽管标题如此,这篇文章并非专门针对Google,而更多是针对……的认知影响。</information> |
| <think>我发现2008年杂志文章《Is Google Making Us Stoopid?》的扩展版入围了某个奖项。我需要查明它入围的是哪个奖项。</think> |
| <search>2008年杂志文章《Is Google Making Us Stoopid?》的扩展版入围了哪个奖项</search> |
| <information>文档2(标题:《Is Google Making Us Stupid?》)……未有定论,并表示“还需要时间才能清楚我们是应该哀悼旧方式、庆祝新方式,还是学会不再担忧并爱上互联网”。《Is Google Making Us Stupid?》 《Is Google Making Us Stupid?》 What the Internet Is Doing to Our Brains(又称《Is Google Making Us Stupid?》)是技术作家Nicholas G. Carr撰写的一篇杂志文章,对互联网对认知的影响持强烈批评态度。该文发表于2008年7/8月号的《The Atlantic》杂志,是一篇六页的封面报道。Carr的主要论点是,互联网可能对认知产生不利影响,削弱专注和沉思的能力。尽管标题如此,这篇文章并非专门针对Google,而更多是针对……的认知影响。</information> |
| <answer>国家杂志奖</answer> |
| 理解源文本的只读背景(非待翻译源文本): <answer> Ronald Ryan </answer> 表20:SEARCH-R1案例研究11(失败):LLM可能被无关的检索信息误导并提供错误答案。 待翻译文本: |
| 问题:谁是钢琴家,Maro Ajemian还是Richard C. Sarafian? 真实答案:Maro Ajemian SEARCH-R1:<think>我需要确定Maro Ajemian或Richard C. Sarafian中谁是钢琴家。我将搜索一下。</think><search>谁是钢琴家,Maro Ajemian还是Richard C. Sarafian</search><information>文档1(标题:“Maro Ajemian”)Maro Ajemian Maro Ajemian(1921年7月9日–1978年9月18日)是一位美国钢琴家。Ajemian在当代音乐领域的职业生涯源于她的亚美尼亚血统。她在美国首演了阿拉姆·哈恰图良的《钢琴协奏曲》后,作为当代钢琴家为人所知;她选择演奏这部作品是基于他们共同的亚美尼亚血统。Ajemian曾就读于茱莉亚音乐学院。1942年3月14日,她与阿尔伯特·施托塞尔指挥的茱莉亚研究生乐团合作,在美国首演了阿拉姆·哈恰图良的降D大调《钢琴协奏曲》。她后来在一次全国巡演中演奏了这部作品。在她演奏了……之后</information><think>我发现Maro Ajemian是一位钢琴家。现在我需要核实Richard C. Sarafian是否是钢琴家。</think><search>Richard C. Sarafian是谁</search><information>文档1(标题:“Richard C. Sarafian”)Richard C. Sarafian Richard Caspar Sarafian(1930年4月28日–2013年9月18日)是一位美国电视和电影导演及演员。他在五十多年的职业生涯中作为导演、演员和作家建立了多方面的职业经历。Sarafian最著名的是作为1971年电影“”的导演。Sarafian于1930年4月28日出生在纽约市,父母是亚美尼亚移民。他在纽约大学学习过法律预科和医学预科,是个差生,但后来转向学习电影,并在该领域表现出色。他离开大学加入美国陆军,在……</information><think>我发现Richard C. Sarafian是一位电视和电影导演及演员。现在我可以将其与曾是钢琴家的Maro Ajemian进行比较。</think><answer>Maro Ajemian</answer> 表17:SEARCH-R1案例研究8(成功):SEARCH-R1能够编写查询以搜索信息不足的内容。 |
| 用于理解原文的只读背景(非待翻译文本): <answer> Ronald Ryan </answer> 表20:SEARCH-R1案例研究11(失败):LLM可能会被不相关的检索信息误导并提供错误答案。 待翻译文本: 问题:Jed Hoyer和John William Henry II谁年纪更大? 真实答案:John William Henry II |
| SEARCH-R1:<think> 我需要判断Jed Hoyer和John William Henry II谁年纪更大。我会去搜索他们的年龄。</think><search> Jed Hoyer或John William Henry II </search><information> 文档1(标题:“Jed Hoyer”)与Sam Elias和Nick Miceli一起创下职业生涯救援纪录。在卫斯理大学期间,他还被接纳为Delta Kappa Epsilon的成员,并且是其兄弟会成员。1995年夏天,他进入新英格兰大学棒球联盟的Waterbury Barons名单,在投手丘和游击手位置都有出场。Hoyer曾在招生办公室工作,之后又在校友/发展办公室工作,毕业后还在该校担任棒球教练。他在28岁加入红袜队之前,曾在Kenyon College的招生部门工作。他于2010年6月与Merrill Muckerman结婚,地点在…… </information><think> 我发现Jed Hoyer是一个人。现在我需要找到他的年龄,并将其与John William Henry II的年龄进行比较。</think><search> John William Henry II </search><information> 文档1(标题:“John W. Henry”)该公司管理层所管理的资产已从2006年的25亿美元下降到2012年末的不到1亿美元。截至2017年7月,“Forbes”估计他的净资产为26亿美元。John William Henry II于1949年9月13日出生在伊利诺伊州昆西。他的父母是大豆农场主,他在成长过程中往返于伊利诺伊州和阿肯色州之间。他15岁时的哮喘病情促使全家搬到加利福尼亚州苹果谷。从维克多维尔的Victor Valley High School毕业后,他先就读于Victor Valley College,之后进入加利福尼亚大学(河滨分校…… </information><think> 我发现John William Henry II出生于1949年9月13日。现在我需要找到Jed Hoyer的出生年份来进行比较。</think><search> Jed Hoyer出生年份 </search><information> 文档1(标题:“Jed Hoyer”)与Sam Elias和Nick Miceli一起创下职业生涯救援纪录。在卫斯理大学期间,他还被接纳为Delta Kappa Epsilon的成员,并且是其兄弟会成员。1995年夏天,他进入新英格兰大学棒球联盟的Waterbury Barons名单,在投手丘和游击手位置都有出场。Hoyer曾在招生办公室工作,之后又在校友/发展办公室工作,毕业后还在该校担任棒球教练。他在28岁加入红袜队之前,曾在Kenyon College的招生部门工作。他于2010年6月与Merrill Muckerman结婚,地点在…… </information><think> 我发现Jed Hoyer出生于1973年12月7日。现在我可以将他的出生年份与John William Henry II的出生年份进行比较。</think><answer> John William Henry II </answer> |
| 用于理解原文的只读背景(非待翻译源文本): <answer> Ronald Ryan </answer> 表20:SEARCH-R1案例研究11(失败):LLM可能会被无关的检索信息误导并提供错误答案。 待翻译文本: 问题:The world's greatest Super-Heroes anthology showcased one of four superheroes known for speaking the phrase "SHAZAM",他们的名字是什么? 标准答案:Captain Marvel SEARCH-R1: <think> 我需要找出以说出短语"SHAZAM"而闻名的四位超级英雄中一位的名字。我会去搜索一下。</think> <search> The world's greatest Super-Heroes anthology showcased one of four superheroes known for speaking the phrase "SHAZAM" </search> <information> 文档1(标题:"Shazam! (TV series)")Shazam!(电视剧)Shazam!是一部半小时的真人电视节目,由Filmaton制作(该工作室的首个此类节目),改编自Fawcett Comics漫画系列Whiz Comics(现归DC Comics所有)中的超级英雄Captain Marvel,也被称为Shazam。该节目由Michael Gray主演Billy Batson,一个可以通过说出魔法词"Shazam!"变身为超级英雄Captain Marvel的少年,Captain Marvel最初由Jackson Bostwick饰演,后来由John Davey饰演。Billy和他的监护人"Mentor"(Les Tremayne)乘坐一辆1973年的Dodge Open Road房车周游全国,寻找需要伸张正义的事情。……</information> <think>我了解到The world's greatest Super-Heroes anthology展示了以说出短语"SHAZAM"而闻名的四位超级英雄中的一位。现在我需要找出他们的名字。</think> <search> four superheroes known for speaking the phrase "SHAZAM" </search> <information> 文档1(标题:"Captain Marvel (DC Comics)")Captain Marvel(DC Comics)Captain Marvel,也被称为Shazam(),是一位虚构的漫画超级英雄,出现在美国出版商DC Comics的出版物中。艺术家C. C. Beck和作家Bill Parker于1939年创作了这个角色。Captain Marvel首次出现在Fawcett Comics出版的"Whiz Comics"第2期(封面日期为1940年2月)。他是Billy Batson的另一重身份,这个男孩通过说出魔法词"SHAZAM"(六位"不朽长老"的首字母缩写:Solomon、Hercules、Atlas、Zeus、Achilles和Mercury),可以变身为一个拥有超人力气、速度、飞行等能力的穿着战服的成年人……</information> <think>我了解到以说出短语"SHAZAM"而闻名的四位超级英雄之一是Captain Marvel(也被称为Shazam)。现在我需要找出另外三位超级英雄。</think> <search> other three superheroes known for speaking the phrase "SHAZAM" </search> <information> 文档2(标题:"Fawcett Comics")Fawcett Comics Fawcett Comics是Fawcett Publications的一个部门,是20世纪40年代漫画黄金时代几家成功的漫画出版商之一。其最受欢迎的角色是Captain Marvel,即电台记者Billy Batson的另一重身份,每当他说出魔法词"Shazam!"时就会变身为这位英雄。Fawcett出版的其他角色包括Captain Video、Hopalong Cassidy、Ibis the Invincible、Bulletman和Bulletgirl、Spy Smasher、Captain Midnight、Phantom Eagle、Mister Scarlet和Pinky、Minute-Man、Commando Yank和Golden Arrow。除了较为知名的超级英雄漫画外,Fawcett还出版了一系列短暂的……</information> <think>我了解到以说出短语"SHAZAM"而闻名的四位超级英雄之一是Captain Marvel(也被称为Shazam)。现在我需要找出另外三位超级英雄。我会去搜索他们。</think> <search> other three superheroes known for speaking the phrase "SHAZAM" </search> <information> 文档3(标题:"Captain Marvel (DC Comics)")交叉事件系列。他是Earth-3的Alexander Luthor的超级能力另一重身份。在故事中,Crime Syndicate(Justice League的邪恶Earth-3对应者)将他们囚禁的Alexander Luthor带到Justice League和其他英雄居住的Prime Earth。Prime Earth的Lex Luthor和他的团队潜入Justice League Watchtower,Syndicate将Alexander扣为人质,他们撕掉Alexander嘴上的胶带,让Alexander说出魔法词"Mazahs!"并变身为他肌肉发达、极其强大的另一重身份。虽然Prime Earth的Shazam以分享他的力量而闻名……</information> <think>我了解到以说出短语"SHAZAM"而闻名的四位超级英雄之一是Captain Marvel(也被称为Shazam)。另外三位超级英雄未在搜索结果中提及。我将根据现有信息提供答案。</think> <answer> Captain Marvel </answer> |
表20:SEARCH-R1 案例研究11(失败):LLM 可能被无关的检索信息误导并提供错误答案。
问题:在《The Rap Game》的哪一季中,有一位参赛者将 Lady Lesharr 列为她的影响者之一,而该季的获胜者是谁?
真实答案:Mani
SEARCH-R1:<think> 我需要找出《The Rap Game》中有一位参赛者将 Lady Lesharr 列为她的影响者之一的那一季的获胜者。我来搜索一下。 </think>
<search> 《The Rap Game》中有一位参赛者将 Lady Lesharr 列为她的影响者之一的那一季的获胜者是谁 </search>
<information> 文档1(标题:“Lady Lesharr”)Lesharr 于2018年9月公开自己是泛性恋。Lesharr 曾提到 Ashley Walters、Lisa Maffia、Missy Elliott 和 Lil Wayne 是她的主要影响者。Lady Lesharr,本名 Melesha Katrina O'Garro(生于1989年12月15日),职业上以 Lady Lesharr 之名闻名,是一位来自英国索利赫尔 Kingshurst 的英国 grime 与嘻哈说唱歌手、歌手和制作人。她最出名的是她的“Queen's Speech”系列自由说唱,其中第四首在2016年走红。《The Rap Game》第二季参赛者 Nia Kay 表示,由于 Lesharr 的独特性和说唱技巧,她是自己的影响者之一。她随后的自由说唱,…… </information>
<think> 我发现 Lady Lesharr 是《The Rap Game》第二季中 Nia Kay 的影响者之一。现在我需要找出那一季的获胜者。 </think>
<search> 《The Rap Game》第二季的获胜者 </search> <information> 文档1(标题:“Chandra Davis”)Chandra Davis Chandra Davis(1978年1月2日出生于密歇根州底特律),又名 London Charles 和 Deelishis,是一位美国模特,也是前真人秀参赛者。她最出名的是作为 VH1 热门真人秀《Flavor of Love 2》的获胜者。Davis 曾参加 VH1《Flavor of Love》第二季(时年29岁)。当 Flavor Flavor 选择她而不是 Tiffany ‘New York’ Pollard 时,她赢得了比赛,后者此前在该节目第一季被评为亚军后又回归。在 FOL 之后,Davis 通过 VH1 特别节目宣布她目前没有和 Flavor 约会,…… </information>
<think> 我发现《The Rap Game》第二季的获胜者是伦敦·查尔斯(Chandra Davis)。现在我可以提供答案了。 </think>
<answer> London Charles </answer>