Niklas Muennighoff 等
一千条精选样本,加上对思考 token 的硬性上限,就能让小模型超过更大的推理系统。2025 年论文,全文免费在线阅读。
s1: Simple test-time scaling Niklas Muennighoff 1 3 4 ^{}1^{3}4 1 3 4 Zitong Yang 1 ^{}1 1 Weijia Shi 2 3 ^{}2^{3} 2 3 Xiang Lisa Li 1 ^{}1 1 Li Fei-Fei 1 ^{1} 1 Hannaneh Hajishirzi 2 3 ^{2}3 2 3 Luke Zettlemoyer 2 ^{2} 2 Percy Liang 1 ^{1} 1 Emmanuel Candès 1 ^{1} 1 Tatsunori Hashimoto 1 ^{1} 1
查看原页 测试时扩展是一种前景广阔的语言建模新方法,它利用额外的测试时计算来提升性能。最近,OpenAI的o1模型展示了这一能力,但并未公开其方法论,从而引发了大量复现工作。我们寻求实现测试时扩展和强推理性能的最简单方法。首先,我们策划了一个小型数据集s1K,包含1,000个问题及配对的推理轨迹,其依据是我们通过消融实验验证的三项标准:难度、多样性和质量。其次,我们开发了预算强制(budget forcing)来控制测试时计算,方法是在模型试图结束时强制终止其思考过程,或通过多次追加“Wait”来延长其思考过程。这可以引导模型复查其答案,常常修正错误的推理步骤。在s1K上对Qwen2.5-32B-Instruct语言模型进行监督微调并为其配备预算强制后,我们的模型s1-32B在竞赛数学问题上超越o1-preview最多达 27 % 27\% 27% (MATH和AIME24)。此外,通过预算强制扩展s1-32B,可以外推超越其在无测试时干预下的性能:在AIME24上从 50 % 50\% 50% 提升至 57 % 57\% 57% 。我们的模型、数据和代码已在https://github.com/simplescaling/s1开源。
查看原页 过去几年,语言模型(LMs)的性能提升在很大程度上依赖于使用大规模自监督预训练来扩大训练时计算(Kaplan et al., 2020; Hoffmann et al., 2022)。这些强大模型的创建为建立在其之上的新扩展范式奠定了基础:测试时扩展。这种方法旨在
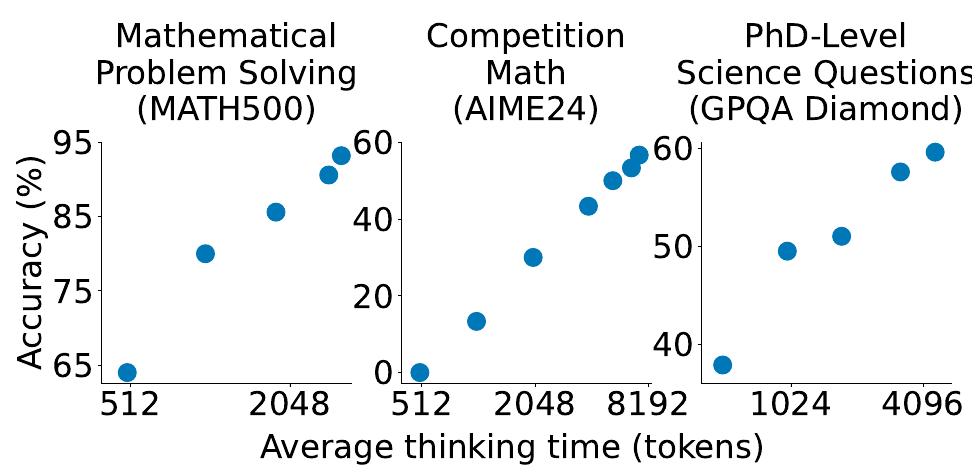
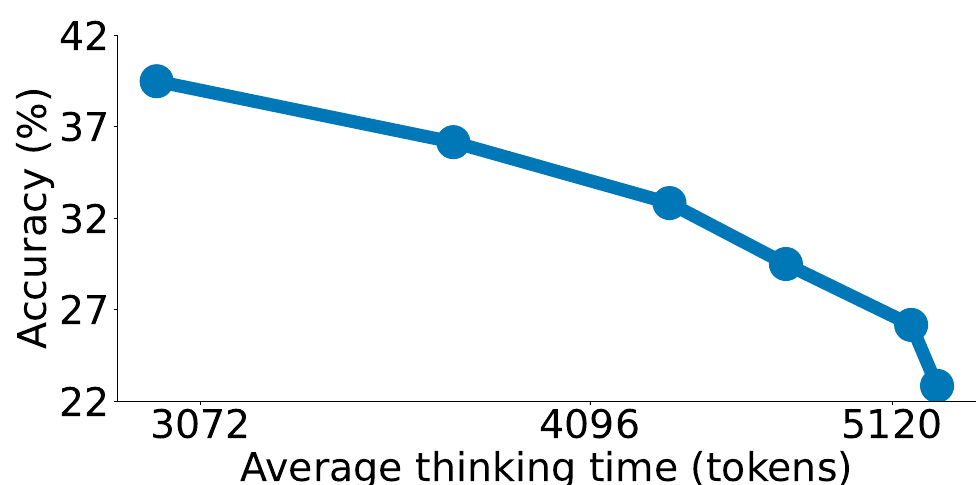
查看原页 查看原页 图1. 使用s1-32B进行测试时扩展。我们在推理密集型任务上对s1-32B进行基准测试,并改变测试时计算量。 查看原页 增加测试时的计算量以获得更好的结果。已有大量工作探索这一想法(Snell et al., 2024; Welleck et al., 2024),而这一范式的可行性最近得到了OpenAI o1的验证(OpenAI, 2024)。o1已展示出强大的推理性能,并且随着测试时计算的扩展而持续获得增益。OpenAI将其方法描述为使用大规模强化学习(RL),这意味着使用了大量数据(OpenAI, 2024)。这导致了各种复现其模型的尝试,依赖于蒙特卡洛树搜索(Gao et al., 2024b; Zhang et al., 2024a)、多智能体方法(Qin et al., 2024)等技术(Wang et al., 2024a; Huang et al., 2024b; 2025)。在这些方法中,DeepSeek R1(DeepSeek-AI et al., 2025)成功复现了o1级别的性能,同样通过数百万样本和多个训练阶段采用了强化学习。然而,尽管有大量o1复现尝试,但没有一个公开复现了清晰的测试时扩展行为。因此,我们提问:实现测试时扩展和强推理性能的最简单方法是什么? 我们表明,仅使用1,000个样本进行下一词元预测训练,并通过一种我们称为预算强制的简单测试时技术控制思考时长,就能得到一个强推理模型,其性能随更多测试时计算而扩展。具体而言,我们构建了s1K,它包含1,000个精心策划的问题,配以从Gemini Thinking Experimental(Google, 2024)蒸馏出的推理轨迹和答案。我们在这一小型数据集上对现成的预训练模型进行监督微调(SFT) ,仅需在16块H100 GPU上训练26分钟。训练后,我们使用预算强制来控制模型花费的测试时计算量:(I)如果模型生成的思考词元超过期望限制,我们通过追加思考结束词元分隔符来强制结束思考过程。以这种方式结束思考会使模型过渡到生成其答案。(II)如果我们希望模型在一个问题上花费更多测试时计算,我们抑制思考结束词元分隔符的生成,转而向模型当前的推理轨迹追加“Wait”,以鼓励更多探索。凭借这一简单配方——在1,000个样本上进行SFT以及测试时预算强制——我们的模型s1-32B展现出了测试时扩展(图1)。此外,s1-32B是样本效率最高的推理模型,并且优于OpenAI的o1-preview等闭源模型(图2)。
我们进行了广泛的消融实验,针对(a)我们对1,000(1K)个推理样本的选择以及(b)我们的测试时扩展。对于(a),我们发现将难度、多样性和质量度量共同纳入我们的选择算法非常重要。随机选择、选择推理轨迹最长的样本,或仅选择最大程度多样化的样本,都会导致性能显著变差(在AIME24上平均约 − 30 % - 30\% − 30% )。在我们完整的59K示例数据池(s1K的超集)上训练,与我们的1K选择相比并未带来实质性增益。这凸显了仔细数据选择的重要性,并呼应了先前关于指令微调的发现(Zhou et al., 2023)。对于(b),我们定义了测试时扩展方法的理想属性以比较不同方法。预算强制带来了最佳的扩展效果,因为它具有完美的可控性,且具有清晰的上升斜率,从而带来强劲性能。
查看原页 总之,我们的贡献是:我们开发了用于创建样本高效推理数据集(§2)和测试时扩展(§3)的简单方法;基于这些方法,我们构建了s1-32B,其性能可与o1-preview相竞争(§4);我们消融了数据(§5.1)和测试时扩展(§5.2)的细微之处。我们以一段讨论结尾,以激励未来关于简单推理的工作(§6)。我们的代码、模型和数据已在https://github.com/simplescaling/s1开源。
查看原页 在本节中,我们描述创建大型数据集的过程,首先在§2.1中,然后在§2.2中将其筛选至s1K。
查看原页 我们遵循三项指导原则从16个来源收集了初始的59,029个问题。质量:数据集应高质量;我们始终检查样本,并忽略例如格式较差的数据集;难度:数据集应具有挑战性并需要大量推理努力;多样 性:数据集应来自不同领域,以覆盖不同的推理任务。我们收集两类数据集:
查看原页 现有数据集的策划 我们最大的来源是NuminaMATH(LI et al., 2024),包含来自在线网站的30,660个数学问题。我们还包括历史AIME问题(1983-2021)。为增强多样性,我们加入了OlympicArena(Huang et al., 2024a),包含来自各种奥林匹克竞赛的4,250个问题,涵盖天文学、生物学、化学、计算机科学、地理、数学和物理学。OmniMath(Gao et al., 2024a)增加了4,238个竞赛级数学问题。我们还包括来自AGIEval(Zhong et al., 2023)的2,385个问题,其特色是来自SAT和LSAT等标准化考试的题目,涵盖英语、法律和逻辑。我们的其他来源见§C中的表7。
查看原页 定量推理中的新数据集 为补充这些现有数据集,我们创建了两个原创数据集。s1-prob由斯坦福大学统计系博士资格考试(https://statistics.stanford.edu)概率部分的182个问题组成,并附有涵盖困难证明的手写解答。概率资格考试每年举行一次,需要专业级别的数学问题求解能力。s1-teasers包含23个具有挑战性的脑筋急转弯,常用于量化交易职位的面试题。每个样本由取自PuzzledQuant(https://www.puzzledquant.com/)的问题和解答组成。我们只取难度最高级别(“Hard”)的示例。
查看原页 对于每个问题,我们使用Google Gemini Flash Thinking API(Google, 2024)生成推理轨迹和解答,提取其推理轨迹和响应。这产生了59K个由问题、生成的推理轨迹和生成的解答组成的三元组。我们数据集中的示例见§D.2。我们使用8-gram将所有样本与我们的评估问题(MATH500、GPQA Diamond、AIME24;§C.5)进行去污染,并对数据去重。
查看原页 我们原本可以直接在59K问题的池子上进行训练,然而,我们的目标是找到资源最少的最简单方法。因此,我们经过三个阶段的筛选,依靠我们的三条指导数据原则:质量、难度和多样性,得出一个仅含1,000个样本的最小集合。
查看原页 质量 我们首先移除所有遇到API错误的问题,将数据集缩减至54,116个样本。接下来,我们通过检查是否存在任何格式问题的字符串模式(如ASCII艺术图、不存在的图像引用或不一致的问题编号)来过滤掉低质量示例,将数据集缩减至51,581个示例。
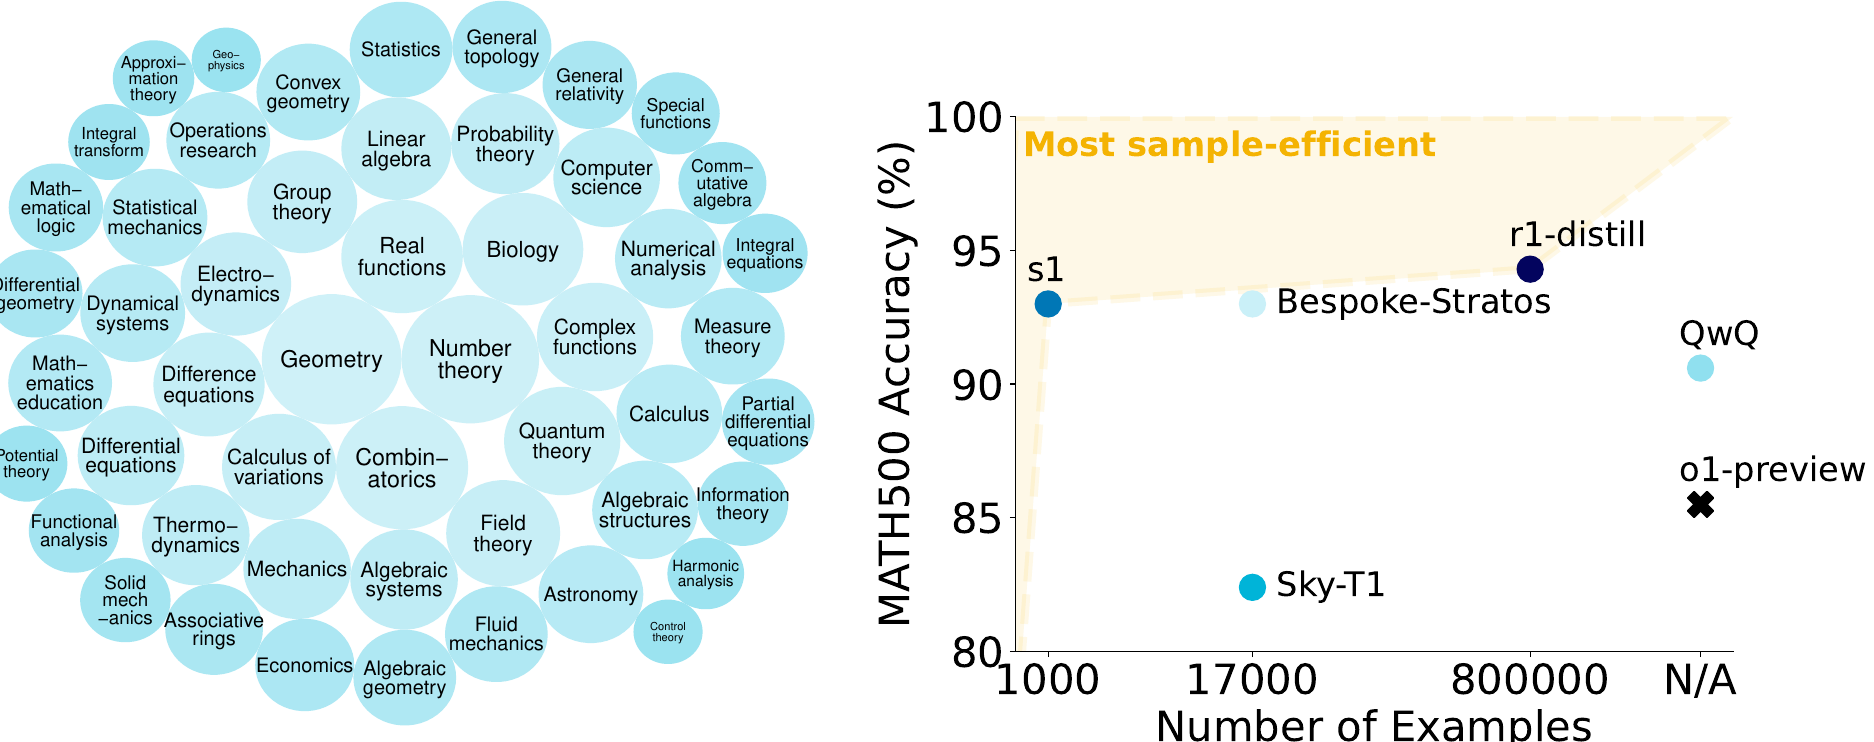
查看原页 查看原页 图2. s1K与s1-32B。(左)s1K是一个包含1,000个高质量、多样且困难问题及其推理轨迹的数据集。(右)s1-32B是一个在s1K上微调的32B参数模型,处于样本效率前沿。其他模型的详细信息见表1。 查看原页 从这个池子中,我们从自认为高质量且无需进一步过滤的数据集中识别出384个样本,用于最终1,000个样本(详见§C.4)。
查看原页 难度 对于难度,我们使用两个指标:模型性能和推理轨迹长度。我们对每个问题评估两个模型:Qwen2.5-7B-Instruct和Qwen2.5-32B-Instruct(Qwen et al., 2024),正确性由Claude 3.5 Sonnet将每次尝试与参考解决方案进行比较来评估(见§C.3的评分协议)。我们使用Qwen2.5分词器测量每条推理轨迹的token长度,以指示问题难度。这基于一个假设:更难的问题需要更多的思考token。根据评分,我们移除Qwen2.5-7B-Instruct或Qwen2.5-32B-Instruct能够正确解决的问题,因此这些问题可能过于简单。通过使用两个模型,我们降低了因其中一个模型在简单问题上罕见出错而导致简单样本溜过筛选的可能性。这将我们的总样本数降至24,496,为下一轮基于多样性的子采样奠定基础。虽然使用这两个模型进行过滤可能针对我们的设置进行了优化,因为我们也将使用Qwen2.5-32B-Instruct作为微调模型,但基于模型的过滤思想可推广到其他设置。
查看原页 多样性 为了量化多样性,我们使用Claude 3.5 Sonnet根据美国数学学会的数学主题分类(MSC)系统(例如几何、组合数学等)将问题分类到不同领域。 1 该分类法侧重于数学主题,但也包括生物学、物理学和经济学等其他科学。为了从24,496个问题的池子中选择最终示例,我们首先均匀随机选择一个领域。然后,我们根据偏向较长推理轨迹的分布从该领域采样一个问题(详见§C.4),其动机如“难度”部分所述。我们重复此过程,直到获得跨越50个领域的1,000个总样本。
查看原页 在第5.1节中,我们将展示将我们的三个标准结合使用是重要的,因为仅孤立地依赖质量、多样性或难度会导致数据集变差。一些蒸馏生成的样本是不正确的,我们在数据中允许这种情况,因为我们关注的是捕捉推理过程,而非完全正确的解答。我们的评分器(§C.3)判定s1K中有53.6%正确,在我们的后续s1K-1.1中为63.0%(见§A)。
查看原页 我们将测试时扩展方法分类为1)串行,即后续计算依赖于先前的计算(例如,长推理轨迹),以及2)并行,即计算独立运行(例如,多数投票)(Snell et al., 2024; Brown et al., 2024)。我们专注于串行扩展,因为直觉上我们认为它应该扩展得更好,因为后续计算可以建立在中间结果之上,从而实现更深的推理和迭代改进。我们提出了新的串行扩展方法及其基准测试方式。
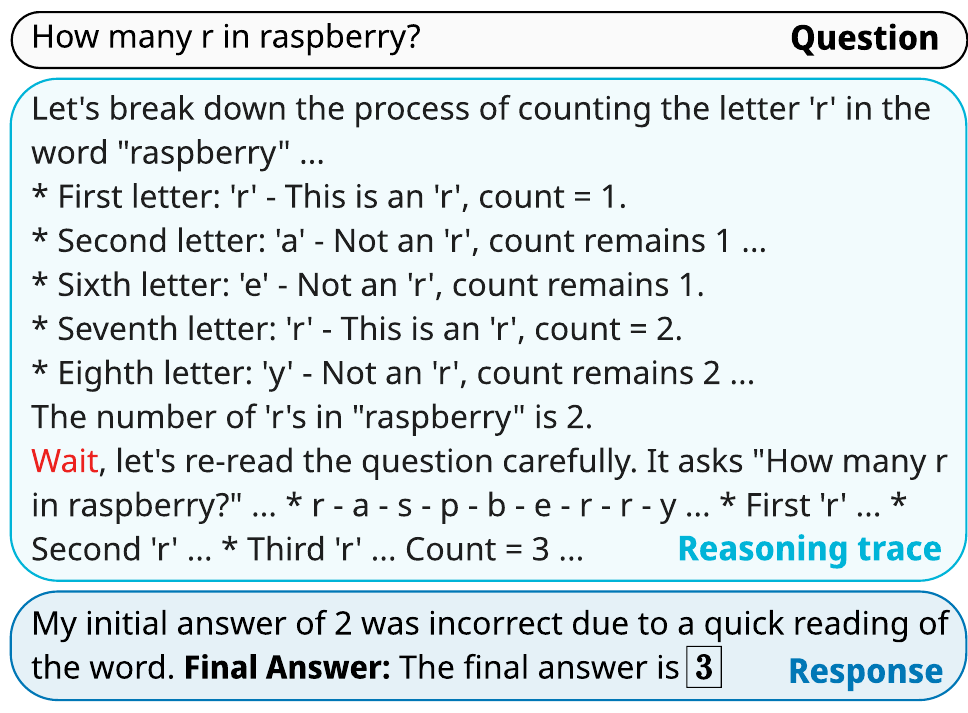
查看原页 预算强制 我们提出一种简单的解码时干预方法,通过强制设定思考token的最大和/或最小数量。具体而言,我们通过简单地追加思考结束token定界符以及可选的“Final Answer:”来强制最大token数,从而提前退出
查看原页 查看原页 图3. 使用s1-32B进行预算强制。模型在“……是2。”之后试图停止,但我们抑制了思考结束的标记分隔符,改为追加“等等”,导致s1-32B自我修正其答案。 查看原页 思考阶段并使模型提供其当前最佳答案。为了强制最小值,我们抑制思考结束token定界符的生成,并可选地在模型当前推理轨迹后追加字符串“Wait”,以鼓励模型反思其当前生成内容。图3包含了一个示例,展示了这种简单方法如何引导模型得出更好的答案。
基线 我们使用以下方法对预算强制进行基准测试:(I)条件长度控制方法,依赖于在提示中告诉模型应生成多长时间。我们按粒度将其分组为(a)Token条件控制:我们在提示中指定思考token的上限;(b)步骤条件控制:我们指定思考步骤的上限,其中每一步大约100个token;(c)类别条件控制:我们编写两个通用提示,告诉模型要么短时间思考,要么长时间思考(详见§E.1)。(II)拒绝采样,即采样直到某次生成符合预定的计算预算。该预言机捕捉了以长度为条件的响应的后验分布。
查看原页 我们建立了一组期望属性作为评估指标,以衡量不同方法的测试时扩展。重要的是,我们不仅关心一种方法所能达到的准确率,还关心其可控性和测试时扩展斜率。对于我们所考虑的每种方法,我们在固定基准(例如AIME24)上运行一组评估 a ∈ A a \in \mathcal{A} a ∈ A ,改变测试时计算量。这产生一个分段线性函数 f f f ,以思考token为x轴衡量计算量,以准确率为y轴(见图1,其中AIME24最右侧的点对应 f ( 7320 ) = 57 % f(7320) = 57\% f ( 7320 ) = 57% )。我们衡量 三个指标:
查看原页 C o n t r o l = 1 ∣ A ∣ ∑ a ∈ A I ( a min ≤ a ≤ a max ) ( 1 ) \mathrm{Control} = \frac{1}{|\mathcal{A}|}\sum_{a\in \mathcal{A}}\mathbb{I}(a_{\min}\leq a\leq a_{\max}) \quad (1) Control = ∣ A ∣ 1 a ∈ A ∑ I ( a m i n ≤ a ≤ a m a x ) ( 1 ) 查看原页 其中 a min , a max a_{\min}, a_{\max} a m i n , a m a x 指预先指定的测试时计算量的最小值和最大值;在我们的情况下即思考token。我们通常只约束 a max a_{\max} a m a x 。由于生成的token对应于所花费的测试时计算量,该指标衡量一种方法在多大程度上允许对该测试时计算量的使用进行控制。我们以百分比形式报告, 100 % 100\% 100% 表示完全控制。
查看原页 S c a l i n g = 1 ( ∣ A ∣ 2 ) ∑ a , b ∈ A b > a f ( b ) − f ( a ) b − a ( 2 ) \mathrm{Scaling} = \frac{1}{\binom{|\mathcal{A}|}{2}}\sum_{\substack{a,b\in\mathcal{A}\\b>a}}\frac{f(b) - f(a)}{b - a} \quad (2) Scaling = ( 2 ∣ A ∣ ) 1 a , b ∈ A b > a ∑ b − a f ( b ) − f ( a ) ( 2 ) 查看原页 扩展是分段线性函数的平均斜率。对于有用的方法,它必须为正,且越大越好。
查看原页 P e r f o r m a n c e = max a ∈ A f ( a ) ( 3 ) \mathrm{Performance} = \max_{a\in \mathcal{A}}f(a) \quad (3) Performance = a ∈ A max f ( a ) ( 3 ) 查看原页 性能是该方法在基准上达到的最大性能。具有单调递增扩展的方法在极限情况下可在任何基准上达到 100 % 100\% 100% 的性能。然而,我们所研究的方法最终会趋于平缓,或由于控制或上下文窗口的限制而进一步扩展失败。
查看原页 训练 我们使用s1K对Qwen2.5-32B-Instruct进行监督微调,使用§D中概述的基本超参数获得我们的模型s1-32B。微调在16块NVIDIA H100 GPU上使用PyTorch FSDP耗时26分钟。
查看原页 评估 我们选择了该领域广泛使用的三个代表性推理基准:AIME24(of America, 2024)包含30道题目,这些题目曾用于2024年1月31日至2月1日举行的2024年美国数学邀请赛(AIME)。AIME测试涵盖算术、代数、计数、几何、数论、概率及其他中学数学主题的数学问题解决能力。在测试中得分高的高中生被邀请参加美国数学奥林匹克(USAMO)。所有AIME答案均为从000到999(含)的整数。部分AIME题目依赖于图形,我们使用矢量图形语言Asymptote提供给模型,因为它无法接受图像输入。MATH500(Hendrycks et al., 2021)是一个由不同难度竞赛数学题组成的基准。我们在先前工作中OpenAI选择的相同500个样本上进行评估(Lightman et al., 2023)。GPQA Diamond(Rein et al., 2023)包含198道来自生物学、化学和物理学的博士级科学问题
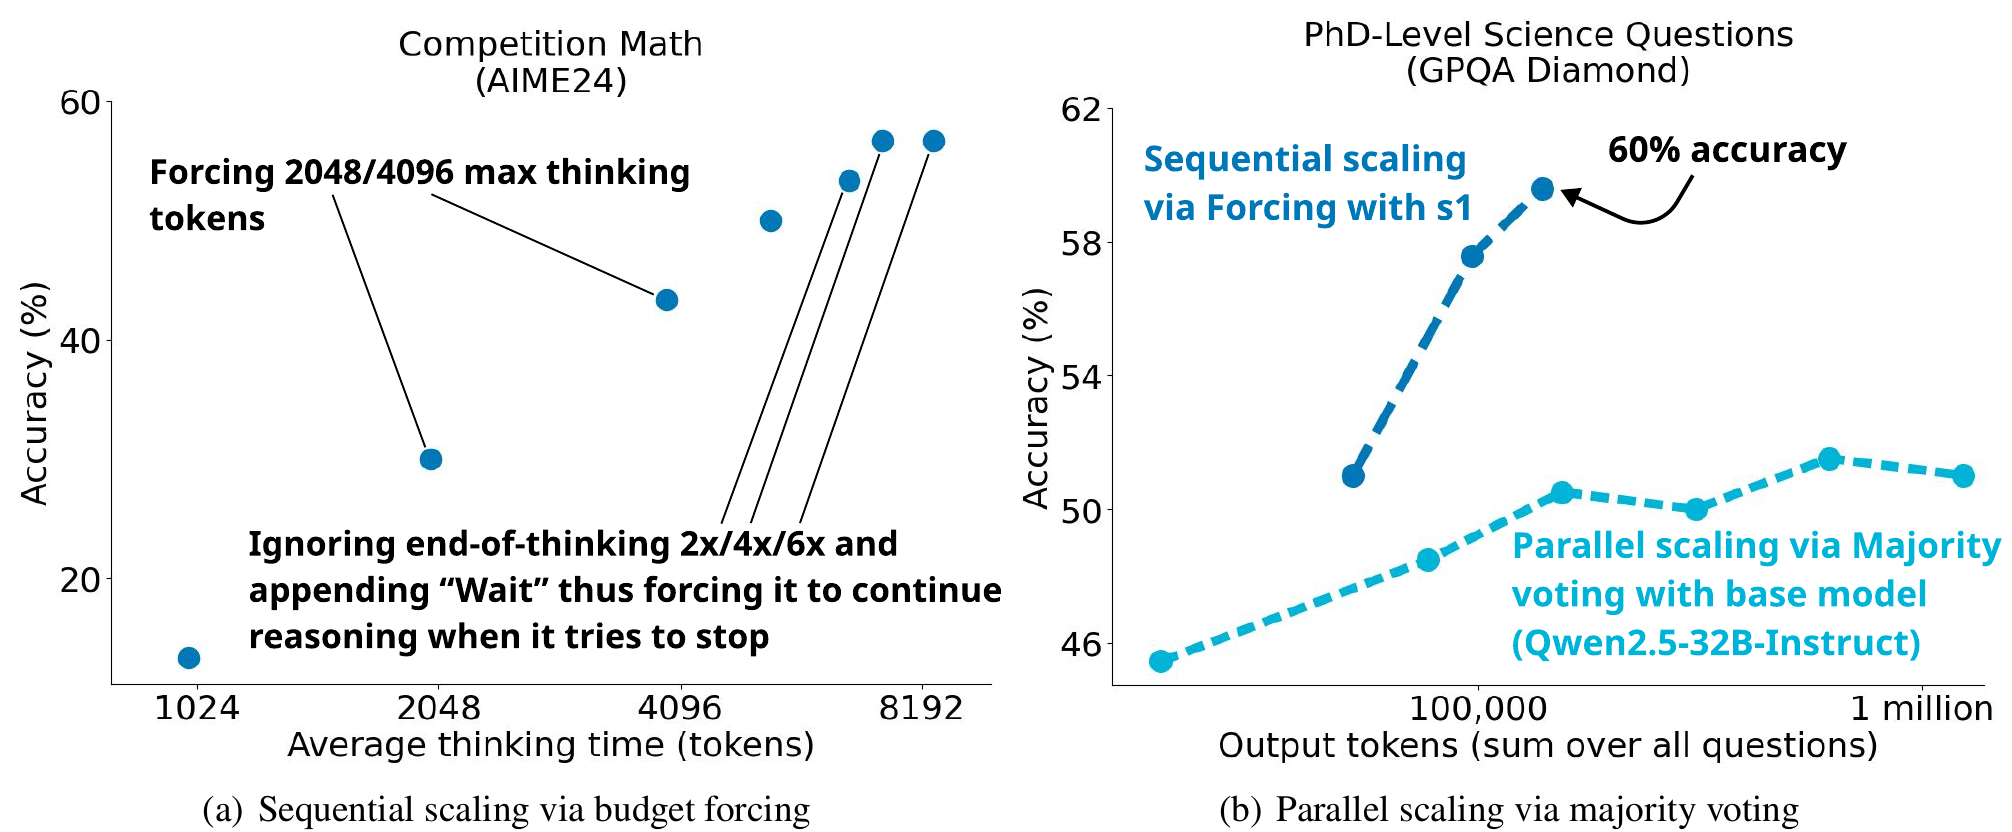
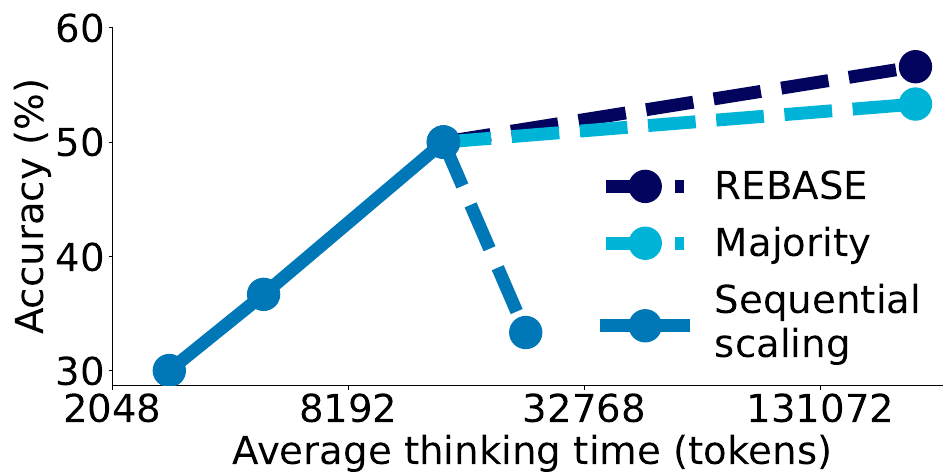
查看原页 查看原页 图4. 顺序与并行测试时扩展。(a):预算强制显示出清晰的扩展趋势,并在一定程度上可外推。对于最右侧的三个点,我们阻止模型停止其思考2/4/6次,每次都在其当前推理轨迹后附加“Wait”。(b):对于Qwen2.5-32B-Instruct,我们对每个样本以温度为1进行64次评估,并可视化在其中2、4、8、16、32和64个样本上进行多数投票时的性能。 查看原页 。拥有相应领域博士学位的专家在GPQA Diamond上仅达到 69.7 % 69.7\% 69.7% (OpenAI, 2024)。当我们在本工作的评估语境中写“GPQA”时,我们始终指Diamond子集。我们基于“lm-evaluation-harness”框架(Gao et al., 2021; Biderman et al., 2024)构建。除非另有说明,我们以温度0(贪婪)进行评估并衡量准确率(等同于pass@1)。
其他模型 我们将s1-32B与以下模型进行基准比较:OpenAI o1系列(OpenAI, 2024),即推广了测试时扩展的闭源模型;DeepSeek r1系列(DeepSeek-AI et al., 2025),即具有最高达到o1级别性能的开源权重推理模型;Qwen的QwQ-32B-preview(Team, 2024),一个未公开方法的32B开源权重推理模型;Sky-T1-32B-Preview(Team, 2025)和Bespoke-32B(Labs, 2025),即从QwQ-32B-preview和r1蒸馏而来、具有开放推理数据的开放模型;Google Gemini 2.0 Flash Thinking Experimental(Google, 2024),即我们从中蒸馏的API。由于其没有官方评估分数,我们使用Gemini API自行对其进行基准测试。然而,Gemini API的“背诵错误”使评估具有挑战性。2 我们通过在其网页界面中手动插入所有30道AIME24题目来规避此问题,因为该界面不会出现该错误。然而,我们省略了MATH500(500题)和GPQA Diamond(198题),因此它们在表1中为N.A.。我们的模型s1-32B完全开放,包括权重、推理数据和代码。
查看原页 表1. s1-32B是一个强大的开放推理模型。我们评估了s1-32B、Qwen和Gemini(部分条目未知(N.A.),见 § 4 \S 4 §4 )。其他结果来自各自的报告(Qwen et al., 2024; Team, 2024; OpenAI, 2024; DeepSeek-AI et al., 2025; Labs, 2025; Team, 2025)。# ex. = 用于推理微调的示例数量;BF = 预算强制。关于我们更好的s1.1模型,见 § A \S \mathrm{A} § A 。 查看原页 s1 w/o Bf⁺ 1K 50.0 92.6 56.6 s1-32B 1K 56.7 93.0 59.6
查看原页 测试时扩展 图1展示了s1-32B在预算强制下随着更多测试时计算而扩展的性能。在图4(左)中,我们扩展了图1(中)的图,表明虽然我们可以使用预算强制技术(§3)和更多测试时计算来提高AIME24性能,但它最终在六倍时趋于平缓。过于频繁地抑制思考结束token定界符可能导致模型陷入重复循环,而非持续推理。在图4(右)中,我们展示在Qwen2.5-32B-Instruct上使用我们的1,000个样本训练以产生s1-32B并为其配备简单的预算强制技术后,它运行在不同的扩展范式中。在基础模型上通过多数投票扩展测试时计算无法赶上s1-32B的性能,这验证了我们在§3中的直觉,即串行扩展比并行更有效。我们在图5中提供了s1-32B的示例生成。
查看原页 样本效率 在图2(右)和表1中,我们将s1-32B与其他模型进行了比较。我们发现s1-32B是样本效率最高的开放数据推理模型。尽管仅在额外1,000个样本上进行训练,它的表现显著优于我们的基础模型(Qwen2.5-32B-Instruct)。同期发布的r1-32B虽然也仅使用SFT(DeepSeek-AI等,2025),但表现出比s1-32B更强的性能。然而,它是在 800 × 800\times 800 × 更多推理样本上训练的。能否仅用1,000个样本达到他们的性能仍是一个开放问题。最后,我们的模型在AIME24上几乎与Gemini 2.0 Thinking持平。由于s1-32B的数据是从Gemini 2.0蒸馏而来,这表明我们的蒸馏过程可能是有效的。
查看原页 在§2中,我们概述了构建s1K的三条指导原则:质量、难度和多样性。在此我们测试将三者结合的重要性以及我们选择策略的整体有效性。仅质量(1K-random):在从Gemini获得高质量推理链后,我们随机选择1,000个样本,完全不依赖难度和多样性过滤。表2显示,该方法在所有基准测试上的表现远逊于s1K。仅多样性(1K-diverse):对于该数据集,我们在各领域均匀采样以最大化多样性,不考虑任何难度概念。该方法同样导致与1K-random相似的较差性能。仅难度(1K-longest):这里我们依赖§2中引入的难度指标之一,选择推理轨迹最长的1,000个样本。该方法显著提升了GPQA性能,但总体上仍不及使用s1K。最大化数量:
查看原页 表2. s1K数据消融实验。对于本表中的所有分数,我们将强制预算(BF)上限设为约30,000个思考token。这比没有BF的分数(表1)表现略好,因为它允许模型在陷入无限循环时以最佳猜测结束。我们报告了相对于s1K模型的差异的 95 % 95\% 95% 配对自助法置信区间,使用了10,000个自助法样本。例如,区间 [ − 13 % , 20 % ] [- 13\% ,20\% ] [ − 13% , 20% ] 意味着,以 95 % 95\% 95% 的置信度,59K-full与s1K之间的真实差异在 − 13 % -13\% − 13% 到 + 20 % +20\% + 20% 之间。如果整个区间为负,例如 [ − 27 % , − 3 % ] [- 27\% , - 3\% ] [ − 27% , − 3% ] ,我们可以确信地说其表现比s1K更差。 查看原页 最后,我们与仅在我们的全部59K样本上训练进行比较,这是所有1K样本版本的超集。这产生了一个强大的模型,但消耗了更多资源。在59K样本上微调需要394个H100 GPU小时,而s1-32B仅需7个H100 GPU小时。此外,如§2所示,仅依赖s1K极具竞争力。总体而言,通过我们在§2中的方法将质量、难度、多样性这三项标准相结合,是实现样本高效推理训练的关键。
查看原页 100% -35 40.0 5 表3. 在AIME24上扩展测试时计算的方法消融实验。 ∣ A ∣ |A| ∣ A ∣ 指用于估计各项属性的评估运行次数;因此数值越高表示稳健性越强。粗体表示我们选用的方法及最佳数值。BF = = = 预算强制,TCC/SCC/CCC = = = 令牌/步骤/类别条件控制, R S = \mathrm{RS} = RS = 拒绝采样。 查看原页 Alice和Bob玩以下游戏。他们面前有一堆 n n n 个令牌。玩家轮流行动,Alice先手。在每一回合中,玩家从堆中移除1个令牌或4个令牌。移除最后一个令牌的人获胜。求满足以下条件的正整数 n n n (\(n\)小于或等于2024)的个数:存在一种Bob的策略,保证无论Alice如何行动,Bob都能赢得游戏。
查看原页 问题要求找出满足Bob有获胜策略的正整数 n ≤ 2024 n\leq 2024 n ≤ 2024 的个数。这是一个典型的无偏博弈,可以用Sprague-Grundy定理分析,或直接找出必胜位置和必败位置。设 W W W 为必胜位置集合(即当前轮到行动的玩家能够强制获胜的令牌数 n n n ), L L L 为必败位置集合。[...]
查看原页 设 P ( n ) P(n) P ( n ) 为命题“当有 n n n 个令牌时,当前轮到行动的玩家有获胜策略”。 P ( 0 ) P(0) P ( 0 ) 为假(当前轮到行动且面对0个令牌的玩家已经输了)。考虑 n n n 的较小值.. n = 1 n = 1 n = 1 :当前轮到行动的玩家可以取1个令牌并获胜。所以 P ( 1 ) P(1) P ( 1 ) 为真。 1 ∈ W 1\in W 1 ∈ W n = 2 n = 2 n = 2 :当前轮到行动的玩家可以取1个令牌,给对手留下1个令牌。由于 1 ∈ W 1\in W 1 ∈ W ,对手获胜。所以 P ( 2 ) P(2) P ( 2 ) 为假。 2 ∈ L 2\in L 2 ∈ L n = 3 n = 3 n = 3 :当前轮到行动的玩家可以取1个令牌,给对手留下2个令牌。由于 2 ∈ L 2\in L 2 ∈ L ,当前轮到行动的玩家获胜。所以 P ( 3 ) P(3) P ( 3 ) 为真。 3 ∈ 3\in 3 ∈ W W W ...]
查看原页 我们要求的是满足Bob有获胜策略的正整数 n ≤ 2024 n\leq 2024 n ≤ 2024 的个数。这意味着如果游戏从 n n n 个令牌开始,且Alice先手,Bob能赢。这发生当且仅当 n n n 是必败位置(因为如果 n ∈ L n\in L n ∈ L ,那么Alice的第一步必定导致Bob处于必胜位置)。[...]
查看原页 让我们尝试在必败位置 L = { 0 , 2 , 5 , 7 , 10 , 12 , 15 , 17 , 20 , 22 , … } L = \{0,2,5,7,10,12,15,17,20,22,\ldots \} L = { 0 , 2 , 5 , 7 , 10 , 12 , 15 , 17 , 20 , 22 , … } 中寻找规律。相邻项之间的差:2,3,2,3,2,3,2,3,2, ...差的模式是交替的2,3。[...] 必败位置的形式为 5 m 5m 5 m 或 5 m + 2 5m + 2 5 m + 2 ,其中 m ≥ 0 m\geq 0 m ≥ 0 。我们需要找出满足属于必败位置集合 L L L 的正整数 n ≤ 2024 n\leq 2024 n ≤ 2024 的个数...]
查看原页 情况1: n = 5 m n = 5m n = 5 m ,其中 m ≥ 1 m\geq 1 m ≥ 1 。 1 ≤ 5 m ≤ 2024 1\leq 5m\leq 2024 1 ≤ 5 m ≤ 2024 1 / 5 ≤ m ≤ 2024 / 5 = 404.8 1 / 5\leq m\leq 2024 / 5 = 404.8 1/5 ≤ m ≤ 2024/5 = 404.8 由于 m m m 是整数, 1 ≤ m ≤ 404 1\leq m\leq 404 1 ≤ m ≤ 404 。 m m m 的取值个数为404。情况2: n = 5 m + 2 n = 5m + 2 n = 5 m + 2 ,其中 m ≥ 0 m\geq 0 m ≥ 0 。 5 m + 2 ≤ 2024 5m + 2\leq 2024 5 m + 2 ≤ 2024 5 m ≤ 2022 m ≤ 2022 / 5 = 404.4 5m\leq 2022m\leq 2022 / 5 = 404.4 5 m ≤ 2022 m ≤ 2022/5 = 404.4 由于 m m m 是整数, 0 ≤ m ≤ 404 0\leq m\leq 404 0 ≤ m ≤ 404 。 m m m 的取值个数为 404 − 0 + 1 = 405 404 - 0 + 1 = 405 404 − 0 + 1 = 405 。
查看原页 满足是必败位置的正整数 n ≤ 2024 n\leq 2024 n ≤ 2024 的总数为 404 + 405 = 809 404 + 405 = \boxed{809} 404 + 405 = 809 。
查看原页 求 a a a 在 b = b = b = ( 2 6 ) \binom{2}{6} ( 6 2 ) 上的投影,如果 a ⋅ b = 8 a\cdot b = 8 a ⋅ b = 8
查看原页 向量 a \mathbf{a} a 在向量 b \mathbf{b} b 上的投影由以下公式给出:
查看原页 p r o j b a = a ⋅ b ∥ b ∥ 2 b \mathrm{proj}_{\mathbf{b}}\mathbf{a} = \frac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{b}\|^{2}}\mathbf{b} proj b a = ∥ b ∥ 2 a ⋅ b b 查看原页 已知 b = ( 2 6 ) \mathbf{b} = \binom{2}{6} b = ( 6 2 ) 且 a ⋅ b = 8 \mathbf{a}\cdot \mathbf{b} = 8 a ⋅ b = 8
查看原页 首先,我们需要求 b \mathbf{b} b 的模的平方,即 ∥ b ∥ 2 \| \mathbf{b}\|^{2} ∥ b ∥ 2 。
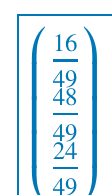
查看原页 ∥ b ∥ 2 = b ⋅ b = 2 2 + 6 2 + 3 2 = 4 + 36 + 9 = 49. ( 2 ) \| \mathbf{b}\|^{2} = \mathbf{b}\cdot \mathbf{b} = 2^{2} + 6^{2} + 3^{2} = 4 + 36 + 9 = 49. \quad (2) ∥ b ∥ 2 = b ⋅ b = 2 2 + 6 2 + 3 2 = 4 + 36 + 9 = 49. ( 2 ) 查看原页 p r o j b a = 8 49 b \mathrm{proj}_{\mathbf{b}}\mathbf{a} = \frac{8}{49}\mathbf{b} proj b a = 49 8 b 查看原页 p r o j b a = 8 49 ( 2 3 ) \mathrm{proj}_{\mathbf{b}}\mathbf{a} = \frac{8}{49}\left(\frac{2}{3}\right) proj b a = 49 8 ( 3 2 ) 查看原页 p r o j b a = ( 8 49 × 2 3 ) = ( 16 49 ) \mathrm{proj}_{\mathbf{b}}\mathbf{a} = \left(\frac{8}{49}\times \frac{2}{3}\right) = \left(\frac{16}{49}\right) proj b a = ( 49 8 × 3 2 ) = ( 49 16 ) 查看原页 查看原页 一个质量为 m m m 的量子力学粒子在二维中运动,势能如下,作为极坐标 ( r , θ ) (r,\theta) ( r , θ ) 的函数。
查看原页 V ( r , θ ) = 1 2 k r 2 + 3 2 k r 2 cos 2 ( θ ) V(r,\theta) = \frac{1}{2} kr^{2} + \frac{3}{2} kr^{2}\cos^{2}(\theta) V ( r , θ ) = 2 1 k r 2 + 2 3 k r 2 cos 2 ( θ ) 查看原页 问题要求求粒子在给定二维势能中的能谱。势能以极坐标 ( r , θ ) (r,\theta) ( r , θ ) 给出:
查看原页 V ( r , θ ) = 1 2 k r 2 + 3 2 k r 2 cos 2 ( θ ) V(r,\theta) = \frac{1}{2} kr^{2} + \frac{3}{2} kr^{2}\cos^{2}(\theta) V ( r , θ ) = 2 1 k r 2 + 2 3 k r 2 cos 2 ( θ ) 查看原页 V ( r , θ ) = 1 2 k r 2 ( 1 + 3 cos 2 ( θ ) ) . V(r,\theta) = \frac{1}{2} kr^{2}(1 + 3\cos^{2}(\theta)). V ( r , θ ) = 2 1 k r 2 ( 1 + 3 cos 2 ( θ )) . 查看原页 H = − ℏ 2 2 m ( ∂ 2 ∂ x 2 + ∂ 2 ∂ y 2 ) + V ( x , y ) .
H = -\frac{\hbar^{2}}{2m}\left(\frac{\partial^{2}}{\partial x^{2}} +\frac{\partial^{2}}{\partial y^{2}}\right) + V(x,y).
H = − 2 m ℏ 2 ( ∂ x 2 ∂ 2 + ∂ y 2 ∂ 2 ) + V ( x , y ) . 查看原页 在极坐标 ( r , θ ) (r,\theta) ( r , θ ) 下,拉普拉斯算符为:
查看原页 ∇ 2 = 1 r ∂ ∂ r ( r ∂ ∂ r ) + 1 r 2 ∂ 2 ∂ θ 2 .
\nabla^{2} = \frac{1}{r}\frac{\partial}{\partial r}\left(r\frac{\partial}{\partial r}\right) + \frac{1}{r^{2}}\frac{\partial^{2}}{\partial\theta^{2}}.
∇ 2 = r 1 ∂ r ∂ ( r ∂ r ∂ ) + r 2 1 ∂ θ 2 ∂ 2 . 查看原页 H = − ℏ 2 2 m [ 1 r ∂ ∂ r ( r ∂ ∂ r ) + 1 r 2 ∂ 2 ∂ θ 2 ] + V ( r , θ ) .
H = -\frac{\hbar^{2}}{2m}\left[\frac{1}{r}\frac{\partial}{\partial r}\left(r\frac{\partial}{\partial r}\right) + \frac{1}{r^{2}}\frac{\partial^{2}}{\partial\theta^{2}}\right] + V(r,\theta).
H = − 2 m ℏ 2 [ r 1 ∂ r ∂ ( r ∂ r ∂ ) + r 2 1 ∂ θ 2 ∂ 2 ] + V ( r , θ ) . 查看原页 定态薛定谔方程为 H ψ = E ψ H\psi = E\psi H ψ = E ψ 。我们可以通过假设形式为 ψ ( r , θ ) = R ( r ) Θ ( θ ) \psi (r,\theta) = R(r)\Theta (\theta) ψ ( r , θ ) = R ( r ) Θ ( θ ) 的解来尝试分离变量。[...]
查看原页 E = ℏ k m ( 2 n x + n y + 3 2 ) .
E = \hbar \sqrt{\frac{k}{m}}\left(2n_{x} + n_{y} + \frac{3}{2}\right).
E = ℏ m k ( 2 n x + n y + 2 3 ) . 查看原页 最终答案: E = ℏ k m ( 2 n x + n y + 3 2 ) . E = \hbar \sqrt{\frac{k}{m}}\left(2n_{x} + n_{y} + \frac{3}{2}\right). E = ℏ m k ( 2 n x + n y + 2 3 ) .
查看原页 预算强制 在表3中,我们比较了在 § 3 \S 3 §3 中引入的测试时扩展方法。总体而言,我们发现预算强制提供了完美的控制、良好的扩展性,并带来了我们最佳的AIME24得分。因此,这是我们在图1和 § 4 \S 4 §4 中用于s1-32B的方法。在表4中,我们比较了用于外推性能的不同字符串。我们发现“Wait”通常给出最佳性能。
查看原页 类别条件控制 我们在 § E .1 \S \mathrm{E}.1 § E .1 中提供了该方法的基准得分,并在此总结三项发现:(1)在没有预算强制的情况下,令牌条件控制失败,因为我们的模型无法可靠地计数令牌——即使经过训练也是如此。(2)在步骤条件控制下,当给定不同的步骤目标时,模型生成的总令牌数相似,因为模型会从步骤少但每步令牌多,转变为步骤多但每步令牌少。因此,模型学会了绕过计算约束,使该方法的可控性变得平庸。(3)类别条件控制可以奏效——告诉模型简单地思考更长时间可以增加其测试时计算量和性能,这在表3中带来了良好的扩展性。
查看原页 表4. 预算强制外推消融实验。我们比较了两次忽略思考结束分隔符,以及追加无字符串或各种字符串的情况。 查看原页 拒绝采样 令人惊讶的是,我们发现仅仅采样直到生成内容符合特定长度会导致如图6所示的逆扩展趋势。在 § E .2 \S \mathrm{E}.2 § E .2 中,我们考 察了一个问题,该问题在拒绝采样 ≤ 4000 \leq 4000 ≤ 4000 时被模型正确回答,但在 ≤ 8000 \leq 8000 ≤ 8000 令牌设置下未能正确回答。在 ≤ 4000 \leq 4000 ≤ 4000 设置中,模型直接跳到正确的方法,而在 ≤ 8000 \leq 8000 ≤ 8000 设置中,它大量回溯。我们假设存在一种相关性:较短的生成往往是模型从一开始就走在正确轨道上的情况,而较长的生成往往是模型犯了错误并因此回溯或质疑自身的情况。这导致在拒绝采样时较长的样本常常是错误的,从而形成逆扩展趋势。
查看原页 模型 有许多并行工作致力于构建复制o1性能的模型(OpenAI,2024)。例如,DeepSeek-r1和k1.5(DeepSeek-AI等,2025;Team等,2025)是用强化学习方法构建的,而其他模型则依赖于使用数万个蒸馏示例进行SFT(Team,2025;Xu等,2025;Labs,2025)。我们表明,仅对1,000个示例进行SFT就足以构建一个与o1-preview匹配的具有竞争力的推理模型,并产生一个位于帕累托前沿的模型(图2)。此外,我们引入了预算强制,将其与我们的推理模型结合,首次复现了OpenAI的测试时扩展曲线(OpenAI,2024)。为什么仅对1,000个样本进行监督微调就能带来如此大的性能提升?我们假设模型在预训练期间已经接触了大量推理数据,这些数据跨越数万亿令牌。因此,执行推理的能力已经存在于我们的模型中。我们的样本高效微调阶段只是激活了它,并且我们在测试时通过预算强制进一步扩展它。这类似于LIMA(Zhou等,2023)中提出的“表层对齐假设”,作者发现1,000个示例足以使模型对齐以遵循用户偏好。
查看原页 查看原页 图6. 在AIME24上使用s1-32B进行拒绝采样。我们以温度为1进行采样,直到所有生成结果都少于(从左到右)3500、4000、5000、8000和16000个思考token,每个样本平均需要655、97、8、3、2和1次尝试。 查看原页 基准和方法 为了评估并推动这些模型的极限,人们引入了越来越具有挑战性的基准,例如奥林匹克级别的科学竞赛(He等,2024;Jain等,2024;Zhong等,2023)以及其他基准(Srivastava等,2023;Glazer等,2024;Su等,2024;Kim等,2024;Phan等,2025)。为了增强模型在推理相关任务上的性能,研究人员采取了多种策略:先前的工作探索了在与数学和科学相关的专门语料上继续训练语言模型(Azerbayev等,2023;Yang等,2024),有时甚至使用合成生成的数据(Yu等,2024)。其他人则开发了专门针对推理性能的训练方法(Zelikman等,2022;2024;Luo等,2025; Yuan等,2025;Wu等,2024a)。另一条重要的研究路线侧重于基于提示的方法来引发和改善推理能力,包括思维链提示等方法(Wei等,2023;Yao等,2023a;b;Bi等,2023;Fu等,2023;Zhang等,2024b;Xiang等,2025;Hu等,2024;Diao等,2024)。这些共同努力旨在推进语言模型的推理能力,使其能够有效处理更复杂和抽象的任务。
查看原页 方法 正如我们在 § 3 \S 3 §3 中介绍的,我们区分了两种扩展测试时计算的方法:并行和串行。前者依赖于并行生成多个求解尝试,并通过特定标准选择最佳结果。这些标准包括选择多数投票中最频繁的响应,或基于外部奖励为Best-of-N选择最佳响应(Brown等,2024;Irvine等,2023;Levi,2024)。与重复采样不同,先前的串行扩展方法让模型基于先前的尝试顺序生成求解尝试,使其能够根据先前结果改进每次尝试(Snell等,2024;Hou等,2025;Lee等,2025)。基于树的搜索方法(Gandhi等,2024;Wu等,2024b)提供了串行与并行扩展之间的混合方法,例如蒙特卡洛树搜索(MCTS)(Liu等,2024;Zhang等,2023;Zhou等,2024;Choi等,2023)和引导束搜索(Xie等,2023)。REBASE(Wu等,2024b)采用过程奖励模型来在树搜索期间平衡利用和剪枝。经验上,REBASE已被证明优于基于采样的方法和MCTS(Wu等,2024b)。奖励模型(Lightman等,2023;Wang等,2024b;c)在这些方法中发挥关键作用。它们有两种变体:结果奖励模型和过程奖励模型。结果奖励模型(Xin等,2024;Ankner等,2024)为完整解分配分数,在Best-of-N选择中特别有用,而过程奖励模型(Lightman等,2023;Wang等,2024b;Wu等,2024b)评估单个推理步骤,并在指导基于树的搜索方法方面有效。
查看原页 进一步测试时扩展的局限 我们已在 § 4 \S 4 §4 中表明,预算强制允许外推测试时计算,例如将AIME24性能从 50 % 50\% 50% 提高到 57 % 57\% 57% 。然而,在进一步扩展时它有两个关键限制:它最终会趋于平缓(图4),并且底层语言模型的上下文窗口会限制它。尽管有这些约束,我们的工作展示了跨越广泛准确率范围的测试时扩展(图1),部分原因是缩小测试时计算的行为是可预测的,并且不受这些约束的影响。
查看原页 继续测试时扩展将需要能够进一步外推测试时计算的方法。我们如何获得
查看原页 查看原页 图7. 使用并行扩展方法进一步扩展。所有指标均为AIME24中30个问题的平均值。REBASE的平均思考令牌数未计入奖励模型带来的额外计算量。对于顺序扩展,我们提示模型最多使用(从左到右)32、64、256和512个步骤。对于REBASE和多数投票,我们生成16条并行轨迹进行聚合。 查看原页 这样的外推?预算强制可能会有改进,例如轮换不同的字符串,而不仅是“Wait”,或将其与频率惩罚或更高温度结合以避免重复循环。未来工作的一个令人兴奋的方向是研究将预算强制应用于通过强化学习训练的推理模型是否能产生更好的外推;或者RL是否允许超越预算强制的新测试时扩展方式。我们的工作定义了正确的指标( § 3.2 \S 3.2 §3.2 )——控制、扩展和性能——以支持未来在测试时计算外推方面的研究和进展。
并行扩展作为一种解决方案 并行扩展为串行扩展的局限提供了一种解决方案,因此我们用两种方法增强我们的串行扩展模型:(I)多数投票:在生成 k k k 个解后,最终解是各代中最频繁出现的那个;(II)通过REBASE进行树搜索:我们使用REBASE过程奖励模型,该模型从LLaMA-34B初始化,并在合成过程奖励建模数据集上进一步微调(Wu等,2024b)。然后我们通过多数投票聚合REBASE生成的解。如图7所示,用REBASE增强我们的模型比多数投票扩展得更好,甚至在此场景中优于串行扩展。然而,REBASE需要在每一步为奖励模型额外进行一次前向传递,增加了一些计算开销。对于串行扩展,当提示使用最多512步时,在30个评估问题中有12个模型生成的响应超出上下文窗口,导致性能大幅下降。总体而言,我们发现这些并行扩展方法补充了串行扩展,因此它们为进一步扩展测试时计算——超越固定上下文窗口——提供了一条途径。
查看原页 影响声明具有强大推理能力的语言模型有潜力极大地提升人类生产力,从协助复杂决策到推动科学突破。然而,近期推理领域的进展,例如 OpenAI 的 o1 和 DeepSeek 的 r1,缺乏透明度,限制了更广泛的研究进展。我们的工作旨在以完全开放的方式推动推理的前沿,促进创新与合作,以加速最终惠及社会的进步。
查看原页 致谢我们感谢 Ryan Marten 使用 Bespoke Curator(Marten et al., 2025)为 s1.1 从 DeepSeek r1 生成轨迹。本工作部分使用 Stanford Marlowe GPU 集群(Kapfer et al., 2025)完成,该集群得益于斯坦福大学的财务支持。我们感谢 Alexander M. Rush、Andrew Ilyas、Banghua Zhu、Chenglei Si、Chunting Zhou、John Yang、Ludwig Schmidt、Samy Jelassi、Suhas Kotha、Tengyu Ma、Xuechen Li、Yu Sun 和 Yue Zhang 提出的极具建设性的讨论。
查看原页 Ankner, Z., Paul, M., Cui, B., Chang, J. D., and Ammanabrolu, P. Critique- out- loud reward models, 2024. URL https://arxiv.org/abs/2408.11791. Arora, D., Singh, H. G., and Mausam. Have llms advanced enough? a challenging problem solving benchmark for large language models, 2023. URL https://arxiv.org/abs/2305.15074. Azerbayev, Z., Schoelkopf, H., Paster, K., Santos, M. D., McAleer, S., Jiang, A. Q., Deng, J., Biderman, S., and Welleck, S. Llemma: An open language model for mathematics, 2023. Bi, Z., Zhang, N., Jiang, Y., Deng, S., Zheng, G., and Chen, H. When do program- of- thoughts work for reasoning?, 2023. URL https://arxiv.org/abs/2308.15452. Biderman, S., Schoelkopf, H., Sutawika, L., Gao, L., Tow, J., Abbasi, B., Aji, A. F., Ammanamanchi, P. S., Black, S., Clive, J., DiPofi, A., Etxaniz, J., Fattori, B., Forde, J. Z., Foster, C., Hsu, J., Jaiswal, M., Lee, W. Y., Li, H., Lovering, C., Muennighoff, N., Pavlick, E., Phang, J., Skowron, A., Tan, S., Tang, X., Wang, K. A., Winata, G. I., Yvon, F., and Zou, A. Lessons from the trenches on reproducible evaluation of language models, 2024. Brown, B., Juravsky, J., Ehrlich, R., Clark, R., Le, Q. V., Ré, C., and Mirhoseini, A. Large language monkeys: Scaling inference compute with repeated sampling, 2024. URL https://arxiv.org/abs/2407.21787.
查看原页 Cesisita, F. L. 多模态结构化生成:CVPR第二届MMFM挑战赛技术报告,2024。URL https://arxiv.org/abs/2406.11403。Chen, W., Yin, M., Ku, M., Lu, P., Wan, Y., Ma, X., Xu, J., Wang, X., and Xia, T. Theoremaqa:一个定理驱动的问答数据集,2023。URL https://arxiv.org/abs/2305.12524。Choi, S., Fang, T., Wang, Z., and Song, Y. Kcts:具有词元级幻觉检测的知识约束树搜索解码,2023。URL https://arxiv.org/abs/2310.09044。DeepSeek-AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., Xue, B., Wang, B., Wu, B., Feng, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., Luo, F., Hao, G., Chen, G., Li, G., Zhang, H., Bao, H., Xu, H., Wang, H., Ding, H., Xin, H., Gao, H., Qu, H., Li, H., Guo, J., Li, J., Wang, J., Chen, J., Yuan, J., Qiu, J., Li, J., Cai, J. L., Ni, J., Liang, J., Chen, J., Dong, K., Hu, K., Gao, K., Guan, K., Huang, K., Yu, K., Wang, L., Zhang, L., Zhao, L., Wang, L., Zhang, L., Xu, L., Xia, L., Zhang, M., Zhang, M., Tang, M., Li, M., Wang, M., Li, M., Tian, N., Huang, P., Zhang, P., Wang, Q., Chen, Q., Du, Q., Ge, R., Zhang, R., Pan, R., Wang, R., Chen, R. J., Jin, R. L., Chen, R., Lu, S., Zhou, S., Chen, S., Ye, S., Wang, S., Yu, S., Zhou, S., Pan, S., Li, S. S., Zhou, S., Wu, S., Ye, S., Yun, T., Pei, T., Sun, T., Wang, T., Zeng, W., Zhao, W., Liu, W., Liang, W., Gao, W., Yu, W., Zhang, W., Xiao, W. L., An, W., Liu, X., Wang, X., Chen, X., Nie, X., Cheng, X., Liu, X., Xie, X., Liu, X., Yang, X., Li, X., Su, X., Lin, X., Li, X. Q., Jin, X., Shen, X., Chen, X., Sun, X., Wang, X., Song, X., Zhou, X., Wang, X., Shan, X., Li, Y. K., Wang, Y. Q., Wei, Y. X., Zhang, Y., Xu, Y., Li, Y., Zhao, Y., Sun, Y., Wang, Y., Yu, Y., Zhang, Y., Shi, Y., Xiong, Y., He, Y., Piao, Y., Wang, Y., Tan, Y., Ma, Y., Liu, Y., Guo, Y., Ou, Y., Wang, Y., Gong, Y., Zou, Y., He, Y., Xiong, Y., Luo, Y., You, Y., Liu, Y., Zhou, Y., Zhu, Y. X., Xu, Y., Huang, Y., Li, Y., Zheng, Y., Zhu, Y., Ma, Y., Tang, Y., Zha, Y., Yan, Y., Ren, Z. Z., Ren, Z., Sha, Z., Fu, Z., Xu, Z., Xie, Z., Zhang, Z., Hao, Z., Ma, Z., Yan, Z., Wu, Z., Gu, Z., Zhu, Z., Liu, Z., Li, Z., Xie, Z., Song, Z., Pan, Z., Huang, Z., Xu, Z., Zhang, Z., and Zhang, Z. Deepseek-r1:通过强化学习激励大语言模型的推理能力,2025。URL https://arxiv.org/abs/2501.12948。Diao, S., Wang, P., Lin, Y., Pan, R., Liu, X., and Zhang, T. 面向大语言模型的带思维链的主动提示,2024。URL https://arxiv.org/abs/2302.12246。 Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al-Dahle, A., Letman, A., Mathur, A., Schelten, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., Rao, A., Zhang, A., Rodriguez, A., Gregerson, A., et al. Llama 3模型群,2024。URL https://arxiv.org/abs/2407.21783。
查看原页 Fu, Y., Peng, H., Sabharwal, A., Clark, P., and Khot, T. 面向多步推理的基于复杂度的提示,2023。URL https://arxiv.org/abs/2210.00720。
查看原页 Gandhi, K., Lee, D., Grand, G., Liu, M., Cheng, W., Sharma, A., and Goodman, N. D. 搜索流(sos):在语言中学习搜索,2024。URL https://arxiv.org/abs/2404.03683。
查看原页 Gao, B., Song, F., Yang, Z., Cai, Z., Miao, Y., Dong, Q., Li, L., Ma, C., Chen, L., Xu, R., Tang, Z., Wang, B., Zan, D., Quan, S., Zhang, G., Sha, L., Zhang, Y., Ren, X., Liu, T., and Chang, B. Omni-math:面向大语言模型的通用奥林匹克级数学基准,2024a。URL https://arxiv.org/abs/2410.07985。
查看原页 Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., and Zou, A. 一个少样本语言模型评估框架,2021年9月。URL https://doi.org/10.5281/zenodo.5371628。
查看原页 Gao, Z., Niu, B., He, X., Xu, H., Liu, H., Liu, A., Hu, X., and Wen, L. 可解释的对比蒙特卡洛树搜索推理,2024b。URL https://arxiv.org/abs/2410.01707。
查看原页 Glazer, E., Erdil, E., Besiroglu, T., Chicharro, D., Chen, E., Gunning, A., Olsson, C. F., Denain, J.-S., Ho, A., de Oliveira Santos, E., Järviniemi, O., Barnett, M., Sandler, R., Vrzala, M., Sevilla, J., Ren, Q., Pratt, E., Levine, L., Barkley, G., Stewart, N., Grechuk, B., Grechuk, T., Enugandla, S. V., and Wildon, M. Frontiermath:评估人工智能高级数学推理能力的基准,2024。URL https://arxiv.org/abs/2411.04872。
查看原页 Google. Gemini 2.0 Flash Thinking模式(gemini-2.0-flash-thinking-exp-1219),2024年12月。URL https://cloud.google.com/vertex-ai/generative-ai/docs/thinking-mode。
查看原页 Groeneveld, D., Beltagy, I., Walsh, P., Bhagia, A., Kinney, R., Tafjord, O., Jha, A. H., Ivison, H., Magnusson, I.,
查看原页 Wang, Y., Arora, S., Atkinson, D., Authur, R., Chandu, K. R., Cohan, A., Dumas, J., Elazar, Y., Gu, Y., Hessel, J., Khot, T., Merrill, W., Morrison, J., Muennighoff, N., Naik, A., Nam, C., Peters, M. E., Pyatkin, V., Ravichander, A., Schwenk, D., Shah, S., Smith, W., Strubell, E., Subramani, N., Wortsman, M., Dasigi, P., Lambert, N., Richardson, K., Zettlemoyer, L., Dodge, J., Lo, K., Soldaini, L., Smith, N. A., and Hajishirzi, H. Olmo:加速语言模型科学,2024。
查看原页 He, C., Luo, R., Bai, Y., Hu, S., Thai, Z. L., Shen, J., Hu, J., Han, X., Huang, Y., Zhang, Y., Liu, J., Qi, L., Liu, Z., and Sun, M. Olympiadbench:一个具有挑战性的基准,用于通过奥林匹克级双语多模态科学问题推动AGI,2024。URL https://arxiv.org/abs/2402.14008。
查看原页 Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., and Steinhardt, J. 使用math数据集衡量数学问题求解能力,2021。URL https://arxiv.org/abs/2103.03874。
查看原页 Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., Rae, J. W., Vinyals, O. 和 Sifre, L. 训练计算最优大语言模型,2022。网址 https://arxiv.org/abs/2203.15556。
查看原页 Hou, Z., Lv, X., Lu, R., Zhang, J., Li, Y., Yao, Z., Li, J., Tang, J. 和 Dong, Y. 通过强化学习和推理扩展推进语言模型推理,2025。网址 https://arxiv.org/abs/2501.11651。
查看原页 Hu, Y., Shi, W., Fu, X., Roth, D., Ostendorf, M., Zettlemoyer, L., Smith, N. A. 和 Krishna, R. 视觉速写板:将速写作为多模态语言模型的视觉思维链,2024。网址 https://arxiv.org/abs/2406.09403。
查看原页 Huang, Z., Wang, Z., Xia, S., Li, X., Zou, H., Xu, R., Fan, R.- Z., Ye, L., Chern, E., Ye, Y., Zhang, Y., Yang, Y., Wu, T., Wang, B., Sun, S., Xiao, Y., Li, Y., Zhou, F., Chern, S., Qin, Y., Ma, Y., Su, J., Liu, Y., Zheng, Y., Zhang, S., Lin, D., Qiao, Y., and Liu, P. Olympicarena:面向超级智能AI的多学科认知推理基准测试,2024a。URL https://arxiv.org/abs/2406.12753。
查看原页 Huang, Z., Zou, H., Li, X., Liu, Y., Zheng, Y., Chern, E., Xia, S., Qin, Y., Yuan, W., and Liu, P. O1复现之旅——第2部分:通过简单蒸馏超越o1-preview,巨大进步还是苦涩教训?,2024b。URL https://arxiv.org/abs/2411.16489。
查看原页 Huang, Z., Geng, G., Hua, S., Huang, Z., Zou, H., Zhang, S., Liu, P., and Zhang, X. O1复现之旅——第3部分:面向医学推理的推理时扩展,2025。URL https://arxiv.org/abs/2501.06458。
查看原页 Irvine, R., Boubert, D., Raina, V., Liusie, A., Zhu, Z., Mudupalli, V., Korshuk, A., Liu, Z., Cremer, F., Assassi, V., Beauchamp, C.- C., Lu, X., Rialan, T., and Beauchamp, W. 以真实世界参与度奖励聊天机器人:面向数百万用户,2023。URL https://arxiv.org/abs/2303.06135。
查看原页 Jain, N., Han, K., Gu, A., Li, W.- D., Yan, F., Zhang, T., Wang, S., Solar- Lezama, A., Sen, K., and Stoica, I. Livecodebench:面向代码的大型语言模型的整体且无污染评估,2024。URL https://arxiv.org/abs/2403.07974。
查看原页 Kapfer, C., Stine, K., Narasimhan, B., Mentzel, C., and Candes, E. Marlowe:斯坦福基于GPU的计算仪器,2025年1月。URL https://doi.org/10.5281/zenodo.14751899。
查看原页 Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., and Amodei, D. 神经语言模型的扩展定律,2020。URL https://arxiv.org/abs/2001.08361。
查看原页 Kim, E., Suk, J., Kim, S., Muennighoff, N., Kim, D., and Oh, A. LLM作为面试官:通过动态LLM评估超越静态测试,2024。URL https://arxiv.org/abs/2412.10424。
查看原页 Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., and Stoica, I. 基于PagedAttention的大型语言模型服务高效内存管理,2023。URL https://arxiv.org/abs/2309.06180。
查看原页 Labs, B. Bespoke- stratos:推理蒸馏的惊人有效性,2025。URL https://hf.co/bespokelabs/Bespoke- Stratos- 32B。访问日期:2025- 01- 22。
查看原页 Lee, K.- H., Fischer, I., Wu, Y.- H., Marwood, D., Baluja, S., Schuurmans, D., and Chen, X. 演化更深的LLM思考,2025。URL https://arxiv.org/abs/2501.09891。
查看原页 Levi, N. 一个简单的推理扩展定律模型,2024。URL https://arxiv.org/abs/2410.16377。
查看原页 LI, J., Beeching, E., Tunstall, L., Lipkin, B., Soletskyi, R., Huang, S. C., Rasul, K., Yu, L., Jiang, A., Shen, Z., Qin, Z., Dong, B., Zhou, L., Fleureau, Y., Lample, G., and Polu, S. Numinnamath,2024。URL https://github.com/project- numina/aimo- progress- prize/blob/main/report/ numina_dataset.pdf。
查看原页 Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I., and Cobbe, K. 让我们逐步验证,2023。URL https://arxiv.org/abs/2305.20050。
查看原页 Ling, W., Yogatama, D., Dyer, C., and Blunsom, P. 通过理由生成进行程序归纳:学习求解并解释代数应用题,2017。URL https://arxiv.org/abs/1705.04146。
查看原页 Liu, J., Cui, L., Liu, H., Huang, D., Wang, Y., and Zhang, Y. Logiqa:面向逻辑推理机器阅读理解的挑战数据集,2020。URL https://arxiv.org/abs/2007.08124。
查看原页 Liu, J., Cohen, A., Pasunuru, R., Choi, Y., Hajishirzi, H., and Celikyilmaz, A. 不要丢弃你的价值模型!使用价值引导的蒙特卡洛树搜索解码生成更优选的文本,2024。URL https://arxiv.org/abs/2309.15028。
查看原页 Loshchilov, I. and Hutter, F. 解耦权重衰减正则化,2019。
查看原页 Luo, H., Sun, Q., Xu, C., Zhao, P., Lou, J., Tao, C., Geng, X., Lin, Q., Chen, S., Tang, Y., and Zhang, D. Wizardmath:通过强化Evol-Instruct赋能大型语言模型的数学推理,2025。URL https://arxiv.org/abs/2308.09583。
查看原页 Marten, R., Vu, T., Ji, C. C.- J., Sharma, K., Pimpalgaonkar, S., Dimakis, A., and Sathiamoorthy, M. Curator:一款用于合成数据创建的工具。https://github.com/bespokelabsai/curator,2025年1月。
查看原页 Muennighoff, N., Soldaini, L., Groeneveld, D., Lo, K., Morrison, J., Min, S., Shi, W., Walsh, P., Tafjord, O., Lambert, N., Gu, Y., Arora, S., Bhagia, A., Schwenk, D., Wadden, D., Wettig, A., Hui, B., Dettmers, T., Kiela, D., Farhadi, A., Smith, N. A., Koh, P. W., Singh, A., and Hajishirzi, H. Olmoe:开放混合专家语言模型,2024。URL https://arxiv.org/abs/2409.02060。
查看原页 of America, M. A. Aime,2024年2月。URL https://artofproblemsolving.com/wiki/index.php/AIME_Problems_and_Solutions/。
查看原页 OpenAI. 使用LLM学习推理,2024年9月。URL https://openai.com/index/learning- to- reason- with- llms/。
查看原页 OpenAI. Openai o3- mini,2025。URL https://openai.com/index/openai- o3- mini/。访问日期:2025- 02- 24。
查看原页 Phan, L., Gatti, A., Han, Z., Li, N., Hu, J., Zhang, H., Shi, S., Choi, M., Agrawal, A., Chopra, A., et al. 人类最后的考试,2025。URL https://arxiv.org/abs/2501.14249。
查看原页 Qin, Y., Li, X., Zou, H., Liu, Y., Xia, S., Huang, Z., Ye, Y., Yuan, W., Liu, H., Li, Y., and Liu, P. O1复现之旅:战略进展报告——第1部分,2024。URL https://arxiv.org/abs/2410.18982。
查看原页 Qwen, : Yang, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Li, C., Liu, D., Huang, F., Wei, H., Lin, H., Yang, J., Tu, J., Zhang, J., Yang, J., Yang, J., Zhou, J., Lin, J., Dang, K., Lu, K., Bao, K., Yang, K., Yu, L., Li, M., Xue, M., Zhang, P., Zhu, Q., Men, R., Lin, R., Li, T., Xia, T., Ren, X., Ren, X., Fan, Y., Su, Y., Zhang, Y., Wan, Y., Liu, Y., Cui, Z., Zhang, Z., and Qiu, Z. Qwen2.5技术报告,2024。URL https://arxiv.org/abs/2412.15115。
查看原页 Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J., and Bowman, S. R. Gpqa:一个研究生水平的谷歌证明问答基准,2023。URL https://arxiv.org/abs/2311.12022。
查看原页 Shi, Q., Tang, M., Narasimhan, K., and Yao, S. 语言模型能解决奥林匹克编程问题吗?,2024。URL https://arxiv.org/abs/2404.10952。
查看原页 Snell, C., Lee, J., Xu, K., and Kumar, A. 最优地扩展LLM测试时计算可能比扩展模型参数更有效,2024。URL https://arxiv.org/abs/2408.03314。
查看原页 Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga-Alonso, A., et al. 超越模仿游戏:量化和外推语言模型的能力,2023。
查看原页 Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., yu Wang, H., Liu, H., Shi, Q., Siegel, Z. S., Tang, M., Sun, R., Yoon, J., Arik, S. O., Chen, D., and Yu, T. Bright:一个用于推理密集型检索的现实且具有挑战性的基准,2024。URL https://arxiv.org/abs/2407.12883。
查看原页 Sun, L., Han, Y., Zhao, Z., Ma, D., Shen, Z., Chen, B., Chen, L., and Yu, K. Scieval:一个面向科学研究的多层次大语言模型评估基准,2024。URL https://arxiv.org/abs/2308.13149。
查看原页 Team, K., Du, A., Gao, B., Xing, B., Jiang, C., Chen, C., Li, C., Xiao, C., Du, C., Liao, C., Tang, C., Wang, C., Zhang, D., Yuan, E., Lu, E., Tang, F., Sung, F., Wei, G., Lai, G., Guo, H., Zhu, H., Ding, H., Hu, H., Yang, H., Zhang, H., Yao, H., Zhao, H., Lu, H., Li, H., Yu, H., Gao, H., Zheng, H., Yuan, H., Chen, J., Guo, J., Su, J., Wang, J., Zhao, J., Zhang, J., Liu, J., Yan, J., Wu, J., Shi, L., Ye, L., Yu, L., Dong, M., Zhang, N., Ma, N., Pan, Q., Gong, Q., Liu, S., Ma, S., Wei, S., Cao, S., Huang, S., Jiang, T., Gao, W., Xiong, W., He, W., Huang, W., Wu, W., He, W., Wei, X., Jia, X., Wu, X., Xu, X., Zu, X., Zhou, X., Pan, X., Charles, Y., Li, Y., Hu, Y., Liu, Y., Chen, Y., Wang, Y., Liu, Y., Qin, Y., Liu, Y., Yang, Y., Bao, Y., Du, Y., Wu, Y., Wang, Y., Zhou, Z., Wang, Z., Li, Z., Zhu, Z., Zhang, Z., Wang, Z., Yang, Z., Huang, Z., Huang, Z., Xu, Z., and Yang, Z. Kimi k1.5:利用大语言模型扩展强化学习,2025。URL https://arxiv.org/abs/2501.12599。
查看原页 Team, N. Sky-tl:在450\(预算下具备o1-preview性能的全开源推理模型,2025。URL https://novasky-ai.github.io/posts/sky-tl。访问日期:2025-01-09。
查看原页 Team, Q. Qwq:深入反思未知的边界,2024年11月。URL https://qwenlm.github.io/blog/qwq-32b-preview/。
查看原页 Wang, J., Meng, F., Liang, Y., and Zhou, J. Drt-o1:通过长思维链优化的深度推理翻译,2024a。URL https://arxiv.org/abs/2412.17498。
查看原页 Wang, P., Li, L., Shao, Z., Xu, R. X., Dai, D., Li, Y., Chen, D., Wu, Y., and Sui, Z. Math-shepherd:无需人工标注即可逐步验证并强化大语言模型,2024b。URL https://arxiv.org/abs/2312.08935。
查看原页 Wang, S., Liu, Z., Zhong, W., Zhou, M., Wei, Z., Chen, Z., and Duan, N. 来自Isat:复杂推理的进展与挑战,2021。URL https://arxiv.org/abs/2108.00648。
查看原页 Wang, Z., Dong, Y., Delalleau, O., Zeng, J., Shen, G., Egert, D., Zhang, J. J., Sreedhar, M. N., and Kuchaiev, O. Help-steer2:用于训练顶级奖励模型的开源数据集,2024c。URL https://arxiv.org/abs/2406.08673。
查看原页 Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q., and Zhou, D. 思维链提示引发大语言模型中的推理,2023。URL https://arxiv.org/abs/2201.11903。
查看原页 Welleck, S., Bertsch, A., Finlayson, M., Schoelkopf, H., Xie, A., Neubig, G., Kulikov, I., and Harchaoui, Z. 从解码到元生成:大语言模型的推理时算法,2024。URL https://arxiv.org/abs/2406.16838。
查看原页 Wu, T., Lan, J., Yuan, W., Jiao, J., Weston, J., and Sukhbaatar, S. 思考型大语言模型:通过思维生成实现通用指令遵循,2024a。URL https://arxiv.org/abs/2410.10630。Wu, Y., Sun, Z., Li, S., Welleck, S., and Yang, Y. 推理扩展定律:语言模型问题求解中计算最优推理的实证分析,2024b。URL https://arxiv.org/abs/2408.00724。Xiang, V., Snell, C., Gandhi, K., Albalak, A., Singh, A., Blagden, C., Phung, D., Rafailov, R., Lile, N., Mahan, D., Castricato, L., Franken, J.-P., Haber, N., and Finn, C. 迈向大语言模型中的系统2推理:通过元思维链学习如何思考,2025。URL https://arxiv.org/abs/2501.04682。Xie, Y., Kawaguchi, K., Zhao, Y., Zhao, X., Kan, M.-Y., He, J., and Xie, Q. 面向推理的自我评估引导束搜索,2023。URL https://arxiv.org/abs/2305.00633。Xin, H., Guo, D., Shao, Z., Ren, Z., Zhu, Q., Liu, B., Ruan, C., Li, W., and Liang, X. Deepseek-prover:通过大规模合成数据推进大语言模型中的定理证明,2024。URL https://arxiv.org/abs/2405.14333。Xu, H., Wu, X., Wang, W., Li, Z., Zheng, D., Chen, B., Hu, Y., Kang, S., Ji, J., Zhang, Y., Guo, Z., Yang, Y., Zhang, M., and Zhang, D. Redstar:扩展长思维链数据能否解锁更好的慢速推理系统?,2025。URL https://arxiv.org/abs/2501.11284。Yang, Z., Band, N., Li, S., Candès, E., and Hashimoto, T. 合成持续预训练,2024。URL https://arxiv.org/abs/2409.07431。Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y., and Narasimhan, K. 思维树:利用大语言模型进行审慎的问题求解,2023a。URL https://arxiv.org/abs/2305.10601。Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., and Cao, Y. React:在语言模型中协同推理与行动,2023b。URL https://arxiv.org/abs/2210.03629。Ye, Y., Huang, Z., Xiao, Y., Chern, E., Xia, S., and Liu, P. Limo:少即是多用于推理,2025a。URL https://arxiv.org/abs/2502.03387。Ye, Y., Xiao, Y., Mi, T., and Liu, P. Aime-preview:面向高级数学推理的严谨且即时评估框架。https://github.com/GAIR-NLP/AIME-Preview,2025b。GitHub仓库。
查看原页 Yu, L., Jiang, W., Shi, H., Yu, J., Liu, Z., Zhang, Y., Kwok, J. T., Li, Z., Weller, A., 和 Liu, W. Metamath:为大语言模型自举你自己的数学问题,2024。URL https://arxiv.org/abs/2309.12284。Yuan, S., Chen, Z., Xi, Z., Ye, J., Du, Z., 和 Chen, J. Agent-r:通过迭代自我训练训练语言模型智能体进行反思,2025。URL https://arxiv.org/abs/2501.11425。Zelikman, E., Wu, Y., Mu, J., 和 Goodman, N. D. Star:用推理自举推理,2022。URL https://arxiv.org/abs/2203.14465。Zelikman, E., Harik, G., Shao, Y., Jayasiri, V., Haber, N., 和 Goodman, N. D. Quiet-star:语言模型可以自学在说话之前思考,2024。URL https://arxiv.org/abs/2403.09629。Zhang, H. 和 Chen, C. 测试时计算扩展定律,2024。URL https://github.com/hughbzhang/ol_inference_scaling_laws。Zhang, S., Chen, Z., Shen, Y., Ding, M., Tenenbaum, J. B., 和 Gan, C. 使用大语言模型进行代码生成规划,2023。URL https://arxiv.org/abs/2303.05510。Zhang, Y., Wu, S., Yang, Y., Shu, J., Xiao, J., Kong, C., 和 Sang, J. ol-coder:面向编程的 ol 复现,2024a。URL https://arxiv.org/abs/2412.00154。Zhang, Y., Yang, J., Yuan, Y., 和 Yao, A. C.-C. 使用大语言模型的累积推理,2024b。URL https://arxiv.org/abs/2308.04371。Zhong, H., Xiao, C., Tu, C., Zhang, T., Liu, Z., 和 Sun, M. Jec-qa:一个法律领域问答数据集,2019。URL https://arxiv.org/abs/1911.12011。Zhong, W., Cui, R., Guo, Y., Liang, Y., Lu, S., Wang, Y., Saied, A., Chen, W., 和 Duan, N. Agieval:一个以人为中心的基础模型评估基准,2023。URL https://arxiv.org/abs/2304.06364。Zhou, A., Yan, K., Shlapentokh-Rothman, M., Wang, H., 和 Wang, Y.-X. 语言智能体树搜索统一了语言模型中的推理、行动和规划,2024。URL https://arxiv.org/abs/2310.04406。Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., Zhang, S., Ghosh, G., Lewis, M., Zettlemoyer, L., 和 Levy, O. Lima:少即是多,用于对齐,2023。URL https://arxiv.org/abs/2305.11206。
查看原页 C.2 完整 59K 问题的数据集构成 17
查看原页 A. s1.1在我们发布 s1 七天后,我们发布了 s1.1。我们使用 DeepSeek r1(DeepSeek-AI et al., 2025)为我们 s1K 中的 1,000 个样本重新生成了轨迹,以创建 s1K-1.1。我们使用相同的训练流程来训练我们的模型 s1.1。自我们发布以来的其他更新包括 o3(OpenAI, 2025)、LIMO(Ye et al., 2025a)和 AIME 2025 的发布。我们在表 5 中考虑了所有这些新进展。我们发现 s1.1 的表现显著优于 s1。我们还尝试了从 Claude 3.7 进行蒸馏,其表现比从 r1 蒸馏更差(未报告)。
查看原页 表5. s1-32B是一个开放且样本高效的推理模型。我们评估了s1-32B、Qwen和Gemini(一些条目未知(N.A.),见 § 4 \S 4 §4 )。其他结果来自各自的报告(Qwen et al., 2024; Team, 2024; OpenAI, 2024; 2025; DeepSeek-AI et al., 2025; Labs, 2025; Team, 2025),但AIME 2025除外(Ye et al., 2025b)。# ex. = = = 用于推理微调的示例数量; B F = \mathrm{BF} = BF = 预算强制。 查看原页 我们使用 vLLM(Kwon et al., 2023)运行评估,因为它比我们尝试过的替代方案更快。然而,我们发现即使使用相同的随机种子和贪婪采样,评估分数在不同运行之间也可能发生显著变化:
查看原页 不同的批大小导致不同结果,见 https://github.com/vllm- project/vllm/issues/5898 持续生成导致不同结果,见 https://github.com/vllm- project/vllm/issues/11783 张量并行性的变化导致不同结果
查看原页 由于我们的模型在给出答案之前会生成长推理轨迹,微小的数值变化可能像滚雪球一样演变成巨大差异。我们遇到许多生成结果在数千个 token 上完全相同,然后突然在一个 token 上出现差异,最终得到完全不同的答案。为了部分缓解这一问题,除非另有说明,我们通常使用全精度运行最终评估。
查看原页 表6. 我们的数据集s1K摘要。Token数量由Qwen-2.5分词器统计。我们提示Claude根据该领域中的若干问题生成关键词。 查看原页 表7. 全部59K问题的组成。思考和回复长度使用Qwen2.5-32B-Instruct分词器(Qwen et al., 2024)以token为单位测量。除了排除我们的评估基准AIME24外,我们还排除了2022-2023年的AIME问题,因为我们在s1-32B的开发阶段使用了这90个问题。 查看原页 为了在 § 2 \S 2 §2 中的数据集选择过程中对示例是否正确进行评分,我们使用图 8 中的提示。我们使用 Claude 3.5 进行评分,但最终 1,000 个样本之间的正确性除外,我们使用 Claude 3.7 进行评分。
查看原页 你是一个用于为科学问题评分的 AI 助手。用户将向你提供问题本身、学生所做的尝试以及问题的正确答案。你的工作是通过将尝试与正确答案进行比较来判断该尝试是否正确。如果预期解答以数字或选项作结,则不应存在歧义。如果预期解答涉及经历整个推理过程,你应根据推理过程是否正确以及在有帮助时答案是否正确来判断该尝试。
查看原页 解释你的推理,并在新的一行以仅包含“是”或“否”(不带引号)结束你的回答。
查看原页 算法 1 提供了我们在多样性选择阶段选择数据的算法。如 § 2 \S 2 §2 中所述,我们还包含来自一些我们认为高质量的特定基准的样本。没有任何样本与我们的最终评估重叠。
查看原页 我们通过检查所选示例与评估基准 MATH500、GPTQA Diamond 和 AIME24 之间的 8-gram 重叠来过滤所有样本。我们排除具有超过 8-gram 重叠的问题。
查看原页 1: 输入: Q ≔ Q\coloneqq Q : = 包含特征的问题集合,共24,496个问题 2: 输出: S ≔ S\coloneqq S : = 选中的问题集合,共1,000个问题 3: S ← ∅ S\leftarrow \emptyset S ← ∅ 初始化输出集合(仅跟踪唯一元素) 4: for q ∈ Q q\in Q q ∈ Q do 5: if IsGeminiCorrect ( q ) (q) ( q ) and (IsAIME ( q ) (q) ( q ) or IsGPQA ( q ) (q) ( q ) ) then 6: S ← S ∪ { q } S\gets S\cup \{q\} S ← S ∪ { q } 7: 选择所有正确的AIME/GPQA解答 8: else if IsGeminiCorrect ( q ) (q) ( q ) and IsMATH ( q ) (q) ( q ) and ThinkingLength ( q ) > 5600 (q) > 5600 ( q ) > 5600 then 9: S ← S ∪ { q } S\gets S\cup \{q\} S ← S ∪ { q } 10: 选择具有长思维链的正确MATH500解答 11: end if 12: end for 13: D ← D\gets D ← 所有可用领域 14: 初始化领域池 15: while ∣ S ∣ < 1000 |S|< 1000 ∣ S ∣ < 1000 do 16: d ← d\gets d ← RandomChoice ( D ) (D) ( D ) 17: 随机选择一个领域 18: Q d ← Q_{d}\gets Q d ← 领域 d d d 中的问题 19: 获取该领域的问题 20: ranks ← \leftarrow ← RankByThinkingLength ( Q d ) (Q_{d}) ( Q d ) 21: 按思维链长度排序 22: weights ← 2 − \leftarrow 2^{-} ← 2 − ranks 23: 应用幂律加权 24: q ← q\gets q ← WeightedSample ( Q d (Q_{d} ( Q d , weights) 25: 偏向更长思维链的采样 26: S ← S ∪ { q } S\gets S\cup \{q\} S ← S ∪ { q } 27: 添加选中的问题 28: Q d ← Q d ∖ { q } Q_{d}\gets Q_{d}\setminus \{q\} Q d ← Q d ∖ { q } 29: if Q d = ∅ Q_{d} = \emptyset Q d = ∅ then 30: D ← D ∖ { d } D\gets D\setminus \{d\} D ← D ∖ { d } 31: 移除已耗尽的领域 32: end if 33: end while
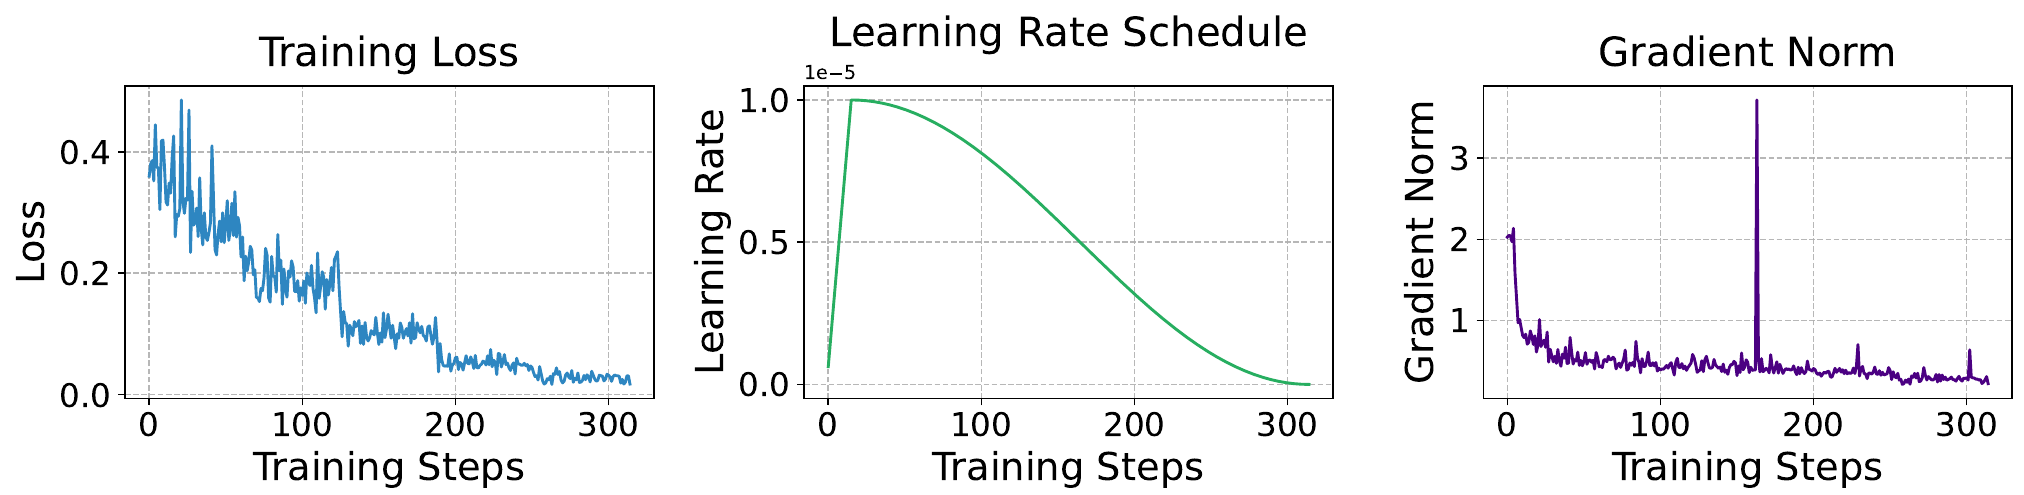
查看原页 我们取一个已经过预训练和指令微调的模型,进一步对其微调以进行推理。具体而言,我们使用Qwen2.5- 32B- Instruct (Qwen et al., 2024),该模型在数学任务上通常匹配或优于更大的Qwen2.5- 72B- Instruct (Qwen et al., 2024)或其他开放模型 (Dubey et al., 2024; Groeneveld et al., 2024; Muennighoff et al., 2024)。我们使用token分隔符将思考阶段与回答阶段分开。我们用<|im_start|>think和<|im_start|>answer包围思考阶段;两者前后均各有一个换行符。我们数据集的样本见 § D .2 \S \mathrm{D}.2 § D .2 。我们使用基本的微调超参数:我们训练5个epoch,批大小为16,总共315个梯度步。我们以bfloat16精度训练,学习率为 1 e − 5 1e - 5 1 e − 5 ,在前 5 % 5\% 5% (16步)线性预热,然后在剩余训练过程中(299步)按照余弦调度衰减至0。我们使用AdamW优化器 (Loshchilov & Hutter, 2019), β 1 = 0.9 \beta_{1} = 0.9 β 1 = 0.9 , β 2 = 0.95 \beta_{2} = 0.95 β 2 = 0.95 ,权重衰减为 1 e − 4 1e - 4 1 e − 4 。我们不在问题上计算损失,只在推理轨迹和解答上计算损失。我们确保序列长度足够大,以避免截断任何样本;我们在 § D .1 \S \mathrm{D}.1 § D .1 中对该设置进行了消融。训练在16块NVIDIA H100 GPU上仅需26分钟。
查看原页 查看原页 图9. s1-32B在s1K上的训练动态。
查看原页 表8. 训练序列长度消融。我们报告“准确率 / 每个样本的平均思维token数”;准确率越高且思维token数(推理成本)越少越好。
查看原页 除了我们在 § 5.2 \S 5.2 §5.2 中的扩展消融之外,我们消融的主要训练超参数是训练期间使用的序列长度。我们发现,较短的训练序列长度会导致测试时更长的推理轨迹。这是因为当使用较短的序列长度训练时,训练样本的答案部分更常被截断。相反,当训练序列长度较长时,更多样本以其完整形式出现,包括模型作答的部分。因此,模型接收到更多梯度更新,在其中学习在其思维链之后生成答案。这反过来导致生成过程中任意时刻答案部分的对数概率更高,从而在测试时产生更短的推理轨迹。在性能方面,我们还发现使用较长序列长度训练的模型表现更好。因此,我们选择最长的训练序列长度,因为它能带来更好的性能,并通过产生更短的推理轨迹使推理更高效。
查看原页 表9、表10、表11包含来自s1K的训练样本。
查看原页 表9. 来自s1- prob的s1K样本。黑色文本是问题,黄色文本是解答。仅基于问题,我们用Gemini生成浅蓝色推理轨迹和蓝色回答,我们将其用于训练。
查看原页 待翻译文本: 给定同一概率空间 ( Ω , F , P ) (\Omega ,\mathcal{F},\mathbb{P}) ( Ω , F , P ) 上的可积随机变量 X , Y 0 X,Y_{0} X , Y 0 和 Z 0 Z_{0} Z 0 ,以及两个 σ \sigma σ -代数 A ⊂ F , B ⊂ F \mathcal{A}\subset \mathcal{F},\mathcal{B}\subset \mathcal{F} A ⊂ F , B ⊂ F 。对于 k = 1 , 2 , … k = 1,2,\ldots k = 1 , 2 , … ,令
查看原页 Y k ≔ E [ X ∣ σ ( A , Z 0 , … , Z k − 1 ) ] , Z k ≔ E [ X ∣ σ ( B , Y 0 , … , Y k − 1 ) ] . Y_{k}\coloneqq \mathbb{E}[X|\sigma (\mathcal{A},Z_{0},\ldots ,Z_{k - 1})],\quad Z_{k}\coloneqq \mathbb{E}[X|\sigma (\mathcal{B},Y_{0},\ldots ,Y_{k - 1})]. Y k : = E [ X ∣ σ ( A , Z 0 , … , Z k − 1 )] , Z k : = E [ X ∣ σ ( B , Y 0 , … , Y k − 1 )] . 查看原页 (a) 证明存在可积随机变量 Y ∞ Y_{\infty} Y ∞ 和 Z ∞ Z_{\infty} Z ∞ ,使得当 n → ∞ n\to \infty n → ∞ 时, E [ ∣ Y n − Y ∞ ∣ ] → 0 \mathbb{E}[|Y_{n} - Y_{\infty}|]\to 0 E [ ∣ Y n − Y ∞ ∣ ] → 0 且 E [ ∣ Z n − Z ∞ ∣ ] → 0 \mathbb{E}[|Z_{n} - Z_{\infty}|]\to 0 E [ ∣ Z n − Z ∞ ∣ ] → 0 。(b) 证明几乎必然地 Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ 。
查看原页 1. 引入记号,对所有 n ≥ 1 n\geq 1 n ≥ 1 ,令 F n ≔ σ ( A , Z 0 , … , Z n − 1 ) F_{n}\coloneqq \sigma (\mathcal{A},Z_{0},\ldots ,Z_{n - 1}) F n : = σ ( A , Z 0 , … , Z n − 1 ) 和 G n ≔ σ ( B , Y 0 , … , Y n − 1 ) G_{n}\coloneqq \sigma (B,Y_{0},\ldots ,Y_{n - 1}) G n : = σ ( B , Y 0 , … , Y n − 1 ) ,并令 F 0 ≔ A F_{0}\coloneqq \mathcal{A} F 0 : = A , G 0 ≔ B G_{0}\coloneqq \mathcal{B} G 0 : = B 。显然,二者都是滤子,且根据定义,对所有 n ≥ 0 n\geq 0 n ≥ 0 ,有 Y n = E [ X ∣ F n ] Y_{n} = \mathbb{E}\left[X|F_{n}\right] Y n = E [ X ∣ F n ] 和 Z n = E [ X ∣ G n ] Z_{n} = \mathbb{E}\left[X|G_{n}\right] Z n = E [ X ∣ G n ] 。因此, { Y n } n ≥ 0 \left\{Y_{n}\right\}{n\geq 0} { Y n } n ≥ 0 (或 { Z n } n ≥ 0 \left\{Z{n}\right\}{n\geq 0} { Z n } n ≥ 0 )是关于滤子 { F n } n ≥ 0 \left\{F{n}\right\}{n\geq 0} { F n } n ≥ 0 (或 { G n } n ≥ 0 \left\{G{n}\right\}_{n\geq 0} { G n } n ≥ 0 )的Doob鞅,从而是一致可积的,因为 X X X 可积。现在应用如下事实:一个鞅是一致可积的当且仅当它在 L 1 L^{1} L 1 中收敛,并得出结论。
查看原页 E [ Y n ∣ G n ] = E [ E [ X ∣ F n ] ∣ G n ] = E [ E [ X ∣ G n ] ∣ F n ] = E [ Z n ∣ F n ] . ( 4 ) \mathbb{E}\left[Y_{n}|G_{n}\right] = \mathbb{E}\left[\mathbb{E}\left[X|F_{n}\right]|G_{n}\right] = \mathbb{E}\left[\mathbb{E}\left[X|G_{n}\right]|F_{n}\right] = \mathbb{E}\left[Z_{n}|F_{n}\right]. \quad (4) E [ Y n ∣ G n ] = E [ E [ X ∣ F n ] ∣ G n ] = E [ E [ X ∣ G n ] ∣ F n ] = E [ Z n ∣ F n ] . ( 4 ) 查看原页 注意 E [ E [ Y n ∣ G n ] − E [ Y ∞ ∣ G n ] ∣ ≤ E ∣ Y n − Y ∞ ∣ = o ( 1 ) \mathbb{E}[\mathbb{E}\left[Y_{n}|G_{n}\right] - \mathbb{E}\left[Y_{\infty}|G_{n}\right]|\leq \mathbb{E}|Y_{n} - Y_{\infty}| = o(1) E [ E [ Y n ∣ G n ] − E [ Y ∞ ∣ G n ] ∣ ≤ E ∣ Y n − Y ∞ ∣ = o ( 1 ) ,并且根据Levy向上定理, E [ Y ∞ ∣ G n ] ⟶ L 1 E [ Y ∞ ∣ G ∞ ] \mathbb{E}\left[Y_{\infty}|G_{n}\right]\stackrel {L^{1}}{\longrightarrow}\mathbb{E}\left[Y_{\infty}|G_{\infty}\right] E [ Y ∞ ∣ G n ] ⟶ L 1 E [ Y ∞ ∣ G ∞ ] ,其中 G ∞ = σ ( ∪ n ≥ 0 G n ) = σ ( B , Y 0 , Y 1 … ) G_{\infty} = \sigma \left(\cup_{n\geq 0}G_{n}\right) = \sigma (B,Y_{0},Y_{1}\ldots) G ∞ = σ ( ∪ n ≥ 0 G n ) = σ ( B , Y 0 , Y 1 … ) 。显然, Y ∞ ∈ m G ∞ Y_{\infty}\in m G_{\infty} Y ∞ ∈ m G ∞ (因为它是 Y n ∈ m G n Y_{n}\in m G_{n} Y n ∈ m G n 的几乎必然极限),因此几乎必然地 E [ Y ∞ ∣ G ∞ ] = Y ∞ \mathbb{E}\left[Y_{\infty}|G_{\infty}\right] = Y_{\infty} E [ Y ∞ ∣ G ∞ ] = Y ∞ 。结合上述观察,我们得出 E [ Y n ∣ G n ] ⟶ L 1 Y ∞ \mathbb{E}\left[Y_{n}|G_{n}\right]\stackrel {L^{1}}{\longrightarrow}Y_{\infty} E [ Y n ∣ G n ] ⟶ L 1 Y ∞ 。类似地, E [ Z n ∣ F n ] ⟶ L 1 Z ∞ \mathbb{E}\left[Z_{n}|F_{n}\right]\stackrel {L^{1}}{\longrightarrow}Z_{\infty} E [ Z n ∣ F n ] ⟶ L 1 Z ∞ 。现在引用式(4),得出几乎必然地 Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ 。
查看原页 2. 由于 X X X 可积,根据Levy向上定理,我们有 Y ∞ = lim n → ∞ Y n = lim n → ∞ E [ X ∣ F n ] = E [ X ∣ F ∞ ] Y_{\infty} = \lim_{n\to \infty}Y_{n} = \lim_{n\to \infty}\mathbb{E}\left[X|F_{n}\right] = \mathbb{E}\left[X|F_{\infty}\right] Y ∞ = lim n → ∞ Y n = lim n → ∞ E [ X ∣ F n ] = E [ X ∣ F ∞ ] 。类似地, Z ∞ = E [ X ∣ G ∞ ] Z_{\infty} = \mathbb{E}\left[X|G_{\infty}\right] Z ∞ = E [ X ∣ G ∞ ] 。另一方面,在第一种证明中我们已观察到 Y ∞ ∈ m G ∞ Y_{\infty}\in m G_{\infty} Y ∞ ∈ m G ∞ ,因此 Y ∞ ∈ Y_{\infty}\in Y ∞ ∈ m G ∞ ∩ m F ∞ = m ( G ∞ ∩ F ∞ ) m G_{\infty}\cap m F_{\infty} = m\left(G_{\infty}\cap F_{\infty}\right) m G ∞ ∩ m F ∞ = m ( G ∞ ∩ F ∞ ) 。由此得到以下结果。
查看原页 Y ∞ = E [ Y ∞ ∣ G ∞ ∩ F ∞ ] = E [ E [ X ∣ F ∞ ] ∣ G ∞ ∩ F ∞ ] = E [ X ∣ G ∞ ∩ F ∞ ] . Y_{\infty} = \mathbb{E}\left[Y_{\infty}|G_{\infty}\cap F_{\infty}\right] = \mathbb{E}\left[\mathbb{E}\left[X|F_{\infty}\right]|G_{\infty}\cap F_{\infty}\right] = \mathbb{E}\left[X|G_{\infty}\cap F_{\infty}\right]. Y ∞ = E [ Y ∞ ∣ G ∞ ∩ F ∞ ] = E [ E [ X ∣ F ∞ ] ∣ G ∞ ∩ F ∞ ] = E [ X ∣ G ∞ ∩ F ∞ ] . 查看原页 类似地, Z ∞ = E [ X ∣ G ∞ ∩ F ∞ ] Z_{\infty} = \mathbb{E}\left[X|G_{\infty}\cap F_{\infty}\right] Z ∞ = E [ X ∣ G ∞ ∩ F ∞ ] 。这证明了几乎必然地 Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ 。
查看原页 让我们分析这个问题。给定由条件期望定义的两个随机变量序列 Y k Y_{k} Y k 和 Z k Z_{k} Z k 。我们需要证明这些序列在 L 1 L^{1} L 1 中收敛,并且它们的极限几乎必然相等。
查看原页
F k = σ ( A , Z 0 , … , Z k − 1 ) F_{k} = \sigma (\mathcal{A},Z_{0},\ldots ,Z_{k - 1}) F k = σ ( A , Z 0 , … , Z k − 1 )
查看原页
G k = σ ( B , Y 0 , … , Y k − 1 ) G_{k} = \sigma (B,Y_{0},\ldots ,Y_{k - 1}) G k = σ ( B , Y 0 , … , Y k − 1 )
查看原页
Y 1 = E [ X ∣ σ ( A ) ] Y_{1} = \mathbb{E}[X|\sigma (\mathcal{A})] Y 1 = E [ X ∣ σ ( A )]
查看原页
Y 2 = E [ X ∣ σ ( A , Z 0 ) ] Y_{2} = \mathbb{E}[X|\sigma (\mathcal{A},Z_{0})] Y 2 = E [ X ∣ σ ( A , Z 0 )]
查看原页
Y 3 = E [ X ∣ σ ( A , Z 0 , Z 1 ) ] Y_{3} = \mathbb{E}[X|\sigma (\mathcal{A},Z_{0},Z_{1})] Y 3 = E [ X ∣ σ ( A , Z 0 , Z 1 )]
查看原页 sigma-代数序列 σ ( A , Z 0 , … , Z k − 1 ) \sigma (\mathcal{A},Z_{0},\ldots ,Z_{k - 1}) σ ( A , Z 0 , … , Z k − 1 ) 是递增的。根据鞅收敛定理(针对条件期望),由于 X X X 可积,序列 Y k Y_{k} Y k 几乎必然且依 L 1 L^{1} L 1 收敛到 E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] \mathbb{E}[X|\sigma (\mathcal{A},Z_{0},Z_{1},\ldots)] E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 。令 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y_{\infty} = \mathbb{E}[X|\sigma (\mathcal{A},Z_{0},Z_{1},\ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 。
查看原页 类似地,对于 Z k Z_{k} Z k 序列:
查看原页 Z 1 = E [ X ∣ σ ( B ) ] Z 2 = E [ X ∣ σ ( B , Y 0 ) ] Z 3 = E [ X ∣ σ ( B , Y 0 , Y 1 ) ] \begin{array}{c} Z_{1} = \mathbb{E}[X|\sigma (B)] \\ Z_{2} = \mathbb{E}[X|\sigma (B,Y_{0})] \\ Z_{3} = \mathbb{E}[X|\sigma (B,Y_{0},Y_{1})] \end{array} Z 1 = E [ X ∣ σ ( B )] Z 2 = E [ X ∣ σ ( B , Y 0 )] Z 3 = E [ X ∣ σ ( B , Y 0 , Y 1 )] 查看原页 sigma-代数序列 σ ( B , Y 0 , … , Y k − 1 ) \sigma (B,Y_{0},\ldots ,Y_{k - 1}) σ ( B , Y 0 , … , Y k − 1 ) 是递增的。根据鞅收敛定理,序列 Z k Z_{k} Z k 几乎必然且依 L 1 L^{1} L 1 收敛到 E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] \mathbb{E}[X|\sigma (B,Y_{0},Y_{1},\ldots)] E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。令 Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] Z_{\infty} = \mathbb{E}[X|\sigma (B,Y_{0},Y_{1},\ldots)] Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。
查看原页 第 (b) 部分:证明几乎必然有 Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ 。
查看原页 我们有 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y_{\infty} = \mathbb{E}[X|\sigma (A,Z_{0},Z_{1},\ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 和 Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] Z_{\infty} = \mathbb{E}[X|\sigma (B,Y_{0},Y_{1},\ldots)] Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。
查看原页 令 Y ∞ = σ ( A , Z 0 , Z 1 , … ) \mathcal{Y}{\infty} = \sigma (A,Z{0},Z_{1},\ldots) Y ∞ = σ ( A , Z 0 , Z 1 , … ) 和 Z ∞ = σ ( B , Y 0 , Y 1 , … ) Z_{\infty} = \sigma (B,Y_{0},Y_{1},\ldots) Z ∞ = σ ( B , Y 0 , Y 1 , … ) 。
查看原页 于是 Y ∞ = E [ X ∣ Y ∞ ] Y_{\infty} = \mathbb{E}[X|\mathcal{Y}{\infty}] Y ∞ = E [ X ∣ Y ∞ ] 和 Z ∞ = E [ X ∣ Z ∞ ] Z{\infty} = \mathbb{E}[X|Z_{\infty}] Z ∞ = E [ X ∣ Z ∞ ] 。
查看原页 考虑 Y 1 = E [ X ∣ A ] Y_{1} = \mathbb{E}[X|\mathcal{A}] Y 1 = E [ X ∣ A ] 。 Z 1 = E [ X ∣ B ] Z_{1} = \mathbb{E}[X|B] Z 1 = E [ X ∣ B ] 。
查看原页 Y 2 = E [ X ∣ σ ( A , Z 0 ) ] Y_{2} = \mathbb{E}[X|\sigma (A,Z_{0})] Y 2 = E [ X ∣ σ ( A , Z 0 )] 。由于 Z 0 = E [ X ∣ B ] Z_{0} = \mathbb{E}[X|B] Z 0 = E [ X ∣ B ] ,有 σ ( A , Z 0 ) = σ ( A , E [ X ∣ B ] ) \sigma (A,Z_{0}) = \sigma (A,\mathbb{E}[X|B]) σ ( A , Z 0 ) = σ ( A , E [ X ∣ B ]) 。
查看原页 Z 2 = E [ X ∣ σ ( B , Y 0 ) ] Z_{2} = \mathbb{E}[X|\sigma (B,Y_{0})] Z 2 = E [ X ∣ σ ( B , Y 0 )] 。由于 Y 0 Y_{0} Y 0 未定义,我们假设 Y 0 Y_{0} Y 0 和 Z 0 Z_{0} Z 0 是给定的。
查看原页 让我们考虑由所有 Y i Y_{i} Y i 和 Z i Z_{i} Z i 生成的 sigma-代数。
查看原页 令 G = σ ( Y 0 , Z 0 , Y 1 , Z 1 , … ) G = \sigma (Y_{0},Z_{0},Y_{1},Z_{1},\ldots) G = σ ( Y 0 , Z 0 , Y 1 , Z 1 , … ) 。
查看原页 Y k Y_{k} Y k 和 Z k Z_{k} Z k 都关于 G G G 可测。因此, Y ∞ Y_{\infty} Y ∞ 和 Z ∞ Z_{\infty} Z ∞ 关于 G G G 可测。
查看原页 考虑 E [ Y n + 1 ∣ A , Z 0 , … , Z n − 1 ] = E [ E [ X ∣ σ ( A , Z 0 , … , Z n ) ] ∣ A , Z 0 , … , Z n − 1 ] = Y n \mathbb{E}[Y_{n + 1}|\mathcal{A},Z_{0},\ldots ,Z_{n - 1}] = \mathbb{E}[\mathbb{E}[X|\sigma (A,Z_{0},\ldots ,Z_{n})]|\mathcal{A},Z_{0},\ldots ,Z_{n - 1}] = Y_{n} E [ Y n + 1 ∣ A , Z 0 , … , Z n − 1 ] = E [ E [ X ∣ σ ( A , Z 0 , … , Z n )] ∣ A , Z 0 , … , Z n − 1 ] = Y n 。
查看原页 考虑 E [ Z n + 1 ∣ B , Y 0 , … , Y n − 1 ] = E [ E [ X ∣ σ ( B , Y 0 , … , Y n ) ] ∣ B , Y 0 , … , Y n − 1 ] = Z n \mathbb{E}[Z_{n + 1}|B,Y_{0},\ldots ,Y_{n - 1}] = \mathbb{E}[\mathbb{E}[X|\sigma (B,Y_{0},\ldots ,Y_{n})]|B,Y_{0},\ldots ,Y_{n - 1}] = Z_{n} E [ Z n + 1 ∣ B , Y 0 , … , Y n − 1 ] = E [ E [ X ∣ σ ( B , Y 0 , … , Y n )] ∣ B , Y 0 , … , Y n − 1 ] = Z n 。
查看原页 令 H = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , Y 1 , Z 1 , … ) ) \mathcal{H} = \sigma (A\cup B\cup \sigma (Y_{0},Z_{0},Y_{1},Z_{1},\ldots)) H = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , Y 1 , Z 1 , … )) 。
查看原页 考虑 E [ X ∣ A , Z 0 , … , Z k − 1 ] = Y k \mathbb{E}[X|\mathcal{A},Z_{0},\ldots ,Z_{k - 1}] = Y_{k} E [ X ∣ A , Z 0 , … , Z k − 1 ] = Y k 。
查看原页 考虑 E [ X ∣ B , Y 0 , … , Y k − 1 ] = Z k \mathbb{E}[X|B,Y_{0},\ldots ,Y_{k - 1}] = Z_{k} E [ X ∣ B , Y 0 , … , Y k − 1 ] = Z k 。
查看原页 让我们考虑极限 sigma-代数 Y ∞ = σ ( A , Z 0 , Z 1 , … ) \mathcal{Y}{\infty} = \sigma (A,Z{0},Z_{1},\ldots) Y ∞ = σ ( A , Z 0 , Z 1 , … ) 和 Z ∞ = σ ( B , Y 0 , Y 1 , … ) Z_{\infty} = \sigma (B,Y_{0},Y_{1},\ldots) Z ∞ = σ ( B , Y 0 , Y 1 , … ) 。
查看原页 我们知道 Y ∞ Y_{\infty} Y ∞ 是 Y ∞ \mathcal{Y}{\infty} Y ∞ -可测的,且 Z ∞ Z{\infty} Z ∞ 是 Z ∞ Z_{\infty} Z ∞ -可测的。
查看原页 令 C = σ ( A ∪ B ) C = \sigma (A\cup B) C = σ ( A ∪ B ) 。
查看原页 Y 1 = E [ X ∣ A ] . Z 1 = E [ X ∣ B ] . Y_{1} = \mathbb{E}[X|\mathcal{A}]. Z_{1} = \mathbb{E}[X|B]. Y 1 = E [ X ∣ A ] . Z 1 = E [ X ∣ B ] . 查看原页 Y 2 = E [ X ∣ σ ( A , Z 0 ) ] = E [ X ∣ σ ( A , E [ X ∣ B ] ) ] . Y_{2} = \mathbb{E}[X|\sigma (A,Z_{0})] = \mathbb{E}[X|\sigma (A,\mathbb{E}[X|B])]. Y 2 = E [ X ∣ σ ( A , Z 0 )] = E [ X ∣ σ ( A , E [ X ∣ B ])] . 查看原页 Z 2 = E [ X ∣ σ ( B , Y 0 ) ] = E [ X ∣ σ ( B , E [ X ∣ A ] ) ] . Z_{2} = \mathbb{E}[X|\sigma (B,Y_{0})] = \mathbb{E}[X|\sigma (B,\mathbb{E}[X|A])]. Z 2 = E [ X ∣ σ ( B , Y 0 )] = E [ X ∣ σ ( B , E [ X ∣ A ])] . 查看原页 考虑 A \mathcal{A} A 和 B B B 独立的情形。那么 Y 1 = E [ X ∣ A ] Y_{1} = \mathbb{E}[X|\mathcal{A}] Y 1 = E [ X ∣ A ] 且 Z 1 = E [ X ∣ B ] Z_{1} = \mathbb{E}[X|B] Z 1 = E [ X ∣ B ] 。
查看原页 Y 2 = E [ X ∣ σ ( A , E [ X ∣ B ] ) ] Y_{2} = \mathbb{E}[X|\sigma (A,\mathbb{E}[X|B])] Y 2 = E [ X ∣ σ ( A , E [ X ∣ B ])] 。
查看原页 让我们考虑由所有信息生成的 sigma-代数。令 F ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … ) F_{\infty} = \sigma (A,B,Y_{0},Z_{0},Y_{1},Z_{1},\ldots) F ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … ) 。
查看原页 那么 Y ∞ Y_{\infty} Y ∞ 和 Z ∞ Z_{\infty} Z ∞ 都是 F ∞ F_{\infty} F ∞ -可测的。
查看原页 我们有 Y ∞ = lim n → ∞ Y n Y_{\infty} = \lim_{n\to \infty}Y_{n} Y ∞ = lim n → ∞ Y n 和 Z ∞ = lim n → ∞ Z n Z_{\infty} = \lim_{n\to \infty}Z_{n} Z ∞ = lim n → ∞ Z n 几乎必然且在 L 1 L^{1} L 1 中成立。
查看原页 考虑 E [ X ∣ A , Z 0 , Z 1 , … ] = Y ∞ \mathbb{E}[X|\mathcal{A},Z_{0},Z_{1},\ldots ] = Y_{\infty} E [ X ∣ A , Z 0 , Z 1 , … ] = Y ∞ 和 E [ X ∣ B , Y 0 , Y 1 , … ] = Z ∞ \mathbb{E}[X|B,Y_{0},Y_{1},\ldots ] = Z_{\infty} E [ X ∣ B , Y 0 , Y 1 , … ] = Z ∞ 。
查看原页 令 H ∞ = σ ( A ∪ B ) \mathcal{H}_{\infty} = \sigma (A\cup B) H ∞ = σ ( A ∪ B ) 。
查看原页 考虑 E [ X ∣ H ∞ ] \mathbb{E}[X|\mathcal{H}_{\infty}] E [ X ∣ H ∞ ] 。
查看原页 让我们尝试证明 Y ∞ Y_{\infty} Y ∞ 和 Z ∞ Z_{\infty} Z ∞ 都等于 E [ X ∣ σ ( A ∨ B ) ] \mathbb{E}[X|\sigma (A\vee B)] E [ X ∣ σ ( A ∨ B )] 。这似乎太简单了。
查看原页 让我们考虑条件期望的定义。对于任意集合 A ∈ Y ∞ A\in \mathcal{Y}{\infty} A ∈ Y ∞ , E [ Y ∞ ∣ A ] = E [ X ∣ A ] \mathbb{E}[Y{\infty}|{A}] = \mathbb{E}[X|{A}] E [ Y ∞ ∣ A ] = E [ X ∣ A ] 。
查看原页 对于任意集合 B ∈ Z ∞ B\in \mathcal{Z}{\infty} B ∈ Z ∞ , E [ Z ∞ ∣ B ] = E [ X ∣ B ] \mathbb{E}[Z{\infty}|{B}] = \mathbb{E}[X|{B}] E [ Z ∞ ∣ B ] = E [ X ∣ B ] 。
查看原页 考虑 E [ Y k + 1 ∣ F k ] = Y k \mathbb{E}[Y_{k + 1}|F_{k}] = Y_{k} E [ Y k + 1 ∣ F k ] = Y k ,其中 F k = σ ( A , Z 0 , … , Z k − 1 ) F_{k} = \sigma (A,Z_{0},\ldots ,Z_{k - 1}) F k = σ ( A , Z 0 , … , Z k − 1 ) 。
查看原页 考虑 E [ Z k + 1 ∣ G k ] = Z k \mathbb{E}[Z_{k + 1}|G_{k}] = Z_{k} E [ Z k + 1 ∣ G k ] = Z k ,其中 G k = σ ( B , Y 0 , … , Y k − 1 ) G_{k} = \sigma (B,Y_{0},\ldots ,Y_{k - 1}) G k = σ ( B , Y 0 , … , Y k − 1 ) 。
查看原页 考虑 sigma-代数 σ ( A ∪ B ) \sigma (A\cup B) σ ( A ∪ B ) 。
查看原页 令 W = E [ X ∣ σ ( A ∪ B ) ] W = \mathbb{E}[X|\sigma (A\cup B)] W = E [ X ∣ σ ( A ∪ B )] 。
查看原页 我们有 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y_{\infty} = \mathbb{E}[X|\sigma (A,Z_{0},Z_{1},\ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 。
查看原页 由于 Z k Z_{k} Z k 依赖于 Y k − 1 Y_{k - 1} Y k − 1 ,而后者又依赖于 Z k − 2 Z_{k - 2} Z k − 2 等等,因此情况很复杂。
查看原页 让我们考虑 Y 0 = E [ X ∣ A ] Y_{0} = \mathbb{E}[X|\mathcal{A}] Y 0 = E [ X ∣ A ] 且 Z 0 = E [ X ∣ B ] Z_{0} = \mathbb{E}[X|B] Z 0 = E [ X ∣ B ] 的情形。
查看原页 那么 Y 1 = E [ X ∣ A ] = Y 0 Y_{1} = \mathbb{E}[X|\mathcal{A}] = Y_{0} Y 1 = E [ X ∣ A ] = Y 0 。
查看原页 Z 1 = E [ X ∣ B ] = Z 0 . Z_{1} = \mathbb{E}[X|B] = Z_{0}. Z 1 = E [ X ∣ B ] = Z 0 . 查看原页 如果是这种情况,那么 Y k = Y 0 Y_{k} = Y_{0} Y k = Y 0 且 Z k = Z 0 Z_{k} = Z_{0} Z k = Z 0 ,所以 Y ∞ = Y 0 Y_{\infty} = Y_{0} Y ∞ = Y 0 且 Z ∞ = Z 0 Z_{\infty} = Z_{0} Z ∞ = Z 0 。
查看原页 我们需要 Y 0 = Z 0 Y_{0} = Z_{0} Y 0 = Z 0 几乎必然成立,即 E [ X ∣ A ] = E [ X ∣ B ] \mathbb{E}[X|\mathcal{A}] = \mathbb{E}[X|B] E [ X ∣ A ] = E [ X ∣ B ] 几乎必然成立。这通常并不成立。
查看原页 考虑由所有 Y i Y_{i} Y i 和 Z i Z_{i} Z i 生成的 sigma-代数,记为 G ∞ = σ ( Y 0 , Z 0 , Y 1 , Z 1 , … ) \mathcal{G}{\infty} = \sigma (Y{0},Z_{0},Y_{1},Z_{1},\ldots) G ∞ = σ ( Y 0 , Z 0 , Y 1 , Z 1 , … ) 。
查看原页 那么 Y ∞ = σ ( A , Z 0 , Z 1 , … ) ⊆ σ ( A , G ∞ ) \mathcal{Y}{\infty} = \sigma (A,Z{0},Z_{1},\ldots)\subseteq \sigma (A,G_{\infty}) Y ∞ = σ ( A , Z 0 , Z 1 , … ) ⊆ σ ( A , G ∞ ) 。
查看原页 \(\mathcal{Z}{\infty} = \sigma (B,Y{0},Y_{1},\ldots)\subseteq \sigma (B,G_{\infty})\) 。 考虑 \(\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ] = Y_{\infty}\) 。这意味着对于任意 \(A\in \sigma (A,Z_{0},Z_{1},\ldots)\) ,有 E [ X 1 A ] = E [ Y ∞ 1 A ] \mathbb{E}[X1_{A}] = \mathbb{E}[Y_{\infty 1_{A}}] E [ X 1 A ] = E [ Y ∞ 1 A ]
查看原页 考虑 \(\mathbb{E}[X|B,Y_{0},Y_{1},\ldots ] = Z_{\infty}\) 。这意味着对于任意 \(B\in \sigma (B,Y_{0},Y_{1},\ldots)\) ,有 E [ X 1 B ] = E [ Z ∞ 1 B ] \mathbb{E}[X1_{B}] = \mathbb{E}[Z_{\infty 1_{B}}] E [ X 1 B ] = E [ Z ∞ 1 B ]
查看原页 令 \(\mathcal{H} = \sigma (A,B)\)
查看原页 考虑 \(\mathbb{E}[X|\mathcal{H}].\)
查看原页 考虑 \(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ] = \mathbb{E}[\mathbb{E}[X|A,Z_{0},Z_{1},\ldots ]|B,Y_{0},Y_{1},\ldots ]\)
查看原页 让我们利用 \(Y_{\infty}\) 是 \(\sigma (A,Z_{0},Z_{1},\ldots)\) - 可测的,且 \(Z_{\infty}\) 是 \(\sigma (B,Y_{0},Y_{1},\ldots)\) - 可测的这一事实。
查看原页 考虑包含 \(\sigma (A,Z_{0},Z_{1},\ldots)\) 和 \(\sigma (B,Y_{0},Y_{1},\ldots)\) 两者的最小 sigma- 代数
查看原页 这就是 \(\sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0})\)
查看原页 让我们尝试证明 \(\mathbb{E}[(Y_{\infty} - Z_{\infty})^{2}] = 0\)
查看原页 E [ ( Y ∞ − Z ∞ ) 2 ] = E [ Y ∞ 2 ] + E [ Z ∞ 2 ] − 2 E [ Y ∞ Z ∞ ] \mathbb{E}[(Y_{\infty} - Z_{\infty})^{2}] = \mathbb{E}[Y_{\infty}^{2}] + \mathbb{E}[Z_{\infty}^{2}] - 2\mathbb{E}[Y_{\infty}Z_{\infty}] E [( Y ∞ − Z ∞ ) 2 ] = E [ Y ∞ 2 ] + E [ Z ∞ 2 ] − 2 E [ Y ∞ Z ∞ ]
查看原页 考虑 \(Y_{k}\) 和 \(Z_{k}\) 的定义
查看原页 E [ Y k + 1 ∣ A , Z 0 , … , Z k − 1 ] = Y k \mathbb{E}[Y_{k + 1}|A,Z_{0},\ldots ,Z_{k - 1}] = Y_{k} E [ Y k + 1 ∣ A , Z 0 , … , Z k − 1 ] = Y k
查看原页 E [ Z k + 1 ∣ B , Y 0 , … , Y k − 1 ] = Z k \mathbb{E}[Z_{k + 1}|B,Y_{0},\ldots ,Y_{k - 1}] = Z_{k} E [ Z k + 1 ∣ B , Y 0 , … , Y k − 1 ] = Z k
查看原页 考虑 \(\mathbb{E}[Y_{\infty}|B,Y_{0},Y_{1},\ldots ]\)
查看原页 由于 \(Y_{\infty}\) 关于 \(\sigma (A,Z_{0},Z_{1},\ldots)\) 可测,这并不容易简化。
查看原页 让我们假设在正测度集上 \(Y_{\infty}\neq Z_{\infty}\) 。
查看原页 考虑 \(A\) 和 \(B\) 为平凡的情形。
查看原页 那么 \(Y_{k} = \mathbb{E}[X|\sigma (Z_{0},\ldots ,Z_{k - 1})]\) 且 \(Z_{k} = \mathbb{E}[X|\sigma (Y_{0},\ldots ,Y_{k - 1})]\)
查看原页 令 \(\mathcal{H}{\infty} = \sigma (A\cup B\cup \{Y{i},Z_{i}\}_{i\geq 0})\)
查看原页 考虑 \(\mathbb{E}[X|\mathcal{H}_{\infty}]\)
查看原页 我们有 \(Y_{\infty} = \mathbb{E}[X|\sigma (A,Z_{0},Z_{1},\ldots)]\)
查看原页 根据条件期望的性质,\(\mathbb{E}[Y_{\infty}|\mathcal{A}] = \mathbb{E}[\mathbb{E}[X|\mathcal{A},Z_{0},Z_{1},\ldots ]|\mathcal{A}]\)
查看原页 考虑由所有涉及的随机变量生成的 sigma- 代数 \(D\) 。
查看原页 D = σ ( A ∪ B ∪ { Y i } i ≥ 0 ∪ { Z i } i ≥ 0 ) D = \sigma (A\cup B\cup \{Y_{i}\}{i\geq 0}\cup \{Z{i}\}_{i\geq 0}) D = σ ( A ∪ B ∪ { Y i } i ≥ 0 ∪ { Z i } i ≥ 0 )
查看原页 令 \(M_{\infty} = \mathbb{E}[X|A\vee B]\)
查看原页 考虑极限。当 \(n\to \infty\) 时,\(\sigma (A,Z_{0},\ldots ,Z_{n - 1})\uparrow \sigma (A,Z_{0},Z_{1},\ldots)\)
查看原页 当 \(n\to \infty\) 时,\(\sigma (B,Y_{0},\ldots ,Y_{n - 1})\uparrow \sigma (B,Y_{0},Y_{1},\ldots)\)
查看原页 令 Y ∞ = σ ( A , Z 0 , Z 1 , … ) Y_{\infty} = \sigma (A,Z_{0},Z_{1},\ldots) Y ∞ = σ ( A , Z 0 , Z 1 , … ) 和 Z ∞ = σ ( B , Y 0 , Y 1 , … ) Z_{\infty} = \sigma (B,Y_{0},Y_{1},\ldots) Z ∞ = σ ( B , Y 0 , Y 1 , … )
查看原页 我们有 Y ∞ = E [ X ∣ Y ∞ ] Y_{\infty} = \mathbb{E}[X|Y_{\infty}] Y ∞ = E [ X ∣ Y ∞ ] 和 Z ∞ = E [ X ∣ Z ∞ ] Z_{\infty} = \mathbb{E}[X|Z_{\infty}] Z ∞ = E [ X ∣ Z ∞ ]
查看原页 考虑 E [ Y ∞ − Z ∞ ] 2 = E [ ( Y ∞ − X ) + ( X − Z ∞ ) ] 2 \mathbb{E}[Y_{\infty} - Z_{\infty}]^{2} = \mathbb{E}[(Y_{\infty} - X) + (X - Z_{\infty})]^{2} E [ Y ∞ − Z ∞ ] 2 = E [( Y ∞ − X ) + ( X − Z ∞ ) ] 2
查看原页 = E [ ( Y ∞ − X ) 2 ] + E [ ( X − Z ∞ ) 2 ] + 2 E [ ( Y ∞ − X ) ( X − Z ∞ ) ] = \mathbb{E}[(Y_{\infty} - X)^{2}] + \mathbb{E}[(X - Z_{\infty})^{2}] + 2\mathbb{E}[(Y_{\infty} - X)(X - Z_{\infty})] = E [( Y ∞ − X ) 2 ] + E [( X − Z ∞ ) 2 ] + 2 E [( Y ∞ − X ) ( X − Z ∞ )] 查看原页 = E [ ( X − E [ X ∣ Y ∞ ] ) 2 ] + E [ ( X − E [ X ∣ Z ∞ ] ) 2 ] + 2 E [ Y ∞ X − Y ∞ Z ∞ − X 2 + X Z ∞ ] = \mathbb{E}[(X - \mathbb{E}[X|Y_{\infty}])^{2}] + \mathbb{E}[(X - \mathbb{E}[X|Z_{\infty}])^{2}] + 2\mathbb{E}[Y_{\infty}X - Y_{\infty}Z_{\infty} - X^{2} + XZ_{\infty}] = E [( X − E [ X ∣ Y ∞ ] ) 2 ] + E [( X − E [ X ∣ Z ∞ ] ) 2 ] + 2 E [ Y ∞ X − Y ∞ Z ∞ − X 2 + X Z ∞ ] 查看原页 = E [ X 2 ] − E [ Y ∞ 2 ] + E [ X 2 ] − E [ Z ∞ 2 ] + 2 E [ Y ∞ X ] − 2 E [ Y ∞ Z ∞ ] − 2 E [ X 2 ] + 2 E [ X Z ∞ ] = \mathbb{E}[X^{2}] - \mathbb{E}[Y_{\infty}^{2}] + \mathbb{E}[X^{2}] - \mathbb{E}[Z_{\infty}^{2}] + 2\mathbb{E}[Y_{\infty}X] - 2\mathbb{E}[Y_{\infty}Z_{\infty}] - 2\mathbb{E}[X^{2}] + 2\mathbb{E}[XZ_{\infty}] = E [ X 2 ] − E [ Y ∞ 2 ] + E [ X 2 ] − E [ Z ∞ 2 ] + 2 E [ Y ∞ X ] − 2 E [ Y ∞ Z ∞ ] − 2 E [ X 2 ] + 2 E [ X Z ∞ ] 查看原页 = − E [ Y ∞ 2 ] − E [ Z ∞ 2 ] + 2 E [ Y ∞ 2 ] − 2 E [ Y ∞ Z ∞ ] + 2 E [ Z ∞ 2 ] = -\mathbb{E}[Y_{\infty}^{2}] - \mathbb{E}[Z_{\infty}^{2}] + 2\mathbb{E}[Y_{\infty}^{2}] - 2\mathbb{E}[Y_{\infty}Z_{\infty}] + 2\mathbb{E}[Z_{\infty}^{2}] = − E [ Y ∞ 2 ] − E [ Z ∞ 2 ] + 2 E [ Y ∞ 2 ] − 2 E [ Y ∞ Z ∞ ] + 2 E [ Z ∞ 2 ] 查看原页 = E [ Y ∞ 2 ] + E [ Z ∞ 2 ] − 2 E [ Y ∞ Z ∞ ] = \mathbb{E}[Y_{\infty}^{2}] + \mathbb{E}[Z_{\infty}^{2}] - 2\mathbb{E}[Y_{\infty}Z_{\infty}] = E [ Y ∞ 2 ] + E [ Z ∞ 2 ] − 2 E [ Y ∞ Z ∞ ] 查看原页 考虑 sigma-代数 C = σ ( A ∪ B ) C = \sigma (A\cup B) C = σ ( A ∪ B )
查看原页 令 W = E [ X ∣ C ] W = \mathbb{E}[X|C] W = E [ X ∣ C ]
查看原页 考虑由所有信息生成的极限 sigma-代数。
查看原页 令 F ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … ) F_{\infty} = \sigma (A,B,Y_{0},Z_{0},Y_{1},Z_{1},\ldots) F ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … )
查看原页 那么 Y ∞ ⊆ F ∞ Y_{\infty}\subseteq F_{\infty} Y ∞ ⊆ F ∞ 和 Z ∞ ⊆ F ∞ Z_{\infty}\subseteq F_{\infty} Z ∞ ⊆ F ∞
查看原页 我们有 E [ X ∣ Y ∞ ] = Y ∞ \mathbb{E}[X|Y_{\infty}] = Y_{\infty} E [ X ∣ Y ∞ ] = Y ∞ 和 E [ X ∣ Z ∞ ] = Z ∞ \mathbb{E}[X|Z_{\infty}] = Z_{\infty} E [ X ∣ Z ∞ ] = Z ∞
查看原页 考虑 E [ Y ∞ ∣ Z ∞ ] \mathbb{E}[Y_{\infty}|Z_{\infty}] E [ Y ∞ ∣ Z ∞ ] 和 E [ Z ∞ ∣ Y ∞ ] \mathbb{E}[Z_{\infty}|Y_{\infty}] E [ Z ∞ ∣ Y ∞ ]
查看原页 令 H = σ ( A ∪ B ) \mathcal{H} = \sigma (A\cup B) H = σ ( A ∪ B )
查看原页 考虑 E [ X ∣ H ] \mathbb{E}[X|\mathcal{H}] E [ X ∣ H ]
查看原页 考虑序列对 ( Y k , Z k ) (Y_{k},Z_{k}) ( Y k , Z k )
查看原页 如果极限相同,那么对于任意有界可测函数 f f f , E [ f ( Y ∞ ) ] = E [ f ( Z ∞ ) ] \mathbb{E}[f(Y_{\infty})] = \mathbb{E}[f(Z_{\infty})] E [ f ( Y ∞ )] = E [ f ( Z ∞ )]
查看原页 考虑 sigma-代数 D = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … ) ) D = \sigma (A\cup B\cup \sigma (Y_{0},Z_{0},\ldots)) D = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … ))
查看原页 那么 Y ∞ Y_{\infty} Y ∞ 和 Z ∞ Z_{\infty} Z ∞ 都关于 D D D 可测
查看原页 考虑 E [ ( Y n − Z n ) 2 ] \mathbb{E}[(Y_{n} - Z_{n})^{2}] E [( Y n − Z n ) 2 ]
查看原页 令 G = σ ( A ∪ B ) G = \sigma (A\cup B) G = σ ( A ∪ B )
查看原页 考虑 W = E [ X ∣ G ] W = \mathbb{E}[X|G] W = E [ X ∣ G ]
查看原页 那么 E [ W ∣ A ] = E [ X ∣ A ] \mathbb{E}[W|A] = \mathbb{E}[X|A] E [ W ∣ A ] = E [ X ∣ A ] 和 E [ W ∣ B ] = E [ X ∣ B ] \mathbb{E}[W|B] = \mathbb{E}[X|B] E [ W ∣ B ] = E [ X ∣ B ] 考虑极限 sigma-代数 L = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … ) ) \mathcal{L} = \sigma (\mathcal{A} \cup \mathcal{B} \cup \sigma (Y_{0}, Z_{0}, \ldots)) L = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … )) 。
查看原页 我们有 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y_{\infty} = \mathbb{E}[X|\sigma (\mathcal{A}, Z_{0}, Z_{1}, \ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 和 Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] Z_{\infty} = \mathbb{E}[X|\sigma (B, Y_{0}, Y_{1}, \ldots)] Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。
查看原页 令 M = σ ( A , Z 0 , Z 1 , … ) ∨ σ ( B , Y 0 , Y 1 , … ) \mathcal{M} = \sigma (\mathcal{A}, Z_{0}, Z_{1}, \ldots) \vee \sigma (B, Y_{0}, Y_{1}, \ldots) M = σ ( A , Z 0 , Z 1 , … ) ∨ σ ( B , Y 0 , Y 1 , … ) 。
查看原页 考虑 E [ X ∣ M ] \mathbb{E}[X|\mathcal{M}] E [ X ∣ M ] 。
查看原页 考虑随机变量 X X X 。那么 Y ∞ = lim n E [ X ∣ F n ] Y_{\infty} = \lim_{n} \mathbb{E}[X|\mathcal{F}{n}] Y ∞ = lim n E [ X ∣ F n ] 和 Z ∞ = lim n E [ X ∣ G n ] Z{\infty} = \lim_{n} \mathbb{E}[X|\mathcal{G}_{n}] Z ∞ = lim n E [ X ∣ G n ] 。
查看原页 令 H ∞ = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … ) ) \mathcal{H}{\infty} = \sigma (\mathcal{A} \cup \mathcal{B} \cup \sigma (Y{0}, Z_{0}, \ldots)) H ∞ = σ ( A ∪ B ∪ σ ( Y 0 , Z 0 , … )) 。
查看原页 考虑 E = { ω : Y ∞ ( ω ) ≠ Z ∞ ( ω ) } E = \{\omega : Y_{\infty}(\omega) \neq Z_{\infty}(\omega)\} E = { ω : Y ∞ ( ω ) = Z ∞ ( ω )} 。假设 P ( E ) > 0 P(E) > 0 P ( E ) > 0 。
查看原页 考虑关于 sigma-代数并的联合的条件期望。
查看原页 令 C ∞ = σ ( A , B , Y 0 , Z 0 , … ) C_{\infty} = \sigma (\mathcal{A}, B, Y_{0}, Z_{0}, \ldots) C ∞ = σ ( A , B , Y 0 , Z 0 , … ) 。
查看原页 考虑 E [ X ∣ C ∞ ] \mathbb{E}[X|C_{\infty}] E [ X ∣ C ∞ ] 。
查看原页 那么 E [ E [ X ∣ C ∞ ] ∣ A , Z 0 , … ] = E [ X ∣ A , Z 0 , … ] = Y n + 1 \mathbb{E}[\mathbb{E}[X|C_{\infty}]|\mathcal{A}, Z_{0}, \ldots ] = \mathbb{E}[X|\mathcal{A}, Z_{0}, \ldots ] = Y_{n + 1} E [ E [ X ∣ C ∞ ] ∣ A , Z 0 , … ] = E [ X ∣ A , Z 0 , … ] = Y n + 1 。
查看原页 并且 E [ E [ X ∣ C ∞ ] ∣ B , Y 0 , … ] = E [ X ∣ B , Y 0 , … ] = Z n + 1 \mathbb{E}[\mathbb{E}[X|C_{\infty}]|B, Y_{0}, \ldots ] = \mathbb{E}[X|B, Y_{0}, \ldots ] = Z_{n + 1} E [ E [ X ∣ C ∞ ] ∣ B , Y 0 , … ] = E [ X ∣ B , Y 0 , … ] = Z n + 1 。
查看原页 因此 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y_{\infty} = \mathbb{E}[X|\sigma (\mathcal{A}, Z_{0}, Z_{1}, \ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 且 Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] Z_{\infty} = \mathbb{E}[X|\sigma (B, Y_{0}, Y_{1}, \ldots)] Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。
查看原页 令 F ∞ = σ ( A , Z 0 , Z 1 , … ) \mathcal{F}{\infty} = \sigma (\mathcal{A}, Z{0}, Z_{1}, \ldots) F ∞ = σ ( A , Z 0 , Z 1 , … ) 且 G ∞ = σ ( B , Y 0 , Y 1 , … ) G_{\infty} = \sigma (B, Y_{0}, Y_{1}, \ldots) G ∞ = σ ( B , Y 0 , Y 1 , … ) 。
查看原页 考虑 E [ X ∣ F ∞ ∨ G ∞ ] \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] E [ X ∣ F ∞ ∨ G ∞ ] 。
查看原页 则 E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ \mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty} E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ 。
查看原页 且 E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ \mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty} E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ 。
查看原页 这意味着 Y ∞ = E [ X ∣ F ∞ ∨ G ∞ ] Y_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] Y ∞ = E [ X ∣ F ∞ ∨ G ∞ ] a.s. 且 Z ∞ = E [ X ∣ F ∞ ∨ G ∞ ] Z_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] Z ∞ = E [ X ∣ F ∞ ∨ G ∞ ] a.s.
查看原页 因此, Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ a.s.
查看原页 (a) 对于序列 Y k Y_{k} Y k , σ \sigma σ -代数 F k = σ ( A , Z 0 , … , Z k − 1 ) \mathcal{F}{k} = \sigma (\mathcal{A}, Z{0}, \ldots , Z_{k - 1}) F k = σ ( A , Z 0 , … , Z k − 1 ) 随 k k k 增大而递增。由于 X X X 可积,由条件期望的鞅收敛定理,序列 Y k = E [ X ∣ F k ] Y_{k} = \mathbb{E}[X|\mathcal{F}{k}] Y k = E [ X ∣ F k ] 几乎必然且依 L 1 L^{1} L 1 收敛到 Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … ) ] Y{\infty} = \mathbb{E}[X|\sigma (\mathcal{A}, Z_{0}, Z_{1}, \ldots)] Y ∞ = E [ X ∣ σ ( A , Z 0 , Z 1 , … )] 。类似地,对于序列 Z k Z_{k} Z k , σ \sigma σ -代数 G k = σ ( B , Y 0 , … , Y k − 1 ) G_{k} = \sigma (B, Y_{0}, \ldots , Y_{k - 1}) G k = σ ( B , Y 0 , … , Y k − 1 ) 递增。由于 X X X 可积,由鞅收敛定理,序列 Z k = E [ X ∣ G k ] Z_{k} = \mathbb{E}[X|G_{k}] Z k = E [ X ∣ G k ] 几乎必然且依 L 1 L^{1} L 1 收敛到 Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … ) ] Z_{\infty} = \mathbb{E}[X|\sigma (B, Y_{0}, Y_{1}, \ldots)] Z ∞ = E [ X ∣ σ ( B , Y 0 , Y 1 , … )] 。
查看原页 (b) 令 F ∞ = σ ( A , Z 0 , Z 1 , … ) \mathcal{F}{\infty} = \sigma (\mathcal{A}, Z{0}, Z_{1}, \ldots) F ∞ = σ ( A , Z 0 , Z 1 , … ) 且 G ∞ = σ ( B , Y 0 , Y 1 , … ) G_{\infty} = \sigma (B, Y_{0}, Y_{1}, \ldots) G ∞ = σ ( B , Y 0 , Y 1 , … ) 。我们有 Y ∞ = E [ X ∣ F ∞ ] Y_{\infty} = \mathbb{E}[X|\mathcal{F}{\infty}] Y ∞ = E [ X ∣ F ∞ ] 且 Z ∞ = E [ X ∣ G ∞ ] Z{\infty} = \mathbb{E}[X|G_{\infty}] Z ∞ = E [ X ∣ G ∞ ] 。考虑 σ \sigma σ -代数 H = F ∞ ∨ G ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … ) \mathcal{H} = \mathcal{F}{\infty} \vee G{\infty} = \sigma (\mathcal{A}, B, Y_{0}, Z_{0}, Y_{1}, Z_{1}, \ldots) H = F ∞ ∨ G ∞ = σ ( A , B , Y 0 , Z 0 , Y 1 , Z 1 , … ) 。考虑 W = E [ X ∣ H ] W = \mathbb{E}[X|\mathcal{H}] W = E [ X ∣ H ] 。
查看原页 我们有 F ∞ ⊆ H \mathcal{F}{\infty} \subseteq \mathcal{H} F ∞ ⊆ H ,因此 E [ W ∣ F ∞ ] = E [ E [ X ∣ H ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ \mathbb{E}[W|\mathcal{F}{\infty}] = \mathbb{E}[\mathbb{E}[X|\mathcal{H}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty} E [ W ∣ F ∞ ] = E [ E [ X ∣ H ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ 。
查看原页 由于 W W W 是 H \mathcal{H} H -可测的, E [ W ∣ F ∞ ] = Y ∞ \mathbb{E}[W|\mathcal{F}{\infty}] = Y{\infty} E [ W ∣ F ∞ ] = Y ∞ 意味着 Y ∞ Y_{\infty} Y ∞ 是 W W W 在给定 F ∞ \mathcal{F}{\infty} F ∞ 下的条件期望。但由于 Y ∞ Y{\infty} Y ∞ 已经是 F ∞ \mathcal{F}{\infty} F ∞ -可测的,若 W W W 是 F ∞ \mathcal{F}{\infty} F ∞ -可测的,则我们有 E [ W ∣ F ∞ ] = W \mathbb{E}[W|\mathcal{F}_{\infty}] = W E [ W ∣ F ∞ ] = W ,而这未必成立。
查看原页 然而,我们知道 E [ Y ∞ ∣ F ∞ ] = Y ∞ \mathbb{E}[Y_{\infty}|\mathcal{F}{\infty}] = Y{\infty} E [ Y ∞ ∣ F ∞ ] = Y ∞ 且 E [ Z ∞ ∣ G ∞ ] = Z ∞ \mathbb{E}[Z_{\infty}|G_{\infty}] = Z_{\infty} E [ Z ∞ ∣ G ∞ ] = Z ∞ 。
查看原页 考虑 E [ X ∣ F ∞ ∨ G ∞ ] \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] E [ X ∣ F ∞ ∨ G ∞ ] 。
查看原页 那么 E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ \mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|\mathcal{F}{\infty}] = \mathbb{E}[X|\mathcal{F}{\infty}] = Y_{\infty} E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ F ∞ ] = E [ X ∣ F ∞ ] = Y ∞ 。
查看原页 这意味着 E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty} E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ 。
查看原页 类似地, E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ \mathbb{E}[\mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}]|G_{\infty}] = \mathbb{E}[X|G_{\infty}] = Z_{\infty} E [ E [ X ∣ F ∞ ∨ G ∞ ] ∣ G ∞ ] = E [ X ∣ G ∞ ] = Z ∞ 。
查看原页 这意味着 E [ X ∣ F ∞ ∨ G ∞ ] = Z ∞ \mathbb{E}[X|\mathcal{F}{\infty} \vee G{\infty}] = Z_{\infty} E [ X ∣ F ∞ ∨ G ∞ ] = Z ∞ 几乎必然成立。
查看原页 因此, Y ∞ = Z ∞ Y_{\infty} = Z_{\infty} Y ∞ = Z ∞ 几乎必然成立。
查看原页 最终答案:最终答案是 [ Y ∞ = Z ∞ ] \left[Y_{\infty} = Z_{\infty}\right] [ Y ∞ = Z ∞ ]
查看原页 表10. 源自s1-teasers的s1K样本。黑色文本是问题,黄色文本是解答。仅基于问题,我们生成浅蓝色推理轨迹和蓝色回复,并使用Gemini进行训练。
查看原页 Alice和Bob各有一枚硬币,并不断抛掷直到出现正面。如果Bob抛掷硬币的次数比Alice多,那么Alice抛掷硬币的期望次数是多少?
查看原页 题目要求的是,在Bob抛掷硬币的次数比Alice多的情况下,Alice抛掷硬币的期望次数。
查看原页 设 X X X 为Alice直到出现正面所抛掷的次数。
查看原页 设 Y Y Y 为Bob直到出现正面所抛掷的次数。
查看原页 X X X 和 Y Y Y 是独立随机变量,服从参数为 p = 0.5 p = 0.5 p = 0.5 (出现正面的概率)的几何分布。
查看原页 几何分布的概率质量函数为 P ( K = k ) = ( 1 − p ) k − 1 p P(K = k) = (1 - p)^{k - 1}p P ( K = k ) = ( 1 − p ) k − 1 p ,其中 k = 1 , 2 , … k = 1,2,\ldots k = 1 , 2 , …
查看原页 在这种情况下, p = 0.5 p = 0.5 p = 0.5 ,所以 P ( K = k ) = ( 0.5 ) k − 1 ( 0.5 ) = ( 0.5 ) k = 1 2 k P(K = k) = (0.5)^{k - 1}(0.5) = (0.5)^{k} = \frac{1}{2^{k}} P ( K = k ) = ( 0.5 ) k − 1 ( 0.5 ) = ( 0.5 ) k = 2 k 1 。
查看原页 已知条件是Bob抛掷硬币的次数比Alice多,这意味着 Y > X Y > X Y > X 。
查看原页 我们要求在给定 Y > X Y > X Y > X 的条件下 X X X 的期望值,即 E [ X ∣ Y > X ] E[X|Y > X] E [ X ∣ Y > X ] 。
查看原页 条件期望的公式为 E [ X ∣ A ] = ∑ x x P ( X = x ∣ A ) E[X|A] = \sum_{x}xP(X = x|A) E [ X ∣ A ] = ∑ x x P ( X = x ∣ A ) 。
查看原页 此外, P ( X = x ∣ A ) = P ( X = x ∩ A ) P ( A ) P(X = x|A) = \frac{P(X = x\cap A)}{P(A)} P ( X = x ∣ A ) = P ( A ) P ( X = x ∩ A ) 。
查看原页 在我们的情况中, A A A 是事件 Y > X Y > X Y > X 。
查看原页 我们需要求 P ( Y > X ) P(Y > X) P ( Y > X ) 。
查看原页 P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ P ( X = x , Y = y ) P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}P(X = x,Y = y) P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ P ( X = x , Y = y )
查看原页 由于 X X X 和 Y Y Y 独立, P ( X = x , Y = y ) = P ( X = x ) P ( Y = y ) = 1 2 x 1 2 y = 1 2 x + y P(X = x,Y = y) = P(X = x)P(Y = y) = \frac{1}{2^{x}}\frac{1}{2^{y}} = \frac{1}{2^{x + y}} P ( X = x , Y = y ) = P ( X = x ) P ( Y = y ) = 2 x 1 2 y 1 = 2 x + y 1 。
查看原页 P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ 1 2 x + y = ∑ x = 1 ∞ 1 2 x ∑ y = x + 1 ∞ 1 2 y P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}\frac{1}{2^{x + y}} = \sum_{x = 1}^{\infty}\frac{1}{2^{x}}\sum_{y = x + 1}^{\infty}\frac{1}{2^{y}} P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ 2 x + y 1 = ∑ x = 1 ∞ 2 x 1 ∑ y = x + 1 ∞ 2 y 1
查看原页 内层和是一个几何级数: ∑ y = x + 1 ∞ ( 1 2 ) y = ( 1 2 ) x + 1 + ( 1 2 ) x + 2 + … \sum_{y = x + 1}^{\infty}\left(\frac{1}{2}\right)^{y} = \left(\frac{1}{2}\right)^{x + 1} + \left(\frac{1}{2}\right)^{x + 2} + \ldots ∑ y = x + 1 ∞ ( 2 1 ) y = ( 2 1 ) x + 1 + ( 2 1 ) x + 2 + …
查看原页 这是一个首项 a = ( 1 2 ) x + 1 a = \left(\frac{1}{2}\right)^{x + 1} a = ( 2 1 ) x + 1 、公比 r = 1 2 r = \frac{1}{2} r = 2 1 的几何级数。
查看原页 其和为 a 1 − r = ( 1 2 ) x + 1 1 1 − 1 2 = ( 1 2 ) x + 1 1 2 = ( 1 2 ) x \frac{a}{1 - r} = \frac{\left(\frac{1}{2}\right)^{x + 1}}{\frac{1}{1 - \frac{1}{2}}} = \frac{\left(\frac{1}{2}\right)^{x + 1}}{\frac{1}{2}} = \left(\frac{1}{2}\right)^{x} 1 − r a = 1 − 2 1 1 ( 2 1 ) x + 1 = 2 1 ( 2 1 ) x + 1 = ( 2 1 ) x 。
查看原页 所以, P ( Y > X ) = ∑ x = 1 ∞ 1 2 x ( 1 2 ) x = ∑ x = 1 ∞ ( 1 4 ) x P(Y > X) = \sum_{x = 1}^{\infty}\frac{1}{2^{x}}\left(\frac{1}{2}\right)^{x} = \sum_{x = 1}^{\infty}\left(\frac{1}{4}\right)^{x} P ( Y > X ) = ∑ x = 1 ∞ 2 x 1 ( 2 1 ) x = ∑ x = 1 ∞ ( 4 1 ) x 。
查看原页 这是另一个首项 a = 1 4 a = \frac{1}{4} a = 4 1 、公比 r = 1 4 r = \frac{1}{4} r = 4 1 的几何级数。
查看原页 其和为 a 1 − r = 1 4 1 1 − 1 4 = 1 4 1 4 = 1 3 \frac{a}{1 - r} = \frac{\frac{1}{4}}{\frac{1}{1 - \frac{1}{4}}} = \frac{\frac{1}{4}}{\frac{1}{4}} = \frac{1}{3} 1 − r a = 1 − 4 1 1 4 1 = 4 1 4 1 = 3 1 。
查看原页 现在,我们需要求 P ( X = x ∩ Y > X ) = P ( X = x , Y > x ) P(X = x\cap Y > X) = P(X = x,Y > x) P ( X = x ∩ Y > X ) = P ( X = x , Y > x ) 。
查看原页 由独立性, P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) P(X = x,Y > x) = P(X = x)P(Y > x) P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) 。
查看原页 P ( Y > x ) = ∑ x = 1 ∞ P ( Y = y ) = ∑ x = 1 ∞ 1 2 y = ( 1 2 ) x + 1 + ( 1 2 ) x + 2 + ⋯ = ( 1 2 ) x P(Y > x) = \sum_{x = 1}^{\infty}P(Y = y) = \sum_{x = 1}^{\infty}\frac{1}{2^{y}} = \left(\frac{1}{2}\right)^{x + 1} + \left(\frac{1}{2}\right)^{x + 2} + \dots = \left(\frac{1}{2}\right)^{x} P ( Y > x ) = ∑ x = 1 ∞ P ( Y = y ) = ∑ x = 1 ∞ 2 y 1 = ( 2 1 ) x + 1 + ( 2 1 ) x + 2 + ⋯ = ( 2 1 ) x 。
查看原页 所以, P ( X = x , Y > x ) = 1 2 x × ( 1 2 ) x = ( 1 4 ) x P(X = x,Y > x) = \frac{1}{2^{x}}\times \left(\frac{1}{2}\right)^{x} = \left(\frac{1}{4}\right)^{x} P ( X = x , Y > x ) = 2 x 1 × ( 2 1 ) x = ( 4 1 ) x 。
查看原页 现在,我们可以求出 P ( X = x ∣ Y > X ) = P ( X = x ∩ Y > X ) P ( Y > X ) = ( 1 4 ) x 3 = 3 ( 1 4 ) x P(X = x|Y > X) = \frac{P(X = x\cap Y > X)}{P(Y > X)} = \frac{\left(\frac{1}{4}\right)^{x}}{3} = 3\left(\frac{1}{4}\right)^{x} P ( X = x ∣ Y > X ) = P ( Y > X ) P ( X = x ∩ Y > X ) = 3 ( 4 1 ) x = 3 ( 4 1 ) x 。
查看原页 E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) = ∑ x = 1 ∞ x ⋅ 3 ( 1 4 ) x = 3 ∑ x = 1 ∞ x ( 1 4 ) x . E[X|Y > X] = \sum_{x = 1}^{\infty}xP(X = x|Y > X) = \sum_{x = 1}^{\infty}x\cdot 3\left(\frac{1}{4}\right)^{x} = 3\sum_{x = 1}^{\infty}x\left(\frac{1}{4}\right)^{x}. E [ X ∣ Y > X ] = x = 1 ∑ ∞ x P ( X = x ∣ Y > X ) = x = 1 ∑ ∞ x ⋅ 3 ( 4 1 ) x = 3 x = 1 ∑ ∞ x ( 4 1 ) x . 查看原页 考虑级数 S = ∑ x = 1 ∞ x r x S = \sum_{x = 1}^{\infty}xr^{x} S = ∑ x = 1 ∞ x r x ,其中 ∣ r ∣ < 1 |r|< 1 ∣ r ∣ < 1 。
查看原页 S = r + 2 r 2 + 3 r 3 + 4 r 4 + … S = r + 2r^{2} + 3r^{3} + 4r^{4} + \ldots S = r + 2 r 2 + 3 r 3 + 4 r 4 + … 查看原页 S r = 1 + 2 r + 3 r 2 + 4 r 3 + … \frac{S}{r} = 1 + 2r + 3r^{2} + 4r^{3} + \ldots r S = 1 + 2 r + 3 r 2 + 4 r 3 + … 查看原页 考虑几何级数 G = 1 + r + r 2 + r 3 + ⋯ = 1 1 − r G = 1 + r + r^{2} + r^{3} + \dots = \frac{1}{1 - r} G = 1 + r + r 2 + r 3 + ⋯ = 1 − r 1 。
查看原页 d G d r = 1 + 2 r + 3 r 2 + 4 r 3 + ⋯ = d d r ( 1 1 − r ) = 1 ( 1 − r ) 2 . \frac{dG}{dr} = 1 + 2r + 3r^{2} + 4r^{3} + \dots = \frac{d}{dr}\left(\frac{1}{1 - r}\right) = \frac{1}{(1 - r)^{2}}. d r d G = 1 + 2 r + 3 r 2 + 4 r 3 + ⋯ = d r d ( 1 − r 1 ) = ( 1 − r ) 2 1 . 查看原页 所以, S r = 1 ( 1 − r ) 2 \frac{S}{r} = \frac{1}{(1 - r)^{2}} r S = ( 1 − r ) 2 1 ,这意味着 S = r ( 1 − r ) 2 S = \frac{r}{(1 - r)^{2}} S = ( 1 − r ) 2 r 。
查看原页 在我们的情况下, r = 1 4 r = \frac{1}{4} r = 4 1 。
查看原页 ∑ X = 1 ∞ x ( 1 4 ) x = 1 4 ( 1 − 1 4 ) 2 = 1 4 ( 3 4 ) 2 = 1 4 9 = 1 4 × 16 9 = 4 9 . \sum_{X = 1}^{\infty}x(\frac{1}{4})^{x} = \frac{\frac{1}{4}}{(1 - \frac{1}{4})^{2}} = \frac{\frac{1}{4}}{(\frac{3}{4})^{2}} = \frac{\frac{1}{4}}{9} = \frac{1}{4}\times \frac{16}{9} = \frac{4}{9}. X = 1 ∑ ∞ x ( 4 1 ) x = ( 1 − 4 1 ) 2 4 1 = ( 4 3 ) 2 4 1 = 9 4 1 = 4 1 × 9 16 = 9 4 . 查看原页 因此, E [ X ∣ Y > X ] = 3 × 4 9 = 12 9 = 4 3 E[X|Y > X] = 3\times \frac{4}{9} = \frac{12}{9} = \frac{4}{3} E [ X ∣ Y > X ] = 3 × 9 4 = 9 12 = 3 4
查看原页 考虑事件 Y > X Y > X Y > X 、 X > Y X > Y X > Y 和 X = Y X = Y X = Y 。
查看原页 由于对称性, P ( Y > X ) = P ( X > Y ) P(Y > X) = P(X > Y) P ( Y > X ) = P ( X > Y ) 。
查看原页 P ( X = Y ) = ∑ k = 1 ∞ P ( X = k , Y = k ) = ∑ k = 1 ∞ P ( X = k ) P ( Y = k ) = ∑ k = 1 ∞ ( 1 2 k ) 2 = ∑ k = 1 ∞ ( 1 4 ) k = 1 1 − 1 4 = 1 4 1 3 = 1 3 . P(X = Y) = \sum_{k = 1}^{\infty}P(X = k,Y = k) = \sum_{k = 1}^{\infty}P(X = k)P(Y = k) = \sum_{k = 1}^{\infty}(\frac{1}{2^{k}})^{2} = \sum_{k = 1}^{\infty}(\frac{1}{4})^{k} = \frac{1}{1 - \frac{1}{4}} = \frac{1}{4}\frac{1}{3} = \frac{1}{3}. P ( X = Y ) = k = 1 ∑ ∞ P ( X = k , Y = k ) = k = 1 ∑ ∞ P ( X = k ) P ( Y = k ) = k = 1 ∑ ∞ ( 2 k 1 ) 2 = k = 1 ∑ ∞ ( 4 1 ) k = 1 − 4 1 1 = 4 1 3 1 = 3 1 . 查看原页 我们有 P ( Y > X ) + P ( X > Y ) + P ( X = Y ) = 1 P(Y > X) + P(X > Y) + P(X = Y) = 1 P ( Y > X ) + P ( X > Y ) + P ( X = Y ) = 1 。
查看原页 P ( Y > X ) + P ( Y > X ) + 1 3 = 1. P(Y > X) + P(Y > X) + \frac{1}{3} = 1. P ( Y > X ) + P ( Y > X ) + 3 1 = 1. 查看原页 2 P ( Y > X ) = 1 − 1 3 = 2 3 . 2P(Y > X) = 1 - \frac{1}{3} = \frac{2}{3}. 2 P ( Y > X ) = 1 − 3 1 = 3 2 . 查看原页 P ( Y > X ) = 1 3 P(Y > X) = \frac{1}{3} P ( Y > X ) = 3 1 。这证实了我们之前的计算。
查看原页 设 E [ X ∣ Y > X ] = μ E[X|Y > X] = \mu E [ X ∣ Y > X ] = μ 。
查看原页 我们要求的是在 Bob 抛掷次数更多的情况下,Alice 抛掷次数的期望。
查看原页 考虑两者第一次抛掷都是反面(tails)的情况。那么过程重新开始,且条件仍然成立。
查看原页 设 A 1 A_{1} A 1 为 Alice 的第一次抛掷, B 1 B_{1} B 1 为 Bob 的第一次抛掷。
查看原页 P ( A 1 = H ) = 1 / 2 , P ( A 1 = T ) = 1 / 2. P(A_{1} = H) = 1 / 2,P(A_{1} = T) = 1 / 2. P ( A 1 = H ) = 1/2 , P ( A 1 = T ) = 1/2. 查看原页 P ( B 1 = H ) = 1 / 2 , P ( B 1 = T ) = 1 / 2. P(B_{1} = H) = 1 / 2,P(B_{1} = T) = 1 / 2. P ( B 1 = H ) = 1/2 , P ( B 1 = T ) = 1/2. 查看原页 情况 1: A 1 = H , B 1 = H . X = 1 , Y = 1 A_{1} = H,B_{1} = H.X = 1,Y = 1 A 1 = H , B 1 = H . X = 1 , Y = 1 ,因此 Y > X Y > X Y > X 为假。
查看原页 情况 2: A 1 = H , B 1 = T A_{1} = H,B_{1} = T A 1 = H , B 1 = T 。Alice 在 1 次时停止,Bob 继续。 Y > 1 Y > 1 Y > 1
查看原页 情况 3: A 1 = T , B 1 = H A_{1} = T,B_{1} = H A 1 = T , B 1 = H 。Bob 在 1 次时停止,Alice 继续。
查看原页 情况 4: A 1 = T , B 1 = T A_{1} = T,B_{1} = T A 1 = T , B 1 = T 。两者都继续。
查看原页 考虑在给定 Y > X Y > X Y > X 下的条件概率。
查看原页 设 E = E [ X ∣ Y > X ] E = E[X|Y > X] E = E [ X ∣ Y > X ] 。
查看原页 如果第一次抛掷为 HH,则条件 Y > X Y > X Y > X 不满足。
查看原页 如果第一次抛掷为 HT,则 Alice 的抛掷次数为 1。
查看原页 如果第一次抛掷为 TH,则 Bob 的抛掷次数为 1,Alice 的至少为 2,因此 Y < X Y < X Y < X 。
查看原页 如果第一次抛掷为 TT,则问题重新开始,Alice 的额外抛掷次数的期望仍为 E E E 。
查看原页 设 N A N_{A} N A 为 Alice 的抛掷次数, N B N_{B} N B 为 Bob 的抛掷次数。
查看原页 已知 N B > N A N_{B} > N_{A} N B > N A 。
查看原页 HT(概率 1/4):Alice 抛掷 1 次。
查看原页 TH(概率 1/4):Bob 抛掷 1 次,Alice > 1 >1 > 1 ,因此 N A > N B N_{A} > N_{B} N A > N B ,条件不满足。
查看原页 设 E E E 为在 Bob 抛掷次数更多的情况下 Alice 抛掷次数的期望。
查看原页 如果第一次抛掷为 HT,则 Alice 抛掷了 1 次,且条件满足。
查看原页 如果第一次抛掷为 TT,则情况与开始时相同,因此 Alice 的额外抛掷次数的期望为 E E E 。
查看原页 E [ X ∣ Y > X ] = E [ X ∣ Y > X , H H ] P ( H H ∣ Y > X ) + E [ X ∣ Y > X , H T ] P ( H T ∣ Y > X ) + E [ X ∣ Y > X , T H ] P ( T H ∣ Y > X ) E[X|Y > X] = E[X|Y > X,H H]P(H H|Y > X) + E[X|Y > X,H T]P(H T|Y > X) + E[X|Y > X,T H]P(T H|Y > X) E [ X ∣ Y > X ] = E [ X ∣ Y > X , H H ] P ( H H ∣ Y > X ) + E [ X ∣ Y > X , H T ] P ( H T ∣ Y > X ) + E [ X ∣ Y > X , T H ] P ( T H ∣ Y > X ) 查看原页 X ) + E [ X ∣ Y > X , T T ] P ( T T ∣ Y > X ) X) + E[X|Y > X,T T]P(T T|Y > X) X ) + E [ X ∣ Y > X , T T ] P ( T T ∣ Y > X ) 查看原页 P ( Y > X ∣ H H ) = 0. P(Y > X|H H) = 0. P ( Y > X ∣ H H ) = 0. 查看原页 P ( Y > X ∣ H T ) = 1. P(Y > X|H T) = 1. P ( Y > X ∣ H T ) = 1. 查看原页 P ( Y > X ∣ T H ) = 0. P(Y > X|T H) = 0. P ( Y > X ∣ T H ) = 0. 查看原页 P ( Y > X ∣ T T ) P(Y > X|T T) P ( Y > X ∣ T T ) 取决于后续的抛掷。
查看原页 E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) = ∑ x = 1 ∞ x P ( X = x , Y > x ) P ( Y > X ) E[X|Y > X] = \sum_{x = 1}^{\infty}x P(X = x|Y > X) = \sum_{x = 1}^{\infty}x\frac{P(X = x,Y > x)}{P(Y > X)} E [ X ∣ Y > X ] = x = 1 ∑ ∞ x P ( X = x ∣ Y > X ) = x = 1 ∑ ∞ x P ( Y > X ) P ( X = x , Y > x ) 查看原页 考虑在给定 Y > X Y > X Y > X 下第一次抛掷的概率。
查看原页 P ( H H ∣ Y > X ) = P ( Y > X ∣ H H ) P ( H H ) P ( Y > X ) = 0.1 / 4 1 / 3 = 0. P(H H|Y > X) = \frac{P(Y > X|H H)P(H H)}{P(Y > X)} = \frac{0.1 / 4}{1 / 3} = 0. P ( H H ∣ Y > X ) = P ( Y > X ) P ( Y > X ∣ H H ) P ( H H ) = 1/3 0.1/4 = 0. 查看原页 P ( H T ∣ Y > X ) = P ( Y > X ∣ H T ) P ( H T ) P ( Y > X ) = 1.1 / 4 1 / 3 = 3 4 . P(H T|Y > X) = \frac{P(Y > X|H T)P(H T)}{P(Y > X)} = \frac{1.1 / 4}{1 / 3} = \frac{3}{4}. P ( H T ∣ Y > X ) = P ( Y > X ) P ( Y > X ∣ H T ) P ( H T ) = 1/3 1.1/4 = 4 3 . 查看原页 P ( T H ∣ Y > X ) = P ( Y > X ∣ T H ) P ( T H ) P ( Y > X ) = 0.1 / 4 1 / 3 = 0. P ( T T ∣ Y > X ) = P ( Y > X ∣ T T ) P ( T T ) P ( Y > X ) \begin{array}{c} P(T H|Y > X) = \frac{P(Y > X|T H)P(T H)}{P(Y > X)} = \frac{0.1 / 4}{1 / 3} = 0. \\ P(T T|Y > X) = \frac{P(Y > X|T T)P(T T)}{P(Y > X)} \end{array} P ( T H ∣ Y > X ) = P ( Y > X ) P ( Y > X ∣ T H ) P ( T H ) = 1/3 0.1/4 = 0. P ( T T ∣ Y > X ) = P ( Y > X ) P ( Y > X ∣ T T ) P ( T T ) 查看原页 如果第一次抛掷为 TT,则后续行为相同,且如果在后续试验中 Bob 比 Alice 抛掷更多次,则条件 Y > X Y > X Y > X 成立。
查看原页 P ( Y > X ∣ T T ) = P ( B o b P(Y > X|T T) = P(\mathrm{Bob} P ( Y > X ∣ T T ) = P ( Bob 从零开始需要比 Alice 更多的抛掷次数 ) = P ( Y > X ) = 1 / 3 ) = P(Y > X) = 1 / 3 ) = P ( Y > X ) = 1/3
查看原页
P ( T T ∣ Y > X ) = ( 1 / 3 ) ⋅ ( 1 / 4 ) 1 / 3 = 1 4 P(T T|Y > X) = \frac{(1 / 3)\cdot(1 / 4)}{1 / 3} = \frac{1}{4} P ( T T ∣ Y > X ) = 1/3 ( 1/3 ) ⋅ ( 1/4 ) = 4 1
查看原页 条件概率之和: 0 + 3 / 4 + 0 + 1 / 4 = 1 0 + 3 / 4 + 0 + 1 / 4 = 1 0 + 3/4 + 0 + 1/4 = 1
查看原页 E [ X ∣ Y > X , H H ] E[X|Y > X, H H] E [ X ∣ Y > X , H H ] :不相关,因为 P ( H H ∣ Y > X ) = 0 P(H H|Y > X) = 0 P ( H H ∣ Y > X ) = 0
查看原页 E [ X ∣ Y > X , H T ] E[X|Y > X, H T] E [ X ∣ Y > X , H T ] :给定 HT 且 Y > X Y > X Y > X ,Alice 抛掷了 1 次。 E = 1 E = 1 E = 1
查看原页 E [ X ∣ Y > X , T H ] E[X|Y > X, T H] E [ X ∣ Y > X , T H ] :不相关。
查看原页 E [ X ∣ Y > X , T T ] E[X|Y > X, T T] E [ X ∣ Y > X , T T ] :给定 TT 且 Y > X Y > X Y > X ,Alice 已经抛掷了一次,额外抛掷次数的期望为 E E E 。因此,总抛掷次数为 1 + E 1 + E 1 + E 。
查看原页 E = 0 ⋅ 0 + 1 ⋅ ( 3 / 4 ) + E = 0\cdot 0 + 1\cdot (3 / 4) + E = 0 ⋅ 0 + 1 ⋅ ( 3/4 ) + 未定义 ⋅ 0 + ( 1 + E ) ⋅ ( 1 / 4 ) \cdot 0 + (1 + E)\cdot (1 / 4) ⋅ 0 + ( 1 + E ) ⋅ ( 1/4 )
查看原页
E = 0 + 3 / 4 + 0 + 1 / 4 + E / 4 E = 0 + 3 / 4 + 0 + 1 / 4 + E / 4 E = 0 + 3/4 + 0 + 1/4 + E /4
查看原页
E = 1 + E / 4 E = 1 + E / 4 E = 1 + E /4
查看原页
E − E / 4 = 1 E - E / 4 = 1 E − E /4 = 1
查看原页
3 E / 4 = 1 3E / 4 = 1 3 E /4 = 1
查看原页 让我们思考一下直觉。如果我们有条件 Y > X Y > X Y > X ,这意味着 Alice “运气好”,很早就抛到了正面,或者 Bob “运气不好”。
查看原页 考虑随机变量 Z = Y − X Z = Y - X Z = Y − X 。已知 Z > 0 Z > 0 Z > 0 。
查看原页 我们要求 E [ X ∣ Z > 0 ] E[X|Z > 0] E [ X ∣ Z > 0 ] 。
查看原页 令 p = P ( h e a d ) = 0.5 p = P(\mathrm{head}) = 0.5 p = P ( head ) = 0.5 。
查看原页 第一次正面之前的反面次数服从参数为 p p p 的几何分布。
查看原页 X − 1 ∼ G e o m ( p ) X - 1\sim G e o m(p) X − 1 ∼ G eo m ( p ) , Y − 1 ∼ G e o m ( p ) Y - 1\sim G e o m(p) Y − 1 ∼ G eo m ( p ) 。
查看原页 P ( X − 1 = k ) = ( 1 − p ) k p P(X - 1 = k) = (1 - p)^{k}p P ( X − 1 = k ) = ( 1 − p ) k p 。
查看原页 P ( X = x ) = ( 1 − p ) x − 1 p P(X = x) = (1 - p)^{x - 1}p P ( X = x ) = ( 1 − p ) x − 1 p 。
查看原页
P ( X = x , Y = y ) = p 2 ( 1 − p ) x − 1 ( 1 − p ) y − 1 P(X = x, Y = y) = p^{2}(1 - p)^{x - 1}(1 - p)^{y - 1} P ( X = x , Y = y ) = p 2 ( 1 − p ) x − 1 ( 1 − p ) y − 1
查看原页 考虑事件 Y = X + k Y = X + k Y = X + k ,其中 k ≥ 1 k \geq 1 k ≥ 1 。
查看原页 P ( Y = X + k ) = ∑ x = 1 ∞ P ( X = x , Y = x + k ) = ∑ x = 1 ∞ p 2 ( 1 − p ) x − 1 ( 1 − p ) x + k − 1 = p 2 ( 1 − p ) k − 1 ∑ x = 1 ∞ ( ( 1 − p ) 2 ) x − 1 = p 2 ( 1 − p ) k − 1 1 1 − ( 1 − p ) 2 = p 2 ( 1 − p ) k − 1 1 1 − ( 1 − 2 p + p 2 ) = p 2 ( 1 − p ) k − 1 1 2 p − p 2 = p 2 ( 1 − p ) k − 1 1 p ( 2 − p ) = p ( 1 − p ) k − 1 2 − p . \begin{array}{c} P(Y = X + k) = \sum_{x = 1}^{\infty}P(X = x,Y = x + k) = \sum_{x = 1}^{\infty}p^{2}(1 - p)^{x - 1}(1 - p)^{x + k - 1} \\ = p^{2}(1 - p)^{k - 1}\sum_{x = 1}^{\infty}((1 - p)^{2})^{x - 1} = p^{2}(1 - p)^{k - 1}\frac{1}{1 - (1 - p)^{2}} \\ = p^{2}(1 - p)^{k - 1}\frac{1}{1 - (1 - 2p + p^{2})} = p^{2}(1 - p)^{k - 1}\frac{1}{2p - p^{2}} = p^{2}(1 - p)^{k - 1}\frac{1}{p(2 - p)} \\ = \frac{p(1 - p)^{k - 1}}{2 - p}. \end{array} P ( Y = X + k ) = ∑ x = 1 ∞ P ( X = x , Y = x + k ) = ∑ x = 1 ∞ p 2 ( 1 − p ) x − 1 ( 1 − p ) x + k − 1 = p 2 ( 1 − p ) k − 1 ∑ x = 1 ∞ (( 1 − p ) 2 ) x − 1 = p 2 ( 1 − p ) k − 1 1 − ( 1 − p ) 2 1 = p 2 ( 1 − p ) k − 1 1 − ( 1 − 2 p + p 2 ) 1 = p 2 ( 1 − p ) k − 1 2 p − p 2 1 = p 2 ( 1 − p ) k − 1 p ( 2 − p ) 1 = 2 − p p ( 1 − p ) k − 1 . 查看原页 如果 p = 0.5 p = 0.5 p = 0.5 ,那么 1 − p = 0.5 1 - p = 0.5 1 − p = 0.5 , 2 − p = 1.5 2 - p = 1.5 2 − p = 1.5 。
查看原页 P ( Y = X + k ) = 0.5 ( 0.5 ) k − 1 1.5 = ( 0.5 ) k 1.5 = ( 1 / 2 ) k 3 / 2 = 1 2 k ⋅ 2 3 = 1 3.2 k − 1 . P(Y = X + k) = \frac{0.5(0.5)^{k - 1}}{1.5} = \frac{(0.5)^{k}}{1.5} = \frac{(1 / 2)^{k}}{3 / 2} = \frac{1}{2^{k}}\cdot \frac{2}{3} = \frac{1}{3.2^{k - 1}}. P ( Y = X + k ) = 1.5 0.5 ( 0.5 ) k − 1 = 1.5 ( 0.5 ) k = 3/2 ( 1/2 ) k = 2 k 1 ⋅ 3 2 = 3. 2 k − 1 1 . 查看原页 检查是否 ∑ k = 1 ∞ P ( Y = X + k ) = P ( Y > X ) = 1 / 3 \sum_{k = 1}^{\infty}P(Y = X + k) = P(Y > X) = 1 / 3 ∑ k = 1 ∞ P ( Y = X + k ) = P ( Y > X ) = 1/3 。
查看原页 ∑ k = 1 ∞ 1 3.2 k − 1 = 1 3 ∑ k = 1 ∞ ( 1 2 ) k − 1 = 1 3 ( 1 + 1 / 2 + 1 / 4 + … ) = 1 3 1 1 − 1 / 2 = 1 3 ⋅ 2 = 2 3 . \sum_{k = 1}^{\infty}\frac{1}{3.2^{k - 1}} = \frac{1}{3}\sum_{k = 1}^{\infty}(\frac{1}{2})^{k - 1} = \frac{1}{3} (1 + 1 / 2 + 1 / 4 + \ldots) = \frac{1}{3}\frac{1}{1 - 1 / 2} = \frac{1}{3}\cdot 2 = \frac{2}{3}. k = 1 ∑ ∞ 3. 2 k − 1 1 = 3 1 k = 1 ∑ ∞ ( 2 1 ) k − 1 = 3 1 ( 1 + 1/2 + 1/4 + … ) = 3 1 1 − 1/2 1 = 3 1 ⋅ 2 = 3 2 . 查看原页 让我们重新计算 P ( Y > X ) P(Y > X) P ( Y > X ) 。
查看原页 P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ ( 1 − p ) x − 1 p ( 1 − p ) y − 1 p = p 2 ∑ x = 1 ∞ ( 1 − p ) x − 1 ∑ y = x + 1 ∞ ( 1 − p ) y − 1 \begin{array}{c} P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}(1 - p)^{x - 1}p^{(1 - p)^{y - 1}}p \\ = p^{2}\sum_{x = 1}^{\infty}(1 - p)^{x - 1}\sum_{y = x + 1}^{\infty}(1 - p)^{y - 1} \end{array} P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ ( 1 − p ) x − 1 p ( 1 − p ) y − 1 p = p 2 ∑ x = 1 ∞ ( 1 − p ) x − 1 ∑ y = x + 1 ∞ ( 1 − p ) y − 1 查看原页 内层求和: ( 1 − p ) x + ( 1 − p ) x + 1 + ⋯ = ( 1 − p ) x 1 − ( 1 − p ) = ( 1 − p ) x p (1 - p)^{x} + (1 - p)^{x + 1} + \dots = \frac{(1 - p)^{x}}{1 - (1 - p)} = \frac{(1 - p)^{x}}{p} ( 1 − p ) x + ( 1 − p ) x + 1 + ⋯ = 1 − ( 1 − p ) ( 1 − p ) x = p ( 1 − p ) x 。
查看原页 P ( Y > X ) = p 2 ∑ x = 1 ∞ ( 1 − p ) x − 1 ( 1 − p ) x p = p ( 1 − p ) ∑ x = 1 ∞ ( 1 − p ) 2 ( x − 1 ) P(Y > X) = p^{2}\sum_{x = 1}^{\infty}(1 - p)^{x - 1}\frac{(1 - p)^{x}}{p} = p(1 - p)\sum_{x = 1}^{\infty}(1 - p)^{2(x - 1)} P ( Y > X ) = p 2 x = 1 ∑ ∞ ( 1 − p ) x − 1 p ( 1 − p ) x = p ( 1 − p ) x = 1 ∑ ∞ ( 1 − p ) 2 ( x − 1 ) 查看原页 = p ( 1 − p ) ∑ x = 1 ∞ ( ( 1 − p ) 2 ) x − 1 = p ( 1 − p ) 1 1 − ( 1 − p ) 2 = p(1 - p)\sum_{x = 1}^{\infty}((1 - p)^{2})^{x - 1} = p(1 - p)\frac{1}{1 - (1 - p)^{2}} = p ( 1 − p ) x = 1 ∑ ∞ (( 1 − p ) 2 ) x − 1 = p ( 1 − p ) 1 − ( 1 − p ) 2 1 查看原页 = p ( 1 − p ) 1 1 − ( 1 − 2 p + p 2 ) = p ( 1 − p ) 1 2 p − p 2 = p ( 1 − p ) 1 p ( 2 − p ) = 1 − p 2 − p . = p(1 - p)\frac{1}{1 - (1 - 2p + p^{2})} = p(1 - p)\frac{1}{2p - p^{2}} = p(1 - p)\frac{1}{p(2 - p)} = \frac{1 - p}{2 - p}. = p ( 1 − p ) 1 − ( 1 − 2 p + p 2 ) 1 = p ( 1 − p ) 2 p − p 2 1 = p ( 1 − p ) p ( 2 − p ) 1 = 2 − p 1 − p . 查看原页 如果 p = 0.5 p = 0.5 p = 0.5 , P ( Y > X ) = 0.5 1.5 = 1 3 P(Y > X) = \frac{0.5}{1.5} = \frac{1}{3} P ( Y > X ) = 1.5 0.5 = 3 1 。正确。
查看原页 现在,让我们求 E [ X ∣ Y > X ] E[X|Y > X] E [ X ∣ Y > X ] 。
查看原页 E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) = ∑ x = 1 ∞ x P ( X = x , Y > x ) P ( Y > X ) . E[X|Y > X] = \sum_{x = 1}^{\infty}xP(X = x|Y > X) = \sum_{x = 1}^{\infty}x\frac{P(X = x,Y > x)}{P(Y > X)}. E [ X ∣ Y > X ] = x = 1 ∑ ∞ x P ( X = x ∣ Y > X ) = x = 1 ∑ ∞ x P ( Y > X ) P ( X = x , Y > x ) . 查看原页 P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) P(X = x,Y > x) = P(X = x)P(Y > x) P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) (独立性)
查看原页 P ( X = x ) = ( 1 − p ) x − 1 p . P(X = x) = (1 - p)^{x - 1}p. P ( X = x ) = ( 1 − p ) x − 1 p . 查看原页 P ( Y > x ) = ∑ y = x + 1 ∞ ( 1 − p ) y − 1 p = p [ ( 1 − p ) x + ( 1 − p ) x + 1 + … ] = p ( 1 − p ) x 1 − ( 1 − p ) = ( 1 − p ) x . P(Y > x) = \sum_{y = x + 1}^{\infty}(1 - p)^{y - 1}p = p[(1 - p)^{x} + (1 - p)^{x + 1} + \ldots ] = p\frac{(1 - p)^{x}}{1 - (1 - p)} = (1 - p)^{x}. P ( Y > x ) = y = x + 1 ∑ ∞ ( 1 − p ) y − 1 p = p [( 1 − p ) x + ( 1 − p ) x + 1 + … ] = p 1 − ( 1 − p ) ( 1 − p ) x = ( 1 − p ) x . 查看原页 P ( X = x , Y > x ) = ( 1 − p ) x − 1 p ( 1 − p ) x = p ( 1 − p ) 2 x − 1 . P(X = x,Y > x) = (1 - p)^{x - 1}p(1 - p)^{x} = p(1 - p)^{2x - 1}. P ( X = x , Y > x ) = ( 1 − p ) x − 1 p ( 1 − p ) x = p ( 1 − p ) 2 x − 1 . 查看原页 E [ X ∣ Y > X ] = 1 P ( Y > X ) ∑ x = 1 ∞ x p ( 1 − p ) 2 x − 1 E[X|Y > X] = \frac{1}{P(Y > X)}\sum_{x = 1}^{\infty}xp(1 - p)^{2x - 1} E [ X ∣ Y > X ] = P ( Y > X ) 1 x = 1 ∑ ∞ x p ( 1 − p ) 2 x − 1 查看原页 = 2 − p 1 − p p ( 1 − p ) − 1 ∑ x = 1 ∞ x ( ( 1 − p ) 2 ) x = \frac{2 - p}{1 - p} p(1 - p)^{- 1}\sum_{x = 1}^{\infty}x((1 - p)^{2})^{x} = 1 − p 2 − p p ( 1 − p ) − 1 ∑ x = 1 ∞ x (( 1 − p ) 2 ) x (幂次有误)
查看原页 P ( Y > x ) = ( 1 − p ) x 1 − ( 1 − p ) p = ( 1 − p ) x . P(Y > x) = \frac{(1 - p)^{x}}{1 - (1 - p)} p = (1 - p)^{x}. P ( Y > x ) = 1 − ( 1 − p ) ( 1 − p ) x p = ( 1 − p ) x . 查看原页 E [ X ∣ Y > X ] = 1 P ( Y > X ) ∑ x = 1 ∞ x P ( X = x ) P ( Y > x ) E[X|Y > X] = \frac{1}{P(Y > X)}\sum_{x = 1}^{\infty}xP(X = x)P(Y > x) E [ X ∣ Y > X ] = P ( Y > X ) 1 x = 1 ∑ ∞ x P ( X = x ) P ( Y > x ) 查看原页 = 1 P ( Y > X ) ∑ x = 1 ∞ x ( 1 − p ) x − 1 p ( 1 − p ) x = \frac{1}{P(Y > X)}\sum_{x = 1}^{\infty}x(1 - p)^{x - 1}p(1 - p)^{x} = P ( Y > X ) 1 x = 1 ∑ ∞ x ( 1 − p ) x − 1 p ( 1 − p ) x 查看原页 = p P ( Y > X ) ∑ x = 1 ∞ x ( 1 − p ) 2 x − 1 = \frac{p}{P(Y > X)}\sum_{x = 1}^{\infty}x(1 - p)^{2x - 1} = P ( Y > X ) p x = 1 ∑ ∞ x ( 1 − p ) 2 x − 1 查看原页 = p ( 1 − p ) / ( 2 − p ) ( 1 − p ) − 1 ∑ x = 1 ∞ x ( ( 1 − p ) 2 ) x = \frac{p}{(1 - p) / (2 - p)}(1 - p)^{-1}\sum_{x = 1}^{\infty}x((1 - p)^{2})^{x} = ( 1 − p ) / ( 2 − p ) p ( 1 − p ) − 1 x = 1 ∑ ∞ x (( 1 − p ) 2 ) x 查看原页 = p 2 − p ( 1 − p ) 2 ∑ x = 1 ∞ x ( ( 1 − p ) 2 ) x . = p\frac{2 - p}{(1 - p)^{2}}\sum_{x = 1}^{\infty}x((1 - p)^{2})^{x}. = p ( 1 − p ) 2 2 − p x = 1 ∑ ∞ x (( 1 − p ) 2 ) x . 查看原页 令 r = ( 1 − p ) 2 r = (1 - p)^{2} r = ( 1 − p ) 2 。 ∑ x = 1 ∞ x r x = r ( 1 − r ) 2 \sum_{x = 1}^{\infty}xr^{x} = \frac{r}{(1 - r)^{2}} ∑ x = 1 ∞ x r x = ( 1 − r ) 2 r 。
查看原页 1 − r = 1 − ( 1 − p ) 2 = 1 − ( 1 − 2 p + p 2 ) = 2 p − p 2 = p ( 2 − p ) . 1 - r = 1 - (1 - p)^{2} = 1 - (1 - 2p + p^{2}) = 2p - p^{2} = p(2 - p). 1 − r = 1 − ( 1 − p ) 2 = 1 − ( 1 − 2 p + p 2 ) = 2 p − p 2 = p ( 2 − p ) . 查看原页 ( 1 − r ) 2 = p 2 ( 2 − p ) 2 . (1 - r)^{2} = p^{2}(2 - p)^{2}. ( 1 − r ) 2 = p 2 ( 2 − p ) 2 . 查看原页 ∑ x = 1 ∞ x ( ( 1 − p ) 2 ) x = ( 1 − p ) 2 p 2 ( 2 − p ) 2 . \sum_{x = 1}^{\infty}x((1 - p)^{2})^{x} = \frac{(1 - p)^{2}}{p^{2}(2 - p)^{2}}. x = 1 ∑ ∞ x (( 1 − p ) 2 ) x = p 2 ( 2 − p ) 2 ( 1 − p ) 2 . 查看原页 E [ X ∣ Y > X ] = p 2 − p ( 1 − p ) 2 ( 1 − p ) 2 p 2 ( 2 − p ) 2 = 1 p ( 2 − p ) . E[X|Y > X] = p\frac{2 - p}{(1 - p)^{2}}\frac{(1 - p)^{2}}{p^{2}(2 - p)^{2}} = \frac{1}{p(2 - p)}. E [ X ∣ Y > X ] = p ( 1 − p ) 2 2 − p p 2 ( 2 − p ) 2 ( 1 − p ) 2 = p ( 2 − p ) 1 . 查看原页 如果 p = 0.5 p = 0.5 p = 0.5 ,那么 E [ X ∣ Y > X ] = 1 0.5 × 1.5 = 1 0.75 = 1 3 / 4 = 4 / 3 E[X|Y > X] = \frac{1}{0.5\times 1.5} = \frac{1}{0.75} = \frac{1}{3 / 4} = 4 / 3 E [ X ∣ Y > X ] = 0.5 × 1.5 1 = 0.75 1 = 3/4 1 = 4/3 。
查看原页 令 X X X 为Alice掷出正面之前掷硬币的次数, Y Y Y 为Bob掷出正面之前掷硬币的次数。 X X X 和 Y Y Y 是相互独立的几何随机变量,参数为 p = 0.5 p = 0.5 p = 0.5 。概率质量函数为 P ( K = k ) = ( 1 − p ) k − 1 p P(K = k) = (1 - p)^{k - 1}p P ( K = k ) = ( 1 − p ) k − 1 p 。
查看原页 我们关心的是,在Bob掷硬币次数多于Alice的条件下,Alice掷硬币次数的期望值,即 E [ X ∣ Y > X ] E[X|Y > X] E [ X ∣ Y > X ] 。
查看原页 根据条件期望的定义, E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) E[X|Y > X] = \sum_{x = 1}^{\infty}xP(X = x|Y > X) E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) 。
查看原页 P ( X = x ∣ Y > X ) = P ( X = x , Y > x ) P ( Y > X ) . P(X = x|Y > X) = \frac{P(X = x,Y > x)}{P(Y > X)}. P ( X = x ∣ Y > X ) = P ( Y > X ) P ( X = x , Y > x ) . 查看原页 首先,计算 P ( Y > X ) P(Y > X) P ( Y > X ) 。
查看原页 P ( Y > X ) = ∑ x = 1 ∞ ∑ y = x + 1 ∞ P ( X = x , Y = y ) = ∑ x = 1 ∞ P ( X = x ) P ( Y > x ) . P(Y > X) = \sum_{x = 1}^{\infty}\sum_{y = x + 1}^{\infty}P(X = x,Y = y) = \sum_{x = 1}^{\infty}P(X = x)P(Y > x). P ( Y > X ) = x = 1 ∑ ∞ y = x + 1 ∑ ∞ P ( X = x , Y = y ) = x = 1 ∑ ∞ P ( X = x ) P ( Y > x ) . 查看原页 P ( X = x ) = ( 0.5 ) x − 1 ( 0.5 ) = ( 0.5 ) x = 1 2 x . P(X = x) = (0.5)^{x - 1}(0.5) = (0.5)^{x} = \frac{1}{2^{x}}. P ( X = x ) = ( 0.5 ) x − 1 ( 0.5 ) = ( 0.5 ) x = 2 x 1 . 查看原页 P ( Y > x ) = ∑ x = 1 ∞ x ( 0.5 ) x − 1 ( 0.5 ) = ( 0.5 ) x . P(Y > x) = \sum_{x = 1}^{\infty}x(0.5)^{x - 1}(0.5) = (0.5)^{x}. P ( Y > x ) = x = 1 ∑ ∞ x ( 0.5 ) x − 1 ( 0.5 ) = ( 0.5 ) x . 查看原页 P ( Y > X ) = ∑ x = 1 ∞ 1 2 x ( 1 2 ) x = ∑ x = 1 ∞ ( 1 4 ) x = 1 / 4 1 − 1 / 4 = 1 / 4 3 / 4 = 1 3 . P(Y > X) = \sum_{x = 1}^{\infty}\frac{1}{2^{x}} (\frac{1}{2})^{x} = \sum_{x = 1}^{\infty}(\frac{1}{4})^{x} = \frac{1 / 4}{1 - 1 / 4} = \frac{1 / 4}{3 / 4} = \frac{1}{3}. P ( Y > X ) = x = 1 ∑ ∞ 2 x 1 ( 2 1 ) x = x = 1 ∑ ∞ ( 4 1 ) x = 1 − 1/4 1/4 = 3/4 1/4 = 3 1 . 查看原页 接下来,计算 P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) = 1 2 x ( 1 2 ) x = ( 1 4 ) x P(X = x,Y > x) = P(X = x)P(Y > x) = \frac{1}{2^{x}} (\frac{1}{2})^{x} = (\frac{1}{4})^{x} P ( X = x , Y > x ) = P ( X = x ) P ( Y > x ) = 2 x 1 ( 2 1 ) x = ( 4 1 ) x 。
查看原页 现在,求 P ( X = x ∣ Y > X ) = P ( X = x , Y > x ) P ( Y > X ) = ( 1 / 4 ) x 1 / 3 = 3 ( 1 4 ) x P(X = x|Y > X) = \frac{P(X = x,Y > x)}{P(Y > X)} = \frac{(1 / 4)^{x}}{1 / 3} = 3(\frac{1}{4})^{x} P ( X = x ∣ Y > X ) = P ( Y > X ) P ( X = x , Y > x ) = 1/3 ( 1/4 ) x = 3 ( 4 1 ) x 。
查看原页 E [ X ∣ Y > X ] = ∑ x = 1 ∞ x P ( X = x ∣ Y > X ) = ∑ x = 1 ∞ x ⋅ 3 ( 1 4 ) x = 3 ∑ x = 1 ∞ x ( 1 4 ) x . E[X|Y > X] = \sum_{x = 1}^{\infty}xP(X = x|Y > X) = \sum_{x = 1}^{\infty}x\cdot 3(\frac{1}{4})^{x} = 3\sum_{x = 1}^{\infty}x(\frac{1}{4})^{x}. E [ X ∣ Y > X ] = x = 1 ∑ ∞ x P ( X = x ∣ Y > X ) = x = 1 ∑ ∞ x ⋅ 3 ( 4 1 ) x = 3 x = 1 ∑ ∞ x ( 4 1 ) x . 查看原页 使用公式 ∑ x = 1 ∞ x r x = r ( 1 − r ) 2 \sum_{x = 1}^{\infty}xr^{x} = \frac{r}{(1 - r)^{2}} ∑ x = 1 ∞ x r x = ( 1 − r ) 2 r ,其中 r = 1 / 4 r = 1 / 4 r = 1/4 :
查看原页 ∑ x = 1 ∞ x ( 1 4 ) x = 1 / 4 ( 1 − 1 / 4 ) 2 = 1 / 4 ( 3 / 4 ) 2 = 1 / 4 9 / 16 = 1 4 × 16 9 = 4 9 . \sum_{x = 1}^{\infty}x(\frac{1}{4})^{x} = \frac{1 / 4}{(1 - 1 / 4)^{2}} = \frac{1 / 4}{(3 / 4)^{2}} = \frac{1 / 4}{9 / 16} = \frac{1}{4}\times \frac{16}{9} = \frac{4}{9}. x = 1 ∑ ∞ x ( 4 1 ) x = ( 1 − 1/4 ) 2 1/4 = ( 3/4 ) 2 1/4 = 9/16 1/4 = 4 1 × 9 16 = 9 4 . 查看原页 E [ X ∣ Y > X ] = 3 × 4 9 = 12 9 = 4 3 . E[X|Y > X] = 3\times \frac{4}{9} = \frac{12}{9} = \frac{4}{3}. E [ X ∣ Y > X ] = 3 × 9 4 = 9 12 = 3 4 . 查看原页 最终答案:最终答案是 4 / 3 \boxed{4 / 3} 4/3
查看原页 表 11. 源自 OlympicArena 天文学子集的 s1K 样本。黑色文字是问题,蓝色文字是解答。仅基于问题,我们用 Gemini 生成浅蓝色推理轨迹和蓝色回答,并将其用于训练。
查看原页 一个经常被重复的有趣事实是,人类每单位体积产生的功率比恒星更多。如果太阳大小相同,但它每单位体积产生的功率与人类相同,那么它的表面温度会是多少?假设“普通人”产生 100 瓦功率,体积为 66400 立方厘米。
查看原页 A: 3500 K B: 10000 K C: 25000 K D: 40000 K E: 50000 K
查看原页 u = 100 66400 × 10 − 6 = 1506 W / m 3 u = \frac{100}{66400\times 10^{-6}} = 1506\mathrm{W / m^{3}} u = 66400 × 1 0 − 6 100 = 1506 W/ m 3 查看原页 太阳的体积是 4 3 π R ⊙ 3 \frac{4}{3}\pi R_{\odot}^{3} 3 4 π R ⊙ 3 ,所以其新的功率输出将为 P = 4 3 π R ⊙ 3 u P = \frac{4}{3}\pi R_{\odot}^{3}u P = 3 4 π R ⊙ 3 u 。为求平衡温度,我们使用
查看原页 P = σ A T 4 = 4 π σ R ⊙ 2 T 4 P = \sigma AT^{4} = 4\pi \sigma R_{\odot}^{2}T^{4} P = σ A T 4 = 4 π σ R ⊙ 2 T 4 查看原页 T = R ⊙ u 3 σ 4 = ( 6.96 × 10 8 ) ( 1506 ) 3 ( 5.67 × 10 − 8 ) 4 = 49823 ≈ 50000 K . T = \sqrt[4]{\frac{R_{\odot}u}{3\sigma}} = \sqrt[4]{\frac{(6.96\times 10^{8})(1506)}{3(5.67\times 10^{-8})}} = 49823\approx 50000\mathrm{K}. T = 4 3 σ R ⊙ u = 4 3 ( 5.67 × 1 0 − 8 ) ( 6.96 × 1 0 8 ) ( 1506 ) = 49823 ≈ 50000 K . 查看原页 题目要求求太阳在大小相同但每单位体积产生的功率与人类相同时的表面温度。
查看原页 人类产生的功率, P h u m a n = 100 W P_{human} = 100\mathrm{W} P h u man = 100 W
查看原页 人类的体积, V h u m a n = 66400 c m 3 V_{human} = 66400\mathrm{cm}^{3} V h u man = 66400 cm 3
查看原页
1 m = 100 c m 1\mathrm{m} = 100\mathrm{cm} 1 m = 100 cm
查看原页
1 m 3 = ( 100 c m ) 3 = 10 6 c m 3 1\mathrm{m}^{3} = (100\mathrm{cm})^{3} = 10^{6}\mathrm{cm}^{3} 1 m 3 = ( 100 cm ) 3 = 1 0 6 cm 3
查看原页
V h u m a n = 66400 c m 3 = 66400 × 10 − 6 m 3 = 0.0664 m 3 V_{human} = 66400\mathrm{cm}^{3} = 66400\times 10^{- 6}\mathrm{m}^{3} = 0.0664\mathrm{m}^{3} V h u man = 66400 cm 3 = 66400 × 1 0 − 6 m 3 = 0.0664 m 3
查看原页 人类的功率密度, ρ p o w e r , h u m a n = P h u m a n V h u m a n = 100 W 0.0664 m 3 \rho_{power,human} = \frac{P_{human}}{V_{human}} = \frac{100\mathrm{W}}{0.0664\mathrm{m}^{3}} ρ p o w er , h u man = V h u man P h u man = 0.0664 m 3 100 W
查看原页
ρ p o w e r , h u m a n = 1506.024 W / m 3 \rho_{power,human} = 1506.024\mathrm{W / m^{3}} ρ p o w er , h u man = 1506.024 W/ m 3
查看原页 现在,考虑一个大小与当前太阳相同、但功率密度等于人类的太阳。
查看原页 我们需要太阳的半径来计算其体积。太阳的平均半径为 R s u n = 6.95 × 10 8 m R_{sun} = 6.95\times 10^{8}\mathrm{m} R s u n = 6.95 × 1 0 8 m
查看原页 太阳的体积, V s u n = 4 3 π R s u n 3 = 4 3 π ( 6.95 × 10 8 m ) 3 V_{sun} = \frac{4}{3}\pi R_{sun}^{3} = \frac{4}{3}\pi (6.95\times 10^{8}\mathrm{m})^{3} V s u n = 3 4 π R s u n 3 = 3 4 π ( 6.95 × 1 0 8 m ) 3
查看原页
V s u n = 4 3 π ( 337.159375 × 10 24 ) m 3 V_{sun} = \frac{4}{3}\pi (337.159375\times 10^{24})\mathrm{m}^{3} V s u n = 3 4 π ( 337.159375 × 1 0 24 ) m 3
查看原页
V s u n = 1410.24 × 10 24 × π m 3 V_{sun} = 1410.24\times 10^{24}\times \pi \mathrm{m}^{3} V s u n = 1410.24 × 1 0 24 × π m 3
查看原页
V s u n = 4.4307 × 10 27 m 3 V_{sun} = 4.4307\times 10^{27}\mathrm{m}^{3} V s u n = 4.4307 × 1 0 27 m 3
查看原页 如果太阳具有与人类相同的功率密度,那么这个被修改后的太阳产生的总功率将是:
查看原页
P m o d i f i e d s u n = ρ p o w e r , h u m a n × V s u n P_{modified sun} = \rho_{power,human}\times V_{sun} P m o d i f i e d s u n = ρ p o w er , h u man × V s u n
查看原页
P m o d i f i e d s u n = 1506.024 W / m 3 × 4.4307 × 10 27 m 3 P_{modified sun} = 1506.024\mathrm{W / m^{3}}\times 4.4307\times 10^{27}\mathrm{m^{3}} P m o d i f i e d s u n = 1506.024 W/ m 3 × 4.4307 × 1 0 27 m 3
查看原页
P m o d i f i e d s u n = 6.6726 × 10 30 W P_{modified sun} = 6.6726\times 10^{30}\mathrm{W} P m o d i f i e d s u n = 6.6726 × 1 0 30 W
查看原页 恒星的表面温度通过斯特藩-玻尔兹曼定律与其光度(总功率输出)相关联:
查看原页
L = 4 π R 2 σ T 4 L = 4\pi R^{2}\sigma T^{4} L = 4 π R 2 σ T 4
查看原页 其中 L L L 是光度(总功率输出), R R R 是恒星半径, σ \sigma σ 是斯特藩-玻尔兹曼常数, T T T 是表面温度。
查看原页 在这种情况下,被修改后的太阳的光度是 P m o d i f i e d _ s u n P_{modified\_ sun} P m o d i f i e d _ s u n 。被修改后的太阳的半径与实际太阳相同, R s u n R_{sun} R s u n 。
查看原页 斯特藩-玻尔兹曼常数, σ = 5.67 × 10 − 8 W m − 2 K − 4 \sigma = 5.67\times 10^{- 8}\mathrm{Wm}^{- 2}\mathrm{K}^{- 4} σ = 5.67 × 1 0 − 8 Wm − 2 K − 4 。
查看原页 P m o d i f i e d _ s u n = 4 π R s u n 2 σ T 4 6.6726 × 10 30 W = 4 π ( 6.95 × 10 8 m ) 2 × 5.67 × 10 − 8 W m − 2 K − 4 × T 4 \begin{array}{c} P_{modified\_ sun} = 4\pi R_{sun}^{2}\sigma T^{4} \\ 6.6726\times 10^{30}\mathrm{W} = 4\pi (6.95\times 10^{8}\mathrm{m})^{2}\times 5.67\times 10^{-8}\mathrm{Wm}^{-2}\mathrm{K}^{-4}\times T^{4} \end{array} P m o d i f i e d _ s u n = 4 π R s u n 2 σ T 4 6.6726 × 1 0 30 W = 4 π ( 6.95 × 1 0 8 m ) 2 × 5.67 × 1 0 − 8 Wm − 2 K − 4 × T 4 查看原页 计算项 4 π R s u n 2 σ 4\pi R_{sun}^{2}\sigma 4 π R s u n 2 σ :
查看原页 R s u n 2 = ( 6.95 × 10 8 ) 2 = 48.3025 × 10 16 m 2 R_{sun}^{2} = (6.95\times 10^{8})^{2} = 48.3025\times 10^{16}\mathrm{m}^{2} R s u n 2 = ( 6.95 × 1 0 8 ) 2 = 48.3025 × 1 0 16 m 2 查看原页 4 π R s u n 2 = 4 π × 48.3025 × 10 16 = 607.08 × 10 16 m 2 4\pi R_{sun}^{2} = 4\pi \times 48.3025\times 10^{16} = 607.08\times 10^{16}\mathrm{m}^{2} 4 π R s u n 2 = 4 π × 48.3025 × 1 0 16 = 607.08 × 1 0 16 m 2 查看原页 4 π R s u n 2 σ = 607.08 × 10 16 m 2 × 5.67 × 10 − 8 W m − 2 K − 4 4\pi R_{sun}^{2}\sigma = 607.08\times 10^{16}\mathrm{m}^{2}\times 5.67\times 10^{-8}\mathrm{Wm}^{-2}\mathrm{K}^{-4} 4 π R s u n 2 σ = 607.08 × 1 0 16 m 2 × 5.67 × 1 0 − 8 Wm − 2 K − 4 查看原页 4 π R s u n 2 σ = 3441.93 × 10 8 W K − 4 = 3.44193 × 10 11 W K − 4 4\pi R_{sun}^{2}\sigma = 3441.93\times 10^{8}\mathrm{WK}^{-4} = 3.44193\times 10^{11}\mathrm{WK}^{-4} 4 π R s u n 2 σ = 3441.93 × 1 0 8 WK − 4 = 3.44193 × 1 0 11 WK − 4 查看原页 6.6726 × 10 30 = 3.44193 × 10 11 × T 4 6.6726\times 10^{30} = 3.44193\times 10^{11}\times T^{4} 6.6726 × 1 0 30 = 3.44193 × 1 0 11 × T 4 查看原页 T 4 = 6.6726 × 10 30 3.44193 × 10 11 = 1.9386 × 10 19 T^{4} = \frac{6.6726\times 10^{30}}{3.44193\times 10^{11}} = 1.9386\times 10^{19} T 4 = 3.44193 × 1 0 11 6.6726 × 1 0 30 = 1.9386 × 1 0 19 查看原页 T = ( 1.9386 × 10 19 ) 1 / 4 = ( 193.86 × 10 17 ) 1 / 4 T = (1.9386\times 10^{19})^{1 / 4} = (193.86\times 10^{17})^{1 / 4} T = ( 1.9386 × 1 0 19 ) 1/4 = ( 193.86 × 1 0 17 ) 1/4 查看原页 T = ( 1.9386 ) 1 / 4 × ( 10 19 ) 1 / 4 = ( 1.9386 ) 0.25 × 10 4.75 T = (1.9386)^{1 / 4}\times (10^{19})^{1 / 4} = (1.9386)^{0.25}\times 10^{4.75} T = ( 1.9386 ) 1/4 × ( 1 0 19 ) 1/4 = ( 1.9386 ) 0.25 × 1 0 4.75 查看原页 计算 (1.9386) 0.25 ^{0.25} 0.25 :令 y = 1.9386 0.25 y = 1.9386^{0.25} y = 1.938 6 0.25 ,则 ln y = 0.25 ln ( 1.9386 ) \ln y = 0.25\ln (1.9386) ln y = 0.25 ln ( 1.9386 )
查看原页
ln ( 1.9386 ) ≈ 0.6619 \ln (1.9386)\approx 0.6619 ln ( 1.9386 ) ≈ 0.6619
查看原页
ln y = 0.25 × 0.6619 = 0.165475 \ln y = 0.25\times 0.6619 = 0.165475 ln y = 0.25 × 0.6619 = 0.165475
查看原页
y = e 0.165475 ≈ 1.1799 y = e^{0.165475}\approx 1.1799 y = e 0.165475 ≈ 1.1799
查看原页 因此, T = 1.1799 × 10 4.75 = 1.1799 × 10 4 × 10 0.75 T = 1.1799\times 10^{4.75} = 1.1799\times 10^{4}\times 10^{0.75} T = 1.1799 × 1 0 4.75 = 1.1799 × 1 0 4 × 1 0 0.75
查看原页
10 0.75 = 10 3 / 4 = ( 10 3 ) 1 / 4 = ( 1000 ) 1 / 4 10^{0.75} = 10^{3 / 4} = (10^{3})^{1 / 4} = (1000)^{1 / 4} 1 0 0.75 = 1 0 3/4 = ( 1 0 3 ) 1/4 = ( 1000 ) 1/4
查看原页 我们知道 5 4 = 625 5^{4} = 625 5 4 = 625 且 6 4 = 1296 6^{4} = 1296 6 4 = 1296 ,所以 ( 1000 ) 1 / 4 (1000)^{1 / 4} ( 1000 ) 1/4 介于5和6之间。
查看原页 或者, 10 0.75 = 10 0.5 × 10 0.25 = 10 × 10 0.25 ≈ 3.16 × 1.778 = 5.62 10^{0.75} = 10^{0.5}\times 10^{0.25} = \sqrt{10}\times 10^{0.25}\approx 3.16\times 1.778 = 5.62 1 0 0.75 = 1 0 0.5 × 1 0 0.25 = 10 × 1 0 0.25 ≈ 3.16 × 1.778 = 5.62
查看原页
T = 1.1799 × 10 4 × 5.62 = 6.63 × 10 4 K = 66300 K T = 1.1799\times 10^{4}\times 5.62 = 6.63\times 10^{4}\mathrm{K} = 66300\mathrm{K} T = 1.1799 × 1 0 4 × 5.62 = 6.63 × 1 0 4 K = 66300 K
查看原页 人体的功率密度: ρ p o w e r , h u m a n = 1506.02 W / m 3 \rho_{power,human} = 1506.02\mathrm{W / m}^{3} ρ p o w er , h u man = 1506.02 W/m 3
查看原页 太阳的体积: V s u n = 4.43 × 10 27 m 3 V_{sun} = 4.43\times 10^{27}\mathrm{m}^{3} V s u n = 4.43 × 1 0 27 m 3
查看原页 改造后太阳的功率: P m o d i f i e d _ s u n = 1506.02 × 4.43 × 10 27 = 6671.67 × 10 27 = 6.67 × 10 30 W P_{modified\_ sun} = 1506.02\times 4.43\times 10^{27} = 6671.67\times 10^{27} = 6.67\times 10^{30}\mathrm{W} P m o d i f i e d _ s u n = 1506.02 × 4.43 × 1 0 27 = 6671.67 × 1 0 27 = 6.67 × 1 0 30 W
查看原页 斯特藩-玻尔兹曼定律: P = 4 π R 2 σ T 4 P = 4\pi R^{2}\sigma T^{4} P = 4 π R 2 σ T 4
查看原页 T 4 = P 4 π R 2 σ
T^{4} = \frac{P}{4\pi R^{2}\sigma}
T 4 = 4 π R 2 σ P 查看原页 4 π R s u n 2 σ = 3.44 × 10 11
4\pi R_{sun}^{2}\sigma = 3.44\times 10^{11}
4 π R s u n 2 σ = 3.44 × 1 0 11 查看原页 T 4 = 6.67 × 10 30 3.44 × 10 11 = 1.939 × 10 19
T^{4} = \frac{6.67\times 10^{30}}{3.44\times 10^{11}} = 1.939\times 10^{19}
T 4 = 3.44 × 1 0 11 6.67 × 1 0 30 = 1.939 × 1 0 19 查看原页 T = ( 1.939 × 10 19 ) 1 / 4 = ( 193.9 × 10 17 ) 1 / 4
T = (1.939\times 10^{19})^{1 / 4} = (193.9\times 10^{17})^{1 / 4}
T = ( 1.939 × 1 0 19 ) 1/4 = ( 193.9 × 1 0 17 ) 1/4 查看原页 T = ( 193.9 ) 0.25 × ( 10 17 ) 0.25 = ( 193.9 ) 0.25 × 10 4.25
T = (193.9)^{0.25}\times (10^{17})^{0.25} = (193.9)^{0.25}\times 10^{4.25}
T = ( 193.9 ) 0.25 × ( 1 0 17 ) 0.25 = ( 193.9 ) 0.25 × 1 0 4.25 查看原页 计算 ( 193.9 ) 0.25 (193.9)^{0.25} ( 193.9 ) 0.25 : 令 y = 193.9 0.25 y = 193.9^{0.25} y = 193. 9 0.25 ,则 ln y = 0.25 ln ( 193.9 ) \ln y = 0.25\ln (193.9) ln y = 0.25 ln ( 193.9 )
查看原页
ln ( 193.9 ) ≈ 5.267 \ln (193.9)\approx 5.267 ln ( 193.9 ) ≈ 5.267
查看原页
ln y = 0.25 × 5.267 = 1.31675 \ln y = 0.25\times 5.267 = 1.31675 ln y = 0.25 × 5.267 = 1.31675
查看原页
y = e 1.31675 ≈ 3.73 y = e^{1.31675}\approx 3.73 y = e 1.31675 ≈ 3.73
查看原页 T = 3.73 × 10 4.25 = 3.73 × 10 4 × 10 0.25 = 37300 × 1.778 = 66329 K
T = 3.73\times 10^{4.25} = 3.73\times 10^{4}\times 10^{0.25} = 37300\times 1.778 = 66329\mathrm{K}
T = 3.73 × 1 0 4.25 = 3.73 × 1 0 4 × 1 0 0.25 = 37300 × 1.778 = 66329 K 查看原页 结果约为66000 K。这不在选项中。让我们回顾一下假设和计算。
查看原页 假设:太阳作为黑体辐射,这对于估算表面温度是合理的。
查看原页 让我们尝试一种更简单的方法,通过建立比值。
查看原页 改造后太阳的单位体积功率等于人体的单位体积功率。
查看原页 P m o d i f i e d \sun V s u n = P h u m a n V h u m a n
\frac{P_{modified\sun}}{V{sun}} = \frac{P_{human}}{V_{human}}
V s u n P m o d i f i e d \sun = V h u man P h u man 查看原页 我们还知道 P m o d i f i e d \sun = 4 π R s u n 2 σ T m o d i f i e d _ s u n 4 P_{modified\sun} = 4\pi R{sun}^2 \sigma T_{modified\_sun}^4 P m o d i f i e d \sun = 4 π R s u n 2 σ T m o d i f i e d _ s u n 4
查看原页 4 π R s u n 2 σ T m o d i f i e d \sun 4 3 π R s u n 3 = P h u m a n V h u m a n
\frac{4\pi R_{sun}^2\sigma T_{modified\sun}^4}{3\pi R{sun}^3} = \frac{P_{human}}{V_{human}}
3 π R s u n 3 4 π R s u n 2 σ T m o d i f i e d \sun 4 = V h u man P h u man 查看原页 3 σ T m o d i f i e d \sun 4 R s u n = ρ p o w e r , h u m a n
\frac{3\sigma T_{modified\sun}^4}{R{sun}} = \rho_{power,human}
R s u n 3 σ T m o d i f i e d \sun 4 = ρ p o w er , h u man 查看原页 T m o d i f i e d \sun 4 = ρ p o w e r , h u m a n R s u n 3 σ
T_{modified\sun}^4 = \frac{\rho{power,human}R_{sun}}{3\sigma}
T m o d i f i e d \sun 4 = 3 σ ρ p o w er , h u man R s u n 查看原页 ρ p o w e r , h u m a n = 1506.02 W / m 3
\rho_{power,human} = 1506.02 \mathrm{W / m^3}
ρ p o w er , h u man = 1506.02 W/ m 3 查看原页 R s u n = 6.95 × 10 8 m
R_{sun} = 6.95 \times 10^8 \mathrm{m}
R s u n = 6.95 × 1 0 8 m 查看原页 σ = 5.67 × 10 − 8 W m − 2 K − 4
\sigma = 5.67 \times 10^{-8} \mathrm{Wm}^{-2} \mathrm{K}^{-4}
σ = 5.67 × 1 0 − 8 Wm − 2 K − 4 查看原页 T m o d i f i e d _ s u n 4 = 1506.02 × 6.95 × 10 8 3 × 5.67 × 10 − 8
T_{modified\_sun}^4 = \frac{1506.02 \times 6.95 \times 10^8}{3 \times 5.67 \times 10^{-8}}
T m o d i f i e d _ s u n 4 = 3 × 5.67 × 1 0 − 8 1506.02 × 6.95 × 1 0 8 查看原页 T m o d i f i e d _ s u n 4 = 10466.839 × 10 8 17.01 × 10 − 8 = 1.0466 × 10 12 1.701 × 10 − 7 = 0.6153 × 10 19 = 6.153 × 10 18
T_{modified\_sun}^4 = \frac{10466.839 \times 10^8}{17.01 \times 10^{-8}} = \frac{1.0466 \times 10^{12}}{1.701 \times 10^{-7}} = 0.6153 \times 10^{19} = 6.153 \times 10^{18}
T m o d i f i e d _ s u n 4 = 17.01 × 1 0 − 8 10466.839 × 1 0 8 = 1.701 × 1 0 − 7 1.0466 × 1 0 12 = 0.6153 × 1 0 19 = 6.153 × 1 0 18 查看原页 T m o d i f i e d _ s u n = ( 6.153 × 10 18 ) 1 / 4 = ( 6153 × 10 15 ) 1 / 4
T_{modified\_sun} = (6.153 \times 10^{18})^{1 / 4} = (6153 \times 10^{15})^{1 / 4}
T m o d i f i e d _ s u n = ( 6.153 × 1 0 18 ) 1/4 = ( 6153 × 1 0 15 ) 1/4 查看原页 T m o d i f i e d _ s u n = ( 6153 ) 0.25 × ( 10 15 ) 0.25 = ( 6153 ) 0.25 × 10 3.75
T_{modified\_sun} = (6153)^{0.25} \times (10^{15})^{0.25} = (6153)^{0.25} \times 10^{3.75}
T m o d i f i e d _ s u n = ( 6153 ) 0.25 × ( 1 0 15 ) 0.25 = ( 6153 ) 0.25 × 1 0 3.75 查看原页 计算 ( 6153 ) 0.25 (6153)^{0.25} ( 6153 ) 0.25 :
查看原页 令 y = 6153 0.25 y = 6153^{0.25} y = 615 3 0.25 ,则 ln y = 0.25 ln ( 6153 ) \ln y = 0.25 \ln (6153) ln y = 0.25 ln ( 6153 )
查看原页
ln ( 6153 ) ≈ 8.724 \ln (6153) \approx 8.724 ln ( 6153 ) ≈ 8.724
查看原页
ln y = 0.25 × 8.724 = 2.181 \ln y = 0.25 \times 8.724 = 2.181 ln y = 0.25 × 8.724 = 2.181
查看原页
y = e 2.181 ≈ 8.85 y = e^{2.181} \approx 8.85 y = e 2.181 ≈ 8.85
查看原页 T m o d i f i e d _ s u n = 8.85 × 10 3.75 = 8.85 × 10 3 × 10 0.75 = 8850 × 5.62 = 49737 K
T_{modified\_sun} = 8.85 \times 10^{3.75} = 8.85 \times 10^{3} \times 10^{0.75} = 8850 \times 5.62 = 49737 \mathrm{K}
T m o d i f i e d _ s u n = 8.85 × 1 0 3.75 = 8.85 × 1 0 3 × 1 0 0.75 = 8850 × 5.62 = 49737 K 查看原页 人体的功率密度: 100 W 0.0664 m 3 = 1506.02 W / m 3 \frac{100 \mathrm{W}}{0.0664 \mathrm{m}^3} = 1506.02 \mathrm{W / m^3} 0.0664 m 3 100 W = 1506.02 W/ m 3
查看原页 推导出的公式为 T 4 = ρ p o w e r , h u m a n R s u n 3 σ T^4 = \frac{\rho_{power,human}R_{sun}}{3\sigma} T 4 = 3 σ ρ p o w er , h u man R s u n 。
查看原页 [ ρ p o w e r , h u m a n ] = W / m 3 [\rho_{power,human}] = \mathrm{W / m^3} [ ρ p o w er , h u man ] = W/ m 3 查看原页
[ R s u n ] = m [R_{sun}] = \mathrm{m} [ R s u n ] = m
查看原页 [ σ ] = W m − 2 K − 4 [\sigma ] = \mathrm{Wm}^{-2}\mathrm{K}^{-4} [ σ ] = Wm − 2 K − 4 查看原页 ( W / m 3 ) c m W m − 2 K − 4 = W / m 2 W m − 2 K − 4 = W m 2 × m 2 K 4 W = K 4 \frac{(\mathrm{W / m^3})_{\mathrm{cm}}}{\mathrm{Wm}^{-2}\mathrm{K}^{-4}} = \frac{\mathrm{W / m^2}}{\mathrm{Wm}^{-2}\mathrm{K}^{-4}} = \frac{\mathrm{W}}{\mathrm{m}^2} \times \frac{\mathrm{m}^2\mathrm{K}^4}{\mathrm{W}} = \mathrm{K}^4 Wm − 2 K − 4 ( W/ m 3 ) cm = Wm − 2 K − 4 W/ m 2 = m 2 W × W m 2 K 4 = K 4 查看原页 分子: 1506.02 × 6.95 × 10 8 = 10466.839 × 10 8 = 1.0466 × 10 12 1506.02 \times 6.95 \times 10^8 = 10466.839 \times 10^8 = 1.0466 \times 10^{12} 1506.02 × 6.95 × 1 0 8 = 10466.839 × 1 0 8 = 1.0466 × 1 0 12
查看原页 分母: 3 × 5.67 × 10 − 8 = 17.01 × 10 − 8 3 \times 5.67 \times 10^{- 8} = 17.01 \times 10^{- 8} 3 × 5.67 × 1 0 − 8 = 17.01 × 1 0 − 8
查看原页 比值: 1.0466 × 10 12 17.01 × 10 − 8 = 0.061528 × 10 20 = 6.1528 × 10 18 \frac{1.0466 \times 10^{12}}{17.01 \times 10^{- 8}} = 0.061528 \times 10^{20} = 6.1528 \times 10^{18} 17.01 × 1 0 − 8 1.0466 × 1 0 12 = 0.061528 × 1 0 20 = 6.1528 × 1 0 18
查看原页
T 4 = 6.1528 × 10 18 T^4 = 6.1528 \times 10^{18} T 4 = 6.1528 × 1 0 18
查看原页 T = ( 6.1528 × 10 18 ) 1 / 4 = ( 6152.8 × 10 15 ) 1 / 4 T = (6.1528 \times 10^{18})^{1 / 4} = (6152.8 \times 10^{15})^{1 / 4} T = ( 6.1528 × 1 0 18 ) 1/4 = ( 6152.8 × 1 0 15 ) 1/4 查看原页
T = ( 6152.8 ) 0.25 × 10 3.75 T = (6152.8)^{0.25} \times 10^{3.75} T = ( 6152.8 ) 0.25 × 1 0 3.75
查看原页 log 10 ( 6152.8 ) ≈ 3.789 \log_{10}(6152.8) \approx 3.789 log 10 ( 6152.8 ) ≈ 3.789 查看原页
0.25 × 3.789 = 0.94725 0.25 \times 3.789 = 0.94725 0.25 × 3.789 = 0.94725
查看原页 10 0.94725 ≈ 8.856 10^{0.94725} \approx 8.856 1 0 0.94725 ≈ 8.856 查看原页 T = 8.856 × 10 3.75 = 8.856 × 10 3 × 10 0.75 = 8856 × 5.623 = 49806 K T = 8.856 \times 10^{3.75} = 8.856 \times 10^{3} \times 10^{0.75} = 8856 \times 5.623 = 49806 \mathrm{K} T = 8.856 × 1 0 3.75 = 8.856 × 1 0 3 × 1 0 0.75 = 8856 × 5.623 = 49806 K 查看原页 微小差异的可能来源:舍入误差、常数的精度。
查看原页 单位体积功率 = 总功率 体积 = \frac{\mathrm{总功率}}{\mathrm{体积}} = 体积 总功率 ρ p o w e r = L V \rho_{power} = \frac{L}{V} ρ p o w er = V L L = 4 π R 2 σ T 4 L = 4\pi R^{2}\sigma T^{4} L = 4 π R 2 σ T 4 V = 4 3 π R 3 V = \frac{4}{3}\pi R^{3} V = 3 4 π R 3 ρ p o w e r = 4 π R 2 σ T 4 4 3 π R 3 = 3 σ T 4 R \rho_{power} = \frac{4\pi R^{2}\sigma T^{4}}{\frac{4}{3}\pi R^{3}} = \frac{3\sigma T^{4}}{R} ρ p o w er = 3 4 π R 3 4 π R 2 σ T 4 = R 3 σ T 4
查看原页 ρ p o w e r , h u m a n = 3 σ T m o d i f i e d , s u n 4 R s u n \rho_{power,human} = \frac{3\sigma T_{modified, sun}^{4}}{R_{sun}} ρ p o w er , h u man = R s u n 3 σ T m o d i f i e d , s u n 4 查看原页
T m o d i f i e d , s u n 4 = ρ p o w e r , h u m a n R s u n 3 σ T_{modified, sun}^{4} = \frac{\rho_{power, human} R_{sun}}{3\sigma} T m o d i f i e d , s u n 4 = 3 σ ρ p o w er , h u man R s u n
查看原页
ρ p o w e r , h u m a n ≈ 10 3 W / m 3 \rho_{power,human}\approx 10^{3}\mathrm{W / m^{3}} ρ p o w er , h u man ≈ 1 0 3 W/ m 3
查看原页
R s u n ≈ 7 × 10 8 m R_{sun}\approx 7\times 10^{8}\mathrm{m} R s u n ≈ 7 × 1 0 8 m
查看原页
σ ≈ 6 × 10 − 8 W m − 2 K − 4 \sigma \approx 6\times 10^{- 8}\mathrm{Wm}^{- 2}\mathrm{K}^{- 4} σ ≈ 6 × 1 0 − 8 Wm − 2 K − 4
查看原页 T 4 ≈ 10 3 × 7 × 10 8 3 × 6 × 10 − 8 = 7 × 10 11 18 × 10 − 8 = 0.38 × 10 19 = 3.8 × 10 18 T^{4}\approx \frac{10^{3}\times 7\times 10^{8}}{3\times 6\times 10^{-8}} = \frac{7\times 10^{11}}{18\times 10^{-8}} = 0.38\times 10^{19} = 3.8\times 10^{18} T 4 ≈ 3 × 6 × 1 0 − 8 1 0 3 × 7 × 1 0 8 = 18 × 1 0 − 8 7 × 1 0 11 = 0.38 × 1 0 19 = 3.8 × 1 0 18 查看原页
T ≈ ( 3.8 × 10 18 ) 1 / 4 = ( 3800 × 10 15 ) 1 / 4 T\approx (3.8\times 10^{18})^{1 / 4} = (3800\times 10^{15})^{1 / 4} T ≈ ( 3.8 × 1 0 18 ) 1/4 = ( 3800 × 1 0 15 ) 1/4
查看原页
T ≈ ( 3800 ) 0.25 × 10 3.75 T\approx (3800)^{0.25}\times 10^{3.75} T ≈ ( 3800 ) 0.25 × 1 0 3.75
查看原页 ( 3800 ) 0.25 : 7 4 = 2401 , 8 4 = 4096. (3800)^{0.25}\colon 7^{4} = 2401,8^{4} = 4096. ( 3800 ) 0.25 : 7 4 = 2401 , 8 4 = 4096. 所以,介于 7 和 8 之间。
查看原页
T ≈ 7.8 × 10 3.75 = 7800 × 5.6 = 43680 K T\approx 7.8\times 10^{3.75} = 7800\times 5.6 = 43680\mathrm{K} T ≈ 7.8 × 1 0 3.75 = 7800 × 5.6 = 43680 K
查看原页 题目陈述很直接,似乎没有任何隐藏的复杂性。所做的假设对于此类问题是标准的。
查看原页 人类的功率: 100 W 100\mathrm{W} 100 W (精确)
查看原页 人类的体积: 66400 c m 3 66400\mathrm{cm}^{3} 66400 cm 3 (精确)
查看原页 得到的结果非常接近选项 E。鉴于选择题的性质,最接近的选项很可能就是出题人想要的答案。
查看原页 如果对题目有任何误解,很可能出在设定上。然而,“如果太阳大小相同,但它产生的单位体积功率与人类相同”这句话似乎很明确。
查看原页 表面温度是用斯特藩-玻尔兹曼定律计算的,假设为黑体辐射。
查看原页 我们计算出的值约为 49800 K,最接近 50000 K。
查看原页 如果我们对常数使用更精确的值,结果可能会略有不同,但很可能不足以偏移到另一个选项。
查看原页 题目中提到的趣闻意味着人类的功率密度高于太阳。让我们验证这一点。
查看原页 太阳的输出功率: 3.846 × 10 26 W 3.846\times 10^{26}\mathrm{W} 3.846 × 1 0 26 W
查看原页 太阳的体积: 4.43 × 10 27 m 3 4.43\times 10^{27}\mathrm{m}^{3} 4.43 × 1 0 27 m 3
查看原页 太阳的功率密度: 3.846 × 10 26 4.43 × 10 27 = 0.868 W / m 3 \frac{3.846\times 10^{26}}{4.43\times 10^{27}} = 0.868\mathrm{W / m^{3}} 4.43 × 1 0 27 3.846 × 1 0 26 = 0.868 W/ m 3
查看原页 人类的功率密度: 1506 W / m 3 1506\mathrm{W / m^{3}} 1506 W/ m 3
查看原页 最后检查计算步骤和逻辑。将改造后太阳的功率密度等同于人类的功率密度,然后使用斯特藩-玻尔兹曼定律的方法似乎是正确的。
查看原页 一个普通人类产生的功率为 P h u m a n = 100 W P_{human} = 100 \mathrm{W} P h u man = 100 W ,一个普通人类的体积为 V h u m a n = 66400 c m 3 = 0.0664 m 3 V_{human} = 66400 \mathrm{cm}^3 = 0.0664 \mathrm{m}^3 V h u man = 66400 cm 3 = 0.0664 m 3 。
查看原页 人类的功率密度为 ρ p o w e r , h u m a n = P h u m a n V h u m a n = 100 W 0.0664 m 3 ≈ 1506.02 W / m 3 \rho_{power,human} = \frac{P_{human}}{V_{human}} = \frac{100 \mathrm{W}}{0.0664 \mathrm{m}^3} \approx 1506.02 \mathrm{W / m}^3 ρ p o w er , h u man = V h u man P h u man = 0.0664 m 3 100 W ≈ 1506.02 W/m 3 。
查看原页 如果太阳大小相同,但产生的单位体积功率与人类相同,那么它的功率密度将是 ρ p o w e r , m o d i f i e d \sun = ρ p o w e r , h u m a n \rho_{power,modified\sun} = \rho{power,human} ρ p o w er , m o d i f i e d \sun = ρ p o w er , h u man 。
查看原页 太阳的半径为 R s u n = 6.95 × 10 8 m R_{sun} = 6.95 \times 10^8 \mathrm{m} R s u n = 6.95 × 1 0 8 m 。
查看原页 太阳的体积为 V s u n = 4 3 π R s u n 3 V_{sun} = \frac{4}{3} \pi R_{sun}^3 V s u n = 3 4 π R s u n 3 。
查看原页 改造后太阳的功率密度由 ρ p o w e r , m o d i f i e d \sun = P m o d i f i e d \sun V s u n \rho_{power,modified\sun} = \frac{P{modified\sun}}{V{sun}} ρ p o w er , m o d i f i e d \sun = V s u n P m o d i f i e d \sun 给出。
查看原页 我们还知道 P m o d i f i e d \sun = 4 π R s u n 2 σ T 4 P_{modified\sun} = 4 \pi R{sun}^2 \sigma T^4 P m o d i f i e d \sun = 4 π R s u n 2 σ T 4 ,其中 T T T 是改造后太阳的表面温度。
查看原页 ρ p o w e r , h u m a n = 4 π R s u n 2 σ T 4 4 3 π R s u n 3 = 3 σ T 4 R s u n \rho_{power,human} = \frac{4 \pi R_{sun}^2 \sigma T^4}{\frac{4}{3} \pi R_{sun}^3} = \frac{3 \sigma T^4}{R_{sun}} ρ p o w er , h u man = 3 4 π R s u n 3 4 π R s u n 2 σ T 4 = R s u n 3 σ T 4 查看原页 T 4 = ρ p o w e r , h u m a n R s u n 3 σ T^4 = \frac{\rho_{power,human} R_{sun}}{3 \sigma} T 4 = 3 σ ρ p o w er , h u man R s u n 查看原页 T 4 = 1506.02 W / m 3 × 6.95 × 10 8 m 3 × 5.67 × 10 − 8 W m − 2 K − 4 T^4 = \frac{1506.02 \mathrm{W / m}^3 \times 6.95 \times 10^8 \mathrm{m}}{3 \times 5.67 \times 10^{-8} \mathrm{Wm}^{-2} \mathrm{K}^{-4}} T 4 = 3 × 5.67 × 1 0 − 8 Wm − 2 K − 4 1506.02 W/m 3 × 6.95 × 1 0 8 m 查看原页 T 4 = 1.0466 × 10 12 1.701 × 10 − 7 = 6.1528 × 10 18 K 4 T^4 = \frac{1.0466 \times 10^{12}}{1.701 \times 10^{-7}} = 6.1528 \times 10^{18} \mathrm{K}^4 T 4 = 1.701 × 1 0 − 7 1.0466 × 1 0 12 = 6.1528 × 1 0 18 K 4 查看原页 T = ( 6.1528 × 10 18 ) 1 / 4 = ( 6152.8 ) 0.25 × 10 18 / 4 = ( 6152.8 ) 0.25 × 10 4.5 T = (6.1528 \times 10^{18})^{1 / 4} = (6152.8)^{0.25} \times 10^{18 / 4} = (6152.8)^{0.25} \times 10^{4.5} T = ( 6.1528 × 1 0 18 ) 1/4 = ( 6152.8 ) 0.25 × 1 0 18/4 = ( 6152.8 ) 0.25 × 1 0 4.5 查看原页 log 10 ( 6152.8 ) ≈ 3.789
\log_{10}(6152.8) \approx 3.789
log 10 ( 6152.8 ) ≈ 3.789 查看原页 0.25 × 3.789 = 0.94725
0.25 \times 3.789 = 0.94725
0.25 × 3.789 = 0.94725 查看原页 ( 6152.8 ) 0.25 = 10 0.94725 ≈ 8.856
(6152.8)^{0.25} = 10^{0.94725} \approx 8.856
( 6152.8 ) 0.25 = 1 0 0.94725 ≈ 8.856 查看原页 T = 8.856 × 10 4.5 = 8.856 × 10 4 × 10 0.5 = 88560 × 10 ≈ 88560 × 3.16 = 280000 K
T = 8.856 \times 10^{4.5} = 8.856 \times 10^4 \times 10^{0.5} = 88560 \times \sqrt{10} \approx 88560 \times 3.16 = 280000 \mathrm{K}
T = 8.856 × 1 0 4.5 = 8.856 × 1 0 4 × 1 0 0.5 = 88560 × 10 ≈ 88560 × 3.16 = 280000 K 查看原页 让我们重新计算指数: 18 / 4 = 4.5 18 / 4 = 4.5 18/4 = 4.5 。
查看原页 T = 8.856 × 10 4.5 = 8.856 × 10 4 × 10 0.5 T = 8.856 \times 10^{4.5} = 8.856 \times 10^4 \times 10^{0.5} T = 8.856 × 1 0 4.5 = 8.856 × 1 0 4 × 1 0 0.5 ——上一步有误。
查看原页
T = ( 6.1528 × 10 18 ) 0.25 = 49806 K T = (6.1528 \times 10^{18})^{0.25} = 49806 \mathrm{K} T = ( 6.1528 × 1 0 18 ) 0.25 = 49806 K
查看原页 表面温度大约为49806 K,最接近50000 K。
查看原页 最终答案:最终答案是 E \boxed{E} E
查看原页 那么推理轨迹的token数在1024到2048之间。在表12中,我们表明训练后模型几乎不遵循token指令。当给定更高限制时,它有时确实会生成更多token,但经常超出限制。这可能并非我们的模型所独有,因为先前工作表明OpenAI o1-mini也无法遵循token指令(Zhang & Chen, 2024)。为防止超出限制,我们测试了预算强制,即在达到限制后强制结束思考。这带来了完美控制(表12(下半部分))。在预算强制下,扩展趋势也更清晰,因为当给定较小思考预算时,模型不再能超出限制。这使得表3中Token Prompting + budget forcing的测试时扩展值更好。为了计算表3中报告的控制度(针对token条件控制变体),我们将表12中思考token少于上限的次数除以总评估次数(无干预时为2/5;有干预时为5/5)。
查看原页 步骤条件控制 Token指令失败,因为当前模型无法计数token。为适应这一能力缺失,我们尝试让计数更粗粒度。我们将推理轨迹划分为步骤,并要求模型思考特定步数而不是token数。我们按双换行将推理轨迹拆分为步骤,根据对样本的人工检查,我们发现这可以作为直观分隔符。我们根据训练样本的步骤数将其分入2的幂桶中,并在图10(右侧)的格式后添加相应的步骤指令。该格式基于早期实验,我们发现模型在倒计数(“还剩3步……还剩2步”)而不是正计数(“第2步……第3步……”)时更可能遵守步骤限制。这可能是因为如果倒计数,最后一步总是1,这会作为模型完成生成的强先验。如果正计数,答案前的最后一步会变化,因此如果模型不记得原始步骤指令,它可能无法停止。我们从表13的结果中得出以下结论:(1)模型仍然难以遵守步骤限制。模型有时会简单地继续数到负步骤,例如“还剩1步”。为解决这个问题,我们一旦达到0步就自动停止思考过程,然后通过附加答案token分隔符(§3)强制模型转入回答模式。这带来了完美的步骤遵守(表13下半部分),但仍存在问题。(2)模型通过让每一步更长来补偿更少的步骤。例如,当被迫使用最多16步而不是256步时,模型平均每步生成96个token,而不是56个。尽管存在这个问题,在表13中更多步骤仍明显与更多总思考token和更好性能相关,导致正斜率。(3)步骤指令比其他方法成本更高。步骤分隔符每个需要约6个token,例如64步总共会增加约380个token。当像表13中那样在token计数中忽略步骤分隔符时,模型平均仍需要7551个思考token,才能在AIME24上仅达到\(33.3\%\)。为了计算表3中报告的控制度(针对步骤条件控制变体),我们首先确定每步上限为100个token,然后将此数乘以指示的步数,得到代理总token限制,例如指示16步时为1600。然后我们检查表13中的思考token是否适合每次评估运行的相应限制(无干预时为3/5;有干预时为5/5)。对于图7中的模型,我们使用一个在早期版本数据和早期版本评估代码库上训练的步骤条件控制模型。
查看原页 类别条件控制 OpenAI通过“reasoning_effort” API参数向用户暴露测试时计算控制,该参数有三个可能设置:低、中、高。OpenAI文档还指出,“降低推理努力可能导致响应更快,并且响应中用于推理的token更少。”这表明他们无法有保证地控制测试时计算。因此,也许OpenAI只是根据所需推理努力调整提示或系统指令。在表14中,我们表明,为短思考和长思考分别设置提示,使我们能够在某种程度上控制思考时间:提示模型思考更久会导致更长思考。然而,它不能可靠提高性能,而且控制并不精确。当我们只有三个类别时,当前对控制的遵守程度可能足够,但它可能无法扩展到更细粒度类别。为了计算表3中报告的控制度(针对该方法),我们假设在表14中提示模型短时间思考应比AIME24默认产生更少token,而长提示应产生更多token。由于\(8033 > 6109\)且\(9651 > 6109\),两者中有一个符合我们的预期控制,因此控制度为\(50\%\)。
查看原页 3https://github.com/openai/openai-python/blob/44d6210f101abedeb2dd68507fcfcb329df70ea/src/openai/types/chat/completion_create_params.py#L172
查看原页 表15. 早期版本s1-32B在AIME24上进行拒绝采样时生成的答案。黑色文本是问题,黄色文本是解答。仅基于问题,我们使用温度为1的s1-32B生成浅蓝色推理轨迹和蓝色响应。对于第一个示例,我们生成直到推理轨迹少于4000个token;对于第二个示例,少于8000个token。每个示例平均需要199(1)次尝试,直到思考 ≤ 4000 \leq 4000 ≤ 4000 ( \(\leq 8000\)个token)。
查看原页 设 O ( 0 , 0 ) , A ( 1 2 , 0 ) O(0,0),A(\frac{1}{2},0) O ( 0 , 0 ) , A ( 2 1 , 0 ) 和 B ( 0 , 3 2 ) B(0,\frac{\sqrt{3}}{2}) B ( 0 , 2 3 ) 为坐标平面中的点。设 F \mathcal{F} F 为单位长度线段 P Q ‾ \overline{P Q} P Q 的族,这些线段位于第一象限, P P P 在 x x x 轴上, Q Q Q 在 y y y 轴上。在 A B ‾ \overline{A B} A B 上存在唯一一点 C C C ,不同于 A A A 和 B B B ,且不属于除 A B ‾ \overline{A B} A B 以外的任何来自 F \mathcal{F} F 的线段。那么 O C 2 = p q O C^{2} = \frac{p}{q} O C 2 = q p ,其中 p p p 和 q q q 是互素正整数。求 p + q p + q p + q 。
查看原页 [使用3981个思考token和1055个答案token的正确生成]
查看原页 题目要求在线段 A B ‾ \overline{A B} A B 上找一点 C C C ,该点不包含在族 F \mathcal{F} F 中除 A B ‾ \overline{A B} A B 本身以外的任何其他线段中。
查看原页 点 O , A , B O,A,B O , A , B 在第一象限内构成一个三角形。
查看原页
O = ( 0 , 0 ) O = (0,0) O = ( 0 , 0 )
查看原页
A = ( 1 2 , 0 ) A = (\frac{1}{2},0) A = ( 2 1 , 0 )
查看原页
B = ( 0 , 3 2 ) B = (0,\frac{\sqrt{3}}{2}) B = ( 0 , 2 3 )
查看原页 线段 A B ‾ \overline{A B} A B 连接 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 ) 和 B ( 0 , 3 2 ) B(0,\frac{\sqrt{3}}{2}) B ( 0 , 2 3 )
查看原页 包含 A B ‾ \overline{A B} A B 的直线方程可通过这两个点求得:
查看原页 斜率 m = 3 2 − 0 0 − 1 2 = − 3 m = \frac{\frac{\sqrt{3}}{2} - 0}{0 - \frac{1}{2}} = - \sqrt{3} m = 0 − 2 1 2 3 − 0 = − 3
查看原页 使用点斜式 y − y 1 = m ( x − x 1 ) y - y_{1} = m(x - x_{1}) y − y 1 = m ( x − x 1 ) ,取点 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 )
查看原页 y − 0 = − 3 ( x − 1 2 ) y - 0 = -\sqrt{3} (x - \frac{1}{2}) y − 0 = − 3 ( x − 2 1 ) 查看原页 y = − 3 x + 3 2 y = -\sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 查看原页 线段 A B ‾ \overline{A B} A B 位于第一象限,连接 ( 1 2 , 0 ) (\frac{1}{2},0) ( 2 1 , 0 ) 与 ( 0 , 3 2 ) (0,\frac{\sqrt{3}}{2}) ( 0 , 2 3 )
查看原页 族 F \mathcal{F} F 由长度为 1 的线段 P Q ‾ \overline{P Q} P Q 组成,其中 P P P 在 x x x 轴上, Q Q Q 在 y y y 轴上。设 P = ( a , 0 ) P = (a,0) P = ( a , 0 ) , Q = ( 0 , b ) Q = (0,b) Q = ( 0 , b ) 。
查看原页 P Q ‾ \overline{P Q} P Q 的长度为 ( a − 0 ) 2 + ( 0 − b ) 2 = a 2 + b 2 = 1 \sqrt{(a - 0)^{2} + (0 - b)^{2}} = \sqrt{a^{2} + b^{2}} = 1 ( a − 0 ) 2 + ( 0 − b ) 2 = a 2 + b 2 = 1 。
查看原页 因此 a 2 + b 2 = 1 a^{2} + b^{2} = 1 a 2 + b 2 = 1 。
查看原页 由于 P P P 在正 x x x 轴上, Q Q Q 在正 y y y 轴上,我们有 a > 0 a > 0 a > 0 且 b > 0 b > 0 b > 0 。
查看原页 线段 P Q ‾ \overline{P Q} P Q 连接 ( a , 0 ) (a,0) ( a , 0 ) 与 ( 0 , b ) (0,b) ( 0 , b ) 。包含 P Q ‾ \overline{P Q} P Q 的直线方程为 x a + y b = 1 \frac{x}{a} +\frac{y}{b} = 1 a x + b y = 1 。
查看原页 族 F \mathcal{F} F 所覆盖的区域是由包含这些线段的直线所围成的区域。端点 ( a , 0 ) (a,0) ( a , 0 ) 与 ( 0 , b ) (0,b) ( 0 , b ) 在满足 a 2 + b 2 = 1 a^{2} + b^{2} = 1 a 2 + b 2 = 1 的条件下变化。
查看原页 考虑参数化 a = cos θ a = \cos \theta a = cos θ , b = sin θ b = \sin \theta b = sin θ ,其中 0 < θ < π 2 0< \theta < \frac{\pi}{2} 0 < θ < 2 π 。
查看原页 线段 P Q ‾ \overline{P Q} P Q 连接 ( cos θ , 0 ) (\cos \theta ,0) ( cos θ , 0 ) 与 ( 0 , sin θ ) (0,\sin \theta) ( 0 , sin θ ) 。该直线的方程为 x cos θ + y sin θ = 1 \frac{x}{\cos\theta} +\frac{y}{\sin\theta} = 1 c o s θ x + s i n θ y = 1 。
查看原页 我们正在寻找 A B ‾ \overline{A B} A B 上一个独特的点 C C C ,它不同于 A A A 和 B B B ,且除 A B ‾ \overline{A B} A B 外不属于 F \mathcal{F} F 中的任何其他线段。
查看原页 设 C C C 是 A B ‾ \overline{A B} A B 上的一点。我们可以将 A B ‾ \overline{A B} A B 上的点参数化为 ( 1 − t ) A + t B (1 - t)A + tB ( 1 − t ) A + tB ,其中 0 ≤ t ≤ 1 0 \leq t \leq 1 0 ≤ t ≤ 1 。
查看原页 C = ( 1 − t ) ( 1 2 , 0 ) + t ( 0 , 3 2 ) = ( 1 2 − 1 2 t , 3 2 t ) C = (1 - t)(\frac{1}{2},0) + t(0,\frac{\sqrt{3}}{2}) = (\frac{1}{2} - \frac{1}{2} t,\frac{\sqrt{3}}{2} t) C = ( 1 − t ) ( 2 1 , 0 ) + t ( 0 , 2 3 ) = ( 2 1 − 2 1 t , 2 3 t ) 。
查看原页 由于 C C C 不同于 A ‾ \overline{A} A 和 B ‾ \overline{B} B ,我们有 0 < t < 1 0< t< 1 0 < t < 1 。
查看原页 假设点 C C C 位于某个线段 P Q ‾ ∈ F \overline{P Q} \in \mathcal{F} P Q ∈ F 上,其中 P = ( cos θ , 0 ) P = (\cos \theta ,0) P = ( cos θ , 0 ) 且 Q = ( 0 , sin θ ) Q = (0,\sin \theta) Q = ( 0 , sin θ ) 。
查看原页 点 C C C 满足方程 x cos θ + y sin θ = 1 \frac{x}{\cos\theta} +\frac{y}{\sin\theta} = 1 c o s θ x + s i n θ y = 1 。
查看原页 1 2 − 1 3 t cos θ + 3 2 t sin θ = 1 1 − t 2 cos θ + 3 t 2 sin θ = 1 \begin{array}{c} \frac{\frac{1}{2} - \frac{1}{3}t}{\cos \theta} +\frac{\frac{\sqrt{3}}{2}t}{\sin \theta} = 1 \\ \frac{1 - t}{2\cos \theta} +\frac{\sqrt{3}t}{2\sin \theta} = 1 \end{array} c o s θ 2 1 − 3 1 t + s i n θ 2 3 t = 1 2 c o s θ 1 − t + 2 s i n θ 3 t = 1 查看原页 1 − t cos θ + 3 t sin θ = 2 ( 1 − t ) sin θ + 3 t cos θ = 2 sin θ cos θ \begin{array}{c} \frac{1 - t}{\cos \theta} +\frac{\sqrt{3}t}{\sin \theta} = 2 \\ (1 - t)\sin \theta +\sqrt{3} t\cos \theta = 2\sin \theta \cos \theta \end{array} c o s θ 1 − t + s i n θ 3 t = 2 ( 1 − t ) sin θ + 3 t cos θ = 2 sin θ cos θ 查看原页 我们正在寻找 A B ‾ \overline{AB} A B 上的一个点 C C C ,使得 F \mathcal{F} F 中包含 C C C 的唯一线段是 A B ‾ \overline{AB} A B 本身。线段 A B ‾ \overline{AB} A B 是族 F \mathcal{F} F 的一部分。
查看原页 对于 A B ‾ \overline{AB} A B , P = A = ( 1 2 , 0 ) P = A = (\frac{1}{2},0) P = A = ( 2 1 , 0 ) 且 Q = B = ( 0 , 3 2 ) Q = B = (0,\frac{\sqrt{3}}{2}) Q = B = ( 0 , 2 3 ) 。
查看原页 这里 a = 1 2 a = \frac{1}{2} a = 2 1 , b = 3 2 b = \frac{\sqrt{3}}{2} b = 2 3 。
查看原页 a 2 + b 2 = ( 1 2 ) 2 + ( 3 2 ) 2 = 1 4 + 3 4 = 1. a^{2} + b^{2} = (\frac{1}{2})^{2} + (\frac{\sqrt{3}}{2})^{2} = \frac{1}{4} +\frac{3}{4} = 1. a 2 + b 2 = ( 2 1 ) 2 + ( 2 3 ) 2 = 4 1 + 4 3 = 1. 查看原页 线段 A B ‾ \overline{AB} A B 连接 ( 1 2 , 0 ) (\frac{1}{2},0) ( 2 1 , 0 ) 和 ( 0 , 3 2 ) (0,\frac{\sqrt{3}}{2}) ( 0 , 2 3 ) 。
查看原页 该直线的方程为 x 1 / 2 + y 3 / 2 = 1 \frac{x}{1 / 2} +\frac{y}{\sqrt{3 / 2}} = 1 1/2 x + 3/2 y = 1 ,化简为 2 x + 2 3 y = 1 2x + \frac{2}{\sqrt{3}} y = 1 2 x + 3 2 y = 1 ,或 3 x + y = 3 2 \sqrt{3} x + y = \frac{\sqrt{3}}{2} 3 x + y = 2 3 。
查看原页 这与方程 y = − 3 x + 3 2 y = -\sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 相符。
查看原页 考虑直线族 x cos θ + y sin θ = 1 \frac{x}{\cos \theta} +\frac{y}{\sin \theta} = 1 c o s θ x + s i n θ y = 1 的包络。
查看原页 x sin θ cos 2 θ + y cos θ sin 2 θ = 0 \frac{x\sin\theta}{\cos^{2}\theta} +\frac{y\cos\theta}{\sin^{2}\theta} = 0 cos 2 θ x sin θ + sin 2 θ y cos θ = 0 查看原页 y cos θ sin 2 θ = x sin θ cos 2 θ \frac{y\cos\theta}{\sin^{2}\theta} = \frac{x\sin\theta}{\cos^{2}\theta} sin 2 θ y cos θ = cos 2 θ x sin θ 查看原页 y cos 3 θ = x sin 3 θ y\cos^{3}\theta = x\sin^{3}\theta y cos 3 θ = x sin 3 θ 查看原页 y x = tan 3 θ \frac{y}{x} = \tan^{3}\theta x y = tan 3 θ 查看原页 tan θ = ( y x ) 1 / 3 \tan \theta = (\frac{y}{x})^{1 / 3} tan θ = ( x y ) 1/3 查看原页 由直线方程: y sin θ = sin θ cos θ − x sin θ y\sin \theta = \sin \theta \cos \theta - x\sin \theta y sin θ = sin θ cos θ − x sin θ
查看原页
y = cos θ − x y = \cos \theta - x y = cos θ − x
查看原页 代入 cos θ = 1 1 + tan 2 θ = 1 1 + ( y / x ) 2 / 3 \cos \theta = \frac{1}{\sqrt{1 + \tan^{2}\theta}} = \frac{1}{\sqrt{1 + (y / x)^{2 / 3}}} cos θ = 1 + t a n 2 θ 1 = 1 + ( y / x ) 2/3 1
查看原页 cos θ = x 1 / 3 ( x 2 / 3 + y 2 / 3 ) 1 / 2 \cos \theta = \frac{x^{1 / 3}}{(x^{2 / 3} + y^{2 / 3})^{1 / 2}} cos θ = ( x 2/3 + y 2/3 ) 1/2 x 1/3 查看原页 sin θ = tan θ cos θ = ( y x ) 1 / 3 x 1 / 3 ( x 2 / 3 + y 2 / 3 ) 1 / 2 = y 1 / 3 ( x 2 / 3 + y 2 / 3 ) 1 / 2 \sin \theta = \tan \theta \cos \theta = (\frac{y}{x})^{1 / 3}\frac{x^{1 / 3}}{(x^{2 / 3} + y^{2 / 3})^{1 / 2}} = \frac{y^{1 / 3}}{(x^{2 / 3} + y^{2 / 3})^{1 / 2}} sin θ = tan θ cos θ = ( x y ) 1/3 ( x 2/3 + y 2/3 ) 1/2 x 1/3 = ( x 2/3 + y 2/3 ) 1/2 y 1/3 查看原页 x cos θ + y sin θ = 1 x ( x 2 / 3 + y 2 / 3 ) 1 / 2 / x 1 / 3 + y ( x 2 / 3 + y 2 / 3 ) 1 / 2 / y 1 / 3 = 1 x 2 / 3 ( x 2 / 3 + y 2 / 3 ) 1 / 2 + y 2 / 3 ( x 2 / 3 + y 2 / 3 ) 1 / 2 = 1 ( x 2 / 3 + y 2 / 3 ) 3 / 2 = 1 x 2 / 3 + y 2 / 3 = 1 \begin{array}{c} \frac{x}{\cos\theta} +\frac{y}{\sin\theta} = 1 \\ x(x^{2 / 3} + y^{2 / 3})^{1 / 2} / x^{1 / 3} + y(x^{2 / 3} + y^{2 / 3})^{1 / 2} / y^{1 / 3} = 1 \\ x^{2 / 3}(x^{2 / 3} + y^{2 / 3})^{1 / 2} + y^{2 / 3}(x^{2 / 3} + y^{2 / 3})^{1 / 2} = 1 \\ (x^{2 / 3} + y^{2 / 3})^{3 / 2} = 1 \\ x^{2 / 3} + y^{2 / 3} = 1 \end{array} c o s θ x + s i n θ y = 1 x ( x 2/3 + y 2/3 ) 1/2 / x 1/3 + y ( x 2/3 + y 2/3 ) 1/2 / y 1/3 = 1 x 2/3 ( x 2/3 + y 2/3 ) 1/2 + y 2/3 ( x 2/3 + y 2/3 ) 1/2 = 1 ( x 2/3 + y 2/3 ) 3/2 = 1 x 2/3 + y 2/3 = 1 查看原页 族 F \mathcal{F} F 的包络是星形线 x 2 / 3 + y 2 / 3 = 1 x^{2 / 3} + y^{2 / 3} = 1 x 2/3 + y 2/3 = 1 。
查看原页 F \mathcal{F} F 中的线段与该星形线相切。
查看原页 我们要寻找的 A B ‾ \overline{AB} A B 上的点 C C C ,就是 A B ‾ \overline{AB} A B 与星形线相切的点。
查看原页 \(\overline{AB}\) 的方程是 \(y = -\sqrt{3} x + \frac{\sqrt{3}}{2}\) 。
查看原页 x 2 / 3 + ( − 3 x + 3 2 ) 2 / 3 = 1 x^{2 / 3} + (-\sqrt{3} x + \frac{\sqrt{3}}{2})^{2 / 3} = 1 x 2/3 + ( − 3 x + 2 3 ) 2/3 = 1 查看原页 令 \(u = x^{1 / 3}\) 和 \(v = y^{1 / 3}\) 。星形线为 \(u^{2} + v^{2} = 1\) 。
查看原页 点 \(C\) 同时位于直线 \(\overline{AB}\) 和星形线上。
查看原页 2 3 x − 1 / 3 + 2 3 y − 1 / 3 y ′ = 0 \frac{2}{3} x^{-1 / 3} + \frac{2}{3} y^{-1 / 3}y' = 0 3 2 x − 1/3 + 3 2 y − 1/3 y ′ = 0 查看原页 y ′ = − y 1 / 3 x 1 / 3 = − ( y x ) 1 / 3 y' = -\frac{y^{1 / 3}}{x^{1 / 3}} = -(\frac{y}{x})^{1 / 3} y ′ = − x 1/3 y 1/3 = − ( x y ) 1/3 查看原页 星形线在点 \((x,y)\) 处切线的斜率为 \(- \sqrt[3]{\frac{y}{x}}\) 。
查看原页 直线 \(\overline{{A B}}\) 的斜率为 \(- \sqrt{3}\) 。
查看原页 因此,在切点处,\(- \sqrt[3]{\frac{y}{x}} = - \sqrt{3}\) 。
查看原页 x 3 x = 3 \frac{\sqrt[3]{x}}{x} = \sqrt{3} x 3 x = 3 查看原页 点 \(C\) 位于直线 \(y = - \sqrt{3} x + \frac{\sqrt{3}}{2}\) 上,并满足 \(\frac{y}{x} = 3\sqrt{3}\) 。
查看原页 所以 \(y = 3\sqrt{3} x\) 。
查看原页 3 3 x = − 3 x + 3 2 3\sqrt{3} x = - \sqrt{3} x + \frac{\sqrt{3}}{2} 3 3 x = − 3 x + 2 3 查看原页 3 x = − x + 1 2 3x = -x + \frac{1}{2} 3 x = − x + 2 1 查看原页 4 x = 1 2 4x = \frac{1}{2} 4 x = 2 1 查看原页 于是 \(y = 3\sqrt{3} (\frac{1}{8}) = \frac{3\sqrt{3}}{8}\) 。
查看原页 点 \(C\) 为 \((\frac{1}{8}, \frac{3\sqrt{3}}{8})\) 。
查看原页 我们需要检查该点是否位于线段 \(\overline{{A B}}\) 上。
查看原页 点 \(C\) 具有形式 \((\frac{1}{2} - \frac{1}{2} t, \frac{\sqrt{3}}{2} t)\) 。
查看原页 1 2 − 1 2 t = 1 8 ⇒ 4 − 4 t = 1 ⇒ 3 = 4 t ⇒ t = 3 4 . 3 2 t = 3 2 ⋅ 3 4 = 3 3 8 . \begin{array}{c} \frac{1}{2} - \frac{1}{2} t = \frac{1}{8} \Rightarrow 4 - 4t = 1 \Rightarrow 3 = 4t \Rightarrow t = \frac{3}{4}. \\ \frac{\sqrt{3}}{2} t = \frac{\sqrt{3}}{2} \cdot \frac{3}{4} = \frac{3\sqrt{3}}{8}. \end{array} 2 1 − 2 1 t = 8 1 ⇒ 4 − 4 t = 1 ⇒ 3 = 4 t ⇒ t = 4 3 . 2 3 t = 2 3 ⋅ 4 3 = 8 3 3 . 查看原页 所以 \(C\) 位于 \(\overline{{A B}}\) 上 。
查看原页 我们需要确保 \(0 < t < 1\) ,这对 \(t = \frac{3}{4}\) 成立。
查看原页 现在,我们需要检查该点 \(C\) 是否不属于 \(\mathcal{F}\) 中的任何其他线段 。
查看原页 点 \(C\) 位于星形线上。线段 \(\overline{{A B}}\) 在 \(C\) 处与星形线相切 。
查看原页 \(\mathcal{F}\) 中包含 \(C\) 的任何其他线段都将以 \(C\) 为内点,而不是切点 。
查看原页 考虑族 \(\mathcal{F}\) 的参数化。
查看原页 点 ( x , y ) (x, y) ( x , y ) 属于 F \mathcal{F} F 中某条线段,当且仅当存在 θ \theta θ 使得 x cos θ + y sin θ = 1 \frac{x}{\cos \theta} + \frac{y}{\sin \theta} = 1 c o s θ x + s i n θ y = 1 。
查看原页 对于点 C = ( 1 8 , 3 3 8 ) C = (\frac{1}{8}, \frac{3\sqrt{3}}{8}) C = ( 8 1 , 8 3 3 ) ,我们有:
查看原页 1 / 8 cos θ + 3 3 / 8 sin θ = 1 \frac{1 / 8}{\cos \theta} + \frac{3\sqrt{3} / 8}{\sin \theta} = 1 cos θ 1/8 + sin θ 3 3 /8 = 1 查看原页 1 cos θ + 3 3 sin θ = 8 \frac{1}{\cos \theta} + \frac{3\sqrt{3}}{\sin \theta} = 8 cos θ 1 + sin θ 3 3 = 8 查看原页
sin θ + 3 3 cos θ = 8 sin θ cos θ \sin \theta + 3\sqrt{3} \cos \theta = 8 \sin \theta \cos \theta sin θ + 3 3 cos θ = 8 sin θ cos θ
查看原页
sin θ + 3 3 cos θ = 4 sin ( 2 θ ) \sin \theta + 3\sqrt{3} \cos \theta = 4 \sin (2\theta) sin θ + 3 3 cos θ = 4 sin ( 2 θ )
查看原页 我们知道 C C C 位于 A B ‾ \overline{{A B}} A B 上,而 A B ‾ \overline{{A B}} A B 对应于 F \mathcal{F} F 中某条特定的线段。
查看原页 题目陈述假设这样的点 C C C 存在且唯一。
查看原页 A B ‾ \overline{{A B}} A B 上不同于 A A A 和 B B B 的唯一一点 C C C ,它不属于 F \mathcal{F} F 中除 A B ‾ \overline{{A B}} A B 以外的任何线段。
查看原页 这意味着,如果 C C C 位于另一条线段 P ′ Q ′ ‾ ∈ F \overline{{P^{\prime}Q^{\prime}}} \in \mathcal{F} P ′ Q ′ ∈ F 上,那么 P ′ Q ′ ‾ = A B ‾ \overline{{P^{\prime}Q^{\prime}}} = \overline{{A B}} P ′ Q ′ = A B 。
查看原页 点 C C C 是 A B ‾ \overline{{A B}} A B 与星形线的切点。
查看原页 现在我们需要求 O C 2 O C^{2} O C 2 。
查看原页 O C 2 = ( 1 8 ) 2 + ( 3 3 8 ) 2 = 1 64 + 27 64 = 28 64 = 7 16 . O C^{2} = (\frac{1}{8})^{2} + (\frac{3\sqrt{3}}{8})^{2} = \frac{1}{64} + \frac{27}{64} = \frac{28}{64} = \frac{7}{16}. O C 2 = ( 8 1 ) 2 + ( 8 3 3 ) 2 = 64 1 + 64 27 = 64 28 = 16 7 . 查看原页 这里 p = 7 p = 7 p = 7 , q = 16 q = 16 q = 16 。
查看原页 p + q = 7 + 16 = 23 p + q = 7 + 16 = 23 p + q = 7 + 16 = 23 。
查看原页 族 F \mathcal{F} F 由端点位于坐标轴上的单位长度线段组成。
查看原页 该族的包络线是星形线 x 2 / 3 + y 2 / 3 = 1 x^{2 / 3} + y^{2 / 3} = 1 x 2/3 + y 2/3 = 1 。
查看原页 F \mathcal{F} F 中的线段与星形线相切。
查看原页 线段 A B ‾ \overline{{A B}} A B 也是族 F \mathcal{F} F 的一个成员。
查看原页 我们要找的是 A B ‾ \overline{{A B}} A B 上位于星形线上的点 C C C 。
查看原页 这个点 C C C 是 A B ‾ \overline{{A B}} A B 与星形线的切点。
查看原页 如果 A B ‾ \overline{{A B}} A B 上的一点位于星形线上,它属于该点处的切线段。由于 A B ‾ \overline{{A B}} A B 就是该切线段,这个点不属于 F \mathcal{F} F 中的任何其他线段。
查看原页 考虑线段 A B ‾ \overline{{A B}} A B 与星形线交于两点的情况。
查看原页 如果线段 A B ‾ \overline{{A B}} A B 不与星形线相切,那么有两个交点。
查看原页 设交点为 C 1 C_{1} C 1 和 C 2 C_{2} C 2
查看原页 如果 C 1 C_{1} C 1 位于 A B ‾ \overline{{A B}} A B 上,那么星形线在 C 1 C_{1} C 1 处的切线就是线段 A B ‾ \overline{{A B}} A B
查看原页 如果 C 2 C_{2} C 2 位于 A B ‾ \overline{{A B}} A B 上,那么星形线在 C 2 C_{2} C 2 处的切线就是线段 A B ‾ \overline{{A B}} A B
查看原页 A B ‾ \overline{{A B}} A B 的斜率为 − 3 - \sqrt{3} − 3
查看原页 我们找到了星形线上切线斜率为 − 3 - \sqrt{3} − 3 的点
查看原页 点 C C C 必须位于 A B ‾ \overline{{A B}} A B 的内部,因此 0 < t < 1 0< t< 1 0 < t < 1
查看原页 参数 t = 3 4 t = \frac{3}{4} t = 4 3 在此范围内。
查看原页 如果 C = A C = A C = A ,那么 t = 0 t = 0 t = 0 , C = ( 1 2 , 0 ) C = (\frac{1}{2},0) C = ( 2 1 , 0 )
查看原页 如果 C = B C = B C = B ,那么 t = 1 t = 1 t = 1 , C = ( 0 , 3 2 ) C = (0,\frac{\sqrt{3}}{2}) C = ( 0 , 2 3 )
查看原页 切点 C C C 是 A B ‾ \overline{{A B}} A B 上(不包括端点)位于星形线上的唯一一点。
查看原页 设由单位长度的线段 P Q ‾ \overline{{P Q}} P Q 构成的线段族 F \mathcal{F} F ,其中 P P P 在正 x x x 轴上, Q Q Q 在正 y y y 轴上。令 P = ( a , 0 ) P = (a,0) P = ( a , 0 ) , Q = ( 0 , b ) Q = (0,b) Q = ( 0 , b ) 。长度条件给出 a 2 + b 2 = 1 a^{2} + b^{2} = 1 a 2 + b 2 = 1 。线段 P Q ‾ \overline{{P Q}} P Q 位于直线 x a + y b = 1 \frac{x}{a} +\frac{y}{b} = 1 a x + b y = 1 上。使用参数化 a = cos θ a = \cos \theta a = cos θ , b = sin θ b = \sin \theta b = sin θ ,其中 0 < θ < π 2 0< \theta < \frac{\pi}{2} 0 < θ < 2 π ,该直线的方程为 x cos θ + y sin θ = 1 \frac{x}{\cos\theta} +\frac{y}{\sin\theta} = 1 c o s θ x + s i n θ y = 1 。
查看原页 这个直线族的包络是星形线 x 2 / 3 + y 2 / 3 = 1 x^{2 / 3} + y^{2 / 3} = 1 x 2/3 + y 2/3 = 1
查看原页 来自 F \mathcal{F} F 的线段与该星形线相切。
查看原页 线段 A B ‾ \overline{{A B}} A B 连接 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 ) 和 B ( 0 , 3 2 ) B(0,\frac{\sqrt{3}}{2}) B ( 0 , 2 3 ) 。包含 A B ‾ \overline{{A B}} A B 的直线方程为 y = − 3 x + 3 2 y = - \sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 。该线段是族 F \mathcal{F} F 的一部分。
查看原页 我们要找 A B ‾ \overline{{A B}} A B 上唯一一点 C C C ,它不同于 A A A 和 B B B ,且不属于除 A B ‾ \overline{{A B}} A B 以外的任何来自 F \mathcal{F} F 的线段。这意味着 C C C 是 A B ‾ \overline{{A B}} A B 与星形线相切的点。
查看原页 星形线在点 ( x , y ) (x,y) ( x , y ) 处的切线斜率为 − y x 3 - \sqrt[3]{\frac{y}{x}} − 3 x y 。 A B ‾ \overline{{A B}} A B 的斜率为 − 3 - \sqrt{3} − 3
查看原页 令斜率相等: − y x 3 = − 3 ⇒ y x = 3 3 - \sqrt[3]{\frac{y}{x}} = - \sqrt{3} \Rightarrow \frac{y}{x} = 3\sqrt{3} − 3 x y = − 3 ⇒ x y = 3 3
查看原页 点 C C C 位于直线 y = − 3 x + 3 2 y = - \sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 上,并满足 y = 3 3 x y = 3\sqrt{3} x y = 3 3 x
查看原页 代入得, 3 3 x = − 3 x + 3 2 ⇒ 4 3 x = 3 2 ⇒ x = 1 8 3\sqrt{3} x = - \sqrt{3} x + \frac{\sqrt{3}}{2} \Rightarrow 4\sqrt{3} x = \frac{\sqrt{3}}{2} \Rightarrow x = \frac{1}{8} 3 3 x = − 3 x + 2 3 ⇒ 4 3 x = 2 3 ⇒ x = 8 1
查看原页 于是 y = 3 3 ( 1 8 ) = 3 3 8 y = 3\sqrt{3} (\frac{1}{8}) = \frac{3\sqrt{3}}{8} y = 3 3 ( 8 1 ) = 8 3 3
查看原页 点 C C C 为 ( 1 8 , 3 3 8 ) (\frac{1}{8},\frac{3\sqrt{3}}{8}) ( 8 1 , 8 3 3 )
查看原页 我们需要检查 C C C 是否位于 A B ‾ \overline{{A B}} A B 上。 A B ‾ \overline{{A B}} A B 上的点为 ( 1 2 − 1 2 t , 3 2 t ) (\frac{1}{2} - \frac{1}{2} t,\frac{\sqrt{3}}{2} t) ( 2 1 − 2 1 t , 2 3 t ) ,其中 0 ≤ t ≤ 1 0\leq t\leq 1 0 ≤ t ≤ 1
查看原页 对于 x = 1 8 x = \frac{1}{8} x = 8 1 , 1 2 − 1 2 t = 1 8 ⇒ t = 3 4 \frac{1}{2} - \frac{1}{2} t = \frac{1}{8} \Rightarrow t = \frac{3}{4} 2 1 − 2 1 t = 8 1 ⇒ t = 4 3
查看原页 对于 y = 3 3 8 y = \frac{3\sqrt{3}}{8} y = 8 3 3 , 3 2 t = 3 3 8 ⇒ t = 3 4 \frac{\sqrt{3}}{2} t = \frac{3\sqrt{3}}{8} \Rightarrow t = \frac{3}{4} 2 3 t = 8 3 3 ⇒ t = 4 3
查看原页 由于 0 < 3 4 < 1 0< \frac{3}{4} < 1 0 < 4 3 < 1 , C C C 是 A B ‾ \overline{{A B}} A B 的内点
查看原页 点 C C C 是 A B ‾ \overline{{A B}} A B 上(不包括端点)位于星形线上的唯一一点。星形线在 C C C 处的切线是线段 A B ‾ \overline{{A B}} A B 。因此, C C C 不属于来自 F \mathcal{F} F 的任何其他线段。
查看原页 最后,我们计算 O C 2 = ( 1 8 ) 2 + ( 3 3 8 ) 2 = 1 64 + 27 64 = 28 64 = 7 16 O C^{2} = (\frac{1}{8})^{2} + (\frac{3\sqrt{3}}{8})^{2} = \frac{1}{64} +\frac{27}{64} = \frac{28}{64} = \frac{7}{16} O C 2 = ( 8 1 ) 2 + ( 8 3 3 ) 2 = 64 1 + 64 27 = 64 28 = 16 7
查看原页 我们有 p = 7 p = 7 p = 7 和 q = 16 q = 16 q = 16 。它们互质。
查看原页
p + q = 7 + 16 = 23 p + q = 7 + 16 = 23 p + q = 7 + 16 = 23
查看原页 [错误生成,包含5923个思考词元和754个答案词元]
查看原页 题目要求在线段 A B ‾ \overline{{A B}} A B 上找到一点 C C C ,使得 C C C 不在族 F \mathcal{F} F 中除 A B ‾ \overline{{A B}} A B 本身以外的任何其他线段上。族 F \mathcal{F} F 由单位长度的线段 P Q ‾ \overline{{P Q}} P Q 组成,其中 P P P 在 x x x 轴上, Q Q Q 在第一象限的 y y y 轴上。令 P = ( x , 0 ) P = (x,0) P = ( x , 0 ) , Q = ( 0 , y ) Q = (0,y) Q = ( 0 , y ) ,其中 x > 0 x > 0 x > 0 , y > 0 y > 0 y > 0 。线段 P Q ‾ \overline{{P Q}} P Q 的长度为1,所以 P P P 与 Q Q Q 之间的距离为1。
查看原页 ( x − 0 ) 2 + ( 0 − y ) 2 x 2 + y 2 = 1 x 2 + y 2 = 1 \begin{array}{c} \frac{\sqrt{(x - 0)^{2}} + (0 - y)^{2}}{x^{2} + y^{2}} = 1 \\ x^{2} + y^{2} = 1 \end{array} x 2 + y 2 ( x − 0 ) 2 + ( 0 − y ) 2 = 1 x 2 + y 2 = 1 查看原页 线段 P Q ‾ \overline{{P Q}} P Q 位于第一象限,所以 x > 0 x > 0 x > 0 , y > 0 y > 0 y > 0
查看原页 方程 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 表示第一象限内的四分之一圆,其端点为 ( 1 , 0 ) (1,0) ( 1 , 0 ) 和 ( 0 , 1 ) (0,1) ( 0 , 1 ) 。 线段 P Q ‾ \overline{{P Q}} P Q 上的点可以参数化为 ( 1 − t ) x + t ( 0 ) , ( 1 − t ) 0 + t y ) = ( x ( 1 − t ) , y t ) (1 - t)x + t(0), (1 - t)0 + ty) = (x(1 - t),yt) ( 1 − t ) x + t ( 0 ) , ( 1 − t ) 0 + t y ) = ( x ( 1 − t ) , y t ) ,其中 0 ≤ t ≤ 1 0 \leq t \leq 1 0 ≤ t ≤ 1 。
查看原页 线段 A B ‾ \overline{{A B}} A B 连接 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 ) 和 B ( 0 , 3 2 ) B(0,\frac{\sqrt{3}}{2}) B ( 0 , 2 3 ) 。
查看原页 包含 A B ‾ \overline{{A B}} A B 的直线方程可以用这两个点求出: 斜率 m = 3 2 − 0 0 − 1 2 2 = 3 2 1 2 = − 3 m = \frac{\frac{\sqrt{3}}{2} - 0}{\frac{0 - \frac{1}{2}}{2}} = \frac{\frac{\sqrt{3}}{2}}{\frac{1}{2}} = -\sqrt{3} m = 2 0 − 2 1 2 3 − 0 = 2 1 2 3 = − 3 。
查看原页 使用点斜式并以点 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 ) 为已知点:
查看原页 y − 0 = − 3 ( x − 1 2 ) y = − 3 x + 3 2 \begin{array}{c} y - 0 = -\sqrt{3} (x - \frac{1}{2}) \\ y = -\sqrt{3} x + \frac{\sqrt{3}}{2} \end{array} y − 0 = − 3 ( x − 2 1 ) y = − 3 x + 2 3 查看原页 线段 A B ‾ \overline{{A B}} A B 位于第一象限,介于 x = 0 x = 0 x = 0 和 x = 1 2 x = \frac{1}{2} x = 2 1 之间。
查看原页 或者,我们可以参数化 A B ‾ \overline{{A B}} A B 上的点。 设 C C C 为 A B ‾ \overline{{A B}} A B 上的一点。则对于某个 0 ≤ λ ≤ 1 0 \leq \lambda \leq 1 0 ≤ λ ≤ 1 ,有 C = ( 1 − λ ) A + λ B C = (1 - \lambda)A + \lambda B C = ( 1 − λ ) A + λ B 。
查看原页 C = ( 1 − λ ) ( 1 2 , 0 ) + λ ( 0 , 3 2 ) = ( 1 2 − 1 2 λ , 3 2 λ ) . C = (1 - \lambda)(\frac{1}{2},0) + \lambda (0,\frac{\sqrt{3}}{2}) = (\frac{1}{2} - \frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda). C = ( 1 − λ ) ( 2 1 , 0 ) + λ ( 0 , 2 3 ) = ( 2 1 − 2 1 λ , 2 3 λ ) . 查看原页 我们要寻找 A B ‾ \overline{{A B}} A B 上唯一一点 C C C ,它不同于 A A A 和 B B B ,且不属于 F \mathcal{F} F 中除 A B ‾ \overline{{A B}} A B 以外的任何线段。 考虑 F \mathcal{F} F 中的一条线段,其端点为 P = ( x , 0 ) P = (x,0) P = ( x , 0 ) 和 Q = ( 0 , y ) Q = (0,y) Q = ( 0 , y ) ,其中 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。 该线段上的一点具有形式 ( x ( 1 − t ) , y t ) (x(1 - t),yt) ( x ( 1 − t ) , y t ) ,其中 0 ≤ t ≤ 1 0 \leq t \leq 1 0 ≤ t ≤ 1 。 我们希望找到 A B ‾ \overline{{A B}} A B 上一点 C C C , C ≠ A , B C \neq A,B C = A , B ,使得若 C C C 位于某条线段 P Q ‾ ∈ F \overline{{P Q}} \in \mathcal{F} P Q ∈ F 上,则 P Q ‾ = A B ‾ \overline{{P Q}} = \overline{{A B}} P Q = A B 。
查看原页 设 C = ( 1 2 − 1 2 λ , 3 2 λ ) C = (\frac{1}{2} - \frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda) C = ( 2 1 − 2 1 λ , 2 3 λ ) ,其中 0 < λ < 1 0 < \lambda < 1 0 < λ < 1 。 若 C C C 位于 F \mathcal{F} F 中的某条线段 P Q ‾ \overline{{P Q}} P Q 上,则存在 x , y > 0 x,y > 0 x , y > 0 满足 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 ,以及 t ∈ [ 0 , 1 ] t \in [0,1] t ∈ [ 0 , 1 ] ,使得:
查看原页 1 2 − 1 2 λ = x ( 1 − t ) \frac{1}{2} - \frac{1}{2}\lambda = x(1 - t) 2 1 − 2 1 λ = x ( 1 − t ) 查看原页 3 2 λ = y t \frac{\sqrt{3}}{2}\lambda = yt 2 3 λ = y t 查看原页 由第一个方程, 1 − t = 1 2 − 1 2 λ 2 x = 1 − λ 2 x 1 - t = \frac{\frac{1}{2} - \frac{1}{2}\lambda}{2x} = \frac{1 - \lambda}{2x} 1 − t = 2 x 2 1 − 2 1 λ = 2 x 1 − λ 。 由第二个方程, t = 3 2 λ y = 3 λ 2 y t = \frac{\frac{\sqrt{3}}{2}\lambda}{y} = \frac{\sqrt{3}\lambda}{2y} t = y 2 3 λ = 2 y 3 λ 。 由于 t ∈ [ 0 , 1 ] t \in [0,1] t ∈ [ 0 , 1 ] ,我们有 1 − t ∈ [ 0 , 1 ] 1 - t \in [0,1] 1 − t ∈ [ 0 , 1 ] 。 又因为 x > 0 x > 0 x > 0 ,所以 1 − λ 2 x > 0 \frac{1 - \lambda}{2x} > 0 2 x 1 − λ > 0 ,这意味着 1 − λ > 0 1 - \lambda > 0 1 − λ > 0 ,即 λ < 1 \lambda < 1 λ < 1 。这与点在 A B ‾ \overline{{A B}} A B 上的条件一致。
查看原页 我们有 1 − t = 1 − λ 2 x 1 - t = \frac{1 - \lambda}{2x} 1 − t = 2 x 1 − λ 和 t = 3 λ 2 y t = \frac{\sqrt{3}\lambda}{2y} t = 2 y 3 λ 。 将这两个方程相加: 1 = 1 − λ 2 x + 3 λ 2 y 1 = \frac{1 - \lambda}{2x} + \frac{\sqrt{3}\lambda}{2y} 1 = 2 x 1 − λ + 2 y 3 λ
查看原页 2 x y = ( 1 − λ ) y + 3 λ x 2xy = (1 - \lambda)y + \sqrt{3}\lambda x 2 x y = ( 1 − λ ) y + 3 λ x 查看原页 我们知道 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。 若点 C C C 属于线段 A B ‾ \overline{{A B}} A B 本身,则该线段的端点为 A A A 和 B B B 。 因此,该线段从 ( 1 2 , 0 ) (\frac{1}{2},0) ( 2 1 , 0 ) 到 ( 0 , 3 2 ) (0,\frac{\sqrt{3}}{2}) ( 0 , 2 3 ) 。 此处, x = 1 2 x = \frac{1}{2} x = 2 1 且 y = 3 2 y = \frac{\sqrt{3}}{2} y = 2 3 。 检验 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 : ( 1 2 ) 2 + ( 3 2 ) 2 = 1 4 + 3 4 = 1 (\frac{1}{2})^{2} + (\frac{\sqrt{3}}{2})^{2} = \frac{1}{4} +\frac{3}{4} = 1 ( 2 1 ) 2 + ( 2 3 ) 2 = 4 1 + 4 3 = 1 。因此 A B ‾ ∈ F \overline{{A B}}\in \mathcal{F} A B ∈ F 。
查看原页 若 C C C 属于 F \mathcal{F} F 中另一条线段 P Q ‾ \overline{{P Q}} P Q ,其端点为 P = ( x , 0 ) P = (x,0) P = ( x , 0 ) 和 Q = ( 0 , y ) Q = (0,y) Q = ( 0 , y ) ,其中 ( x , y ) ≠ ( 1 2 , 3 2 ) (x,y)\neq (\frac{1}{2},\frac{\sqrt{3}}{2}) ( x , y ) = ( 2 1 , 2 3 ) 。 考虑几何解释。族 F \mathcal{F} F 由长度为 1、端点位于坐标轴上的线段组成。这些线段的中点在圆 ( x − 1 2 ) 2 + ( y − 1 2 ) 2 = 1 2 (x - \frac{1}{2})^{2} + (y - \frac{1}{2})^{2} = \frac{1}{2} ( x − 2 1 ) 2 + ( y − 2 1 ) 2 = 2 1 上。 设点 C C C 对应于某个 λ \lambda λ 。 若 C C C 位于 P Q ‾ \overline{{P Q}} P Q 上,则 C = ( x ( 1 − t ) , y t ) C = (x(1 - t),y t) C = ( x ( 1 − t ) , y t ) 。 因此, 1 2 − 1 2 λ = x ( 1 − t ) \frac{1}{2} - \frac{1}{2}\lambda = x(1 - t) 2 1 − 2 1 λ = x ( 1 − t ) 且 3 2 λ = y t \frac{\sqrt{3}}{2}\lambda = y t 2 3 λ = y t 。 我们需要找到一个 λ ∈ ( 0 , 1 ) \lambda \in (0,1) λ ∈ ( 0 , 1 ) ,使得这些方程在 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 、 x , y > 0 x,y > 0 x , y > 0 条件下的唯一解为 x = 1 2 x = \frac{1}{2} x = 2 1 且 y = 3 2 y = \frac{\sqrt{3}}{2} y = 2 3 。 由方程可得 1 − t = 1 − λ 2 x 1 - t = \frac{1 - \lambda}{2x} 1 − t = 2 x 1 − λ 和 t = 3 λ 2 y t = \frac{\sqrt{3}\lambda}{2y} t = 2 y 3 λ 。 将这些代入 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。
查看原页 尝试另一种方法。考虑该线段族的切线。 这些线段由点 ( x , 0 ) (x,0) ( x , 0 ) 和 ( 0 , y ) (0,y) ( 0 , y ) 构成,其中 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。 包含线段 P Q ‾ \overline{{P Q}} P Q 的直线方程为 x x + y y = 1 \frac{x}{x} +\frac{y}{y} = 1 x x + y y = 1 ,或 x x + y y = 1 \frac{x}{x} +\frac{y}{y} = 1 x x + y y = 1 。 该直线方程为 x x + y y = 1 \frac{x}{x} +\frac{y}{y} = 1 x x + y y = 1 。
查看原页 考虑线段的参数形式方程: ( x ( 1 − t ) , y t ) (x(1 - t),y t) ( x ( 1 − t ) , y t ) 。 若点 C C C 位于该线段上,则 C = ( x c , y c ) C = (x_{c},y_{c}) C = ( x c , y c ) ,其中 x c = x ( 1 − t ) x_{c} = x(1 - t) x c = x ( 1 − t ) 且 y c = y t y_{c} = y t y c = y t 。 因此, x c x = 1 − t \frac{x_{c}}{x} = 1 - t x x c = 1 − t 且 y c y = t \frac{y_{c}}{y} = t y y c = t 。 x c x + y c y = 1 − t + t = 1 \frac{x_{c}}{x} +\frac{y_{c}}{y} = 1 - t + t = 1 x x c + y y c = 1 − t + t = 1 。 F \mathcal{F} F 中的线段是直线 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 的一部分,其中 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 , x 0 , y 0 > 0 x_{0},y_{0} > 0 x 0 , y 0 > 0 。
查看原页 考虑点 C = ( 1 2 − 1 2 λ , 3 2 λ ) C = (\frac{1}{2} -\frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda) C = ( 2 1 − 2 1 λ , 2 3 λ ) 。 若 C C C 位于 F \mathcal{F} F 中一条端点为 ( x , 0 ) (x,0) ( x , 0 ) 和 ( 0 , y ) (0,y) ( 0 , y ) 的线段上,则:
查看原页 1 − 1 2 λ x + 3 λ y = 1 \frac{1 - \frac{1}{2}\lambda}{x} +\frac{\sqrt{3}\lambda}{y} = 1 x 1 − 2 1 λ + y 3 λ = 1 查看原页 1 − λ 2 x + 3 λ 2 y = 1 \frac{1 - \lambda}{2x} +\frac{\sqrt{3}\lambda}{2y} = 1 2 x 1 − λ + 2 y 3 λ = 1 查看原页 我们需要找到一个唯一的 λ ∈ ( 0 , 1 ) \lambda \in (0,1) λ ∈ ( 0 , 1 ) ,使得该方程在 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 、 x , y > 0 x,y > 0 x , y > 0 条件下的唯一解 ( x , y ) (x,y) ( x , y ) 为 ( 1 2 , 3 2 ) (\frac{1}{2},\frac{\sqrt{3}}{2}) ( 2 1 , 2 3 ) 。
查看原页 将 x = 1 2 x = \frac{1}{2} x = 2 1 和 y = 3 2 y = \frac{\sqrt{3}}{2} y = 2 3 代入方程:
查看原页 1 − λ 2 ( 1 2 ) + 3 λ 2 ( 3 2 ) = 1 \frac{1 - \lambda}{2(\frac{1}{2})} +\frac{\sqrt{3}\lambda}{2(\frac{\sqrt{3}}{2})} = 1 2 ( 2 1 ) 1 − λ + 2 ( 2 3 ) 3 λ = 1 查看原页 1 − λ + λ = 1 1 - \lambda +\lambda = 1 1 − λ + λ = 1 查看原页 这表明 A B ‾ \overline{{A B}} A B 上的任意点都位于线段 A B ‾ \overline{{A B}} A B 本身上。
查看原页 考虑包含 A B ‾ \overline{{A B}} A B 的直线: y = − 3 x + 3 2 y = -\sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 。
查看原页 若 A B ‾ \overline{{A B}} A B 上的点 C C C 同时也位于 F \mathcal{F} F 中另一条端点为 ( x , 0 ) (x,0) ( x , 0 ) 和 ( 0 , y ) (0,y) ( 0 , y ) 的线段上,则:
查看原页 x C x + y C y = 1. \frac{x_{C}}{x} +\frac{y_{C}}{y} = 1. x x C + y y C = 1. 查看原页 设点 C C C 按比 μ : ( 1 − μ ) \mu :(1 - \mu) μ : ( 1 − μ ) 分割 A B ‾ \overline{{A B}} A B ,其中 0 < μ < 1 0< \mu < 1 0 < μ < 1 。
查看原页 C = ( 1 − μ ) A + μ B = ( 1 − μ ) ( 1 2 , 0 ) + μ ( 0 , 3 2 ) = ( 1 2 − 1 2 μ , 3 2 μ ) . C = (1 - \mu)A + \mu B = (1 - \mu)(\frac{1}{2},0) + \mu (0,\frac{\sqrt{3}}{2}) = (\frac{1}{2} -\frac{1}{2}\mu ,\frac{\sqrt{3}}{2}\mu). C = ( 1 − μ ) A + μ B = ( 1 − μ ) ( 2 1 , 0 ) + μ ( 0 , 2 3 ) = ( 2 1 − 2 1 μ , 2 3 μ ) . 查看原页 若 C C C 位于一条端点为 ( x , 0 ) (x,0) ( x , 0 ) 和 ( 0 , y ) (0,y) ( 0 , y ) 的线段上,则:
查看原页 1 − 1 2 μ x + 3 μ 2 = 1. \frac{1 - \frac{1}{2}\mu}{x} +\frac{\sqrt{3}\mu}{2} = 1. x 1 − 2 1 μ + 2 3 μ = 1. 查看原页 我们正在寻找一个点 C C C ,使得经过 C C C 且形如 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 的直线是唯一的,其中 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 。
查看原页 考虑以原点为中心的单位圆的切线。形如 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 的直线是圆 x 2 + y 2 = r 2 x^{2} + y^{2} = r^{2} x 2 + y 2 = r 2 的切线。
查看原页 考虑对偶问题。这族线段对应于第一象限中四分之一圆 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 上的点。
查看原页 包含这些线段的直线为 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 。
查看原页 方程为\(\frac{x}{x_{0}} +\frac{y}{y_{0}} = 1\) ,其中约束条件为 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 。
查看原页 令\(x_{0} = \cos \theta\) , y 0 = sin θ y_{0} = \sin \theta y 0 = sin θ ,其中 0 < θ < π 2 0 < \theta < \frac{\pi}{2} 0 < θ < 2 π 。
查看原页 这些直线的方程为 x cos θ + y sin θ = 1 x \cos \theta + y \sin \theta = 1 x cos θ + y sin θ = 1 。
查看原页 直线族\(x \cos \theta + y \sin \theta = 1\) 的包络是圆 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。
查看原页 来自 F \mathcal{F} F 的线段是第一象限中单位圆的切线的部分。
查看原页 A B ‾ \overline{AB} A B 上不属于 F \mathcal{F} F 中任何其他线段的点 C C C 意味着经过 C C C 的单位圆的切线是唯一的。
查看原页 考虑点 C = ( 1 2 − 1 2 λ , 3 2 λ ) C = (\frac{1}{2} - \frac{1}{2}\lambda , \frac{\sqrt{3}}{2}\lambda) C = ( 2 1 − 2 1 λ , 2 3 λ ) 。
查看原页 经过 C C C 的单位圆的切线具有形式 x x C + y y C = 1 xx_{C} + yy_{C} = 1 x x C + y y C = 1 。
查看原页 如果切线是唯一的,那么 C C C 位于单位圆上。
查看原页 1 2 − 1 2 λ ) 2 + ( 3 2 λ ) 2 = 1 1 4 − 1 2 λ + 1 4 λ 2 ) + 3 4 λ 2 = 1 1 4 − 1 2 λ + λ 2 = 1 4 λ 2 − 2 λ + 1 = 4 4 λ 2 − 2 λ − 3 = 0 \begin{array}{c} \frac{1}{2} -\frac{1}{2}\lambda)^{2} + (\frac{\sqrt{3}}{2}\lambda)^{2} = 1 \\ \frac{1}{4} -\frac{1}{2}\lambda +\frac{1}{4}\lambda^{2}) + \frac{3}{4}\lambda^{2} = 1 \\ \frac{1}{4} -\frac{1}{2}\lambda +\lambda^{2} = 1 \\ 4\lambda^{2} - 2\lambda +1 = 4 \\ 4\lambda^{2} - 2\lambda -3 = 0 \end{array} 2 1 − 2 1 λ ) 2 + ( 2 3 λ ) 2 = 1 4 1 − 2 1 λ + 4 1 λ 2 ) + 4 3 λ 2 = 1 4 1 − 2 1 λ + λ 2 = 1 4 λ 2 − 2 λ + 1 = 4 4 λ 2 − 2 λ − 3 = 0 查看原页 λ = − ( 2 − 2 ) ( − 2 ) 2 − 4 ( 4 ) ( − 3 ) 2 ( 4 ) = 2 + 4 + 48 8 = 2 + 52 8 = 2 + 2 13 8 = 1 + 13 4 . \lambda = \frac{-(2 - 2)\sqrt{(-2)^{2} - 4(4)(-3)}}{2(4)} = \frac{2 + \sqrt{4 + 48}}{8} = \frac{2 + \sqrt{52}}{8} = \frac{2 + 2\sqrt{13}}{8} = \frac{1 + \sqrt{13}}{4}. λ = 2 ( 4 ) − ( 2 − 2 ) ( − 2 ) 2 − 4 ( 4 ) ( − 3 ) = 8 2 + 4 + 48 = 8 2 + 52 = 8 2 + 2 13 = 4 1 + 13 . 查看原页 我们需要 0 < λ < 1 0 < \lambda < 1 0 < λ < 1 。
查看原页 13 ≈ 3.6 1 + 3.6 = 4.6 4 > 1. \frac{\sqrt{13}\approx 3.6}{1 + 3.6} = \frac{4.6}{4} >1. 1 + 3.6 13 ≈ 3.6 = 4 4.6 > 1. 查看原页 1 − 3.6 4 = − 2.6 4 < 0. \frac{1 - 3.6}{4} = \frac{-2.6}{4} < 0. 4 1 − 3.6 = 4 − 2.6 < 0. 查看原页 让我们重新表述这个条件。 A B ‾ \overline{AB} A B 上存在唯一的点 C C C ,使得若 C C C 位于线段 P Q ‾ ∈ F \overline{PQ} \in \mathcal{F} P Q ∈ F 上,则 P Q ‾ = A B ‾ \overline{PQ} = \overline{AB} P Q = A B 。
查看原页 设 A B ‾ \overline{AB} A B 上的点 C C C 为 ( 1 2 − 1 2 λ , 3 2 λ ) (\frac{1}{2} - \frac{1}{2}\lambda , \frac{\sqrt{3}}{2}\lambda) ( 2 1 − 2 1 λ , 2 3 λ ) 。
查看原页 考虑 F \mathcal{F} F 中端点为 ( x , 0 ) (x, 0) ( x , 0 ) 和 ( 0 , y ) (0, y) ( 0 , y ) 的线段, x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。
查看原页 该线段的参数形式为 ( x ( 1 − t ) , y t ) (x(1 - t), y t) ( x ( 1 − t ) , y t ) 。
查看原页 如果 C C C 位于此线段上,那么对于某个 t ∈ [ 0 , 1 ] t \in [0, 1] t ∈ [ 0 , 1 ] :
查看原页 1 2 − 1 2 λ = x ( 1 − t ) \frac{1}{2} -\frac{1}{2}\lambda = x(1 - t) 2 1 − 2 1 λ = x ( 1 − t ) 查看原页 3 2 λ = y t \frac{\sqrt{3}}{2}\lambda = y t 2 3 λ = y t 查看原页 如果线段是唯一的,那么 x x x 和 y y y 的值是唯一的。
查看原页 方程 1 − λ 2 x + 3 λ 2 y = 1 \frac{1 - \lambda}{2x} + \frac{\sqrt{3}\lambda}{2y} = 1 2 x 1 − λ + 2 y 3 λ = 1 在 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 、 x , y > 0 x, y > 0 x , y > 0 条件下的唯一解应为 x = 1 2 x = \frac{1}{2} x = 2 1 , y = 3 2 y = \frac{\sqrt{3}}{2} y = 2 3 。
查看原页 考虑包含 A B ‾ \overline{AB} A B 的直线与由 F \mathcal{F} F 中线段形成的区域边界的交点。
查看原页 边界是 x x x 轴、 y y y 轴和四分之一圆 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。
查看原页 再次考虑对偶问题。直线族 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 ,其中 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 , x 0 , y 0 > 0 x_{0}, y_{0} > 0 x 0 , y 0 > 0 。
查看原页 这些直线的包络是圆 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 。
查看原页 一个点属于 F \mathcal{F} F 中唯一的一条线段,当且仅当它位于圆 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 上。
查看原页 A B ‾ \overline{AB} A B 上的点 C C C 满足 C = t A + ( 1 − t ) B C = tA + (1 - t)B C = t A + ( 1 − t ) B 。
查看原页 让我们考虑线段为 A B ‾ \overline{AB} A B 的情形。此处 x = 1 2 x = \frac{1}{2} x = 2 1 , y = 3 2 y = \frac{\sqrt{3}}{2} y = 2 3 。
查看原页 点 C C C 可以表示为 ( 1 2 ( 1 − s ) , 3 2 s ) (\frac{1}{2} (1 - s), \frac{\sqrt{3}}{2} s) ( 2 1 ( 1 − s ) , 2 3 s ) ,其中 0 ≤ s ≤ 1 0 \leq s \leq 1 0 ≤ s ≤ 1 。
查看原页 我们要找 A B ‾ \overline{AB} A B 上的一点 C C C ,它不在 F \mathcal{F} F 中任何其他线段上。
查看原页 考虑其几何结构。族 F \mathcal{F} F 构成一个由坐标轴和四分之一圆所围成的区域。
查看原页 这些线段是以直线 y = x y = x y = x 上为圆心、与坐标轴相切的圆上的弦。
查看原页 设一条线段的端点为 ( cos θ , 0 ) (\cos \theta ,0) ( cos θ , 0 ) 和 ( 0 , sin θ ) (0,\sin \theta) ( 0 , sin θ )
查看原页 线段上的一点为 ( cos θ ( 1 − t ) , sin θ t ) (\cos \theta (1 - t),\sin \theta t) ( cos θ ( 1 − t ) , sin θ t )
查看原页 点 C = ( 1 2 − 1 2 λ , 3 2 λ ) C = (\frac{1}{2} - \frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda) C = ( 2 1 − 2 1 λ , 2 3 λ )
查看原页 若 C C C 位于这样一条线段上,则 1 2 − 1 2 λ cos θ = 1 − t \frac{\frac{1}{2} - \frac{1}{2}\lambda}{\cos\theta} = 1 - t c o s θ 2 1 − 2 1 λ = 1 − t 且 3 2 λ sin θ = t \frac{\frac{\sqrt{3}}{2}\lambda}{\sin\theta} = t s i n θ 2 3 λ = t
查看原页 1 − λ 2 cos θ + 3 λ 2 sin θ = 1. \frac{1 - \lambda}{2\cos\theta} +\frac{\sqrt{3}\lambda}{2\sin\theta} = 1. 2 cos θ 1 − λ + 2 sin θ 3 λ = 1. 查看原页 我们需要一个唯一的 λ ∈ ( 0 , 1 ) \lambda \in (0,1) λ ∈ ( 0 , 1 ) ,使得唯一的解 ( cos θ , sin θ ) (\cos \theta ,\sin \theta) ( cos θ , sin θ ) 为 ( 1 2 , 3 2 ) (\frac{1}{2},\frac{\sqrt{3}}{2}) ( 2 1 , 2 3 ) ,这对应于 θ = π 3 \theta = \frac{\pi}{3} θ = 3 π
查看原页 考虑函数 f ( θ ) = 1 2 cos θ − λ 2 cos θ + 3 λ 2 sin θ f(\theta) = \frac{1}{2\cos\theta} - \frac{\lambda}{2\cos\theta} +\frac{\sqrt{3}\lambda}{2\sin\theta} f ( θ ) = 2 c o s θ 1 − 2 c o s θ λ + 2 s i n θ 3 λ
查看原页 我们需要 f ( θ ) = 1 f(\theta) = 1 f ( θ ) = 1
查看原页 若 λ = 1 2 \lambda = \frac{1}{2} λ = 2 1 ,则 C = ( 1 4 , 3 4 ) C = (\frac{1}{4},\frac{\sqrt{3}}{4}) C = ( 4 1 , 4 3 )
查看原页 1 − 1 / 2 2 cos θ + 3 ( 1 / 2 ) 2 sin θ = 1 \frac{1 - 1 / 2}{2\cos\theta} +\frac{\sqrt{3(1 / 2)}}{2\sin\theta} = 1 2 cos θ 1 − 1/2 + 2 sin θ 3 ( 1/2 ) = 1 查看原页 1 4 cos θ + 3 4 sin θ = 1 \frac{1}{4\cos\theta} +\frac{\sqrt{3}}{4\sin\theta} = 1 4 cos θ 1 + 4 sin θ 3 = 1 查看原页 1 cos θ + 3 sin θ = 4 \frac{1}{\cos\theta} +\frac{\sqrt{3}}{\sin\theta} = 4 cos θ 1 + sin θ 3 = 4 查看原页
sin θ + 3 cos θ = 4 sin θ cos θ \sin \theta +\sqrt{3}\cos \theta = 4\sin \theta \cos \theta sin θ + 3 cos θ = 4 sin θ cos θ
查看原页
sin θ + 3 cos θ = 2 sin ( 2 θ ) \sin \theta +\sqrt{3}\cos \theta = 2\sin (2\theta) sin θ + 3 cos θ = 2 sin ( 2 θ )
查看原页 除以 2: 1 2 sin θ + 3 2 cos θ = sin ( 2 θ ) \frac{1}{2}\sin \theta +\frac{\sqrt{3}}{2}\cos \theta = \sin (2\theta) 2 1 sin θ + 2 3 cos θ = sin ( 2 θ )
查看原页
sin ( θ + π 3 ) = sin ( 2 θ ) \sin (\theta +\frac{\pi}{3}) = \sin (2\theta) sin ( θ + 3 π ) = sin ( 2 θ )
查看原页 θ + π 3 = 2 θ + 2 π k \theta +\frac{\pi}{3} = 2\theta +2\pi k θ + 3 π = 2 θ + 2 π k ,或 θ + π 3 = π − 2 θ + 2 π k \theta +\frac{\pi}{3} = \pi - 2\theta +2\pi k θ + 3 π = π − 2 θ + 2 π k
查看原页 θ = π 3 − 2 π k \theta = \frac{\pi}{3} - 2\pi k θ = 3 π − 2 π k ,因此 θ = π 3 \theta = \frac{\pi}{3} θ = 3 π
查看原页
3 θ = π − π 3 + 2 π k = 2 π 3 + 2 π k 3\theta = \pi - \frac{\pi}{3} +2\pi k = \frac{2\pi}{3} +2\pi k 3 θ = π − 3 π + 2 π k = 3 2 π + 2 π k
查看原页
θ = 2 π 9 + 2 π k 3 \theta = \frac{2\pi}{9} +\frac{2\pi k}{3} θ = 9 2 π + 3 2 π k
查看原页 若 k = 0 k = 0 k = 0 ,则 θ = 2 π 9 \theta = \frac{2\pi}{9} θ = 9 2 π
查看原页 若 k = 1 k = 1 k = 1 ,则 θ = 2 π 9 + 2 π 3 = 2 π + 6 π 9 = 8 π 9 \theta = \frac{2\pi}{9} +\frac{2\pi}{3} = \frac{2\pi + 6\pi}{9} = \frac{8\pi}{9} θ = 9 2 π + 3 2 π = 9 2 π + 6 π = 9 8 π
查看原页 若 λ = 1 2 \lambda = \frac{1}{2} λ = 2 1 ,则该点为 ( 1 4 , 3 4 ) (\frac{1}{4},\frac{\sqrt{3}}{4}) ( 4 1 , 4 3 )
查看原页 该点位于对应于 θ = π 3 \theta = \frac{\pi}{3} θ = 3 π 和 θ = 2 π 9 \theta = \frac{2\pi}{9} θ = 9 2 π 的线段上
查看原页 唯一的点 C C C 意味着对于 λ \lambda λ 的其他取值, ( x , y ) (x,y) ( x , y ) 的解多于一个
查看原页 这导致 λ = 1 ± 13 4 \lambda = \frac{1\pm\sqrt{13}}{4} λ = 4 1 ± 13 ,两者都不在 ( 0 , 1 ) (0,1) ( 0 , 1 ) 内。
查看原页 考虑族 F \mathcal{F} F 的几何解释。这些线段连接坐标轴上的点,使得距离为 1。
查看原页 这些线段中点的轨迹是圆 ( x − 1 2 ) 2 + ( y − 1 2 ) 2 = 1 2 (x - \frac{1}{2})^{2} + (y - \frac{1}{2})^{2} = \frac{1}{2} ( x − 2 1 ) 2 + ( y − 2 1 ) 2 = 2 1 ,位于第一象限。
查看原页 若点 C C C 位于 F \mathcal{F} F 中的一条线段上,则 C C C 位于连接 ( x , 0 ) (x,0) ( x , 0 ) 与 ( 0 , y ) (0,y) ( 0 , y ) 且满足 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 的线段上。
查看原页 包含该线段的直线为 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 。
查看原页 若 C C C 属于唯一一条线段,则存在唯一一条这种形式的直线经过 C C C 。
查看原页 A B ‾ \overline{AB} A B 上的点 C C C 为 ( 1 2 − 1 2 λ , 3 2 λ ) (\frac{1}{2} - \frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda) ( 2 1 − 2 1 λ , 2 3 λ ) 。
查看原页 我们需要唯一的 ( x 0 , y 0 ) (x_{0},y_{0}) ( x 0 , y 0 ) ,满足 x 0 2 + y 0 2 = 1 , x 0 , y 0 > 0 x_{0}^{2} + y_{0}^{2} = 1,x_{0},y_{0} > 0 x 0 2 + y 0 2 = 1 , x 0 , y 0 > 0 ,使得 1 2 − 1 2 λ x 0 + 3 2 λ y 0 = 1 \frac{\frac{1}{2} - \frac{1}{2}\lambda}{x_{0}} +\frac{\frac{\sqrt{3}}{2}\lambda}{y_{0}} = 1 x 0 2 1 − 2 1 λ + y 0 2 3 λ = 1 。
查看原页 设点 C C C 使得经过 C C C 且形式为 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 的直线唯一,并受约束于 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 。
查看原页 点 C C C 位于包含 A B ‾ \overline{AB} A B 的直线与单位圆的交点上。
查看原页 ( 1 2 − 1 2 λ ) 2 + ( 3 2 λ ) 2 = 1. (\frac{1}{2} -\frac{1}{2}\lambda)^{2} + (\frac{\sqrt{3}}{2}\lambda)^{2} = 1. ( 2 1 − 2 1 λ ) 2 + ( 2 3 λ ) 2 = 1. 查看原页 我们未找到 λ ∈ ( 0 , 1 ) \lambda \in (0,1) λ ∈ ( 0 , 1 ) 的解。 唯一的点 C C C 意味着,若任何其他线段经过 C C C ,它必定是 A B ‾ \overline{AB} A B 。
查看原页 考虑包含连接 ( x , 0 ) (x,0) ( x , 0 ) 与 ( 0 , y ) (0,y) ( 0 , y ) 的线段的直线的斜率。斜率为 − y x - \frac{y}{x} − x y 。
查看原页 方程为 y = − y x x + y y = - \frac{y}{x} x + y y = − x y x + y 。
查看原页 若 C C C 位于该线段上,则 1 − λ 2 x + 3 λ 2 y = 1 \frac{1 - \lambda}{2x} +\frac{\sqrt{3}\lambda}{2y} = 1 2 x 1 − λ + 2 y 3 λ = 1 。
查看原页 设点 C C C 的坐标为 ( a , b ) (a,b) ( a , b ) 。连接 ( x , 0 ) (x,0) ( x , 0 ) 与 ( 0 , y ) (0,y) ( 0 , y ) 的线段经过 ( a , b ) (a,b) ( a , b ) 。 a x + b y = 1 \frac{a}{x} +\frac{b}{y} = 1 x a + y b = 1 。 若 C C C 在 A B ‾ \overline{AB} A B 上,则 b = − 3 a + 3 2 b = - \sqrt{3} a + \frac{\sqrt{3}}{2} b = − 3 a + 2 3 。 a = 1 2 − 1 2 λ , b = 3 2 λ a = \frac{1}{2} - \frac{1}{2}\lambda ,b = \frac{\sqrt{3}}{2}\lambda a = 2 1 − 2 1 λ , b = 2 3 λ 。
查看原页 解: 设线段族为 F \mathcal{F} F 。这些线段的端点为 P = ( x , 0 ) P = (x,0) P = ( x , 0 ) 和 Q = ( 0 , y ) Q = (0,y) Q = ( 0 , y ) ,满足 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 且 x , y > 0 x,y > 0 x , y > 0 。线段 P Q ‾ \overline{PQ} P Q 上的点满足 x y + y x = 1 \frac{x}{y} +\frac{y}{x} = 1 y x + x y = 1 。这些线段位于直线 x x 0 + y y 0 = 1 \frac{x}{x_{0}} +\frac{y}{y_{0}} = 1 x 0 x + y 0 y = 1 上,其中 x 0 2 + y 0 2 = 1 x_{0}^{2} + y_{0}^{2} = 1 x 0 2 + y 0 2 = 1 , x 0 , y 0 > 0 x_{0},y_{0} > 0 x 0 , y 0 > 0 。
查看原页 线段 A B ‾ \overline{AB} A B 的端点为 A ( 1 2 , 0 ) A(\frac{1}{2},0) A ( 2 1 , 0 ) 和 B ( 0 , 3 2 ) B(0,\frac{\sqrt{3}}{2}) B ( 0 , 2 3 ) 。包含 A B ‾ \overline{AB} A B 的直线方程为 y = − 3 x + 3 2 y = - \sqrt{3} x + \frac{\sqrt{3}}{2} y = − 3 x + 2 3 。
查看原页 A B ‾ \overline{AB} A B 上的点 C C C 可参数化为 C = ( 1 2 − 1 2 λ , 3 2 λ ) C = (\frac{1}{2} - \frac{1}{2}\lambda ,\frac{\sqrt{3}}{2}\lambda) C = ( 2 1 − 2 1 λ , 2 3 λ ) ,其中 0 ≤ λ ≤ 1 0\leq \lambda \leq 1 0 ≤ λ ≤ 1 。
查看原页 若 C C C 属于 F \mathcal{F} F 中端点为 ( x , 0 ) (x,0) ( x , 0 ) 和 ( 0 , y ) (0,y) ( 0 , y ) 的一条线段,则 1 2 − 1 2 λ x + 3 2 λ y = 1 \frac{\frac{1}{2} - \frac{1}{2}\lambda}{x} +\frac{\frac{\sqrt{3}}{2}\lambda}{y} = 1 x 2 1 − 2 1 λ + y 2 3 λ = 1 。
查看原页 我们正在寻找 A B ‾ \overline{AB} A B 上唯一一个不同于 A A A 和 B B B 的点 C C C ,它不属于 F \mathcal{F} F 中除 A B ‾ \overline{AB} A B 外的任何线段。这意味着,在 x 2 + y 2 = 1 x^{2} + y^{2} = 1 x 2 + y 2 = 1 、 x , y > 0 x,y > 0 x , y > 0 的条件下,该方程的唯一解 ( x , y ) (x,y) ( x , y ) 是 ( 1 2 , 3 2 ) (\frac{1}{2},\frac{\sqrt{3}}{2}) ( 2 1 , 2 3 ) 。
查看原页 来自 F \mathcal{F} F 的线段是单位圆的切线的一部分。点 C C C 必须与线段族的包络相切。该包络就是单位圆本身。
查看原页 在 A B ‾ \overline{AB} A B 上,除 A A A 和 B B B 之外,唯一位于单位圆上的点是 C C C 。我们需要求解:
查看原页 ( 1 2 − 1 2 λ ) 2 + ( 3 2 λ ) 2 = 1 (\frac{1}{2} -\frac{1}{2}\lambda)^{2} + (\frac{\sqrt{3}}{2}\lambda)^{2} = 1 ( 2 1 − 2 1 λ ) 2 + ( 2 3 λ ) 2 = 1 查看原页 λ = 1 2 \lambda = \frac{1}{2} λ = 2 1 。点 C = ( 1 4 , 3 2 ) C = (\frac{1}{4},\frac{\sqrt{3}}{2}) C = ( 4 1 , 2 3 ) 。
查看原页 O C 2 = ( 1 4 ) 2 + ( 3 4 ) 2 = 1 16 + 3 16 = 4 16 = 1 4 . O C^{2} = (\frac{1}{4})^{2} + (\frac{\sqrt{3}}{4})^{2} = \frac{1}{16} +\frac{3}{16} = \frac{4}{16} = \frac{1}{4}. O C 2 = ( 4 1 ) 2 + ( 4 3 ) 2 = 16 1 + 16 3 = 16 4 = 4 1 . 查看原页 O C 2 = 1 4 = p q O C^{2} = \frac{1}{4} = \frac{p}{q} O C 2 = 4 1 = q p ,所以 p = 1 p = 1 p = 1 , q = 4 q = 4 q = 4 。 p p p 与 q q q 互质。 p + q = 1 + 4 = 5 p + q = 1 + 4 = 5 p + q = 1 + 4 = 5 。
查看原页 最终答案:最终答案为 5 \boxed{5} 5
查看原页 V 2 → V 3 \mathbf{V}2 \rightarrow \mathbf{V}3 V 2 → V 3 (2025-03):
查看原页 添加了 § A \S \mathrm{A} § A
查看原页 在 § 2 \S 2 §2 中添加了正确样本的数量
查看原页 V 1 → V 2 \mathbf{V}1 \rightarrow \mathbf{V}2 V 1 → V 2 (2025-02):
查看原页 新用户注册即送 $1 免费额度,把你自己的 PDF 也做成同款电子书